
Sans traces, versions de modèle et de prompt, spans d’outils et métriques de coût, chaque incident reste de la spéculation.
Pendant quatre articles, j’ai écrit sur des principes : Contracts, evals, sécurité des outils, supervision humaine. C’est juste - mais en exploitation, comment je sais si tout ça fonctionne vraiment ?
Sans observability structurée, impossible. Un False Success dans le refund-agent - l’outil signale un succès, le client attend son argent - est introuvable avec des application logs et des taux d’erreur. Tout est au vert. Le système n’a pas échoué, il a menti.
Cet article montre de quelle infrastructure d’observability ont besoin les équipes qui font tourner des fonctionnalités d’IA en production. À quelles questions dois-je pouvoir répondre ? À quoi ressemble une bonne trace ? Et comment situer où j’en suis moi-même ?

Cinq questions avant l’outillage
Comment aurais-je pu déboguer ça en 30 secondes ?
Pas avec grep dans des fichiers de log. Pas avec un dashboard qui m’affiche l’uptime et le taux d’erreur - car les deux étaient au vert. Pas d’erreur, pas d’alerte, juste un mauvais résultat.
Les métriques traditionnelles n’attrapent pas les erreurs propres à l’IA. Un False Success, un mauvais choix d’outil ou des actions hallucinées restent invisibles tant que je ne regarde que les codes de statut HTTP et le nombre d’exceptions. Le problème est plus profond - dans la logique de décision de l’agent et dans l’interprétation des réponses des outils. Entre deux tours, du contexte se perd sans qu’aucun fichier de log ne le signale.
Avant de parler d’outillage, cinq questions auxquelles chaque équipe devrait pouvoir répondre.
1. Débogage : pourquoi l’agent a-t-il dit X au client alors que Y s’est produit ?
Le refund-agent dit « Le remboursement est parti ». Mais refund_order a renvoyé une erreur - ou n’a même jamais été appelé. Sans trace corrélée avec les résultats des tool calls, les entrées et les sorties du modèle, on joue aux devinettes. J’ai besoin d’une chaîne : saisie de l’utilisateur, décision de routing, intention d’appel d’outil, résultat de l’outil, réponse générée. Sans trou.
2. Coûts : combien coûte un cas de support moyen - et quel chemin d’agent consomme le plus de tokens ?
Tous les cas de support ne coûtent pas le même prix. Un simple lookup de FAQ coûte quelques centaines de tokens. Un flux de remboursement avec vérification d’identité, consultation de commande et boucle d’approbation peut vite en consommer vingt fois plus. Sans attribution des tokens par agent, par outil et par conversation, je ne vois qu’une facture mensuelle - mais pas où part l’argent.
3. Latence : où l’agent bloque-t-il - sur l’appel au modèle, sur le tool call ou sur le retrieval ?
L’utilisateur attend. Mais quoi, au juste ? Le modèle, qui met 3 secondes à répondre ? L’appel lookup_order, qui tourne contre une base de données lente ? Ou un système de retrieval qui rassemble le contexte ? La décomposition de la latence par span n’est pas un nice-to-have - c’est la seule façon d’optimiser de manière ciblée au lieu de deviner.
4. Qualité : à quelle fréquence l’agent choisit-il le mauvais outil ? À quelle fréquence lui faut-il plusieurs tentatives ?
L’agent a quatre outils au choix. Combien de fois prend-il le bon ? Combien de fois appelle-t-il lookup_order alors qu’il aurait dû appeler verify_customer - pour ne se corriger qu’à la deuxième tentative ? Le suivi du choix des outils et le nombre de retries me montrent où le modèle se trompe systématiquement. Ce ne sont pas des edge cases - ce sont des signaux de problèmes de prompt ou de tool descriptions manquantes.
5. Conformité : puis-je retracer le chemin de décision complet pour un dossier client précis ?
Un client appelle et veut savoir pourquoi son remboursement n’est pas arrivé. La réglementation exige la traçabilité. J’ai besoin d’un audit trail qui montre : quel agent a appelé quel outil et quand, quels événements d’approbation il y a eu, qui a autorisé quoi ? Sans ça, chaque dossier client est une boîte noire.
Cinq questions, cinq exigences d’observability différentes. Et pourtant, en pratique, il se passe souvent la même chose : on branche un outil de tracing, on écrit quelques spans - et ensuite chacun espère que les bonnes données seront dedans.
Dans la plupart des équipes, ce n’est pas l’outillage qui manque - c’est la clarté sur les questions d’exploitation auxquelles il faut répondre.
Anatomie d’une trace
Cinq questions. Aucun dashboard qui y répond. Changeons ça.
Prenons le refund-agent et regardons ce qu’une seule requête de support produit comme trace - quand on instrumente correctement :
[ROOT] invoke_agent support-request
├── [LLM] chat gpt-5.4-nano (décision de routing)
│   ├── gen_ai.usage.input_tokens: 674
│   ├── gen_ai.response.finish_reasons: ["tool-calls"]
│   └── gen_ai.response.model: gpt-5.4-nano
├── [TOOL] execute_tool lookup_order
├── [TOOL] execute_tool verify_customer
├── [EVENT] approval.requested (pause HITL)
│   └── wait_duration_ms, risk_level, tool_arguments
├── [EVENT] approval.granted (reprise HITL)
│   └── approver_id, approval_id, justification
├── [TOOL] execute_tool refund_order (post-approval)
└── [LLM] chat gpt-5.4-nano (réponse finale)
    ├── gen_ai.usage.input_tokens: 4083
    ├── gen_ai.response.finish_reasons: ["stop"]
    └── gen_ai.response.model: gpt-5.4-nano
Une trace, sept child spans. Chacun répond à une question différente.
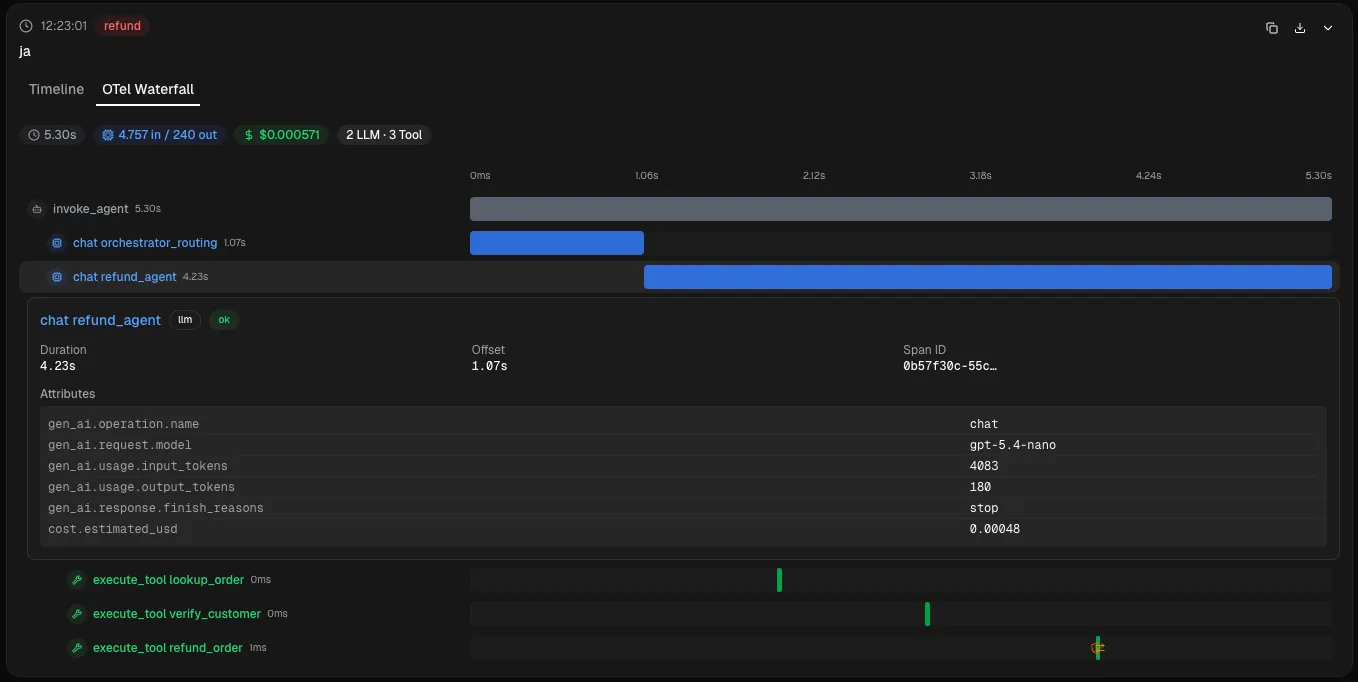
Regardons de plus près.
Trois types de spans, trois perspectives
Les appels LLM (chat) sont les interactions avec le modèle. Chaque span porte le nombre de tokens (gen_ai.usage.input_tokens, gen_ai.usage.output_tokens), le modèle réellement utilisé (gen_ai.response.model - pas toujours identique à celui demandé) et la finish reason. Trois appels LLM dans une requête ? Ça fait trois postes de coût (question 2), trois contributions à la latence (question 3), trois sources d’erreur potentielles.
Les exécutions d’outils (execute_tool) enregistrent chaque appel d’outil avec ses arguments et son résultat. verify_customer a pris 40 ms et renvoyé valid: true ? C’est dans le span. refund_order a échoué sur un timeout ? C’est aussi dans le span - et j’ai ma réponse à la question 1 : pourquoi l’agent a-t-il confirmé au client quelque chose qui ne s’est jamais produit ?
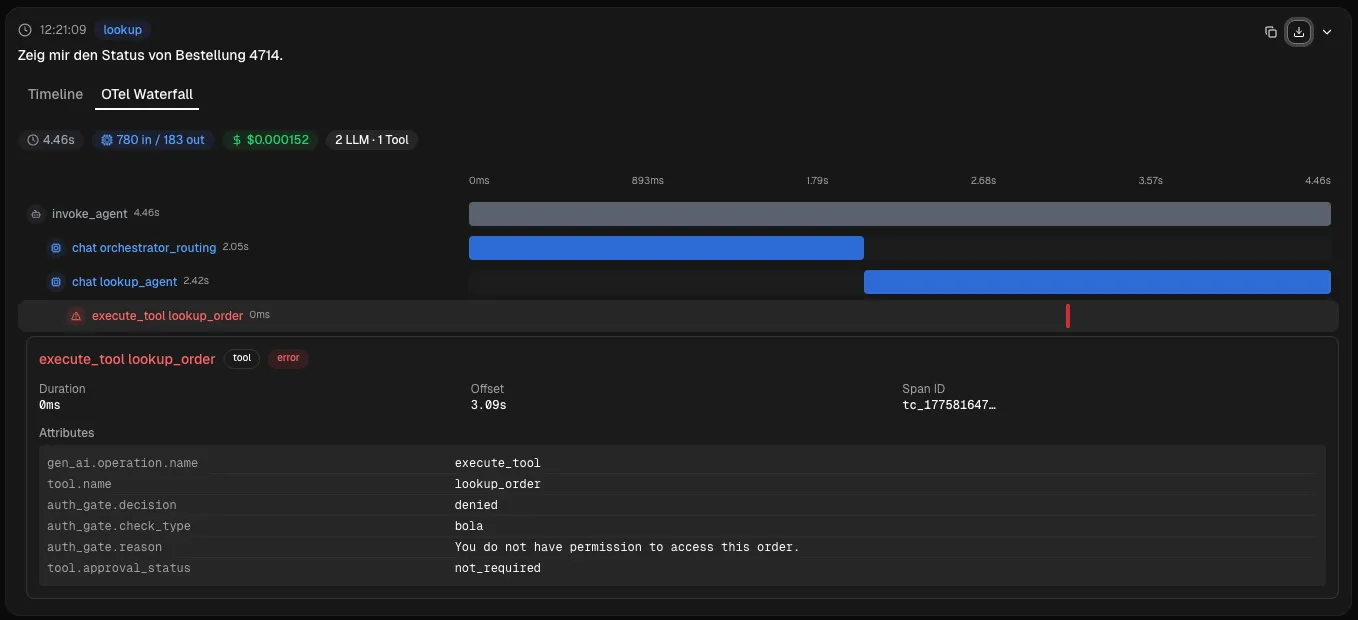
L’orchestration de l’agent (invoke_agent) est le root span - c’est lui qui tient l’ensemble. Durée totale, coût total, statut final. Si je veux savoir si le refund-agent ralentit, je regarde ici. Si je veux savoir pourquoi, je regarde dans les child spans.
Context Propagation : qui a déclenché quoi ?
Une trace sans contexte, c’est un point de données sans repère - techniquement correct, inutile en pratique. Lors d’un incident, la question décisive n’est jamais « Qu’a fait l’agent ? », mais « Qu’a fait l’agent pour quel client, dans quel ticket ? »
Le Baggage OpenTelemetry et les attributs du root span règlent ça : session.id, user.id, ticket.id voyagent comme Baggage à travers toute la trace. Chaque span hérite du contexte. Si le refund-agent a remboursé un mauvais montant à 14 h 32, je retrouve la trace complète en quelques secondes via le ticket.id - pas par de l’archéologie dans les fichiers de log.
Les événements d’approbation dans la trace
L’article sur le HITL portait sur l’architecture des approval gates. Ici, il s’agit de leur visibilité.

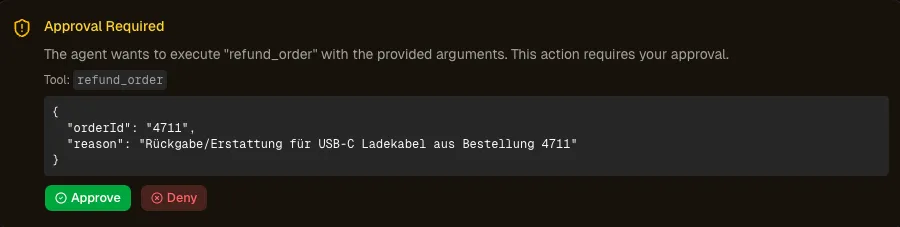
En avril 2026, il n’existe pas de convention OTel standardisée pour les événements d’approbation. Autrement dit : des custom events. approval.requested et approval.granted comme span events sur le root span, avec des attributs comme wait_duration_ms, risk_level, approver_id et approval_id.
Pourquoi c’est important ? Deux métriques en découlent directement : la latence d’approbation (combien de temps le workflow attend-il un humain ?) et le taux d’approbation (à quelle fréquence approuve-t-on vs. refuse-t-on ?). Un taux de refus en hausse est un signal. Soit l’agent propose des actions de plus en plus douteuses - soit les critères d’approbation sont trop stricts. Dans les deux cas, je veux le savoir.
Ce qui n’a PAS sa place dans la trace
Les workloads d’IA produisent 10 à 50 fois plus de télémétrie que des services classiques. Chaque appel LLM a un prompt, une completion, souvent plusieurs tool calls avec leurs résultats. La tentation de tout logger est grande.
Les métadonnées et les références sont la règle par défaut. Nombre de tokens, version du modèle, finish reason, nom de l’outil, durée - oui. Texte complet du prompt, clés API, feedback client brut - non. Pas parce que ce serait techniquement impossible, mais parce qu’en temps normal, c’est inutile.
Architecture break-glass : quand vous avez quand même besoin du contenu complet
Parfois, les métadonnées ne suffisent pas. Un incident d’hallucination, un dossier client escaladé - là, j’ai besoin du prompt réel et de la completion. La solution n’est pas un choix binaire, mais une architecture à deux voies :
Production Lane : events minimisés, uniquement métadonnées et références. Rétention longue, risque faible. C’est l’état normal.
Break-Glass Lane : contenu complet, activé par un approbateur nommément désigné avec une justification documentée. Rétention courte (24 à 72 h), suppression automatique, audit trail complet. Chaque accès est traçable.
Le pattern n’est pas nouveau - c’est le même principe que pour l’accès aux bases de données de production ou l’escrow de clés de chiffrement. La différence : avec les workloads d’IA, le volume de données par requête est si élevé que la voie par défaut doit être vraiment minimale pour que la voie break-glass reste gérable.
Ce qu’OpenTelemetry fournit - et ce qu’il ne fournit pas
Quiconque s’intéresse à l’observability des fonctionnalités d’IA tombe sur les OpenTelemetry GenAI Semantic Conventions. La spec existe, elle grandit, elle a le vent en poupe. Mais elle a aussi un problème : en avril 2026, pas un seul attribut n’est Stable. Tout porte le statut « Development ». Utiliser les conventions aujourd’hui, c’est devoir définir OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental - et donc accepter que des attributs puissent être renommés à tout moment.
Ça ne veut pas dire que la spec est inutile. Ça veut dire que nous devons savoir ce qu’elle sait faire - et surtout ce qu’elle ne sait pas faire. (Petite précision de vocabulaire : la spec utilise le statut « Development », mais la variable d’opt-in s’appelle experimental - un vestige historique. C’est la même chose.)
Ce que la spec couvre
Les conventions définissent des types de spans pour les opérations les plus importantes : chat, text_completion, embeddings, execute_tool, invoke_agent, invoke_workflow. S’y ajoutent des attributs de base comme gen_ai.provider.name, gen_ai.request.model, le nombre de tokens et les finish reasons. Côté métriques, il y a gen_ai.client.token.usage sous forme d’histogramme, gen_ai.client.operation.duration et des métriques de streaming comme gen_ai.server.time_to_first_token.
Parmi les ajouts plus récents : les conventions MCP (mcp.method.name, mcp.session.id), les spans d’agent (invoke_agent, invoke_workflow) et un event gen_ai.evaluation.result avec score et label. La direction est la bonne.
Ce que la spec ne couvre pas
Les manques concernent justement les choses qui font la différence en exploitation :
- Suivi des coûts : pas d’attribut
gen_ai.cost. Les API des fournisseurs renvoient le nombre de tokens, mais pas les prix. Des plateformes comme Langfuse ou Helicone règlent ça avec des tables de prix maintenues - mais au niveau de la spec, le calcul des coûts reste un chantier à part. - Versioning des prompts : aucun concept de registre de prompts. Quelle version du system prompt du refund-agent a conduit à quel résultat - pas couvert.
- Feedback utilisateur : pas d’event standardisé pouce en haut / pouce en bas. Le lien entre trace et évaluation par l’utilisateur n’existe pas dans la spec.
- Approbation et HITL : pas de convention pour les events de pause/reprise. Quand un humain est intervenu, et pourquoi - invisible.
- Guardrails : pas d’event pour le filtrage de contenu ou les safety checks. Savoir si une sortie a été filtrée - pas prévu.
La spec fournit le squelette : modèle, fournisseur, tokens, latence. Tout ce qui fait passer des fonctionnalités d’IA du gadget au système de production - coûts, versions, feedback, gouvernance - se trouve en dehors des conventions.
Attributs dépréciés - ce qui a déjà changé
Ceux qui ont démarré tôt avec les conventions doivent migrer : gen_ai.system s’appelle désormais gen_ai.provider.name, gen_ai.usage.prompt_tokens est devenu gen_ai.usage.input_tokens, gen_ai.usage.completion_tokens est devenu gen_ai.usage.output_tokens. Un avant-goût de ce que signifie le statut « Development » en pratique.

Les OTel GenAI Conventions sont un bon point de départ - mais qui compte sur la spec pour couvrir toutes les exigences d’observability aura des surprises en production.
Les six erreurs les plus fréquentes en observability des LLM
L’observability des fonctionnalités d’IA est encore jeune. Mais quelques pièges reviennent déjà sans cesse dans les post-mortems et les blogs d’ingénierie. Six anti-patterns :
1. Tout logger, ne rien corréler
Les application logs, ce n’est pas ce qui manque. Quelque part, il est écrit qu’un appel LLM a eu lieu. Ailleurs, qu’un outil a été appelé. Mais à quel dossier client ça appartient ? Quelle étape de l’agent a déclenché l’appel ?
Sans trace IDs pour faire le lien, les logs ne sont que du bruit horodaté. Quand le refund-agent confirme un remboursement qui n’est jamais arrivé, je ne veux pas chercher dans trois flux de logs différents - je veux une trace qui me montre tout le déroulement.
2. Logger intégralement les prompts en production
Comme décrit dans le chapitre sur les traces : les content events doivent être en opt-in, pas en opt-out. Pourtant, on logge souvent tout - par peur de rater quelque chose lors d’un incident. Résultat : des coûts de stockage qui explosent et des données personnelles dans le backend d’observability. La meilleure question n’est pas « De quoi pourrions-nous avoir besoin ? », mais « Quelles métadonnées suffisent pour 95 % des cas - et comment obtenir le reste quand nous en avons besoin ? » L’architecture break-glass esquissée plus haut résout exactement ça.
3. Des comptes de tokens sans attribution des coûts
« Nous consommons 2 millions de tokens par jour. » - « Pour quoi faire ? » - Silence.
Un compte global de tokens, c’est un chiffre sur un dashboard. Rien de plus. Sans tagging de métadonnées sur chaque requête API - user_id, feature_name, agent_name -, impossible de dire quelle fonctionnalité fait grimper les coûts. Le refund-agent ? Le résumé ? Le routing ? Optimiser les coûts sans attribution, c’est deviner.
4. N’instrumenter que le happy path
C’est l’erreur la plus dangereuse. Erreurs d’outils, retries, chaînes interrompues - tout est invisible. Le taux d’erreur a l’air bon, parce que seules les exécutions réussies sont comptées.
Faites le calcul : 10 étapes d’agent avec 99 % de précision chacune donnent 90 % de précision globale. Et chaque retry invisible multiplie les coûts et la latence sans que personne ne s’en aperçoive. Les error spans, le nombre de retries et le suivi des finish reasons ont leur place à chaque étape - pas seulement à la dernière.
Ce que vous ne mesurez pas, vous ne l’optimisez pas. Ce que vous ne voyez pas, vous l’ignorez - jusqu’à ce que ça devienne un incident.
5. L’observability après coup
« On fait d’abord les fonctionnalités, l’observability après. » Ça sonne pragmatique. En pratique, ça veut dire : au premier incident, vous n’avez aucune donnée. Pas de trace, pas de span, pas d’information de version. Juste des suppositions.
L’observability est une décision d’architecture, pas une tâche ops pour le sprint 12. Le trace context, la structure des spans et le schéma de métadonnées doivent être en place avant que la première fonctionnalité passe en production. Instrumenter après coup, c’est casser après coup toutes les abstractions.
Michael Seel va un cran plus loin dans « AI Systems Architecture: Governance » : l’observability n’a pas sa place seulement dans le backlog de l’équipe, mais dans la plateforme - sinon on voit apparaître du Shadow AI, comme il existe du Shadow IT.

6. Le culte du cargo des dashboards
Graphique de latence. Courbe du nombre de tokens. Jauge du taux d’erreur. Trois dashboards, douze panneaux, zéro enseignement. Personne ne les regarde jusqu’à ce qu’un incident arrive - et là, ils n’aident pas, parce qu’ils répondent aux mauvaises questions.
Un dashboard qui affiche « requêtes par minute » ne répond à aucune question d’exploitation. Quel est le taux d’hallucination ? Quel chemin d’agent coûte le plus cher ? Y a-t-il de la dérive de prompt ? Les dashboards doivent permettre de prendre des décisions, pas décorer des métriques.
Modèle de maturité : de Blind à Diagnostic
Il n’existe pas de « LLM Observability Maturity Model » officiel - pas de norme ISO, pas de PDF de Magic Quadrant Gartner. Mais quand je regarde comment Honeycomb, LangChain et Portkey décrivent le sujet, une progression claire se dessine. Je l’ai condensée en cinq niveaux - pas comme un framework académique, mais comme une grille d’évaluation pour une seule question : où en sommes-nous, et quelle est la prochaine étape raisonnable ?
| Niveau | Nom | Caractéristiques | Lesquelles des cinq questions trouvent une réponse |
|---|---|---|---|
| 0 | Blind | Pas de traces, uniquement des application logs | Aucune. Chaque incident est de la spéculation. |
| 1 | Basic | Logging requête/réponse, nombre de tokens | Question 2 (coûts) en partie - mais sans réponse sur le où et le pourquoi. |
| 2 | Structured | Traces OTel avec conventions GenAI, spans d’outils | Questions 1 (débogage), 3 (latence), 4 (qualité). |
| 3 | Operational | Dashboards, alertes sur coûts/latence/taux d’erreur | Questions 1 à 4 de façon proactive. Contrôle des coûts. SLOs. |
| 4 | Diagnostic | Pipeline trace-vers-eval, détection de dérive | Les cinq questions - plus une boucle de feedback vers les evals. |
La plupart des équipes se situent entre le niveau 0 et le niveau 1. Le niveau 2 est la prochaine étape raisonnable.
Ce n’est pas une supposition. Vous avez console.log("LLM response:", result) en production ? Niveau 1. Même pas ça ? Niveau 0. Dans les deux cas, ça veut dire : quand quelque chose tourne mal, on devine au lieu de diagnostiquer.
Le niveau 2 - des traces structurées avec OpenTelemetry et les GenAI Semantic Conventions - est le point à partir duquel le débogage cesse d’être un jeu de devinettes. Ici, chaque requête devient traçable : quel prompt est entré, quel modèle a répondu, quels outils ont été appelés, combien de temps chaque étape a duré. C’est atteignable avec un effort raisonnable - et ça paie dès le premier incident.
Le niveau 3 demande plus que de l’outillage - il demande de la maturité organisationnelle. Tout le monde sait construire des dashboards. Mais définir des alertes pertinentes, formuler des SLOs pour des fonctionnalités d’IA, faire respecter des budgets de coût par fonctionnalité - ce sont des décisions qu’une équipe doit prendre ensemble.
Le niveau 4, c’est là où l’observability et les evals se rejoignent. Les traces de production repartent dans le pipeline d’eval. Un incident n’est pas seulement corrigé, il est ancré sous forme de test de régression. Dans l’article sur les evals, j’ai écrit que les evals sans retours de production vieillissent - le niveau 4 comble exactement ce manque.

Choix de l’outillage : quel setup convient ?
« Quel outil d’observability devrais-je prendre ? » - Ça dépend. Mais pas des fonctionnalités - de la question de savoir quelles couches je dois couvrir.
Le modèle à deux couches
L’observability des fonctionnalités d’IA se décompose en deux problématiques fondamentalement différentes :
Layer 1 : observability de l’infrastructure. Le système est-il en bonne santé ? Quelle est la latence ? Où les requêtes échouent-elles ? C’est le domaine d’OpenTelemetry - distributed tracing, métriques, logs. Les GenAI Semantic Conventions étendent OTel avec des attributs spécifiques aux LLM comme gen_ai.usage.input_tokens ou gen_ai.request.model. Si vous avez déjà un setup OTel, la vue infrastructure sur les appels d’IA vous est presque offerte.
Layer 2 : observability au niveau du prompt. L’IA produit-elle de bonnes sorties ? Quelle version de prompt fonctionne le mieux ? Où le modèle hallucine-t-il ? OTel seul ne répond pas à ces questions - pour ça, il me faut une plateforme LLM dédiée avec playground de prompts, pipelines d’eval et suivi des sessions.
Les deux couches répondent à des questions différentes. Faire tenir les deux dans un seul outil, c’est un compromis dans les deux sens.
Trois scénarios
Une équipe avec OTel dans sa stack ? Alors les GenAI Semantic Conventions complètent la vue infrastructure, et Langfuse (ou une plateforme comparable) vient se poser par-dessus pour l’observability au niveau du prompt.
Un projet d’IA greenfield ? Pour les startups : Langfuse Cloud, point. On ne peut pas démarrer plus vite. Pour les grandes organisations : prévoir OTel dès le premier jour - l’ajouter après coup coûte plus cher à chaque service. Plus une plateforme LLM pour la deuxième couche.
Des exigences de conformité ? Alors le self-hosting compte. Langfuse est entièrement self-hostable et c’est l’option la plus claire. LangSmith et Braintrust proposent le self-hosting dans leur offre Enterprise, mais avec un effort d’infrastructure plus élevé et un contrôle limité. Helicone est open source et lui aussi self-hostable. Si vos données ne peuvent pas sortir de chez vous, vous avez des options - mais la barrière d’entrée varie considérablement.
Ou alors : le construire soi-même ?
Objection légitime : avec l’aide de l’IA, on peut quand même bricoler une telle stack d’observability en quelques soirées. C’est vrai - pour le Layer 1. SDK OTel, Grafana Tempo ou Jaeger comme backend, dashboards Grafana, quelques attributs de span maison pour gen_ai.*. Une table de coûts en JSON, les versions de prompt sous forme de hash dans le span. Ce n’est pas sorcier, et je suis bien le dernier à le déconseiller - au contraire.
Le Layer 2 est la partie la plus dure. Registre de prompts avec vue diff entre les versions, pipelines d’eval avec LLM-as-Judge, threading des sessions sur de longues conversations, capture du feedback avec une UI pour le Product et la QA. Ce n’est pas « quelques soirées » - c’est une plateforme à part entière.
La variante pragmatique : construire le Layer 1 soi-même, brancher une plateforme pour le Layer 2. Langfuse se connecte via un bridge OTel à une stack Layer 1 faite maison - le meilleur des deux mondes.
En bref : Langfuse, Arize Phoenix, LangSmith, Helicone, Braintrust
Langfuse - Le package open source le plus complet. Self-hostable, bridge OTel pour la connexion à l’infrastructure, gestion des prompts, pipelines d’eval. La communauté grandit vite et la plateforme couvre de plus en plus les deux couches. Pour la plupart des équipes, le point d’entrée le plus sûr.
Arize Phoenix - Le meilleur de sa catégorie pour le débogage RAG et l’analyse d’embeddings. Local-first, idéal en phase de développement. Si vous travaillez beaucoup avec du retrieval et voulez comprendre la pertinence des chunks, c’est ici que vous trouverez les meilleurs outils.
LangSmith - Le choix naturel pour les équipes qui travaillent déjà dans l’écosystème LangChain. Intégration profonde, bonne Developer Experience. Le self-hosting est disponible en add-on Enterprise, mais exige une infrastructure conséquente (16+ vCPU, 64+ Go de RAM). Si vous n’êtes pas lié à LangChain, vous avez peu de raisons de commencer ici.
Helicone - Open source (licence MIT) et self-hostable. En version cloud, le démarrage le plus rapide qui soit : changer l’URL du proxy, terminé. Bien pour un premier aperçu des coûts et de la latence. La version self-hosted contourne le problème de conformité de l’approche proxy.
Braintrust - Le framework d’eval le plus solide du comparatif. Pour faire des évaluations systématiques un processus central, c’est ici que vous trouverez les outils les plus aboutis. Self-hosting dans l’offre Enterprise sous forme de modèle hybride : data plane dans votre propre compte, control plane chez Braintrust.
Comment tout s’imbrique
Cet article n’est pas une pièce isolée. C’est la conséquence logique de tout ce que j’ai écrit ces dernières semaines - et il rend opérationnels les concepts des articles précédents :
- Contracts comme fondation - validation de schéma contre la sortie du modèle. Dans le monde de l’observability, cette validation devient un attribut de span : le schéma a-t-il collé ? Quand, où et combien de fois n’a-t-il pas collé ?
- Les evals ne vivent pas que dans la CI. Les traces de production deviennent des jeux de données d’eval - le fil resté ouvert, « les evals sans retours de production vieillissent », trouve ici sa réponse.
- La sécurité des outils devient tangible grâce aux spans d’outils. Un False Success - l’outil signale un succès, mais rien ne s’est passé - ne devient visible que quand le span d’outil porte la réponse réelle du backend sous forme d’event.
- Le Human-in-the-Loop laisse des événements d’approbation dans la trace. Et la détection du rubber-stamping, que j’y avais décrite comme design pattern ? Elle devient une métrique : durée moyenne de revue, taux de refus, approbation sans changement de contexte.
Et pour ceux qui pensent que l’observability est optionnelle
Le règlement européen sur l’IA (AI Act) la rend obligatoire.

L’art. 12 exige un « automatic recording of events » pour les systèmes à haut risque - et ne parle pas de console.log. L’art. 12 exige qu’un déployeur comprenne ce que le système a fait. L’art. 14 impose une supervision humaine capable de « comprendre correctement les capacités et les limites du système » - sans traces, c’est une exigence creuse. L’art. 19 prescrit une durée de conservation d’au moins six mois. Et l’art. 72 exige une surveillance après commercialisation - c’est-à-dire précisément l’analyse systématique des données de production que décrit cet article.
AI Act européen - les articles pertinents
- Art. 12 - Tenue de registres : les systèmes à haut risque doivent enregistrer automatiquement les événements (logs), afin d’assurer la traçabilité sur toute leur durée de vie.
- Art. 14 - Contrôle humain : les personnes chargées de la supervision doivent pouvoir interpréter les capacités et les limites du système. Cela suppose un accès aux traces et aux métriques.
- Art. 19 - Obligation de conservation : les logs doivent être conservés au moins 6 mois.
- Art. 72 - Surveillance après commercialisation : les fournisseurs doivent collecter et analyser systématiquement les données de production.
L’échéance pour les obligations relatives au haut risque est août 2026. Ces articles forment une chaîne réglementaire qui exige exactement l’infrastructure d’observability décrite dans cet article. Si vous la construisez de toute façon, vous avez la base technique pour la conformité. Sinon, vous aurez bientôt un problème.
Perspective : des traces aux tests de régression
La prochaine étape logique, c’est le pipeline trace-vers-eval. Un incident en production - un montant halluciné, un False Success, un edge case passé inaperçu - devient une trace. La trace devient un jeu de données d’eval. Le jeu de données d’eval devient un test de régression permanent dans la CI. Aucun incident ne doit se produire deux fois de la même façon.
L’observability n’est pas un sujet ops. Sans elle, les Contracts, les evals et la supervision humaine restent des concepts que je ne vois pas quand ils cassent.