
Ohne Traces, Modell- und Promptversionen, Tool-Spans und Kostenmetriken bleibt jeder Incident Kaffeesatzleserei.
Vier Posts lang hab ich über Prinzipien geschrieben: Contracts, Evals, Tool-Sicherheit, Human Oversight. Stimmt ja alles - aber wie seh ich im Betrieb, ob dat alles wirklich funktioniert?
Ohne strukturierte Observability: gar nich. ’N False Success im Refund-Agent - dat Tool meldet Erfolg, der Kunde wartet auf seine Kohle - findest du mit Application Logs und Error Rates nich. Alles grün. Dat System hat nich versagt, et hat gelogen.
Dieser Post zeigt, welche Observability-Infrastruktur Teams brauchen, die AI-Features live laufen haben. Welche Fragen muss ich beantworten können? Wie sieht ’n guter Trace aus? Und wo stehe ich selbst gerade?

Fünf Fragen vorm Tooling
Wie hätt ich dat in 30 Sekunden debuggen können?
Nich mit grep in Logfiles. Nich mit ’nem Dashboard, dat mir Uptime und Error Rate zeigt - denn beides war grün. Kein Fehler, kein Alert, bloß ’n falsches Ergebnis.
Klassische Metriken fangen AI-spezifische Fehler nich ab. False Success, falsche Tool-Auswahl oder halluzinierte Aktionen bleiben unsichtbar, solange ich nur auf HTTP-Statuscodes und Exception-Counts gucke. Dat Problem sitzt tiefer - inne Entscheidungslogik vom Agent und inne Interpretation der Tool-Antworten. Zwischen Turns geht Kontext flöten, ohne dat irgendein Logfile ’nen Mucks macht.
Bevor ich über Tooling rede: fünf Fragen, die jedes Team beantworten können sollte.
1. Debugging: Warum hat der Agent dem Kunden X gesacht, obwohl Y passiert is?
Der Refund-Agent sacht “Erstattung is raus”. Aber refund_order hat ’nen Fehler zurückgegeben - oder wurde gar nich erst aufgerufen. Ohne korrelierten Trace mit Tool-Call-Ergebnissen, Modell-Inputs und Modell-Outputs is dat Rätselraten. Ich brauch ’ne Kette: Nutzereingabe, Routing-Entscheidung, Tool-Intent, Tool-Result, generierte Antwort. Lückenlos.
2. Kosten: Wat kostet ’n durchschnittlicher Supportfall - und welcher Agent-Pfad frisst die meisten Tokens?
Nich jeder Supportfall is gleich teuer. ’N einfacher FAQ-Lookup kostet ’n paar hundert Tokens. ’N Refund-Flow mit Identitätsprüfung, Bestellabfrage und Approval-Schleife kann schnell dat Zwanzigfache verbraten. Ohne Token-Attribution pro Agent, Tool und Conversation seh ich nur ’ne monatliche Rechnung - aber nich, wo dat Geld hingeht.
3. Latenz: Wo hängt der Agent - am Modell-Call, am Tool-Call oder am Retrieval?
Der Nutzer wartet. Aber worauf? Auf dat Modell, dat 3 Sekunden für die Antwort braucht? Auf den lookup_order-Call, der gegen ’ne lahme Datenbank läuft? Oder auf ’n Retrieval-System, dat sich den Kontext zusammensucht? Span-basierte Latenz-Aufschlüsselung is kein Nice-to-have - dat is die einzige Möglichkeit, gezielt zu optimieren statt zu raten.
4. Qualität: Wie oft nimmt der Agent dat falsche Tool? Wie oft braucht er mehrere Anläufe?
Der Agent hat vier Tools zur Auswahl. Wie oft greift er zum richtigen? Wie oft ruft er lookup_order auf, obwohl er verify_customer hätte aufrufen müssen - und korrigiert sich erst im zweiten Anlauf? Tool-Selection-Tracking und Retry-Counts zeigen mir, wo dat Modell systematisch danebenliegt. Dat sind keine Edge Cases - dat sind Signale für Prompt-Probleme oder fehlende Tool-Descriptions.
5. Compliance: Kann ich den kompletten Entscheidungspfad für ’nen konkreten Kundenvorgang nachvollziehen?
Kunde ruft an, will wissen, warum die Erstattung nich angekommen is. Die Regulierung verlangt Nachvollziehbarkeit. Ich brauch ’nen Audit-Trail, der zeigt: Welcher Agent hat wann welches Tool aufgerufen, welche Approval-Events gab et, wer hat wat genehmigt? Ohne dat is jeder Kundenvorgang ’ne Black Box.
Fünf Fragen, fünf verschiedene Observability-Anforderungen. Und trotzdem passiert inne Praxis oft datselbe: Da wird ’n Tracing-Tool angeklemmt, ’n paar Spans werden geschrieben - und dann hofft jeder, dat die richtigen Daten schon dabei sein werden.
In den meisten Teams fehlt nich dat Tooling - et fehlt die Klarheit darüber, welche Betriebsfragen überhaupt beantwortet werden müssen.
Anatomie von ’nem Trace
Fünf Fragen. Kein Dashboard, dat se beantwortet. Ändern wir dat ma.
Nehmen wir den Refund-Agent und gucken uns an, wat ’n einzelner Support-Request als Trace produziert - wenn wir ordentlich instrumentieren:
[ROOT] invoke_agent support-request
├── [LLM] chat gpt-5.4-nano (Routing-Entscheidung)
│   ├── gen_ai.usage.input_tokens: 674
│   ├── gen_ai.response.finish_reasons: ["tool-calls"]
│   └── gen_ai.response.model: gpt-5.4-nano
├── [TOOL] execute_tool lookup_order
├── [TOOL] execute_tool verify_customer
├── [EVENT] approval.requested (HITL-Pause)
│   └── wait_duration_ms, risk_level, tool_arguments
├── [EVENT] approval.granted (HITL-Resume)
│   └── approver_id, approval_id, justification
├── [TOOL] execute_tool refund_order (post-approval)
└── [LLM] chat gpt-5.4-nano (finale Antwort)
    ├── gen_ai.usage.input_tokens: 4083
    ├── gen_ai.response.finish_reasons: ["stop"]
    └── gen_ai.response.model: gpt-5.4-nano
Ein Trace, sieben Child-Spans. Jeder beantwortet ’ne andere Frage.
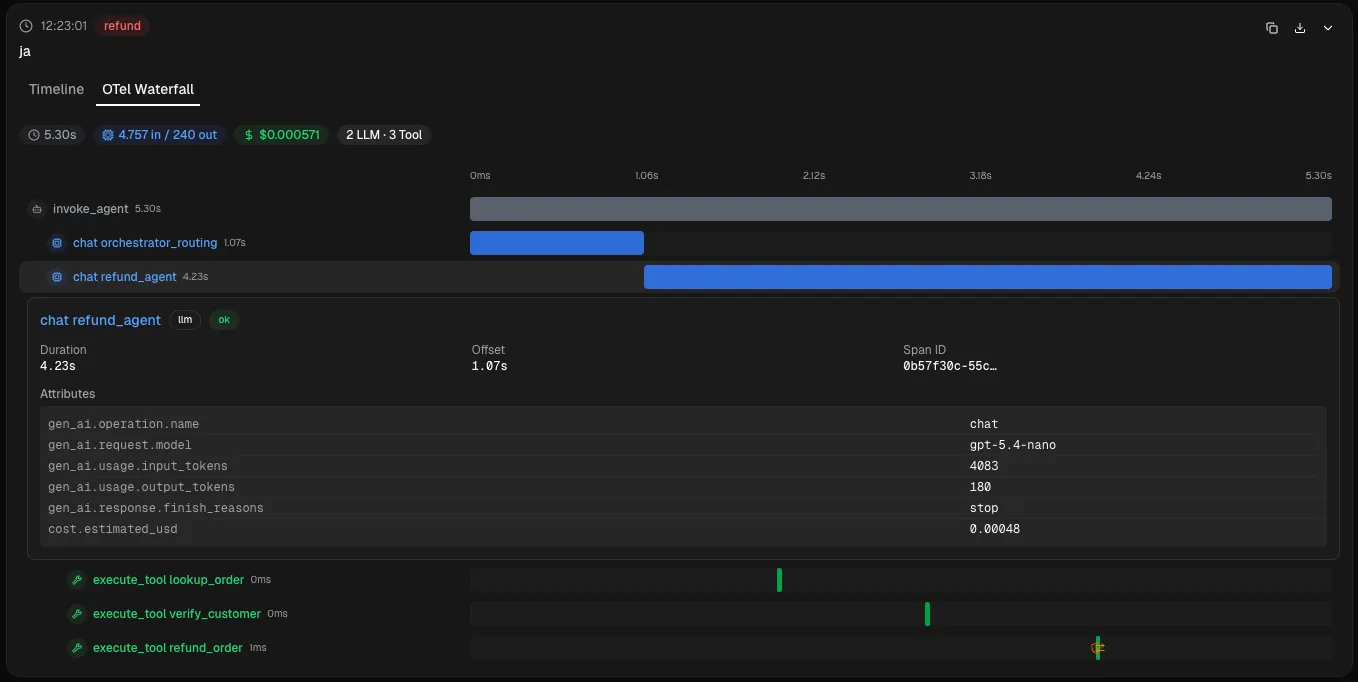
Gucken wir ma genauer hin.
Drei Span-Typen, drei Blickwinkel
LLM-Calls (chat) sind die Modell-Interaktionen. Jeder Span hat Token-Counts (gen_ai.usage.input_tokens, gen_ai.usage.output_tokens), dat Modell, dat wirklich benutzt wurde (gen_ai.response.model - nich immer datselbe wie dat angeforderte), und die Finish-Reason dabei. Drei LLM-Calls in einem Request? Dat sind drei Kostenpunkte (Frage 2), drei Latenz-Beiträge (Frage 3), drei mögliche Fehlerquellen.
Tool-Executions (execute_tool) halten jeden Werkzeug-Aufruf mit Argumenten und Ergebnis fest. verify_customer hat 40ms gebraucht und valid: true zurückgegeben? Steht im Span. refund_order is mit ’nem Timeout auffe Nase gefallen? Steht auch im Span - und damit hab ich die Antwort auf Frage 1: Warum hat der Agent dem Kunden wat bestätigt, dat nie passiert is?
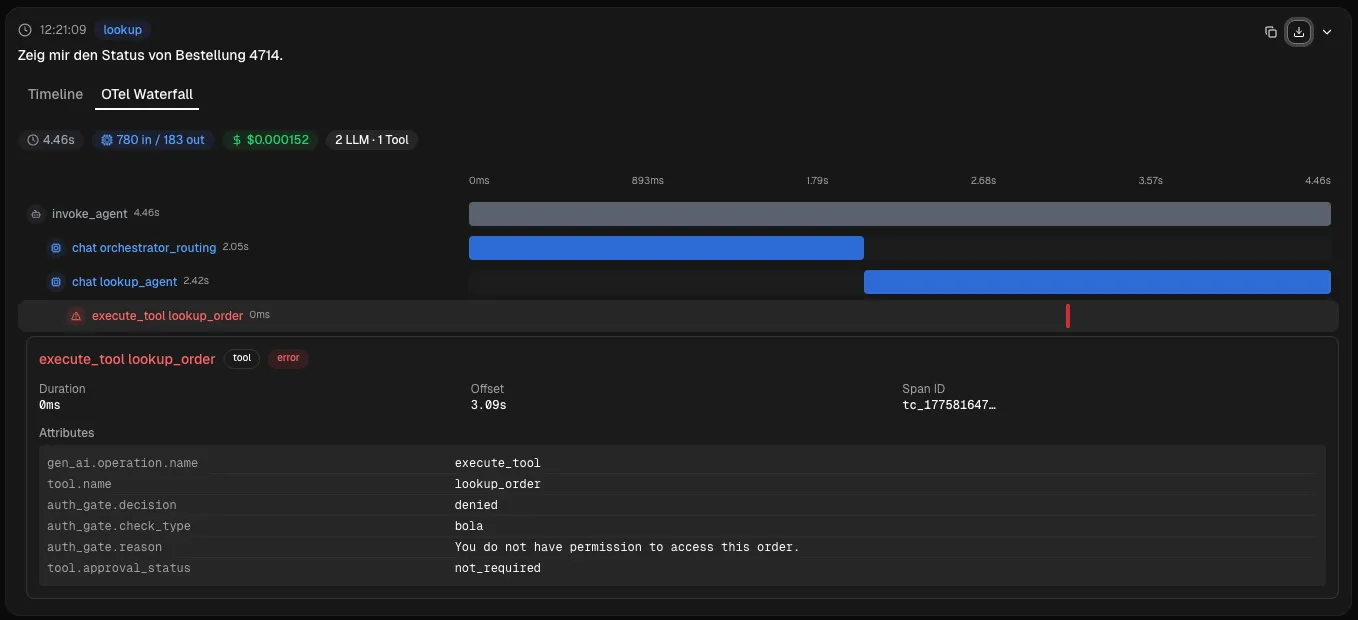
Agent-Orchestration (invoke_agent) is der Root-Span - der hält den ganzen Laden zusammen. Gesamtdauer, Gesamtkosten, finaler Status. Wenn ich wissen will, ob der Refund-Agent lahmer wird, guck ich hier. Wenn ich wissen will, warum, guck ich inne Child-Spans.
Context Propagation: Wer hat wat ausgelöst?
’N Trace ohne Kontext is ’n Datenpunkt ohne Koordinatensystem - technisch korrekt, praktisch für die Tonne. Die entscheidende Frage bei ’nem Incident is nie “Wat hat der Agent gemacht?”, sondern “Wat hat der Agent für welchen Kunden in welchem Ticket gemacht?”
OpenTelemetry Baggage und Root-Span-Attributes lösen dat: session.id, user.id, ticket.id wandern als Baggage durch den ganzen Trace. Jeder Span erbt den Kontext. Wenn der Refund-Agent um 14:32 ’nen falschen Betrag erstattet hat, find ich über die ticket.id in Sekunden den kompletten Trace - nich durch Logfile-Archäologie.
Approval-Events im Trace
Im HITL-Post ging et um die Architektur von Approval-Gates. Hier geht et darum, wie man die sieht.

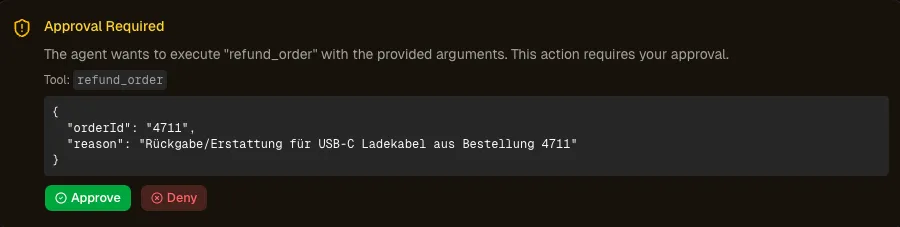
Stand April 2026 gibt et keine standardisierte OTel-Convention für Approval-Events. Heißt: Custom Events. approval.requested und approval.granted als Span-Events auf dem Root-Span, mit Attributen wie wait_duration_ms, risk_level, approver_id und approval_id.
Warum dat wichtig is? Zwei Metriken fallen direkt dabei ab: Approval-Latenz (wie lange wartet der Workflow auf ’nen Menschen?) und Approval-Rate (wie oft wird genehmigt vs. abgelehnt?). ’Ne steigende Ablehnungsrate is ’n Signal. Entweder der Agent schlägt immer häufiger fragwürdige Aktionen vor - oder die Approval-Kriterien sind zu streng. Beides will ich wissen.
Wat NICH in den Trace gehört
AI-Workloads produzieren 10-50x mehr Telemetrie als klassische Services. Jeder LLM-Call hat ’nen Prompt, ’ne Completion, oft mehrere Tool-Calls mit Ergebnissen. Die Versuchung, einfach alles zu loggen, is groß.
Metadata und Referenzen sind der Default. Token-Counts, Modellversion, Finish-Reason, Tool-Name, Dauer - ja. Kompletter Prompt-Text, API-Keys, rohes Kundenfeedback - nee. Nich weil et technisch nich ginge, sondern weil et im Normalfall unnötig is.
Break-Glass-Architektur: Wenn du doch den vollen Content brauchs
Manchmal reichen Metadata nich. ’N Halluzinations-Incident, ’n eskalierter Kundenfall - da brauch ich den echten Prompt und die Completion. Die Lösung is keine Entweder-oder-Entscheidung, sondern ’ne Zwei-Lanes-Architektur:
Production Lane: Minimierte Events, nur Metadata und Referenzen. Lange Retention, niedriges Risiko. Dat is der Normalzustand.
Break-Glass Lane: Voller Content, freigeschaltet von ’nem Named-Approver mit dokumentierter Begründung. Kurze Retention (24-72h), automatische Löschung, kompletter Audit-Trail. Jeder Zugriff is nachvollziehbar.
Dat Muster is nich neu - dat is datselbe Prinzip wie bei Production-Database-Access oder Encryption-Key-Escrow. Der Unterschied: Bei AI-Workloads is dat Datenvolumen pro Request so hoch, dat die Default-Lane wirklich minimal sein muss, damit die Break-Glass-Lane überhaupt noch handhabbar bleibt.
Wat OpenTelemetry liefert - und wat nich
Wer sich mit Observability für AI-Features beschäftigt, stolpert über die OpenTelemetry GenAI Semantic Conventions. Die Spec gibt et, die wächst, die hat Schwung. Aber se hat auch ’n Problem: Stand April 2026 is kein einziges Attribut Stable. Alles hat den Status “Development”. Wer die Conventions heute benutzt, muss OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental setzen - und damit in Kauf nehmen, dat Attribute jederzeit umbenannt werden können.
Dat heißt nich, dat die Spec nix taugt. Et heißt, dat wir wissen müssen, wat se kann - und vor allem, wat se nich kann. (Kurz zu den Begriffen: Die Spec benutzt den Status “Development”, aber die Opt-In-Variable heißt experimental - ’n historisches Überbleibsel. Gemeint is datselbe.)
Wat die Spec abdeckt
Die Conventions definieren Span-Typen für die wichtigsten Operationen: chat, text_completion, embeddings, execute_tool, invoke_agent, invoke_workflow. Dazu kommen Kern-Attributes wie gen_ai.provider.name, gen_ai.request.model, Token-Counts und Finish-Reasons. Auf der Metrics-Seite gibt et gen_ai.client.token.usage als Histogram, gen_ai.client.operation.duration und Streaming-Metriken wie gen_ai.server.time_to_first_token.
Neuere Ergänzungen sind MCP-Conventions (mcp.method.name, mcp.session.id), Agent-Spans (invoke_agent, invoke_workflow) und ’n gen_ai.evaluation.result-Event mit Score und Label. Die Richtung stimmt.
Wat die Spec nich abdeckt
Die Lücken betreffen genau die Sachen, die im Betrieb den Unterschied machen:
- Kosten-Tracking: Kein
gen_ai.cost-Attribut. Die Provider-APIs liefern Token-Counts, aber keine Preise. Plattformen wie Langfuse oder Helicone lösen dat über gepflegte Preistabellen - aber auf Spec-Ebene bleibt die Kostenberechnung ’ne eigene Baustelle. - Prompt-Versioning: Kein Konzept von Prompt-Registries. Welche Version vom System-Prompt vom Refund-Agent zu welchem Ergebnis geführt hat - nich abgedeckt.
- User Feedback: Kein standardisiertes Daumen-hoch/runter-Event. Die Verbindung zwischen Trace und Nutzerbewertung gibt et inne Spec nich.
- Approval und HITL: Keine Convention für Pause/Resume-Events. Wann ’n Mensch eingegriffen hat und warum - unsichtbar.
- Guardrails: Kein Event für Content-Filtering oder Safety-Checks. Ob ’n Output gefiltert wurde - nich vorgesehen.
Die Spec liefert dat Gerippe: Modell, Provider, Tokens, Latenz. Alles, wat AI-Features von der Spielerei zum Produktionssystem macht - Kosten, Versionen, Feedback, Governance - liegt außerhalb der Conventions.
Deprecated Attributes - wat sich schon geändert hat
Wer früh mit den Conventions angefangen hat, muss migrieren: gen_ai.system heißt getz gen_ai.provider.name, gen_ai.usage.prompt_tokens wurde zu gen_ai.usage.input_tokens, gen_ai.usage.completion_tokens zu gen_ai.usage.output_tokens. ’N Vorgeschmack darauf, wat “Development”-Status inne Praxis heißt.

Die OTel GenAI Conventions sind ’n guter Startpunkt - aber wer sich drauf verlässt, dat die Spec alle Observability-Anforderungen abdeckt, erlebt in Produktion sein blaues Wunder.
Die sechs häufigsten Fehler bei LLM-Observability
Observability für AI-Features is noch jung. Aber ’n paar Fallen tauchen in Post-Mortems und Engineering-Blogs getz schon immer wieder auf. Sechs Anti-Patterns:
1. Alles loggen, nix korrelieren
Application Logs gibt et. Jede Menge davon. Irgendwo steht, dat ’n LLM-Call passiert is. Irgendwo anders steht, dat ’n Tool aufgerufen wurde. Aber zu welchem Kundenvorgang gehört dat? Welcher Agent-Step hat den Call ausgelöst?
Ohne Trace-IDs als Klammer sind Logs nur Rauschen mit Zeitstempel. Wenn der Refund-Agent ’ne Rückerstattung bestätigt, die nie ankam, will ich nich in drei verschiedenen Log-Streams rumwühlen - ich will einen Trace, der mir den ganzen Vorgang zeigt.
2. Prompts in Produktion komplett loggen
Wie im Trace-Kapitel beschrieben: Content-Events gehören auf Opt-In, nich Opt-Out. Trotzdem wird oft alles geloggt - aus Angst, im Incident wat zu verpassen. Dat Ergebnis: explodierende Speicherkosten und PII im Observability-Backend. Die bessere Frage is nich “Wat könnten wir brauchen?”, sondern “Welche Metadata reichen für 95% der Fälle - und wie kommen wir anne Rest, wenn wir den brauchen?” Die Break-Glass-Architektur von oben löst genau dat.
3. Token-Counts ohne Kostenzuordnung
“Wir verbrauchen 2 Millionen Tokens am Tag.” - “Wofür?” - Funkstille.
Globale Token-Counts sind ’ne Zahl auf ’nem Dashboard. Mehr nich. Ohne Metadata-Tagging an jedem API-Request - user_id, feature_name, agent_name - kannze nich beantworten, welches Feature die Kosten hochtreibt. Isset der Refund-Agent? Die Zusammenfassung? Dat Routing? Kostenoptimierung ohne Attribution is Raten.
4. Nur den Happy Path instrumentieren
Dat is der gefährlichste Fehler. Tool-Fehler, Retries, abgebrochene Chains - alles unsichtbar. Die Error Rate sieht gut aus, weil nur erfolgreiche Abschlüsse gezählt werden.
Rechne nach: 10 Agent-Steps mit je 99% Accuracy landen bei 90% Gesamtaccuracy. Und jeder unsichtbare Retry multipliziert Kosten und Latenz, ohne dat et einer merkt. Error-Spans, Retry-Counts und Finish-Reason-Tracking gehören an jeden Step - nich nur an den letzten.
Wat du nich misst, optimierst du nich. Wat du nich siehst, ignorierst du - bis ’n Incident draus wird.
5. Observability als Nachgedanke
“Wir machen erst die Features, dann die Observability.” Klingt pragmatisch. Inne Praxis heißt dat: Beim ersten Incident hasse keine Daten. Kein Trace, kein Span, keine Versionsinfo. Nur Vermutungen.
Observability is ’ne Architekturentscheidung, keine Ops-Aufgabe für Sprint 12. Trace-Context, Span-Struktur und Metadata-Schema müssen stehen, bevor dat erste Feature live geht. Hinterher instrumentieren heißt hinterher alle Abstraktionen wieder aufstemmen. Wie Kabel verlegen, nachdem die Bude schon tapeziert is.
Michael Seel geht in “AI Systems Architecture: Governance” den nächsten Schritt: Observability gehört nich nur ins Team-Backlog, sondern inne Plattform - sonst entsteht Shadow AI, so wie früher Shadow IT.

6. Dashboard-Cargo-Cult
Latenz-Chart. Token-Count-Graph. Error-Rate-Gauge. Drei Dashboards, zwölf Panels, null Erkenntnisse. Keiner guckt drauf, bis ’n Incident passiert - und dann helfen se nich, weil se die falschen Fragen beantworten.
’N Dashboard, dat “Requests pro Minute” zeigt, beantwortet keine einzige Betriebsfrage. Wie hoch is die Halluzinationsrate? Welcher Agent-Pfad kostet am meisten? Gibt et Prompt-Drift? Dashboards müssen Entscheidungen möglich machen, nich Metriken dekorieren.
Reifegradmodell: Von Blind bis Diagnostic
Et gibt kein offizielles “LLM Observability Maturity Model” - keinen ISO-Standard, kein Gartner-Quadranten-PDF. Aber wenn ich mir anguck, wie Honeycomb, LangChain und Portkey dat Thema beschreiben, zeichnet sich ’ne klare Entwicklung ab. Ich hab se auf fünf Stufen eingedampft - nich als akademisches Framework, sondern als Bewertungsraster für die eine Frage: Wo stehen wir, und wat is der nächste sinnvolle Schritt?
| Stufe | Name | Kennzeichen | Welche der fünf Fragen beantwortet werden |
|---|---|---|---|
| 0 | Blind | Keine Traces, nur Application Logs | Keine. Jeder Incident is Kaffeesatzleserei. |
| 1 | Basic | Request/Response-Logging, Token-Counts | Frage 2 (Kosten) teilweise - aber ohne Antwort auf dat Wo und Warum. |
| 2 | Structured | OTel-Traces mit GenAI-Conventions, Tool-Spans | Fragen 1 (Debugging), 3 (Latenz), 4 (Qualität). |
| 3 | Operational | Dashboards, Alerts auf Kosten/Latenz/Fehlerrate | Fragen 1-4 proaktiv. Kostencontrolling. SLOs. |
| 4 | Diagnostic | Trace-zu-Eval-Pipeline, Drift-Erkennung | Alle fünf Fragen - plus Feedback-Loop inne Evals. |
Die meisten Teams hängen zwischen Stufe 0 und 1. Stufe 2 is der sinnvolle nächste Schritt.
Dat is keine Vermutung. Wer heute console.log("LLM response:", result) in Produktion hat, is auf Stufe 1. Wer nich ma dat hat - Stufe 0. Beides heißt: Wenn wat schiefgeht, wird geraten statt diagnostiziert.
Stufe 2 - Structured Traces mit OpenTelemetry und den GenAI Semantic Conventions - is der Punkt, ab dem Debugging aufhört, ’n Ratespiel zu sein. Hier werden einzelne Requests nachvollziehbar: Welcher Prompt ging rein, welches Modell hat geantwortet, welche Tools wurden aufgerufen, wie lange hat jeder Schritt gedauert. Dat kriegt man mit überschaubarem Aufwand hin - und dat zahlt sich ab dem ersten Incident aus.
Stufe 3 braucht mehr als Tooling - die braucht organisatorische Reife. Dashboards bauen kann jeder. Aber sinnvolle Alerts festlegen, SLOs für AI-Features formulieren, Kostenbudgets pro Feature durchsetzen - dat sind Entscheidungen, die ’n Team zusammen treffen muss.
Stufe 4 is da, wo Observability und Evals zusammenwachsen. Produktions-Traces fließen zurück inne Eval-Pipeline. ’N Incident wird nich nur gefixt, sondern als Regressionstest festgenagelt. Im Evals-Post hab ich geschrieben, dat Evals ohne Feedback aus der Produktion veralten - Stufe 4 macht genau die Lücke dicht.

Tooling-Entscheidung: Welches Setup passt?
“Welches Observability-Tool soll ich nehmen?” - Kommt drauf an. Aber nich auf Features - sondern auf die Frage, welche Schichten ich abdecken muss.
Dat Zwei-Schichten-Modell
Observability für AI-Features zerfällt in zwei grundverschiedene Fragestellungen:
Layer 1: Infrastruktur-Observability. Is dat System gesund? Wie hoch is die Latenz? Wo brechen Requests ab? Dat is dat Revier von OpenTelemetry - Distributed Tracing, Metriken, Logs. Die GenAI Semantic Conventions erweitern OTel um LLM-spezifische Attribute wie gen_ai.usage.input_tokens oder gen_ai.request.model. Wer schon ’n OTel-Setup hat, kriegt damit die Infrastruktur-Sicht auf AI-Calls quasi geschenkt.
Layer 2: Prompt-Level-Observability. Produziert die AI gute Outputs? Welche Prompt-Version performt besser? Wo halluziniert dat Modell? Die Fragen beantwortet OTel alleine nich - dafür brauch ich ’ne eigene LLM-Plattform mit Prompt-Playground, Eval-Pipelines und Session-Tracking.
Beide Schichten beantworten unterschiedliche Fragen. Beides in ein Tool zu quetschen is ’n Kompromiss in beide Richtungen.
Drei Szenarien
’N Team mit OTel im Stack? Dann ergänzen die GenAI Semantic Conventions die Infrastruktur-Sicht, und Langfuse (oder ’ne vergleichbare Plattform) setzt für die Prompt-Level-Observability obendrauf.
Greenfield-AI-Projekt? Für Startups: Langfuse Cloud, fertig. Schneller geht der Einstieg nich. Für größere Organisationen: OTel von Tag 1 an einplanen - dat nachzurüsten wird mit jedem Service teurer. Plus ’ne LLM-Plattform für die zweite Schicht.
Compliance-Anforderungen? Dann zählt Self-Hosting. Langfuse is komplett self-hostbar und die klarste Option. LangSmith und Braintrust bieten Self-Hosting im Enterprise-Tier an, aber mit mehr Infrastruktur-Aufwand und weniger Kontrolle. Helicone is Open Source und auch self-hostbar. Wer Daten nich aus der Hand geben kann, hat Optionen - aber die Einstiegshürde is ganz unterschiedlich hoch.
Oder: selber bauen?
Berechtigter Einwurf: Mit AI-Unterstützung kannze doch so ’nen Observability-Stack an ’n paar Abenden zusammenstöpseln. Stimmt - für Layer 1. OTel-SDK, Grafana Tempo oder Jaeger als Backend, Grafana-Dashboards, ’n paar eigene Span-Attribute für gen_ai.*. Kostentabelle als JSON, Prompt-Versionen als Hash im Span. Dat is keine Raketenwissenschaft, und ich bin der Letzte, der davon abrät - im Gegenteil.
Layer 2 is der härtere Brocken. Prompt-Registry mit Diff-Ansicht zwischen Versionen, Eval-Pipelines mit LLM-as-Judge, Session-Threading über lange Konversationen, Feedback-Capture mit UI für Product und QA. Dat sind nich “’n paar Abende” - dat is ’ne eigene Plattform.
Die pragmatische Variante: Layer 1 selber bauen, bei Layer 2 ’ne Plattform andocken. Langfuse lässt sich per OTel-Bridge an ’nen selbstgebauten Layer-1-Stack anklemmen - Best of both.
Kurz eingeschätzt: Langfuse, Arize Phoenix, LangSmith, Helicone, Braintrust
Langfuse - Dat stärkste Open-Source-Gesamtpaket. Self-hostbar, OTel-Bridge für die Anbindung anne Infrastruktur, Prompt-Management, Eval-Pipelines. Die Community wächst schnell und die Plattform deckt beide Schichten immer mehr ab. Für die meisten Teams der sicherste Einstieg.
Arize Phoenix - Best-in-class für RAG-Debugging und Embedding-Analyse. Local-first, ideal für die Entwicklungsphase. Wer viel mit Retrieval macht und Chunk-Relevanz verstehen will, findet hier dat beste Werkzeug.
LangSmith - Passt wie Faust auf Auge für Teams, die eh schon im LangChain-Ökosystem unterwegs sind. Tiefe Integration, gute Developer Experience. Self-Hosting gibt et als Enterprise-Add-on, braucht aber ordentlich Infrastruktur (16+ vCPU, 64+ GB RAM). Wer nich an LangChain hängt, hat wenig Grund, hier anzufangen.
Helicone - Open Source (MIT-Lizenz) und self-hostbar. Inne Cloud-Variante der schnellste Einstieg überhaupt: Proxy-URL tauschen, fertig. Gut für erste Einblicke in Kosten und Latenz. Self-Hosted umgeht dat Compliance-Problem vom Proxy-Ansatz.
Braintrust - Dat stärkste Eval-Framework im Vergleich. Wer systematische Evaluations als Kernprozess etablieren will, findet hier die ausgereiftesten Werkzeuge. Self-Hosting im Enterprise-Tier als Hybrid-Modell: Data Plane im eigenen Account, Control Plane bei Braintrust.
Wie alles zusammenläuft
Dieser Post is kein Einzelstück. Der is die logische Folge von allem, wat inne letzten Wochen geschrieben wurde - und er macht die Konzepte aus den vorigen Posts betriebstauglich:
- Contracts als Fundament - Schema-Validierung gegen den Modelloutput. Inne Observability-Welt wird die Validierung zum Span-Attribut: Hat dat Schema gepasst? Wann, wo und wie oft hat et nich gepasst?
- Evals leben nich nur inne CI. Produktions-Traces werden zu Eval-Datensätzen - der offene Faden “Evals ohne Feedback aus der Produktion veralten” wird hier eingelöst.
- Tool-Sicherheit wird durch Tool-Spans greifbar. ’N False Success - dat Tool meldet Erfolg, aber passiert is nix - wird erst sichtbar, wenn der Tool-Span die echte Backend-Response als Event mitschleppt.
- Human-in-the-Loop hinterlässt Approval-Events im Trace. Und die Rubber-Stamp-Detection, die ich da als Design-Pattern beschrieben hab? Die wird zur Metrik: durchschnittliche Review-Dauer, Reject-Rate, Approval ohne Kontextänderung.
Und wer meint, Observability wär optional
Der EU AI Act macht et zur Pflicht.

Art. 12 verlangt “automatic recording of events” für High-Risk-Systeme - und meint damit nich console.log. Art. 12 verlangt, dat ’n Deployer versteht, wat dat System gemacht hat. Art. 14 fordert Human Oversight mit der Fähigkeit, “die Fähigkeiten und Grenzen des Systems richtig zu interpretieren” - ohne Traces is dat ’ne leere Forderung. Art. 19 schreibt ’ne Aufbewahrungsfrist von mindestens sechs Monaten vor. Und Art. 72 verlangt Post-Market Monitoring - also genau die systematische Analyse von Produktionsdaten, die dieser Post beschreibt.
EU AI Act - die relevanten Artikel
- Art. 12 - Record-keeping: High-Risk-Systeme müssen Ereignisse automatisch aufzeichnen (Logs), damit die Traceability über die ganze Lebensdauer gesichert is.
- Art. 14 - Human Oversight: Aufsichtspersonen müssen die Fähigkeiten und Grenzen vom System interpretieren können. Dat setzt Zugang zu Traces und Metriken voraus.
- Art. 19 - Aufbewahrungspflicht: Logs müssen mindestens 6 Monate gespeichert werden.
- Art. 72 - Post-Market Monitoring: Anbieter müssen Produktionsdaten systematisch sammeln und auswerten.
Die Deadline für die High-Risk-Pflichten is August 2026. Die Artikel bilden ’ne regulatorische Kette, die genau die Observability-Infrastruktur verlangt, die in diesem Post beschrieben wird. Wer die sowieso baut, hat die technische Grundlage für Compliance. Wer se nich baut, hat bald ’n Problem.
Ausblick: Von Traces zu Regressionstests
Der nächste logische Schritt is die Trace-zu-Eval-Pipeline. ’N Incident in Produktion - ’n halluzinierter Betrag, ’n False Success, ’n übersehener Edge Case - wird zum Trace. Der Trace wird zum Eval-Datensatz. Der Eval-Datensatz wird zum dauerhaften Regressionstest inne CI. Kein Incident darf zweimal auf dieselbe Tour passieren.
Observability is kein Ops-Thema. Ohne die bleiben Contracts, Evals und Human Oversight Konzepte, die ich nich seh, wenn se kaputtgehen.