
Zonder traces, model- en promptversies, tool-spans en kostenmetrics blijft elk incident speculatie.
Vier posts lang heb ik over principes geschreven: contracts, evals, toolveiligheid, human oversight. Allemaal waar - maar hoe zie ik in productie of dat allemaal echt werkt?
Zonder gestructureerde observability helemaal niet. Een false success in de refund-agent - de tool meldt succes, de klant wacht op zijn geld - vind je niet met application logs en error rates. Alles groen. Het systeem heeft niet gefaald, het heeft gelogen.
Deze post laat zien welke observability-infrastructuur je nodig hebt als team dat AI-features live draait. Welke vragen moet ik kunnen beantwoorden? Hoe ziet een goede trace eruit? En waar plaats ik mijn eigen situatie?

Vijf vragen vóór de tooling
Hoe had ik dat in 30 seconden kunnen debuggen?
Niet met grep in logfiles. Niet met een dashboard dat me uptime en error rate laat zien - want allebei waren ze groen. Geen fout, geen alert, alleen een verkeerd resultaat.
Traditionele metrics vangen AI-specifieke fouten niet af. False success, een verkeerde toolkeuze of gehallucineerde acties blijven onzichtbaar zolang ik alleen naar HTTP-statuscodes en exception-counts kijk. Het probleem zit dieper - in de beslislogica van de agent en in de interpretatie van de tool-antwoorden. Tussen turns gaat context verloren, zonder dat een logfile daarop wijst.
Voordat ik het over tooling heb: vijf vragen die elk team zou moeten kunnen beantwoorden.
1. Debugging: waarom heeft de agent de klant X verteld, terwijl Y gebeurd is?
De refund-agent zegt “terugbetaling is eruit”. Maar refund_order heeft een fout teruggegeven - of is niet eens aangeroepen. Zonder gecorreleerde trace met tool-call-resultaten, model-inputs en model-outputs is het gokken. Ik heb een keten nodig: gebruikersinvoer, routingbeslissing, tool-intent, tool-result, gegenereerd antwoord. Zonder gaten.
2. Kosten: wat kost een gemiddelde supportcase - en welk agent-pad verbruikt de meeste tokens?
Niet elke supportcase is even duur. Een simpele FAQ-lookup kost een paar honderd tokens. Een refund-flow met identiteitscontrole, orderopvraging en approval-lus kan al snel het twintigvoudige verbruiken. Zonder token-attributie per agent, tool en conversation zie ik alleen een maandelijkse rekening - maar niet waar het geld naartoe gaat.
3. Latency: waar hangt de agent - bij de model-call, de tool-call of de retrieval?
De gebruiker wacht. Maar waarop? Op het model, dat 3 seconden nodig heeft voor het antwoord? Op de lookup_order-call, die tegen een trage database draait? Of op een retrievalsysteem dat de context bij elkaar zoekt? Een uitsplitsing van latency per span is geen nice-to-have - het is de enige manier om gericht te optimaliseren in plaats van te gokken.
4. Kwaliteit: hoe vaak kiest de agent de verkeerde tool? Hoe vaak heeft hij meerdere pogingen nodig?
De agent heeft vier tools om uit te kiezen. Hoe vaak pakt hij de juiste? Hoe vaak roept hij lookup_order aan terwijl hij verify_customer had moeten aanroepen - en corrigeert hij zichzelf pas bij de tweede poging? Tool-selection-tracking en retry-counts laten me zien waar het model er systematisch naast zit. Dat zijn geen edge cases - dat zijn signalen voor promptproblemen of ontbrekende tool-descriptions.
5. Compliance: kan ik het volledige beslispad voor een concrete klantzaak reconstrueren?
Een klant belt en wil weten waarom de terugbetaling niet is aangekomen. Regelgeving eist herleidbaarheid. Ik heb een audit-trail nodig die laat zien: welke agent heeft wanneer welke tool aangeroepen, welke approval-events waren er, wie heeft wat goedgekeurd? Zonder dat is elke klantzaak een black box.
Vijf vragen, vijf verschillende eisen aan observability. En toch gebeurt in de praktijk vaak hetzelfde: er wordt een tracingtool aangesloten, er worden een paar spans geschreven - en dan hoopt iedereen dat de juiste data er wel tussen zal zitten.
In de meeste teams ontbreekt niet de tooling - er ontbreekt duidelijkheid over welke operationele vragen beantwoord moeten worden.
Anatomie van een trace
Vijf vragen. Geen dashboard dat ze beantwoordt. Laten we dat veranderen.
Neem de refund-agent en kijk wat een enkele supportrequest als trace oplevert - als we hem goed instrumenteren:
[ROOT] invoke_agent support-request
├── [LLM] chat gpt-5.4-nano (routingbeslissing)
│   ├── gen_ai.usage.input_tokens: 674
│   ├── gen_ai.response.finish_reasons: ["tool-calls"]
│   └── gen_ai.response.model: gpt-5.4-nano
├── [TOOL] execute_tool lookup_order
├── [TOOL] execute_tool verify_customer
├── [EVENT] approval.requested (HITL-pauze)
│   └── wait_duration_ms, risk_level, tool_arguments
├── [EVENT] approval.granted (HITL-resume)
│   └── approver_id, approval_id, justification
├── [TOOL] execute_tool refund_order (post-approval)
└── [LLM] chat gpt-5.4-nano (definitief antwoord)
    ├── gen_ai.usage.input_tokens: 4083
    ├── gen_ai.response.finish_reasons: ["stop"]
    └── gen_ai.response.model: gpt-5.4-nano
Eén trace, zeven child-spans. Elk beantwoordt een andere vraag.
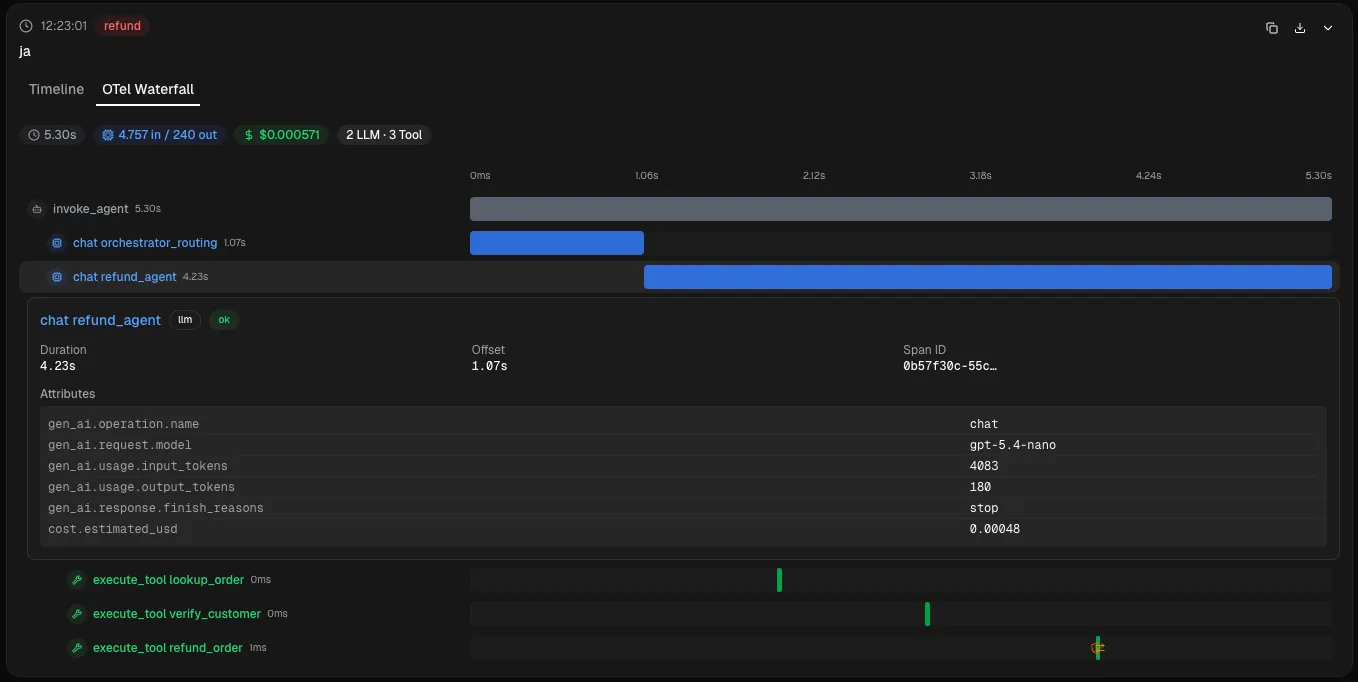
Laten we beter kijken.
Drie span-typen, drie perspectieven
LLM-calls (chat) zijn de interacties met het model. Elke span draagt token-counts (gen_ai.usage.input_tokens, gen_ai.usage.output_tokens), het daadwerkelijk gebruikte model (gen_ai.response.model - niet altijd identiek aan het aangevraagde) en de finish-reason. Drie LLM-calls in één request? Dat zijn drie kostenposten (vraag 2), drie bijdragen aan de latency (vraag 3), drie potentiële foutbronnen.
Tool-executions (execute_tool) leggen elke toolaanroep vast met argumenten en resultaat. verify_customer duurde 40ms en gaf valid: true terug? Staat in de span. refund_order is mislukt met een timeout? Staat ook in de span - en daarmee heb ik het antwoord op vraag 1: waarom heeft de agent de klant iets bevestigd dat nooit gebeurd is?
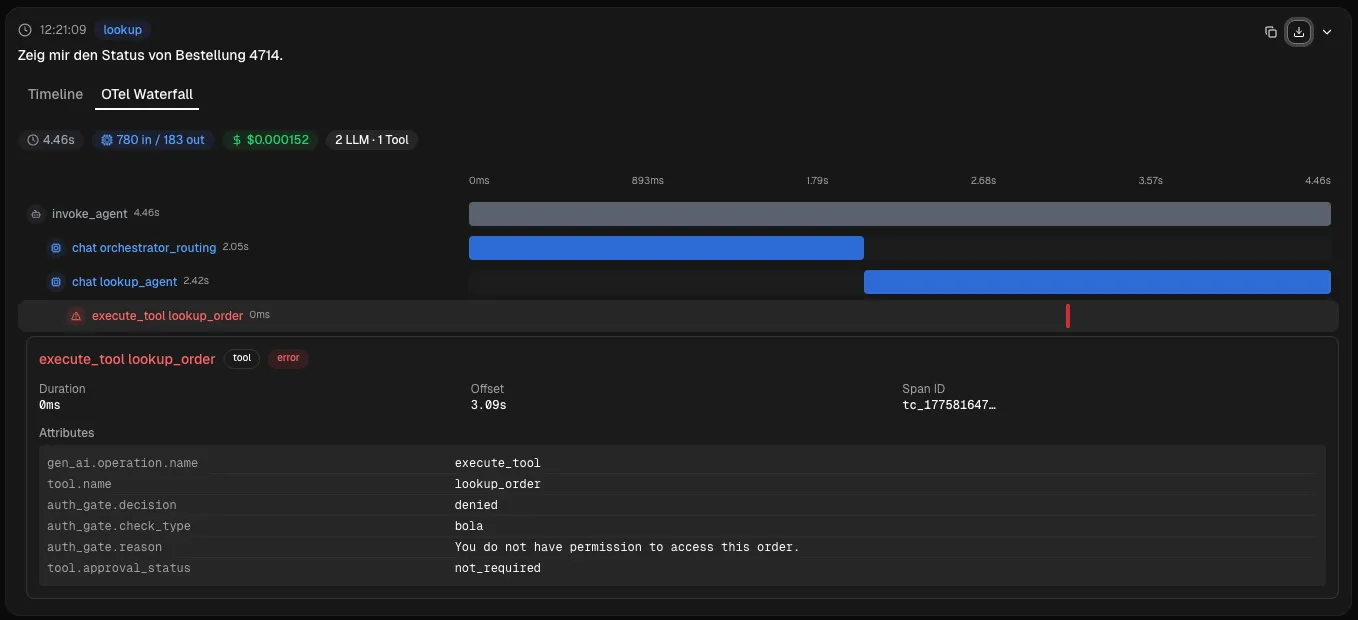
Agent-orchestration (invoke_agent) is de root-span - die houdt alles bij elkaar. Totale duur, totale kosten, eindstatus. Als ik wil weten of de refund-agent trager wordt, kijk ik hier. Als ik wil weten waarom, kijk ik in de child-spans.
Context propagation: wie heeft wat in gang gezet?
Een trace zonder context is een datapunt zonder assenstelsel - technisch correct, praktisch nutteloos. De beslissende vraag bij een incident is nooit “Wat heeft de agent gedaan?”, maar “Wat heeft de agent voor welke klant in welk ticket gedaan?”
OpenTelemetry Baggage en root-span-attributes lossen dat op: session.id, user.id, ticket.id reizen als baggage door de hele trace. Elke span erft de context. Als de refund-agent om 14:32 een verkeerd bedrag heeft terugbetaald, vind ik via de ticket.id binnen seconden de volledige trace - niet via logfile-archeologie.
Approval-events in de trace
In de HITL-post ging het over de architectuur van approval-gates. Hier gaat het over hun zichtbaarheid.

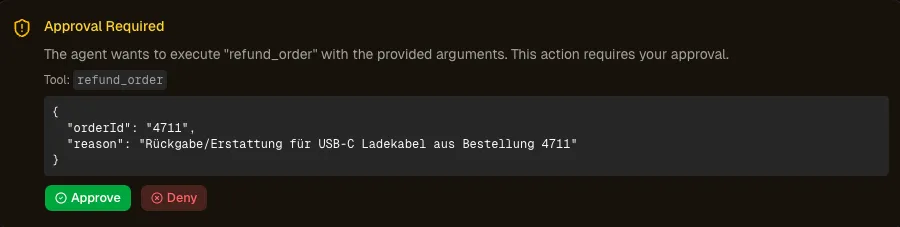
Per april 2026 bestaat er geen gestandaardiseerde OTel-convention voor approval-events. Dat betekent: custom events. approval.requested en approval.granted als span-events op de root-span, met attributen als wait_duration_ms, risk_level, approver_id en approval_id.
Waarom dat belangrijk is? Er rollen meteen twee metrics uit: approval-latency (hoe lang wacht de workflow op een mens?) en approval-rate (hoe vaak wordt er goedgekeurd vs. afgewezen?). Een stijgend afwijzingspercentage is een signaal. Ofwel stelt de agent steeds vaker twijfelachtige acties voor - ofwel zijn de approval-criteria te streng. Ik wil het allebei weten.
Wat NIET in de trace hoort
AI-workloads genereren 10-50x meer telemetrie dan klassieke services. Elke LLM-call heeft een prompt, een completion, vaak meerdere tool-calls met resultaten. De verleiding om alles te loggen is groot.
Metadata en referenties zijn de default. Token-counts, modelversie, finish-reason, toolnaam, duur - ja. Volledige prompttekst, API-keys, ruwe klantfeedback - nee. Niet omdat het technisch onmogelijk zou zijn, maar omdat het normaal gesproken onnodig is.
Break-glass-architectuur: als je toch de volledige content nodig hebt
Soms is metadata niet genoeg. Een hallucinatie-incident, een geëscaleerde klantzaak - dan heb ik de echte prompt en de completion nodig. De oplossing is geen of-of-beslissing, maar een architectuur met twee lanes:
Production lane: geminimaliseerde events, alleen metadata en referenties. Lange retentie, laag risico. Dat is de normale toestand.
Break-glass lane: volledige content, geactiveerd door een named approver met gedocumenteerde motivering. Korte retentie (24-72u), automatische verwijdering, volledige audit-trail. Elke toegang is herleidbaar.
Het patroon is niet nieuw - het is hetzelfde principe als bij toegang tot productiedatabases of encryption-key-escrow. Het verschil: bij AI-workloads is het datavolume per request zo hoog dat de default-lane echt minimaal moet zijn, wil de break-glass-lane überhaupt beheersbaar blijven.
Wat OpenTelemetry levert - en wat niet
Wie zich met observability voor AI-features bezighoudt, stuit op de OpenTelemetry GenAI Semantic Conventions. De spec bestaat, groeit en heeft momentum. Maar er is ook een probleem: per april 2026 is er geen enkel attribuut stable. Alles heeft de status “Development”. Wie de conventions vandaag gebruikt, moet OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental zetten - en daarmee accepteren dat attributen op elk moment een andere naam kunnen krijgen.
Dat betekent niet dat de spec nutteloos is. Het betekent dat we moeten weten wat hij kan - en vooral wat hij niet kan. (Korte begripsverheldering: de spec gebruikt de status “Development”, maar de opt-in-variabele heet experimental - een historisch overblijfsel. Bedoeld wordt hetzelfde.)
Wat de spec afdekt
De conventions definiëren span-typen voor de belangrijkste operaties: chat, text_completion, embeddings, execute_tool, invoke_agent, invoke_workflow. Daarbij komen kern-attributes als gen_ai.provider.name, gen_ai.request.model, token-counts en finish-reasons. Aan de metrics-kant is er gen_ai.client.token.usage als histogram, gen_ai.client.operation.duration en streaming-metrics als gen_ai.server.time_to_first_token.
Nieuwere toevoegingen zijn MCP-conventions (mcp.method.name, mcp.session.id), agent-spans (invoke_agent, invoke_workflow) en een gen_ai.evaluation.result-event met score en label. De richting klopt.
Wat de spec niet afdekt
De gaten zitten precies bij de dingen die in productie het verschil maken:
- Kostentracking: geen
gen_ai.cost-attribuut. De provider-API’s leveren token-counts, maar geen prijzen. Platforms als Langfuse of Helicone lossen dat op met bijgehouden prijstabellen - maar op spec-niveau blijft kostenberekening een klus die je zelf moet klaren. - Prompt-versioning: geen concept van prompt-registries. Welke versie van de system prompt van de refund-agent tot welk resultaat heeft geleid - niet afgedekt.
- User feedback: geen gestandaardiseerd thumbs-up/down-event. De koppeling tussen trace en gebruikersbeoordeling bestaat in de spec niet.
- Approval en HITL: geen convention voor pause/resume-events. Wanneer een mens heeft ingegrepen en waarom - onzichtbaar.
- Guardrails: geen event voor content-filtering of safety-checks. Of een output gefilterd is - niet voorzien.
De spec levert het skelet: model, provider, tokens, latency. Alles wat AI-features van speeltje tot productiesysteem maakt - kosten, versies, feedback, governance - valt buiten de conventions.
Deprecated attributes - wat er al veranderd is
Wie vroeg met de conventions is begonnen, moet migreren: gen_ai.system heet nu gen_ai.provider.name, gen_ai.usage.prompt_tokens werd gen_ai.usage.input_tokens, gen_ai.usage.completion_tokens werd gen_ai.usage.output_tokens. Een voorproefje van wat de status “Development” in de praktijk betekent.

De OTel GenAI Conventions zijn een goed startpunt - maar wie erop vertrouwt dat de spec alle eisen aan observability afdekt, komt in productie voor verrassingen te staan.
De zes meest gemaakte fouten bij LLM-observability
Observability voor AI-features is nog jong. Maar een paar valkuilen duiken in post-mortems en engineeringblogs nu al steeds weer op. Zes anti-patterns:
1. Alles loggen, niets correleren
Application logs zijn er. Heel veel. Ergens staat dat er een LLM-call is gedaan. Ergens anders staat dat er een tool is aangeroepen. Maar bij welke klantzaak hoort dat? Welke agent-step heeft de call in gang gezet?
Zonder trace-ID’s als verbindend element zijn logs alleen ruis met timestamps. Als de refund-agent een terugbetaling bevestigt die nooit is aangekomen, wil ik niet in drie verschillende log-streams zoeken - ik wil één trace die me de hele zaak laat zien.
2. Prompts in productie volledig loggen
Zoals beschreven in het trace-hoofdstuk: content-events horen op opt-in, niet op opt-out. Toch wordt er vaak alles gelogd - uit angst om bij een incident iets te missen. Het resultaat: exploderende opslagkosten en PII in de observability-backend. De betere vraag is niet “Wat zouden we nodig kunnen hebben?”, maar “Welke metadata volstaat voor 95% van de gevallen - en hoe komen we bij de rest als we die nodig hebben?” De hierboven geschetste break-glass-architectuur lost precies dat op.
3. Token-counts zonder kostentoewijzing
“We verbruiken 2 miljoen tokens per dag.” - “Waarvoor?” - Stilte.
Globale token-counts zijn een getal op een dashboard. Meer niet. Zonder metadata-tagging bij elke API-request - user_id, feature_name, agent_name - kun je niet beantwoorden welke feature de kosten opdrijft. Is het de refund-agent? De samenvatting? De routing? Kostenoptimalisatie zonder attributie is gokken.
4. Alleen het happy path instrumenteren
Dit is de gevaarlijkste fout. Toolfouten, retries, afgebroken chains - allemaal onzichtbaar. De error rate ziet er goed uit, omdat alleen geslaagde afrondingen worden geteld.
Reken maar na: 10 agent-steps met elk 99% accuracy komen uit op 90% totale accuracy. En elke onzichtbare retry vermenigvuldigt kosten en latency zonder dat iemand het merkt. Error-spans, retry-counts en finish-reason-tracking horen bij elke step - niet alleen bij de laatste.
Wat je niet meet, optimaliseer je niet. Wat je niet ziet, negeer je - tot het een incident wordt.
5. Observability als bijgedachte
“We bouwen eerst de features, dan de observability.” Dat klinkt pragmatisch. In de praktijk betekent het: bij het eerste incident heb je geen data. Geen trace, geen span, geen versie-informatie. Alleen vermoedens.
Observability is een architectuurbeslissing, geen ops-klus voor sprint 12. Trace-context, span-structuur en metadata-schema moeten staan voordat de eerste feature live gaat. Achteraf instrumenteren betekent achteraf alle abstracties openbreken.
Michael Seel zet in “AI Systems Architecture: Governance” de volgende stap: observability hoort niet alleen in de backlog van het team, maar in het platform - anders ontstaat shadow AI, naar analogie van shadow IT.

6. Dashboard-cargocult
Latency-chart. Token-count-grafiek. Error-rate-gauge. Drie dashboards, twaalf panels, nul inzichten. Niemand kijkt ernaar tot er een incident is - en dan helpen ze niet, omdat ze de verkeerde vragen beantwoorden.
Een dashboard dat “requests per minuut” toont, beantwoordt geen enkele operationele vraag. Hoe hoog is het percentage hallucinaties? Welk agent-pad kost het meest? Is er prompt-drift? Dashboards moeten beslissingen mogelijk maken, niet metrics decoreren.
Volwassenheidsmodel: van blind tot diagnostic
Er bestaat geen officieel “LLM Observability Maturity Model” - geen ISO-standaard, geen pdf met een Gartner-kwadrant. Maar als ik bekijk hoe Honeycomb, LangChain en Portkey het onderwerp beschrijven, tekent zich een duidelijke progressie af. Ik heb die samengevat in vijf niveaus - niet als academisch framework, maar als beoordelingsraster voor die ene vraag: Waar staan we, en wat is de volgende zinnige stap?
| Niveau | Naam | Kenmerken | Welke van de vijf vragen beantwoord worden |
|---|---|---|---|
| 0 | Blind | Geen traces, alleen application logs | Geen. Elk incident is speculatie. |
| 1 | Basic | Request/response-logging, token-counts | Vraag 2 (kosten) gedeeltelijk - maar zonder antwoord op het waar en waarom. |
| 2 | Structured | OTel-traces met GenAI-conventions, tool-spans | Vragen 1 (debugging), 3 (latency), 4 (kwaliteit). |
| 3 | Operational | Dashboards, alerts op kosten/latency/foutpercentage | Vragen 1-4 proactief. Kostenbeheersing. SLO’s. |
| 4 | Diagnostic | Trace-naar-eval-pipeline, drift-detectie | Alle vijf de vragen - plus een feedbackloop naar de evals. |
De meeste teams zitten tussen niveau 0 en 1. Niveau 2 is de zinnige volgende stap.
Dat is geen vermoeden. Wie vandaag console.log("LLM response:", result) in productie heeft staan, zit op niveau 1. Wie zelfs dat niet heeft - niveau 0. Beide betekenen: als er iets misgaat, wordt er gegokt in plaats van gediagnosticeerd.
Niveau 2 - structured traces met OpenTelemetry en de GenAI Semantic Conventions - is het punt waarop debugging ophoudt een gokspel te zijn. Hier worden afzonderlijke requests herleidbaar: welke prompt ging erin, welk model heeft geantwoord, welke tools zijn aangeroepen, hoe lang duurde elke stap. Dat is met beperkte moeite haalbaar - en betaalt zich vanaf het eerste incident terug.
Niveau 3 vraagt meer dan tooling - het vraagt organisatorische volwassenheid. Dashboards bouwen kan iedereen. Maar zinnige alerts definiëren, SLO’s voor AI-features formuleren, kostenbudgetten per feature afdwingen - dat zijn beslissingen die een team samen moet nemen.
Niveau 4 is waar observability en evals samengroeien. Productie-traces stromen terug naar de eval-pipeline. Een incident wordt niet alleen gefixt, maar verankerd als regressietest. In de evals-post schreef ik dat evals zonder productiefeedback verouderen - niveau 4 dicht precies dat gat.

Toolingkeuze: welke setup past?
“Welke observability-tool moet ik nemen?” - Dat hangt ervan af. Maar niet van features - wel van de vraag welke lagen ik moet afdekken.
Het tweelagenmodel
Observability voor AI-features valt uiteen in twee fundamenteel verschillende vraagstukken:
Layer 1: infrastructuur-observability. Is het systeem gezond? Hoe hoog is de latency? Waar breken requests af? Dat is het domein van OpenTelemetry - distributed tracing, metrics, logs. De GenAI Semantic Conventions breiden OTel uit met LLM-specifieke attributen als gen_ai.usage.input_tokens of gen_ai.request.model. Wie al een OTel-setup heeft, krijgt daarmee de infrastructuurblik op AI-calls bijna cadeau.
Layer 2: observability op promptniveau. Levert de AI goede outputs? Welke promptversie presteert beter? Waar hallucineert het model? Die vragen beantwoordt OTel alleen niet - daarvoor heb ik een dedicated LLM-platform nodig met prompt-playground, eval-pipelines en session-tracking.
Beide lagen beantwoorden verschillende vragen. Ze allebei in één tool persen is een compromis in beide richtingen.
Drie scenario’s
Een team met OTel in de stack? Dan vullen de GenAI Semantic Conventions de infrastructuurblik aan, en Langfuse (of een vergelijkbaar platform) komt erbovenop voor de observability op promptniveau.
Greenfield AI-project? Voor startups: Langfuse Cloud, klaar. Sneller instappen kan niet. Voor grotere organisaties: OTel vanaf dag 1 inplannen - het achteraf inbouwen wordt met elke service duurder. Plus een LLM-platform voor de tweede laag.
Compliance-eisen? Dan telt self-hosting. Langfuse is volledig self-hostbaar en de duidelijkste optie. LangSmith en Braintrust bieden self-hosting in de enterprise-tier aan, maar met meer infrastructuurwerk en beperkte controle. Helicone is open source en ook self-hostbaar. Wie data niet uit handen kan geven, heeft opties - maar de instapdrempel verschilt flink.
Of: zelf bouwen?
Terechte tegenwerping: met AI-ondersteuning prik je zo’n observability-stack toch in een paar avonden in elkaar? Klopt - voor layer 1. OTel-SDK, Grafana Tempo of Jaeger als backend, Grafana-dashboards, een paar eigen span-attributen voor gen_ai.*. Kostentabel als JSON, promptversies als hash in de span. Dat is geen rocket science, en ik ben de laatste die het afraadt - integendeel.
Layer 2 is het lastigere deel. Prompt-registry met diff-weergave tussen versies, eval-pipelines met LLM-as-judge, session-threading over lange conversaties, feedback-capture met een UI voor product en QA. Dat zijn geen “paar avonden” - dat is een platform op zich.
De pragmatische variant: layer 1 zelf bouwen, en voor layer 2 een platform aankoppelen. Langfuse kun je via een OTel-bridge aansluiten op een zelfgebouwde layer-1-stack - best of both.
Korte inschattingen: Langfuse, Arize Phoenix, LangSmith, Helicone, Braintrust
Langfuse - Het sterkste open-source totaalpakket. Self-hostbaar, OTel-bridge voor de koppeling met de infrastructuur, promptmanagement, eval-pipelines. De community groeit snel en het platform dekt steeds meer beide lagen af. Voor de meeste teams de veiligste instap.
Arize Phoenix - Best-in-class voor RAG-debugging en embedding-analyse. Local-first, ideaal voor de ontwikkelfase. Wie veel met retrieval werkt en chunk-relevantie wil begrijpen, vindt hier de beste tools.
LangSmith - De natuurlijke fit voor teams die al in het LangChain-ecosysteem werken. Diepe integratie, goede developer experience. Self-hosting is beschikbaar als enterprise-add-on, maar vergt flinke infrastructuur (16+ vCPU, 64+ GB RAM). Wie niet aan LangChain vastzit, heeft weinig reden om hier te beginnen.
Helicone - Open source (MIT-licentie) en self-hostbaar. In de cloudvariant de snelste instap die er is: proxy-URL omwisselen, klaar. Goed voor eerste inzichten in kosten en latency. Self-hosted omzeilt het compliance-probleem van de proxy-aanpak.
Braintrust - Het sterkste eval-framework in de vergelijking. Wie systematische evaluations als kernproces wil neerzetten, vindt hier de meest volwassen tools. Self-hosting in de enterprise-tier als hybride model: data plane in je eigen account, control plane bij Braintrust.
Hoe alles samenkomt
Deze post staat niet op zichzelf. Hij is het logische gevolg van alles wat de afgelopen weken is geschreven - en hij maakt de concepten uit de vorige posts operationeel:
- Contracts als fundament - schemavalidatie van de modeloutput. In de observability-wereld wordt die validatie een span-attribuut: paste het schema? Wanneer, waar en hoe vaak paste het niet?
- Evals leven niet alleen in de CI. Productie-traces worden eval-datasets - de open draad “evals zonder productiefeedback verouderen” wordt hier ingelost.
- Toolveiligheid wordt tastbaar via tool-spans. Een false success - de tool meldt succes, maar er is niets gebeurd - wordt pas zichtbaar als de tool-span de daadwerkelijke backend-response als event meedraagt.
- Human-in-the-loop laat approval-events achter in de trace. En de rubber-stamp-detectie die ik daar als design pattern beschreef? Die wordt een metric: gemiddelde reviewduur, reject-rate, approval zonder contextwijziging.
En voor wie denkt dat observability optioneel is
De EU AI-verordening maakt het verplicht.

Art. 12 eist “automatic recording of events” voor high-risk-systemen - en bedoelt daarmee niet console.log. Art. 12 eist dat een deployer begrijpt wat het systeem heeft gedaan. Art. 14 eist human oversight met het vermogen om “de capaciteiten en beperkingen van het systeem correct te interpreteren” - zonder traces is dat een lege eis. Art. 19 schrijft een bewaartermijn van minstens zes maanden voor. En Art. 72 eist post-market monitoring - dus precies de systematische analyse van productiedata die deze post beschrijft.
EU AI-verordening - de relevante artikelen
- Art. 12 - Record-keeping: high-risk-systemen moeten gebeurtenissen automatisch vastleggen (logs), zodat traceability over de hele levensduur gewaarborgd is.
- Art. 14 - Human oversight: toezichthouders moeten de capaciteiten en beperkingen van het systeem kunnen interpreteren. Dat veronderstelt toegang tot traces en metrics.
- Art. 19 - Bewaarplicht: logs moeten minstens 6 maanden bewaard worden.
- Art. 72 - Post-market monitoring: aanbieders moeten productiedata systematisch verzamelen en analyseren.
De deadline voor de high-risk-verplichtingen is augustus 2026. Deze artikelen vormen een regulatoire keten die precies de observability-infrastructuur vereist die in deze post wordt beschreven. Wie die toch al bouwt, heeft de technische basis voor compliance. Wie die niet bouwt, heeft binnenkort een probleem.
Vooruitblik: van traces naar regressietests
De volgende logische stap is de trace-naar-eval-pipeline. Een incident in productie - een gehallucineerd bedrag, een false success, een over het hoofd geziene edge case - wordt een trace. De trace wordt een eval-dataset. De eval-dataset wordt een blijvende regressietest in de CI. Geen enkel incident mag twee keer op dezelfde manier gebeuren.
Observability is geen ops-onderwerp. Zonder observability blijven contracts, evals en human oversight concepten die ik niet zie als ze breken.