
Uten traces, modell- og promptversjoner, tool-spans og kostnadsmetrikker forblir hver incident spekulasjon.
I fire innlegg har jeg skrevet om prinsipper: Contracts, evals, verktøysikkerhet, Human Oversight. Riktig nok - men hvordan ser jeg i drift om alt dette faktisk fungerer?
Uten strukturert Observability: ikke i det hele tatt. En False Success i refund-agenten - verktøyet melder suksess, kunden venter på pengene sine - finner du ikke med applikasjonslogger og error rates. Alt er grønt. Systemet har ikke feilet, det har løyet.
Dette innlegget viser hvilken Observability-infrastruktur team trenger når de har AI-funksjoner live. Hvilke spørsmål må jeg kunne svare på? Hvordan ser en god trace ut? Og hvor står jeg selv?

Fem spørsmål før tooling
Hvordan kunne jeg ha debugget dette på 30 sekunder?
Ikke med grep i loggfiler. Ikke med et dashboard som viser meg oppetid og error rate - for begge var grønne. Ingen feil, ingen alert, bare et feil resultat.
Tradisjonelle metrikker fanger ikke opp AI-spesifikke feil. False Success, feil valg av verktøy eller hallusinerte handlinger forblir usynlige så lenge jeg bare ser på HTTP-statuskoder og antall exceptions. Problemet sitter dypere - i agentens beslutningslogikk og i tolkningen av svarene fra verktøyene. Kontekst går tapt mellom turer uten at en eneste loggfil sier fra om det.
Før jeg snakker om tooling: fem spørsmål ethvert team bør kunne svare på.
1. Debugging: Hvorfor sa agenten X til kunden, selv om Y skjedde?
Refund-agenten sier «refusjonen er sendt». Men refund_order returnerte en feil - eller ble aldri kalt i det hele tatt. Uten en korrelert trace med resultater fra tool-calls, modell-input og modell-output blir det gjetting. Jeg trenger en kjede: brukerens input, routing-beslutning, tool-intent, tool-result, generert svar. Uten hull.
2. Kostnader: Hva koster en gjennomsnittlig supportsak - og hvilken agent-sti bruker flest tokens?
Ikke alle supportsaker er like dyre. Et enkelt FAQ-oppslag koster noen hundre tokens. En refund-flyt med identitetssjekk, ordreoppslag og approval-loop kan fort bruke tjue ganger så mye. Uten token-attribusjon per agent, verktøy og samtale ser jeg bare en månedlig regning - men ikke hvor pengene går.
3. Latens: Hvor henger agenten - på modell-callet, tool-callet eller retrievalen?
Brukeren venter. Men på hva? På modellen, som bruker 3 sekunder på svaret? På lookup_order-callet, som går mot en treg database? Eller på et retrieval-system som samler sammen konteksten? Span-basert oppsplitting av latens er ikke en nice-to-have - det er den eneste måten å optimalisere målrettet i stedet for å gjette.
4. Kvalitet: Hvor ofte velger agenten feil verktøy? Hvor ofte trenger den flere forsøk?
Agenten har fire verktøy å velge mellom. Hvor ofte velger den det riktige? Hvor ofte kaller den lookup_order når den skulle ha kalt verify_customer - og retter seg først på andre forsøk? Tracking av verktøyvalg og antall retries viser meg hvor modellen systematisk bommer. Det er ikke edge cases - det er signaler om prompt-problemer eller manglende tool-descriptions.
5. Compliance: Kan jeg følge hele beslutningsstien for en konkret kundesak?
En kunde ringer og vil vite hvorfor refusjonen ikke har kommet. Regelverket krever sporbarhet. Jeg trenger et audit-trail som viser: Hvilken agent kalte hvilket verktøy når, hvilke approval-events fantes, hvem godkjente hva? Uten det er hver kundesak en black box.
Fem spørsmål, fem ulike krav til Observability. Og likevel skjer ofte det samme i praksis: Man kobler på et tracing-verktøy, skriver noen spans - og så håper alle at de riktige dataene nok er med.
I de fleste team er det ikke tooling som mangler - det er klarhet om hvilke driftsspørsmål som må besvares.
Anatomien til en trace
Fem spørsmål. Ingen dashboards som svarer på dem. La oss endre på det.
La oss ta refund-agenten og se på hva én enkelt support-request produserer som trace - når vi instrumenterer riktig:
[ROOT] invoke_agent support-request
├── [LLM] chat gpt-5.4-nano (routing-beslutning)
│   ├── gen_ai.usage.input_tokens: 674
│   ├── gen_ai.response.finish_reasons: ["tool-calls"]
│   └── gen_ai.response.model: gpt-5.4-nano
├── [TOOL] execute_tool lookup_order
├── [TOOL] execute_tool verify_customer
├── [EVENT] approval.requested (HITL-pause)
│   └── wait_duration_ms, risk_level, tool_arguments
├── [EVENT] approval.granted (HITL-resume)
│   └── approver_id, approval_id, justification
├── [TOOL] execute_tool refund_order (post-approval)
└── [LLM] chat gpt-5.4-nano (endelig svar)
    ├── gen_ai.usage.input_tokens: 4083
    ├── gen_ai.response.finish_reasons: ["stop"]
    └── gen_ai.response.model: gpt-5.4-nano
Én trace, sju child-spans. Hver av dem svarer på et annet spørsmål.
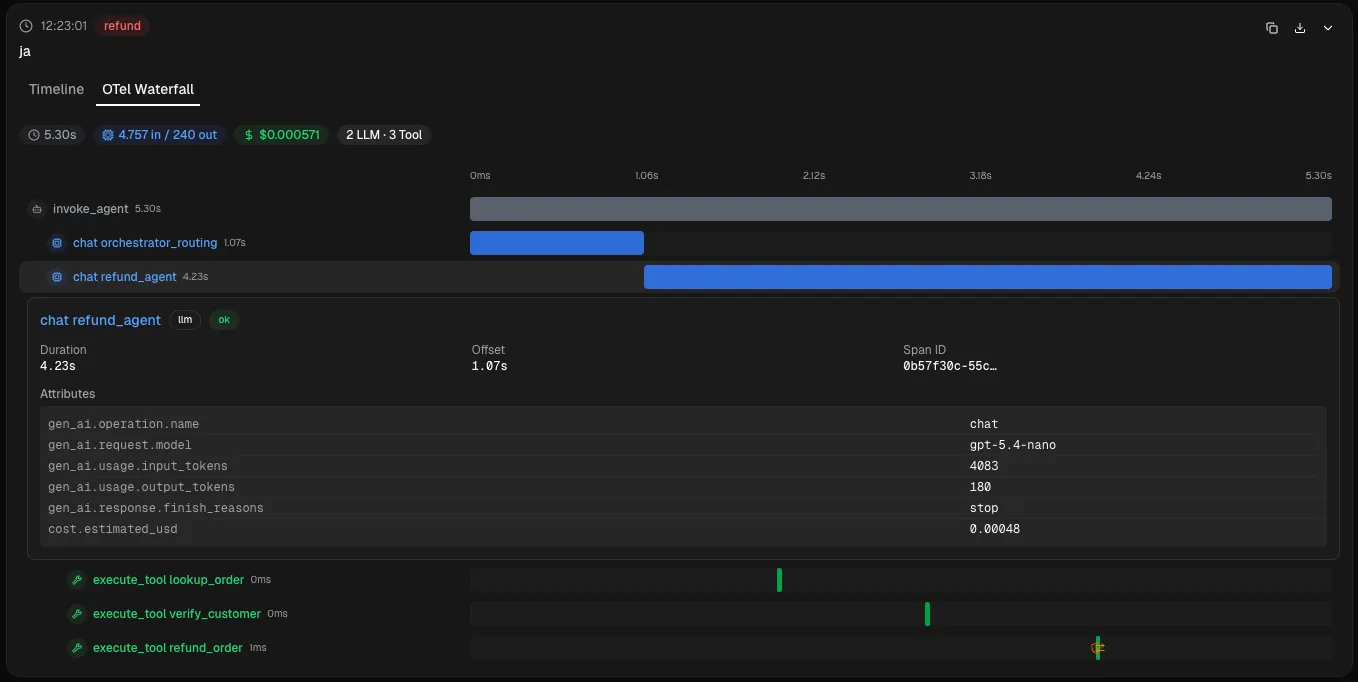
La oss se nærmere.
Tre span-typer, tre perspektiver
LLM-calls (chat) er modell-interaksjonene. Hver span bærer token-counts (gen_ai.usage.input_tokens, gen_ai.usage.output_tokens), modellen som faktisk ble brukt (gen_ai.response.model - ikke alltid den samme som den som ble bedt om) og finish-reason. Tre LLM-calls i én request? Det er tre kostnadsposter (spørsmål 2), tre bidrag til latens (spørsmål 3), tre potensielle feilkilder.
Tool-executions (execute_tool) fanger hvert verktøykall med argumenter og resultat. verify_customer brukte 40 ms og returnerte valid: true? Står i spanen. refund_order feilet med en timeout? Står også i spanen - og dermed har jeg svaret på spørsmål 1: Hvorfor bekreftet agenten noe overfor kunden som aldri skjedde?
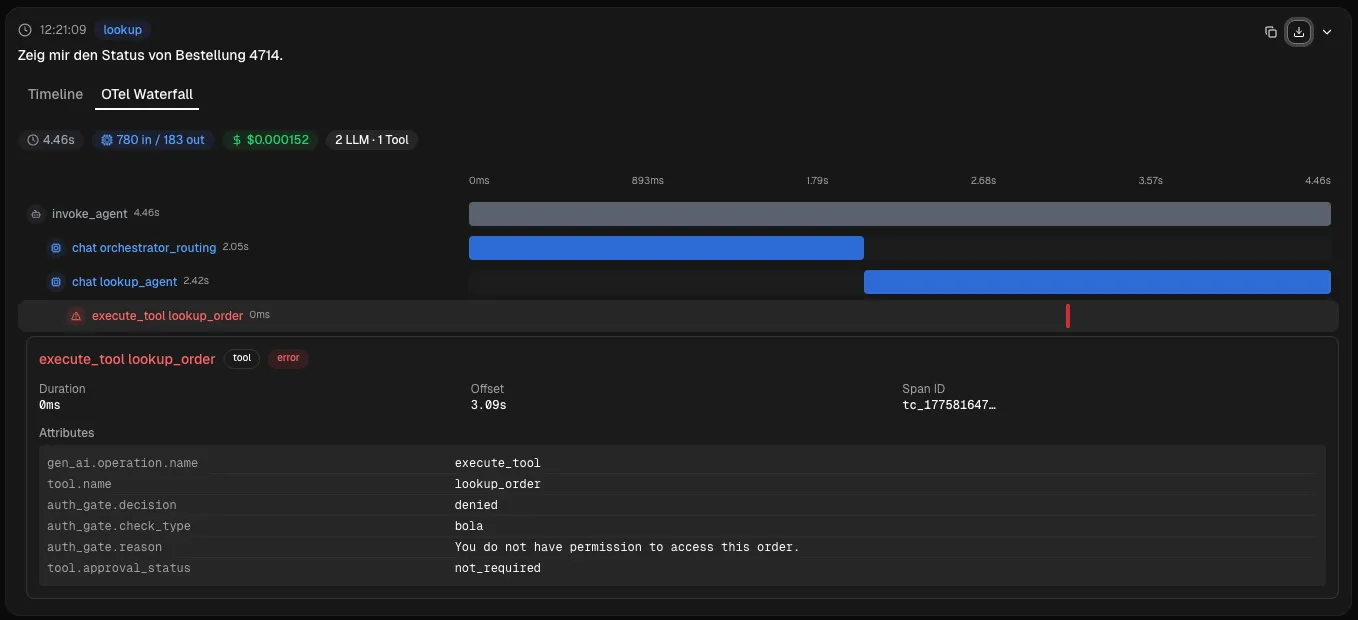
Agent-orkestrering (invoke_agent) er root-spanen - den holder alt sammen. Total varighet, totale kostnader, endelig status. Vil jeg vite om refund-agenten blir tregere, ser jeg her. Vil jeg vite hvorfor, ser jeg i child-spanene.
Context propagation: Hvem utløste hva?
En trace uten kontekst er et datapunkt uten koordinatsystem - teknisk korrekt, praktisk ubrukelig. Det avgjørende spørsmålet ved en incident er aldri «Hva gjorde agenten?», men «Hva gjorde agenten for hvilken kunde i hvilken sak?»
OpenTelemetry Baggage og root-span-attributter løser det: session.id, user.id, ticket.id vandrer som baggage gjennom hele tracen. Hver span arver konteksten. Hvis refund-agenten refunderte feil beløp klokka 14:32, finner jeg den komplette tracen via ticket.id på sekunder - ikke gjennom arkeologi i loggfiler.
Approval-events i tracen
HITL-innlegget handlet om arkitekturen til approval-gates. Her handler det om å gjøre dem synlige.

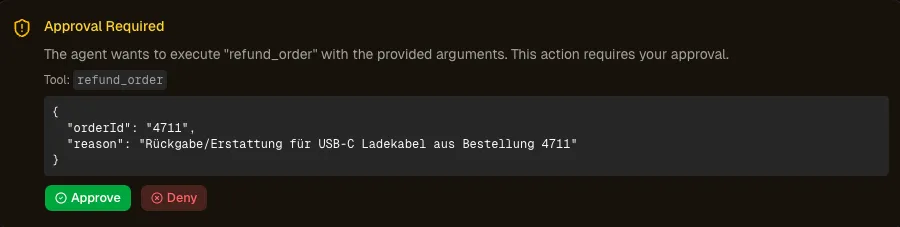
Per april 2026 finnes det ingen standardisert OTel-convention for approval-events. Det betyr: custom events. approval.requested og approval.granted som span-events på root-spanen, med attributter som wait_duration_ms, risk_level, approver_id og approval_id.
Hvorfor det er viktig? To metrikker faller rett ut: approval-latens (hvor lenge venter arbeidsflyten på et menneske?) og approval-rate (hvor ofte blir noe godkjent vs. avvist?). En økende avvisningsrate er et signal. Enten foreslår agenten stadig mer tvilsomme handlinger - eller så er kriteriene for godkjenning for strenge. Begge deler vil jeg vite.
Hva som IKKE hører hjemme i tracen
AI-workloads produserer 10-50x mer telemetri enn klassiske tjenester. Hvert LLM-call har en prompt, en completion og ofte flere tool-calls med resultater. Fristelsen til å logge alt er stor.
Metadata og referanser er default. Token-counts, modellversjon, finish-reason, verktøynavn, varighet - ja. Fullstendig prompttekst, API-nøkler, rå tilbakemeldinger fra kunder - nei. Ikke fordi det er teknisk umulig, men fordi det normalt er unødvendig.
Break-glass-arkitektur: Når du likevel trenger hele innholdet
Noen ganger holder ikke metadata. En hallusinasjons-incident, en eskalert kundesak - da trenger jeg den faktiske prompten og completionen. Løsningen er ikke et enten-eller-valg, men en arkitektur med to spor (lanes):
Production lane: minimerte events, bare metadata og referanser. Lang retention, lav risiko. Det er normaltilstanden.
Break-glass lane: fullt innhold, aktivert av en navngitt approver med dokumentert begrunnelse. Kort retention (24-72 t), automatisk sletting, komplett audit-trail. Hver tilgang er sporbar.
Mønsteret er ikke nytt - det er samme prinsipp som ved tilgang til produksjonsdatabaser eller escrow av krypteringsnøkler. Forskjellen: I AI-workloads er datamengden per request så stor at default-lanen virkelig må være minimal for at break-glass-lanen i det hele tatt skal være håndterbar.
Hva OpenTelemetry leverer - og hva det ikke leverer
Den som setter seg inn i Observability for AI-funksjoner, støter på OpenTelemetry GenAI Semantic Conventions. Spesifikasjonen finnes, den vokser, den har momentum. Men den har også et problem: Per april 2026 er ikke ett eneste attributt Stable. Alt har statusen «Development». Den som bruker conventions i dag, må sette OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental - og dermed akseptere at attributter kan få nye navn når som helst.
Det betyr ikke at spesifikasjonen er ubrukelig. Det betyr at vi må vite hva den kan - og fremfor alt hva den ikke kan. (Kort begrepsavklaring: Spesifikasjonen bruker statusen «Development», men opt-in-variabelen heter experimental - en historisk rest. Det betyr det samme.)
Hva spesifikasjonen dekker
Conventions definerer span-typer for de viktigste operasjonene: chat, text_completion, embeddings, execute_tool, invoke_agent, invoke_workflow. I tillegg kommer kjerneattributter som gen_ai.provider.name, gen_ai.request.model, token-counts og finish-reasons. På metrikksiden finnes gen_ai.client.token.usage som histogram, gen_ai.client.operation.duration og streaming-metrikker som gen_ai.server.time_to_first_token.
Nyere tillegg er MCP-conventions (mcp.method.name, mcp.session.id), agent-spans (invoke_agent, invoke_workflow) og et gen_ai.evaluation.result-event med score og label. Retningen er riktig.
Hva spesifikasjonen ikke dekker
Hullene gjelder akkurat de tingene som utgjør forskjellen i drift:
- Kostnadssporing: Ikke noe
gen_ai.cost-attributt. API-ene til leverandørene leverer token-counts, men ikke priser. Plattformer som Langfuse eller Helicone løser det med vedlikeholdte pristabeller - men på spesifikasjonsnivå er kostnadsberegning noe du må løse selv. - Prompt-versjonering: Ikke noe konsept for prompt-registries. Hvilken versjon av system-prompten til refund-agenten som førte til hvilket resultat - ikke dekket.
- Brukertilbakemeldinger: Ikke noe standardisert tommel opp/ned-event. Koblingen mellom trace og brukerens vurdering finnes ikke i spesifikasjonen.
- Approval og HITL: Ingen convention for pause/resume-events. Når et menneske grep inn, og hvorfor - usynlig.
- Guardrails: Ikke noe event for content-filtering eller safety-sjekker. Om en output ble filtrert - ikke tatt høyde for.
Spesifikasjonen leverer skjelettet: modell, leverandør, tokens, latens. Alt som gjør AI-funksjoner om fra leketøy til produksjonssystem - kostnader, versjoner, tilbakemeldinger, governance - ligger utenfor conventions.
Deprecated attributter - hva som allerede har endret seg
Den som startet tidlig med conventions, må migrere: gen_ai.system heter nå gen_ai.provider.name, gen_ai.usage.prompt_tokens ble til gen_ai.usage.input_tokens, gen_ai.usage.completion_tokens til gen_ai.usage.output_tokens. En forsmak på hva statusen «Development» betyr i praksis.

OTel GenAI Conventions er et godt utgangspunkt - men den som stoler på at spesifikasjonen dekker alle krav til Observability, får seg en overraskelse i produksjon.
De seks vanligste feilene ved LLM-Observability
Observability for AI-funksjoner er fortsatt ungt. Men noen feller dukker allerede opp igjen og igjen i post-mortems og engineering-blogger. Seks anti-patterns:
1. Logge alt, korrelere ingenting
Applikasjonslogger finnes. Mange av dem. Et sted står det at et LLM-call har skjedd. Et annet sted står det at et verktøy ble kalt. Men hvilken kundesak hører det til? Hvilket agent-steg utløste callet?
Uten trace-ID-er som binder det sammen, er logger bare støy med tidsstempler. Når refund-agenten bekrefter en refusjon som aldri kom frem, vil jeg ikke lete i tre ulike loggstrømmer - jeg vil ha én trace som viser meg hele saken.
2. Logge prompter fullstendig i produksjon
Som beskrevet i trace-kapittelet: Content-events skal være opt-in, ikke opt-out. Likevel blir ofte alt logget - av frykt for å gå glipp av noe under en incident. Resultatet: eksploderende lagringskostnader og PII i Observability-backenden. Det bedre spørsmålet er ikke «Hva kunne vi trenge?», men «Hvilke metadata holder for 95 % av tilfellene - og hvordan får vi tak i resten når vi trenger det?» Break-glass-arkitekturen skissert over løser akkurat det.
3. Token-counts uten kostnadsfordeling
«Vi bruker 2 millioner tokens om dagen.» - «Til hva?» - Stillhet.
Globale token-counts er et tall på et dashboard. Ikke noe mer. Uten metadata-tagging på hver API-request - user_id, feature_name, agent_name - er det umulig å svare på hvilken funksjon som driver kostnadene. Er det refund-agenten? Oppsummeringen? Routingen? Kostnadsoptimalisering uten attribusjon er gjetting.
4. Bare instrumentere happy path
Dette er den farligste feilen. Feil i verktøy, retries, avbrutte kjeder - alt usynlig. Error rate ser fin ut, fordi bare vellykkede avslutninger blir talt med.
Regn på det: 10 agent-steg med 99 % accuracy hver ender på 90 % total accuracy. Og hver usynlige retry ganger opp kostnader og latens uten at noen merker det. Error-spans, retry-counts og sporing av finish-reason hører hjemme på hvert steg - ikke bare på det siste.
Det du ikke måler, optimaliserer du ikke. Det du ikke ser, ignorerer du - helt til det blir en incident.
5. Observability som ettertanke
«Vi tar funksjonene først, så Observability.» Det høres pragmatisk ut. I praksis betyr det: Ved første incident har du ingen data. Ingen trace, ingen span, ingen versjonsinformasjon. Bare antagelser.
Observability er en arkitekturbeslutning, ikke en ops-oppgave for sprint 12. Trace-kontekst, span-struktur og metadata-skjema må være på plass før den første funksjonen går live. Å instrumentere i etterkant betyr å bryte opp alle abstraksjoner i etterkant.
Michael Seel tar i «AI Systems Architecture: Governance» neste steg: Observability hører ikke bare hjemme i teamets backlog, men i plattformen - ellers oppstår shadow AI på samme måte som shadow IT.

6. Dashboard-cargo-cult
Latensgraf. Token-count-graf. Error-rate-måler. Tre dashboards, tolv paneler, null innsikt. Ingen ser på dem før det skjer en incident - og da hjelper de ikke, fordi de svarer på feil spørsmål.
Et dashboard som viser «requests per minutt», svarer ikke på ett eneste driftsspørsmål. Hvor høy er hallusinasjonsraten? Hvilken agent-sti koster mest? Finnes det prompt-drift? Dashboards må muliggjøre beslutninger, ikke pynte på metrikker.
Modenhetsmodell: Fra Blind til Diagnostic
Det finnes ingen offisiell «LLM Observability Maturity Model» - ingen ISO-standard, ingen PDF med Gartner-kvadranter. Men når jeg ser på hvordan Honeycomb, LangChain og Portkey beskriver temaet, tegner det seg en tydelig progresjon. Jeg har kokt den ned til fem nivåer - ikke som et akademisk rammeverk, men som et vurderingsskjema for ett spørsmål: Hvor står vi, og hva er det neste fornuftige steget?
| Nivå | Navn | Kjennetegn | Hvilke av de fem spørsmålene som besvares |
|---|---|---|---|
| 0 | Blind | Ingen traces, bare applikasjonslogger | Ingen. Hver incident er spekulasjon. |
| 1 | Basic | Request/response-logging, token-counts | Spørsmål 2 (kostnader) delvis - men uten svar på hvor og hvorfor. |
| 2 | Structured | OTel-traces med GenAI-conventions, tool-spans | Spørsmål 1 (debugging), 3 (latens), 4 (kvalitet). |
| 3 | Operational | Dashboards, alerts på kostnader/latens/feilrate | Spørsmål 1-4 proaktivt. Kostnadskontroll. SLO-er. |
| 4 | Diagnostic | Trace-til-eval-pipeline, drift-deteksjon | Alle fem spørsmålene - pluss feedback-loop inn i evalene. |
De fleste team er mellom nivå 0 og 1. Nivå 2 er det fornuftige neste steget.
Det er ikke en antagelse. Den som i dag har console.log("LLM response:", result) i produksjon, er på nivå 1. Den som ikke engang har det - nivå 0. Begge deler betyr: Når noe går galt, blir det gjettet i stedet for diagnostisert.
Nivå 2 - strukturerte traces med OpenTelemetry og GenAI Semantic Conventions - er punktet der debugging slutter å være en gjettelek. Her blir enkelt-requests sporbare: Hvilken prompt gikk inn, hvilken modell svarte, hvilke verktøy ble kalt, hvor lang tid tok hvert steg. Det er oppnåelig med overkommelig innsats - og lønner seg fra første incident.
Nivå 3 krever mer enn tooling - det krever organisatorisk modenhet. Alle kan bygge dashboards. Men å definere meningsfulle alerts, formulere SLO-er for AI-funksjoner, håndheve kostnadsbudsjetter per funksjon - det er beslutninger et team må ta sammen.
Nivå 4 er der Observability og evals vokser sammen. Produksjonstraces flyter tilbake inn i eval-pipelinen. En incident blir ikke bare fikset, men forankret som regresjonstest. I evals-innlegget skrev jeg at evals uten tilbakemeldinger fra produksjon blir utdaterte - nivå 4 tetter akkurat det hullet.

Valg av tooling: Hvilket oppsett passer?
«Hvilket Observability-verktøy skal jeg velge?» - Det kommer an på. Men ikke på features - det kommer an på hvilke lag jeg må dekke.
Tolagsmodellen
Observability for AI-funksjoner deler seg i to grunnleggende forskjellige problemstillinger:
Layer 1: Infrastruktur-Observability. Står det bra til med systemet? Hvor høy er latensen? Hvor faller requests ut? Dette er domenet til OpenTelemetry - distributed tracing, metrikker, logger. GenAI Semantic Conventions utvider OTel med LLM-spesifikke attributter som gen_ai.usage.input_tokens eller gen_ai.request.model. Den som allerede har et OTel-oppsett, får dermed infrastrukturperspektivet på AI-calls nesten gratis.
Layer 2: Observability på promptnivå. Produserer AI-en gode outputs? Hvilken promptversjon presterer bedre? Hvor hallusinerer modellen? Disse spørsmålene svarer ikke OTel på alene - til det trenger jeg en dedikert LLM-plattform med prompt-playground, eval-pipelines og session-tracking.
De to lagene svarer på ulike spørsmål. Å presse begge inn i ett verktøy er et kompromiss i begge retninger.
Tre scenarioer
Et team med OTel i stacken? Da utfyller GenAI Semantic Conventions infrastrukturperspektivet, og Langfuse (eller en tilsvarende plattform) legger seg oppå for Observability på promptnivå.
Greenfield AI-prosjekt? For startups: Langfuse Cloud, ferdig. Raskere kommer du ikke i gang. For større organisasjoner: Planlegg OTel fra dag 1 - å ettermontere det blir dyrere for hver tjeneste. Pluss en LLM-plattform for det andre laget.
Krav til compliance? Da er det self-hosting som teller. Langfuse kan self-hostes fullt ut og er det tydeligste alternativet. LangSmith og Braintrust tilbyr self-hosting i enterprise-nivået, men med høyere infrastrukturinnsats og begrenset kontroll. Helicone er open source og kan også self-hostes. Den som ikke kan gi fra seg data, har alternativer - men terskelen for å komme i gang varierer betydelig.
Eller: bygge selv?
Et berettiget innspill: Med AI-hjelp kan man jo plugge sammen en slik Observability-stack på noen kvelder. Det stemmer - for Layer 1. OTel-SDK, Grafana Tempo eller Jaeger som backend, Grafana-dashboards, noen egne span-attributter for gen_ai.*. Kostnadstabell som JSON, promptversjoner som hash i spanen. Det er ikke rakettforskning, og jeg er den siste som vil fraråde det - tvert imot.
Layer 2 er den tøffere delen. Prompt-registry med diff-visning mellom versjoner, eval-pipelines med LLM-as-judge, session-threading over lange samtaler, innsamling av feedback med UI for produkt og QA. Det er ikke «noen kvelder» - det er en egen plattform.
Den pragmatiske varianten: Bygg Layer 1 selv, koble på en plattform for Layer 2. Langfuse kan kobles til en hjemmesnekret Layer 1-stack via en OTel-bridge - best of both.
Kortvurderinger: Langfuse, Arize Phoenix, LangSmith, Helicone, Braintrust
Langfuse - Den sterkeste open source-totalpakken. Kan self-hostes, OTel-bridge for infrastrukturkoblingen, prompt-management, eval-pipelines. Communityen vokser raskt, og plattformen dekker i økende grad begge lag. For de fleste team den tryggeste starten.
Arize Phoenix - Best-in-class for RAG-debugging og embedding-analyse. Local-first, ideell for utviklingsfasen. Den som jobber mye med retrieval og vil forstå chunk-relevans, finner de beste verktøyene her.
LangSmith - Det naturlige valget for team som allerede jobber i LangChain-økosystemet. Dyp integrasjon, god developer experience. Self-hosting er tilgjengelig som enterprise-tillegg, men krever betydelig infrastruktur (16+ vCPU, 64+ GB RAM). Den som ikke er bundet til LangChain, har liten grunn til å starte her.
Helicone - Open source (MIT-lisens) og kan self-hostes. I sky-varianten den aller raskeste veien inn: bytt proxy-URL, ferdig. Bra for første innsikt i kostnader og latens. Self-hosted omgår compliance-problemet med proxy-tilnærmingen.
Braintrust - Det sterkeste eval-rammeverket i sammenligningen. Den som vil etablere systematisk evaluering som kjerneprosess, finner de mest modne verktøyene her. Self-hosting i enterprise-nivået som hybridmodell: data plane i egen konto, control plane hos Braintrust.
Hvordan alt henger sammen
Dette innlegget står ikke alene. Det er den logiske konsekvensen av alt som er skrevet de siste ukene - og det operasjonaliserer konseptene fra de forrige innleggene:
- Contracts som grunnlag - skjemavalidering mot modelloutputen. I Observability-verdenen blir denne valideringen et span-attributt: Passet skjemaet? Når, hvor og hvor ofte passet det ikke?
- Evals lever ikke bare i CI. Produksjonstraces blir til eval-datasett - den åpne tråden «evals uten tilbakemeldinger fra produksjon blir utdaterte» blir innfridd her.
- Verktøysikkerhet blir håndgripelig gjennom tool-spans. En False Success - verktøyet melder suksess, men ingenting har skjedd - blir først synlig når tool-spanen bærer den faktiske responsen fra backend som event.
- Human-in-the-Loop etterlater approval-events i tracen. Og rubber-stamp-deteksjonen jeg beskrev der som design-pattern? Den blir en metrikk: gjennomsnittlig review-tid, reject-rate, approval uten endring i kontekst.
Og for den som tror Observability er valgfritt
EUs AI-forordning (EU AI Act) gjør det til en plikt.

Art. 12 krever «automatic recording of events» for høyrisikosystemer - og mener ikke console.log med det. Art. 12 krever at en deployer forstår hva systemet har gjort. Art. 14 krever Human Oversight med evnen til å «tolke systemets kapasiteter og begrensninger riktig» - uten traces er det et tomt krav. Art. 19 fastsetter en oppbevaringstid på minst seks måneder. Og Art. 72 krever post-market monitoring - altså nettopp den systematiske analysen av produksjonsdata som dette innlegget beskriver.
EU AI Act - de relevante artiklene
- Art. 12 - Record-keeping: Høyrisikosystemer må ha automatisk registrering av hendelser (logger) som sikrer sporbarhet gjennom hele levetiden.
- Art. 14 - Human Oversight: De som fører tilsyn, må kunne tolke systemets kapasiteter og begrensninger. Forutsetter tilgang til traces og metrikker.
- Art. 19 - Oppbevaringsplikt: Logger må lagres i minst 6 måneder.
- Art. 72 - Post-market monitoring: Leverandører må samle inn og analysere produksjonsdata systematisk.
Fristen for høyrisikopliktene er august 2026. Disse artiklene danner en regulatorisk kjede som krever nøyaktig den Observability-infrastrukturen dette innlegget beskriver. Den som bygger den uansett, har det tekniske grunnlaget for compliance. Den som ikke bygger den, får snart et problem.
Et blikk fremover: Fra traces til regresjonstester
Det neste logiske steget er trace-til-eval-pipelinen. En incident i produksjon - et hallusinert beløp, en False Success, et oversett edge case - blir en trace. Tracen blir et eval-datasett. Eval-datasettet blir en permanent regresjonstest i CI. Ingen incident skal få skje to ganger på samme måte.
Observability er ikke et ops-tema. Uten det forblir Contracts, evals og Human Oversight konsepter jeg ikke ser når de ryker.