
Utan traces, modell- och promptversioner, tool-spans och kostnadsmått förblir varje incident spekulation.
I fyra inlägg har jag skrivit om principer: contracts, evals, verktygssäkerhet, human oversight. Allt rätt – men hur ser jag i drift om allt det där faktiskt fungerar?
Utan strukturerad observability: inte alls. En false success i refund-agenten – verktyget rapporterar framgång, kunden väntar på sina pengar – går inte att hitta med applikationsloggar och error rates. Allt är grönt. Systemet har inte fallerat, det har ljugit.
Det här inlägget visar vilken observability-infrastruktur team behöver när de kör AI-funktioner live. Vilka frågor måste jag kunna besvara? Hur ser en bra trace ut? Och hur bedömer jag var jag själv står?

Fem frågor före verktygen
Hur hade jag kunnat debugga det på 30 sekunder?
Inte med grep i loggfiler. Inte med en dashboard som visar uptime och error rate – för båda var gröna. Inget fel, inget larm, bara ett felaktigt resultat.
Traditionella mått fångar inte AI-specifika fel. False success, fel val av verktyg eller hallucinerade åtgärder förblir osynliga så länge jag bara tittar på HTTP-statuskoder och antal exceptions. Problemet sitter djupare – i agentens beslutslogik och i hur den tolkar verktygens svar. Mellan turerna går kontext förlorad utan att någon loggfil säger ett ord om det.
Innan jag pratar om verktyg: fem frågor som varje team borde kunna besvara.
1. Debugging: Varför sa agenten X till kunden fast Y hände?
Refund-agenten säger ”återbetalningen är skickad”. Men refund_order returnerade ett fel – eller anropades inte ens. Utan en korrelerad trace med resultaten från tool calls, modellens input och modellens output är det gissningslek. Jag behöver en kedja: användarens input, routingbeslut, tool-intent, tool-resultat, genererat svar. Utan luckor.
2. Kostnad: Vad kostar ett genomsnittligt supportärende – och vilken agentväg drar mest tokens?
Alla supportärenden kostar inte lika mycket. En enkel FAQ-lookup kostar några hundra tokens. Ett refund-flöde med identitetskontroll, orderuppslag och approval-loop kan snabbt dra tjugo gånger så mycket. Utan token-attribution per agent, verktyg och konversation ser jag bara en månadsfaktura – men inte vart pengarna tar vägen.
3. Latens: Var fastnar agenten – i modellanropet, i tool-callet eller i retrievalen?
Användaren väntar. Men på vad? På modellen som behöver 3 sekunder för svaret? På lookup_order-anropet som går mot en långsam databas? Eller på ett retrieval-system som samlar ihop kontexten? En span-baserad uppdelning av latensen är ingen nice-to-have – det är det enda sättet att optimera riktat i stället för att gissa.
4. Kvalitet: Hur ofta väljer agenten fel verktyg? Hur ofta behöver den flera försök?
Agenten har fyra verktyg att välja mellan. Hur ofta väljer den rätt? Hur ofta anropar den lookup_order fast den borde ha anropat verify_customer – och rättar sig först vid andra försöket? Spårning av verktygsval och antal retries visar mig var modellen systematiskt slår fel. Det är inga edge cases – det är signaler om promptproblem eller saknade tool descriptions.
5. Compliance: Kan jag följa hela beslutsvägen för ett konkret kundärende?
En kund ringer och vill veta varför återbetalningen aldrig kom fram. Regelverket kräver spårbarhet. Jag behöver en audit trail som visar: vilken agent anropade vilket verktyg när, vilka approval-events fanns, vem godkände vad? Utan det är varje kundärende en black box.
Fem frågor, fem olika krav på observability. Och ändå händer ofta samma sak i praktiken: man kopplar in ett tracing-verktyg, skriver några spans – och sedan hoppas alla att rätt data redan finns med.
I de flesta team är det inte verktygen som saknas – det är klarheten kring vilka driftfrågor som måste besvaras.
Anatomin hos en trace
Fem frågor. Ingen dashboard som besvarar dem. Det ändrar vi på.
Vi tar refund-agenten och tittar på vad en enda supportförfrågan genererar som trace – om vi instrumenterar den rätt:
[ROOT] invoke_agent support-request
├── [LLM] chat gpt-5.4-nano (routingbeslut)
│   ├── gen_ai.usage.input_tokens: 674
│   ├── gen_ai.response.finish_reasons: ["tool-calls"]
│   └── gen_ai.response.model: gpt-5.4-nano
├── [TOOL] execute_tool lookup_order
├── [TOOL] execute_tool verify_customer
├── [EVENT] approval.requested (HITL-paus)
│   └── wait_duration_ms, risk_level, tool_arguments
├── [EVENT] approval.granted (HITL-resume)
│   └── approver_id, approval_id, justification
├── [TOOL] execute_tool refund_order (post-approval)
└── [LLM] chat gpt-5.4-nano (slutligt svar)
    ├── gen_ai.usage.input_tokens: 4083
    ├── gen_ai.response.finish_reasons: ["stop"]
    └── gen_ai.response.model: gpt-5.4-nano
En trace, sju child-spans. Var och en besvarar en annan fråga.
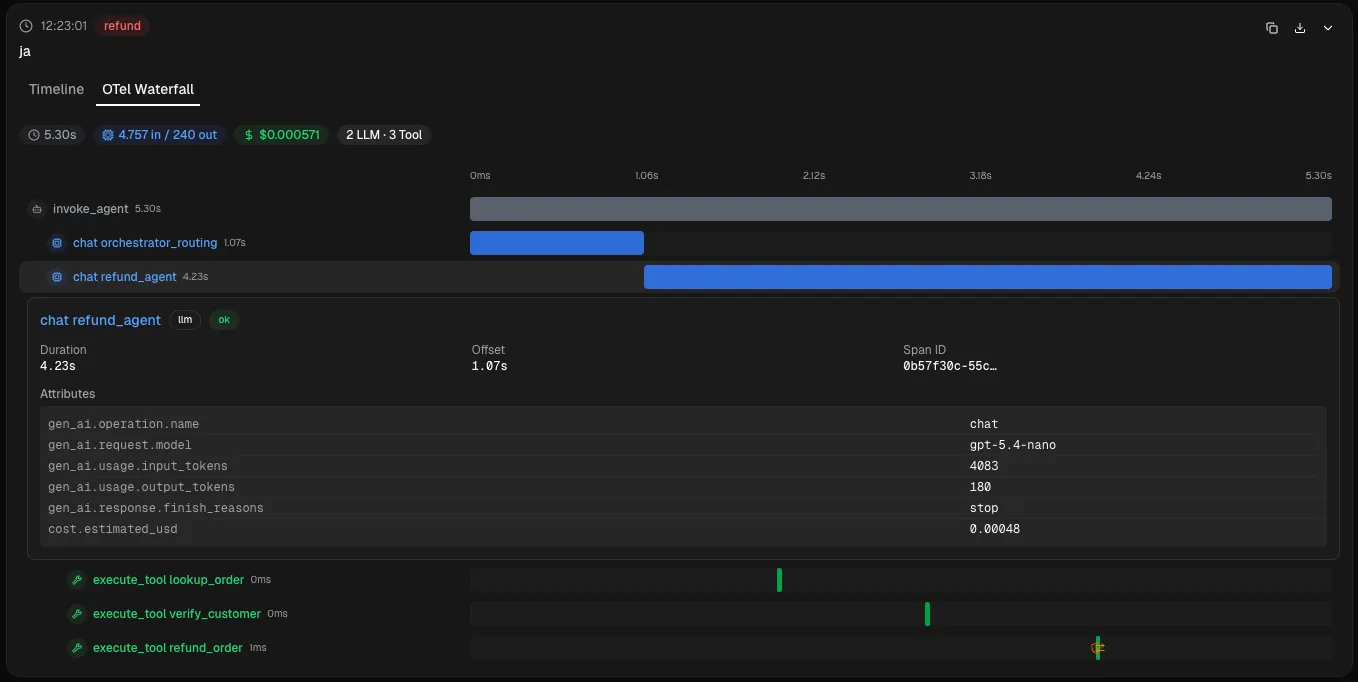
Låt oss titta närmare.
Tre typer av spans, tre perspektiv
LLM-anrop (chat) är interaktionerna med modellen. Varje span bär antal tokens (gen_ai.usage.input_tokens, gen_ai.usage.output_tokens), den modell som faktiskt användes (gen_ai.response.model – inte alltid samma som den som efterfrågades) och finish reason. Tre LLM-anrop i en förfrågan? Det är tre kostnadsposter (fråga 2), tre bidrag till latensen (fråga 3), tre potentiella felkällor.
Tool executions (execute_tool) fångar varje verktygsanrop med argument och resultat. verify_customer tog 40 ms och returnerade valid: true? Står i spanen. refund_order misslyckades med en timeout? Står också i spanen – och där har jag svaret på fråga 1: varför bekräftade agenten något för kunden som aldrig hände?
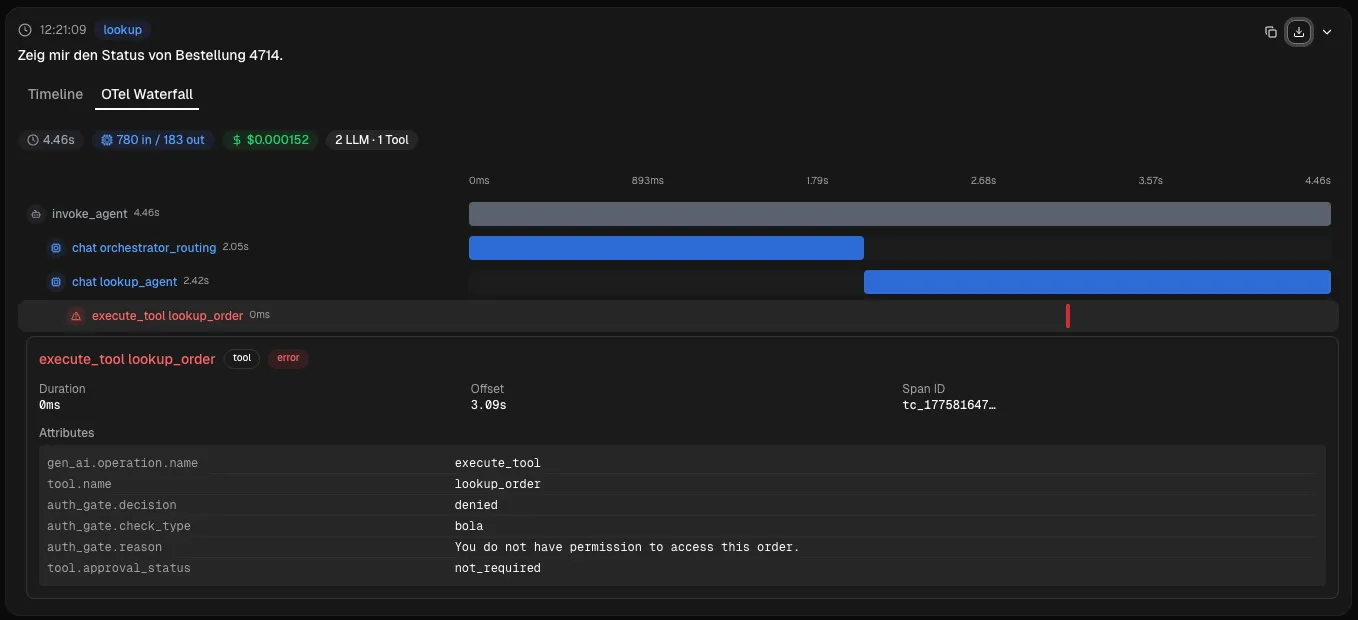
Agent orchestration (invoke_agent) är root-spanen – den håller ihop allt. Total tid, total kostnad, slutlig status. Vill jag veta om refund-agenten blir långsammare tittar jag här. Vill jag veta varför tittar jag i child-spansen.
Context propagation: vem utlöste vad?
En trace utan kontext är en datapunkt utan koordinatsystem – tekniskt korrekt, praktiskt oanvändbar. Den avgörande frågan vid en incident är aldrig ”Vad gjorde agenten?” utan ”Vad gjorde agenten för vilken kund i vilket ärende?”
OpenTelemetry Baggage och attribut på root-spanen löser det: session.id, user.id, ticket.id följer med som baggage genom hela tracen. Varje span ärver kontexten. Om refund-agenten betalade tillbaka fel belopp klockan 14:32 hittar jag hela tracen via ticket.id på några sekunder – inte genom loggfilsarkeologi.
Approval-events i tracen
I HITL-inlägget handlade det om arkitekturen bakom approval-gates. Här handlar det om att göra dem synliga.

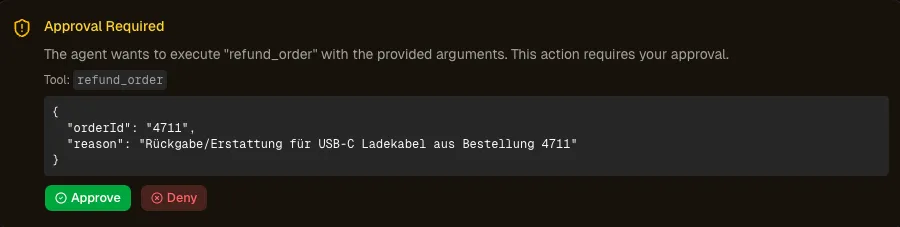
I april 2026 finns det ingen standardiserad OTel-konvention för approval-events. Det betyder: custom events. approval.requested och approval.granted som span-events på root-spanen, med attribut som wait_duration_ms, risk_level, approver_id och approval_id.
Varför spelar det roll? Två mått faller ut direkt: approval-latens (hur länge väntar arbetsflödet på en människa?) och approval-rate (hur ofta godkänns det vs. avslås?). En stigande andel avslag är en signal. Antingen föreslår agenten allt tvivelaktigare åtgärder – eller så är kriterierna för approval för stränga. I båda fallen vill jag veta om det.
Vad som INTE hör hemma i tracen
AI-workloads genererar 10–50 gånger mer telemetri än klassiska tjänster. Varje LLM-anrop har en prompt, en completion och ofta flera tool calls med resultat. Frestelsen att logga allt är stor.
Metadata och referenser är default. Antal tokens, modellversion, finish reason, verktygsnamn, tid – ja. Fullständig prompttext, API-nycklar, rå kundfeedback – nej. Inte för att det vore tekniskt omöjligt, utan för att det i normalfallet är onödigt.
Break glass-arkitektur: när du ändå behöver hela innehållet
Ibland räcker inte metadata. En hallucinationsincident, ett eskalerat kundärende – då behöver jag den faktiska prompten och completionen. Lösningen är inget antingen–eller-beslut utan en arkitektur med två spår:
Production lane: minimerade events, bara metadata och referenser. Lång retention, låg risk. Det är normaltillståndet.
Break glass lane: fullt innehåll, aktiverat av en namngiven godkännare med dokumenterad motivering. Kort retention (24–72 h), automatisk radering, fullständig audit trail. Varje åtkomst går att spåra.
Mönstret är inte nytt – det är samma princip som vid åtkomst till produktionsdatabaser eller key escrow för krypteringsnycklar. Skillnaden: i AI-workloads är datavolymen per förfrågan så hög att default-spåret verkligen måste vara minimalt för att break glass-spåret ska gå att hantera överhuvudtaget.
Vad OpenTelemetry levererar – och vad det inte gör
Den som sätter sig in i observability för AI-funktioner stöter på OpenTelemetry GenAI Semantic Conventions. Specen finns, den växer, den har momentum. Men den har också ett problem: i april 2026 är inte ett enda attribut stable. Allt har status ”Development”. Den som använder konventionerna i dag måste sätta OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental – och därmed acceptera att attribut kan byta namn när som helst.
Det betyder inte att specen är oanvändbar. Det betyder att vi måste veta vad den klarar – och framför allt vad den inte klarar. (En kort begreppsförklaring: specen använder statusen ”Development”, men opt-in-variabeln heter experimental – en historisk kvarleva. Det betyder samma sak.)
Vad specen täcker
Konventionerna definierar span-typer för de viktigaste operationerna: chat, text_completion, embeddings, execute_tool, invoke_agent, invoke_workflow. Till det kommer kärnattribut som gen_ai.provider.name, gen_ai.request.model, antal tokens och finish reasons. På metrics-sidan finns gen_ai.client.token.usage som histogram, gen_ai.client.operation.duration och streaming-mått som gen_ai.server.time_to_first_token.
Nyare tillägg är MCP-konventioner (mcp.method.name, mcp.session.id), agent-spans (invoke_agent, invoke_workflow) och ett gen_ai.evaluation.result-event med score och label. Riktningen stämmer.
Vad specen inte täcker
Luckorna gäller just det som gör skillnad i drift:
- Kostnadsspårning: Inget
gen_ai.cost-attribut. Providerns API:er levererar antal tokens, men inga priser. Plattformar som Langfuse eller Helicone löser det med underhållna pristabeller – men på specnivå förblir kostnadsberäkning ett eget bygge. - Promptversionering: Inget koncept för prompt-registries. Vilken version av refund-agentens systemprompt som ledde till vilket resultat – inte täckt.
- Användarfeedback: Inget standardiserat tumme upp/ner-event. Kopplingen mellan trace och användarens bedömning finns inte i specen.
- Approval och HITL: Ingen konvention för pause/resume-events. När en människa grep in och varför – osynligt.
- Guardrails: Inget event för content filtering eller safety checks. Om en output filtrerades – finns inte med.
Specen levererar skelettet: modell, provider, tokens, latens. Allt som gör AI-funktioner till produktionssystem i stället för lekstuga – kostnader, versioner, feedback, governance – ligger utanför konventionerna.
Deprecated attributes – vad som redan har ändrats
Den som började tidigt med konventionerna måste migrera: gen_ai.system heter nu gen_ai.provider.name, gen_ai.usage.prompt_tokens blev gen_ai.usage.input_tokens, gen_ai.usage.completion_tokens blev gen_ai.usage.output_tokens. En försmak av vad statusen ”Development” betyder i praktiken.

OTel GenAI Conventions är en bra startpunkt – men den som förlitar sig på att specen täcker alla krav på observability får en överraskning i produktion.
De sex vanligaste misstagen med LLM-observability
Observability för AI-funktioner är fortfarande ungt. Men några fällor dyker redan upp om och om igen i post-mortems och engineering-bloggar. Sex anti-patterns:
1. Logga allt, korrelera ingenting
Applikationsloggar finns. Massor av dem. Någonstans står det att ett LLM-anrop har gjorts. Någon annanstans står det att ett verktyg anropades. Men vilket kundärende hör det till? Vilket agentsteg utlöste anropet?
Utan trace-ID:n som håller ihop allt är loggar bara brus med tidsstämplar. Om refund-agenten bekräftar en återbetalning som aldrig kom fram vill jag inte leta i tre olika loggströmmar – jag vill ha en trace som visar mig hela förloppet.
2. Logga prompts fullständigt i produktion
Som beskrevs i trace-avsnittet: content-events ska vara opt-in, inte opt-out. Ändå loggas ofta allt – av rädsla för att missa något vid en incident. Resultatet: exploderande lagringskostnader och PII i observability-backenden. Den bättre frågan är inte ”Vad skulle vi kunna behöva?” utan ”Vilken metadata räcker för 95 % av fallen – och hur kommer vi åt resten när vi behöver det?” Break glass-arkitekturen som skissades ovan löser just det.
3. Antal tokens utan kostnadsfördelning
”Vi förbrukar 2 miljoner tokens per dag.” – ”Till vad?” – Tystnad.
Ett globalt antal tokens är en siffra på en dashboard. Inte mer. Utan metadata-taggning på varje API-request – user_id, feature_name, agent_name – går det inte att svara på vilken funktion som driver kostnaderna. Är det refund-agenten? Sammanfattningen? Routingen? Kostnadsoptimering utan attribution är gissning.
4. Instrumentera bara happy path
Det här är det farligaste misstaget. Verktygsfel, retries, avbrutna kedjor – allt osynligt. Error rate ser bra ut, eftersom bara lyckade avslut räknas.
Räkna efter: 10 agentsteg med 99 % accuracy vardera landar på 90 % total accuracy. Och varje osynlig retry multiplicerar kostnad och latens utan att någon märker det. Error-spans, antal retries och spårning av finish reason hör hemma på varje steg – inte bara på det sista.
Det du inte mäter optimerar du inte. Det du inte ser ignorerar du – tills det blir en incident.
5. Observability i efterhand
”Vi gör funktionerna först, sedan observability.” Det låter pragmatiskt. I praktiken betyder det: vid första incidenten har du ingen data. Ingen trace, ingen span, ingen versionsinformation. Bara gissningar.
Observability är ett arkitekturbeslut, inte en ops-uppgift för sprint 12. Trace-kontext, span-struktur och metadata-schema måste vara på plats innan den första funktionen går live. Att instrumentera i efterhand betyder att bryta upp alla abstraktioner i efterhand.
Michael Seel tar nästa steg i ”AI Systems Architecture: Governance”: observability hör inte bara hemma i teamets backlog utan i plattformen – annars uppstår shadow AI, på samma sätt som shadow IT.

6. Dashboard-cargokult
Latensdiagram. Graf över antal tokens. Mätare för error rate. Tre dashboards, tolv paneler, noll insikter. Ingen tittar på dem förrän en incident inträffar – och då hjälper de inte, eftersom de besvarar fel frågor.
En dashboard som visar ”requests per minut” besvarar inte en enda driftfråga. Hur hög är hallucinationsgraden? Vilken agentväg kostar mest? Finns det prompt drift? Dashboards ska ge underlag för beslut, inte vara dekoration med mått.
Mognadsmodell: från Blind till Diagnostic
Det finns ingen officiell ”LLM Observability Maturity Model” – ingen ISO-standard, ingen Gartner-kvadrant som PDF. Men när jag tittar på hur Honeycomb, LangChain och Portkey beskriver ämnet framträder en tydlig progression. Jag har kokat ner den till fem nivåer – inte som ett akademiskt ramverk, utan som ett bedömningsraster för en enda fråga: Var står vi, och vad är nästa rimliga steg?
| Nivå | Namn | Kännetecken | Vilka av de fem frågorna som besvaras |
|---|---|---|---|
| 0 | Blind | Inga traces, bara applikationsloggar | Inga. Varje incident är spekulation. |
| 1 | Basic | Loggning av request/response, antal tokens | Fråga 2 (kostnad) delvis – men utan svar på var och varför. |
| 2 | Structured | OTel-traces med GenAI-konventioner, tool-spans | Fråga 1 (debugging), 3 (latens), 4 (kvalitet). |
| 3 | Operational | Dashboards, larm på kostnad/latens/felfrekvens | Fråga 1–4 proaktivt. Kostnadsstyrning. SLO:er. |
| 4 | Diagnostic | Pipeline från trace till eval, upptäckt av drift | Alla fem frågorna – plus en feedback-loop in i evalsen. |
De flesta team befinner sig mellan nivå 0 och 1. Nivå 2 är det rimliga nästa steget.
Det är ingen gissning. Den som i dag har console.log("LLM response:", result) i produktion är på nivå 1. Den som inte ens har det – nivå 0. Båda innebär: när något går fel gissar man i stället för att diagnostisera.
Nivå 2 – structured traces med OpenTelemetry och GenAI Semantic Conventions – är punkten där debugging slutar vara en gissningslek. Här blir enskilda förfrågningar spårbara: vilken prompt gick in, vilken modell svarade, vilka verktyg anropades, hur lång tid tog varje steg. Det går att nå med rimlig insats – och betalar sig från första incidenten.
Nivå 3 kräver mer än verktyg – den kräver organisatorisk mognad. Vem som helst kan bygga dashboards. Men att definiera meningsfulla larm, formulera SLO:er för AI-funktioner och driva igenom kostnadsbudgetar per funktion – det är beslut som ett team måste fatta tillsammans.
Nivå 4 är där observability och evals växer ihop. Produktions-traces flödar tillbaka in i eval-pipelinen. En incident blir inte bara fixad utan förankrad som regressionstest. I eval-inlägget skrev jag att evals utan feedback från produktion blir inaktuella – nivå 4 täpper till precis den luckan.

Val av verktyg: vilket setup passar?
”Vilket observability-verktyg ska jag ta?” – Det beror på. Men inte på funktioner – utan på vilka lager jag behöver täcka.
Tvålagersmodellen
Observability för AI-funktioner delas upp i två fundamentalt olika frågeställningar:
Layer 1: infrastruktur-observability. Mår systemet bra? Hur hög är latensen? Var bryts förfrågningar av? Det är OpenTelemetrys domän – distributed tracing, mått, loggar. GenAI Semantic Conventions bygger ut OTel med LLM-specifika attribut som gen_ai.usage.input_tokens eller gen_ai.request.model. Den som redan har ett OTel-setup får därmed infrastrukturvyn över AI-anropen nästan på köpet.
Layer 2: observability på promptnivå. Producerar AI:n bra output? Vilken promptversion presterar bättre? Var hallucinerar modellen? De frågorna besvarar inte OTel på egen hand – för det behöver jag en dedikerad LLM-plattform med prompt-playground, eval-pipelines och session-tracking.
De två lagren besvarar olika frågor. Att pressa in båda i ett verktyg är en kompromiss åt båda hållen.
Tre scenarier
Ett team med OTel i stacken? Då kompletterar GenAI Semantic Conventions infrastrukturvyn, och Langfuse (eller en jämförbar plattform) läggs ovanpå för observability på promptnivå.
Greenfield-AI-projekt? För startups: Langfuse Cloud, klart. Snabbare än så går det inte att komma igång. För större organisationer: planera in OTel från dag 1 – att bygga in det i efterhand blir dyrare för varje tjänst. Plus en LLM-plattform för det andra lagret.
Compliance-krav? Då är det self-hosting som gäller. Langfuse går att self-hosta fullt ut och är det tydligaste alternativet. LangSmith och Braintrust erbjuder self-hosting i enterprise-nivån, men med större infrastrukturinsats och begränsad kontroll. Helicone är open source och går också att self-hosta. Den som inte kan lämna ifrån sig data har alternativ – men tröskeln för att komma igång varierar kraftigt.
Eller: bygga själv?
En befogad invändning: med AI-stöd går det väl att koppla ihop en sådan observability-stack på några kvällar. Stämmer – för layer 1. OTel-SDK, Grafana Tempo eller Jaeger som backend, Grafana-dashboards, några egna span-attribut för gen_ai.*. Kostnadstabell som JSON, promptversioner som hash i spanen. Det är ingen raketforskning, och jag är den sista att avråda från det – tvärtom.
Layer 2 är den svårare delen. Prompt-registry med diff-vy mellan versioner, eval-pipelines med LLM-as-judge, session threading över långa konversationer, insamling av feedback med UI för product och QA. Det är inte ”några kvällar” – det är en egen plattform.
Den pragmatiska varianten: bygg layer 1 själv och docka på en plattform för layer 2. Langfuse kan anslutas via en OTel-brygga till en egenbyggd layer 1-stack – det bästa av två världar.
Korta bedömningar: Langfuse, Arize Phoenix, LangSmith, Helicone, Braintrust
Langfuse – Det starkaste helhetspaketet inom open source. Går att self-hosta, OTel-brygga för infrastrukturkopplingen, prompthantering, eval-pipelines. Communityn växer snabbt och plattformen täcker i allt högre grad båda lagren. För de flesta team den säkraste starten.
Arize Phoenix – Best-in-class för RAG-debugging och analys av embeddings. Local-first, idealiskt för utvecklingsfasen. Den som jobbar mycket med retrieval och vill förstå chunk-relevans hittar de bästa verktygen här.
LangSmith – Det naturliga valet för team som redan jobbar i LangChain-ekosystemet. Djup integration, bra developer experience. Self-hosting finns som enterprise-tillägg men kräver betydande infrastruktur (16+ vCPU, 64+ GB RAM). Den som inte är bunden till LangChain har liten anledning att börja här.
Helicone – Open source (MIT-licens) och går att self-hosta. I molnvarianten den snabbaste starten av alla: byt proxy-URL, klart. Bra för första insikter om kostnad och latens. Med self-hosting slipper man compliance-problemet med proxy-upplägget.
Braintrust – Det starkaste eval-ramverket i jämförelsen. Den som vill etablera systematiska utvärderingar som kärnprocess hittar de mest mogna verktygen här. Self-hosting i enterprise-nivån som hybridmodell: data plane i det egna kontot, control plane hos Braintrust.
Hur allt hänger ihop
Det här inlägget står inte för sig självt. Det är den logiska konsekvensen av allt som skrivits de senaste veckorna – och det operationaliserar koncepten från de tidigare inläggen:
- Contracts som grund – schemavalidering mot modellens output. I observability-världen blir den valideringen ett span-attribut: Passade schemat? När, var och hur ofta passade det inte?
- Evals lever inte bara i CI. Produktions-traces blir eval-dataset – den öppna tråden ”evals utan feedback från produktion blir inaktuella” knyts ihop här.
- Verktygssäkerhet blir gripbar genom tool-spans. En false success – verktyget rapporterar framgång, men ingenting har hänt – blir synlig först när tool-spanen bär det faktiska svaret från backenden som ett event.
- Human-in-the-loop lämnar approval-events efter sig i tracen. Och den rubber stamp-detektion som jag beskrev där som designmönster? Den blir ett mått: genomsnittlig review-tid, andel avslag, approval utan ändrad kontext.
Och för den som tror att observability är frivilligt
EU:s AI-förordning (AI Act) gör det till ett krav.

Art. 12 kräver ”automatic recording of events” för högrisksystem – och menar inte console.log. Art. 12 kräver att en deployer förstår vad systemet har gjort. Art. 14 kräver human oversight med förmågan att ”korrekt tolka systemets kapacitet och begränsningar” – utan traces är det ett tomt krav. Art. 19 föreskriver en lagringstid på minst sex månader. Och art. 72 kräver övervakning efter utsläppandet på marknaden (post-market monitoring) – alltså precis den systematiska analys av produktionsdata som det här inlägget beskriver.
EU:s AI-förordning – de relevanta artiklarna
- Art. 12 – Registrering: högrisksystem måste automatiskt registrera händelser (loggar) som säkerställer spårbarhet under hela livslängden.
- Art. 14 – Mänsklig tillsyn: de som utövar tillsyn måste kunna tolka systemets kapacitet och begränsningar. Förutsätter tillgång till traces och mått.
- Art. 19 – Lagringsskyldighet: loggar måste sparas i minst 6 månader.
- Art. 72 – Övervakning efter utsläppandet på marknaden: leverantörer måste systematiskt samla in och analysera produktionsdata.
Deadline för högriskkraven är augusti 2026. De här artiklarna bildar en regulatorisk kedja som kräver exakt den observability-infrastruktur som beskrivs i det här inlägget. Den som ändå bygger den har den tekniska grunden för compliance. Den som inte bygger den har snart ett problem.
Framåtblick: från traces till regressionstester
Nästa logiska steg är pipelinen från trace till eval. En incident i produktion – ett hallucinerat belopp, en false success, ett förbisett edge case – blir en trace. Tracen blir ett eval-dataset. Eval-datasetet blir ett permanent regressionstest i CI. Ingen incident får hända två gånger på samma sätt.
Observability är ingen ops-fråga. Utan den förblir contracts, evals och human oversight koncept som jag inte ser när de går sönder.