
Plus un agent est autonome, plus ce qui compte, c’est la qualité des points d’intervention humaine - pas leur suppression.
Un client veut un remboursement. Le Refund-Agent propose refund_order, les paramètres sont bons, l’autorisation est vérifiée. Et là : une bannière d’approbation. Le workflow se met en pause. Rien ne se passe tant qu’un humain n’a pas cliqué sur « Confirmer ».
Le premier réflexe ? « Pourquoi il ne peut pas simplement le faire ? »
Je connais ce réflexe. On construit des agents pour qu’ils fassent des choses à notre place - et ensuite, on leur met un panneau stop en travers du chemin. Ça ressemble à de la friction. À un retour en arrière. À l’inverse de l’automatisation. Sauf que refund_order déplace de l’argent. Du vrai argent. Et un agent capable de déplacer de l’argent en toute autonomie n’est pas une feature - c’est un risque.
Le requiresApproval: true dans le catalogue d’outils du Refund-Agent n’est pas un hasard. C’est une décision d’architecture - dans l’article précédent, j’ai présenté le policy gate comme partie de la « Definition of Done » des outils d’agent. Là-bas, require_approval était un point parmi d’autres. Ici, il devient le sujet central.

La pause n’est pas un bug, c’est de la gouvernance
Un point d’approbation dans un système d’agents suit un principe simple : l’agent propose, l’humain décide, le système exécute. Trois étapes, des responsabilités claires. Ça ressemble à de l’overhead - mais c’est de l’architecture.
Il est important de distinguer deux concepts souvent confondus : l’elicitation et les governance gates. L’elicitation, c’est quand l’agent demande activement des informations - « De quel numéro de commande parlez-vous ? » ou « Je génère le rapport de test en PDF ou en Markdown ? ». L’agent a besoin d’un input pour continuer. Un governance gate, c’est autre chose : le système impose une validation avant qu’une action irréversible soit exécutée. Pas parce que l’agent hésite, mais parce que l’action l’exige.
L’elicitation, c’est de l’UX. La gouvernance, c’est de l’architecture de sécurité.
L’analogie avec les reviews de pull requests est parlante : oui, les reviews de PR prennent du temps. Oui, c’est un goulot d’étranglement. Et pourtant, c’est la norme dans presque toutes les équipes professionnelles - parce que les dégâts causés par du code non contrôlé en production pèsent plus lourd que l’overhead. Les approval gates des agents reposent sur le même principe : un point d’arrêt imposé avant un changement d’état qu’on ne peut pas simplement annuler.
L’analyse d’Anthropic sur Claude Code apporte une observation intéressante : le modèle se met de lui-même en pause dans plus de 16 % des tours complexes - plus de deux fois plus souvent que les humains n’interrompent l’agent (environ 7 %). Le modèle reconnaît sa propre incertitude et agit en conséquence. Il n’attend pas qu’on l’arrête - il s’arrête lui-même.

« Building Effective Agents » d’Anthropic recommande exactement cela : les agents doivent pouvoir faire une pause à des checkpoints et attendre un feedback humain. La philosophie sous-jacente se résume à un principe que je considère comme central - Least Agency : ne donnez à l’agent que l’autonomie dont la tâche a réellement besoin. Pas plus.
Ceux qui ont lu attentivement mon article sur les Evals s’en souviennent peut-être : le Contract indiquait explicitement User-Approval: le workflow devrait se mettre en pause - comme décision de design délibérée, pas comme solution de fortune.

Le pause/resume est aux systèmes d’agents ce que les reviews de pull requests sont au code : pas une option, mais de l’assurance qualité.
Quand l’approbation est obligatoire - et quand elle ne l’est pas
Toutes les actions d’un agent n’ont pas besoin d’un humain. Faire valider lookup_order serait absurde. Mais laisser passer refund_order sans validation serait de la négligence. La question n’est pas binaire - c’est un modèle par paliers.
| Niveau de risque | Exemple | Action |
|---|---|---|
| Lecture seule | lookup_order, faq_search |
Auto-Allow |
| Mutation à faible risque | reset_password |
Logger, pas d’approbation |
| Mutation à haut risque | refund_order |
Approbation requise |
| Irréversible | delete_account |
Approbation + principe des quatre yeux |
La lecture seule n’est pas critique - l’agent lit des données, mais ne modifie aucun état. Ici, un approval gate ne fait que freiner le flux sans rien gagner en sécurité. Les mutations à faible risque modifient un état, mais l’impact est limité et réversible. Un nouveau mot de passe, l’utilisateur peut le réinitialiser lui-même. Logger suffit pour que l’audit trail reste complet. Les mutations à haut risque déplacent de l’argent, modifient des contrats ou touchent à des données sensibles - ici, un humain doit valider explicitement avant que le système n’exécute. Et les actions irréversibles comme la suppression d’un compte n’ont pas seulement besoin d’une approbation, mais du principe des quatre yeux : une deuxième personne confirme ce que la première a validé.
Le classement n’a rien d’une science - c’est une décision produit délibérée. Dans le Refund-Agent, ça donne concrètement ceci :
Ce modèle par paliers n’est pas un framework théorique. À partir d’août 2026, il devient aussi pertinent sur le plan réglementaire.
Règlement européen sur l'IA (AI Act), art. 14 : cinq capacités obligatoires à partir du 2 août 2026
Pour les systèmes à haut risque, l’AI Act impose cinq capacités concrètes de contrôle humain :
- Comprendre & surveiller - capacités, limites et détection d’anomalies (art. 14(4)(a))
- Conscience de l’automation bias - conscience de la confiance excessive dans les sorties de l’IA (art. 14(4)(b))
- Interpréter correctement les sorties - à l’aide d’outils d’interprétation (art. 14(4)(c))
- Override ou annulation - pouvoir annuler ou ignorer toute décision de l’IA (art. 14(4)(d))
- Intervenir ou arrêter - arrêt sûr via un bouton stop ou équivalent (art. 14(4)(e))
À noter : l’art. 14(4)(b) vise explicitement l’automation bias - des sciences comportementales inscrites dans le droit dur. En cas d’infraction, les amendes peuvent atteindre 15 millions d’euros ou 3 % du chiffre d’affaires annuel mondial.
Toutes les actions n’ont pas besoin d’un humain. Mais toute action risquée a besoin de la possibilité d’un humain. Et celle-ci doit être prévue dans l’architecture - pas vissée après coup.
Comment fonctionne techniquement un flux d’approbation
Du modèle par paliers à l’implémentation. Le pattern de base est étonnamment simple - la complexité se trouve ailleurs que là où la plupart des gens la cherchent.
Le pattern
Chaque flux d’approbation suit le même déroulé : l’agent formule une intention d’appel d’outil. Un policy gate vérifie si cette intention nécessite une autorisation. Si oui, l’exécution se met en pause, l’intention atterrit dans une file d’approbation, un humain décide - et c’est seulement alors que le tool call est réellement exécuté. Ou pas.
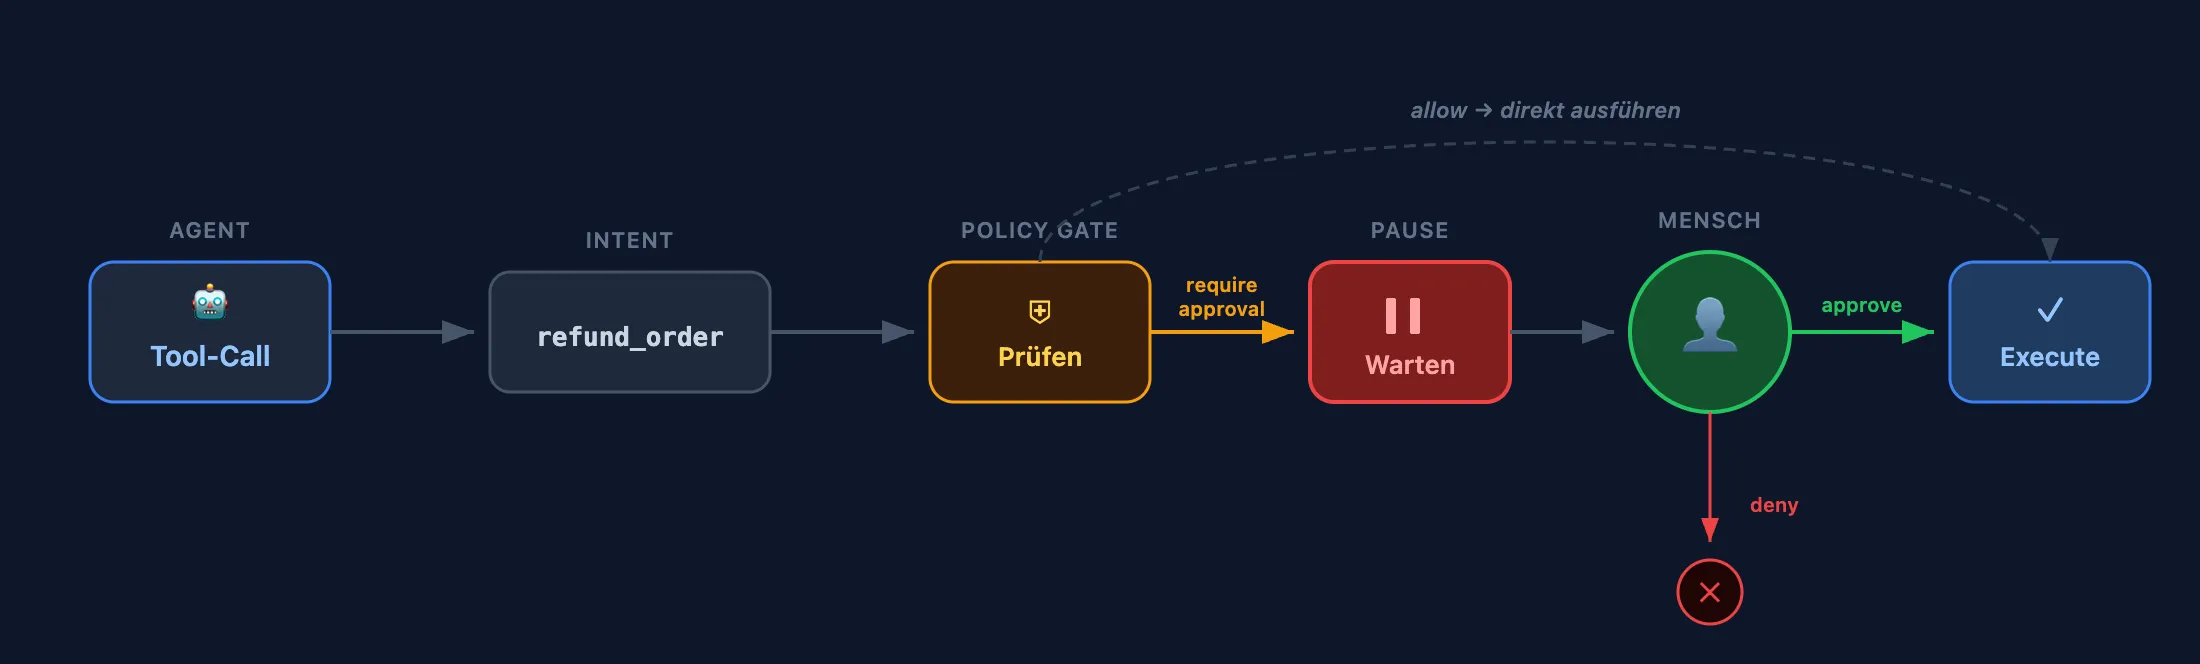
En code, ça demande étonnamment peu d’effort. Dans le Vercel AI SDK, un seul flag sur la définition de l’outil suffit :
const refundOrder = tool({
  description: 'Process a refund for an order',
  parameters: z.object({
    orderId: z.string(),
    reason: z.string(),
  }),
  needsApproval: true,
  execute: async ({ orderId, reason }) => {
    return await processRefund(orderId, reason);
  },
});
needsApproval: true - c’est tout. Le serveur attend que le client envoie une décision via addToolApprovalResponse. Approuvé ? Le tool call est exécuté. Refusé ? L’agent reçoit le refus comme contexte et peut réagir.
Le vrai défi ne réside pas dans le pattern lui-même, mais dans tout ce qui doit se passer autour : persistance de l’état, reprise après crash, et la question de ce qui arrive à une approbation qui ne tombe qu’au bout de trois heures.
Comparaison des SDK
| Dimension | Vercel AI SDK | OpenAI Agents SDK | LangGraph | Temporal |
|---|---|---|---|---|
| Mécanisme de pause | needsApproval sur l’outil |
needs_approval sur l’outil |
interrupt() dans le node |
workflow.wait_condition() |
| Persistance de l’état | État client (React) | Explicite via RunState.to_json() |
Checkpointer automatique | Event history automatique |
| Reprise après crash | Dépend de la session | Manuelle (réhydratation depuis la DB) | Dépend du checkpointer | Replay entièrement automatique |
| Cas d’usage idéal | UI de chat React/Next.js | Outils d’agent légers | Workflows basés sur des graphes | Enterprise long-running |
Vercel et OpenAI misent sur des flags déclaratifs directement sur l’outil - le point d’entrée le plus simple. LangGraph crée des checkpoints automatiquement, mais le code situé avant un interrupt() doit être idempotent, parce que tout le node est rejoué depuis le début au resume. Temporal joue dans une autre catégorie : temps d’attente pratiquement illimité, replay entièrement automatique en cas de crash, signals pour les décisions externes.
Approbation avec l'OpenAI Agents SDK (Python)
result = await Runner.run(agent, "Delete temp files no longer needed.")
if result.interruptions:
    state = result.to_state()
    serialized = state.to_json()        # persist to DB for async approval
    # ... later, after human decision ...
    state = RunState.from_json(agent, serialized)
    state.approve(result.interruptions[0])
    result = await Runner.run(agent, state)
MCP fournit désormais lui aussi une primitive pertinente : l’elicitation permet à un serveur MCP d’attendre un input utilisateur pendant l’exécution d’un outil - avant tout pour des informations manquantes, pas pour la gouvernance. Mais le pattern pause/resume sous-jacent (accept, decline, cancel) est le même. Un protocole standardisé de governance gate manque encore dans MCP - la primitive pour le construire, elle, est là.
Ce que l’approbateur doit voir
Techniquement, tout cela fonctionne. Mais un flux d’approbation ne vaut que par l’information que reçoit l’approbateur. Qui veut quoi, sur quel objet, pourquoi, avec quel risque - tout cela doit se saisir d’un coup d’œil. Pas tout l’historique du chat, pas chaque étape intermédiaire de la conversation de l’agent. Mais une base de décision condensée.
Dans le Refund-Agent, ça ressemble à ceci : une bannière d’approbation affiche le nom de l’outil et les arguments en JSON. Approve ou Deny. Et chaque décision rejoint un audit trail structuré - avec acteur, sujet, approvalOutcome, approvalId et hash de la version du prompt.
Le flux d’approbation n’est pas un problème technique. C’est un problème produit : de quoi un humain a-t-il besoin pour prendre la bonne décision en trois secondes ?
Durable execution
Pour la démo, l’état de session suffit. En production, non. Les approbations qui prennent des heures ou des jours ont besoin de durable execution. Un onglet de navigateur qui se ferme ne doit pas envoyer un remboursement approuvé dans le néant.
Le problème du coup de tampon : quand l’approbation tourne à la farce
On sait maintenant comment construire des flux d’approbation. La question n’est pas de savoir si on peut les construire - mais s’ils fonctionnent. L’objection la plus honnête saute aux yeux : à quoi sert une étape d’approbation si l’humain valide tout les yeux fermés de toute façon ?
La réponse est inconfortable. Parce que c’est exactement ce qui se passe - et de manière systématique.
Automation complacency
Le phénomène a un nom : l’automation complacency. Plus un système fonctionne de façon fiable, moins l’humain vérifie ses sorties d’un œil critique. Ce n’est pas un échec individuel, mais un effet cognitif bien documenté. Et il s’aggrave à mesure que l’IA s’améliore.
Les chiffres sont sans appel. Les systèmes cliniques d’aide à la décision affichent des taux d’override de 90-95 % - neuf alertes sur dix sont balayées d’un clic. Une partie de ces rejets est rationnelle, parce que beaucoup d’alertes ne sont pas pertinentes cliniquement. Mais c’est justement là le problème : quand 90 % des alertes sont du bruit, le système apprend à l’humain à ne plus regarder. Une étude du JAMA portant sur 457 cliniciens est allée plus loin : quand l’IA donnait volontairement des recommandations erronées, la précision diagnostique tombait de 73 % à 61,7 %. L’IA ne rendait pas les décisions meilleures - elle rendait les humains moins bons.
Quand le coup de tampon devient une défaillance du système
Le scandale néerlandais des allocations familiales de 2021 montre ce qui se passe quand le coup de tampon s’étend à toute une administration. Techniquement, le système était HITL - des agents devaient vérifier et valider les évaluations de fraude basées sur du ML. En pratique, personne ne remettait la sortie en question. Des milliers de familles ont été classées à tort comme fraudeuses. Le gouvernement a démissionné.
En 2023, avec l’arrêt SCHUFA (C-634/21), la Cour de justice de l’Union européenne en a tiré la conséquence juridique : quand un humain se contente de valider la sortie de l’IA sans examen substantiel, cela relève du « solely automated decision-making » au sens de l’art. 22 du RGPD. Le coup de tampon n’est pas seulement un problème d’UX - c’est un risque de conformité.
Des design patterns contre le coup de tampon
Mais la recherche montre aussi que le coup de tampon n’est pas une loi de la nature. C’est un problème de design.
Les cognitive forcing functions (Buçinca et al. 2021) obligent le reviewer à se forger un jugement indépendant avant que la recommandation de l’IA ne soit visible. Ça a l’air trivial, mais c’est ce qui a l’effet le plus fort sur l’overreliance.
La variable challenge injection glisse dans la file de review des items dont on sait déjà s’ils sont bons ou mauvais - ce qu’on appelle des trap tasks. Un reviewer qui évalue mal trois cas fictifs d’affilée reçoit un feedback. Ça maintient l’attention en éveil.
La mandatory justification remplace le bouton d’approbation par un champ de justification structuré. Pas « Approve/Reject », mais « Qu’avez-vous vérifié exactement, et pourquoi le résultat est-il correct ? »
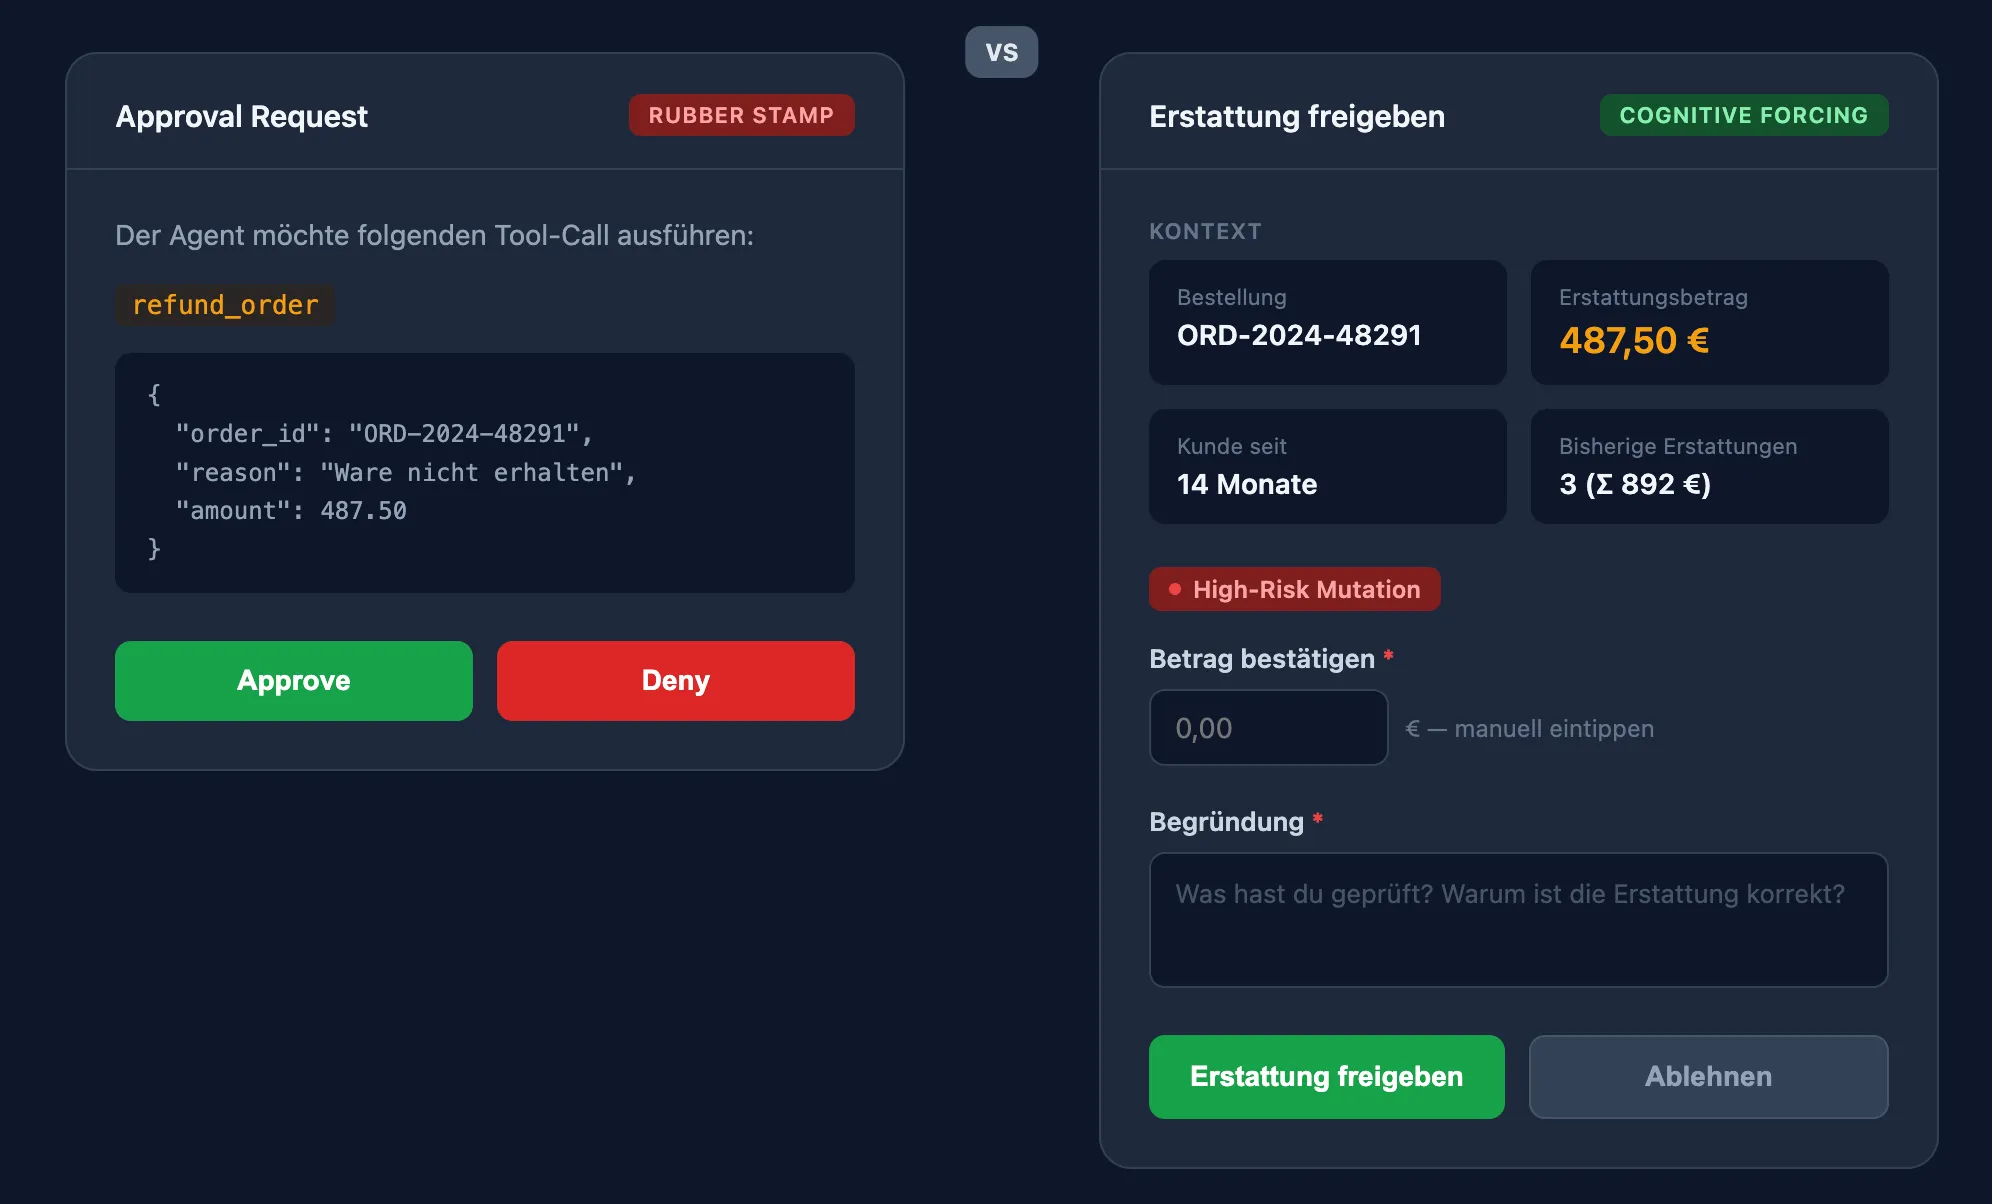
Une revue systématique de 2025 (Springer) en distille le résultat central : les explications de l’IA seules - c’est-à-dire la transparence sur pourquoi l’IA a décidé ainsi - ne suffisent pas. Le levier le plus efficace, c’est l’engagement actif de l’utilisateur. L’humain doit travailler, pas seulement regarder.
Et c’est là que ça devient inconfortable : Buçinca et al. ont constaté que les designs qui réduisaient le plus l’overreliance étaient précisément ceux que les utilisateurs notaient le moins bien subjectivement. Les utilisateurs n’aimaient pas les cognitive forcing functions. Un bon design d’approbation est inconfortable - by design. Si votre processus d’approbation est agréable à utiliser, vous n’avez probablement pas résolu le problème.
Voir le HITL comme un bug UX, c’est n’avoir jamais lu un rapport d’incident de production.
Le contrôle n’est pas un retour en arrière
La question n’a jamais été « HITL, oui ou non ». La question est : quelle dose d’autonomie supporte quelle action - et comment cela évolue-t-il dans le temps ?
Le modèle de risque par paliers détermine quel outil a besoin de quel gate. Mais il existe un second axe : de combien de contrôle le système dans son ensemble a-t-il besoin ? Un nouvel outil dans un domaine encore non éprouvé démarre en mode audit - l’humain passe chaque action en review. Avec une performance mesurée (précision, fréquence des overrides, taux d’exceptions), le système peut passer progressivement en mode assistance : l’IA agit, l’humain surveille. Et à terme, il opère de façon quasi autonome à l’intérieur de limites clairement définies - mais ces limites restent imposées par l’architecture, pas fondées sur la confiance.
En 2026, Jakob Nielsen a fait une observation dérangeante : vérifier la sortie d’une IA est souvent cognitivement plus difficile que de la produire soi-même. Mais c’est précisément ce rôle de vérification qui reste à l’humain. Et il devient d’autant plus important que les systèmes s’améliorent.
L’infrastructure pour une autonomie contrôlée existe. Les SDK fournissent les primitives. La seule question qui reste, c’est de savoir si on s’en sert.
Un agent qui ne sait pas quand il doit faire une pause n’est pas un agent autonome - c’est un processus incontrôlé.