
Hoe autonomer een agent wordt, hoe belangrijker de kwaliteit van de menselijke ingrijpmomenten wordt. Niet het afschaffen ervan.
Een klant wil zijn geld terug. De refund-agent stelt refund_order voor, de parameters kloppen, de autorisatie is gecontroleerd. En dan: een approval-banner. De workflow pauzeert. Er gebeurt niets tot een mens op “Bevestigen” klikt.
De eerste reflex? “Waarom kan hij dat niet gewoon doen?”
Ik ken die reflex. We bouwen agents zodat ze dingen voor ons regelen, en dan zetten we een stopbord voor hun neus. Dat voelt als frictie. Als een stap terug. Als het tegenovergestelde van automatisering. Alleen: refund_order verplaatst geld. Echt geld. En een agent die zelfstandig geld kan verplaatsen, is geen feature. Het is een risico.
De requiresApproval: true in de tool-catalogus van de refund-agent is geen toeval. Het is een architectuurbeslissing. In de vorige post introduceerde ik de policy gate als onderdeel van de “Definition of Done” voor agent-tools. Daar was require_approval één punt van de vele. Hier staat het centraal.

Pauze is geen bug, maar governance
Een approval-moment in een agent-systeem volgt een simpel principe: de agent stelt voor, de mens beslist, het systeem voert uit. Drie stappen, duidelijke verantwoordelijkheid. Dat klinkt als overhead, maar het is architectuur.
Belangrijk is het onderscheid tussen twee concepten die vaak door elkaar worden gehaald: elicitation en governance gates. Elicitation betekent dat de agent actief om informatie vraagt: “Welk bestelnummer bedoel je?” of “Zal ik het testrapport als pdf of als Markdown genereren?”. De agent heeft input nodig om verder te kunnen. Een governance gate is iets anders: het systeem dwingt een goedkeuring af voordat een onomkeerbare actie wordt uitgevoerd. Niet omdat de agent twijfelt, maar omdat de actie het vereist.
Elicitation is UX. Governance is beveiligingsarchitectuur.
De vergelijking met pull request reviews helpt: ja, PR-reviews kosten tijd. Ja, ze zijn een bottleneck. En toch zijn ze in bijna elk professioneel team standaard, omdat de schade door ongecontroleerde code in productie zwaarder weegt dan de overhead. Approval-gates bij agents zijn hetzelfde principe: een afgedwongen stoppunt vóór een wijziging in de state die je niet zomaar ongedaan kunt maken.
Anthropics analyse van Claude Code levert daarbij een interessante observatie op: het model pauzeert in meer dan 16% van de complexe turns uit zichzelf. Dat is meer dan twee keer zo vaak als mensen de agent onderbreken (zo’n 7%). Het model herkent zijn eigen onzekerheid en handelt daarnaar. Het wacht niet tot het wordt gestopt, het stopt zichzelf.

Anthropics “Building Effective Agents” raadt precies dat aan: agents moeten bij checkpoints kunnen pauzeren en op menselijke feedback kunnen wachten. De filosofie daarachter is samen te vatten in één principe dat ik centraal vind, least agency: geef de agent precies zoveel autonomie als de taak echt vraagt. Niet meer.
Wie mijn post over evals goed heeft gelezen, herinnert zich misschien: in het contract stond expliciet User-Approval: de workflow moet pauzeren, als bewuste designbeslissing, niet als noodoplossing.

Pause/resume is voor agent-systemen wat pull request reviews voor code zijn: niet optioneel, maar kwaliteitsborging.
Wanneer approval verplicht is, en wanneer niet
Niet elke agent-actie heeft een mens nodig. lookup_order laten goedkeuren zou absurd zijn. Maar refund_order zonder goedkeuring laten doorlopen zou nalatig zijn. De vraag is niet binair, het is een model met niveaus.
| Risiconiveau | Voorbeeld | Actie |
|---|---|---|
| Read-only | lookup_order, faq_search |
Auto-allow |
| Low-risk mutation | reset_password |
Loggen, geen approval |
| High-risk mutation | refund_order |
Approval vereist |
| Onomkeerbaar | delete_account |
Approval + vier-ogenprincipe |
Read-only is onschuldig: de agent leest data, maar verandert niets aan de state. Hier remt een approval-gate alleen de flow af, zonder dat je er veiligheid voor terugkrijgt. Low-risk mutations veranderen wel state, maar het effect is beperkt en omkeerbaar. Een nieuw wachtwoord kan de user zelf weer resetten. Loggen is genoeg om de audit trail compleet te houden. High-risk mutations verplaatsen geld, wijzigen contracten of raken gevoelige data. Hier moet een mens expliciet goedkeuren voordat het systeem iets uitvoert. En onomkeerbare acties zoals het verwijderen van een account hebben niet alleen approval nodig, maar een vier-ogenprincipe: een tweede persoon bevestigt wat de eerste heeft goedgekeurd.
De indeling is geen wetenschap. Het is een bewuste productbeslissing. In de refund-agent ziet dat er concreet zo uit:
Dit model met niveaus is geen theoretisch framework. Vanaf augustus 2026 wordt het ook relevant voor de regelgeving.
AI-verordening art. 14: vijf verplichte vaardigheden vanaf 2 augustus 2026
De Europese AI-verordening (AI Act) schrijft voor hoog-risicosystemen vijf concrete vaardigheden voor menselijk toezicht voor:
- Begrijpen & monitoren: capaciteiten, beperkingen en het opsporen van anomalieën (art. 14(4)(a))
- Bewustzijn van automation bias: besef van overmatig vertrouwen in AI-output (art. 14(4)(b))
- Output correct interpreteren: met behulp van interpretatietools (art. 14(4)(c))
- Overrulen of terugdraaien: elke AI-beslissing kunnen terugdraaien of negeren (art. 14(4)(d))
- Ingrijpen of stoppen: een veilige stop via een stopknop of iets vergelijkbaars (art. 14(4)(e))
Opvallend: art. 14(4)(b) benoemt automation bias expliciet. Gedragswetenschap in harde wetgeving. Bij overtredingen dreigen boetes tot 15 miljoen euro of 3% van de wereldwijde jaaromzet.
Niet elke actie heeft een mens nodig. Maar elke risicovolle actie heeft de mogelijkheid van een mens nodig. En die moet in de architectuur zijn voorzien, niet achteraf zijn aangeschroefd.
Hoe een approval-flow technisch werkt
Van het model met niveaus naar de implementatie. Het basispattern is verrassend simpel. De complexiteit zit ergens anders dan de meeste mensen denken.
Het pattern
Elke approval-flow volgt hetzelfde verloop: de agent formuleert een tool-intent. Een policy gate controleert of die intent goedkeuring vereist. Zo ja, dan pauzeert de uitvoering, de intent belandt in een approval queue, een mens beslist, en pas dan wordt de tool call daadwerkelijk uitgevoerd. Of juist niet.
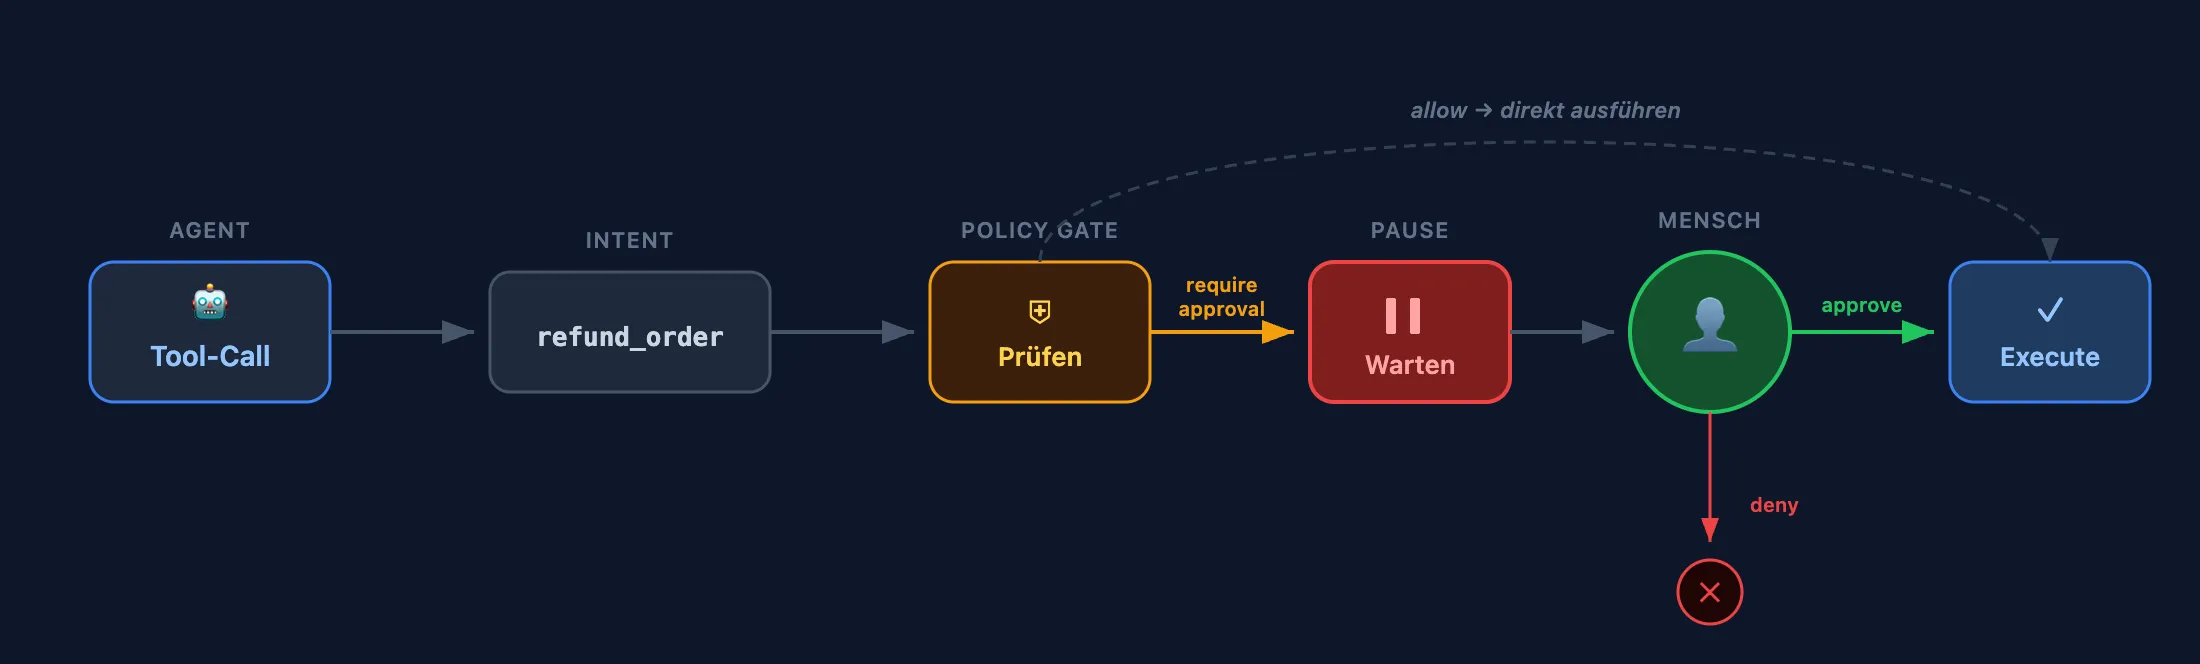
In code is dat verbazingwekkend weinig werk. In de Vercel AI SDK volstaat één enkele flag op de tooldefinitie:
const refundOrder = tool({
  description: 'Process a refund for an order',
  parameters: z.object({
    orderId: z.string(),
    reason: z.string(),
  }),
  needsApproval: true,
  execute: async ({ orderId, reason }) => {
    return await processRefund(orderId, reason);
  },
});
needsApproval: true, dat is alles. De server wacht tot de client via addToolApprovalResponse een beslissing stuurt. Goedgekeurd? Dan wordt de tool call uitgevoerd. Afgewezen? Dan krijgt de agent de afwijzing als context en kan hij daarop reageren.
De eigenlijke uitdaging zit niet in het pattern zelf, maar in alles wat eromheen moet gebeuren: state persistence, crash recovery, en de vraag wat er gebeurt met een approval die pas na drie uur binnenkomt.
SDK-vergelijking
| Dimensie | Vercel AI SDK | OpenAI Agents SDK | LangGraph | Temporal |
|---|---|---|---|---|
| Pauzemechanisme | needsApproval op tool |
needs_approval op tool |
interrupt() in node |
workflow.wait_condition() |
| State-persistentie | Client-state (React) | Expliciet via RunState.to_json() |
Automatische checkpointer | Automatische event history |
| Crash recovery | Afhankelijk van sessie | Handmatig (rehydrate uit DB) | Afhankelijk van checkpointer | Volautomatische replay |
| Best fit | React/Next.js-chat-UI’s | Lichtgewicht agent-tools | Graph-gebaseerde workflows | Enterprise long-running |
Vercel en OpenAI zetten in op declaratieve flags direct op de tool, de makkelijkste instap. LangGraph maakt automatisch checkpoints, maar code vóór een interrupt() moet idempotent zijn, omdat de hele node bij een resume opnieuw vanaf het begin draait. Temporal is van een andere orde: praktisch onbeperkte wachttijd, volautomatische replay na een crash, signals voor externe beslissingen.
Approval met de OpenAI Agents SDK (Python)
result = await Runner.run(agent, "Delete temp files no longer needed.")
if result.interruptions:
    state = result.to_state()
    serialized = state.to_json()        # persist to DB for async approval
    # ... later, after human decision ...
    state = RunState.from_json(agent, serialized)
    state.approve(result.interruptions[0])
    result = await Runner.run(agent, state)
Ook MCP levert inmiddels een relevante primitive: elicitation laat een MCP-server tijdens de tool-executie wachten op input van de user. Vooral voor ontbrekende informatie, niet voor governance. Maar het onderliggende pause/resume-patroon (accept, decline, cancel) is hetzelfde. Een gestandaardiseerd protocol voor governance gates ontbreekt nog in MCP, de primitive ervoor is er wel.
Wat de approver moet zien
Technisch werkt dat allemaal. Maar een approval-flow is maar zo goed als de informatie die de approver krijgt. Wie wil wat, op welk object, waarom, met welk risico: dat moet in één oogopslag te zien zijn. Niet de hele chatgeschiedenis, niet elke tussenstap van het agent-gesprek. Maar een compacte basis om op te beslissen.
In de refund-agent ziet dat er zo uit: een approval-banner toont toolnaam en argumenten als JSON. Approve of deny. En elke beslissing wordt onderdeel van een gestructureerde audit trail, met actor, subject, approvalOutcome, approvalId en de hash van de promptversie.
De approval-flow is geen technisch probleem. Het is een productprobleem: wat heeft een mens nodig om in drie seconden de juiste beslissing te nemen?
Durable execution
In de demo is session state genoeg. In productie niet. Approvals die uren of dagen duren, hebben durable execution nodig. Een browsertab die dichtgaat, mag een goedgekeurde refund niet in het niets laten verdwijnen.
Het rubber-stamp-probleem: als approval een farce wordt
We weten nu hoe je approval-flows bouwt. De vraag is niet of we ze kunnen bouwen, maar of ze werken. Het eerlijkste tegenargument ligt voor de hand: wat heb je aan een approval-stap als de mens toch alles klakkeloos goedkeurt?
Het antwoord is ongemakkelijk. Want precies dat gebeurt, en wel systematisch.
Automation complacency
Het fenomeen heeft een naam: automation complacency. Hoe betrouwbaarder een systeem werkt, hoe minder kritisch de mens de output ervan controleert. Dat is geen individueel falen, maar een goed gedocumenteerd cognitief effect. En het wordt erger naarmate de AI beter wordt.
De cijfers zijn eenduidig. Klinische decision-support-systemen laten override-percentages van 90-95% zien: negen van de tien waarschuwingen worden weggeklikt. Een deel daarvan is rationeel, omdat veel alerts klinisch irrelevant zijn. Maar precies dat is het probleem: als 90% van de waarschuwingen ruis is, traint het systeem de mens om niet meer te kijken. Een JAMA-studie met 457 clinici ging verder: als de AI met opzet foute aanbevelingen gaf, daalde de diagnostische accuracy van 73% naar 61,7%. De AI maakte de beslissingen niet beter. Ze maakte de mensen slechter.
Als rubber-stamping systeemfalen wordt
De toeslagenaffaire van 2021 laat zien wat er gebeurt als rubber-stamping op bestuursniveau escaleert. Technisch was het systeem HITL: medewerkers moesten de ML-gebaseerde fraudebeoordelingen controleren en goedkeuren. In de praktijk stelde niemand de output ter discussie. Duizenden gezinnen werden ten onrechte als fraudeur aangemerkt. De regering trad af.
Het Europese Hof van Justitie heeft in 2023 in het SCHUFA-arrest (C-634/21) de juridische consequentie getrokken: als een mens de AI-output alleen klakkeloos goedkeurt, zonder inhoudelijke controle, geldt dat als “solely automated decision-making” onder art. 22 AVG. Rubber-stamping is niet alleen een UX-probleem. Het is een compliancerisico.
Design-patterns tegen rubber-stamping
Het onderzoek laat ook zien: rubber-stamping is geen natuurwet. Het is een designprobleem.
Cognitive forcing functions (Buçinca et al. 2021) dwingen de reviewer een eigen oordeel te vormen voordat de aanbeveling van de AI zichtbaar wordt. Dat klinkt triviaal, maar het heeft het sterkste effect op overreliance.
Variable challenge injection mengt bekende goede en slechte items in de review-queue, zogeheten trap tasks. Wie drie gefingeerde gevallen achter elkaar verkeerd beoordeelt, krijgt feedback. Dat houdt de aandacht scherp.
Mandatory justification vervangt de approve-knop door een gestructureerd veld voor een onderbouwing. Niet “approve/reject”, maar “Wat heb je precies gecontroleerd, en waarom is het resultaat correct?”
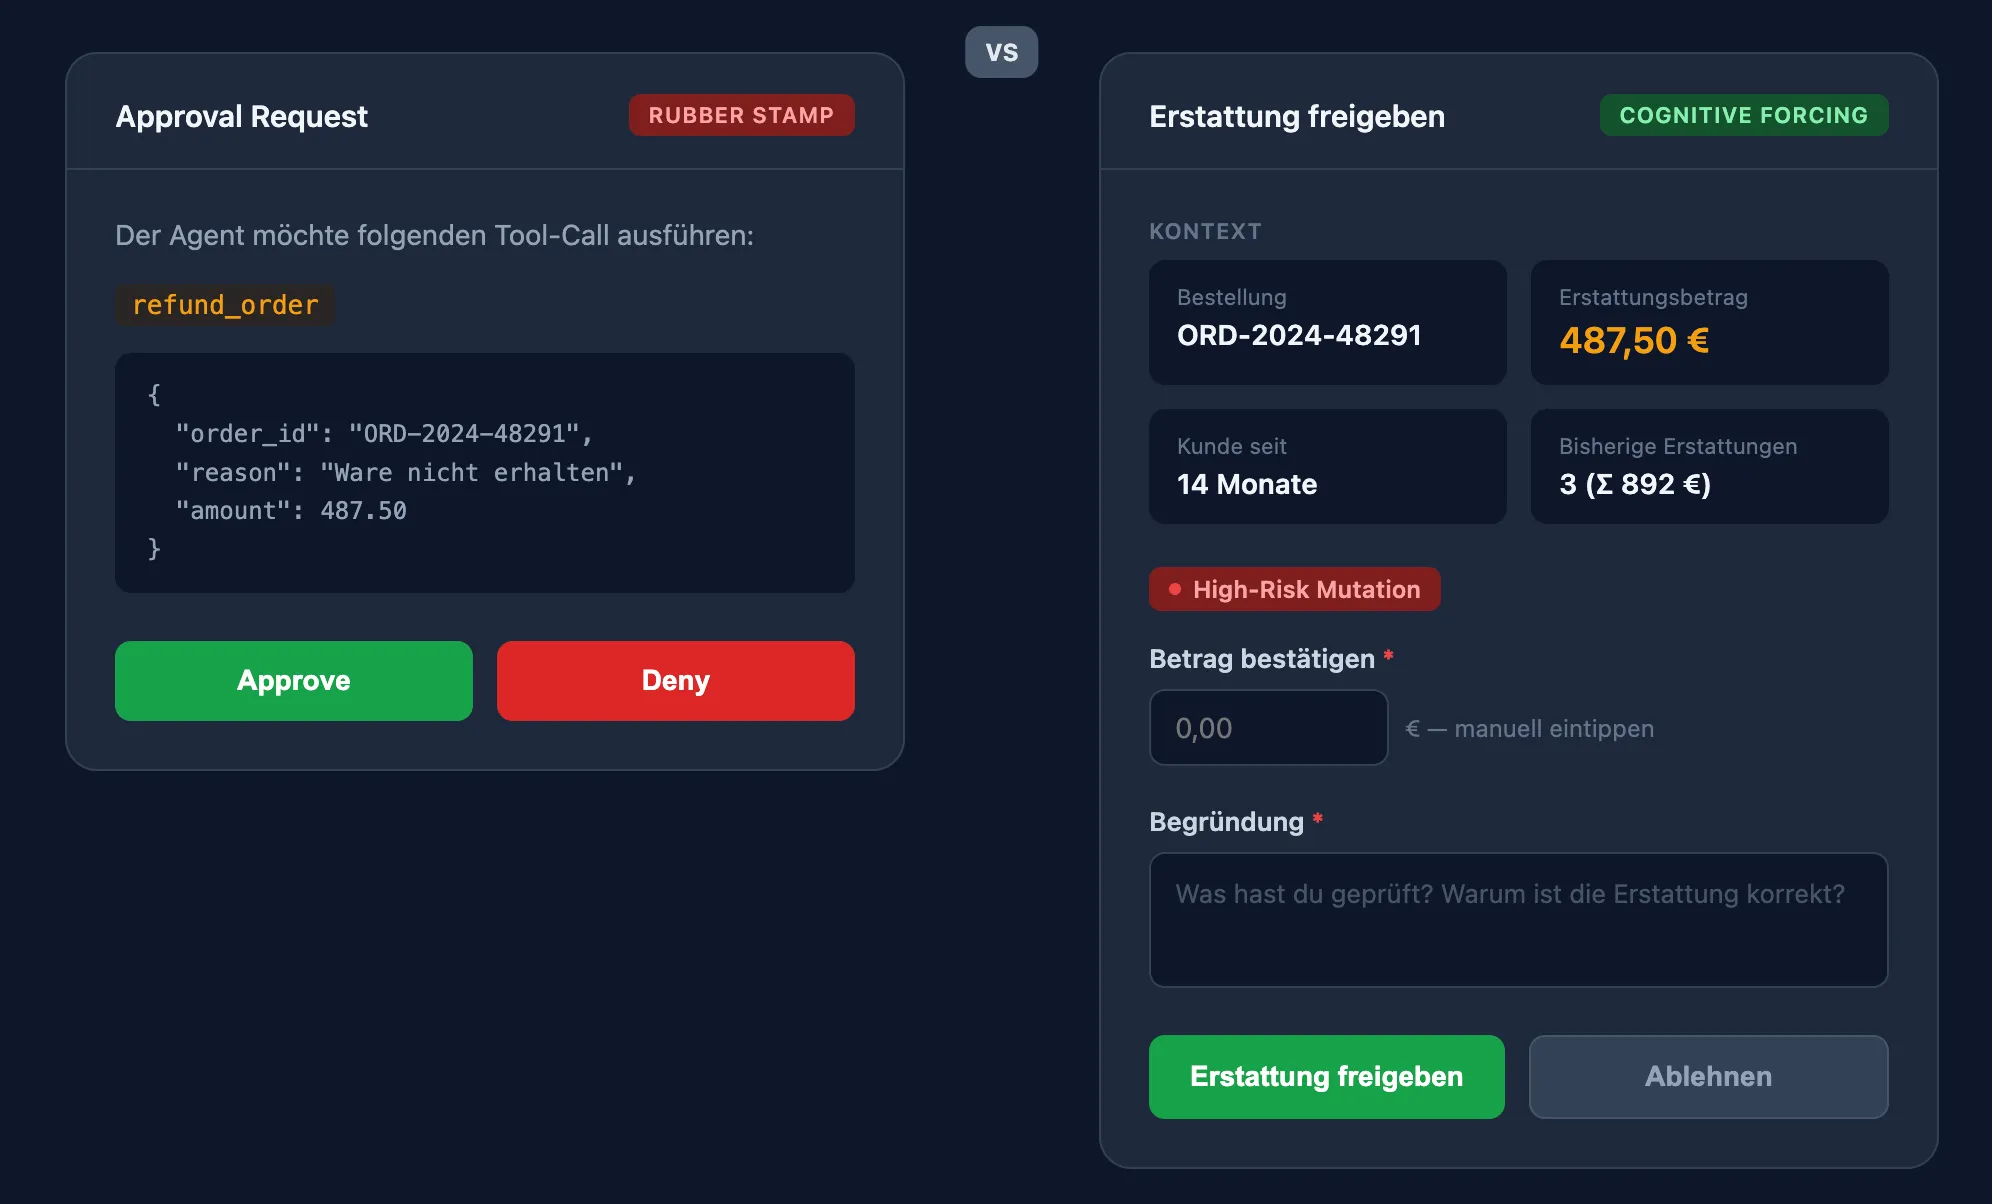
Een systematic review uit 2025 (Springer) destilleert de kernbevinding: AI-uitleg alleen, dus transparantie over waarom de AI zo heeft besloten, is niet genoeg. De effectiefste hefboom is actieve betrokkenheid van de user. De mens moet werken, niet alleen toekijken.
En hier wordt het ongemakkelijk: Buçinca et al. ontdekten dat precies de designs die overreliance het sterkst verminderden, de slechtste subjectieve beoordelingen van users kregen. De gebruikers vonden de cognitive forcing functions gewoon niet leuk. Goed approval-design is ongemakkelijk, by design. Wie het approval-proces zo inricht dat het prettig aanvoelt, heeft het probleem waarschijnlijk niet opgelost.
Wie HITL als UX-bug ziet, heeft nooit een incident report uit productie gelezen.
Controle is geen stap terug
De vraag was nooit “HITL ja of nee”. De vraag is: hoeveel autonomie verdraagt welke actie, en hoe verandert dat in de loop van de tijd?
Het model met risiconiveaus bepaalt welke tool welke gate nodig heeft. Maar er is een tweede as: hoeveel oversight heeft het systeem als geheel nodig? Een nieuwe tool in een onbeproefd domein start in auditmodus: de mens reviewt elke actie. Met gemeten performance (accuracy, override-frequentie, exception rates) kan het systeem geleidelijk naar de assist-modus: de AI handelt, de mens monitort. En op een gegeven moment opereert het binnen duidelijk gedefinieerde grenzen nagenoeg autonoom, maar die grenzen blijven in de architectuur afgedwongen, niet gebouwd op vertrouwen.
Jakob Nielsen deed in 2026 een ongemakkelijke observatie: AI-output verifiëren is cognitief vaak moeilijker dan hem zelf produceren. Maar precies die verificatie is de rol die voor de mens overblijft. En die wordt belangrijker naarmate de systemen beter worden.
De infrastructuur voor gecontroleerde autonomie is er. De SDK’s leveren de primitives. De vraag is alleen nog of we ze gebruiken.
Een agent die niet weet wanneer hij moet pauzeren, is geen autonome agent. Het is een ongecontroleerd proces.