
Ju mer autonom en agent blir, desto viktigare blir kvaliteten på de mänskliga ingreppspunkterna – inte att de avskaffas.
En kund vill ha en återbetalning. Refund-agenten föreslår refund_order, parametrarna stämmer, behörigheten är kontrollerad. Och sedan: en approval-banner. Workflowet pausar. Ingenting händer förrän en människa klickar på “Bekräfta”.
Första reflexen? “Varför kan den inte bara göra det?”
Jag känner igen den reflexen. Vi bygger agenter för att de ska göra saker åt oss – och sedan ställer vi en stoppskylt i vägen för dem. Det känns som friction. Som ett steg bakåt. Som motsatsen till automatisering. Bara det att refund_order flyttar pengar. Riktiga pengar. Och en agent som självständigt kan flytta pengar är ingen feature – den är en risk.
requiresApproval: true i refund-agentens tool-katalog är ingen slump. Det är ett arkitektoniskt beslut – i förra inlägget introducerade jag Policy Gate som en del av “Definition of Done” för agent-tools. Där var require_approval en punkt bland många. Här blir det huvudtemat.

Paus är ingen bugg, utan governance
En approval-punkt i ett agentsystem följer en enkel princip: agenten föreslår, människan beslutar, systemet utför. Tre steg, tydligt ansvar. Det låter som overhead – men det är arkitektur.
Det är viktigt att skilja mellan två koncept som ofta blandas ihop: Elicitation och Governance Gates. Elicitation betyder att agenten aktivt frågar efter information – “Vilket ordernummer menar du?” eller “Ska jag generera testrapporten som PDF eller Markdown?”. Agenten behöver input för att kunna arbeta vidare. En Governance Gate är något annat: systemet tvingar fram ett godkännande innan en oåterkallelig åtgärd utförs. Inte för att agenten är osäker, utan för att åtgärden kräver det.
Elicitation är UX. Governance är säkerhetsarkitektur.
Analogin med pull request-reviews hjälper: ja, PR-reviews tar tid. Ja, de är en flaskhals. Och ändå är de standard i nästan varje professionellt team – eftersom skadan från okontrollerad kod i produktion väger tyngre än overheaden. Approval-gates för agenter är samma princip: en påtvingad stoppunkt före en tillståndsförändring som inte så lätt går att ångra.
Anthropics analys av Claude Code bidrar med en intressant observation: modellen pausar på eget initiativ i över 16 % av de komplexa turerna – mer än dubbelt så ofta som människor avbryter agenten (runt 7 %). Modellen känner igen sin egen osäkerhet och agerar därefter. Den väntar inte på att bli stoppad – den stoppar sig själv.

Anthropics “Building Effective Agents” rekommenderar just det: agenter ska kunna pausa vid checkpoints och vänta på mänsklig feedback. Filosofin bakom kan kokas ner till en princip som jag anser är central – Least Agency: ge agenten bara så mycket autonomi som uppgiften faktiskt kräver. Inte mer.
Den som läste mitt inlägg om evals noga kanske minns: i Contractet stod uttryckligen User-Approval: Workflowet bör pausa – som ett medvetet designbeslut, inte som en nödlösning.

Pause/resume är för agentsystem vad pull request-reviews är för kod: inte valfritt, utan kvalitetssäkring.
När approval är ett måste – och när det inte är det
Alla agentåtgärder behöver inte en människa. Att nicka igenom lookup_order vore absurt. Men att låta refund_order gå igenom utan godkännande vore vårdslöst. Frågan är inte binär – den är en stegmodell.
| Risknivå | Exempel | Åtgärd |
|---|---|---|
| Read-only | lookup_order, faq_search |
Auto-allow |
| Low-risk mutation | reset_password |
Logga, inget approval |
| High-risk mutation | refund_order |
Approval krävs |
| Oåterkallelig | delete_account |
Approval + fyraögonsprincipen |
Read-only är okritiskt – agenten läser data men ändrar inget tillstånd. Här bromsar en approval-gate bara flödet, utan att ge någon säkerhet. Low-risk mutations ändrar tillstånd, men effekten är begränsad och går att återställa. Ett nytt lösenord kan användaren själv återställa. Att logga räcker för att audit trailen ska förbli komplett. High-risk mutations flyttar pengar, ändrar avtal eller rör känsliga data – här måste en människa uttryckligen godkänna innan systemet utför. Och oåterkalleliga åtgärder som kontoborttagningar behöver inte bara approval, utan en fyraögonsprincip: en andra person bekräftar det som den första har godkänt.
Indelningen är ingen vetenskap – den är ett medvetet produktbeslut. I refund-agenten ser det konkret ut så här:
Den här stegmodellen är inget teoretiskt ramverk. Från augusti 2026 blir den också regulatoriskt relevant.
EU:s AI-förordning art. 14: fem obligatoriska förmågor från den 2 augusti 2026
EU:s AI-förordning (AI Act) föreskriver fem konkreta förmågor för mänsklig tillsyn i högrisksystem:
- Förstå och övervaka – kapacitet, begränsningar och upptäckt av avvikelser (art. 14.4 a)
- Medvetenhet om automation bias – medvetenhet om överdriven tillit till AI-output (art. 14.4 b)
- Tolka output korrekt – med hjälp av tolkningsverktyg (art. 14.4 c)
- Override eller reverse – kunna upphäva eller bortse från varje AI-beslut (art. 14.4 d)
- Ingripa eller stoppa – säker stoppning via stoppknapp e.d. (art. 14.4 e)
Värt att notera: art. 14.4 b tar uttryckligen upp automation bias – beteendevetenskap i hård lag. Vid överträdelser riskerar man upp till 15 miljoner euro eller 3 % av den globala årsomsättningen.
Alla åtgärder behöver inte en människa. Men varje riskfylld åtgärd behöver möjligheten till en människa. Och den måste vara inplanerad i arkitekturen – inte fastskruvad i efterhand.
Hur ett approval-flöde fungerar tekniskt
Från stegmodell till implementation. Grundmönstret är förvånansvärt enkelt – komplexiteten ligger någon annanstans än de flesta tror.
Mönstret
Varje approval-flöde följer samma förlopp: agenten formulerar en tool-intent. En Policy Gate kontrollerar om den här intenten kräver ett godkännande. Om ja, pausar exekveringen, intenten hamnar i en approval queue, en människa beslutar – och först då utförs tool callet faktiskt. Eller inte.
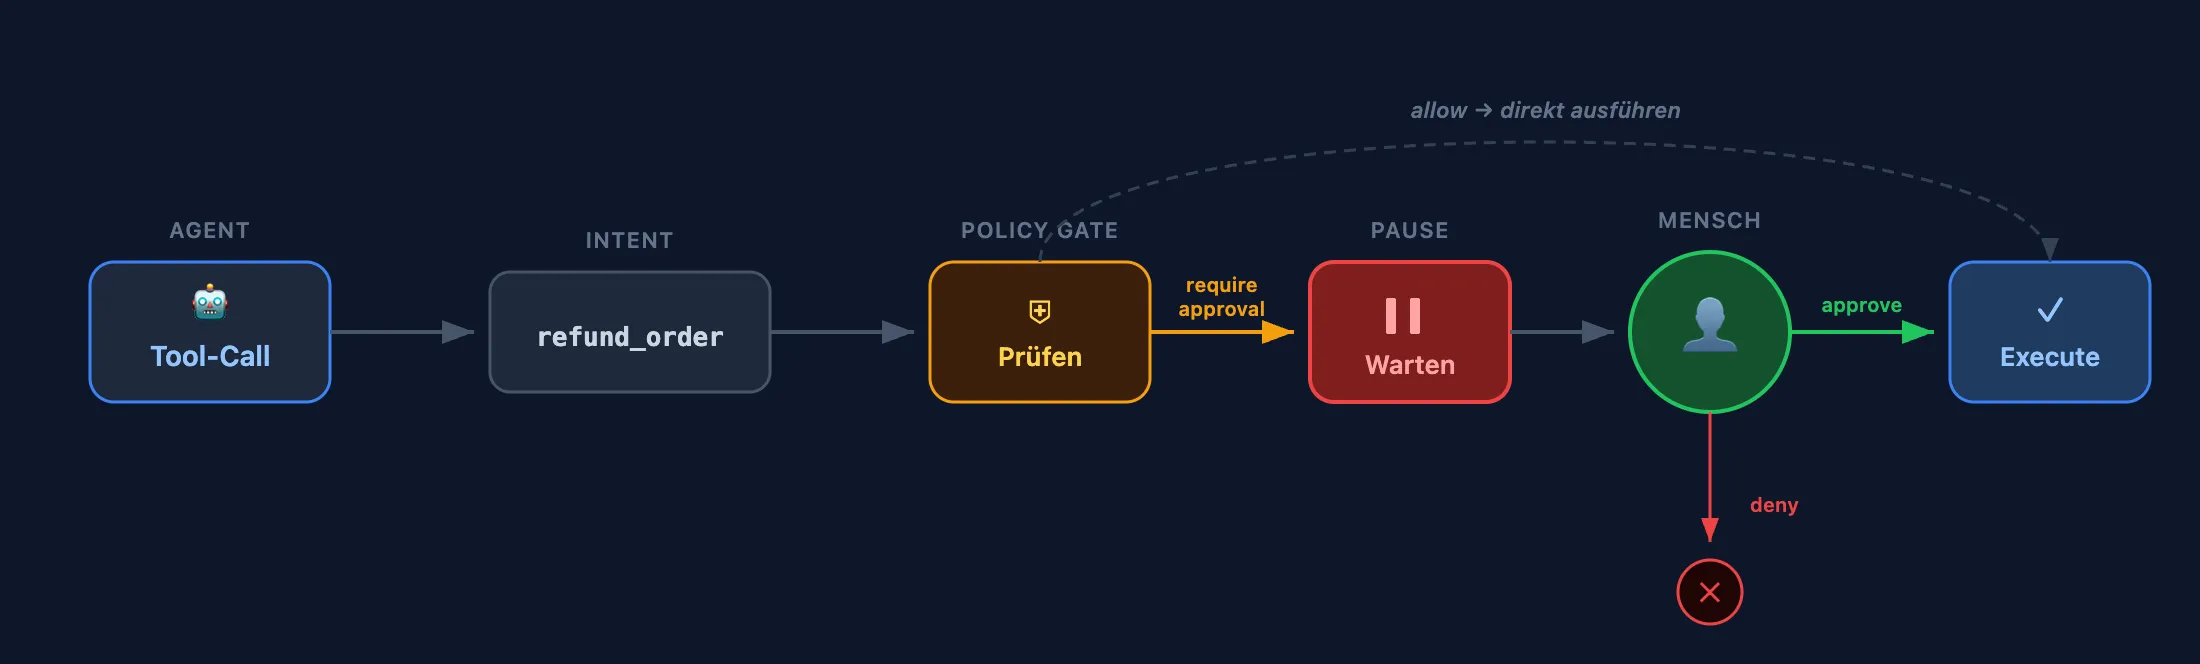
I kod är det förvånansvärt lite jobb. I Vercel AI SDK räcker en enda flagga på tool-definitionen:
const refundOrder = tool({
  description: 'Process a refund for an order',
  parameters: z.object({
    orderId: z.string(),
    reason: z.string(),
  }),
  needsApproval: true,
  execute: async ({ orderId, reason }) => {
    return await processRefund(orderId, reason);
  },
});
needsApproval: true – det är allt. Servern väntar tills klienten skickar ett beslut via addToolApprovalResponse. Approved? Tool callet utförs. Denied? Agenten får avslaget som kontext och kan reagera.
Den egentliga utmaningen ligger inte i själva mönstret, utan i det som måste hända runt omkring: state persistence, crash recovery, och frågan om vad som händer med ett approval som kommer först efter tre timmar.
SDK-jämförelse
| Dimension | Vercel AI SDK | OpenAI Agents SDK | LangGraph | Temporal |
|---|---|---|---|---|
| Pausmekanism | needsApproval på tool |
needs_approval på tool |
interrupt() i node |
workflow.wait_condition() |
| State-persistens | Klient-state (React) | Explicit via RunState.to_json() |
Automatisk checkpointer | Automatisk event history |
| Crash recovery | Sessionsberoende | Manuell (rehydrera från DB) | Checkpointer-beroende | Helautomatisk replay |
| Passar bäst för | React/Next.js chatt-UI:n | Lättviktiga agent-tools | Grafbaserade workflows | Enterprise long-running |
Vercel och OpenAI satsar på deklarativa flaggor direkt på toolet – den enklaste ingången. LangGraph checkpointar automatiskt, men kod före en interrupt() måste vara idempotent, eftersom hela noden körs om från början vid resume. Temporal spelar i en annan liga: praktiskt taget obegränsad väntetid, helautomatisk replay vid krasch, signals för externa beslut.
Approval med OpenAI Agents SDK (Python)
result = await Runner.run(agent, "Delete temp files no longer needed.")
if result.interruptions:
    state = result.to_state()
    serialized = state.to_json()        # persist to DB for async approval
    # ... later, after human decision ...
    state = RunState.from_json(agent, serialized)
    state.approve(result.interruptions[0])
    result = await Runner.run(agent, state)
Även MCP har numera en relevant primitiv: elicitation låter en MCP-server vänta på användarinput under tool-exekveringen – främst för saknad information, inte för governance. Men det underliggande pause/resume-mönstret (accept, decline, cancel) är detsamma. Ett standardiserat protokoll för governance gates saknas ännu i MCP – men primitiven för det finns redan.
Vad den som godkänner måste se
Tekniskt fungerar allt det här. Men ett approval-flöde är bara så bra som informationen som approvern får. Vem vill vad, på vilket objekt, varför, med vilken risk – det måste gå att ta in med en blick. Inte hela chatthistoriken, inte varje mellansteg i agentkonversationen. Utan ett komprimerat beslutsunderlag.
I refund-agenten ser det ut så här: en approval-banner visar toolnamn och argument som JSON. Approve eller deny. Och varje beslut blir en del av en strukturerad audit trail – med actor, subject, approvalOutcome, approvalId och hash av promptversionen.
Approval-flödet är inget tekniskt problem. Det är ett produktproblem: vad behöver en människa för att fatta rätt beslut på tre sekunder?
Durable execution
I demot räcker session state. I produktion gör det inte det. Approvals som tar timmar eller dagar behöver durable execution. En webbläsarflik som stängs får inte skicka en godkänd återbetalning ut i tomma intet.
Rubber stamp-problemet: när approval blir en fars
Nu vet vi hur approval-flöden byggs. Frågan är inte om vi kan bygga dem – utan om de fungerar. Det ärligaste motargumentet ligger nära till hands: vad är ett approval-steg värt om människan ändå vinkar igenom allt?
Svaret är obekvämt. För det är precis det som händer – och dessutom systematiskt.
Automation complacency
Fenomenet har ett namn: automation complacency. Ju pålitligare ett system fungerar, desto mindre kritiskt granskar människan dess output. Det är inget individuellt misslyckande, utan en väldokumenterad kognitiv effekt. Och den blir värre ju bättre AI:n blir.
Siffrorna är entydiga. Kliniska beslutsstödssystem visar override-frekvenser på 90–95 % – nio av tio varningar klickas bort. En del av det är rationellt, eftersom många alerts är kliniskt irrelevanta. Men det är just det som är problemet: när 90 % av varningarna är brus tränar systemet människan att sluta titta. En JAMA-studie med 457 kliniker gick längre: när AI:n medvetet gav felaktiga rekommendationer sjönk den diagnostiska träffsäkerheten från 73 % till 61,7 %. AI:n gjorde inte besluten bättre – den gjorde människorna sämre.
När rubber stamping blir ett systemfel
Den nederländska barnbidragsskandalen 2021 visar vad som händer när rubber stamping eskalerar på myndighetsnivå. Tekniskt var systemet HITL – handläggare skulle granska och godkänna de ML-baserade bedrägeribedömningarna. I praktiken ifrågasatte ingen outputen. Tusentals familjer pekades felaktigt ut som bedragare. Regeringen avgick.
EU-domstolen drog 2023 den juridiska konsekvensen i SCHUFA-domen (C-634/21): om en människa bara vinkar igenom AI-outputen utan att granska den på riktigt räknas det som “solely automated decision-making” enligt GDPR art. 22. Rubber stamping är inte bara ett UX-problem – det är en compliance-risk.
Designmönster mot rubber stamping
Forskningen visar dock också: rubber stamping är ingen naturlag. Det är ett designproblem.
Cognitive Forcing Functions (Buçinca et al. 2021) tvingar granskaren att bilda sig ett självständigt omdöme innan AI-rekommendationen blir synlig. Det låter trivialt, men har störst effekt på overreliance.
Variable Challenge Injection blandar in kända bra/dåliga poster i review-kön – så kallade trap tasks. Den som bedömer tre fingerade fall i rad fel får feedback. Det håller uppmärksamheten uppe.
Mandatory Justification ersätter approve-knappen med ett strukturerat motiveringsfält. Inte “Approve/Reject”, utan “Vad exakt har du kontrollerat, och varför är resultatet korrekt?”
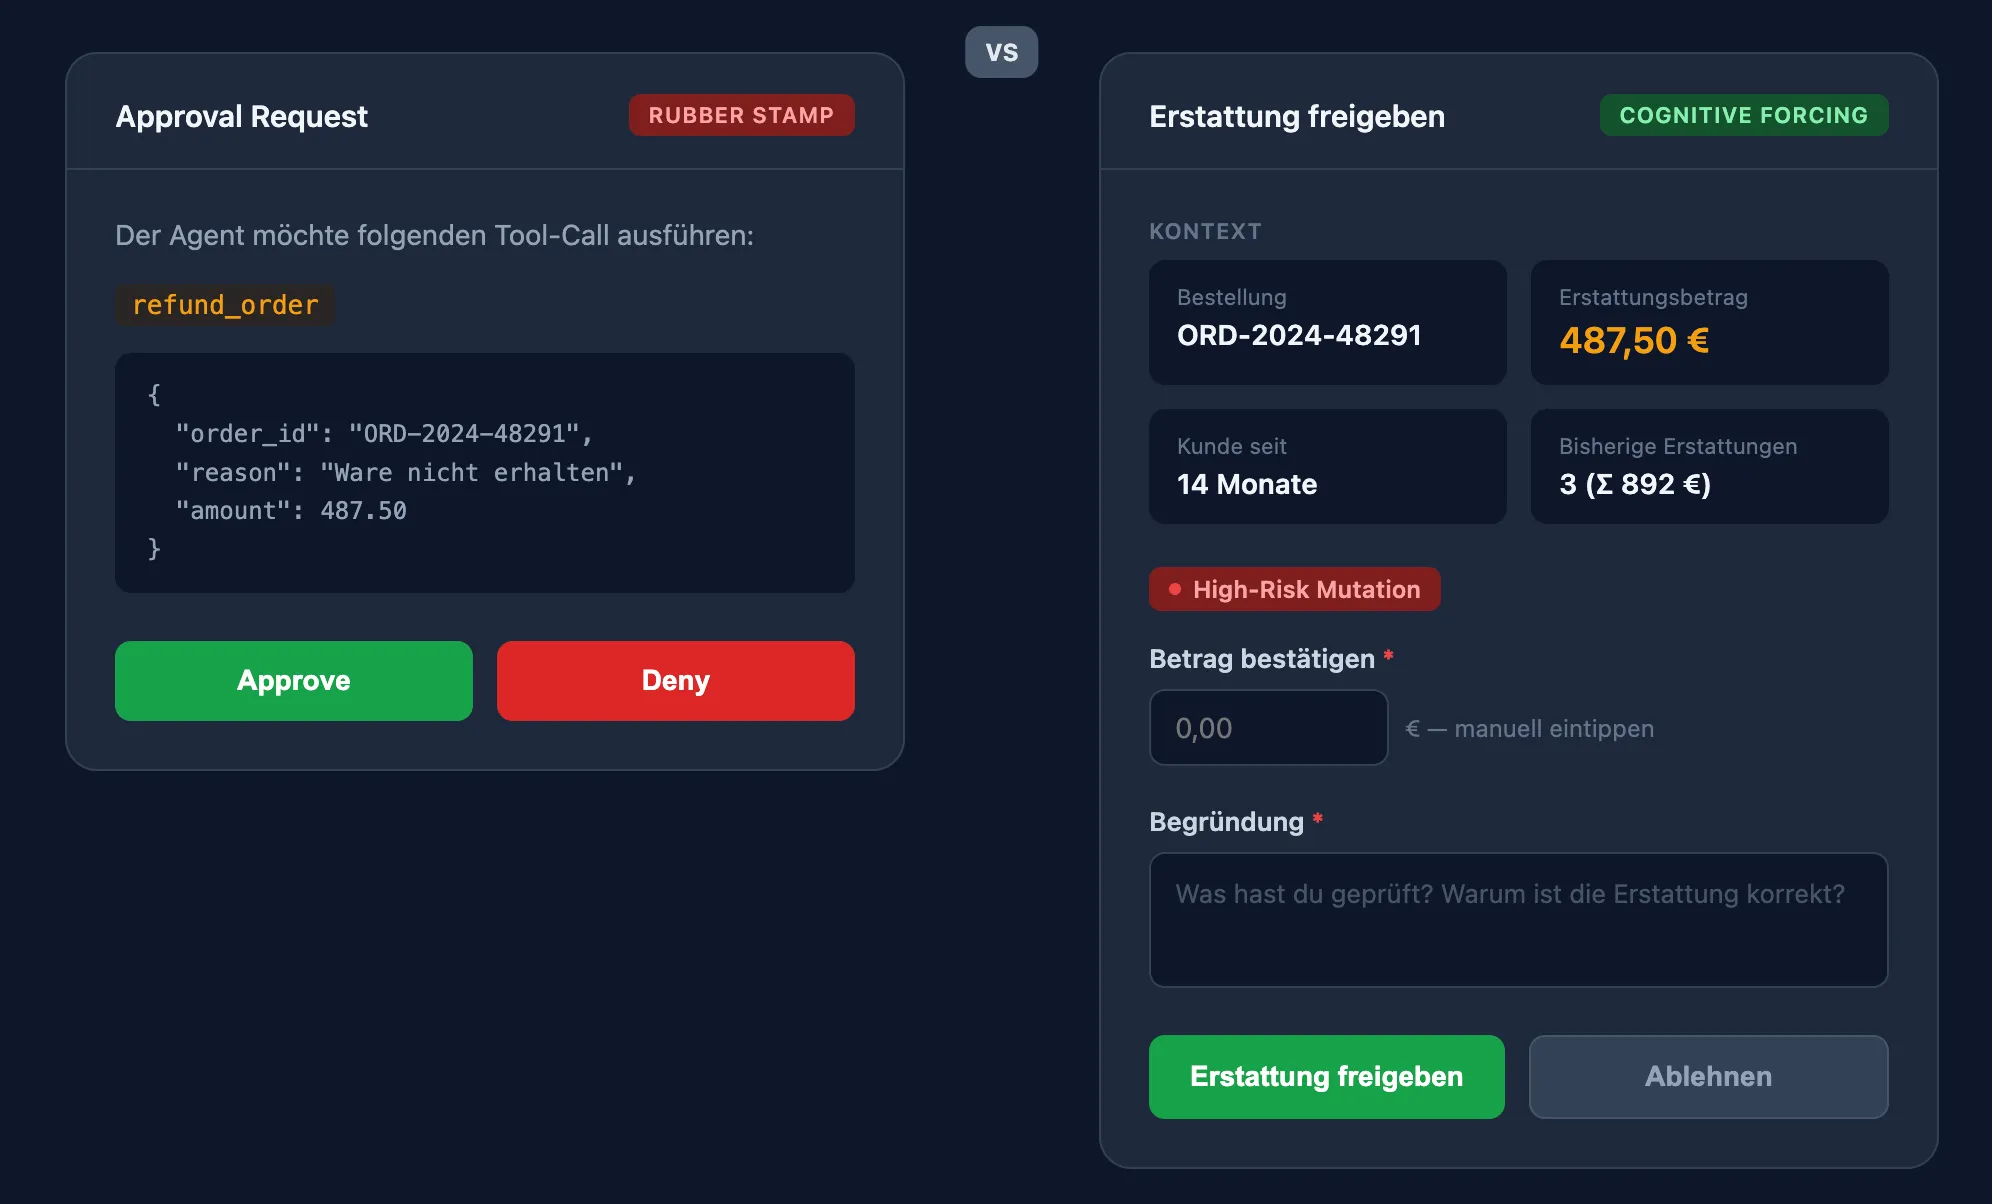
En systematisk översikt från 2025 (Springer) destillerar kärnfyndet: AI-förklaringar ensamma – alltså transparens om varför AI:n beslutade som den gjorde – räcker inte. Den mest effektiva hävstången är aktivt user engagement. Människan måste arbeta, inte bara titta på.
Och här blir det obekvämt: Buçinca et al. fann att just de designer som minskade overreliance mest fick sämst subjektiva betyg av användarna. Användarna gillade inte cognitive forcing functions. Bra approval-design är obekväm – by design. Den som utformar approval-processen så att den känns bra har förmodligen inte löst problemet.
Den som ser HITL som en UX-bugg har aldrig läst en incidentrapport från produktion.
Kontroll är inget steg bakåt
Frågan var aldrig “HITL ja eller nej”. Frågan är: hur mycket autonomi tål vilken åtgärd – och hur förändras det över tid?
Riskstegsmodellen avgör vilket tool som behöver vilken gate. Men det finns en andra axel: hur mycket oversight behöver helhetssystemet? Ett nytt tool i en oprövad domän startar i audit-läge – människan granskar varje åtgärd. Med uppmätt prestanda (accuracy, override-frekvens, exception rates) kan systemet gradvis gå över till assist-läge: AI:n agerar, människan övervakar. Och till slut opererar det nästan autonomt inom tydligt definierade gränser – men gränserna förblir påtvingade av arkitekturen, inte byggda på tillit.
Jakob Nielsen gjorde 2026 en obekväm iakttagelse: att verifiera AI-output är kognitivt ofta svårare än att själv producera den. Men just den verifieringen är rollen som återstår för människan. Och den blir desto viktigare ju bättre systemen blir.
Infrastrukturen för kontrollerad autonomi finns. SDK:erna levererar primitiverna. Frågan är bara om vi använder dem.
En agent som inte vet när den måste pausa är ingen autonom agent – den är en okontrollerad process.