
Je autonomer ’n Agent wird, desto wichtiger wird die Qualität vonne menschlichen Eingriffspunkte - nich dat man se abschafft.
Ein Kunde will ’ne Erstattung. Der Refund-Agent schlägt refund_order vor, die Parameter stimmen, die Berechtigung is geprüft. Und dann: ’n Approval-Banner. Der Workflow pausiert. Nix passiert, bis ’n Mensch auf “Bestätigen” klickt.
Der erste Reflex? “Warum kann der dat nich einfach machen?”
Ich kenn den Reflex. Wir bauen Agents, damit se Sachen für uns erledigen - und dann stellen wir denen ’n Stoppschild inne Quere. Dat fühlt sich an wie Friction. Wie ’n Rückschritt. Wie dat Gegenteil von Automatisierung. Nur: refund_order bewegt Geld. Echtes Geld. Und ’n Agent, der autonom Geld bewegen kann, is kein Feature - dat is ’n Risiko.
Dat requiresApproval: true im Tool-Catalog vom Refund-Agent is kein Zufall. Dat is ’ne architektonische Entscheidung - im vorherigen Post hab ich dat Policy Gate als Teil vonne “Definition of Done” für Agent-Tools eingeführt. Da war require_approval ein Punkt unter vielen. Hier wird dat getz dat zentrale Thema.

Pause is kein Bug, sondern Governance
Ein Approval-Punkt in ’nem Agent-System folgt ’nem einfachen Prinzip: Der Agent schlägt vor, der Mensch entscheidet, dat System führt aus. Drei Schritte, klare Verantwortung. Klingt nach Overhead - is aber Architektur.
Wichtig is, zwei Konzepte auseinanderzuhalten, die oft in einen Topf geworfen werden: Elicitation und Governance Gates. Elicitation heißt, dat der Agent aktiv nach Informationen fragt - “Welche Bestellnummer meinsse?” oder “Soll ich den Testbericht als PDF oder Markdown generieren?”. Der Agent braucht Input, um weiterzumachen. ’N Governance Gate is wat anderes: Dat System erzwingt ’ne Freigabe, bevor ’ne irreversible Aktion ausgeführt wird. Nich weil der Agent unsicher is, sondern weil die Aktion dat verlangt.
Elicitation is UX. Governance is Sicherheitsarchitektur.
Der Vergleich mit Pull Request Reviews hilft: Ja, PR-Reviews kosten Zeit. Ja, dat is ’n Bottleneck. Und trotzdem sind se in fast jedem professionellen Team Standard - weil der Schaden durch unkontrollierten Code in Produktion den Overhead überwiegt. Approval-Gates bei Agents sind dat gleiche Prinzip: ’n erzwungener Haltepunkt vor ’ner Zustandsänderung, die sich nich einfach rückgängig machen lässt. Wie der Schlagbaum anne Zechenausfahrt: Da kommt nix raus, ohne dat einer draufgeguckt hat.
Anthropics Analyse zu Claude Code liefert dazu ’ne interessante Beobachtung: Dat Modell pausiert in über 16 % vonne komplexen Turns von sich aus - mehr als doppelt so oft, wie Menschen den Agent unterbrechen (rund 7 %). Dat Modell erkennt seine eigene Unsicherheit und handelt danach. Et wartet nich drauf, gestoppt zu werden - et stoppt sich selbst.

Anthropics “Building Effective Agents” empfiehlt genau dat: Agents sollen bei Checkpoints pausieren und auf menschliches Feedback warten können. Die Philosophie dahinter lässt sich auf ein Prinzip runterkochen, dat ich für zentral halt - Least Agency: Gib dem Agent nur so viel Autonomie, wie die Aufgabe tatsächlich braucht. Nich mehr.
Wer in meinem Post zu Evals genau hingeguckt hat, erinnert sich vielleicht: Im Contract stand ausdrücklich User-Approval: Der Workflow sollte pausieren - als bewusste Design-Entscheidung, nich als Notlösung.

Pause/Resume is für Agent-Systeme dat, wat Pull Request Reviews für Code sind: nich optional, sondern Qualitätssicherung.
Wann Approval Pflicht is - und wann nich
Nich jede Agent-Aktion braucht ’nen Menschen. lookup_order abzunicken wär albern. Aber refund_order ohne Freigabe durchlaufen zu lassen wär fahrlässig. Die Frage is nich binär - dat is ’n Stufenmodell.
| Risiko-Stufe | Beispiel | Aktion |
|---|---|---|
| Read-Only | lookup_order, faq_search |
Auto-Allow |
| Low-Risk Mutation | reset_password |
Loggen, kein Approval |
| High-Risk Mutation | refund_order |
Approval erforderlich |
| Irreversibel | delete_account |
Approval + 4-Augen-Prinzip |
Read-Only is unkritisch - der Agent liest Daten, verändert aber keinen Zustand. Hier bremst ’n Approval-Gate nur den Flow, ohne dat et Sicherheit bringt. Low-Risk Mutations verändern Zustand, aber die Auswirkung is begrenzt und umkehrbar. ’N neues Passwort kann der User selbst zurücksetzen. Loggen reicht, damit der Audit-Trail vollständig bleibt. High-Risk Mutations bewegen Geld, ändern Verträge oder betreffen sensible Daten - hier muss ’n Mensch ausdrücklich freigeben, bevor dat System ausführt. Und irreversible Aktionen wie Account-Löschungen brauchen nich nur Approval, sondern ’n 4-Augen-Prinzip: ’Ne zweite Person bestätigt, wat die erste freigegeben hat.
Die Zuordnung is keine Wissenschaft - dat is ’ne bewusste Produkt-Entscheidung. Im Refund-Agent sieht dat konkret so aus:
Dat Stufenmodell is kein theoretisches Framework. Ab August 2026 wird dat auch regulatorisch relevant.
EU AI Act Art. 14: Fünf Pflicht-Fähigkeiten ab 2. August 2026
Der EU AI Act schreibt für High-Risk-Systeme fünf konkrete Human-Oversight-Fähigkeiten vor:
- Verstehen & Überwachen - Kapazitäten, Limitierungen und Anomalie-Erkennung (Art. 14(4)(a))
- Automation Bias Awareness - Bewusstsein für Über-Vertrauen in AI-Output (Art. 14(4)(b))
- Output korrekt interpretieren - mittels Interpretations-Tools (Art. 14(4)(c))
- Override oder Reverse - jede AI-Entscheidung umkehren oder ignorieren können (Art. 14(4)(d))
- Eingreifen oder Stoppen - Safe-Halt via Stop-Button o.Ä. (Art. 14(4)(e))
Bemerkenswert: Art. 14(4)(b) spricht ausdrücklich Automation Bias an - Behavioral Science in Hard Law. Bei Verstößen drohen bis zu 15 Mio. EUR oder 3% vom globalen Jahresumsatz. Dat is keine Portokasse.
Nich jede Aktion braucht ’nen Menschen. Aber jede risikoreiche Aktion braucht die Möglichkeit von ’nem Menschen. Und die muss architektonisch vorgesehen sein - nich hinterher drangeschraubt.
Wie ’n Approval-Flow technisch funktioniert
Vom Stufenmodell zur Implementierung. Dat grundlegende Pattern is überraschend simpel - die Komplexität liegt woanders, als die meisten denken.
Dat Pattern
Jeder Approval-Flow läuft gleich ab: Der Agent formuliert ’nen Tool-Intent. ’N Policy Gate prüft, ob der Intent ’ne Genehmigung braucht. Wenn ja, pausiert die Execution, der Intent landet in ’ner Approval Queue, ’n Mensch entscheidet - und erst dann wird der Tool-Call tatsächlich ausgeführt. Oder eben nich.
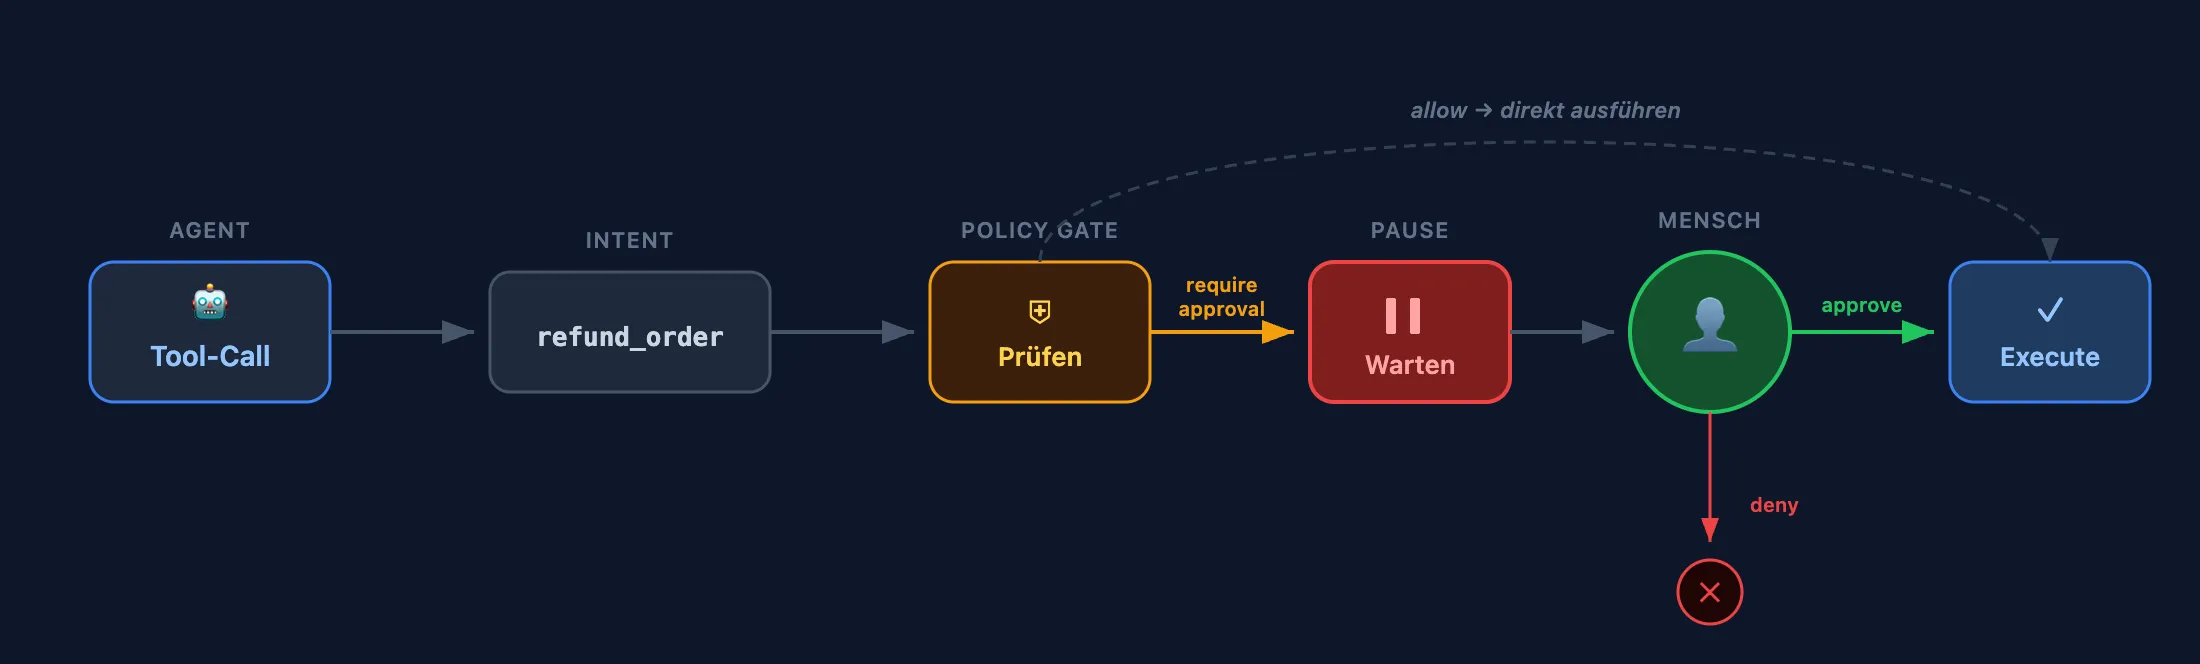
Im Code is dat erstaunlich wenig Aufwand. Im Vercel AI SDK reicht ein einziges Flag anne Tool-Definition:
const refundOrder = tool({
  description: 'Process a refund for an order',
  parameters: z.object({
    orderId: z.string(),
    reason: z.string(),
  }),
  needsApproval: true,
  execute: async ({ orderId, reason }) => {
    return await processRefund(orderId, reason);
  },
});
needsApproval: true - dat is alles. Der Server wartet, bis der Client über addToolApprovalResponse ’ne Entscheidung schickt. Approved? Der Tool-Call wird ausgeführt. Denied? Der Agent kricht die Ablehnung als Kontext und kann reagieren.
Die eigentliche Herausforderung steckt nich im Pattern selbst, sondern in dem, wat drumherum passieren muss: State Persistence, Crash Recovery, und die Frage, wat mit ’nem Approval passiert, dat erst nach drei Stunden kommt.
SDK-Vergleich
| Dimension | Vercel AI SDK | OpenAI Agents SDK | LangGraph | Temporal |
|---|---|---|---|---|
| Pause-Mechanismus | needsApproval auf Tool |
needs_approval auf Tool |
interrupt() in Node |
workflow.wait_condition() |
| State-Persistenz | Client-State (React) | Explizit via RunState.to_json() |
Automatischer Checkpointer | Automatische Event History |
| Crash Recovery | Session-abhängig | Manuell (Rehydrate aus DB) | Checkpointer-abhängig | Vollautomatisches Replay |
| Best Fit | React/Next.js Chat-UIs | Leichtgewichtige Agent-Tools | Graph-basierte Workflows | Enterprise Long-Running |
Vercel und OpenAI setzen auf deklarative Flags direkt am Tool - der einfachste Einstieg. LangGraph checkpointet automatisch, aber Code vor ’nem interrupt() muss idempotent sein, weil die ganze Node beim Resume von vorne läuft. Temporal spielt in ’ner anderen Liga, so wie der BVB gegen die Kreisliga: praktisch unbegrenzte Wartezeit, vollautomatisches Replay beim Crash, Signals für externe Entscheidungen.
Approval mitm OpenAI Agents SDK (Python)
result = await Runner.run(agent, "Delete temp files no longer needed.")
if result.interruptions:
    state = result.to_state()
    serialized = state.to_json()        # persist to DB for async approval
    # ... later, after human decision ...
    state = RunState.from_json(agent, serialized)
    state.approve(result.interruptions[0])
    result = await Runner.run(agent, state)
Auch MCP liefert inzwischen ’n passendes Primitiv: Elicitation erlaubt et ’nem MCP-Server, während der Tool-Execution auf User-Input zu warten - vor allem für fehlende Informationen, nich für Governance. Aber dat Pause/Resume-Muster dahinter (accept, decline, cancel) is dat gleiche. Ein standardisiertes Governance-Gate-Protokoll fehlt in MCP noch - dat Primitiv dafür is aber da.
Wat der Approver sehen muss
Technisch funktioniert dat alles. Aber ’n Approval-Flow is nur so gut wie die Information, die der Approver kricht. Wer will wat, auf welchem Objekt, warum, mit welchem Risiko - dat muss auf einen Blick klar sein. Nich der ganze Chat-Verlauf, nich jeder Zwischenschritt vonne Agent-Konversation. Sondern ’ne eingedampfte Entscheidungsgrundlage.
Im Refund-Agent sieht dat so aus: ’N Approval-Banner zeigt Tool-Name und Argumente als JSON. Approve oder Deny. Und jede Entscheidung wird Teil von ’nem strukturierten Audit-Trail - mit Actor, Subject, approvalOutcome, approvalId und Prompt-Version-Hash.
Der Approval-Flow is kein technisches Problem. Dat is ’n Produkt-Problem: Wat braucht ’n Mensch, um in drei Sekunden die richtige Entscheidung zu treffen?
Durable Execution
Inne Demo reicht Session State. In Produktion nich. Approvals, die Stunden oder Tage dauern, brauchen Durable Execution. ’N Browser-Tab, der zugeht, darf keinen genehmigten Refund ins Nirwana schicken.
Dat Rubber-Stamp-Problem: Wenn Approval zur Farce wird
Wir wissen getz, wie Approval-Flows gebaut werden. Die Frage is nich, ob wir se bauen können - sondern ob se wirken. Dat ehrlichste Gegenargument liegt auffe Hand: Wat bringt ’n Approval-Schritt, wenn der Mensch sowieso alles durchwinkt?
Die Antwort is unbequem. Denn genau dat passiert - und zwar systematisch.
Automation Complacency
Dat Phänomen hat ’nen Namen: Automation Complacency. Je zuverlässiger ’n System arbeitet, desto weniger kritisch prüft der Mensch dem sein Output. Dat is kein Versagen vom Einzelnen, sondern ’n gut dokumentierter kognitiver Effekt. Und der wird schlimmer, je besser die AI wird.
Die Zahlen sind eindeutig. Klinische Decision-Support-Systeme zeigen Override-Raten von 90-95 % - neun von zehn Warnungen werden wechgeklickt. ’N Teil davon is vernünftig, weil viele Alerts klinisch irrelevant sind. Aber genau dat is dat Problem: Wenn 90 % der Warnungen Rauschen sind, trainiert dat System den Menschen, nich mehr hinzugucken. ’Ne JAMA-Studie mit 457 Klinikern ging weiter: Wenn die AI absichtlich fehlerhafte Empfehlungen gab, sank die diagnostische Accuracy von 73 % auf 61,7 %. Die AI hat die Entscheidungen nich besser gemacht - se hat die Menschen schlechter gemacht.
Wenn Rubber-Stamping zum Systemversagen wird
Der niederländische Kinderbeihilfe-Skandal von 2021 zeigt, wat passiert, wenn Rubber-Stamping auf Verwaltungsebene eskaliert. Technisch war dat System HITL - Sachbearbeiter mussten die ML-basierten Betrugsbewertungen prüfen und freigeben. Inne Praxis hat keiner den Output hinterfragt. Tausende Familien wurden fälschlich als Betrüger eingestuft. Die Regierung trat zurück.
Der Europäische Gerichtshof hat 2023 im SCHUFA-Urteil (C-634/21) die juristische Konsequenz gezogen: Wenn ’n Mensch den AI-Output nur durchwinkt, ohne substanziell zu prüfen, gilt dat als “solely automated decision-making” unter GDPR Art. 22. Rubber-Stamping is nich nur ’n UX-Problem - dat is ’n Compliance-Risiko.
Design-Patterns gegen Rubber-Stamping
Die Forschung zeigt aber auch: Rubber-Stamping is kein Naturgesetz. Dat is ’n Design-Problem.
Cognitive Forcing Functions (Buçinca et al. 2021) zwingen den Reviewer, sich ’n eigenes Urteil zu bilden, bevor die AI-Empfehlung sichtbar wird. Klingt banal, hat aber den stärksten Effekt auf Overreliance.
Variable Challenge Injection mischt bekannte gut/schlecht-Items inne Review-Queue - sogenannte Trap Tasks. Wer drei fingierte Fälle hintereinander falsch bewertet, kricht Feedback. Dat hält die Aufmerksamkeit hoch.
Mandatory Justification ersetzt den Approve-Button durch ’n strukturiertes Begründungsfeld. Nich “Approve/Reject”, sondern “Wat genau hasse geprüft, und warum is dat Ergebnis korrekt?”
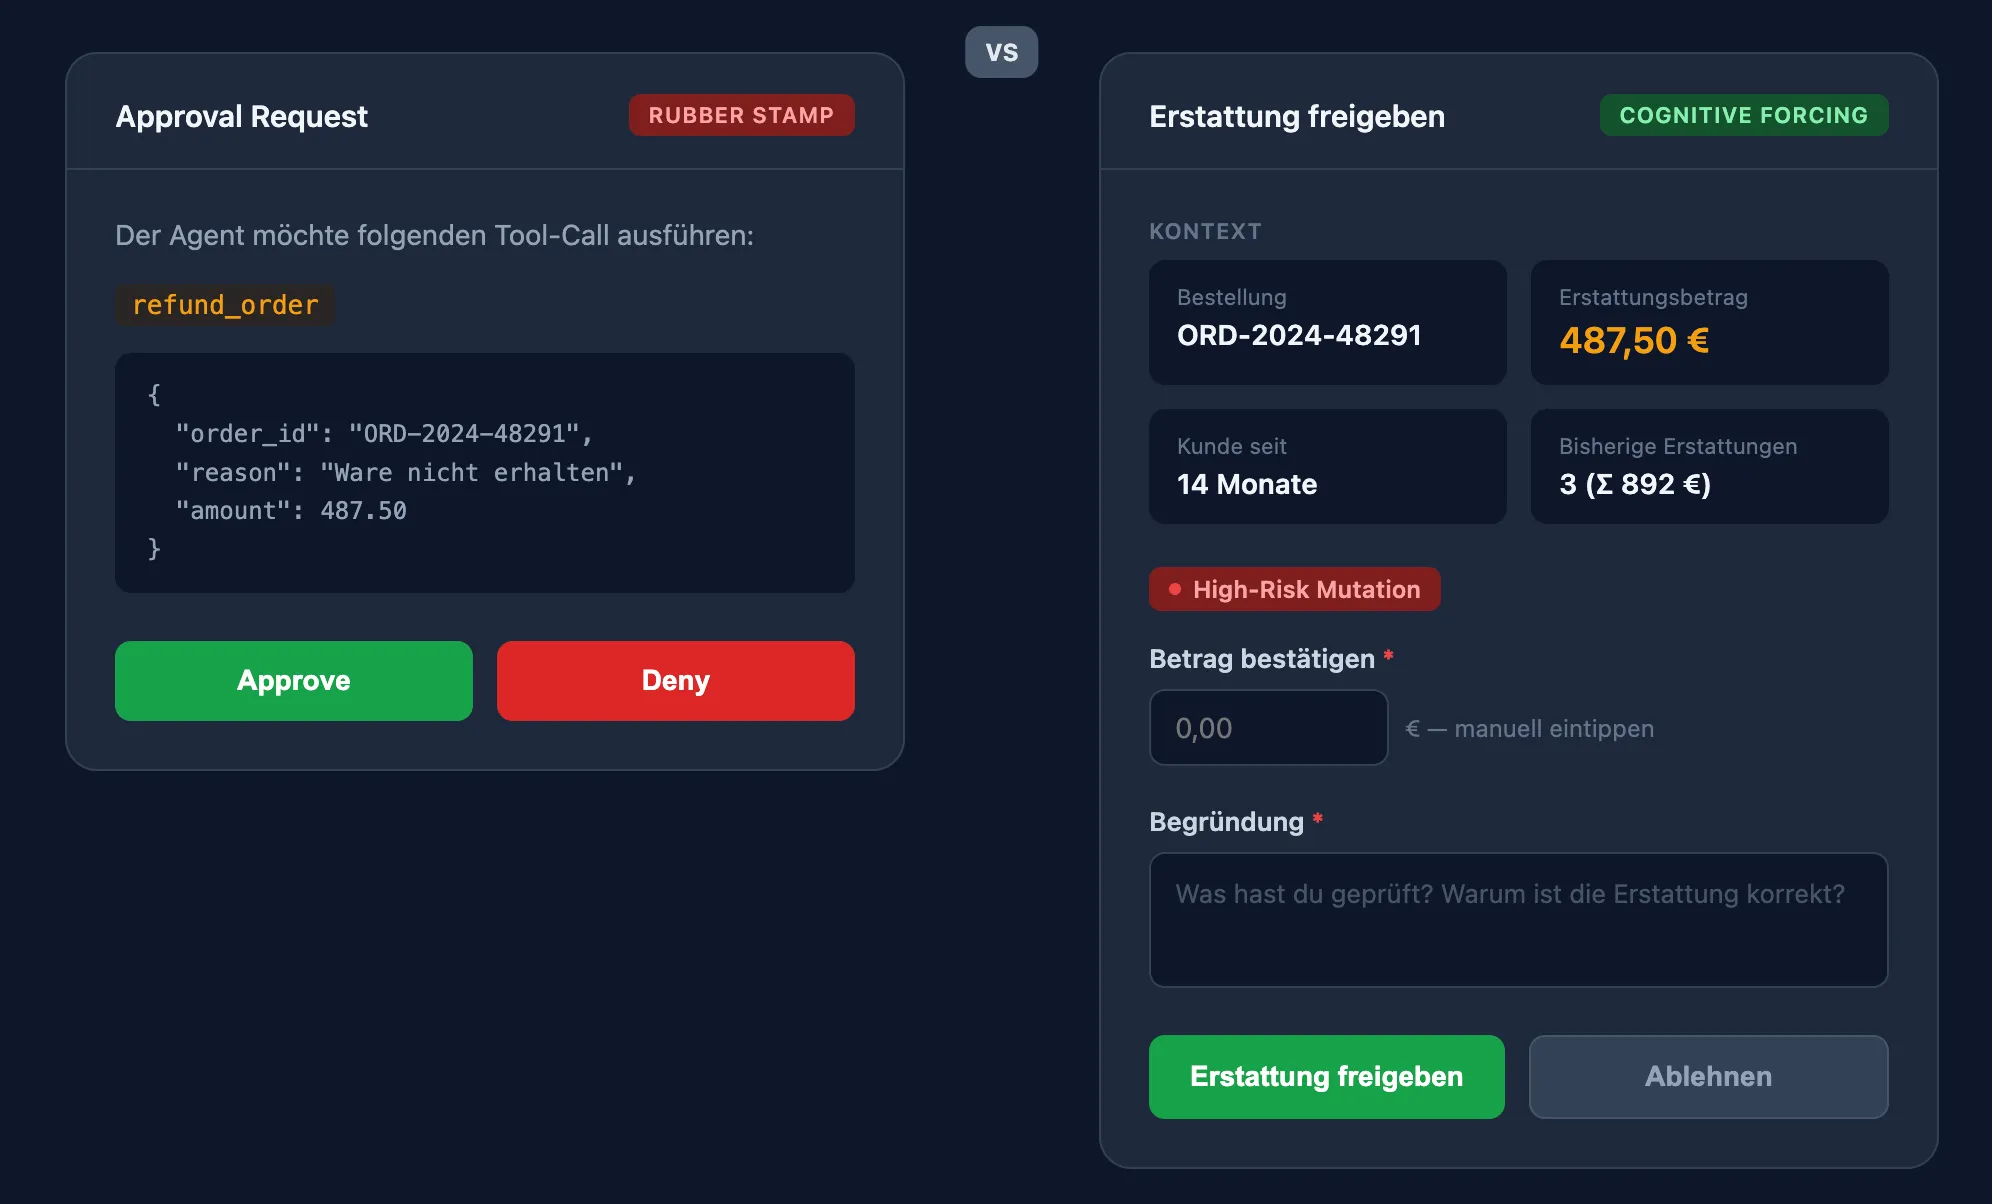
Ein Systematic Review von 2025 (Springer) dampft dat Kernfinding ein: AI-Erklärungen allein - also Transparenz darüber, warum die AI so entschieden hat - reichen nich. Der wirksamste Hebel is aktives User Engagement. Der Mensch muss malochen, nich nur zugucken.
Und hier wird et unbequem: Buçinca et al. fanden raus, dat genau die Designs, die Overreliance am stärksten reduziert haben, die schlechtesten subjektiven Bewertungen vonne User gekricht haben. Die Nutzer mochten die Cognitive Forcing Functions nich. Gutes Approval-Design is unbequem - by design. Wer den Approval-Prozess so baut, dat er sich gut anfühlt, hat dat Problem wahrscheinlich nich gelöst.
Wer HITL als UX-Bug betrachtet, hat noch nie ’nen echten Incident Report aus Produktion gelesen.
Kontrolle is kein Rückschritt
Die Frage war nie “HITL ja oder nein”. Die Frage is: Wie viel Autonomie verträgt welche Aktion - und wie verändert sich dat über die Zeit?
Dat Risiko-Stufenmodell bestimmt, welches Tool welches Gate braucht. Aber et gibt ’ne zweite Achse: Wie viel Oversight braucht dat Gesamtsystem? ’N neues Tool in ’ner unerprobten Domain startet im Audit-Modus - der Mensch reviewt jede Aktion. Mit gemessener Performance (Accuracy, Override-Frequenz, Exception Rates) kann dat System nach und nach in den Assist-Modus wechseln: Die AI agiert, der Mensch monitort. Und irgendwann läuft et innerhalb klar definierter Grenzen fast autonom - aber die Grenzen bleiben architektonisch erzwungen, nich auf Vertrauen gebaut. Wie beim Neuen unter Tage: Erst geht der Steiger überall mit, irgendwann nich mehr, aber die Sicherheitsvorschriften bleiben trotzdem.
Jakob Nielsen hat 2026 ’ne unbequeme Beobachtung gemacht: AI-Output zu verifizieren is im Kopp oft schwieriger, als ihn selbst zu produzieren. Aber genau diese Verifikation is die Rolle, die dem Menschen bleibt. Und die wird umso wichtiger, je besser die Systeme werden.
Die Infrastruktur für kontrollierte Autonomie is da. Die SDKs liefern die Primitives. Die Frage is nur noch, ob wir se nutzen.
’N Agent, der nich weiß, wann er pausieren muss, is kein autonomer Agent - dat is ’n unkontrollierter Prozess.