
Jo mer autonom en agent blir, desto viktigere blir kvaliteten på punktene der mennesker griper inn – ikke å avskaffe dem.
En kunde vil ha refusjon. Refund-agenten foreslår refund_order, parameterne stemmer, tilgangen er sjekket. Og så: et approval-banner. Workflowen pauser. Ingenting skjer før et menneske klikker på “Bekreft”.
Den første refleksen? “Hvorfor kan den ikke bare gjøre det?”
Jeg kjenner den refleksen. Vi bygger agenter for at de skal gjøre ting for oss – og så setter vi et stoppskilt i veien for dem. Det føles som friksjon. Som et tilbakeskritt. Som det motsatte av automatisering. Men refund_order flytter penger. Ekte penger. Og en agent som kan flytte penger på egen hånd, er ingen feature – den er en risiko.
requiresApproval: true i tool-katalogen til refund-agenten er ingen tilfeldighet. Det er en arkitektonisk beslutning – i forrige innlegg introduserte jeg policy gaten som en del av “Definition of Done” for agent-tools. Der var require_approval ett punkt av mange. Her blir det hovedtemaet.

Pause er ingen bug, men governance
Et approval-punkt i et agentsystem følger et enkelt prinsipp: Agenten foreslår, mennesket bestemmer, systemet utfører. Tre steg, klart ansvar. Det høres ut som overhead – men er arkitektur.
Det er viktig å skille mellom to konsepter som ofte blandes sammen: elicitation og governance gates. Elicitation betyr at agenten aktivt spør etter informasjon – “Hvilket ordrenummer mener du?” eller “Skal jeg lage testrapporten som PDF eller Markdown?”. Agenten trenger input for å jobbe videre. En governance gate er noe annet: Systemet tvinger frem en godkjenning før en irreversibel handling blir utført. Ikke fordi agenten er usikker, men fordi handlingen krever det.
Elicitation er UX. Governance er sikkerhetsarkitektur.
Analogien til pull request-reviews hjelper: Ja, PR-reviews tar tid. Ja, de er en flaskehals. Og likevel er de standard i nesten alle profesjonelle team – fordi skaden fra ukontrollert kode i produksjon veier tyngre enn overheaden. Approval-gates for agenter er samme prinsipp: et påtvunget stoppunkt før en tilstandsendring som ikke uten videre kan gjøres om.
Anthropics analyse av Claude Code gir en interessant observasjon her: Modellen pauser av seg selv i over 16 % av komplekse turns – mer enn dobbelt så ofte som mennesker avbryter agenten (rundt 7 %). Modellen gjenkjenner sin egen usikkerhet og handler deretter. Den venter ikke på å bli stoppet – den stopper seg selv.

Anthropics “Building Effective Agents” anbefaler nettopp dette: Agenter skal kunne pause ved checkpoints og vente på tilbakemelding fra mennesker. Filosofien bak kan kokes ned til et prinsipp jeg mener er sentralt – least agency: Gi agenten bare så mye autonomi som oppgaven faktisk krever. Ikke mer.
Den som leste innlegget mitt om evals nøye, husker kanskje: I contracten sto det eksplisitt User-Approval: Workflowen skal pause – som en bevisst designbeslutning, ikke som en nødløsning.

Pause/resume er for agentsystemer det pull request-reviews er for kode: ikke valgfritt, men kvalitetssikring.
Når approval er påkrevd – og når ikke
Ikke alle agenthandlinger trenger et menneske. Å nikke gjennom lookup_order ville vært absurd. Men å la refund_order gå gjennom uten godkjenning ville vært uaktsomt. Spørsmålet er ikke binært – det er en trappemodell.
| Risikonivå | Eksempel | Handling |
|---|---|---|
| Read-only | lookup_order, faq_search |
Auto-allow |
| Low-risk mutation | reset_password |
Logg, ingen approval |
| High-risk mutation | refund_order |
Approval påkrevd |
| Irreversibel | delete_account |
Approval + firøyneprinsippet |
Read-only er ukritisk – agenten leser data, men endrer ingen tilstand. Her bremser en approval-gate bare flyten uten å gi mer sikkerhet. Low-risk mutations endrer tilstand, men virkningen er begrenset og reversibel. Et nytt passord kan brukeren tilbakestille selv. Det holder å logge, så audit trailen forblir komplett. High-risk mutations flytter penger, endrer kontrakter eller berører sensitive data – her må et menneske eksplisitt godkjenne før systemet utfører. Og irreversible handlinger som sletting av kontoer trenger ikke bare approval, men firøyneprinsippet: En annen person bekrefter det den første har godkjent.
Inndelingen er ingen vitenskap – den er en bevisst produktbeslutning. I refund-agenten ser det konkret slik ut:
Denne trappemodellen er ikke noe teoretisk rammeverk. Fra august 2026 blir den også regulatorisk relevant.
EUs KI-forordning art. 14: fem påkrevde evner fra 2. august 2026
EUs KI-forordning (AI Act) foreskriver fem konkrete evner til menneskelig tilsyn (human oversight) for høyrisikosystemer:
- Forstå og overvåke – kapasiteter, begrensninger og avviksdeteksjon (art. 14(4)(a))
- Bevissthet om automation bias – bevissthet om overdreven tillit til AI-output (art. 14(4)(b))
- Tolke output riktig – ved hjelp av tolkningsverktøy (art. 14(4)(c))
- Overstyre eller reversere – kunne omgjøre eller se bort fra enhver AI-beslutning (art. 14(4)(d))
- Gripe inn eller stoppe – safe halt via stoppknapp e.l. (art. 14(4)(e))
Verdt å merke seg: Art. 14(4)(b) tar eksplisitt for seg automation bias – atferdsforskning i hard lov. Ved brudd risikerer man bøter på opptil 15 mill. EUR eller 3 % av den globale årsomsetningen.
Ikke alle handlinger trenger et menneske. Men alle risikable handlinger trenger muligheten for et menneske. Og den må være planlagt inn i arkitekturen – ikke skrudd på i etterkant.
Hvordan en approval-flow fungerer teknisk
Fra trappemodell til implementasjon. Det grunnleggende mønsteret er overraskende enkelt – kompleksiteten ligger et annet sted enn de fleste tror.
Mønsteret
Hver approval-flow følger samme forløp: Agenten formulerer en tool-intent. En policy gate sjekker om denne intenten krever godkjenning. Hvis ja, pauser kjøringen, intenten havner i en approval-kø, et menneske bestemmer – og først da blir tool callet faktisk utført. Eller ikke.
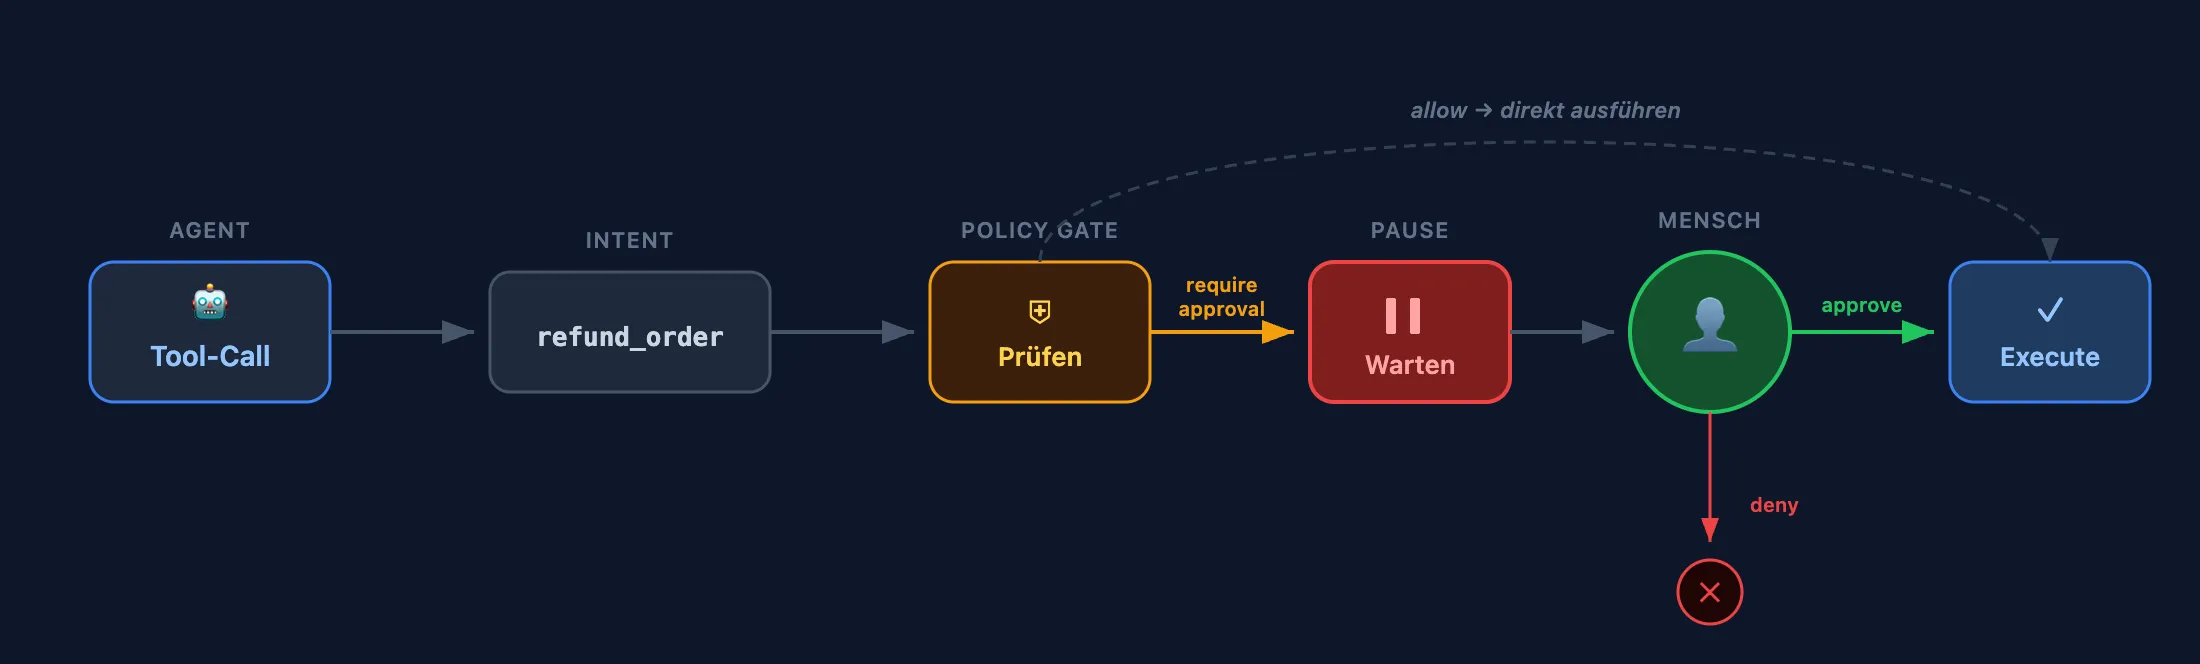
I kode er dette overraskende lite arbeid. I Vercel AI SDK holder det med ett eneste flagg på tool-definisjonen:
const refundOrder = tool({
  description: 'Process a refund for an order',
  parameters: z.object({
    orderId: z.string(),
    reason: z.string(),
  }),
  needsApproval: true,
  execute: async ({ orderId, reason }) => {
    return await processRefund(orderId, reason);
  },
});
needsApproval: true – det er alt. Serveren venter til klienten sender en beslutning via addToolApprovalResponse. Godkjent? Tool callet blir utført. Avvist? Agenten får avvisningen som kontekst og kan reagere.
Den egentlige utfordringen ligger ikke i selve mønsteret, men i det som må skje rundt det: state persistence, crash recovery, og spørsmålet om hva som skjer med en approval som først kommer etter tre timer.
SDK-sammenligning
| Dimensjon | Vercel AI SDK | OpenAI Agents SDK | LangGraph | Temporal |
|---|---|---|---|---|
| Pausemekanisme | needsApproval på tool |
needs_approval på tool |
interrupt() i node |
workflow.wait_condition() |
| State-persistens | Klient-state (React) | Eksplisitt via RunState.to_json() |
Automatisk checkpointer | Automatisk event history |
| Crash recovery | Avhengig av sesjon | Manuell (rehydrering fra DB) | Avhengig av checkpointer | Helautomatisk replay |
| Passer best til | Chat-UI-er i React/Next.js | Lettvekts agent-tools | Grafbaserte workflows | Enterprise long-running |
Vercel og OpenAI satser på deklarative flagg direkte på toolet – den enkleste inngangen. LangGraph checkpointer automatisk, men kode før en interrupt() må være idempotent, fordi hele noden kjøres fra start ved resume. Temporal spiller i en annen liga: praktisk talt ubegrenset ventetid, helautomatisk replay ved krasj, signals for eksterne beslutninger.
Approval med OpenAI Agents SDK (Python)
result = await Runner.run(agent, "Delete temp files no longer needed.")
if result.interruptions:
    state = result.to_state()
    serialized = state.to_json()        # persist to DB for async approval
    # ... later, after human decision ...
    state = RunState.from_json(agent, serialized)
    state.approve(result.interruptions[0])
    result = await Runner.run(agent, state)
Også MCP har nå en relevant primitiv: Elicitation lar en MCP-server vente på brukerinput under tool-kjøringen – primært for manglende informasjon, ikke for governance. Men det underliggende pause/resume-mønsteret (accept, decline, cancel) er det samme. En standardisert protokoll for governance gates mangler fortsatt i MCP – men primitiven for det er der.
Hva godkjenneren må se
Teknisk fungerer alt dette. Men en approval-flow er aldri bedre enn informasjonen godkjenneren får. Hvem vil hva, på hvilket objekt, hvorfor, med hvilken risiko – det må kunne fanges opp med ett blikk. Ikke hele chatloggen, ikke hvert mellomsteg i agentsamtalen. Men et komprimert beslutningsgrunnlag.
I refund-agenten ser det slik ut: Et approval-banner viser toolnavn og argumenter som JSON. Approve eller deny. Og hver beslutning blir en del av en strukturert audit trail – med actor, subject, approvalOutcome, approvalId og hash av promptversjonen.
Approval-flowen er ikke et teknisk problem. Den er et produktproblem: Hva trenger et menneske for å ta riktig beslutning på tre sekunder?
Durable execution
I demoen holder session state. I produksjon gjør det ikke det. Approvals som tar timer eller dager, trenger durable execution. En nettleserfane som lukkes, får ikke sende en godkjent refusjon ut i det blå.
Rubber stamp-problemet: når approval blir en farse
Nå vet vi hvordan approval-flows bygges. Spørsmålet er ikke om vi kan bygge dem – men om de virker. Det ærligste motargumentet ligger i dagen: Hva hjelper et approval-steg hvis mennesket uansett vinker alt gjennom?
Svaret er ubehagelig. For det er akkurat det som skjer – og det systematisk.
Automation complacency
Fenomenet har et navn: automation complacency. Jo mer pålitelig et system fungerer, desto mindre kritisk sjekker mennesket outputen. Det er ikke individuell svikt, men en godt dokumentert kognitiv effekt. Og den blir verre jo bedre AI-en blir.
Tallene er entydige. Kliniske decision support-systemer viser override-rater på 90–95 % – ni av ti advarsler blir klikket bort. En del av dette er rasjonelt, fordi mange alerts er klinisk irrelevante. Men det er nettopp problemet: Når 90 % av advarslene er støy, trener systemet mennesket til å slutte å se etter. En JAMA-studie med 457 klinikere gikk lenger: Når AI-en med vilje ga feilaktige anbefalinger, falt den diagnostiske accuracyen fra 73 % til 61,7 %. AI-en gjorde ikke beslutningene bedre – den gjorde menneskene dårligere.
Når rubber stamping blir systemsvikt
Den nederlandske barnetrygdskandalen fra 2021 viser hva som skjer når rubber stamping eskalerer på forvaltningsnivå. Teknisk sett var systemet HITL – saksbehandlere måtte sjekke og godkjenne de ML-baserte svindelvurderingene. I praksis var det ingen som stilte spørsmål ved outputen. Tusenvis av familier ble feilaktig stemplet som svindlere. Regjeringen gikk av.
EU-domstolen trakk den juridiske konsekvensen i 2023 i SCHUFA-dommen (C-634/21): Hvis et menneske bare vinker AI-outputen gjennom uten å sjekke den substansielt, regnes det som “solely automated decision-making” etter GDPR art. 22. Rubber stamping er ikke bare et UX-problem – det er en compliance-risiko.
Designmønstre mot rubber stamping
Forskningen viser imidlertid også: Rubber stamping er ingen naturlov. Det er et designproblem.
Cognitive forcing functions (Buçinca et al. 2021) tvinger revieweren til å danne seg en uavhengig vurdering før AI-anbefalingen blir synlig. Det høres trivielt ut, men har sterkest effekt på overreliance.
Variable challenge injection blander kjente gode/dårlige elementer inn i review-køen – såkalte trap tasks. Den som vurderer tre fingerte tilfeller feil på rad, får tilbakemelding. Det holder oppmerksomheten oppe.
Mandatory justification erstatter approve-knappen med et strukturert begrunnelsesfelt. Ikke “Approve/Reject”, men “Hva nøyaktig har du sjekket, og hvorfor er resultatet riktig?”
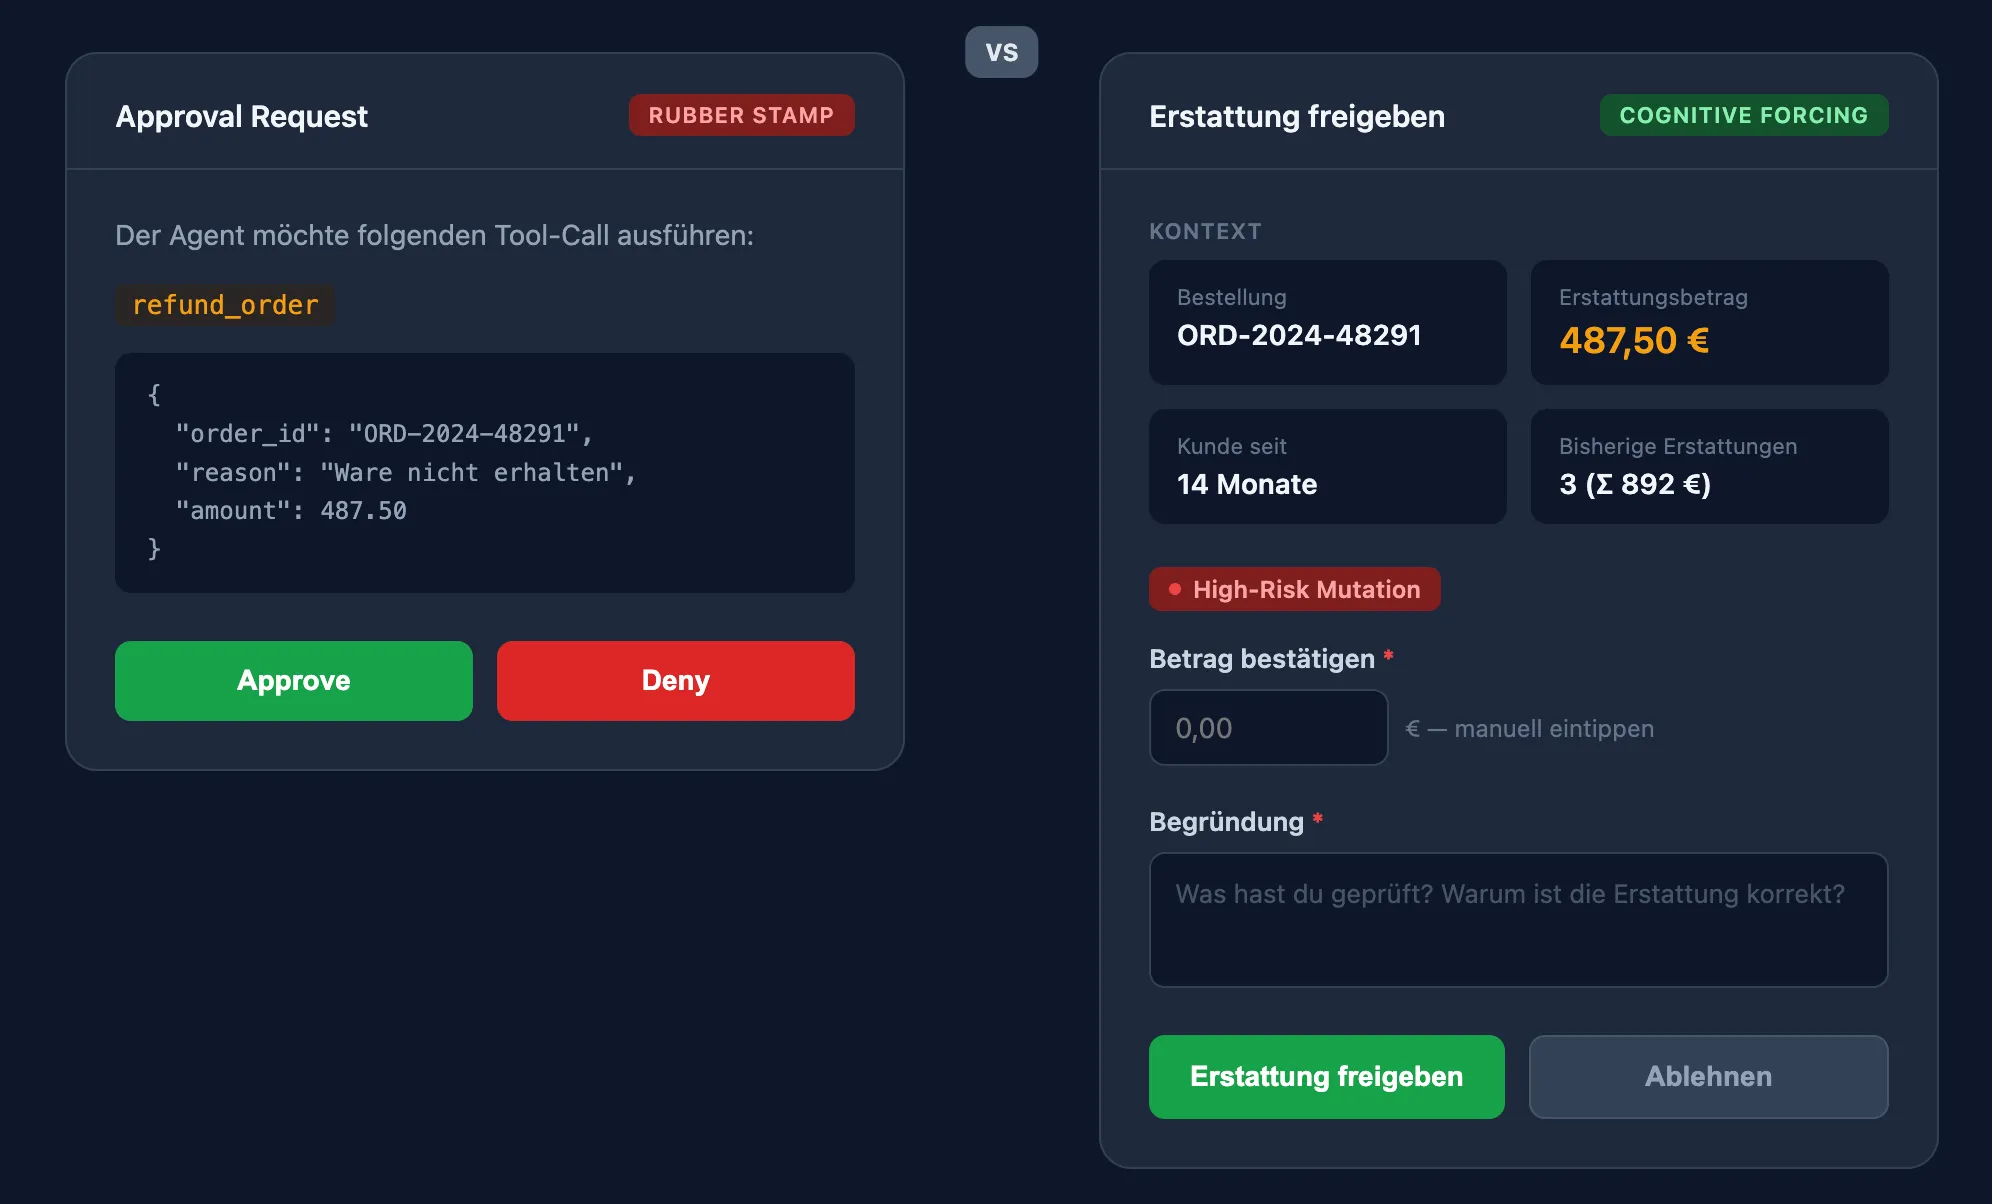
En systematisk review fra 2025 (Springer) destillerer kjernefunnet: AI-forklaringer alene – altså åpenhet om hvorfor AI-en bestemte som den gjorde – er ikke nok. Den mest effektive spaken er aktivt user engagement. Mennesket må jobbe, ikke bare se på.
Og her blir det ubehagelig: Buçinca et al. fant at nettopp de designene som reduserte overreliance mest, fikk de dårligste subjektive vurderingene fra brukerne. Brukerne likte ikke cognitive forcing functions. Godt approval-design er ubehagelig – by design. Den som utformer approval-prosessen slik at den føles god, har sannsynligvis ikke løst problemet.
Den som ser på HITL som en UX-bug, har aldri lest en incident report fra produksjon.
Kontroll er ikke et tilbakeskritt
Spørsmålet var aldri “HITL ja eller nei”. Spørsmålet er: Hvor mye autonomi tåler hvilken handling – og hvordan endrer det seg over tid?
Trappemodellen for risiko avgjør hvilket tool som trenger hvilken gate. Men det finnes en andre akse: Hvor mye oversight trenger systemet som helhet? Et nytt tool i et uprøvd domene starter i audit-modus – mennesket reviewer hver handling. Med målt ytelse (accuracy, override-frekvens, exception rates) kan systemet gradvis gå over i assist-modus: AI-en handler, mennesket overvåker. Og på et tidspunkt opererer det nesten autonomt innenfor klart definerte grenser – men grensene forblir håndhevet av arkitekturen, ikke bygget på tillit.
Jakob Nielsen kom i 2026 med en ubehagelig observasjon: Å verifisere AI-output er kognitivt ofte vanskeligere enn å produsere den selv. Men det er nettopp denne verifiseringen som er rollen som gjenstår for mennesket. Og den blir desto viktigere jo bedre systemene blir.
Infrastrukturen for kontrollert autonomi er på plass. SDK-ene leverer primitivene. Spørsmålet er bare om vi bruker dem.
En agent som ikke vet når den må pause, er ingen autonom agent – den er en ukontrollert prosess.