
La plupart des démos d’IA n’échouent pas à cause du modèle. Elles échouent parce qu’elles produisent du texte libre - alors que l’application a en réalité besoin de contrats. Dès qu’un modèle ne se contente plus de répondre gentiment dans une fenêtre de chat, mais déclenche de la logique produit, de bons prompts ne suffisent plus.
L’AI FullStack Engineering commence là où l’output du modèle devient une partie du système - c’est-à-dire là où j’ai besoin d’un Contract, d’une évaluation et d’Observability.
Repo : https://github.com/rubenvitt/plan-from-issue
Webapp finie : https://plan-from-issue.pages.dev/
La préparation : notre exemple
Pour rendre tout ça un peu plus concret, je veux commencer par un exemple : une mini-webapp qui transforme une issue GitHub ou n’importe quel texte de ticket (par exemple de Jira ou GitLab) en plan de mise en œuvre structuré. Pour ça, je pars d’abord d’une structure cible, qui me sert à expliquer une feature AI-FullStack.
{
  "summary": "string",
  "affectedAreas": ["frontend", "backend", "database", "infra"],
  "risks": ["string"],
  "implementationSteps": ["string"],
  "testIdeas": ["string"],
  "requiresApproval": true
}
À partir de cet exemple, il est facile de faire générer une webapp qui, en s’appuyant sur cette structure cible, me présentera de façon pertinente différents plans de mise en œuvre - dans ce cas, c’est Claude Code qui l’a réalisée pour moi.
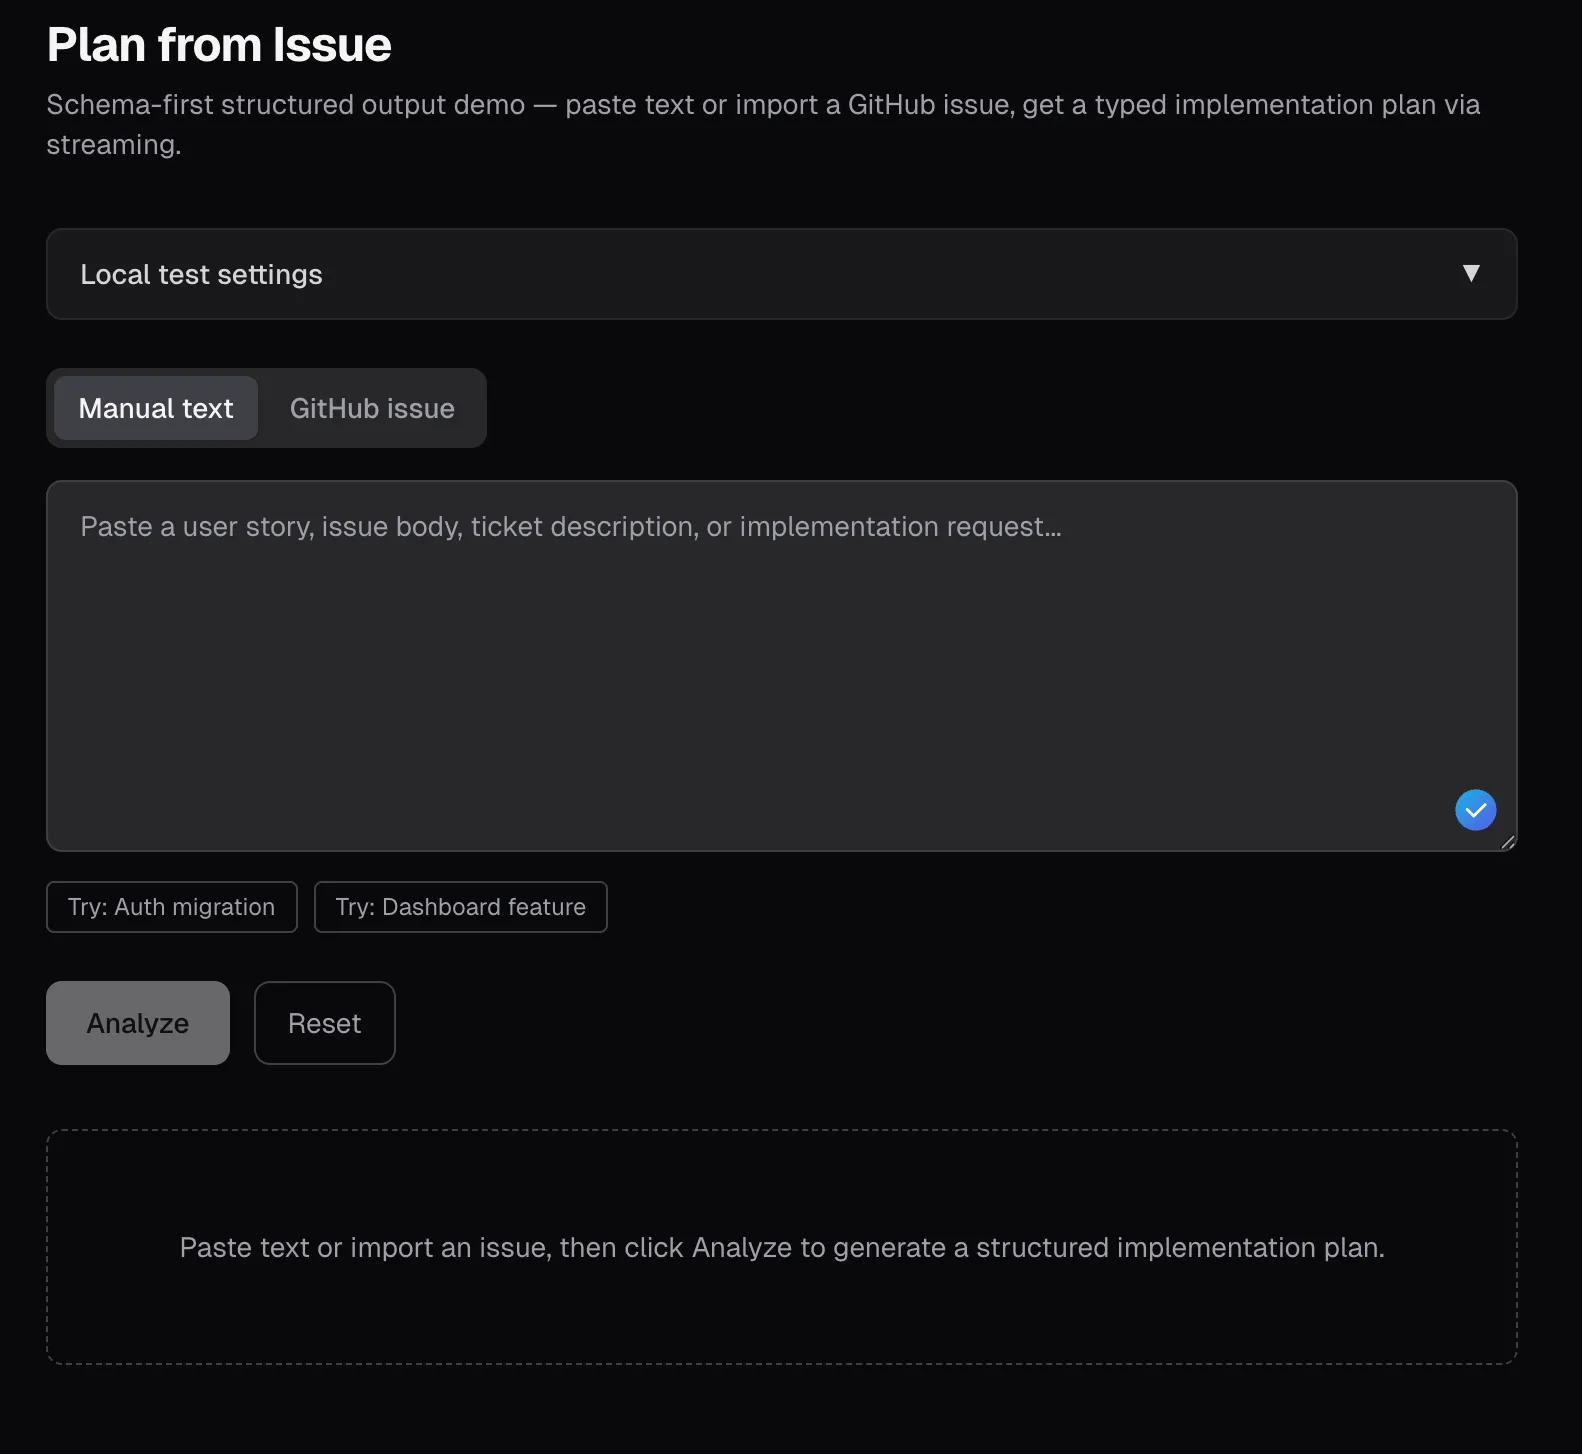
Dans la webapp générée, l’utilisateur peut saisir une issue dans la zone de texte ou la récupérer depuis GitHub - et l’afficher de façon structurée. Bien sûr, c’est un cas d’usage vraiment simple et vite trouvé, mais les principes et concepts expliqués valent aussi pour des UI plus élaborées - ici, ils sont simplement faciles à suivre.
Contract-first plutôt que prompt-first
Avec l’exemple ci-dessus, j’ai laissé Claude tout générer d’un coup - en fait, on pourrait s’arrêter là. L’appli fonctionne (à partir d’un prompt rédigé par ChatGPT).
Prompt généré pour créer la démo
You are a senior TypeScript engineer. Build a small but polished demo web app that showcases schema-first AI output using the Vercel AI SDK.
Do not ask follow-up questions. Make reasonable choices and implement the full app end-to-end. Do not leave placeholders or stubs. Keep the code compact, readable, and suitable for a public demo repo / blog post.
Goal
Build a mini web app that turns either:
- freeform story / ticket text
- a GitHub issue
into a structured implementation plan.
The point of the app is to demonstrate that the AI feature is contract-first, not chat-first.
Stack
Use:
- Next.js App Router
- TypeScript
- AI SDK
- AI SDK UI
- Zod
- @ai-sdk/openai
- minimal styling only (simple CSS or Tailwind is fine)
- no database
- no authentication system
- no server-side persistence
Non-negotiable AI SDK architecture
Use these exact patterns:
- shared Zod schema imported by both client and server
- streamText + Output.object(…) in the route handler
- experimental_useObject on the client
- createOpenAI(…) to instantiate the provider with a request-specific API key
- custom request headers from the client to the analyze route
- no plain-text fallback mode for the main analysis flow
- do not use useChat for the main experience
This app is object-generation first, not chat first.
Core JSON contract
The app must use this exact top-level JSON shape and these exact property names:
{ "summary": "string", "affectedAreas": ["frontend", "backend", "database", "infra"], "risks": ["string"], "implementationSteps": ["string"], "testIdeas": ["string"], "requiresApproval": true }Implement it as a shared Zod schema and export the inferred TypeScript type.
Schema requirements:
- summary: non-empty string
- affectedAreas: non-empty array of unique enum values, restricted to: frontend, backend, database, infra
- risks: array of strings
- implementationSteps: non-empty array of strings
- testIdeas: non-empty array of strings
- requiresApproval: boolean
Do not parse model text with regex. Do not accept “almost matching” output. The UI and server must rely on schema-validated structured output.
Mais revenons quelques pas en arrière. Normalement, je ne construis pas quelque chose juste pour le remplir avec de l’IA. Ce que je veux, c’est que mes données soient préparées et intégrées intelligemment dans l’UI. Il existe déjà d’innombrables articles sur Internet à ce sujet, et l’IA m’aide déjà parfaitement sur ce point.
Le point central, en revanche : d’abord le Contract, ensuite le prompt. Je dois savoir quelles données je dois extraire de façon structurée avant de passer à l’écriture et au peaufinage de mon prompt. C’est du travail d’ingénierie classique, qu’on aurait déjà dû connaître avant l’ère de l’IA :
- Quels champs est-ce que je veux extraire des données non structurées ?
- Quels champs sont obligatoires ? Lesquels sont optionnels ?
- Quelles plages de valeurs s’appliquent aux nombres et aux strings ? Y a-t-il des enums ?
- À quels endroits dois-je limiter l’output pour qu’il reste exploitable dans l’UI ou dans le pipeline ?
Selon le langage de programmation choisi, différents frameworks m’y aident. Si l’on pense à l’un des environnements de développement les plus modernes (TypeScript), on pourrait par exemple envisager ai-sdk. Mais Java est aussi servi avec Spring AI, et d’autres langages ont certainement un outillage similaire. Ces frameworks aident à unifier la communication avec différents fournisseurs de modèles, pour que je n’aie pas à me lier directement aux éditeurs et à leurs API. Dans cet article, je me concentre sur TypeScript et ai-sdk.

Ces frameworks ont le gros avantage d’unifier les API des différents fournisseurs et de garder les fonctions typiques simples et configurables de la même manière - par exemple les structured outputs, exactement ce dont nous avons besoin.

Pour construire ce Contract, il faut le plus souvent un Contract - avant tout un JSON Schema. Les JSON Schemas décrivent le Contract des JSON : quels champs sont obligatoires ? Quelle regex ces valeurs doivent-elles respecter ? Plages de nombres, etc. - pour créer ou valider ce JSON Schema, nous pouvons utiliser des outils comme https://json.ophir.dev/. Ou demander à l’IA de nous créer un JSON Schema adapté à nos besoins.
La partie la plus importante de ma feature d’IA n’est pas le prompt, mais le contrat que le reste de l’application attend de la réponse du modèle.
Avec le Contract généré ou rédigé en poche, nous pouvons nous lancer dans la formulation d’un prompt adapté. La réponse correspondra sûrement soit au Contract - soit à un Contract d’erreur qu’il faut traiter séparément, par exemple refusal chez OpenAI.

Des Evals plutôt que du feeling
Construire une feature d’IA sans Evals, c’est tester sur ses utilisateurs.
Comme décrit plus haut, Claude m’a construit du premier coup une webapp fonctionnelle ; si je saisis par exemple l’issue https://github.com/rubenvitt/bluelight-hub/issues/420, j’obtiens un output structuré :
{
  "summary": "Implement a Verpflegungsmanagement feature under the Betreuung area to manage feeding locations, meal planning, and distribution tracking for Einsatzkräfte and Betroffene. The change includes frontend views on the specified route and backend CRUD plus integrations for planning quantities and recording consumption.",
  "affectedAreas": [
    "frontend",
    "backend"
  ],
  "risks": [
    "Integration dependencies on Kräfte-, Betroffene-, Logistik-Modul, and Lagekarte may block parts of the feature or require fallback handling.",
    "Quantity estimation can become inconsistent if personnel and affected-person counts are unavailable, delayed, or separated differently than expected.",
    "Tracking meal status and portion counts across multiple Ausgabestellen introduces risk of incorrect state transitions or double counting.",
    "Capturing Sonderbedürfnisse must stay usable in the UI while still being detailed enough for planning."
  ],
  "implementationSteps": [
    "Add backend CRUD support for Verpflegungsstellen with fields for name, location, type, capacity, opening/output times, and responsible personnel.",
    "Add backend CRUD support for Mahlzeiten including time, type, estimated quantity, assigned Ausgabe-/Verpflegungsstelle, separated counts for Einsatzkräfte and Betroffene, Sonderbedürfnisse, and status values Geplant, In Zubereitung, Ausgabe, Abgeschlossen.",
    "Implement backend logic for quantity estimation based on the provided formula using counts from Kräfte and Betroffene where available.",
    "Add backend endpoints or service integration for recording consumption data per Mahlzeit and Ausgabe-/Verpflegungsstelle: issued portions, beverage consumption, remaining quantities, and material consumption for Logistik handoff.",
    "Build the frontend page at /app/einsatz/$einsatzId/betreuung/verpflegung with management views for Verpflegungsstellen and Mahlzeiten.",
    "Implement Verpflegungsstellen cards showing key details and current status, with create/edit/delete flows.",
    "Implement a Mahlzeiten timeline that separates planned, current, and past meals and supports status updates through the defined lifecycle.",
    "Add meal planning UI for time, type, quantity estimate, separated person counts, special needs, and assigned distribution point.",
    "Implement quick-entry controls for portion output using +/- counters and forms for beverage usage and remaining quantities.",
    "Add a dashboard view showing supply coverage as x% versorgt based on planned vs. served data.",
    "Integrate map marking of Verpflegungsstellen on the Lagekarte from the route workflow.",
    "Connect quantity planning to personnel counts from Kräfte and affected-person counts from Betroffene, and send recorded material consumption to Logistik for replenishment workflows."
  ],
  "testIdeas": [
    "Create, update, list, and delete Verpflegungsstellen with all required fields and verify they appear correctly in the management UI.",
    "Plan a Mahlzeit with separated counts for Einsatzkräfte and Betroffene and verify the estimated quantity follows the specified calculation.",
    "Verify meal status transitions from Geplant to In Zubereitung to Ausgabe to Abgeschlossen are reflected correctly in the timeline and detail views.",
    "Record portion output for a meal at a specific Verpflegungsstelle with +/- quick entry and confirm totals persist correctly.",
    "Record beverage consumption, remaining quantities, and material consumption and verify the data is stored and associated with the correct meal and location.",
    "Enter Sonderbedürfnisse such as allergies, vegetarian, halal, and confirm they are retained and visible in planning views.",
    "Verify Verpflegungsstellen are shown on the Lagekarte with the configured location.",
    "Test integration behavior when Kräfte or Betroffene counts are available versus unavailable, ensuring quantity estimation degrades predictably.",
    "Verify the dashboard coverage percentage updates as portions are issued.",
    "Confirm material consumption data is handed off correctly to the Logistik integration path."
  ],
  "requiresApproval": false
}
40 lignes de résultat. LGTM. Done.
Ou… pas ?
La question n’est pas de savoir si la réponse a l’air « intelligente », mais si elle est assez fiable pour mon workflow.
Comment savoir si ce résultat est un bon résultat ? Comment savoir si je peux m’y fier ? Le Contract me donne une garantie structurelle. Mais ça ne dit pas encore si le contenu tient la route sur le fond. Ce sont donc surtout les questions métier qu’il faut clarifier : les zones concernées sont-elles bien identifiées ? Les risques sont-ils exploitables ? Est-ce que je peux vraiment utiliser les idées de tests - ou est-ce du blabla inutile ? Le flag d’approbation est-il plausible ? Une option pour répondre entièrement à ces questions, c’est de passer en revue chaque réponse une par une - et d’y répondre moi-même, de les évaluer. Ensuite, je peux ajuster le prompt et réévaluer. Mais mon avis honnête là-dessus ? Je n’en ai pas envie, non ! Mais alors pas du tout.
Et oui, il existe une alternative. Plusieurs, même. OpenAI a son propre optimizer, mais il existe aussi de nombreux outils open source. Un exemple serait https://github.com/promptfoo/promptfoo.
Pour faire simple, j’ai choisi ici la plateforme OpenAI. Une évaluation s’y fait vite : créer un prompt (important : avec une variable !), créer un nouveau dataset dans l’onglet Evaluation, puis y ajouter des données de test. Je prends simplement quelques-unes de mes issues du projet bluelight-hub - puis je clique sur play, et le prompt est exécuté sur la liste d’inputs (attention : ça coûte de l’argent).
OpenAI nous aide déjà beaucoup ici : presque tout peut y être retravaillé automatiquement, et même notre JSON Schema peut être généré. J’y ai simplement collé le schéma zod du projet d’exemple - et le JSON Schema correspondant a été généré…. parfait.
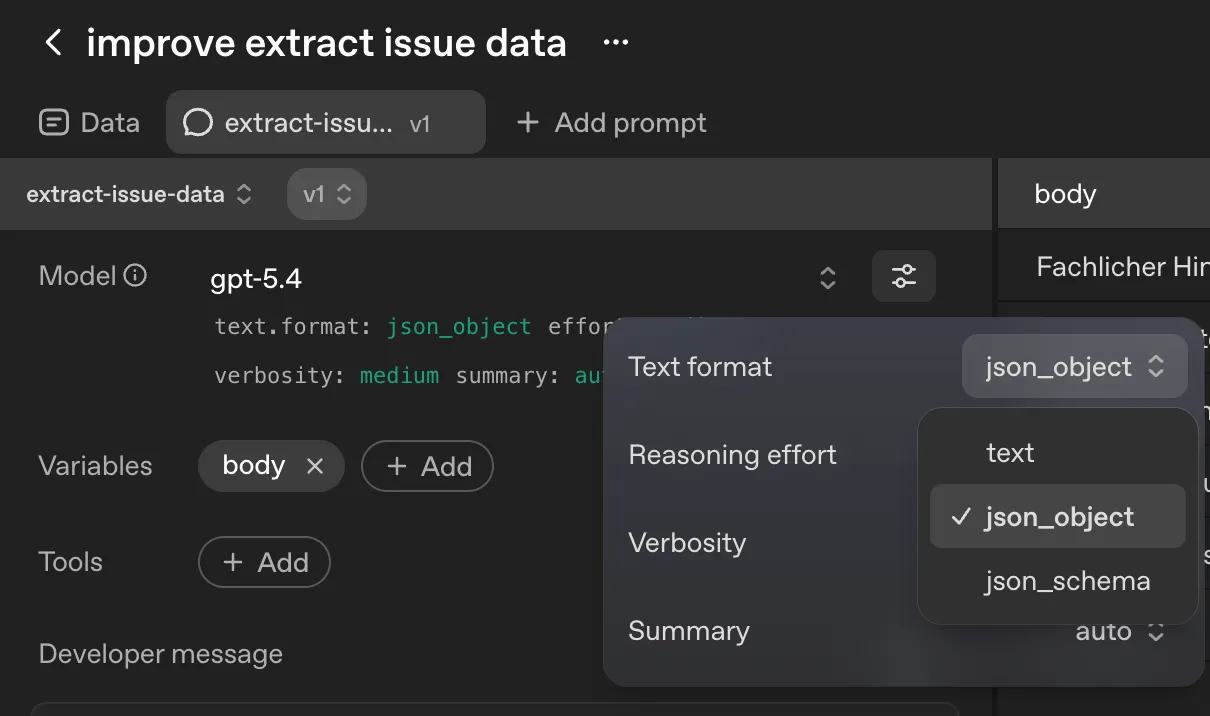
L’avantage ? Nous avons maintenant plusieurs colonnes dans notre vue d’Eval et pouvons lire directement chacune des valeurs produites, puis décider comment nous voulons les traiter.
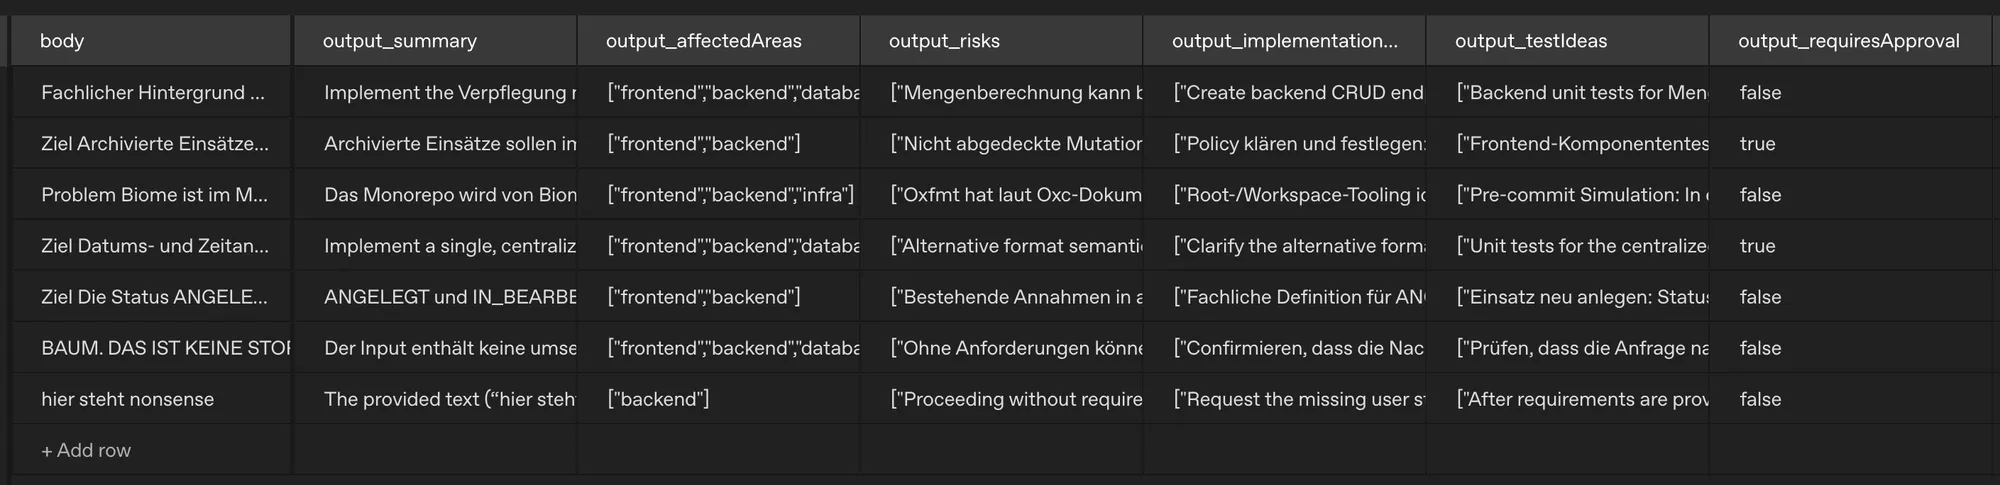
Nous pouvons maintenant commencer l’évaluation proprement dite : créer de nouvelles colonnes soit pour une revue manuelle (annotation) - soit laisser l’IA examiner, vérifier et noter chaque réponse (grader), selon nos critères.
Après une première évaluation sur deux critères, c’est clair : notre prompt a besoin d’être retravaillé. Que faire ? Dans cet outil, un clic sur Optimize suffit - et OpenAI s’occupe du reste, sur la base de la notation issue de l’évaluation du prompt.
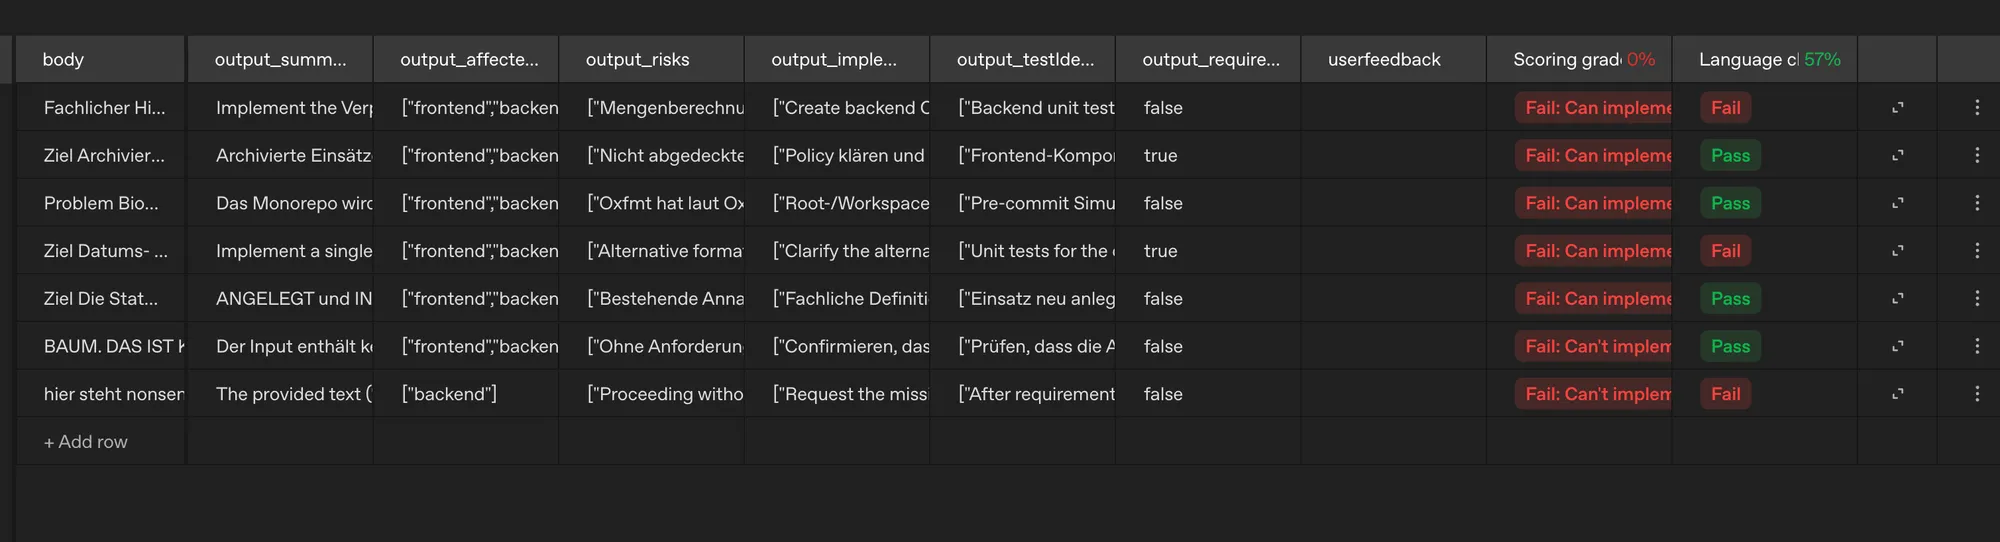
Après un peu plus d’optimisation et un ajustement manuel (par prompt), le résultat s’est un peu amélioré. Bien sûr, c’est un très petit jeu d’évaluation - ce qui m’intéresse ici, c’est plutôt le principe ; j’ai aussi laissé de côté le feedback manuel, même s’il fait normalement partie du processus pour obtenir au final des résultats pertinents.
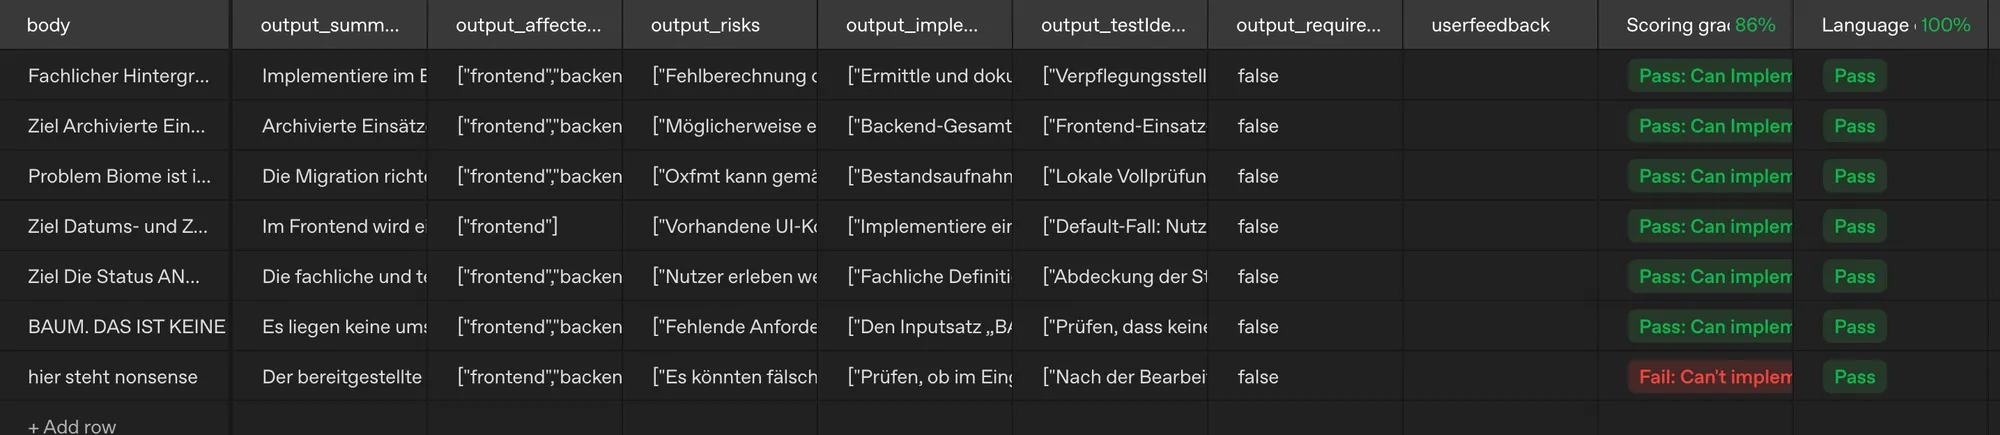
Avec ce super résultat, je file directement voir Claude pour lui demander de remplacer le prompt par celui qu’on vient de créer.
Nous avons donc maintenant un prompt amélioré, qui couvre mieux nos exigences. Avec le structured output, nous construisons de l’UI au lieu d’un simple output textuel. Voilà pour ce mini-aperçu. Il reste encore tellement à découvrir, à optimiser et à affiner.
Le principe de base de l’Eval devrait en tout cas être clair : définir des objectifs, constituer un dataset d’exemples, éventuellement avec les résultats attendus, fixer des métriques, comparer les runs, faire évaluer.
De l’Observability plutôt qu’une boîte noire
Quand nous intégrons des systèmes non déterministes dans nos applications, il est d’autant plus important de comprendre ce qui s’est passé quand quelque chose casse, pour trouver un moyen d’atténuer exactement ça. Cela passe par quelques points de données importants que nous voulons idéalement collecter :
- quel modèle a été utilisé ?
- combien de temps le LLM a-t-il mis pour répondre ?
- le JSON renvoyé était-il valide par rapport au Contract ?
- des retries ont-ils été nécessaires ?
- le cas échéant : quels tools ont été utilisés ?
- où des humains ont-ils dû intervenir ?
- combien de tokens ont été utilisés, et quels en étaient les coûts ?
OpenTelemetry définit désormais des conventions pour les applications GenAI : events, métriques et spans. Ça veut dire que les fonctions d’IA peuvent elles aussi être intégrées à l’Observability. Dans l’AI SDK mentionné plus haut, il existe aussi un connecteur pour collecter et envoyer automatiquement les données correspondantes via le framework.

La partie FullStack, c’est l’UI, pas seulement le modèle
Le sujet ne devient FullStack que lorsque je ne me contente pas d’appeler un modèle, mais que je conçois un parcours d’utilisation pour des humains.
Maintenant que nous avons convenu d’un Contract raisonnable avec le LLM, que nous le communiquons via l’API et que nous avons construit un prompt vraiment génial, que manque-t-il ? L’UI, évidemment. Au début de l’article, je l’ai déjà laissé entendre : afficher un peu de texte, tout le monde sait le faire. Même après la tentative one-shot avec Claude, ce n’était certes pas une interface de chat, mais ça restait une simple suite de textes. Nous évoluons ici sur un terrain un peu aride - un plan de mise en œuvre pour des stories - mais pour l’affichage, on doit bien pouvoir faire quelque chose de chouette, non ?
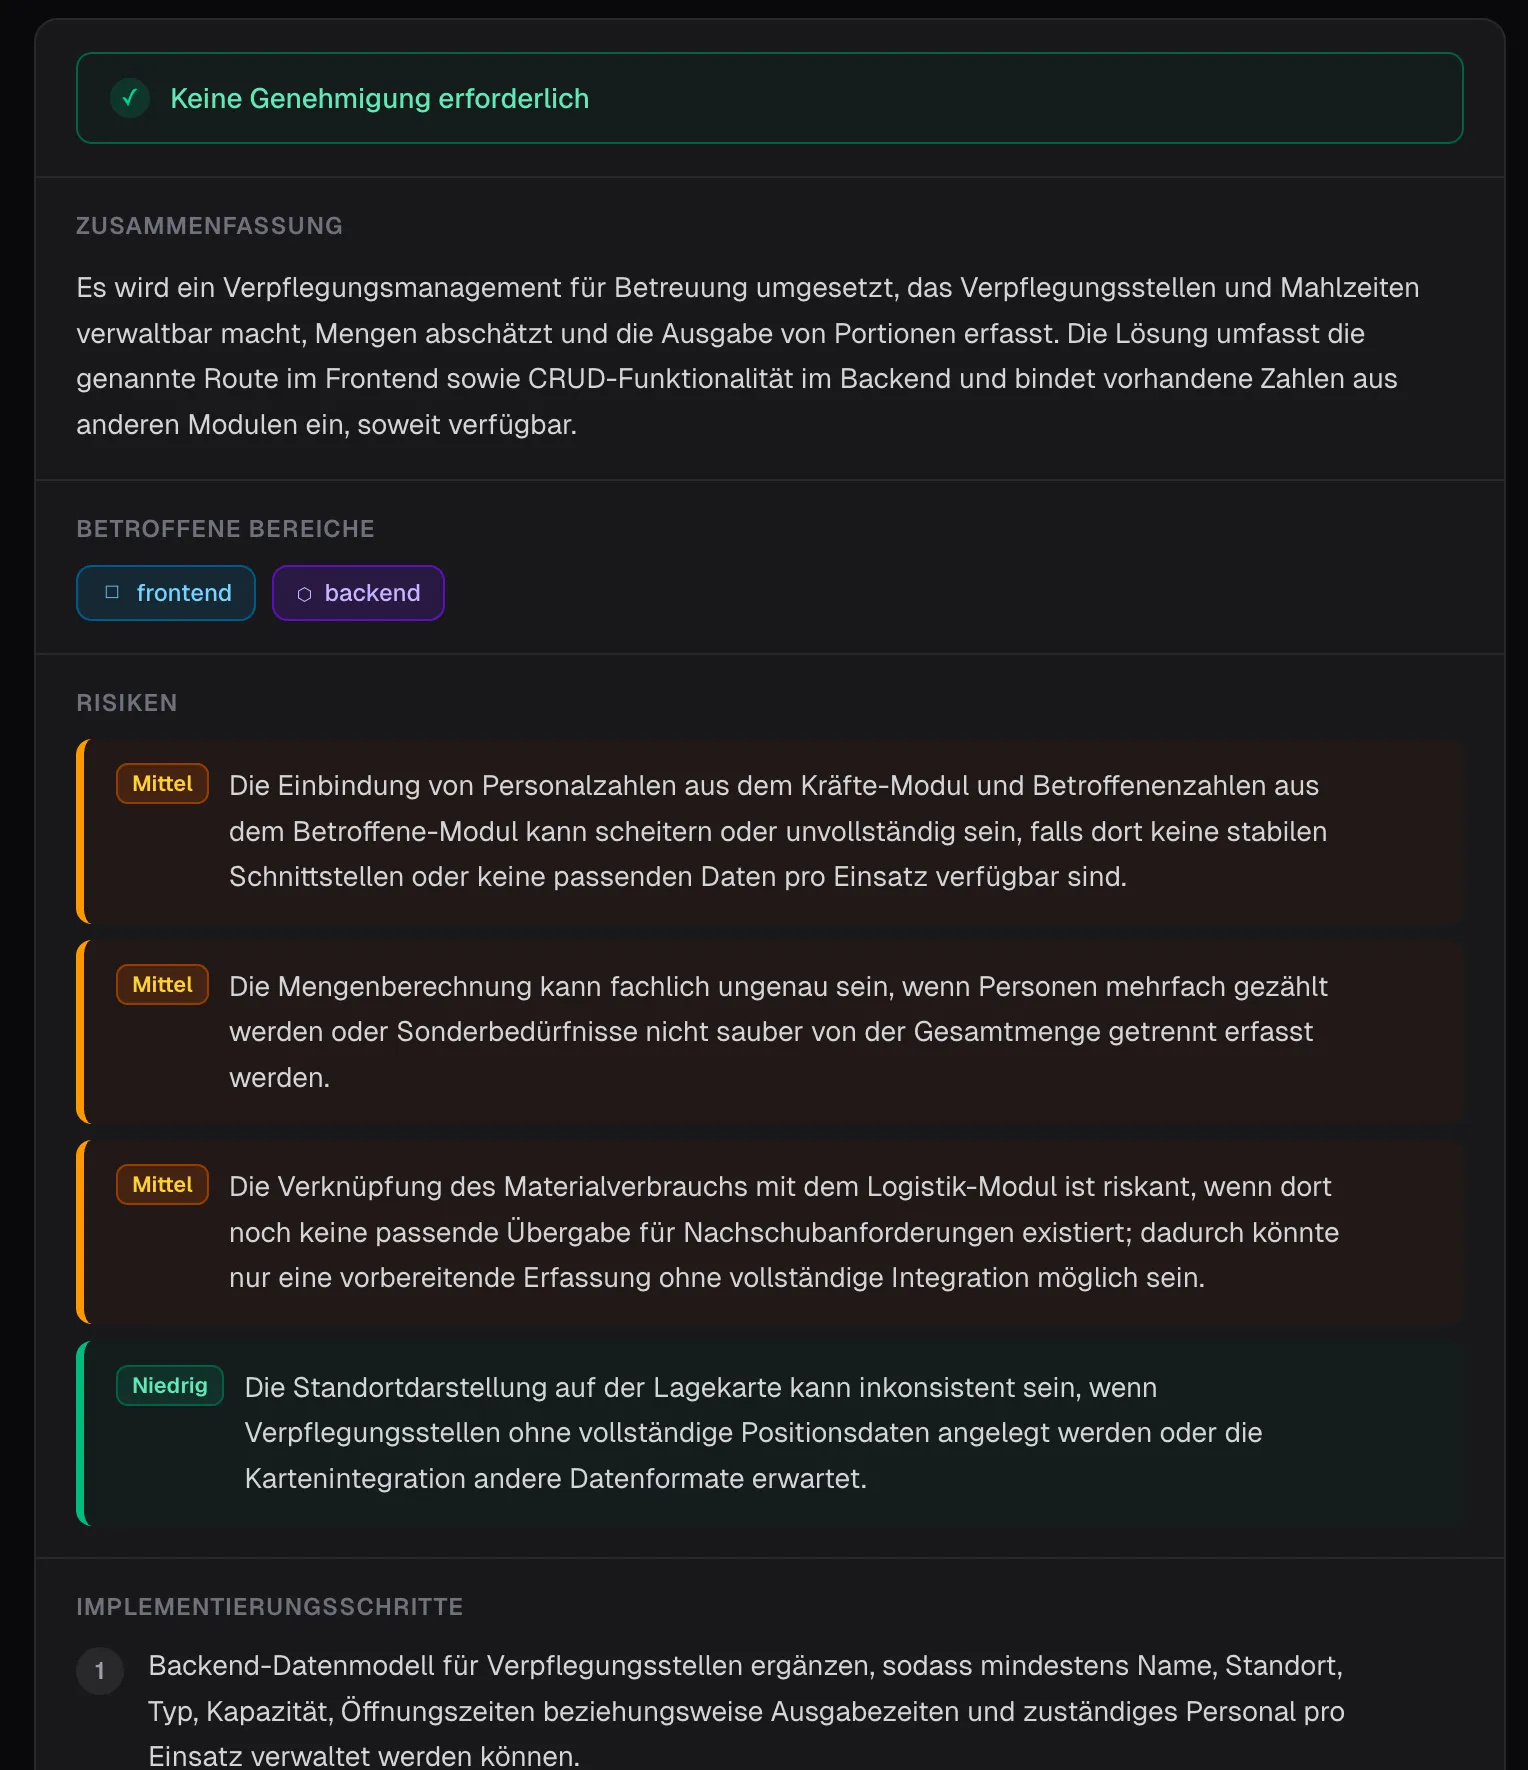
Dans un premier temps, je voulais simplement que les données soient présentées un peu plus joliment. Jusque-là, tout va bien ; et pourquoi pas un canvas de mise en œuvre ?
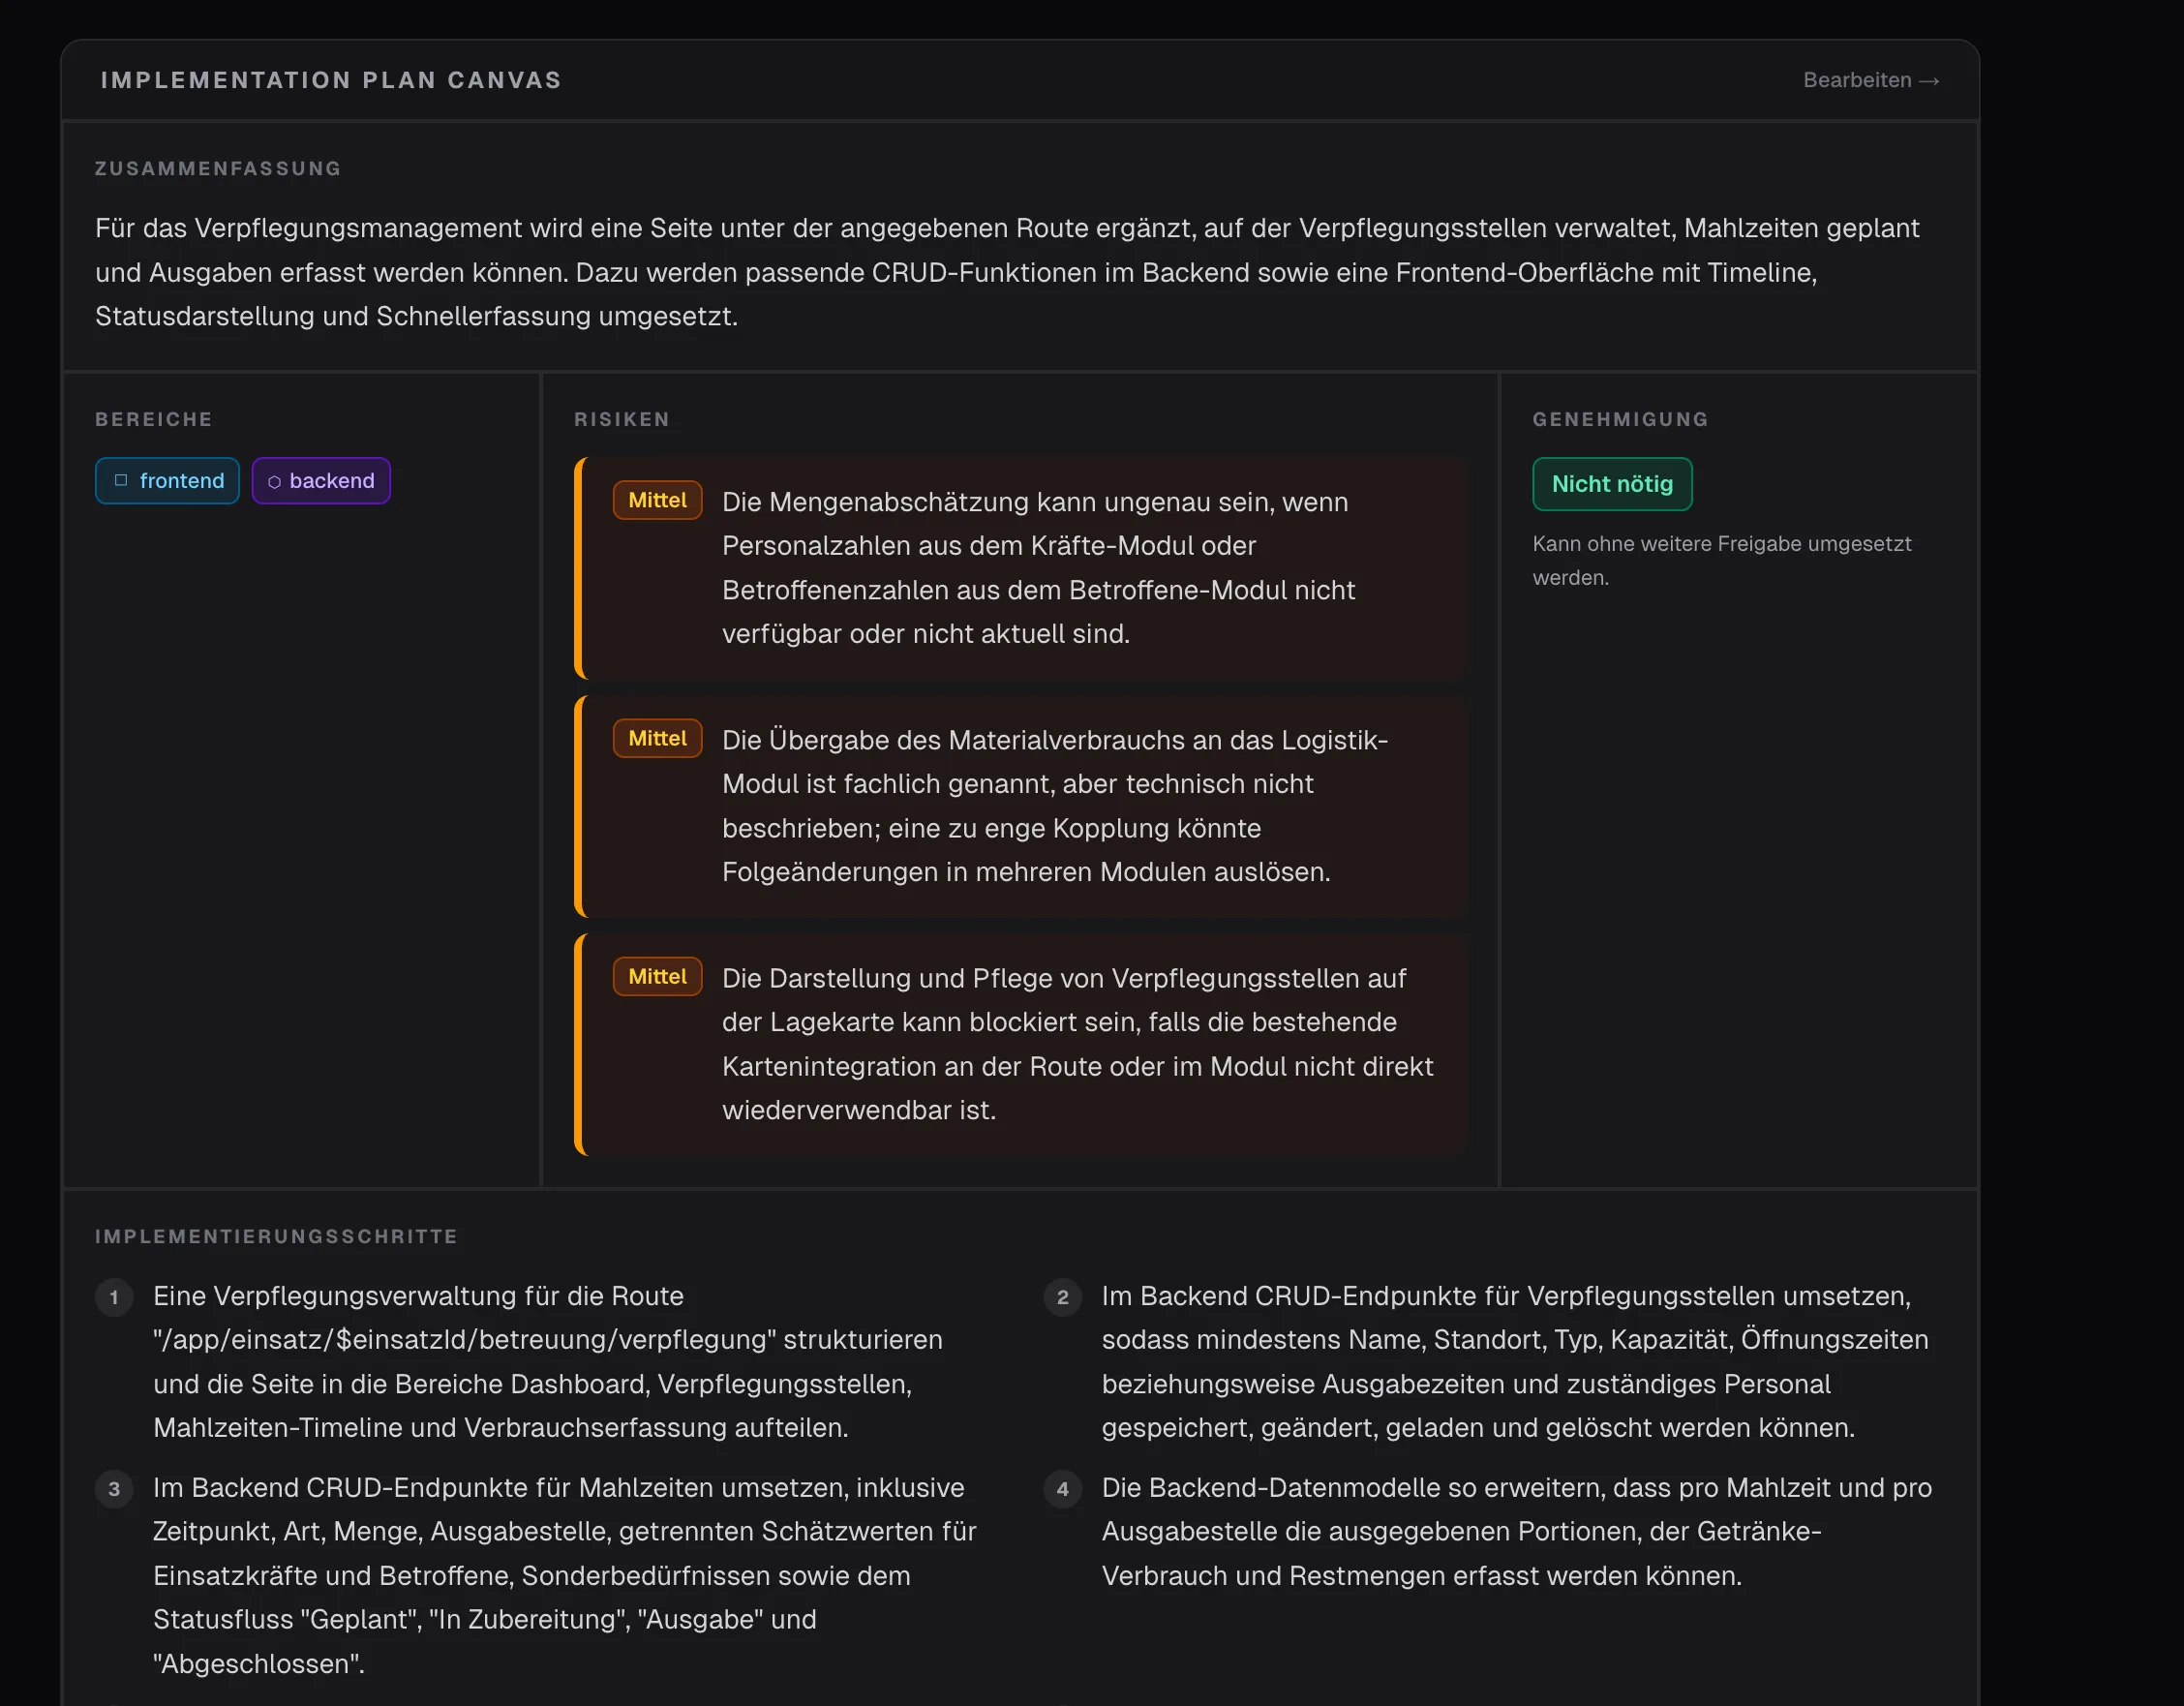
Un autre type d’affichage - avec la possibilité de modifier les contenus - mais comment créer une vraie valeur ajoutée ? Si la tâche comprend du travail frontend… ne devrions-nous pas générer directement une maquette ? Aussitôt dit, aussitôt fait…
Ohh, I love Agentic Engineering.
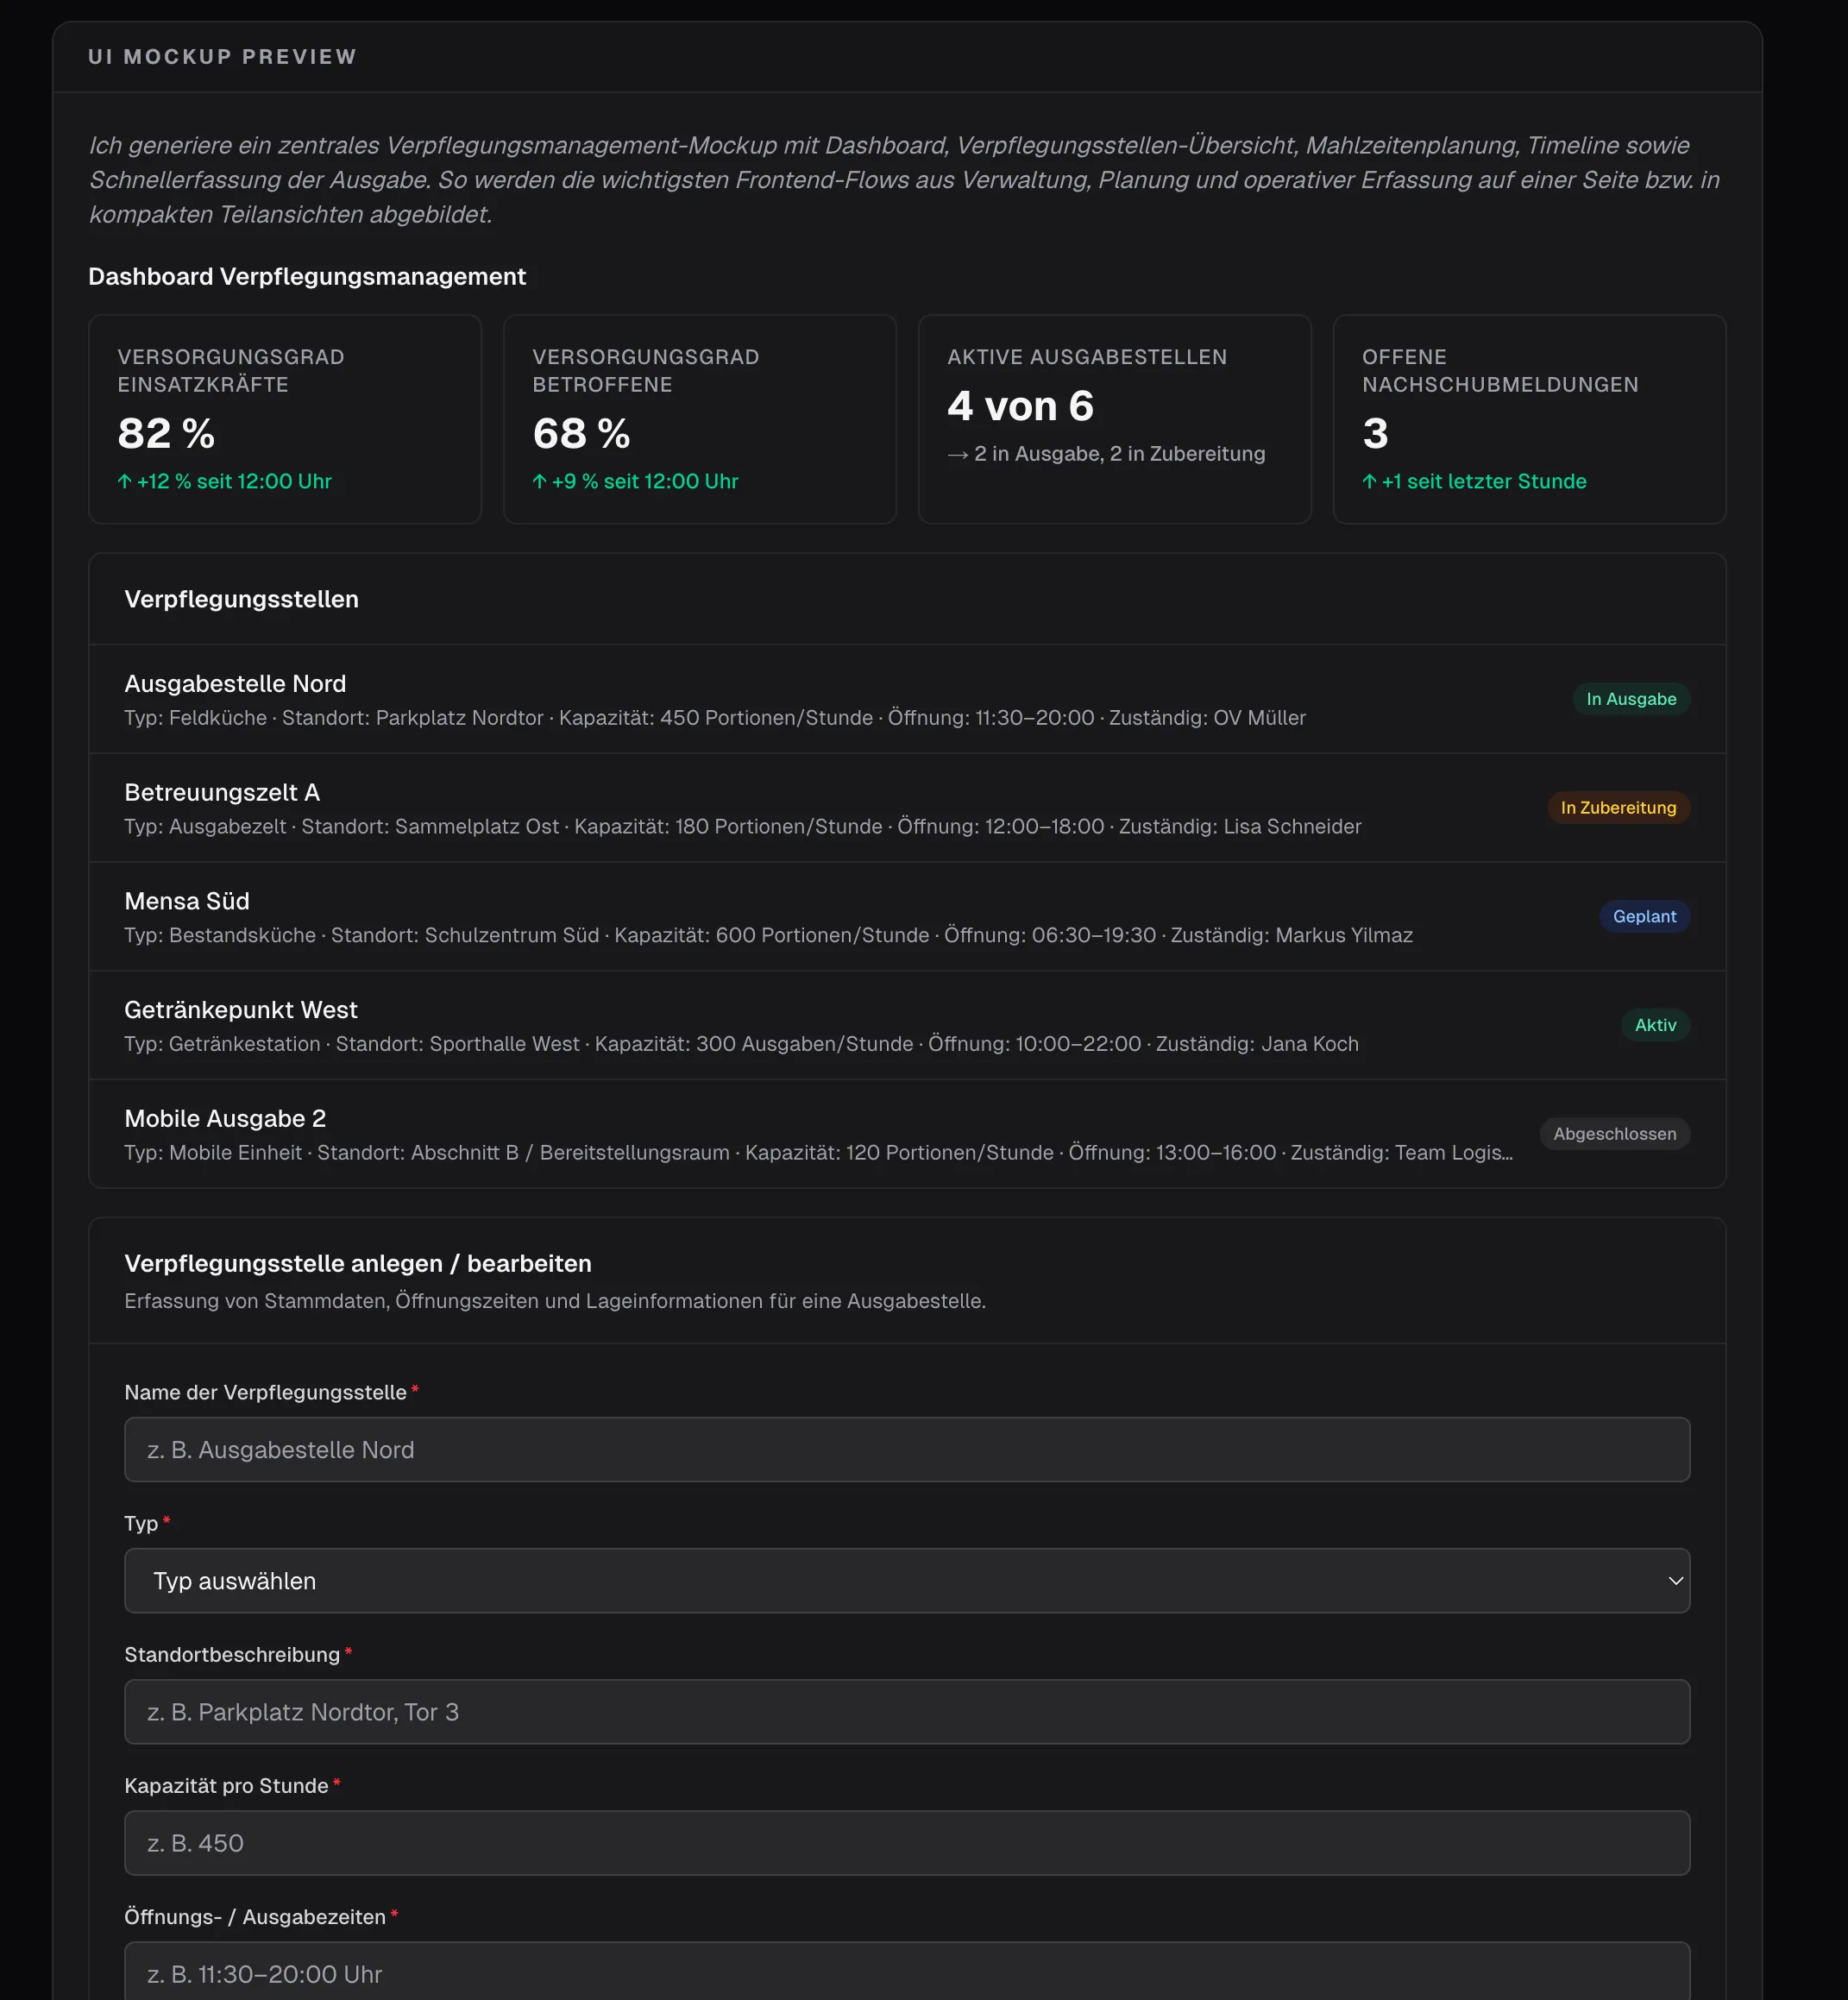
Le prompt engineering reste utile. Mais dès que l’output du modèle porte une vraie logique produit, j’ai surtout besoin de trois choses : des Contracts, des Evals et de la télémétrie. C’est exactement là que commence pour moi l’AI Systems Engineering. Et avec la découverte de nouveaux patterns d’interaction.
