
De flesta AI-demos faller inte på modellen. De faller på att de producerar fritext - fast applikationen egentligen behöver kontrakt. Så fort en modell inte längre bara svarar trevligt i ett chattfönster utan triggar produktlogik räcker det inte med bra prompts.
AI FullStack Engineering börjar där modellens output blir en del av systemet - alltså där jag behöver Contract, utvärdering och Observability.
Repo: https://github.com/rubenvitt/plan-from-issue
Färdig webbapp: https://plan-from-issue.pages.dev/
Förberedelserna: vårt exempel
För att göra det hela lite mer konkret vill jag börja med ett exempel: en liten webbapp som gör om en GitHub-issue eller valfri ärendetext (t.ex. från Jira, GitLab) till en strukturerad implementationsplan. Till det använder jag först en målstruktur, som jag sedan förklarar en AI-FullStack-feature utifrån.
{
  "summary": "string",
  "affectedAreas": ["frontend", "backend", "database", "infra"],
  "risks": ["string"],
  "implementationSteps": ["string"],
  "testIdeas": ["string"],
  "requiresApproval": true
}
Utifrån det här exemplet är det enkelt att få en webbapp byggd som med hjälp av målbilden presenterar olika implementationsplaner på ett vettigt sätt - det har Claude Code gjort åt mig i det här fallet.
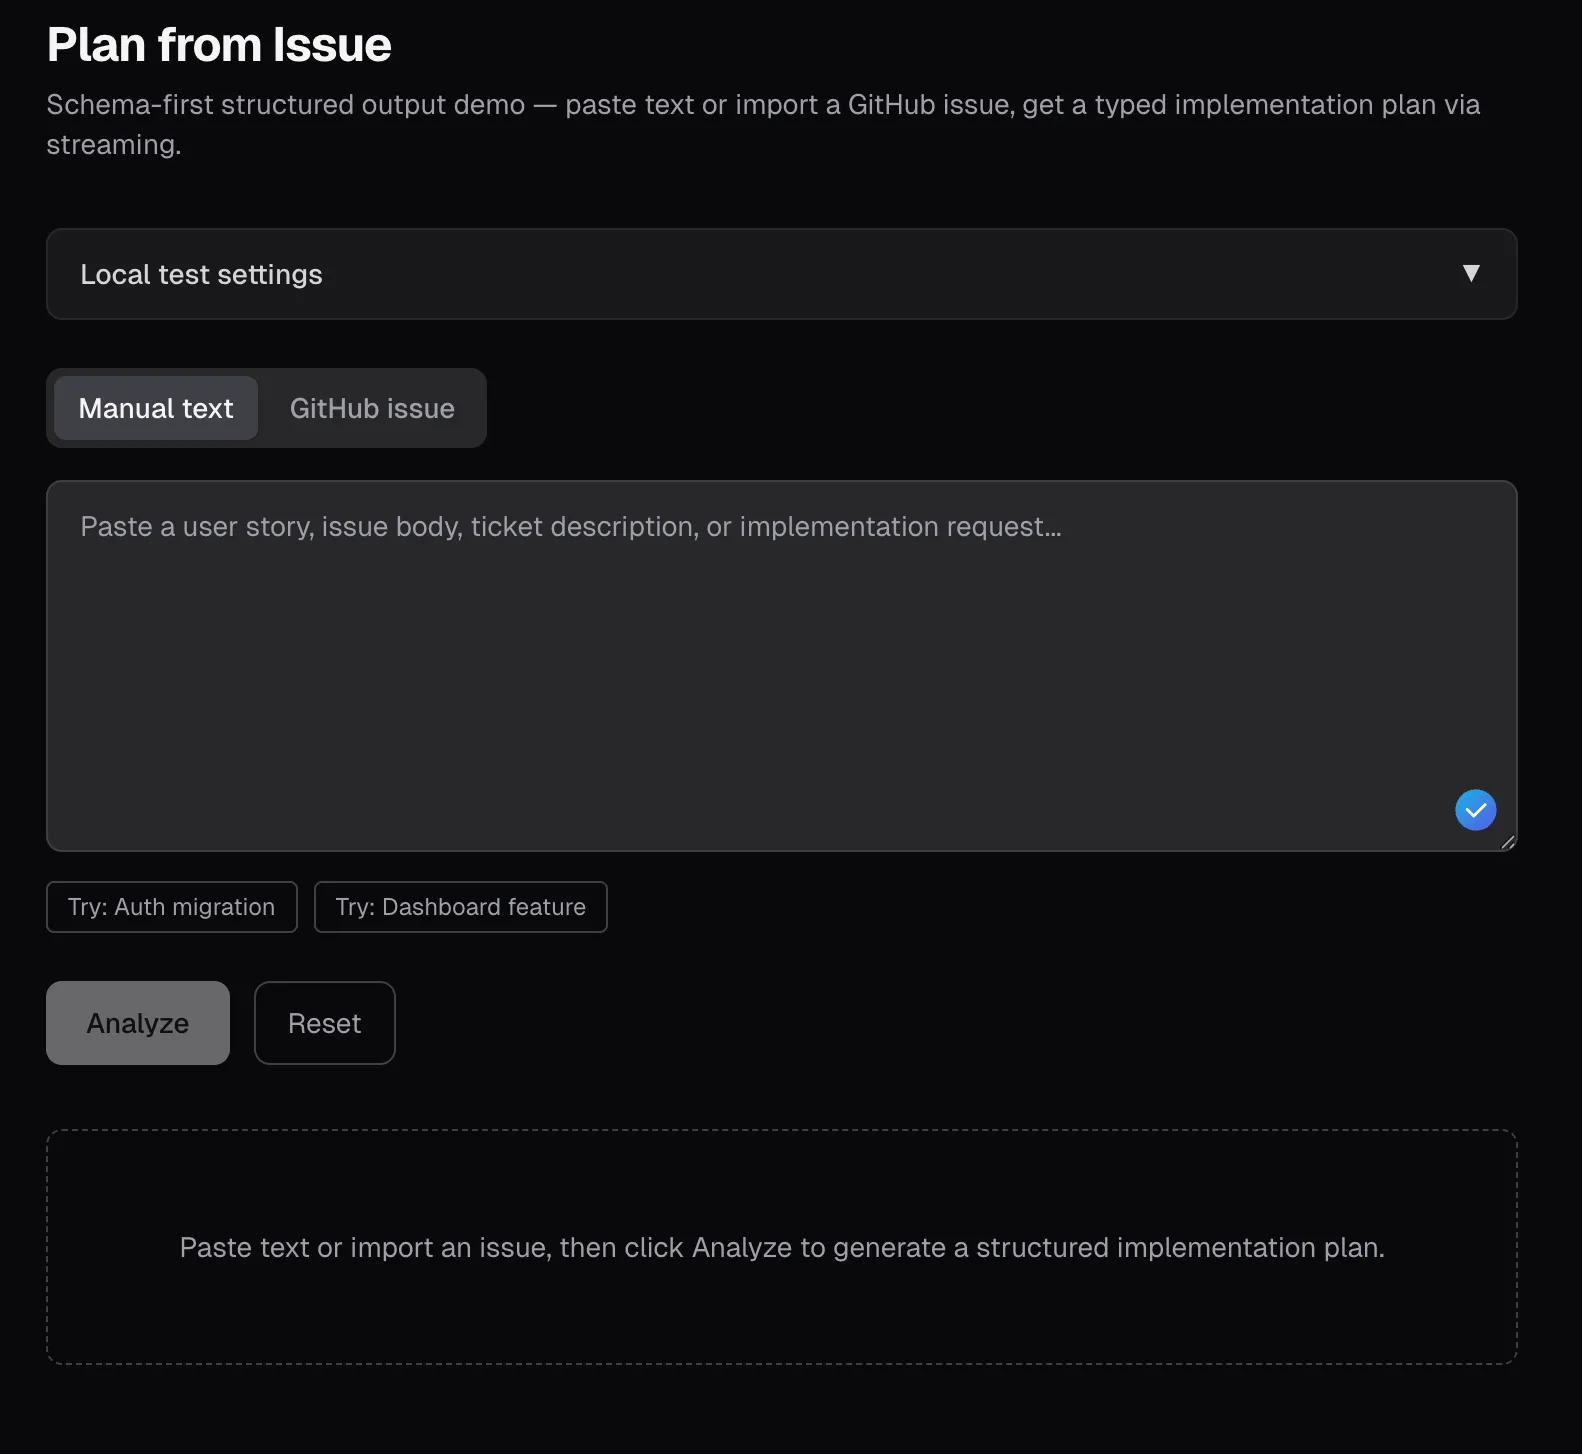
I webbappen kan användaren klistra in en issue i textrutan eller hämta den från GitHub - och se den presenterad i strukturerad form. Visst, det är ett väldigt enkelt och snabbt framtaget use case, men principerna och koncepten som förklaras gäller även för mer genomarbetade UI:n - i det här fallet är de bara lätta att följa.
Contract-first i stället för prompt-first
Med exemplet ovan lät jag Claude bygga allt i ett svep - egentligen är vi redan klara här. Appen fungerar (efter en prompt som ChatGPT skrev).
Genererad prompt för att bygga demon
You are a senior TypeScript engineer. Build a small but polished demo web app that showcases schema-first AI output using the Vercel AI SDK.
Do not ask follow-up questions. Make reasonable choices and implement the full app end-to-end. Do not leave placeholders or stubs. Keep the code compact, readable, and suitable for a public demo repo / blog post.
Goal
Build a mini web app that turns either:
- freeform story / ticket text
- a GitHub issue
into a structured implementation plan.
The point of the app is to demonstrate that the AI feature is contract-first, not chat-first.
Stack
Use:
- Next.js App Router
- TypeScript
- AI SDK
- AI SDK UI
- Zod
- @ai-sdk/openai
- minimal styling only (simple CSS or Tailwind is fine)
- no database
- no authentication system
- no server-side persistence
Non-negotiable AI SDK architecture
Use these exact patterns:
- shared Zod schema imported by both client and server
- streamText + Output.object(…) in the route handler
- experimental_useObject on the client
- createOpenAI(…) to instantiate the provider with a request-specific API key
- custom request headers from the client to the analyze route
- no plain-text fallback mode for the main analysis flow
- do not use useChat for the main experience
This app is object-generation first, not chat first.
Core JSON contract
The app must use this exact top-level JSON shape and these exact property names:
{ "summary": "string", "affectedAreas": ["frontend", "backend", "database", "infra"], "risks": ["string"], "implementationSteps": ["string"], "testIdeas": ["string"], "requiresApproval": true }Implement it as a shared Zod schema and export the inferred TypeScript type.
Schema requirements:
- summary: non-empty string
- affectedAreas: non-empty array of unique enum values, restricted to: frontend, backend, database, infra
- risks: array of strings
- implementationSteps: non-empty array of strings
- testIdeas: non-empty array of strings
- requiresApproval: boolean
Do not parse model text with regex. Do not accept “almost matching” output. The UI and server must rely on schema-validated structured output.
Men låt oss ta några steg tillbaka. Normalt bygger jag inte något bara för att fylla det med AI. I stället ska mina data bearbetas och integreras intelligent i UI:t. Det finns redan otaliga artiklar om det på nätet, och där är AI redan en utmärkt hjälp.
Kärnpunkten är dock: först kommer Contractet, sedan prompten. Jag måste veta vilka data jag ska extrahera strukturerat innan jag går vidare till att skriva och finslipa min prompt. Det kräver engineering-arbete av det slag som vi borde känna igen redan från tiden före AI.
- Vilka fält vill jag extrahera ur de ostrukturerade datan?
- Vilka fält är obligatoriska? Vilka valfria?
- Vilka värdeintervall gäller för tal & strängar? Finns det enums?
- Var bör jag begränsa outputen så att den förblir användbar i UI:t eller i pipelinen?
Här hjälper olika ramverk mig beroende på vilket programmeringsspråk jag väljer. Tänker vi på en av de modernare utvecklingsmiljöerna (TypeScript) kan till exempel ai-sdk komma i fråga. Men även Java täcks in med Spring AI, och andra språk har säkert liknande verktyg. De här ramverken hjälper till att göra kommunikationen med olika model providers enhetlig, så att jag inte behöver binda mig direkt till leverantörer och deras API:er. I den här artikeln fokuserar jag på TypeScript & ai-sdk.

Sådana ramverk har den stora fördelen att de gör de enskilda leverantörernas API:er enhetliga och håller typiska funktioner enkla och likvärdigt konfigurerbara - till exempel structured outputs, precis det vi behöver.

För att konstruera det här Contractet behövs oftast ett Contract - framför allt ett JSON-schema. JSON-scheman beskriver kontraktet för JSON: vilka obligatoriska fält finns? Vilket regex måste värdena följa? Talintervall osv. - för att skapa eller validera JSON-schemat kan vi använda verktyg som https://json.ophir.dev/. Eller be AI:n skapa ett JSON-schema som passar våra behov.
Den viktigaste delen av min AI-feature är inte prompten, utan kontraktet som resten av applikationen förväntar sig av modellens svar.
Med det genererade eller egenhändigt skapade Contractet i bagaget kan vi ge oss i kast med att formulera en passande prompt. Svaret kommer säkert antingen att motsvara Contractet - eller ett fel-Contract som vi måste hantera separat, t.ex. refusal från OpenAI.

Evals i stället för magkänsla
Den som bygger en AI-feature utan evals testar på användarna.
Som beskrivet ovan byggde Claude en fungerande webbapp åt mig på ett enda försök. Om jag som exempel matar in issuen https://github.com/rubenvitt/bluelight-hub/issues/420 får jag strukturerad output:
{
  "summary": "Implement a Verpflegungsmanagement feature under the Betreuung area to manage feeding locations, meal planning, and distribution tracking for Einsatzkräfte and Betroffene. The change includes frontend views on the specified route and backend CRUD plus integrations for planning quantities and recording consumption.",
  "affectedAreas": [
    "frontend",
    "backend"
  ],
  "risks": [
    "Integration dependencies on Kräfte-, Betroffene-, Logistik-Modul, and Lagekarte may block parts of the feature or require fallback handling.",
    "Quantity estimation can become inconsistent if personnel and affected-person counts are unavailable, delayed, or separated differently than expected.",
    "Tracking meal status and portion counts across multiple Ausgabestellen introduces risk of incorrect state transitions or double counting.",
    "Capturing Sonderbedürfnisse must stay usable in the UI while still being detailed enough for planning."
  ],
  "implementationSteps": [
    "Add backend CRUD support for Verpflegungsstellen with fields for name, location, type, capacity, opening/output times, and responsible personnel.",
    "Add backend CRUD support for Mahlzeiten including time, type, estimated quantity, assigned Ausgabe-/Verpflegungsstelle, separated counts for Einsatzkräfte and Betroffene, Sonderbedürfnisse, and status values Geplant, In Zubereitung, Ausgabe, Abgeschlossen.",
    "Implement backend logic for quantity estimation based on the provided formula using counts from Kräfte and Betroffene where available.",
    "Add backend endpoints or service integration for recording consumption data per Mahlzeit and Ausgabe-/Verpflegungsstelle: issued portions, beverage consumption, remaining quantities, and material consumption for Logistik handoff.",
    "Build the frontend page at /app/einsatz/$einsatzId/betreuung/verpflegung with management views for Verpflegungsstellen and Mahlzeiten.",
    "Implement Verpflegungsstellen cards showing key details and current status, with create/edit/delete flows.",
    "Implement a Mahlzeiten timeline that separates planned, current, and past meals and supports status updates through the defined lifecycle.",
    "Add meal planning UI for time, type, quantity estimate, separated person counts, special needs, and assigned distribution point.",
    "Implement quick-entry controls for portion output using +/- counters and forms for beverage usage and remaining quantities.",
    "Add a dashboard view showing supply coverage as x% versorgt based on planned vs. served data.",
    "Integrate map marking of Verpflegungsstellen on the Lagekarte from the route workflow.",
    "Connect quantity planning to personnel counts from Kräfte and affected-person counts from Betroffene, and send recorded material consumption to Logistik for replenishment workflows."
  ],
  "testIdeas": [
    "Create, update, list, and delete Verpflegungsstellen with all required fields and verify they appear correctly in the management UI.",
    "Plan a Mahlzeit with separated counts for Einsatzkräfte and Betroffene and verify the estimated quantity follows the specified calculation.",
    "Verify meal status transitions from Geplant to In Zubereitung to Ausgabe to Abgeschlossen are reflected correctly in the timeline and detail views.",
    "Record portion output for a meal at a specific Verpflegungsstelle with +/- quick entry and confirm totals persist correctly.",
    "Record beverage consumption, remaining quantities, and material consumption and verify the data is stored and associated with the correct meal and location.",
    "Enter Sonderbedürfnisse such as allergies, vegetarian, halal, and confirm they are retained and visible in planning views.",
    "Verify Verpflegungsstellen are shown on the Lagekarte with the configured location.",
    "Test integration behavior when Kräfte or Betroffene counts are available versus unavailable, ensuring quantity estimation degrades predictably.",
    "Verify the dashboard coverage percentage updates as portions are issued.",
    "Confirm material consumption data is handed off correctly to the Logistik integration path."
  ],
  "requiresApproval": false
}
40 rader resultat. LGTM. Done.
Eller… inte?
Frågan är inte om svaret låter ”smart”, utan om det är tillräckligt pålitligt för mitt arbetsflöde.
Hur vet jag att resultatet är ett bra resultat? Hur vet jag att jag kan lita på det? Contractet ger mig en strukturell garanti. Om innehållet håller i sak är därmed fortfarande obesvarat. Därför måste framför allt de sakliga frågorna redas ut: har de berörda områdena identifierats på ett rimligt sätt? Är riskerna användbara? Kan jag verkligen använda testidéerna - eller är det onödigt nonsens? Är approval-flaggan rimlig? Ett sätt att besvara de här frågorna fullt ut är att gå igenom varje enskilt svar - och besvara och bedöma frågorna själv. Sedan kan jag justera prompten och bedöma igen. Men min ärliga åsikt om det? Det vill jag inte, nej! Jag har ingen lust.
Och ja, det finns ett alternativ. Till och med flera. OpenAI har en egen optimizer, men det finns också gott om open source-verktyg. Ett exempel är https://github.com/promptfoo/promptfoo.
För att hålla det enkelt valde jag OpenAI Platform här. Där är en utvärdering snabbt gjord: skapa en prompt (viktigt: med variabel!), lägg upp ett nytt dataset under fliken Evaluation och klistra sedan in testdata. Jag tar helt enkelt några av mina issues från bluelight-hub-projektet - sedan klickar jag på play, och prompten körs mot listan med inputs (obs: det kostar pengar).
Här får vi redan mycket hjälp av OpenAI, nästan allt kan omarbetas automatiskt direkt där, även vårt JSON-schema kan genereras. Jag klistrade helt enkelt in zod-schemat från exempelprojektet - och fick det matchande JSON-schemat genererat…. perfekt.
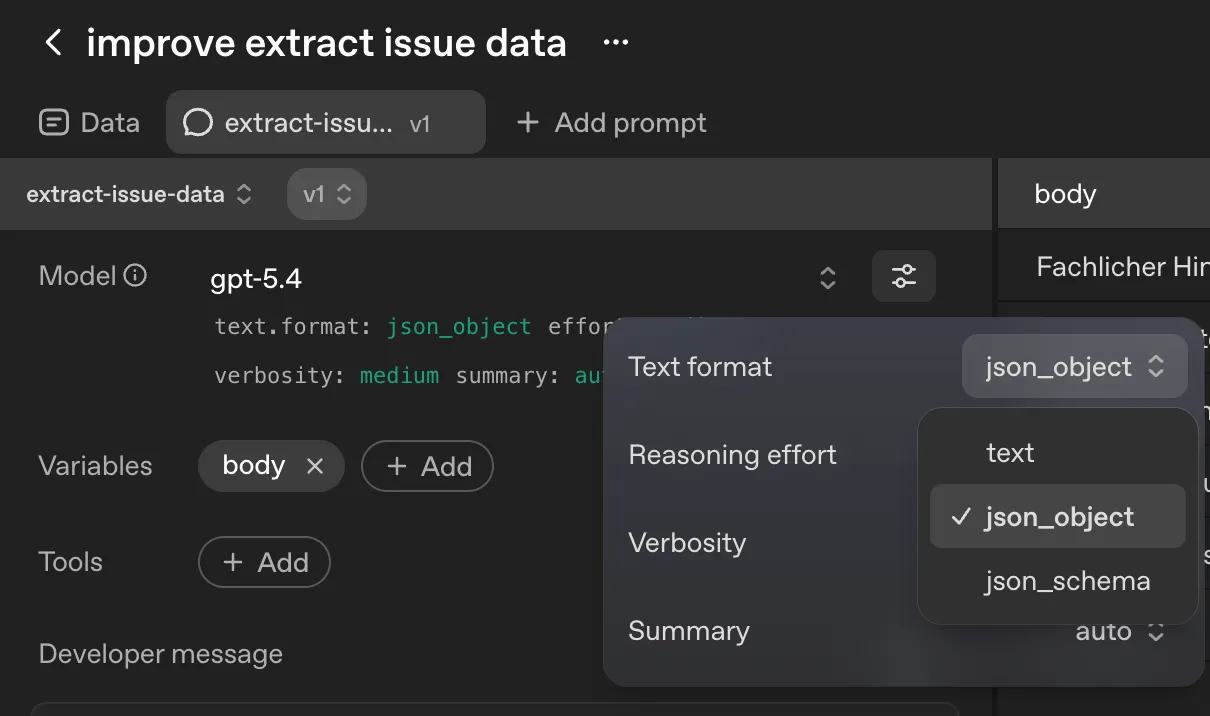
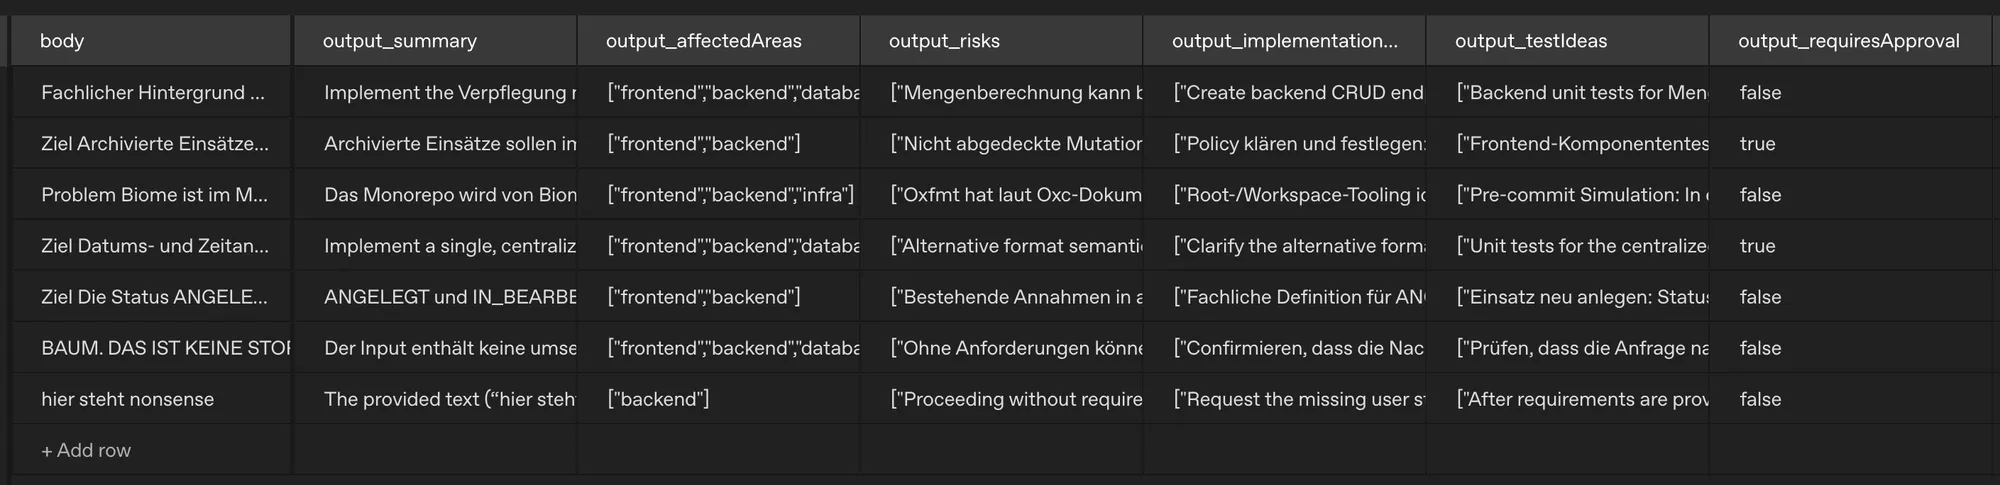
Fördelen med det? Nu har vi flera kolumner i vår eval-vy och kan direkt läsa av de värden som producerats var för sig och avgöra hur vi vill hantera dem.
Nu kan vi börja med själva utvärderingen: lägg till nya kolumner, antingen för manuell granskning (annotation) - eller så låter vi AI:n granska, kontrollera och bedöma de enskilda svaren (grader); enligt våra kriterier.
Efter en första utvärdering mot två kriterier blir det tydligt: vår prompt behöver lite efterarbete. Vad gör vi? I det här verktyget räcker ett klick på Optimize - och OpenAI tar hand om resten - baserat på bedömningen från promptutvärderingen.
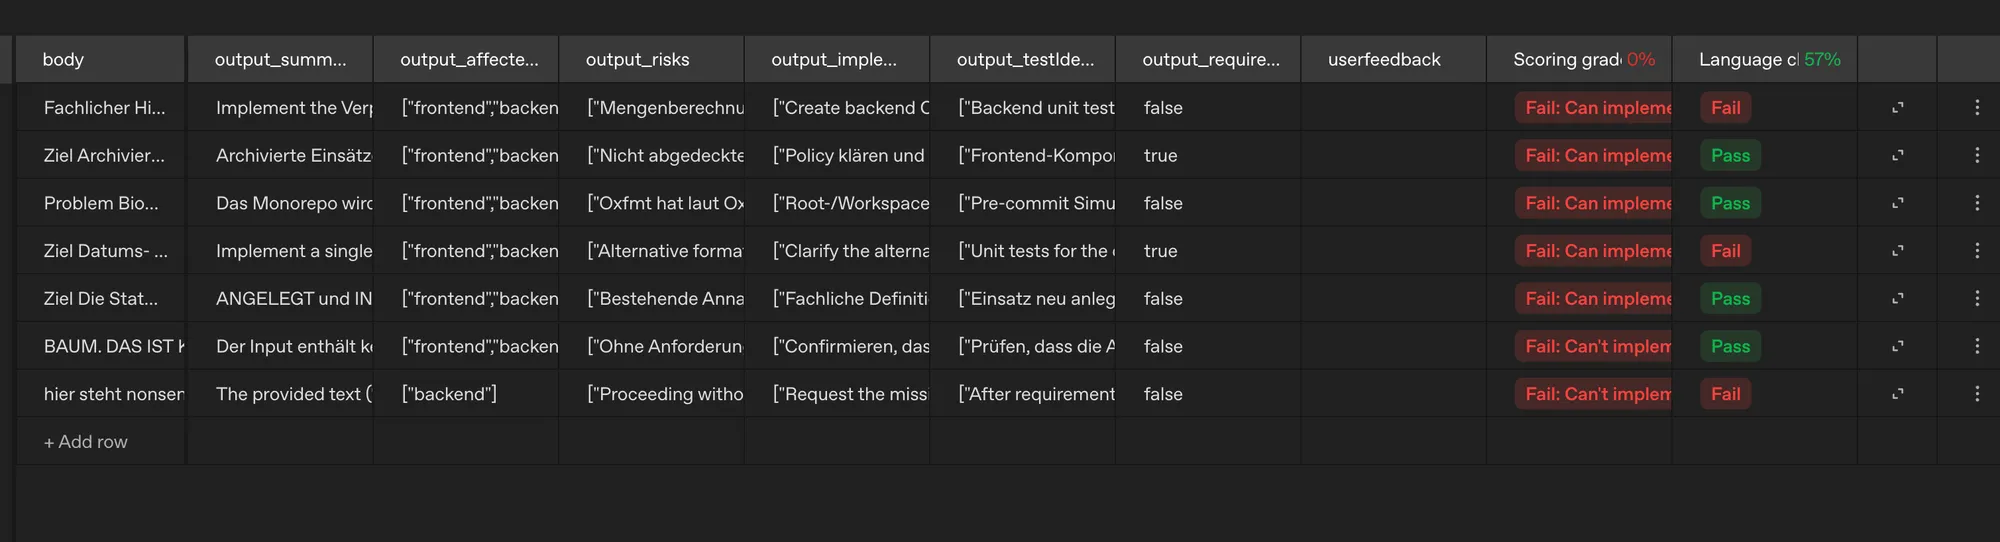
Efter lite mer optimering och en manuell justering (via prompt) blev resultatet lite bättre. Visst, det här är ett riktigt litet set för utvärdering - för mig handlar det här mer om principen; manuell feedback hoppade jag också helt enkelt över, även om den normalt hör till för att i slutändan få meningsfulla resultat.
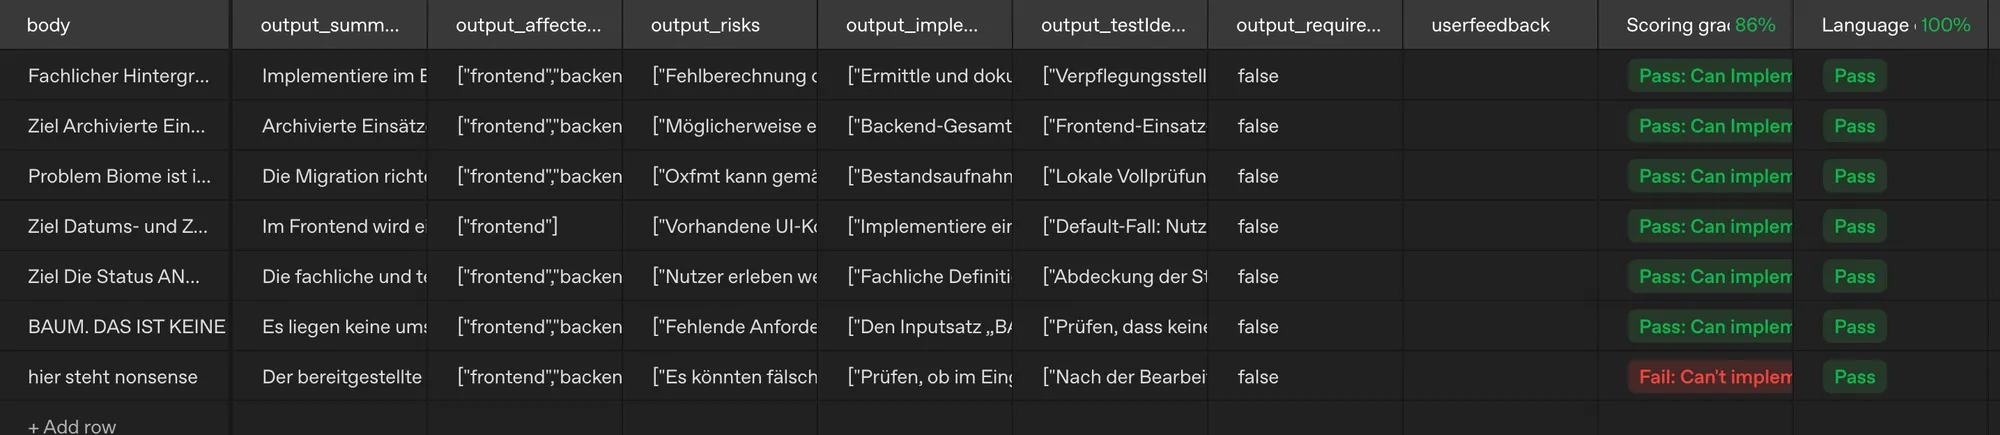
Med det fina resultatet går jag direkt till Claude och ber den byta ut prompten mot den nya.
Därmed har vi nu en förbättrad prompt som täcker våra krav bättre. Med structured output bygger vi UI i stället för ren textoutput. Det var den lilla inblicken. Här finns så mycket mer att upptäcka, optimera och förfina.
Grundprincipen för evals borde ändå ha blivit tydlig: definiera mål, samla ett dataset av exempel, eventuellt med förväntade resultat, bestäm mätvärden, jämför körningar, låt dem utvärderas.
Observability i stället för svart låda
När vi bygger in icke-deterministiska system i våra applikationer blir det ännu viktigare att förstå vad som hände när något går sönder, så att vi kan hitta ett sätt att motverka just det. Till det hör några viktiga datapunkter som vi helst vill samla in:
- vilken modell användes?
- hur lång tid behövde LLM:en för ett svar?
- var den returnerade JSON:en giltig enligt Contractet?
- behövdes retries?
- i förekommande fall: vilka tools användes?
- var behövde människor ingripa?
- hur många tokens användes och hur höga var kostnaderna för dem?
OpenTelemetry har numera konventioner för events, mätvärden & spans i GenAI-applikationer. Det betyder att även AI-funktionerna kan kopplas in i Observability. I det AI SDK som nämndes ovan finns också en konnektor för att automatiskt samla in och skicka motsvarande data via ramverket.

FullStack-delen är UI:t, inte bara modellen
Det blir FullStack först när jag inte bara anropar en modell, utan designar ett användarflöde för människor.
Nu när vi har kommit överens om ett vettigt Contract med LLM:en, kommunicerar det via API:t och har byggt en riktigt bra prompt - vad saknas? Självklart, UI:t. I början av inlägget antydde jag redan: att bara visa lite text, det kan vem som helst. Även efter one-shot-försöket med Claude var det visserligen inget chattgränssnitt, men ändå bara en rad texter efter varandra. Visst rör vi oss nu i lite torr terräng - en implementationsplan för stories - men åtminstone presentationen kan vi väl få till något snyggt?
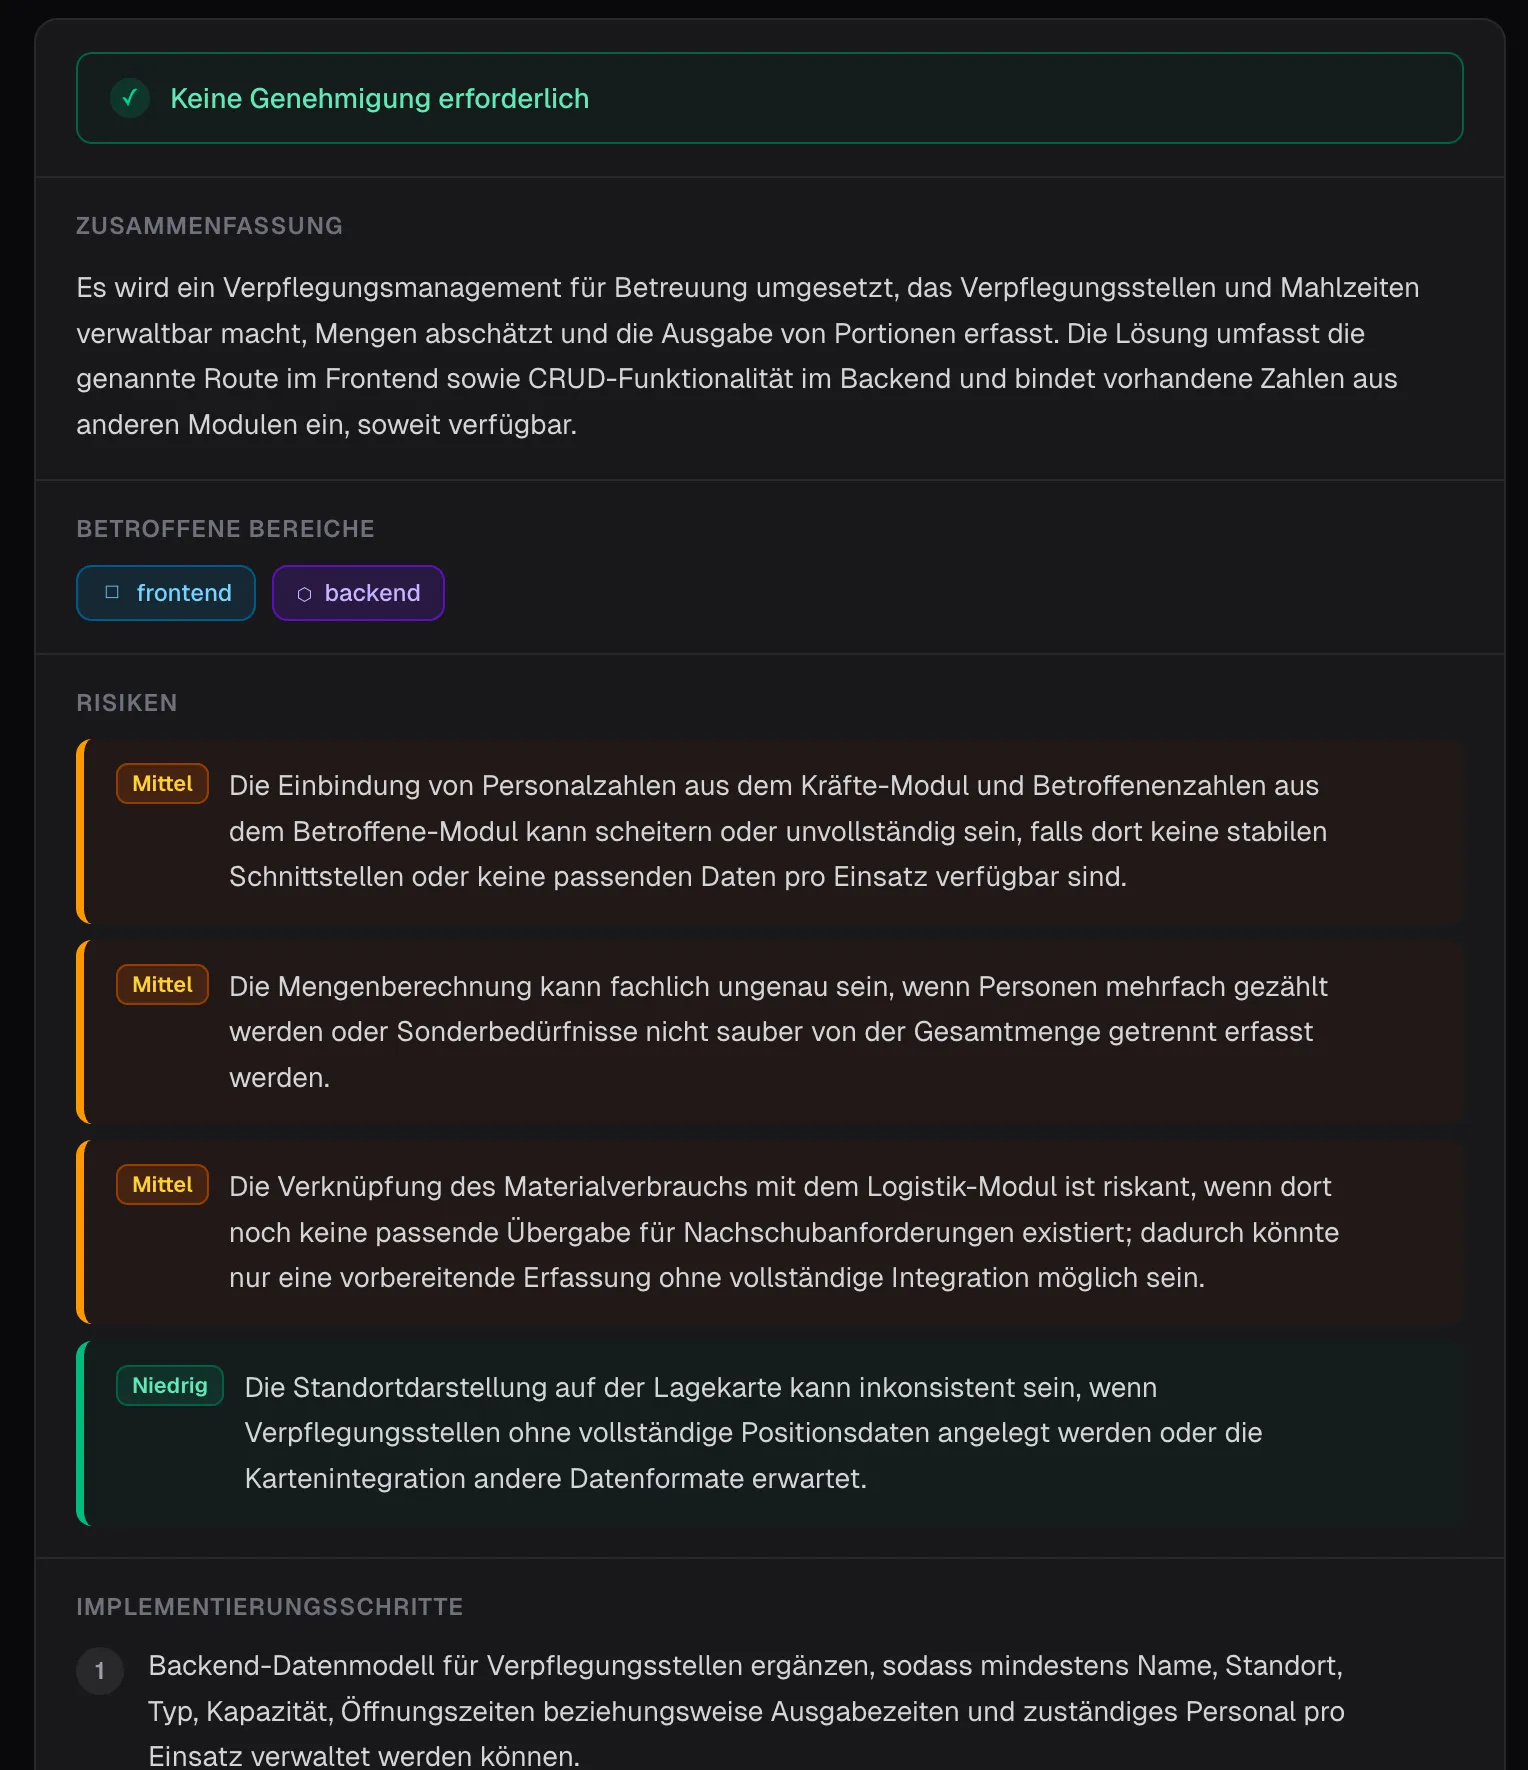
I första steget ville jag bara att datan skulle presenteras lite snyggare. Så långt allt väl, men hur vore det med en implementations-canvas?
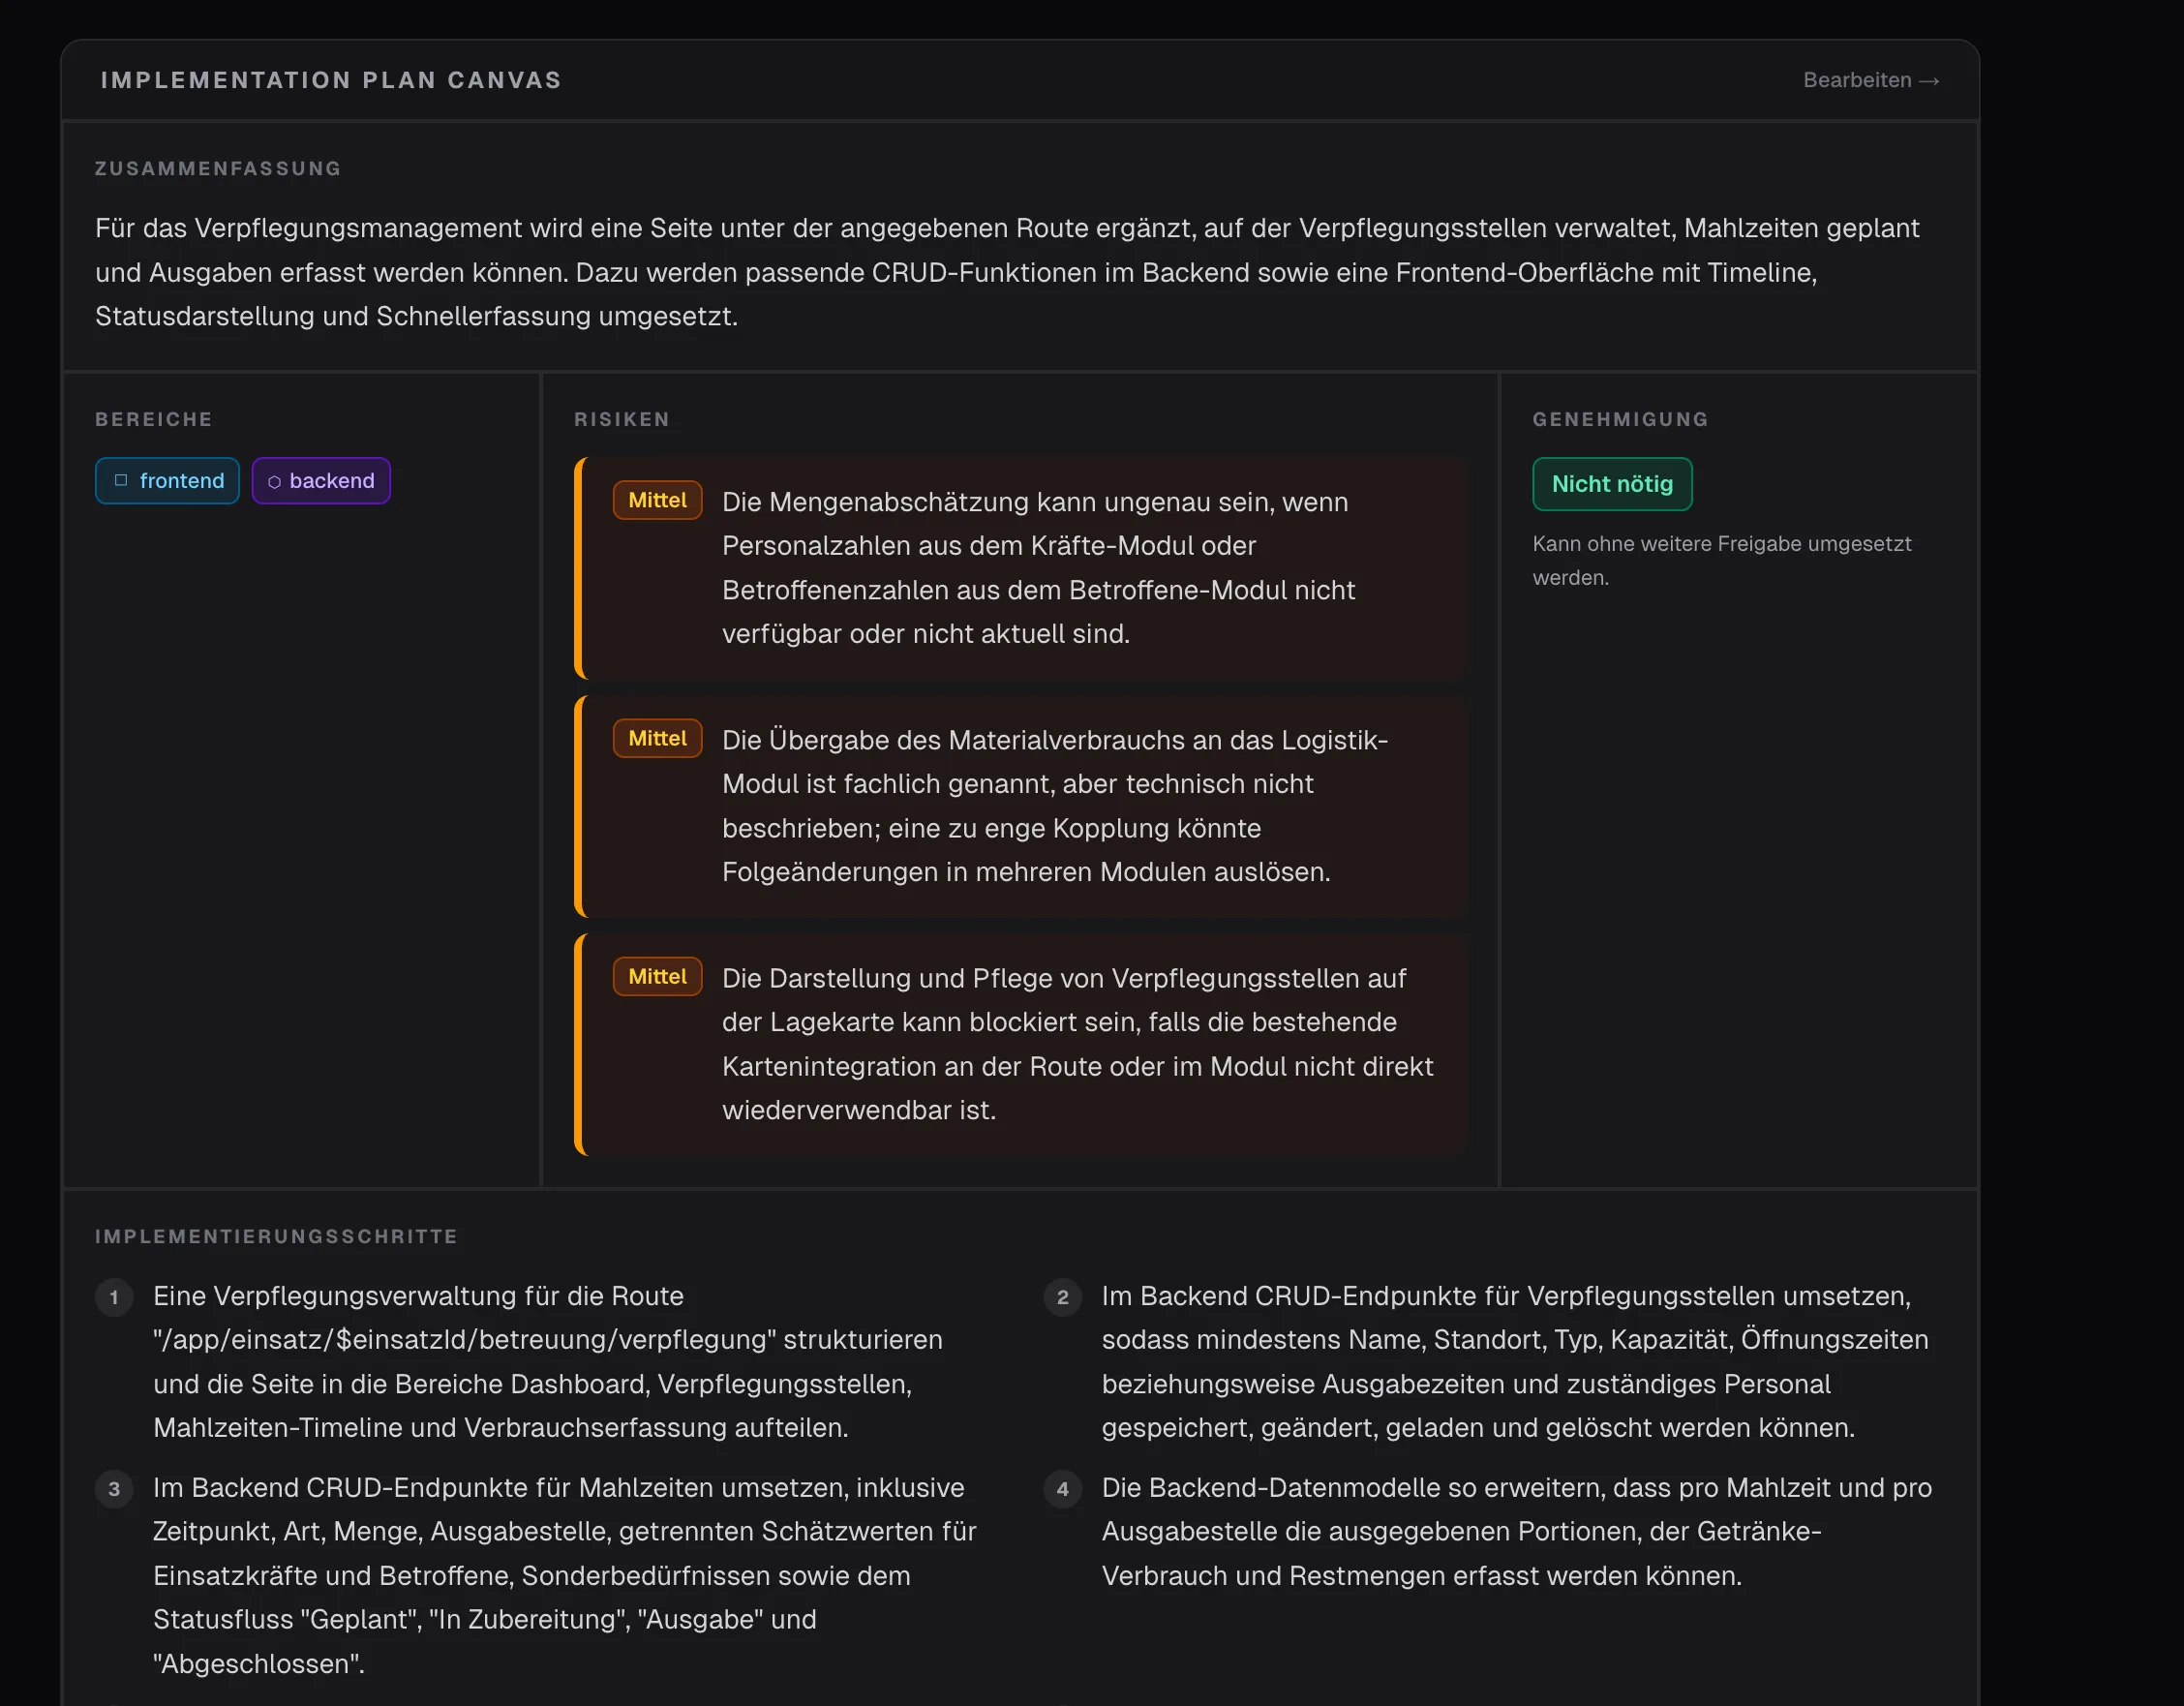
Ännu ett sätt att visa datan - med möjlighet att redigera innehållet - men hur skapar vi verkligt mervärde? Om tasken innehåller frontend-arbete… borde vi inte generera en mockup direkt? Sagt och gjort…
Ohh, I love Agentic Engineering.
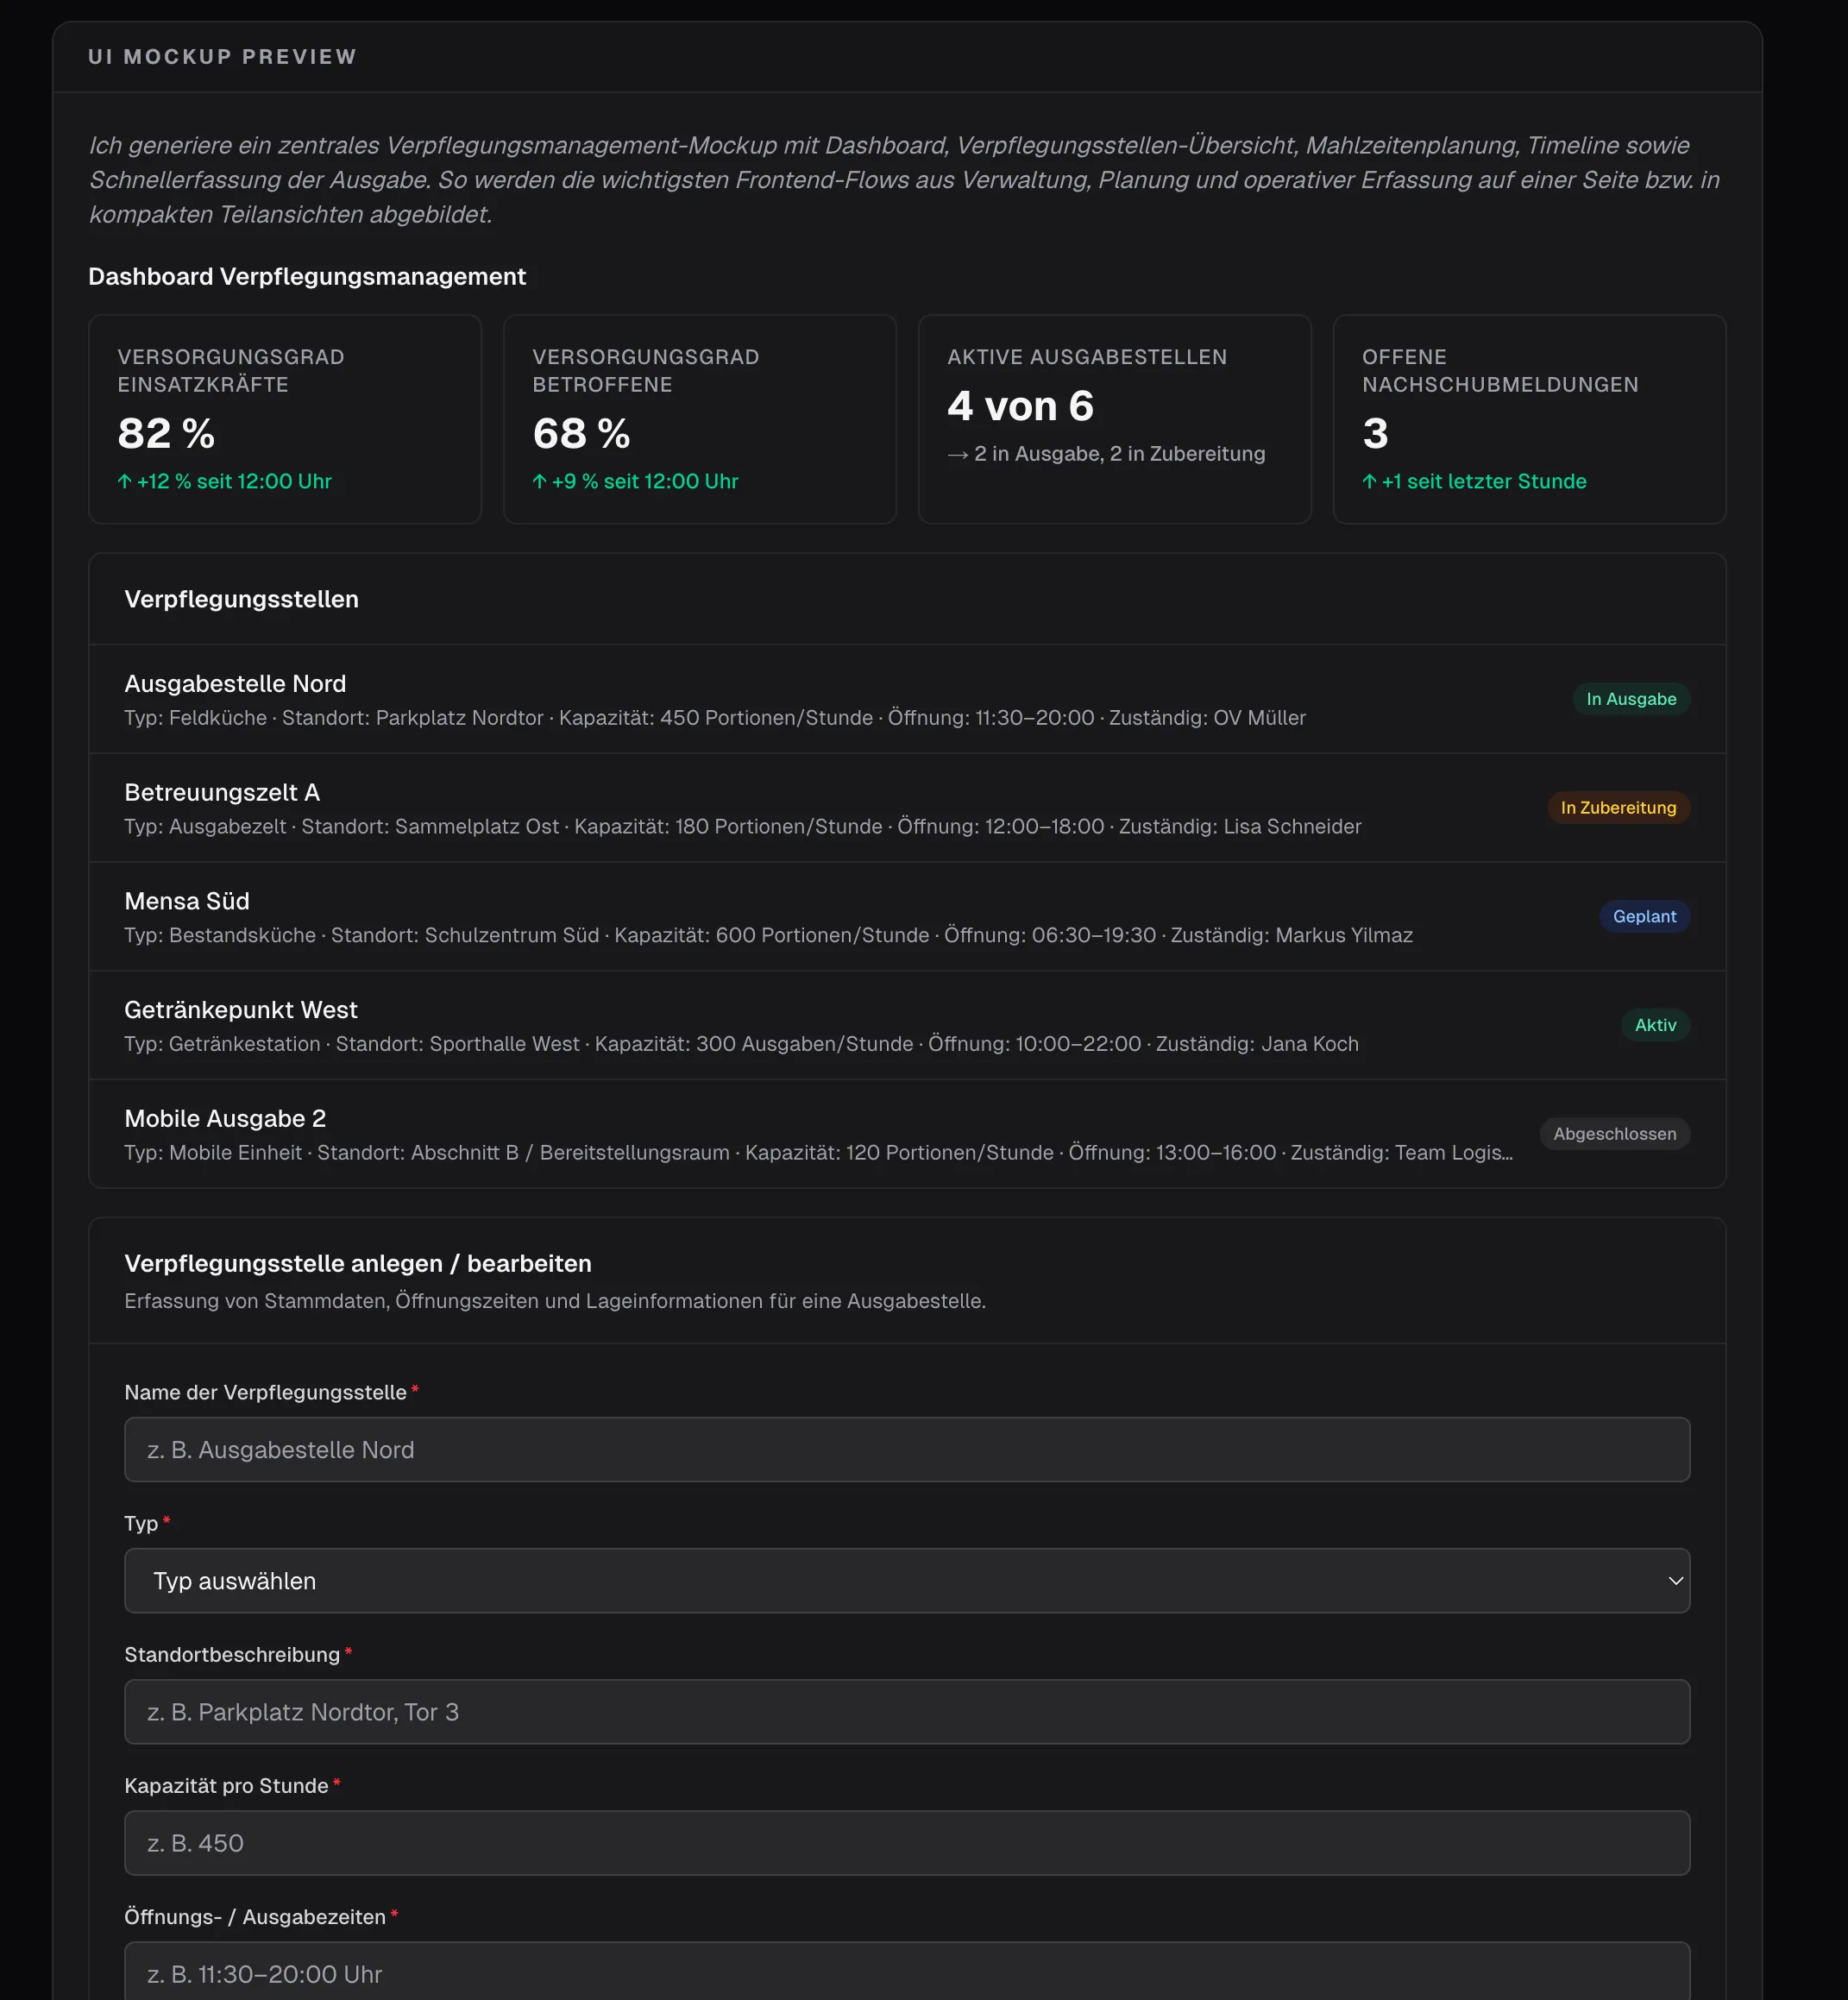
Prompt engineering förblir användbart. Men så fort modellens output bär verklig produktlogik behöver jag framför allt tre saker: Contracts, evals och telemetri. Det är precis där AI Systems Engineering börjar för mig. Och där vi upptäcker nya interaktionsmönster.
