
Die meisten AI-Demos gehen nich am Modell kaputt. Die gehen daran kaputt, dat se Freitext ausspucken - obwohl die Anwendung eigentlich Verträge braucht. Sobald ’n Modell nich mehr nur nett in ’nem Chatfenster antwortet, sondern Produktlogik auslöst, reichen gute Prompts allein nich mehr.
AI FullStack Engineering fängt da an, wo Modelloutput ’n Teil vom System wird - also da, wo ich Contract, Auswertung und Observability brauch.
Repo: https://github.com/rubenvitt/plan-from-issue
Fertige Webapp: https://plan-from-issue.pages.dev/
Die Vorbereitung: Unser Beispiel
Damit dat alles ’n bisschen greifbarer wird, fang ich mit ’nem Beispiel an: ’ne Mini-Webapp, die aus ’nem GitHub Issue oder irgend’nem Ticket-Text (z.B. aus Jira, GitLab) ’n strukturierten Umsetzungsplan macht. Dafür nehm ich mir zuerst ’ne Zielstruktur, anhand der ich ’n AI-FullStack-Feature erklär.
{
  "summary": "string",
  "affectedAreas": ["frontend", "backend", "database", "infra"],
  "risks": ["string"],
  "implementationSteps": ["string"],
  "testIdeas": ["string"],
  "requiresApproval": true
}
Auf Basis von diesem Beispiel kannze dir ganz einfach ’ne WebApp bauen lassen, die mit diesem Zielbild verschiedene Umsetzungspläne vernünftig darstellt - dat hat in diesem Fall Claude Code für mich gemacht.
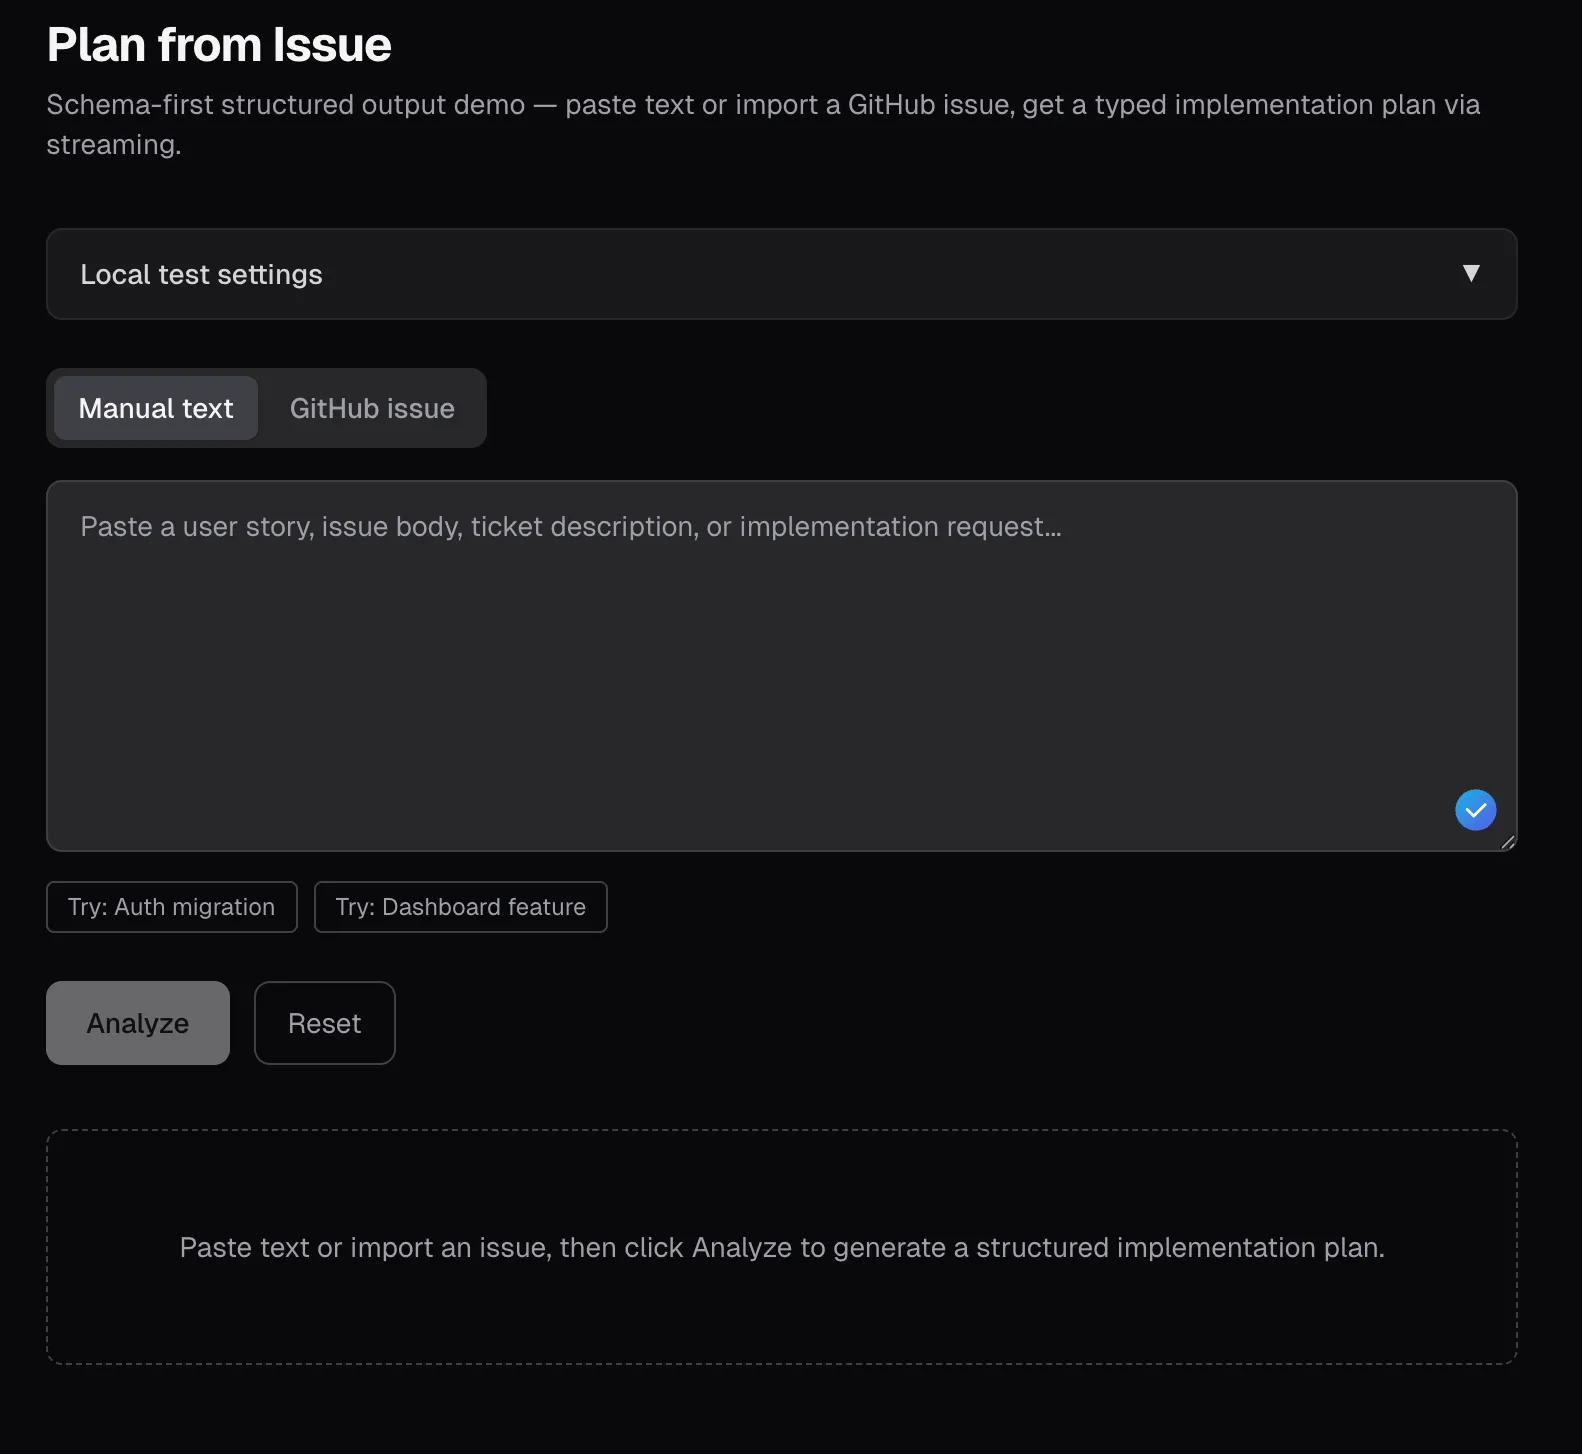
In der fertigen Webapp kann der Nutzer ’n Issue inne Textbox reinschreiben oder über GitHub abrufen - und dat strukturiert anzeigen lassen. Klar, dat is ’n echt einfacher und schnell hergeholter Use Case, trotzdem gelten die Prinzipien und Konzepte auch für ausgefuchstere UIs - hier isset halt einfach nachzuvollziehen.
Contract-first statt Prompt-first
Mit dem Beispiel von oben hab ich Claude einmal alles bauen lassen - eigentlich sind wa hier schon fertig. Die App funktioniert (nach ’nem Prompt, den ChatGPT geschrieben hat). Feierabend? Nich ganz.
Generierter Prompt zum Bauen vonne Demo
You are a senior TypeScript engineer. Build a small but polished demo web app that showcases schema-first AI output using the Vercel AI SDK.
Do not ask follow-up questions. Make reasonable choices and implement the full app end-to-end. Do not leave placeholders or stubs. Keep the code compact, readable, and suitable for a public demo repo / blog post.
Goal
Build a mini web app that turns either:
- freeform story / ticket text
- a GitHub issue
into a structured implementation plan.
The point of the app is to demonstrate that the AI feature is contract-first, not chat-first.
Stack
Use:
- Next.js App Router
- TypeScript
- AI SDK
- AI SDK UI
- Zod
- @ai-sdk/openai
- minimal styling only (simple CSS or Tailwind is fine)
- no database
- no authentication system
- no server-side persistence
Non-negotiable AI SDK architecture
Use these exact patterns:
- shared Zod schema imported by both client and server
- streamText + Output.object(…) in the route handler
- experimental_useObject on the client
- createOpenAI(…) to instantiate the provider with a request-specific API key
- custom request headers from the client to the analyze route
- no plain-text fallback mode for the main analysis flow
- do not use useChat for the main experience
This app is object-generation first, not chat first.
Core JSON contract
The app must use this exact top-level JSON shape and these exact property names:
{ "summary": "string", "affectedAreas": ["frontend", "backend", "database", "infra"], "risks": ["string"], "implementationSteps": ["string"], "testIdeas": ["string"], "requiresApproval": true }Implement it as a shared Zod schema and export the inferred TypeScript type.
Schema requirements:
- summary: non-empty string
- affectedAreas: non-empty array of unique enum values, restricted to: frontend, backend, database, infra
- risks: array of strings
- implementationSteps: non-empty array of strings
- testIdeas: non-empty array of strings
- requiresApproval: boolean
Do not parse model text with regex. Do not accept “almost matching” output. The UI and server must rely on schema-validated structured output.
Gehen wa aber noch ma ’n paar Schritte zurück. Normalerweise bau ich nich wat, bloß um et mit AI vollzukippen. Stattdessen sollen meine Daten aufbereitet und schlau inne UI eingebaut werden. Dazu gibt et schon unzählige Artikel im Internet, und AI hilft mir da schon prima.
Der Knackpunkt is aber: Zuerst kommt der Contract, dann der Prompt. Ich muss wissen, welche Daten ich strukturiert rausziehen muss, bevor ich mich ans Schreiben und Polieren von meinem Prompt mach. Dafür heißt et, Engineering-Arbeit aufzulisten, wie man se schon vor der AI-Zeit kennen sollte.
- Welche Felder will ich aus den unstrukturierten Daten rausziehen?
- Welche Felder sind Pflicht? Welche optional?
- Welche Wertebereiche gelten für Zahlen & Strings? Gibt et Enums?
- An welchen Stellen sollt ich den Output begrenzen, damit der inne UI oder Pipeline brauchbar bleibt?
Dabei helfen mir je nach Programmiersprache unterschiedliche Frameworks. Nehmen wa eine vonne moderneren Entwicklungsumgebungen (TypeScript), dann käm zum Beispiel ai-sdk in Frage. Aber auch Java wird mit Spring AI bedient, andere Programmiersprachen bringen bestimmt ähnliches Werkzeug mit. Diese Frameworks helfen, die Kommunikation mit verschiedenen Model Providern zu vereinheitlichen, sodass ich mich nich direkt an Hersteller und deren APIs ketten muss. In diesem Artikel bleib ich bei TypeScript & ai-sdk.

Solche Frameworks haben den dicken Vorteil, dat se die APIs vonne einzelnen Anbieter vereinheitlichen und typische Funktionen einfach und gleich konfigurierbar halten - so z.B. structured outputs, genau dat, wat wa brauchen.

Um diesen Contract zu bauen, brauchse meistens ’n Contract - vor allem JSON-Schema. JSON-Schemas beschreiben den Contract für JSONs: Welche Pflichtfelder gibt et? Welchen Regex müssen die Werte einhalten? Zahlenbereiche usw. - um so’n JSON-Schema zu bauen oder zu prüfen, können wa Tools wie https://json.ophir.dev/ nehmen. Oder die AI fragen, ob se uns ’n passendes JSON-Schema nach unseren Wünschen baut.
Dat Wichtigste an meinem AI-Feature is nich der Prompt, sondern der Vertrag, den der Rest vonne Anwendung vonne Modellantwort erwartet.
Mit dem generierten oder selbst gebauten Contract im Henkelmann können wa uns aufmachen, ’n passenden Prompt zu schreiben. Die Antwort wird dann entweder dem Contract entsprechen - oder ’nem Fehler-Contract, um den wa uns extra kümmern müssen, z.B. refusal von OpenAI.

Evals statt Bauchgefühl
Wer ’n AI-Feature ohne Evals baut, testet am Nutzer.
Wie oben beschrieben, hat Claude mir mit einem Shot direkt ’ne funktionierende Webapp gebaut. Wenn ich als Beispiel dat Issue https://github.com/rubenvitt/bluelight-hub/issues/420 eintrag, krich ich strukturierten Output:
{
  "summary": "Implement a Verpflegungsmanagement feature under the Betreuung area to manage feeding locations, meal planning, and distribution tracking for Einsatzkräfte and Betroffene. The change includes frontend views on the specified route and backend CRUD plus integrations for planning quantities and recording consumption.",
  "affectedAreas": [
    "frontend",
    "backend"
  ],
  "risks": [
    "Integration dependencies on Kräfte-, Betroffene-, Logistik-Modul, and Lagekarte may block parts of the feature or require fallback handling.",
    "Quantity estimation can become inconsistent if personnel and affected-person counts are unavailable, delayed, or separated differently than expected.",
    "Tracking meal status and portion counts across multiple Ausgabestellen introduces risk of incorrect state transitions or double counting.",
    "Capturing Sonderbedürfnisse must stay usable in the UI while still being detailed enough for planning."
  ],
  "implementationSteps": [
    "Add backend CRUD support for Verpflegungsstellen with fields for name, location, type, capacity, opening/output times, and responsible personnel.",
    "Add backend CRUD support for Mahlzeiten including time, type, estimated quantity, assigned Ausgabe-/Verpflegungsstelle, separated counts for Einsatzkräfte and Betroffene, Sonderbedürfnisse, and status values Geplant, In Zubereitung, Ausgabe, Abgeschlossen.",
    "Implement backend logic for quantity estimation based on the provided formula using counts from Kräfte and Betroffene where available.",
    "Add backend endpoints or service integration for recording consumption data per Mahlzeit and Ausgabe-/Verpflegungsstelle: issued portions, beverage consumption, remaining quantities, and material consumption for Logistik handoff.",
    "Build the frontend page at /app/einsatz/$einsatzId/betreuung/verpflegung with management views for Verpflegungsstellen and Mahlzeiten.",
    "Implement Verpflegungsstellen cards showing key details and current status, with create/edit/delete flows.",
    "Implement a Mahlzeiten timeline that separates planned, current, and past meals and supports status updates through the defined lifecycle.",
    "Add meal planning UI for time, type, quantity estimate, separated person counts, special needs, and assigned distribution point.",
    "Implement quick-entry controls for portion output using +/- counters and forms for beverage usage and remaining quantities.",
    "Add a dashboard view showing supply coverage as x% versorgt based on planned vs. served data.",
    "Integrate map marking of Verpflegungsstellen on the Lagekarte from the route workflow.",
    "Connect quantity planning to personnel counts from Kräfte and affected-person counts from Betroffene, and send recorded material consumption to Logistik for replenishment workflows."
  ],
  "testIdeas": [
    "Create, update, list, and delete Verpflegungsstellen with all required fields and verify they appear correctly in the management UI.",
    "Plan a Mahlzeit with separated counts for Einsatzkräfte and Betroffene and verify the estimated quantity follows the specified calculation.",
    "Verify meal status transitions from Geplant to In Zubereitung to Ausgabe to Abgeschlossen are reflected correctly in the timeline and detail views.",
    "Record portion output for a meal at a specific Verpflegungsstelle with +/- quick entry and confirm totals persist correctly.",
    "Record beverage consumption, remaining quantities, and material consumption and verify the data is stored and associated with the correct meal and location.",
    "Enter Sonderbedürfnisse such as allergies, vegetarian, halal, and confirm they are retained and visible in planning views.",
    "Verify Verpflegungsstellen are shown on the Lagekarte with the configured location.",
    "Test integration behavior when Kräfte or Betroffene counts are available versus unavailable, ensuring quantity estimation degrades predictably.",
    "Verify the dashboard coverage percentage updates as portions are issued.",
    "Confirm material consumption data is handed off correctly to the Logistik integration path."
  ],
  "requiresApproval": false
}
40 Zeilen Ergebnis. LGTM. Done. Ab anne Bude.
Oder… doch nich?
Die Frage is nich, ob die Antwort “smart” klingt, sondern ob se für meinen Workflow verlässlich genug is.
Woher weiß ich, dat dat Ergebnis ’n gutes Ergebnis is? Woher weiß ich, dat ich mich da drauf verlassen kann? Der Contract gibt mir ’ne strukturelle Garantie. Ob der Inhalt fachlich wat taugt, is damit noch nich beantwortet. Deswegen müssen vor allem die fachlichen Fragen geklärt werden: Sind die betroffenen Bereiche vernünftig erkannt? Sind die Risiken brauchbar? Kann ich mit den Testideen wirklich wat anfangen - oder is dat überflüssiger Kokolores? Is dat Approval-Flag plausibel? Eine Möglichkeit, diese Fragen komplett zu beantworten, is, durch jede einzelne Antwort durchzugehen - und die Fragen für mich selber zu beantworten, zu bewerten. Dann kann ich den Prompt anpassen und noch ma bewerten. Aber meine ehrliche Meinung dazu? Dat will ich nich, nee! Da hab ich keinen Bock drauf.
Und jau, et gibt ’ne Alternative. Sogar ’n paar. OpenAI hat ’n eigenen Optimizer, et gibt aber auch jede Menge Open-Source-Tools. ’n Beispiel dafür wär https://github.com/promptfoo/promptfoo.
Damit et einfach bleibt, hab ich mich hier für die OpenAI Platform entschieden. Da is ’ne Evaluierung flott gemacht: Prompt anlegen (wichtig: mit Variable!), im Reiter Evaluation ’n neues Dataset anlegen, dann Testdaten reinkippen. Ich nehm mir einfach ’n paar von meinen Issues ausm bluelight-hub-Projekt - danach auf Play klicken, schon wird der Prompt auf die Liste an Inputs losgelassen (Achtung: kostet Geld).
Hier hilft uns OpenAI schon ordentlich, fast alles kann da direkt automatisch überarbeitet werden, auch unser JSON Schema kann generiert werden. Ich hab einfach ma dat zod-Schema ausm Beispielprojekt da reingepackt - dann wurde dat passende JSON Schema dazu generiert…. perfekt.
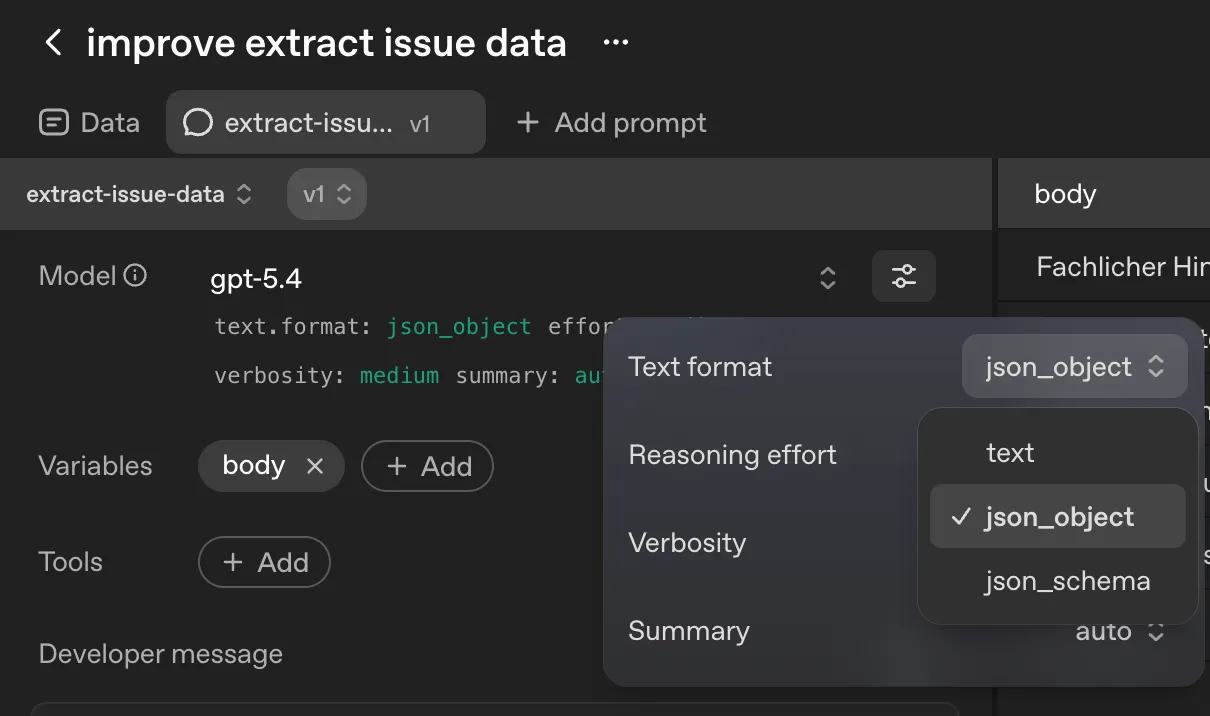
Der Vorteil dabei? Wir haben getz mehrere Spalten in unserer Eval-Ansicht und können die einzeln produzierten Werte direkt ablesen und prüfen, wie wa damit umgehen wollen.
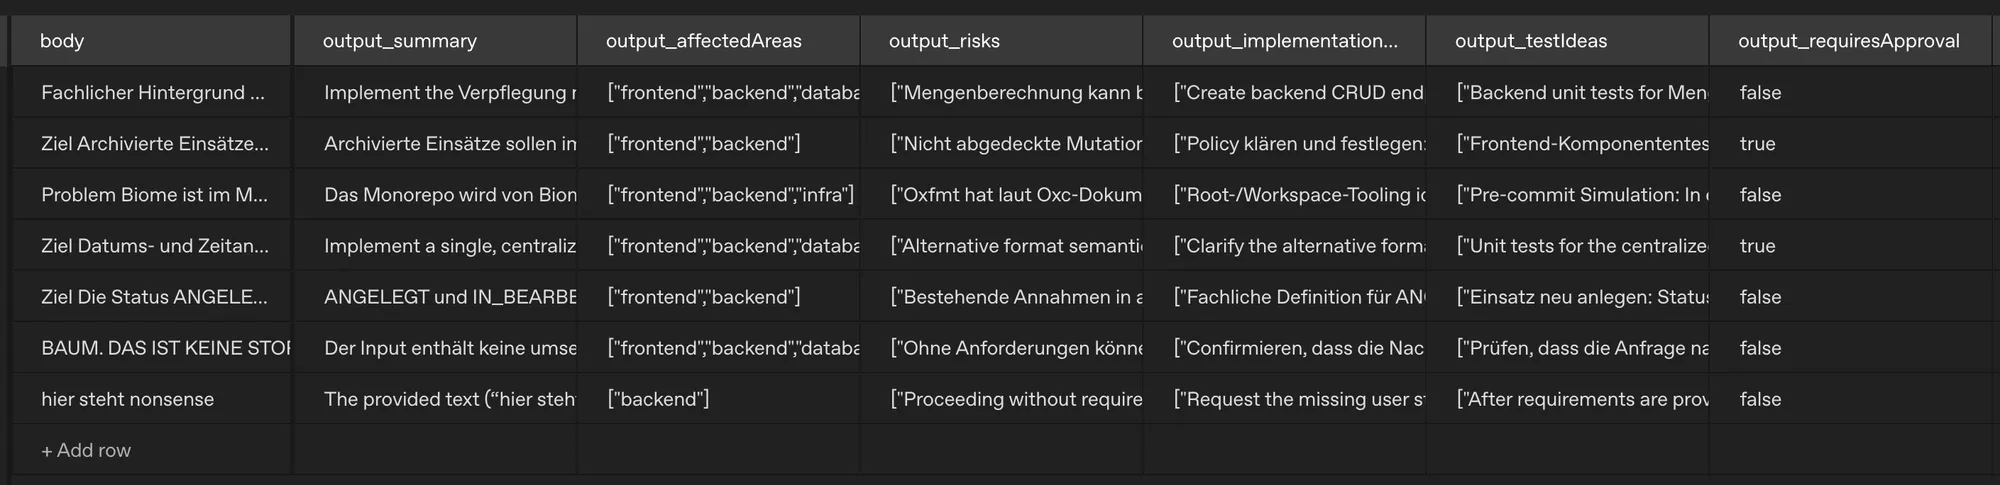
Getz können wa mit der eigentlichen Evaluierung loslegen: Neue Columns anlegen, entweder für Begutachtung von Hand (annotation) - oder wir lassen die AI die einzelnen Antworten begutachten (grader), prüfen und bewerten; nach unseren Kriterien.
Nach ’ner ersten Evaluation nach zwei Kriterien wird klar: Unser Prompt muss noch ma inne Werkstatt. Wat is zu tun? In diesem Tool reicht ’n Klick auf Optimize - und OpenAI kümmert sich um den Rest - auf Basis vonne Bewertung aus der Prompt Evaluation.
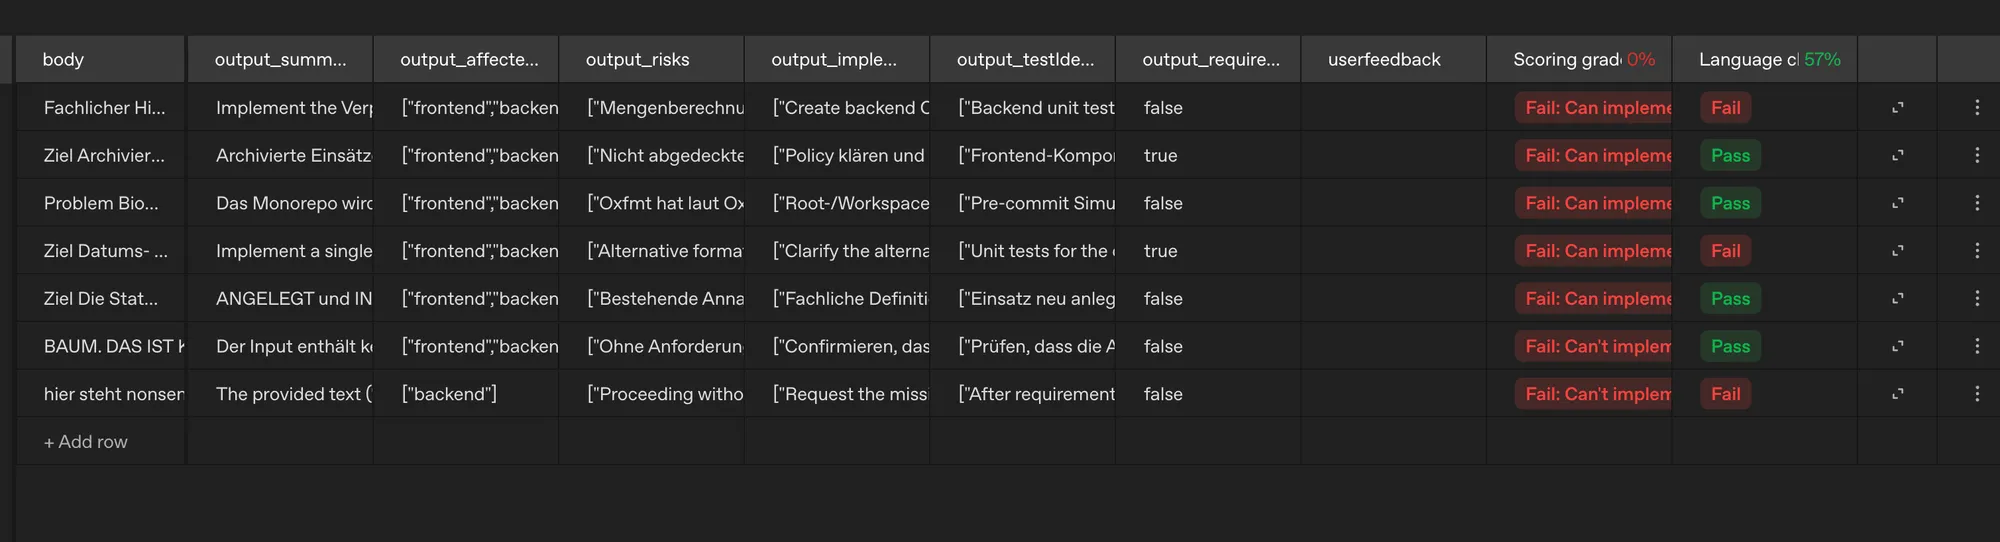
Nach ’n bisschen mehr Optimierung und ’ner Anpassung von Hand (per Prompt) is dat Ergebnis dann ’n bisschen besser geworden. Klar, dat is ’n echt kleines Set zur Evaluierung - mir gehts hier eher um die Sache an sich; auch Feedback von Hand hab ich hier einfach ma weggelassen, auch wenn dat normalerweise dazugehört, um am Ende vernünftige Ergebnisse zu kriegen.
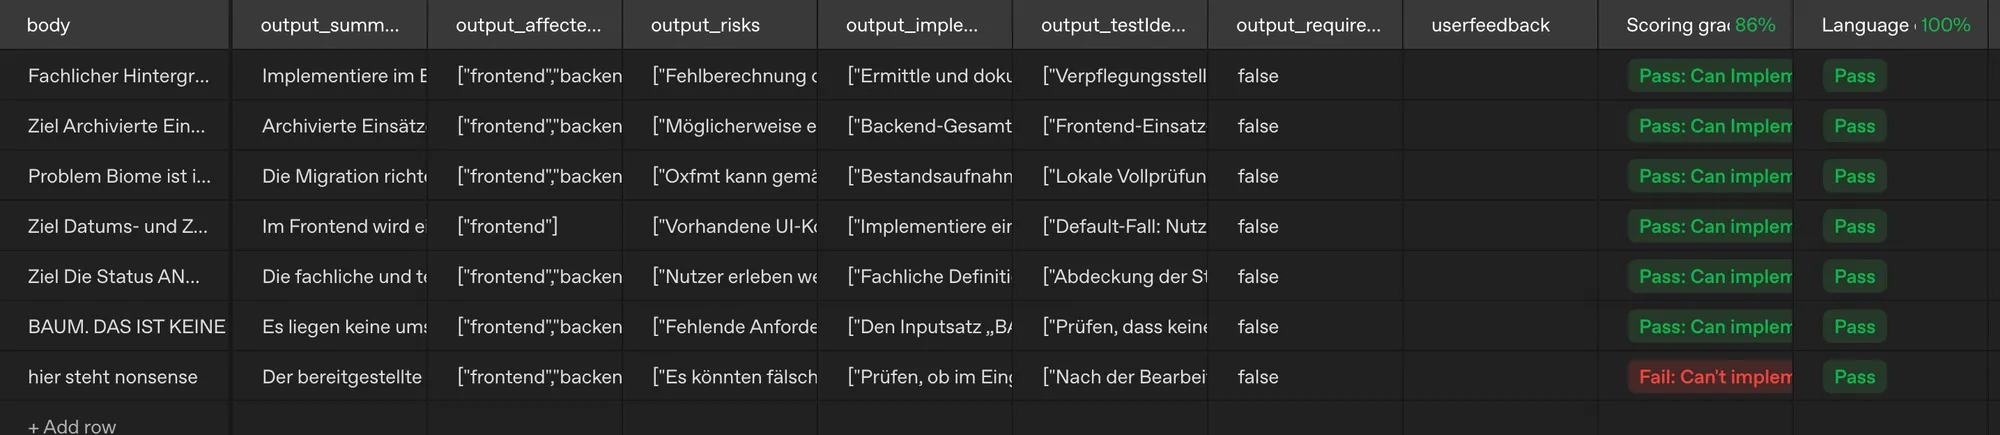
Mit dem tollen Ergebnis geh ich direkt zu Claude und bitte drum, den Prompt mit dem neuen zu aktualisieren.
Damit haben wa getz ’n verbesserten Prompt, der unsere Anforderungen besser abdeckt. Mit dem structured output bauen wa UI, statt bloß Text-Output. So viel zum Mini-Einblick. Da gibt et noch so viel mehr zu entdecken, zu optimieren und zu verfeinern.
Dat Grundprinzip vonne Eval sollte aber trotzdem klar geworden sein: Ziele festlegen, Datensatz aus Beispielen sammeln, eventuell mit erwarteten Ergebnissen, Metriken festlegen, Läufe vergleichen, auswerten lassen.
Observability statt Black Box
Wenn wa nichtdeterministische Systeme in unsere Anwendungen einbauen, is et umso wichtiger zu verstehen, wat passiert is, wenn ma wat kaputt is, damit wa ’n Weg finden, genau dat abzumildern. Dazu gehören ’n paar wichtige Datenpunkte, die wa am besten sammeln:
- welches Modell wurde genommen?
- wie lange hat dat LLM für ’ne Antwort gebraucht?
- war dat zurückgegebene JSON valide zum Contract?
- waren Retries nötig?
- ggf.: welche Tools wurden benutzt?
- wo mussten Menschen eingreifen?
- wie viele Token gingen drauf und wat hat dat gekostet?
OpenTelemetry hat inzwischen Konventionen für GenAI Applications für Events, Metriken & Spans. Dat heißt, auch die AI-Funktionen können in die Observability eingebunden werden. Im oben erwähnten AI SDK gibt et ebenfalls ’n Konnektor, um über dat Framework automatisch die passenden Daten aufzunehmen und zu verschicken.

Der FullStack-Teil is die UI, nich nur dat Modell
FullStack wird dat Thema erst dann, wenn ich nich nur ’n Modell anquatsche, sondern ’n Bedienfluss für Menschen entwerf.
Getz, wo wa ’n vernünftigen Contract mit dem LLM ausgemacht haben, den wa über die API kommunizieren, und ’n echt tollen Prompt gebaut haben - wat fehlt? Klar, die UI. Am Anfang vom Post hab ich schon angedeutet: Bloß ’n bisschen Text anzeigen, dat kann jeder. Auch nach dem One-Shot-Versuch mit Claude war dat zwar kein Chat-Interface, aber trotzdem nur ’ne Aneinanderreihung von Texten. Getz bewegen wa uns zwar auf etwas trockenem Terrain - ’nem Umsetzungsplan für Stories -, aber zumindest für die Darstellung kriegen wa doch bestimmt wat Tolles hin, oder?
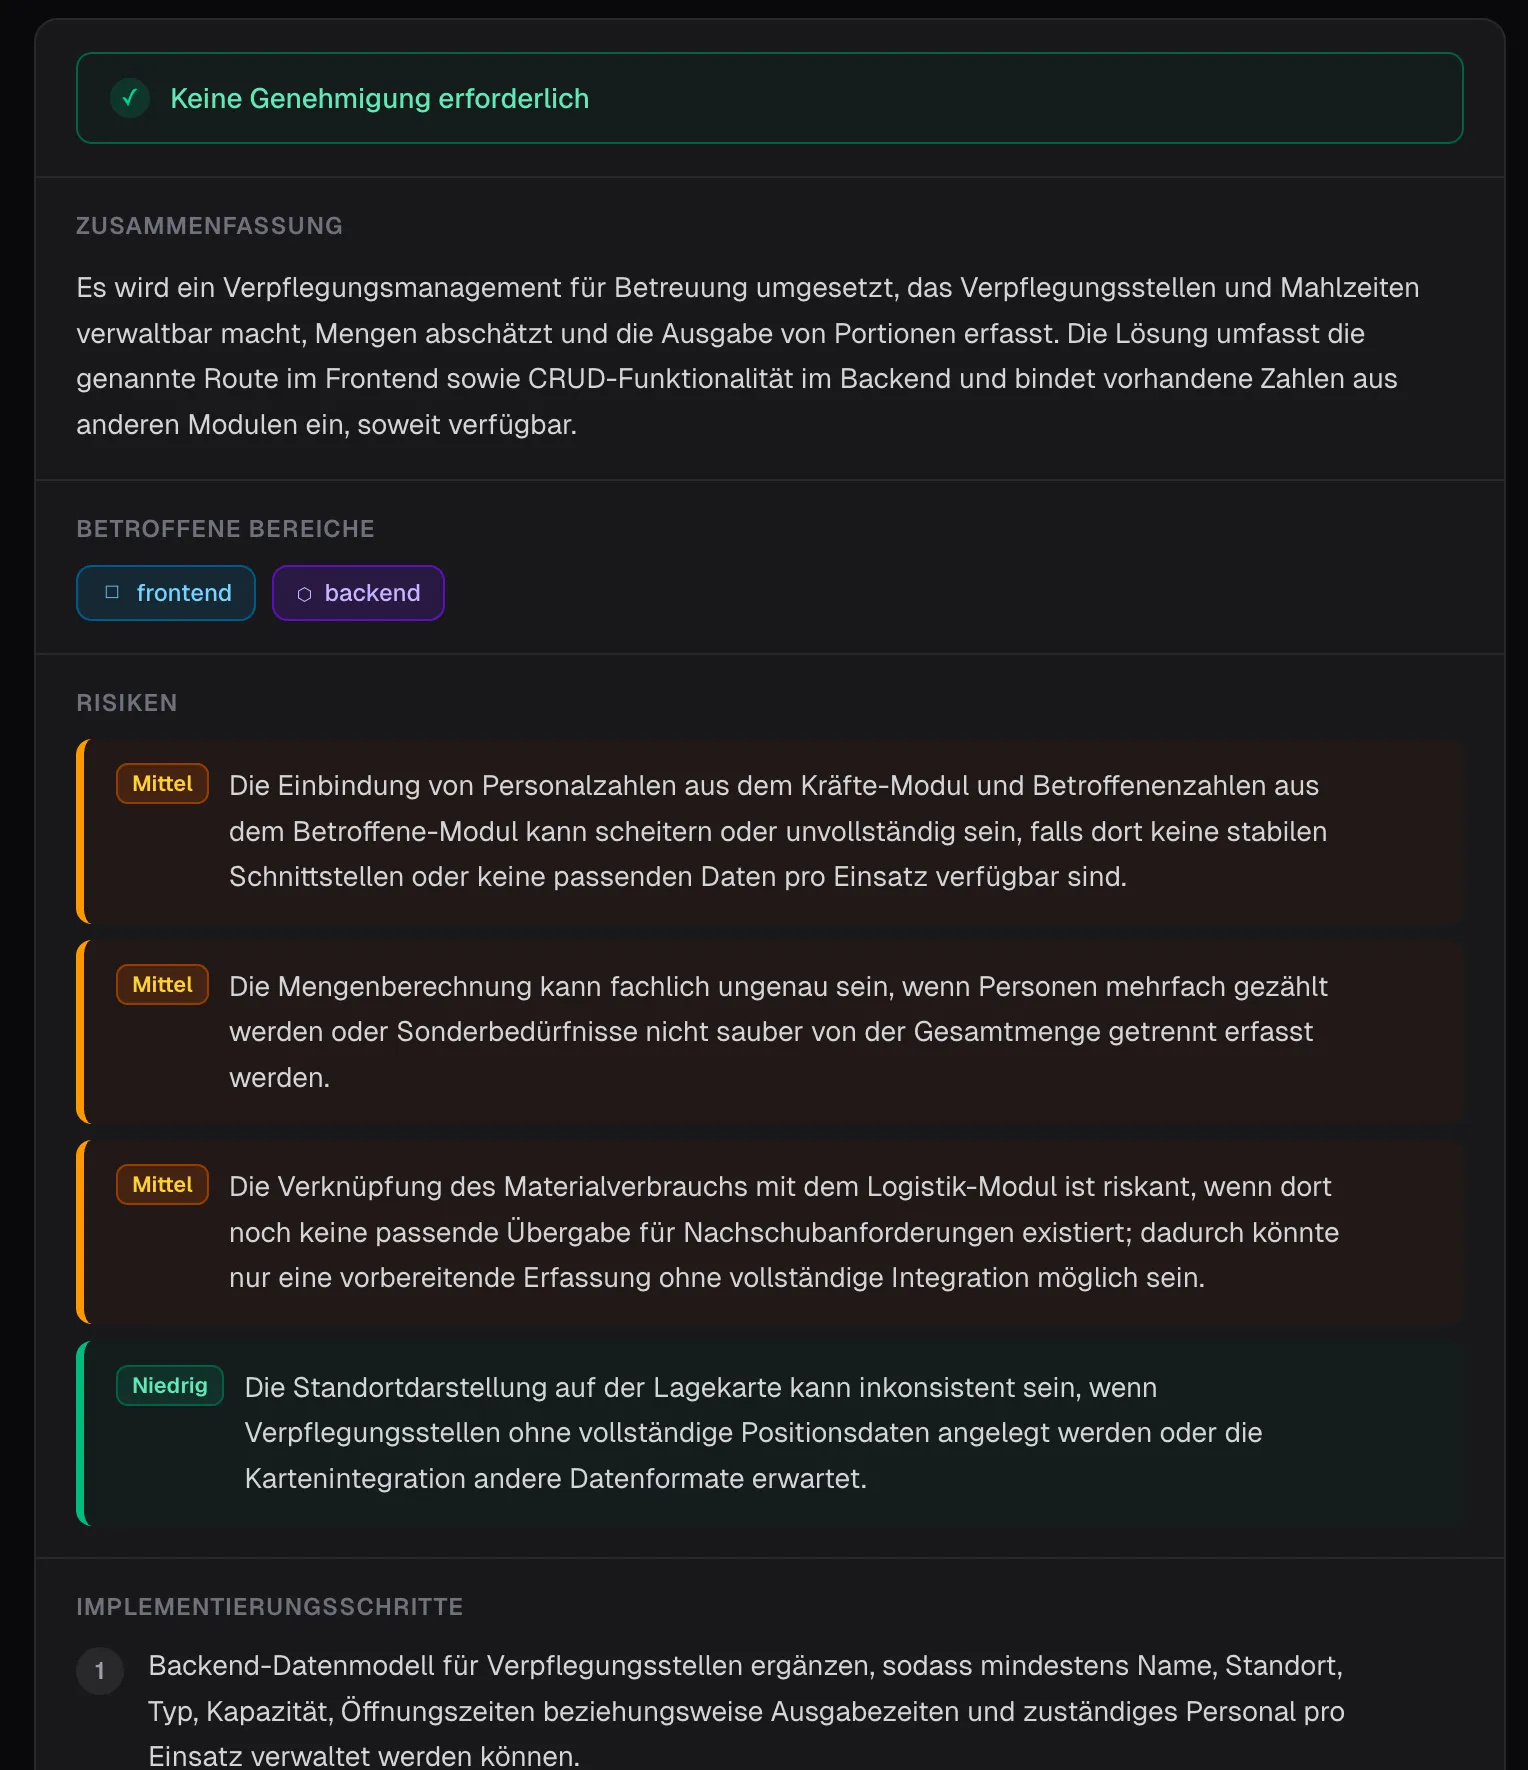
Im ersten Schritt wollt ich, dat die Daten einfach ’n bisschen schöner aufbereitet werden. So weit, so gut - wie wär et dann mit ’nem Umsetzungs-Canvas?
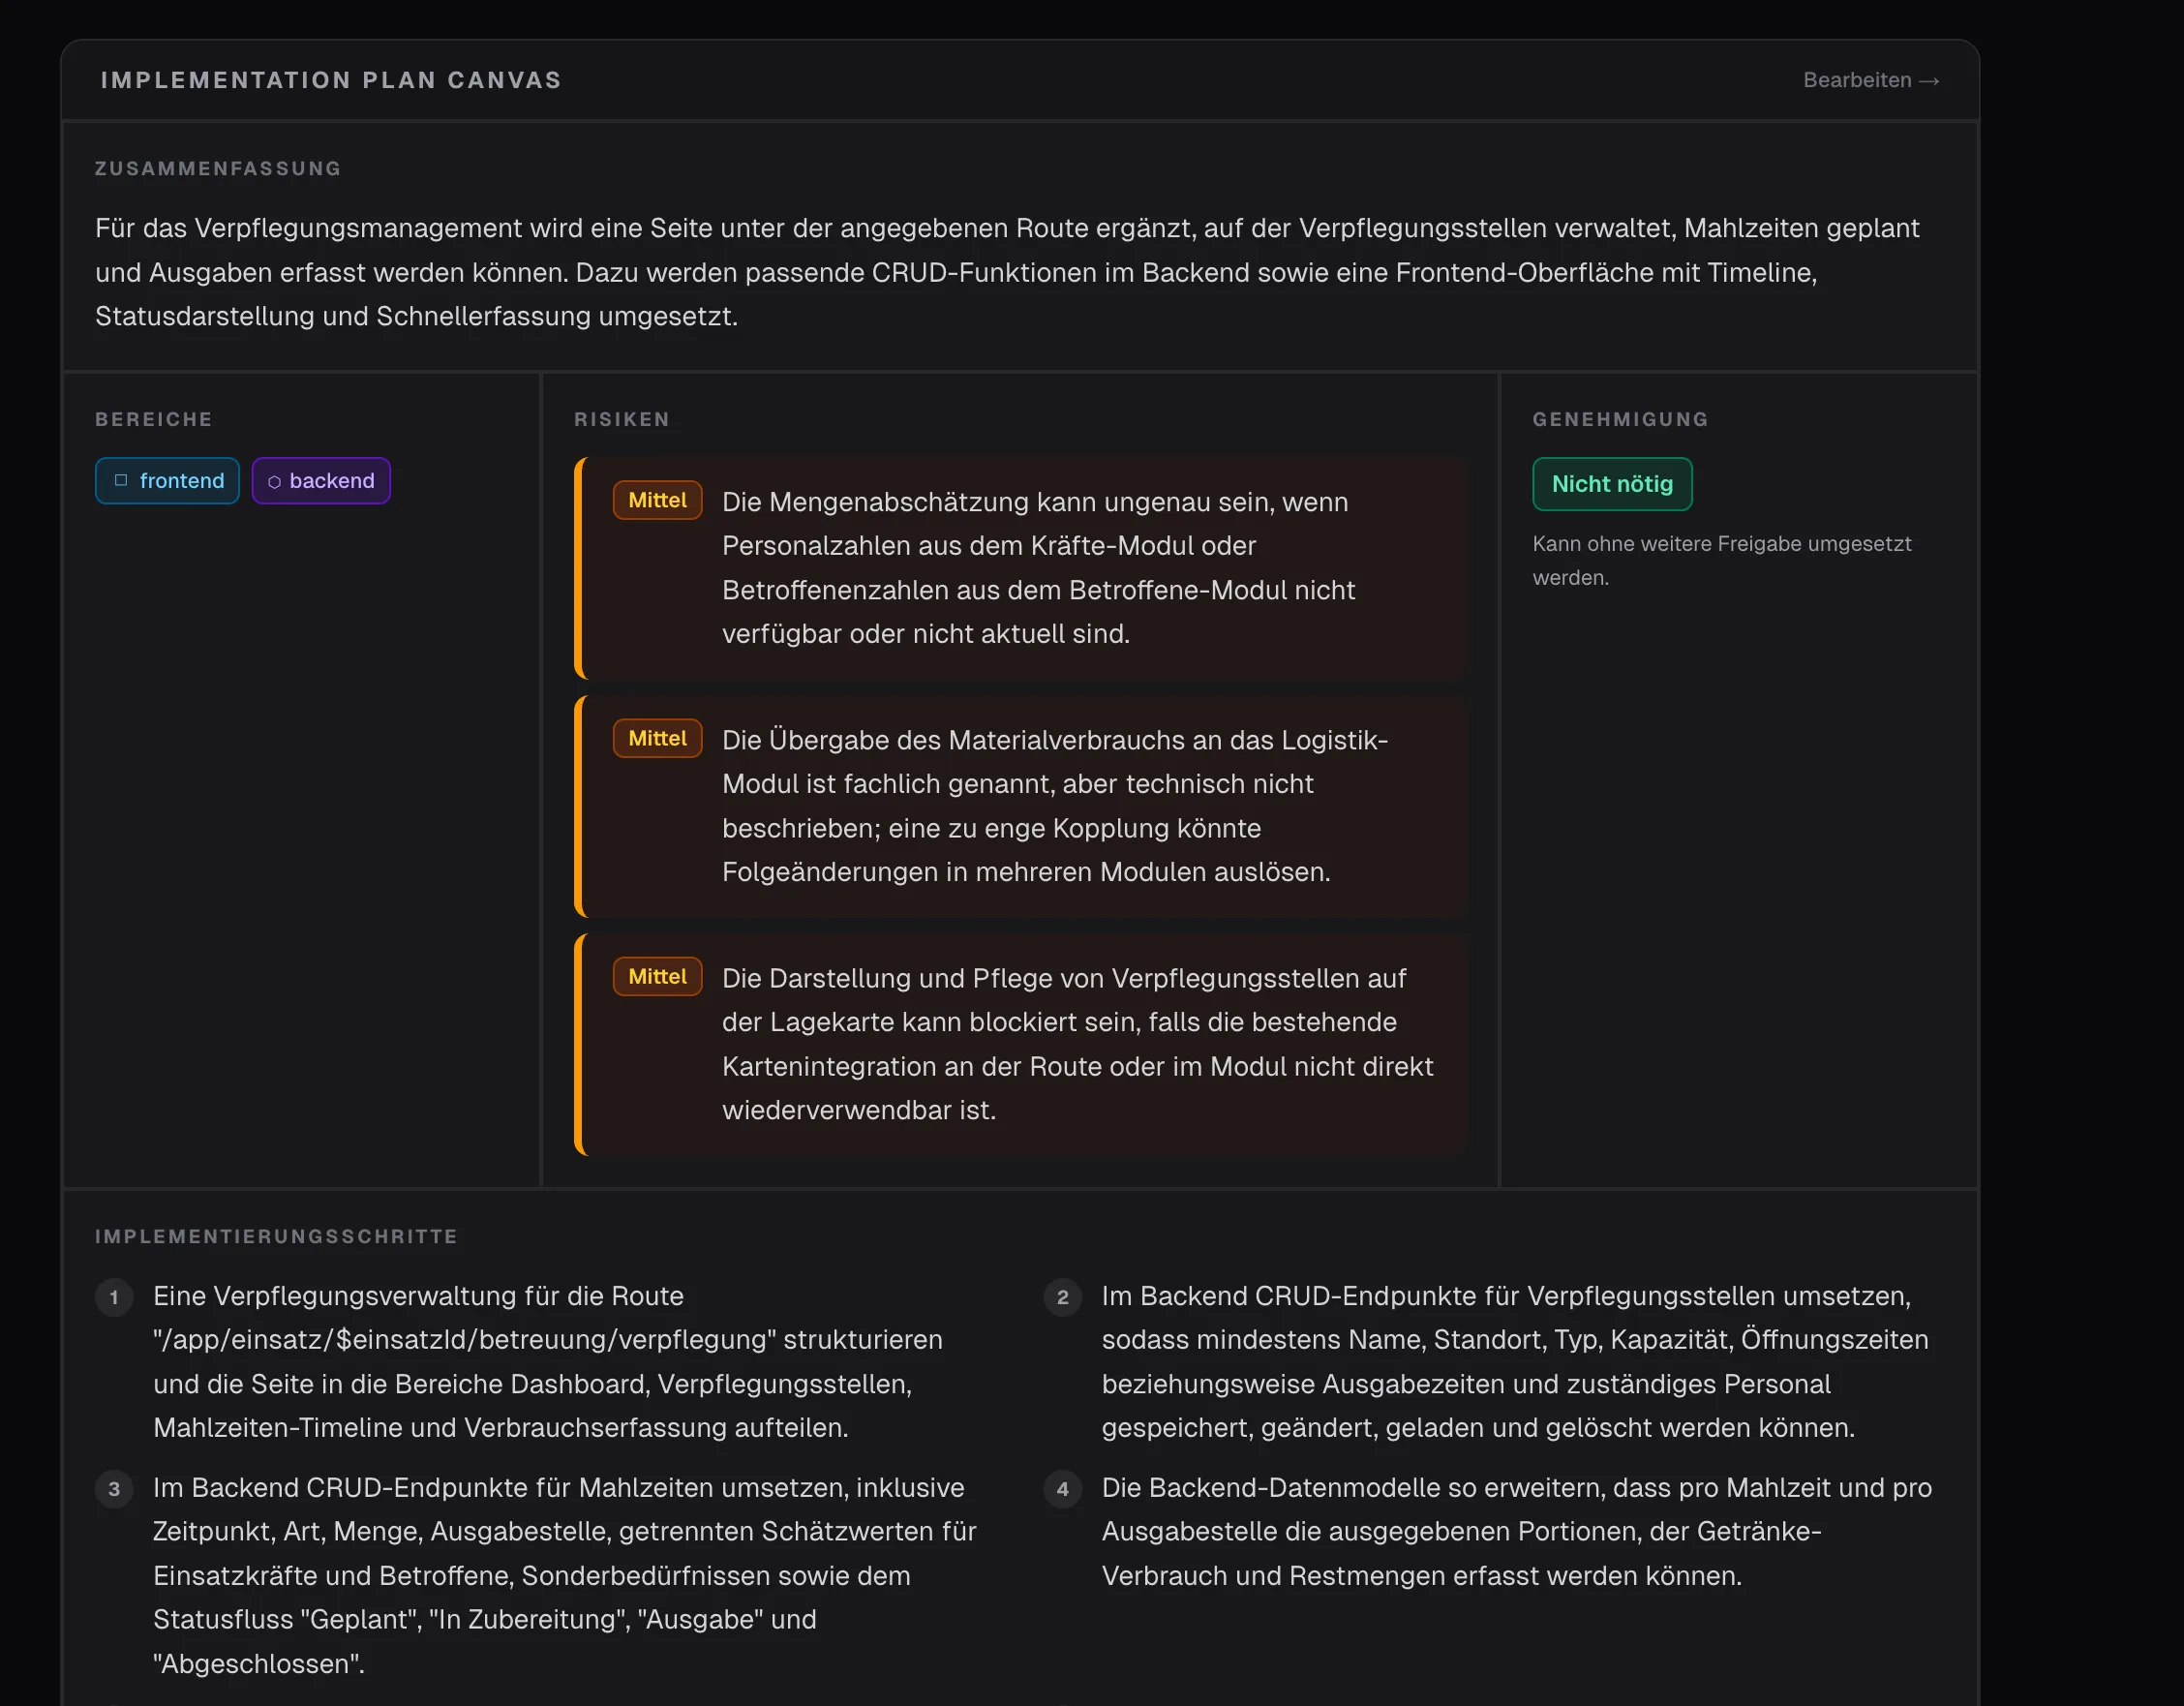
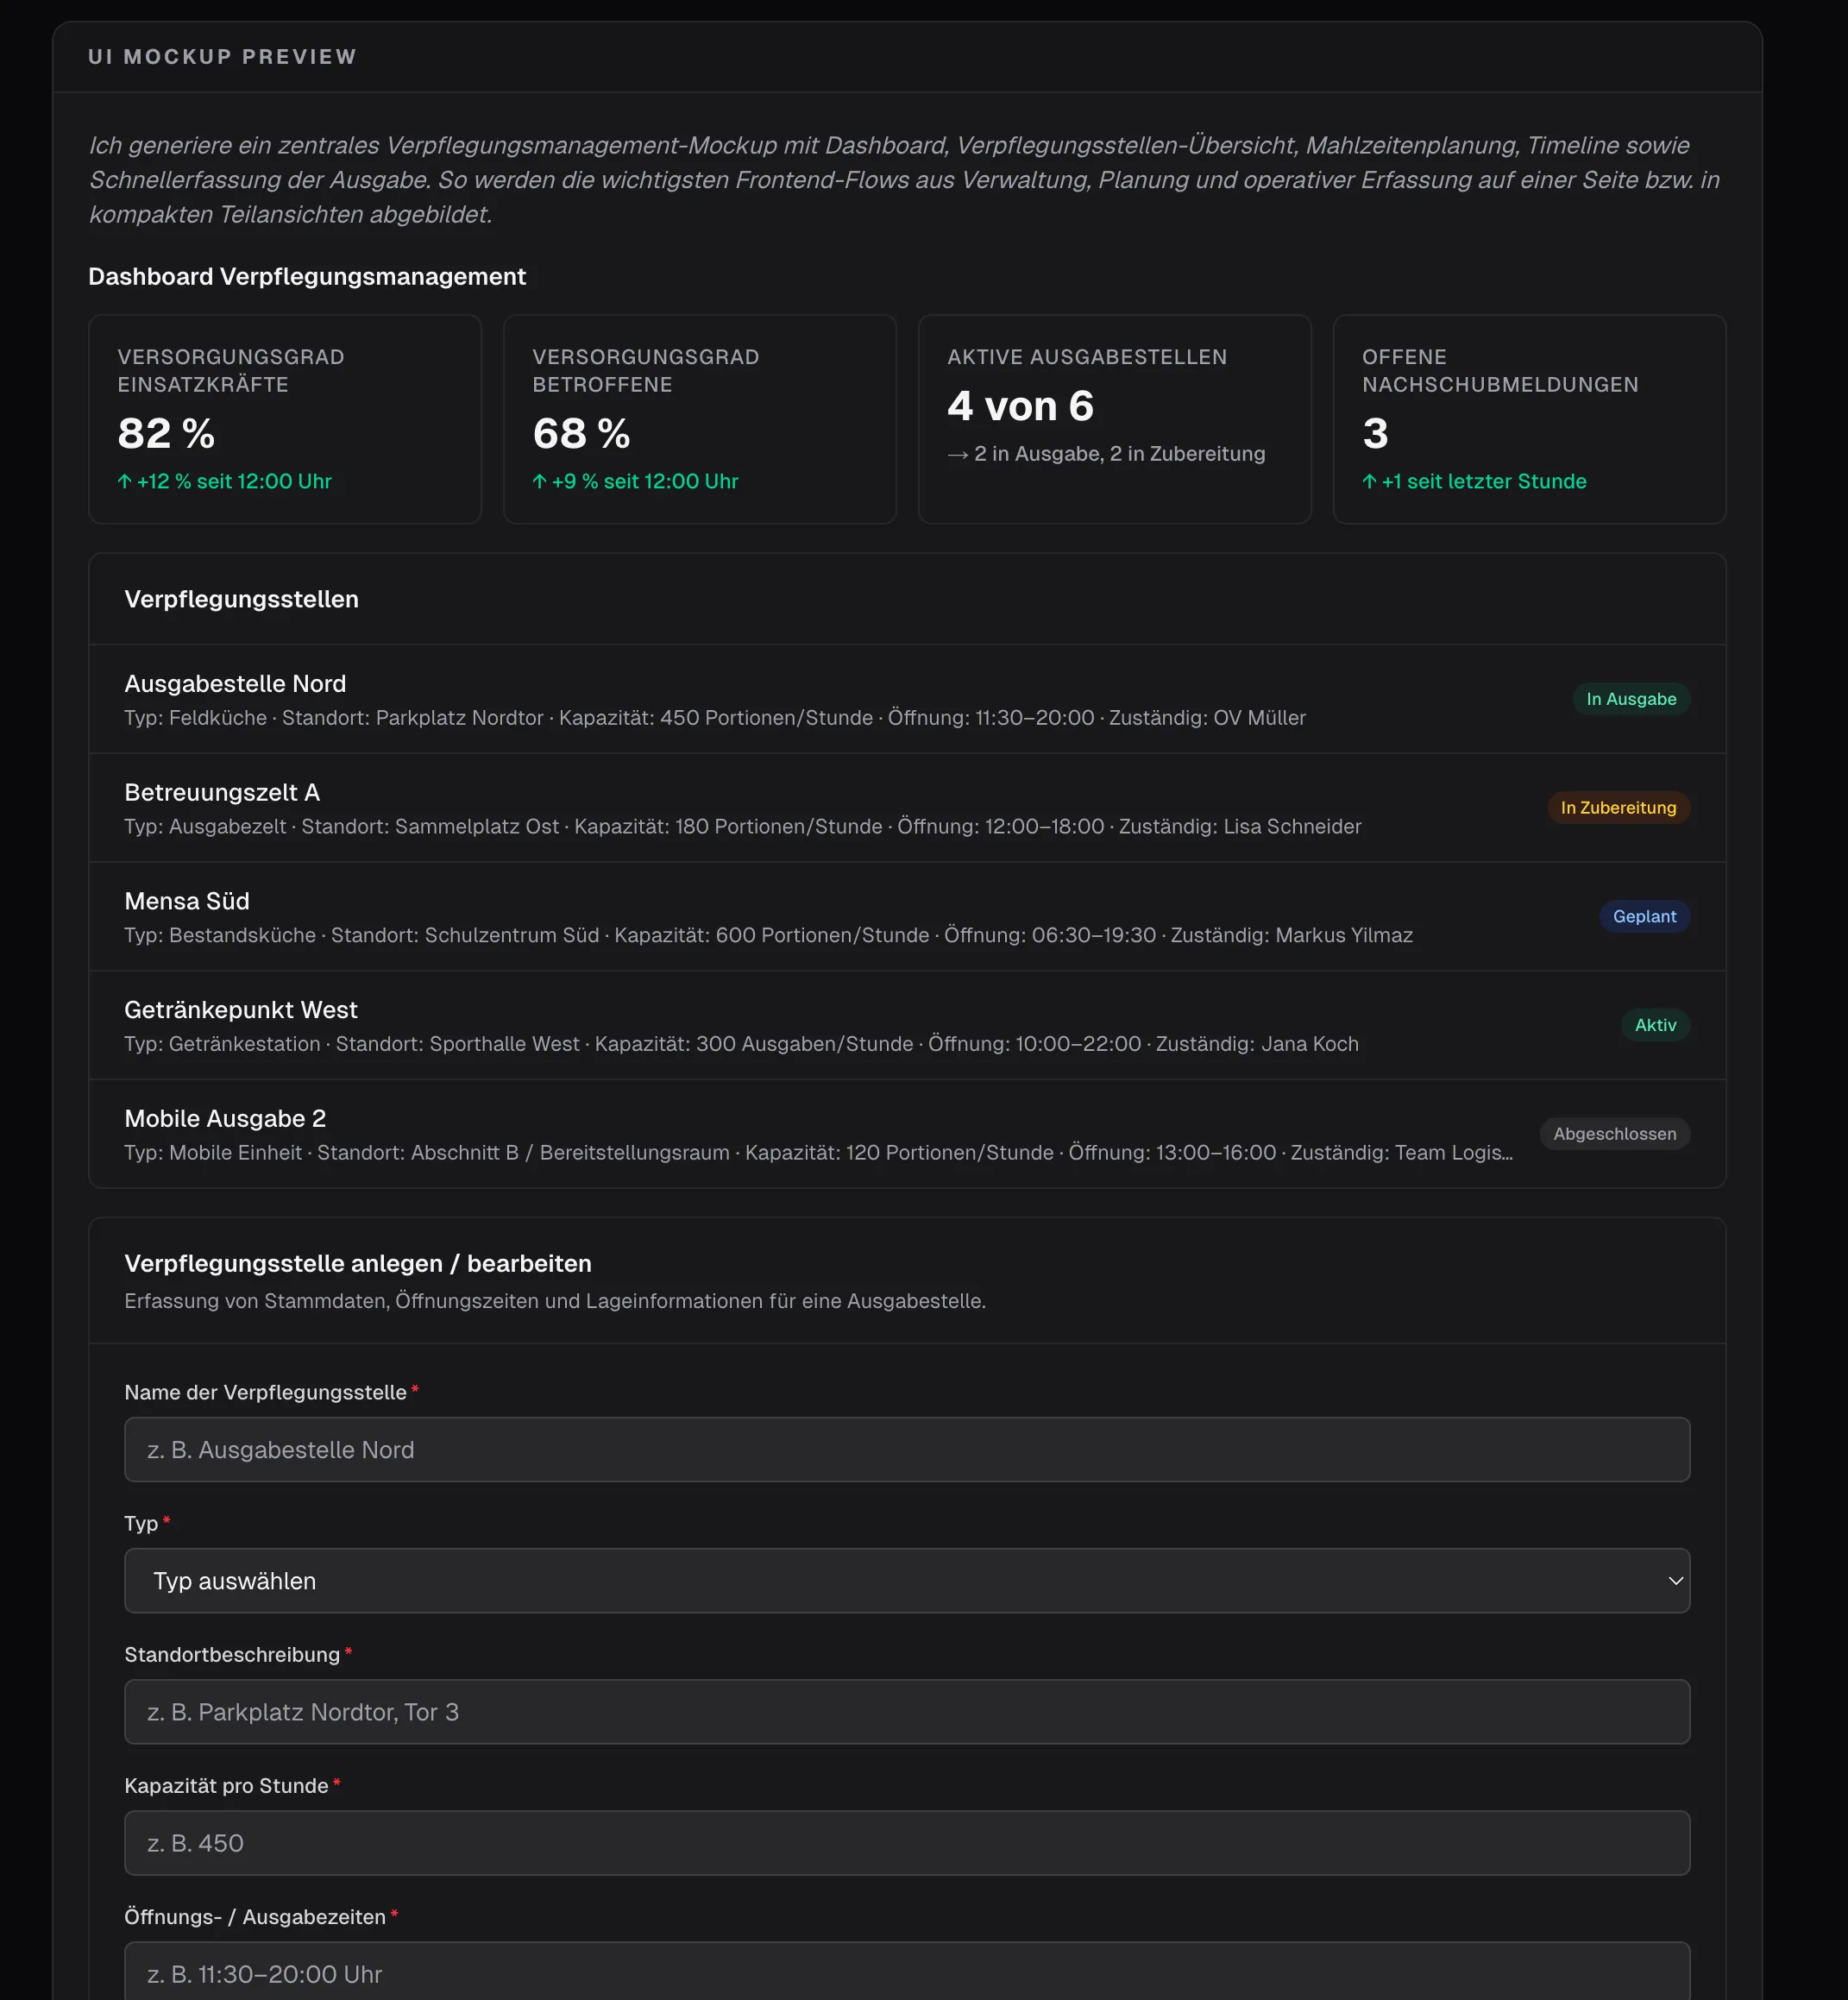
Noch ’ne Art der Anzeige - mit der Möglichkeit, die Inhalte zu bearbeiten - aber wie schaffen wa echten Mehrwert? Wenn der Task Frontend-Arbeit drin hat… sollten wa dann nich direkt ’n Mockup bauen? Gesagt, getan…
Ohh, I love Agentic Engineering.
Prompt Engineering bleibt nützlich. Aber sobald Modelloutput echte Produktlogik trägt, brauch ich vor allem drei Dinge: Contracts, Evals und Telemetrie. Genau da fängt für mich AI Systems Engineering an. Und beim Entdecken von neuen Interaktionsmustern. Glück auf.
