
De meeste AI-demo’s stranden niet op het model. Ze stranden op het feit dat ze vrije tekst produceren - terwijl de applicatie eigenlijk contracten nodig heeft. Zodra een model niet meer alleen vriendelijk antwoordt in een chatvenster, maar productlogica in gang zet, zijn goede prompts alleen niet meer genoeg.
AI FullStack Engineering begint waar modeloutput een onderdeel van het systeem wordt - dus daar waar ik contract, evaluatie en observability nodig heb.
Repo: https://github.com/rubenvitt/plan-from-issue
Werkende webapp: https://plan-from-issue.pages.dev/
De voorbereiding: ons voorbeeld
Om het allemaal wat concreter te maken, begin ik met een voorbeeld: een mini-webapp die een GitHub-issue of willekeurige tickettekst (bijv. uit Jira of GitLab) omzet in een gestructureerd implementatieplan. Daarvoor gebruik ik eerst een doelstructuur, aan de hand waarvan ik een AI-FullStack-feature uitleg.
{
  "summary": "string",
  "affectedAreas": ["frontend", "backend", "database", "infra"],
  "risks": ["string"],
  "implementationSteps": ["string"],
  "testIdeas": ["string"],
  "requiresApproval": true
}
Op basis van dit voorbeeld is het eenvoudig om een webapp te laten bouwen die met behulp van dit doelbeeld verschillende implementatieplannen zinvol weergeeft - dat heeft in dit geval Claude Code voor me gedaan.
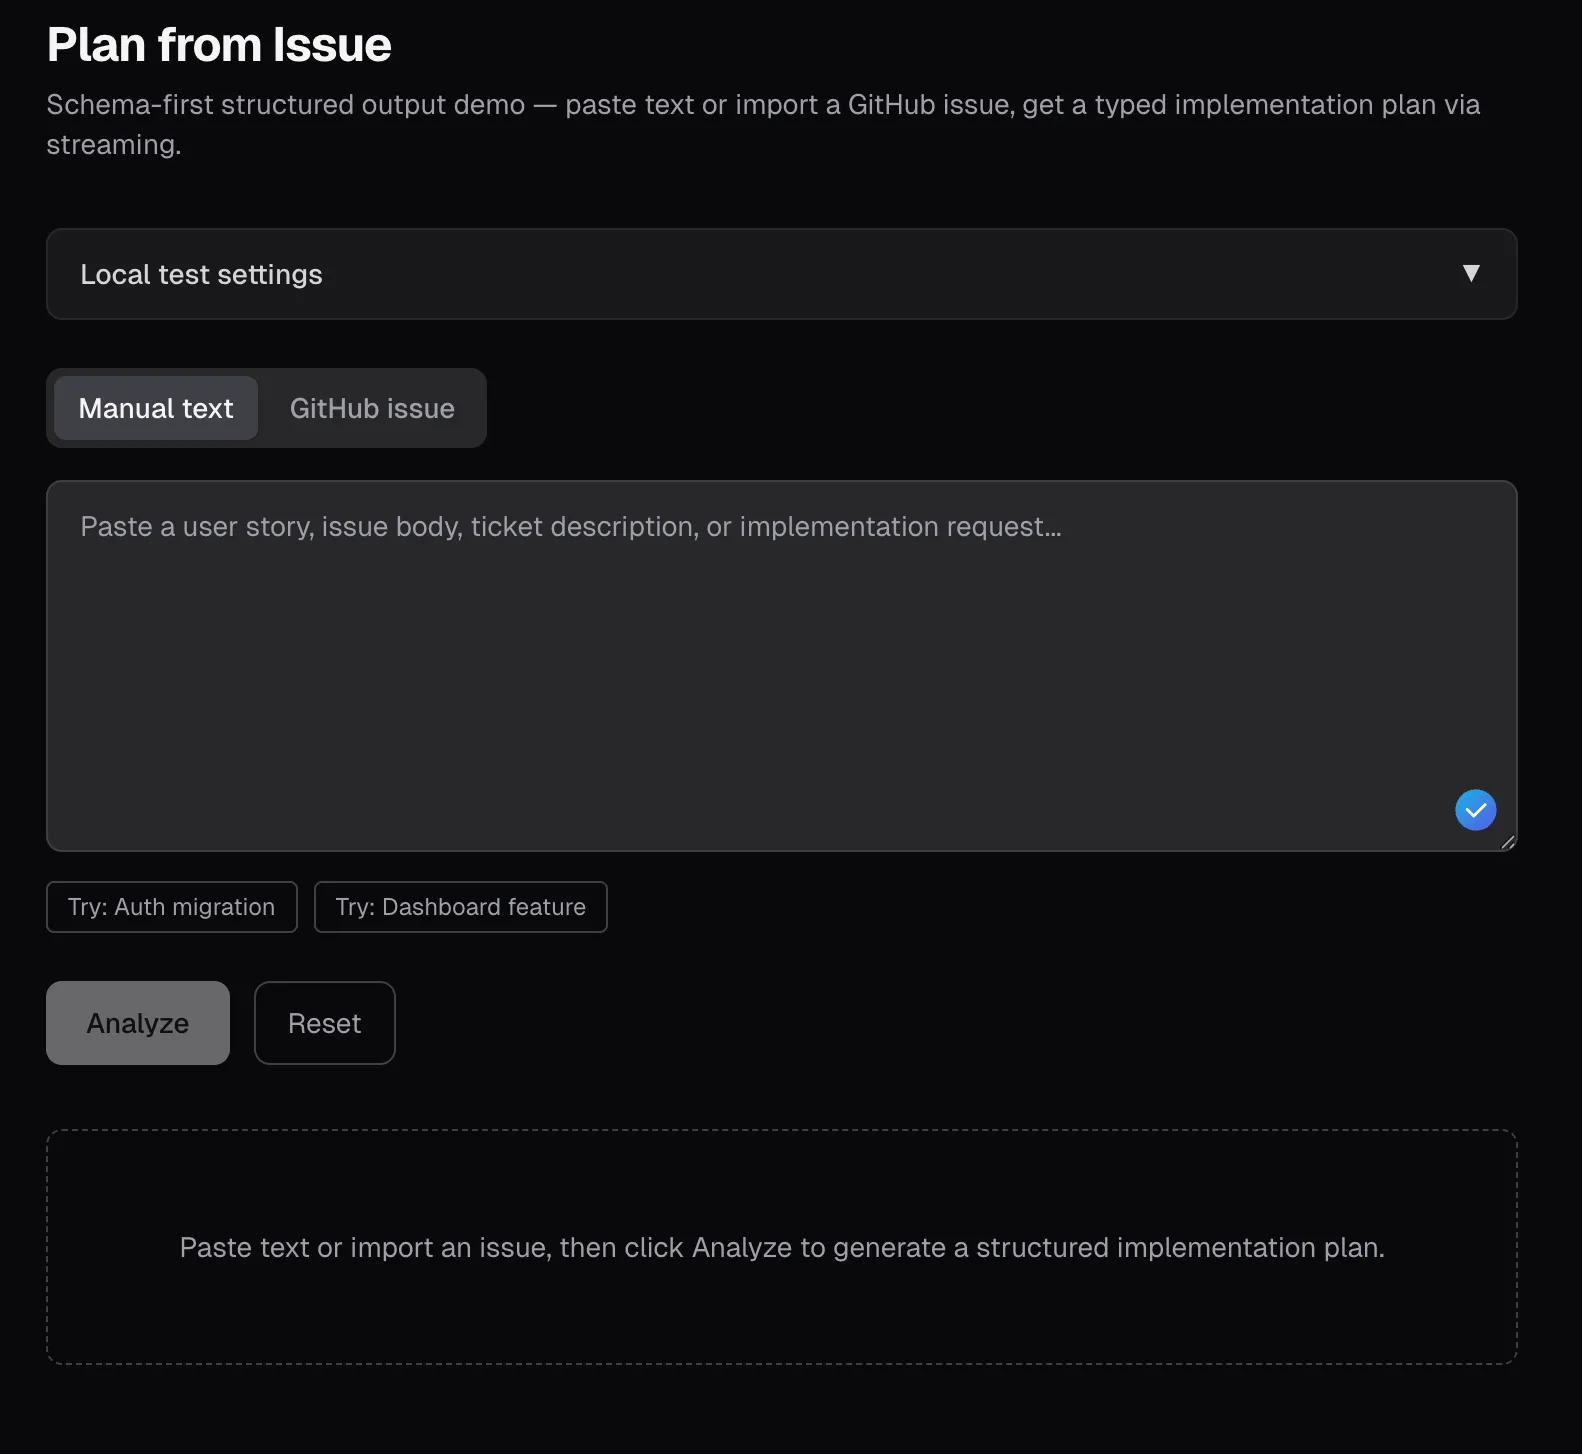
In de gebouwde webapp kan de gebruiker een issue in het tekstvak plakken of via GitHub ophalen - en het gestructureerd laten weergeven. Natuurlijk, dit is een heel eenvoudige en snel bedachte use case, maar de principes en concepten die ik uitleg gelden ook voor uitgebreidere UI’s - in dit geval zijn ze gewoon makkelijk te volgen.
Contract-first in plaats van prompt-first
Met het voorbeeld hierboven heb ik Claude gewoon alles laten bouwen - eigenlijk zijn we hier al klaar. De app werkt (na een door ChatGPT geschreven prompt).
Gegenereerde prompt voor het bouwen van de demo
You are a senior TypeScript engineer. Build a small but polished demo web app that showcases schema-first AI output using the Vercel AI SDK.
Do not ask follow-up questions. Make reasonable choices and implement the full app end-to-end. Do not leave placeholders or stubs. Keep the code compact, readable, and suitable for a public demo repo / blog post.
Goal
Build a mini web app that turns either:
- freeform story / ticket text
- a GitHub issue
into a structured implementation plan.
The point of the app is to demonstrate that the AI feature is contract-first, not chat-first.
Stack
Use:
- Next.js App Router
- TypeScript
- AI SDK
- AI SDK UI
- Zod
- @ai-sdk/openai
- minimal styling only (simple CSS or Tailwind is fine)
- no database
- no authentication system
- no server-side persistence
Non-negotiable AI SDK architecture
Use these exact patterns:
- shared Zod schema imported by both client and server
- streamText + Output.object(…) in the route handler
- experimental_useObject on the client
- createOpenAI(…) to instantiate the provider with a request-specific API key
- custom request headers from the client to the analyze route
- no plain-text fallback mode for the main analysis flow
- do not use useChat for the main experience
This app is object-generation first, not chat first.
Core JSON contract
The app must use this exact top-level JSON shape and these exact property names:
{ "summary": "string", "affectedAreas": ["frontend", "backend", "database", "infra"], "risks": ["string"], "implementationSteps": ["string"], "testIdeas": ["string"], "requiresApproval": true }Implement it as a shared Zod schema and export the inferred TypeScript type.
Schema requirements:
- summary: non-empty string
- affectedAreas: non-empty array of unique enum values, restricted to: frontend, backend, database, infra
- risks: array of strings
- implementationSteps: non-empty array of strings
- testIdeas: non-empty array of strings
- requiresApproval: boolean
Do not parse model text with regex. Do not accept “almost matching” output. The UI and server must rely on schema-validated structured output.
Maar laten we een paar stappen teruggaan. Normaal gesproken bouw ik niet iets alleen om het met AI te vullen. In plaats daarvan wil ik mijn gegevens laten verwerken en slim in de UI laten integreren. Daar zijn al talloze artikelen over op internet te vinden, en AI helpt me daar al prima bij.
Het kernpunt is echter: eerst komt het contract, dan de prompt. Ik moet weten welke gegevens ik gestructureerd moet extraheren, voordat ik aan het schrijven en perfectioneren van mijn prompt begin. Daarvoor moet ik engineeringwerk op een rij zetten dat ook in het pre-AI-tijdperk al bekend had moeten zijn.
- Welke velden wil ik uit de ongestructureerde gegevens halen?
- Welke velden zijn verplicht? Welke optioneel?
- Welke waardebereiken gelden voor getallen & strings? Zijn er enums?
- Waar moet ik de output begrenzen, zodat hij in de UI of pipeline bruikbaar blijft?
Afhankelijk van de gekozen programmeertaal helpen verschillende frameworks me daarbij. Denken we aan een van de modernere ontwikkelomgevingen (TypeScript), dan zou bijvoorbeeld ai-sdk in aanmerking komen. Maar ook voor Java is er iets: Spring AI, en andere programmeertalen hebben ongetwijfeld vergelijkbare tooling. Deze frameworks helpen de communicatie met verschillende model providers te uniformeren, zodat ik me niet direct aan leveranciers en hun API’s hoef te binden. In dit artikel concentreer ik me op TypeScript & ai-sdk.

Zulke frameworks hebben het grote voordeel dat ze de API’s van de afzonderlijke aanbieders uniformeren en typische functies eenvoudig en gelijkwaardig configureerbaar houden - bijvoorbeeld structured outputs, precies wat we nodig hebben.

Om dit contract op te stellen, is meestal een contract - vooral JSON Schema - nodig. JSON Schema’s beschrijven het contract voor JSON: welke velden zijn verplicht? Aan welke regex moeten die waarden voldoen? Getalbereiken enz. - om dit JSON Schema te maken of te valideren kunnen we tools gebruiken zoals https://json.ophir.dev/. Of AI vragen om een passend JSON Schema voor onze behoeften te maken.
Het belangrijkste deel van mijn AI-feature is niet de prompt, maar het contract dat de rest van de applicatie van het modelantwoord verwacht.
Met het gegenereerde of zelf gemaakte contract op zak kunnen we aan de slag met een passende prompt. Het antwoord zal dan óf aan het contract voldoen - óf aan een fout-contract dat we apart moeten afhandelen, bijv. refusal van OpenAI.

Evals in plaats van onderbuikgevoel
Wie een AI-feature bouwt zonder evals, test op de gebruiker.
Zoals hierboven beschreven heeft Claude in één shot meteen een werkende webapp voor me gebouwd. Als ik bijvoorbeeld het issue https://github.com/rubenvitt/bluelight-hub/issues/420 invoer, krijg ik gestructureerde output:
{
  "summary": "Implement a Verpflegungsmanagement feature under the Betreuung area to manage feeding locations, meal planning, and distribution tracking for Einsatzkräfte and Betroffene. The change includes frontend views on the specified route and backend CRUD plus integrations for planning quantities and recording consumption.",
  "affectedAreas": [
    "frontend",
    "backend"
  ],
  "risks": [
    "Integration dependencies on Kräfte-, Betroffene-, Logistik-Modul, and Lagekarte may block parts of the feature or require fallback handling.",
    "Quantity estimation can become inconsistent if personnel and affected-person counts are unavailable, delayed, or separated differently than expected.",
    "Tracking meal status and portion counts across multiple Ausgabestellen introduces risk of incorrect state transitions or double counting.",
    "Capturing Sonderbedürfnisse must stay usable in the UI while still being detailed enough for planning."
  ],
  "implementationSteps": [
    "Add backend CRUD support for Verpflegungsstellen with fields for name, location, type, capacity, opening/output times, and responsible personnel.",
    "Add backend CRUD support for Mahlzeiten including time, type, estimated quantity, assigned Ausgabe-/Verpflegungsstelle, separated counts for Einsatzkräfte and Betroffene, Sonderbedürfnisse, and status values Geplant, In Zubereitung, Ausgabe, Abgeschlossen.",
    "Implement backend logic for quantity estimation based on the provided formula using counts from Kräfte and Betroffene where available.",
    "Add backend endpoints or service integration for recording consumption data per Mahlzeit and Ausgabe-/Verpflegungsstelle: issued portions, beverage consumption, remaining quantities, and material consumption for Logistik handoff.",
    "Build the frontend page at /app/einsatz/$einsatzId/betreuung/verpflegung with management views for Verpflegungsstellen and Mahlzeiten.",
    "Implement Verpflegungsstellen cards showing key details and current status, with create/edit/delete flows.",
    "Implement a Mahlzeiten timeline that separates planned, current, and past meals and supports status updates through the defined lifecycle.",
    "Add meal planning UI for time, type, quantity estimate, separated person counts, special needs, and assigned distribution point.",
    "Implement quick-entry controls for portion output using +/- counters and forms for beverage usage and remaining quantities.",
    "Add a dashboard view showing supply coverage as x% versorgt based on planned vs. served data.",
    "Integrate map marking of Verpflegungsstellen on the Lagekarte from the route workflow.",
    "Connect quantity planning to personnel counts from Kräfte and affected-person counts from Betroffene, and send recorded material consumption to Logistik for replenishment workflows."
  ],
  "testIdeas": [
    "Create, update, list, and delete Verpflegungsstellen with all required fields and verify they appear correctly in the management UI.",
    "Plan a Mahlzeit with separated counts for Einsatzkräfte and Betroffene and verify the estimated quantity follows the specified calculation.",
    "Verify meal status transitions from Geplant to In Zubereitung to Ausgabe to Abgeschlossen are reflected correctly in the timeline and detail views.",
    "Record portion output for a meal at a specific Verpflegungsstelle with +/- quick entry and confirm totals persist correctly.",
    "Record beverage consumption, remaining quantities, and material consumption and verify the data is stored and associated with the correct meal and location.",
    "Enter Sonderbedürfnisse such as allergies, vegetarian, halal, and confirm they are retained and visible in planning views.",
    "Verify Verpflegungsstellen are shown on the Lagekarte with the configured location.",
    "Test integration behavior when Kräfte or Betroffene counts are available versus unavailable, ensuring quantity estimation degrades predictably.",
    "Verify the dashboard coverage percentage updates as portions are issued.",
    "Confirm material consumption data is handed off correctly to the Logistik integration path."
  ],
  "requiresApproval": false
}
40 regels resultaat. LGTM. Done.
Of… niet?
De vraag is niet of het antwoord “slim” klinkt, maar of het betrouwbaar genoeg is voor mijn workflow.
Hoe weet ik dat het resultaat een goed resultaat is? Hoe weet ik dat ik erop kan vertrouwen? Het contract geeft me een structurele garantie. Of de inhoud vakinhoudelijk deugt, is daarmee nog niet beantwoord. Daarom moeten vooral de inhoudelijke vragen beantwoord worden: zijn de betrokken gebieden zinnig herkend? Zijn de risico’s bruikbaar? Kan ik echt iets met de testideeën - of is het overbodige onzin? Is de approval-flag plausibel? Eén manier om deze vragen volledig te beantwoorden is door elk afzonderlijk antwoord heen te gaan - en die vragen voor mezelf beantwoorden en beoordelen. Daarna kan ik de prompt aanpassen en opnieuw beoordelen. Maar mijn eerlijke mening daarover? Dat wil ik niet, nee! Ik heb er geen zin in.
En ja, er is een alternatief. Zelfs meerdere. OpenAI heeft een eigen optimizer, maar er zijn ook talloze open-source tools. Een voorbeeld daarvan is https://github.com/promptfoo/promptfoo.
Om het eenvoudig te laten zien, heb ik hier voor het OpenAI Platform gekozen. Daar is een evaluatie snel gedaan: prompt aanmaken (belangrijk: met variabele!), op het tabblad Evaluation een nieuwe dataset aanmaken en dan testdata invoegen. Ik pak gewoon een paar van mijn issues uit het bluelight-hub-project - daarna op play klikken, en de prompt wordt op de lijst met inputs uitgevoerd (let op: kost geld).
OpenAI helpt ons hier al flink: bijna alles kan daar direct automatisch worden herschreven, ook ons JSON Schema kan gegenereerd worden. Ik heb gewoon het zod-schema uit het voorbeeldproject erin geplakt - en het bijpassende JSON Schema werd gegenereerd…. perfect.
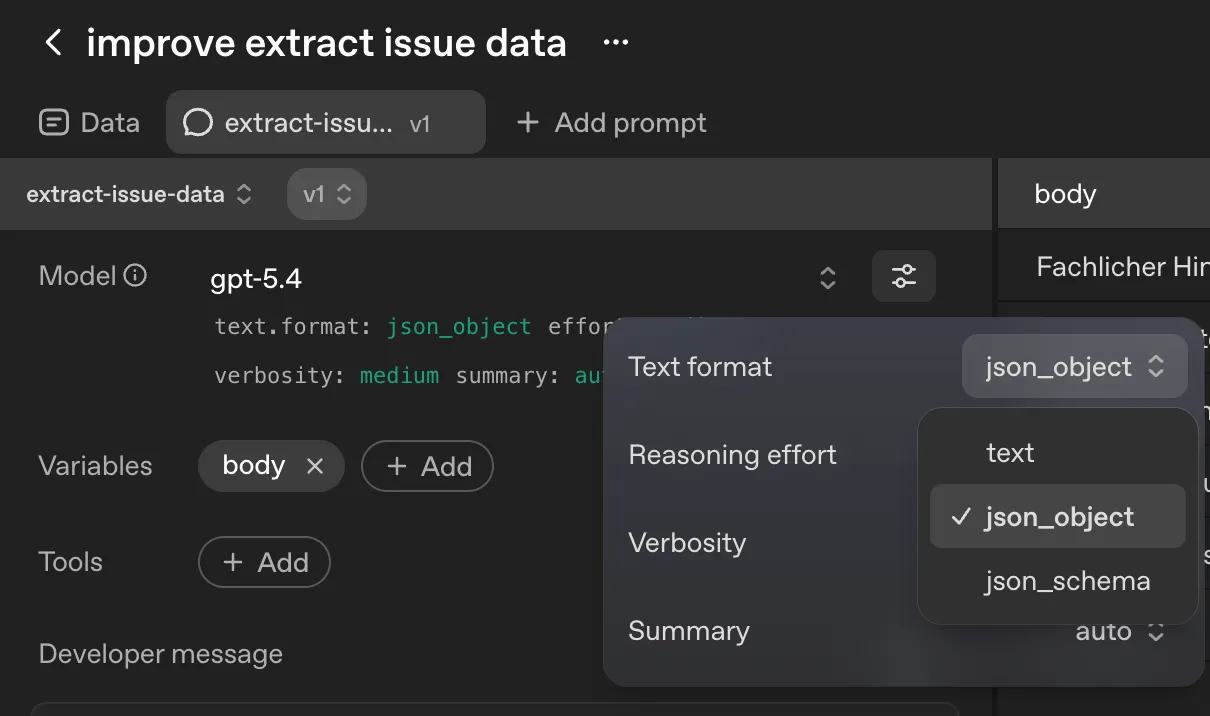
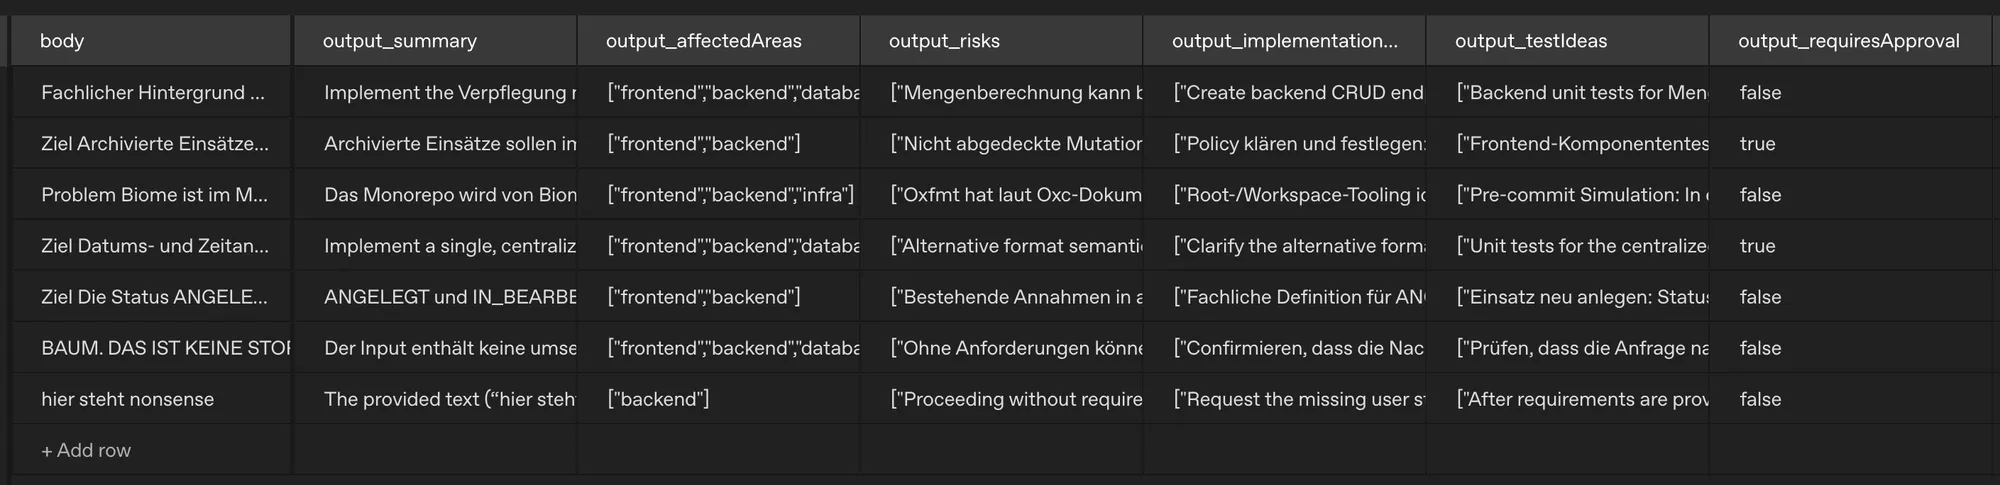
Het voordeel daarvan? We hebben nu meerdere kolommen in onze eval-weergave en kunnen de afzonderlijk geproduceerde waarden direct aflezen en bekijken hoe we ermee willen omgaan.
Nu kunnen we aan de eigenlijke evaluatie beginnen: nieuwe columns aanmaken voor handmatige beoordeling (annotation) - of we laten de AI de afzonderlijke antwoorden beoordelen (grader), controleren en scoren; volgens onze criteria.
Na een eerste evaluatie op twee criteria wordt duidelijk: onze prompt heeft wat nawerk nodig. Wat te doen? In deze tool volstaat een klik op Optimize - en OpenAI regelt de rest - op basis van de beoordeling uit de prompt-evaluatie.
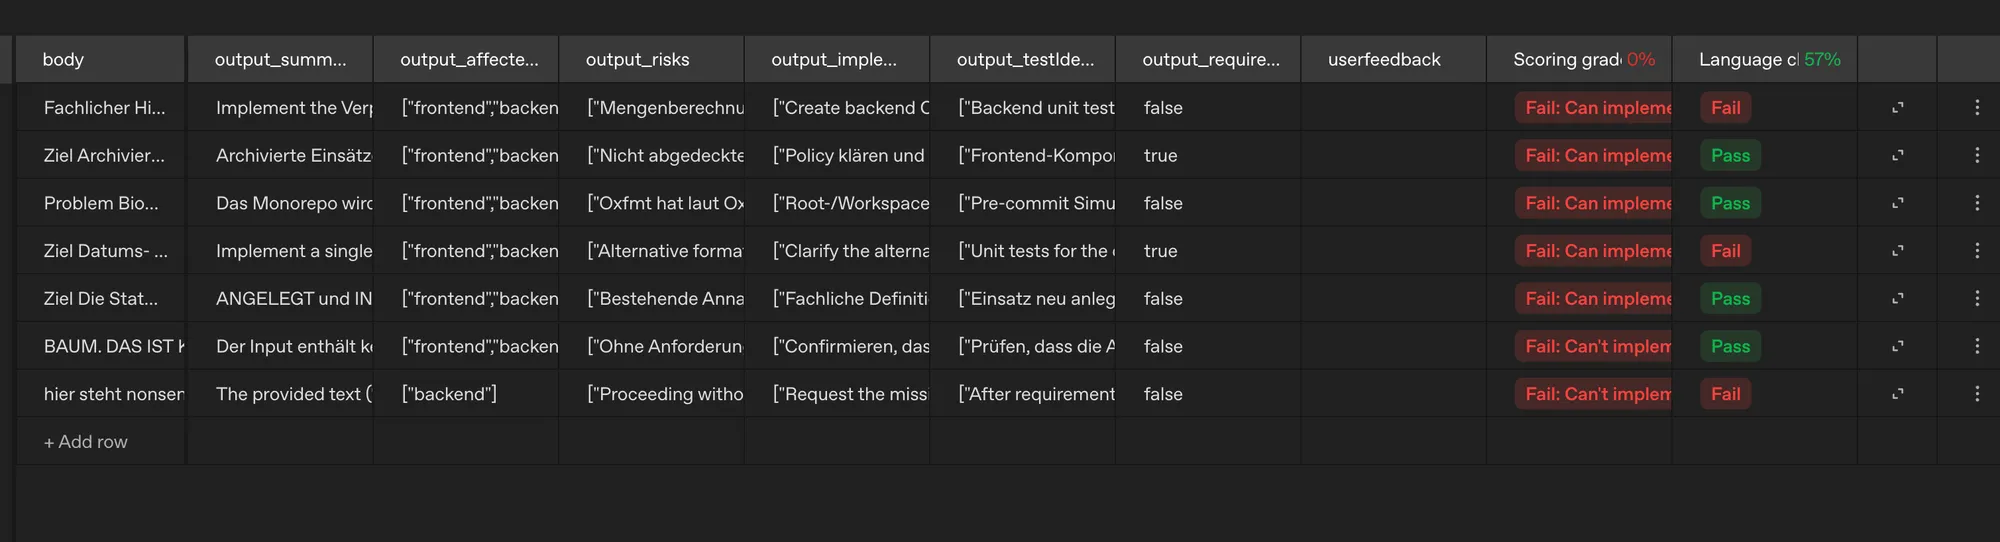
Na wat verdere optimalisatie en een handmatige aanpassing (via prompt) is het resultaat dan een stukje beter geworden. Natuurlijk, dit is een heel kleine set om te evalueren - het gaat me hier meer om het principe; handmatige feedback heb ik hier ook gewoon weggelaten, ook al hoort die er normaal gesproken bij om uiteindelijk zinnige resultaten te krijgen.
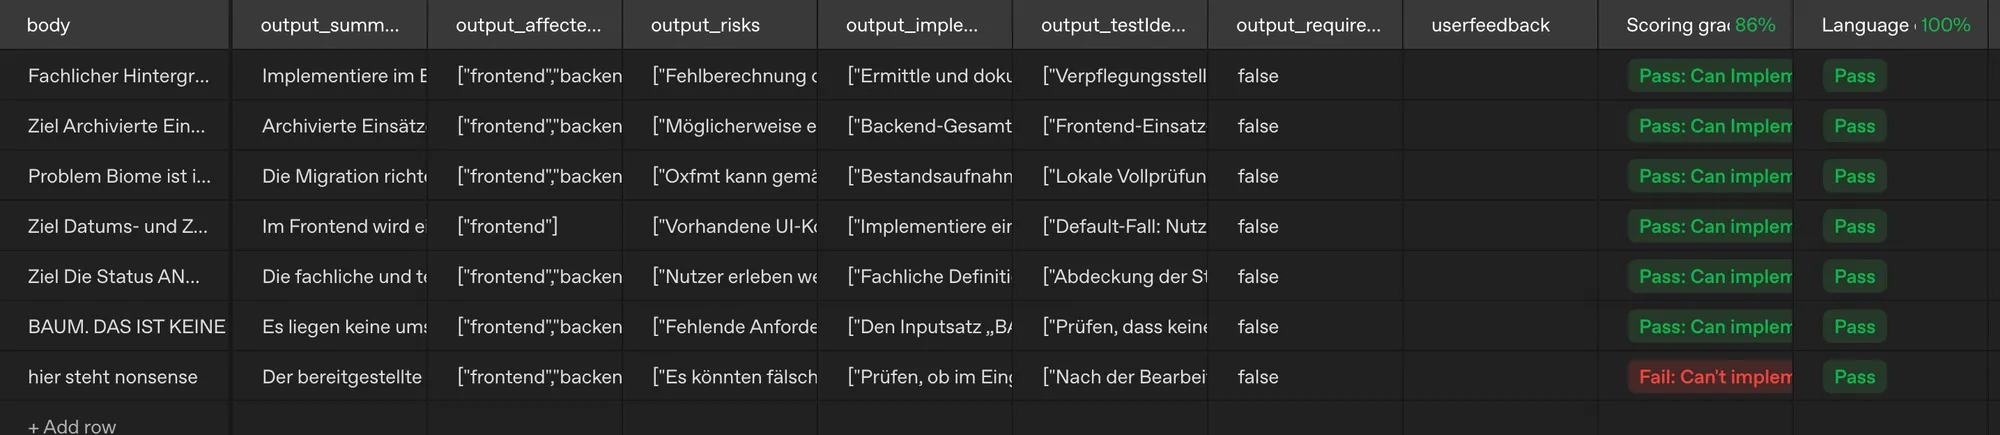
Met dat mooie resultaat ga ik direct naar Claude en vraag om de prompt te vervangen door de nieuwe.
Daarmee hebben we nu een verbeterde prompt die onze eisen beter afdekt. Met de structured output bouwen we UI in plaats van alleen tekstoutput. Tot zover dit kijkje in de keuken. Er valt nog zoveel meer te ontdekken, te optimaliseren en te verfijnen.
Het grondprincipe van de eval zou wel duidelijk moeten zijn: doelen definiëren, een dataset verzamelen uit voorbeelden, eventueel met verwachte resultaten, metrics vastleggen, runs vergelijken, laten evalueren.
Observability in plaats van een black box
Als we niet-deterministische systemen in onze applicaties inbouwen, is het des te belangrijker om te begrijpen wat er gebeurd is als er iets kapotgaat, zodat we een manier vinden om precies dat te mitigeren. Daar horen een paar belangrijke datapunten bij die we het liefst willen verzamelen:
- welk model is gebruikt?
- hoe lang had het LLM nodig voor een antwoord?
- was de teruggegeven JSON geldig volgens het contract?
- waren retries nodig?
- eventueel: welke tools zijn gebruikt?
- waar moesten mensen ingrijpen?
- hoeveel tokens zijn er gebruikt en hoe hoog waren de bijbehorende kosten?
OpenTelemetry heeft inmiddels conventies voor GenAI-applicaties voor events, metrics & spans. Dat betekent dat ook de AI-functies in de observability kunnen worden opgenomen. In de eerder genoemde AI SDK bestaat ook een connector om via het framework automatisch de bijbehorende data vast te leggen en te versturen.

Het FullStack-deel is de UI, niet alleen het model
Het wordt pas echt FullStack als ik niet alleen een model aanspreek, maar een bedieningsflow voor mensen ontwerp.
Nu we een fatsoenlijk contract met het LLM hebben afgesproken, dat we via de API communiceren, en een echt sterke prompt hebben gebouwd, wat ontbreekt er nog? Juist, de UI. Aan het begin van de post liet ik het al doorschemeren: een beetje tekst tonen, dat kan iedereen. Ook na de one-shot-poging met Claude was het weliswaar geen chatinterface, maar toch nog steeds een aaneenschakeling van teksten. We begeven ons nu weliswaar op wat droog terrein - een implementatieplan voor stories - maar voor de weergave krijgen we vast iets moois voor elkaar, toch?
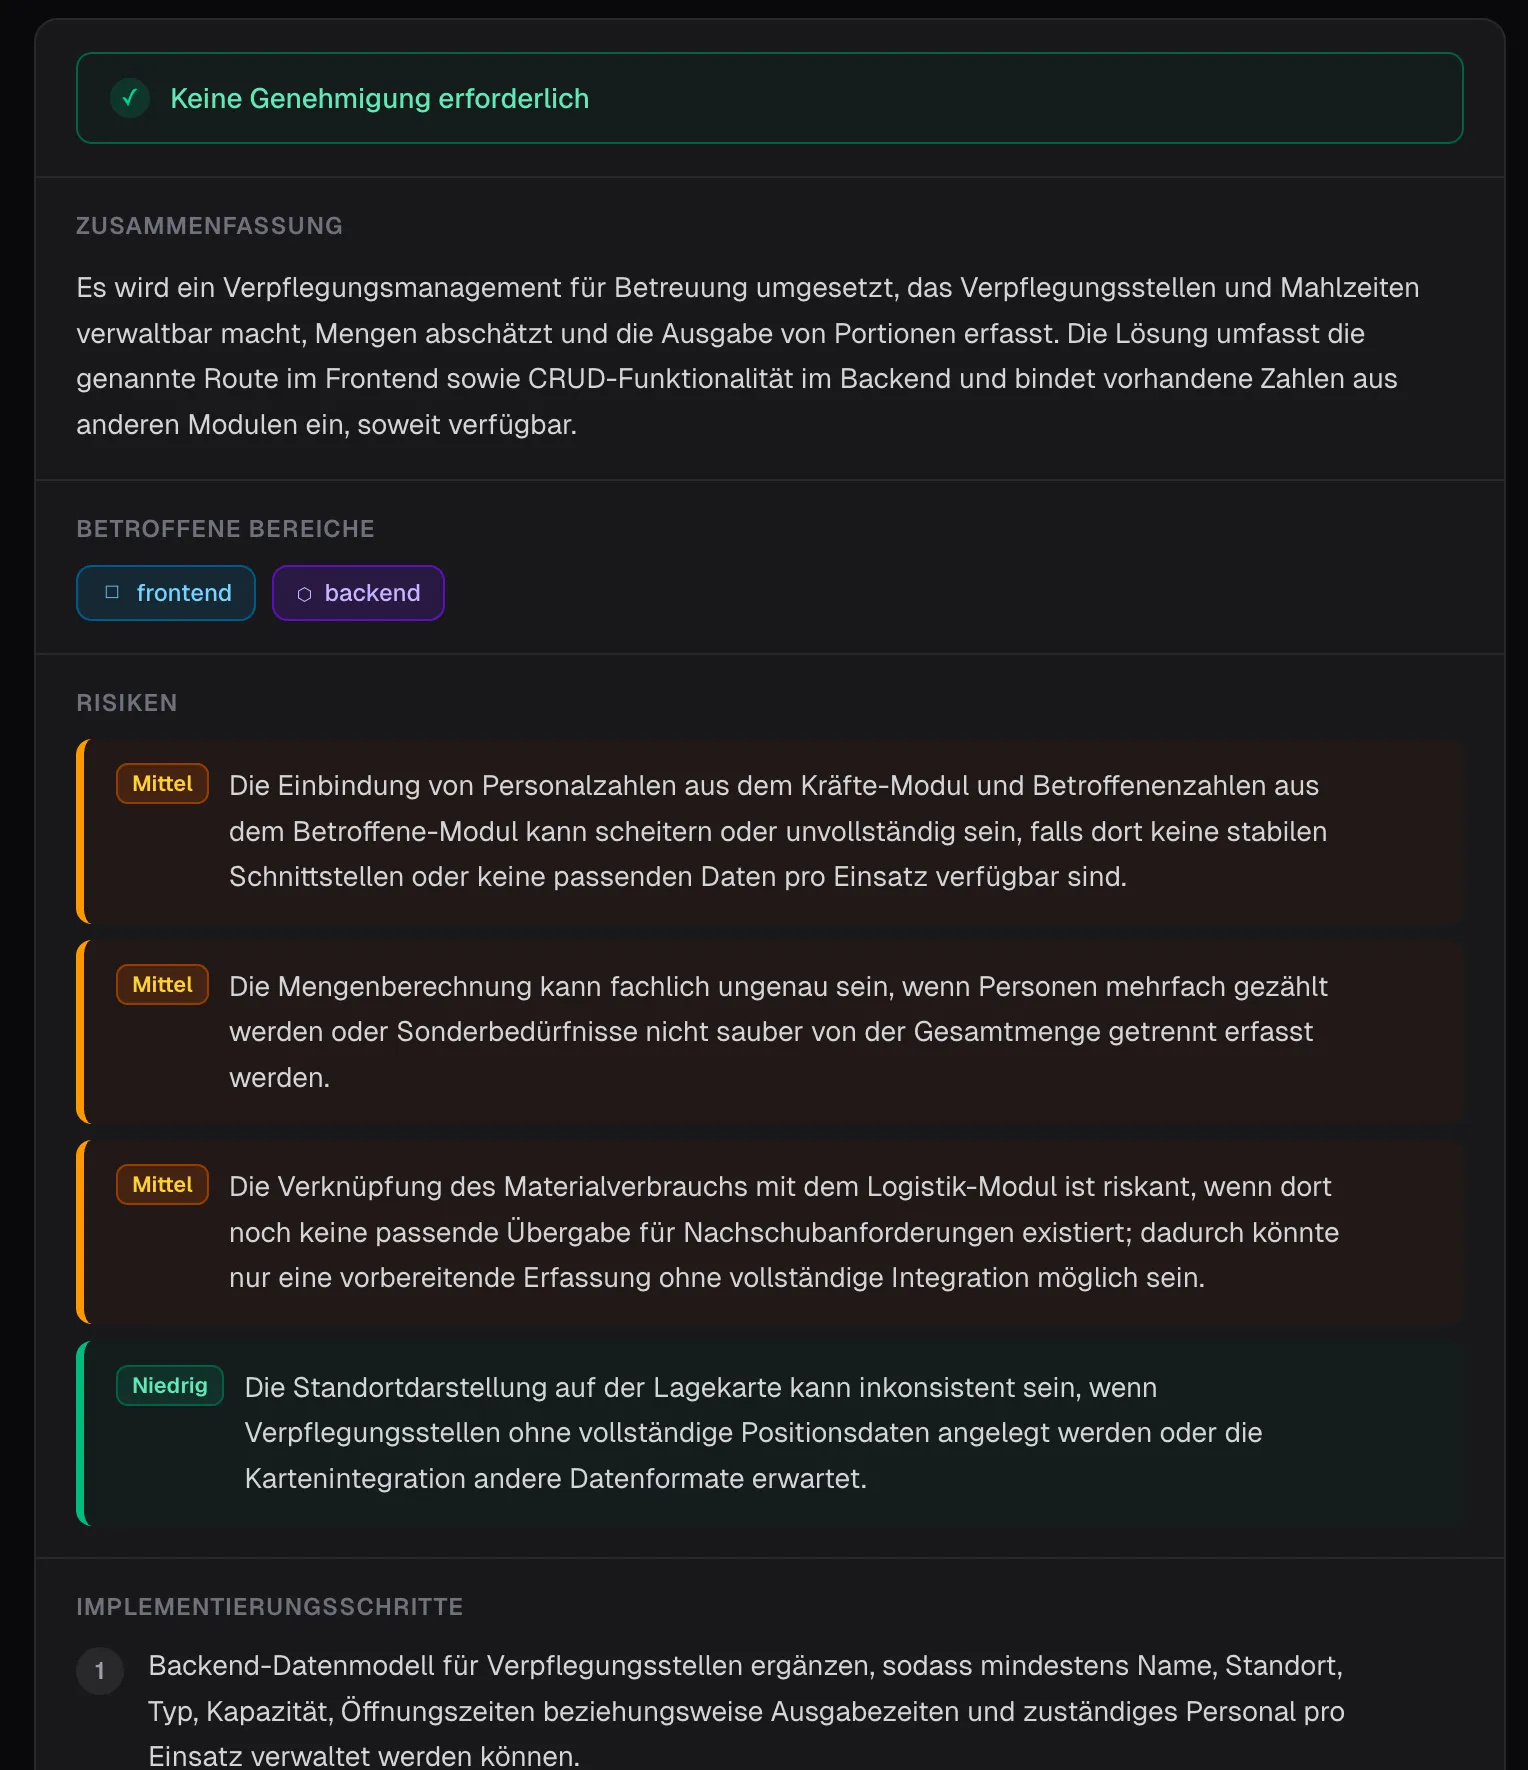
Als eerste stap wilde ik dat de gegevens gewoon wat mooier werden weergegeven. Prima tot nu toe, maar wat dacht je dan van een implementatie-canvas?
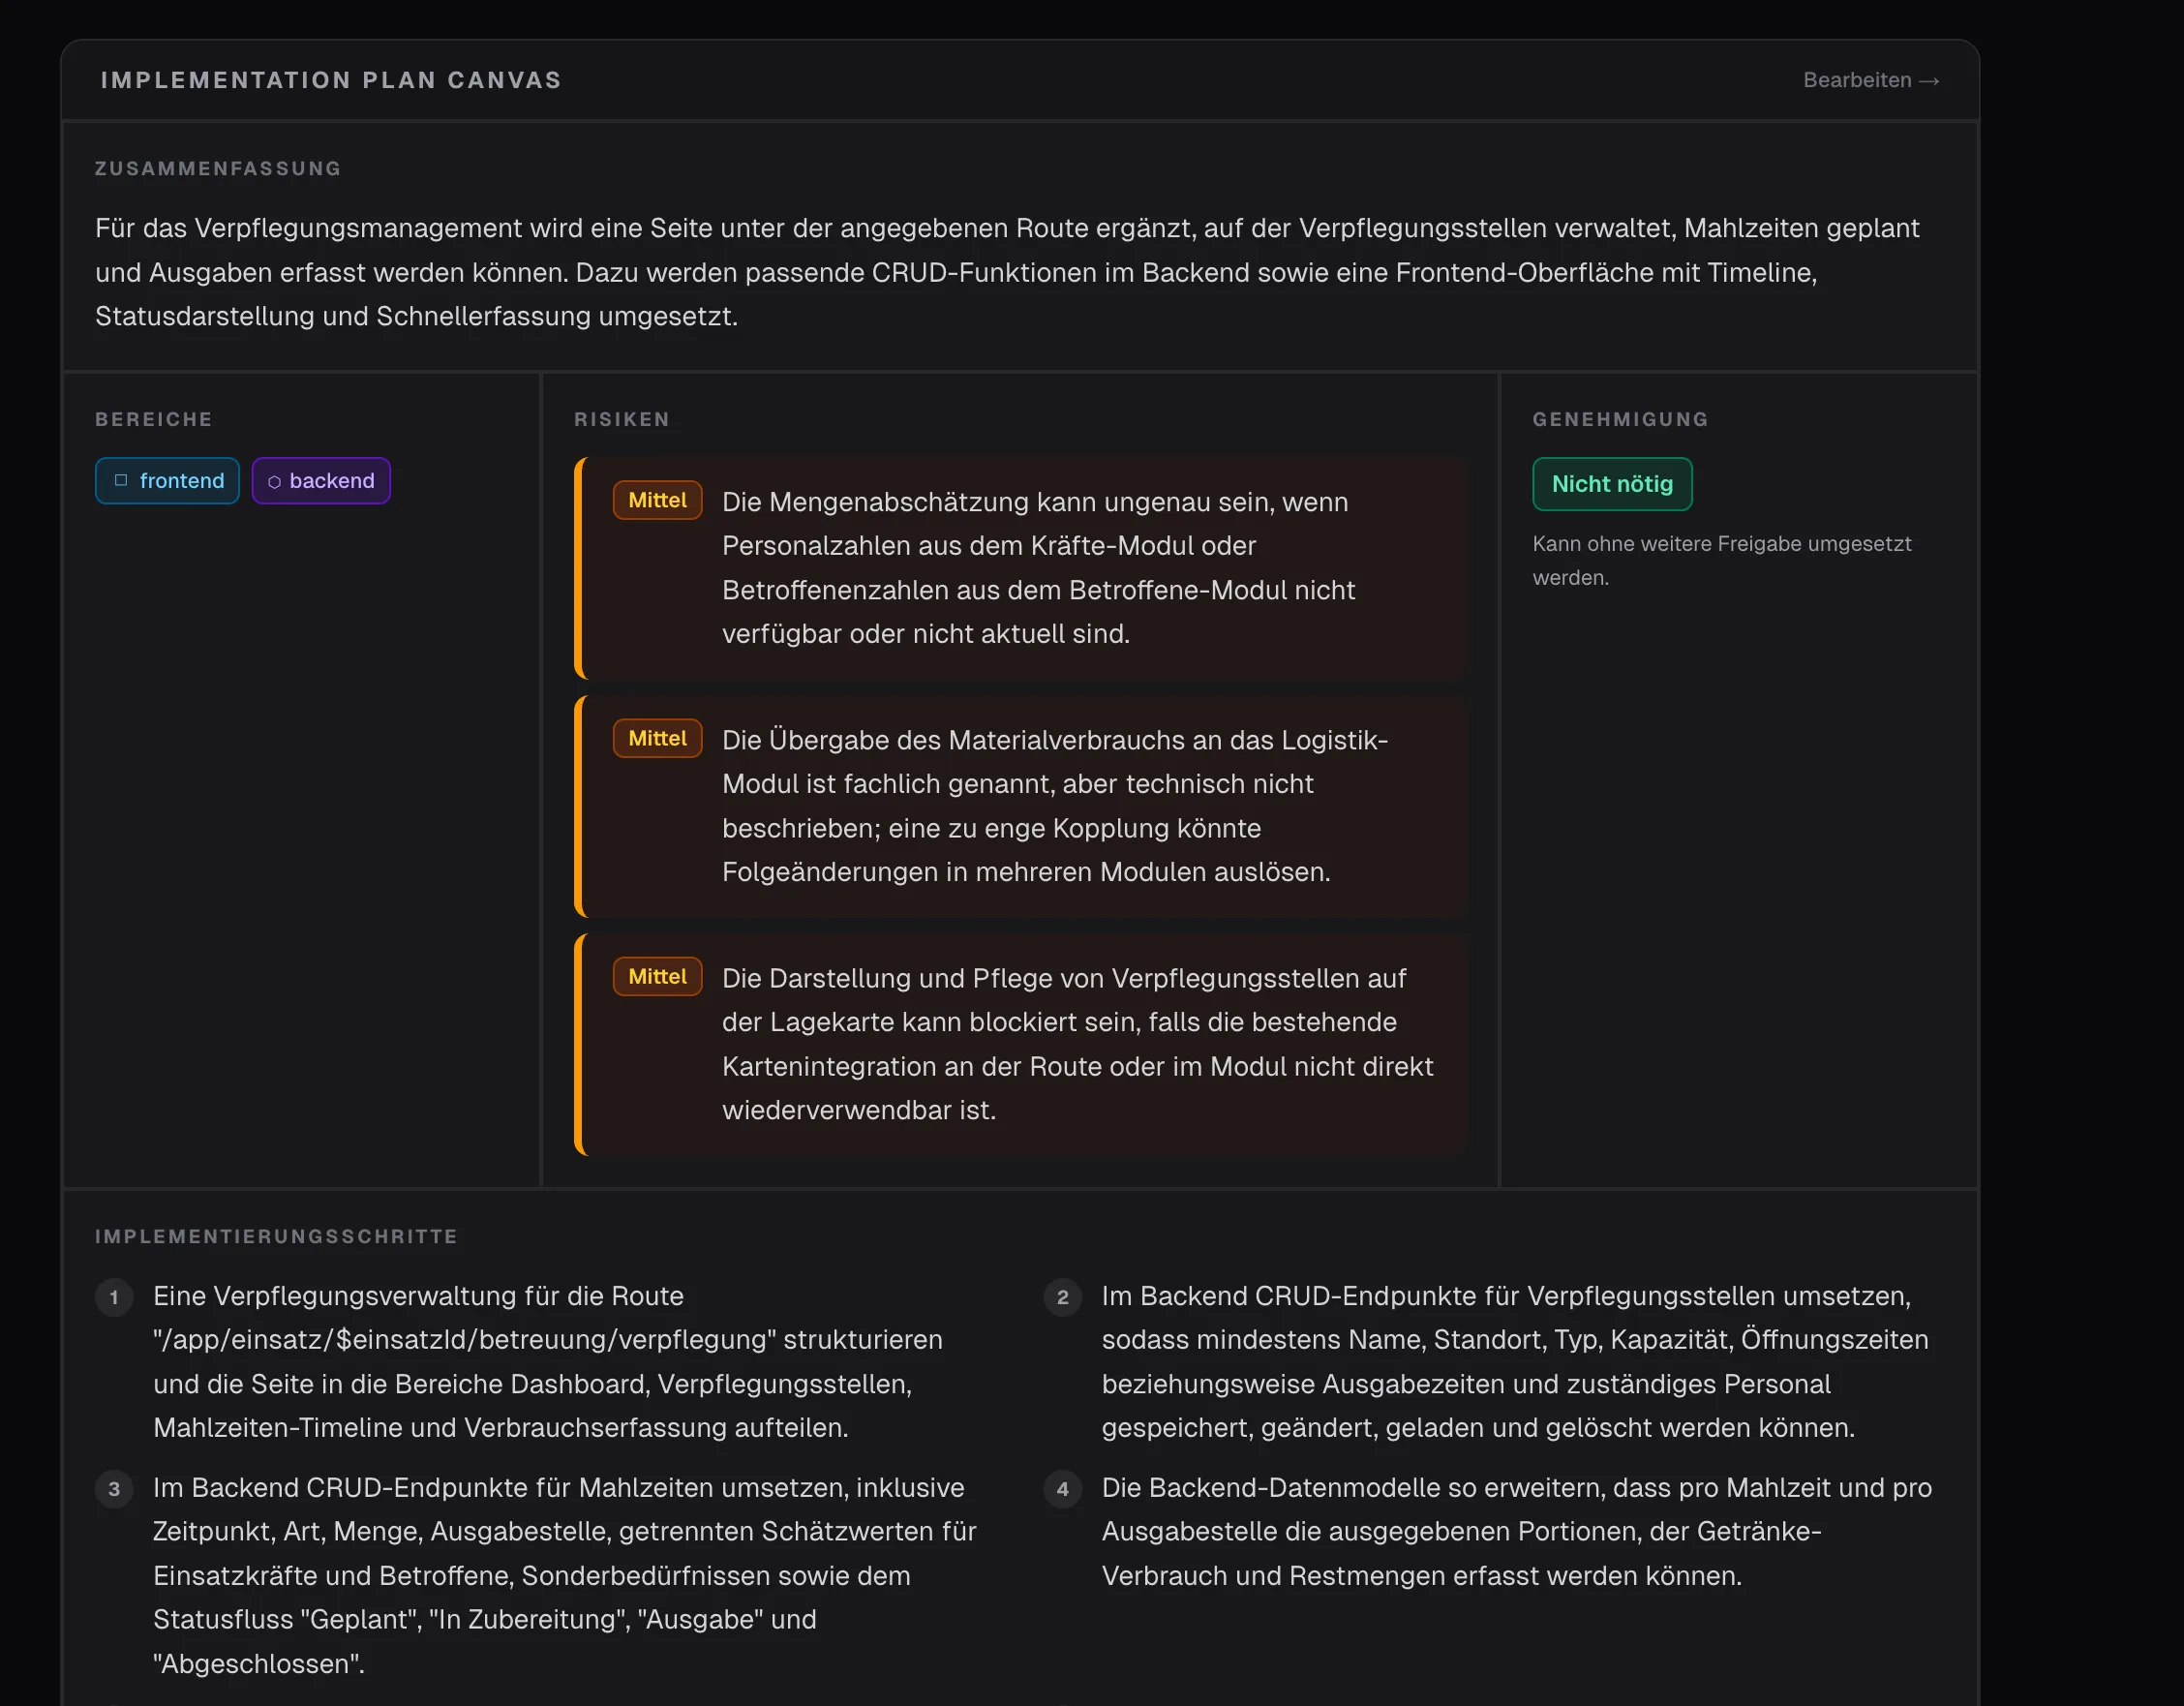
Nog een manier van weergeven - met de optie om de inhoud te bewerken - maar hoe kunnen we echte meerwaarde creëren? Als de taak frontendwerk bevat… zouden we dan niet meteen een mockup moeten genereren? Zo gezegd, zo gedaan…
Ohh, I love Agentic Engineering.
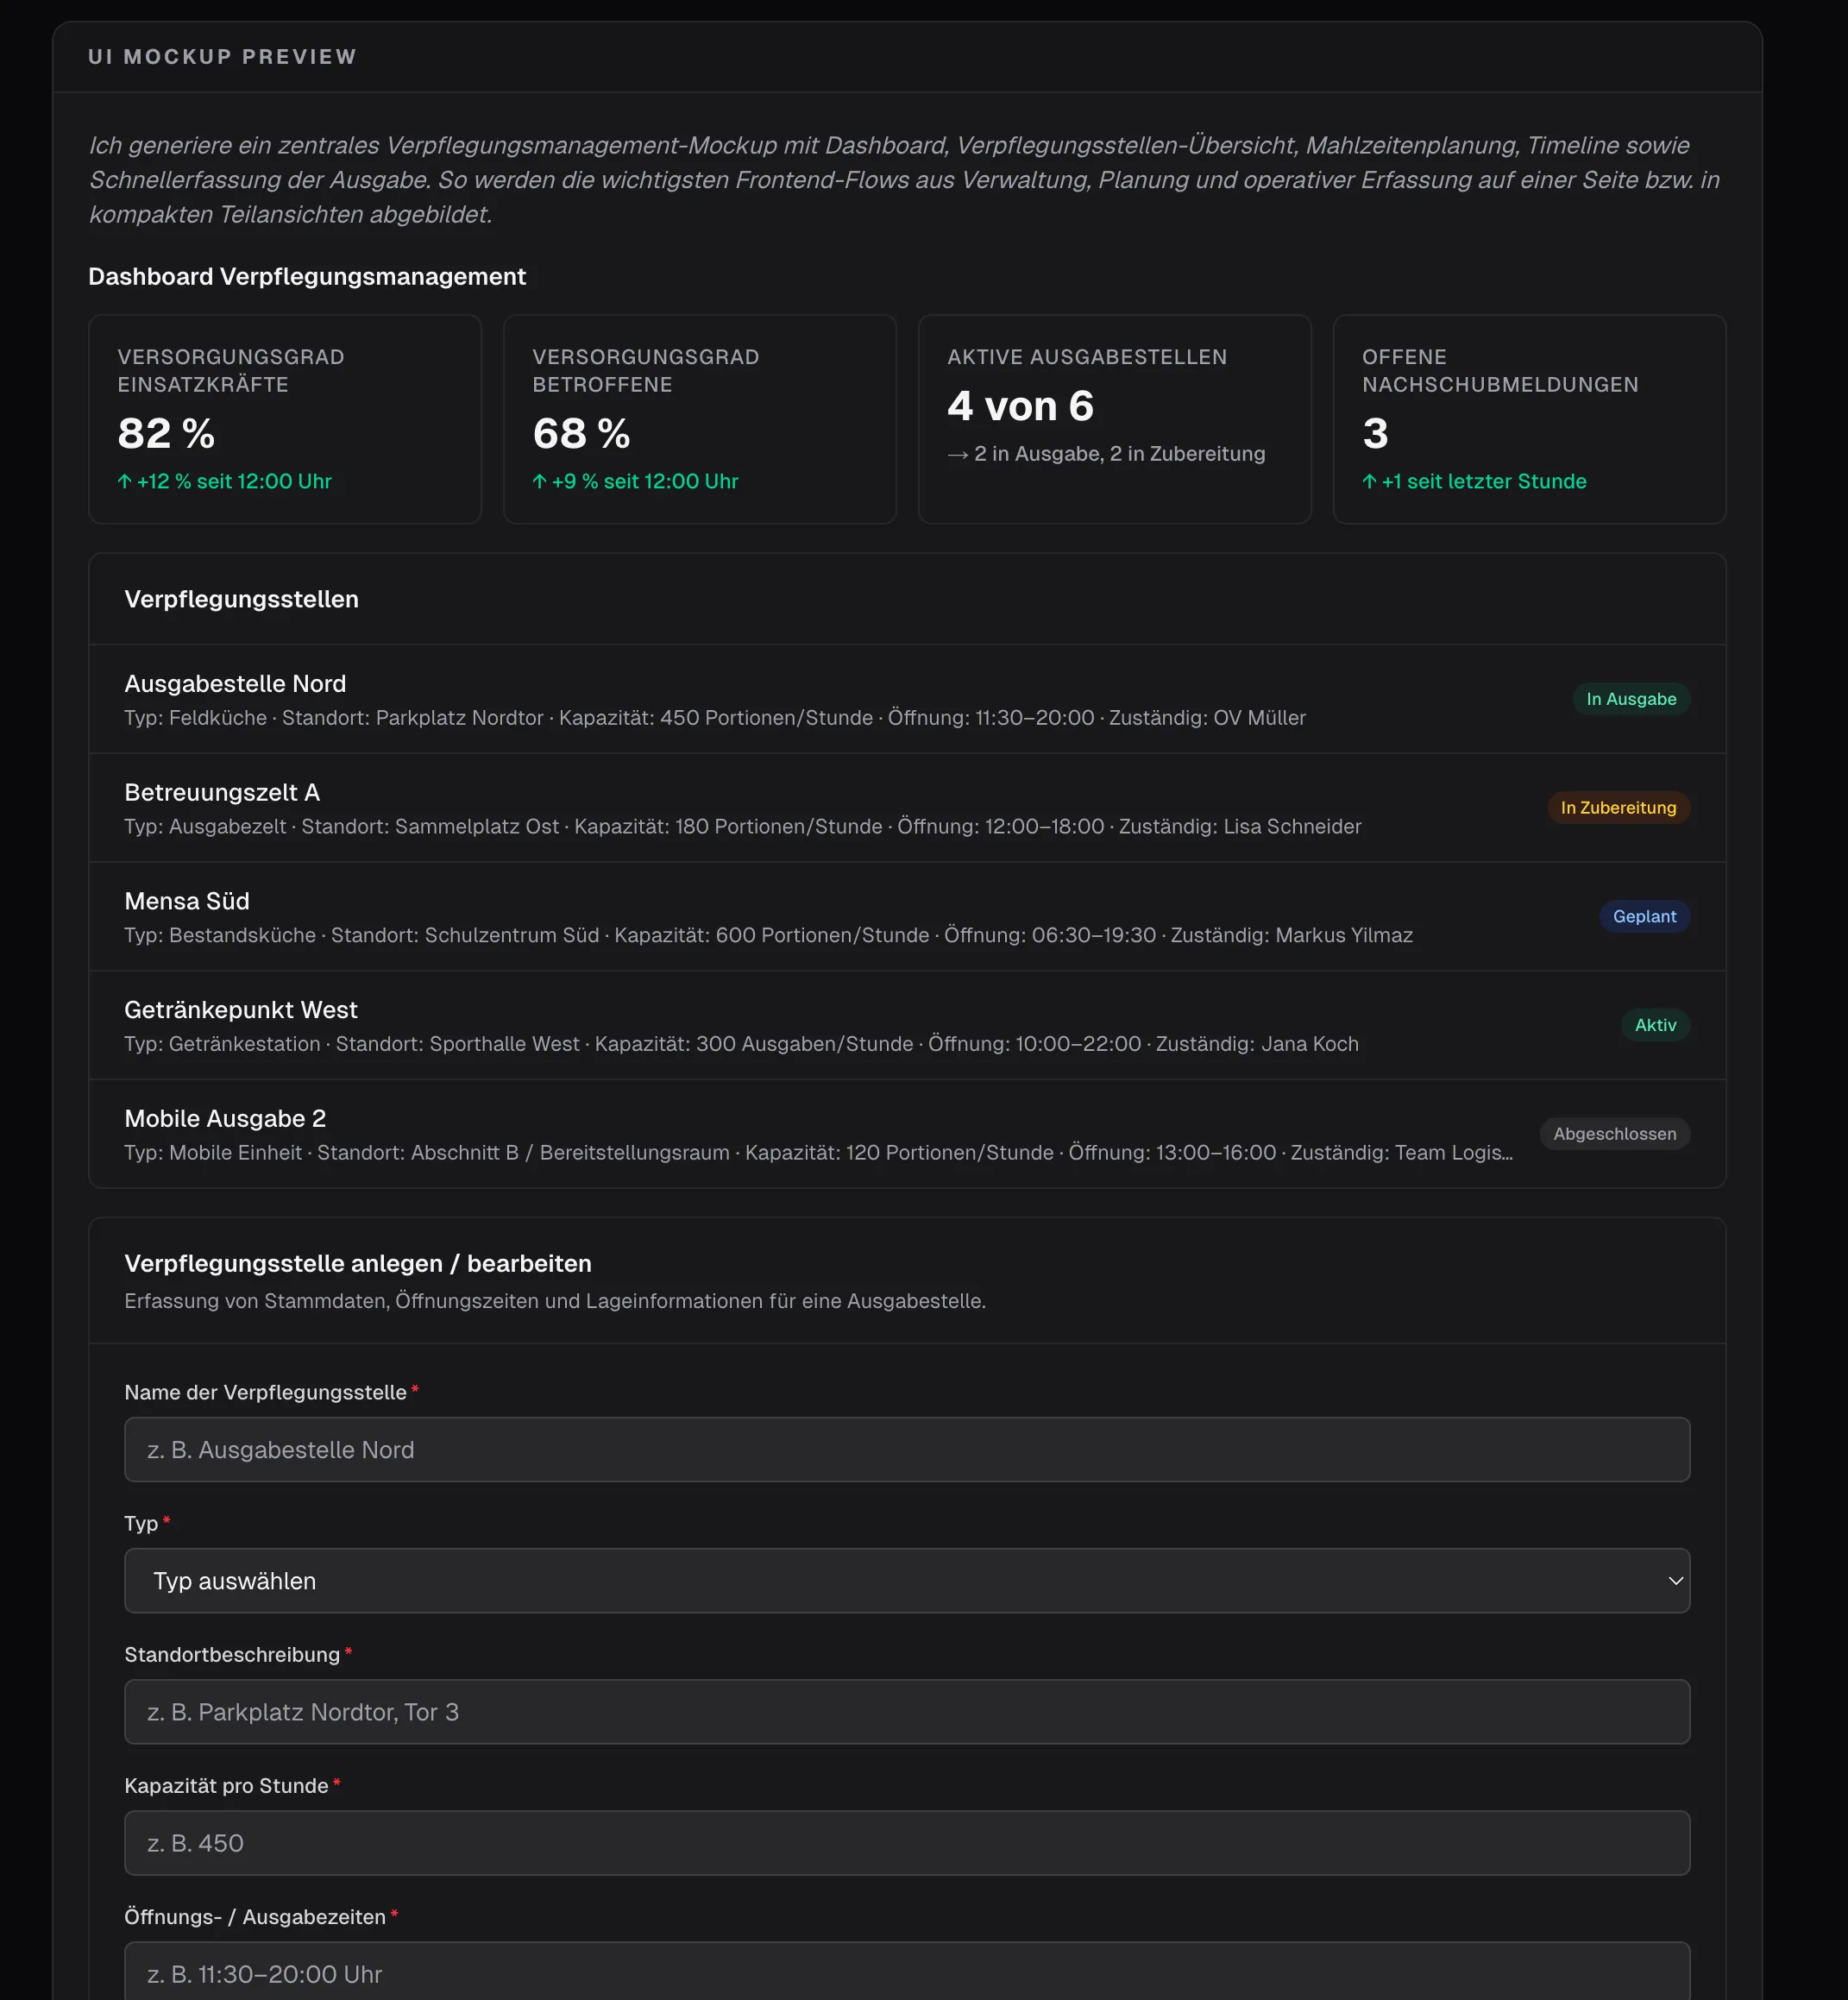
Prompt engineering blijft nuttig. Maar zodra modeloutput echte productlogica draagt, heb ik vooral drie dingen nodig: contracts, evals en telemetrie. Precies daar begint voor mij AI Systems Engineering. En bij het ontdekken van nieuwe interactiepatronen.
