
De fleste AI-demoer feiler ikke på grunn av modellen. De feiler fordi de produserer fritekst - selv om applikasjonen egentlig trenger kontrakter. Så snart en modell ikke lenger bare svarer pent i et chatvindu, men utløser produktlogikk, holder det ikke lenger med gode prompts alene.
AI FullStack Engineering begynner der modelloutput blir en del av systemet - altså der jeg trenger contract, evaluering og observability.
Repo: https://github.com/rubenvitt/plan-from-issue
Ferdig webapp: https://plan-from-issue.pages.dev/
Forberedelsen: eksemplet vårt
For å gjøre alt dette litt mer konkret vil jeg begynne med et eksempel: en mini-webapp som gjør et GitHub-issue eller en hvilken som helst ticket-tekst (f.eks. fra Jira, GitLab) om til en strukturert implementeringsplan. Utgangspunktet er en målstruktur som jeg bruker til å forklare en AI-FullStack-feature.
{
  "summary": "string",
  "affectedAreas": ["frontend", "backend", "database", "infra"],
  "risks": ["string"],
  "implementationSteps": ["string"],
  "testIdeas": ["string"],
  "requiresApproval": true
}
Med dette eksemplet som utgangspunkt er det lett å få laget en webapp som bruker dette målbildet til å vise ulike implementeringsplaner på en fornuftig måte - det tok Claude Code seg av for meg i dette tilfellet.
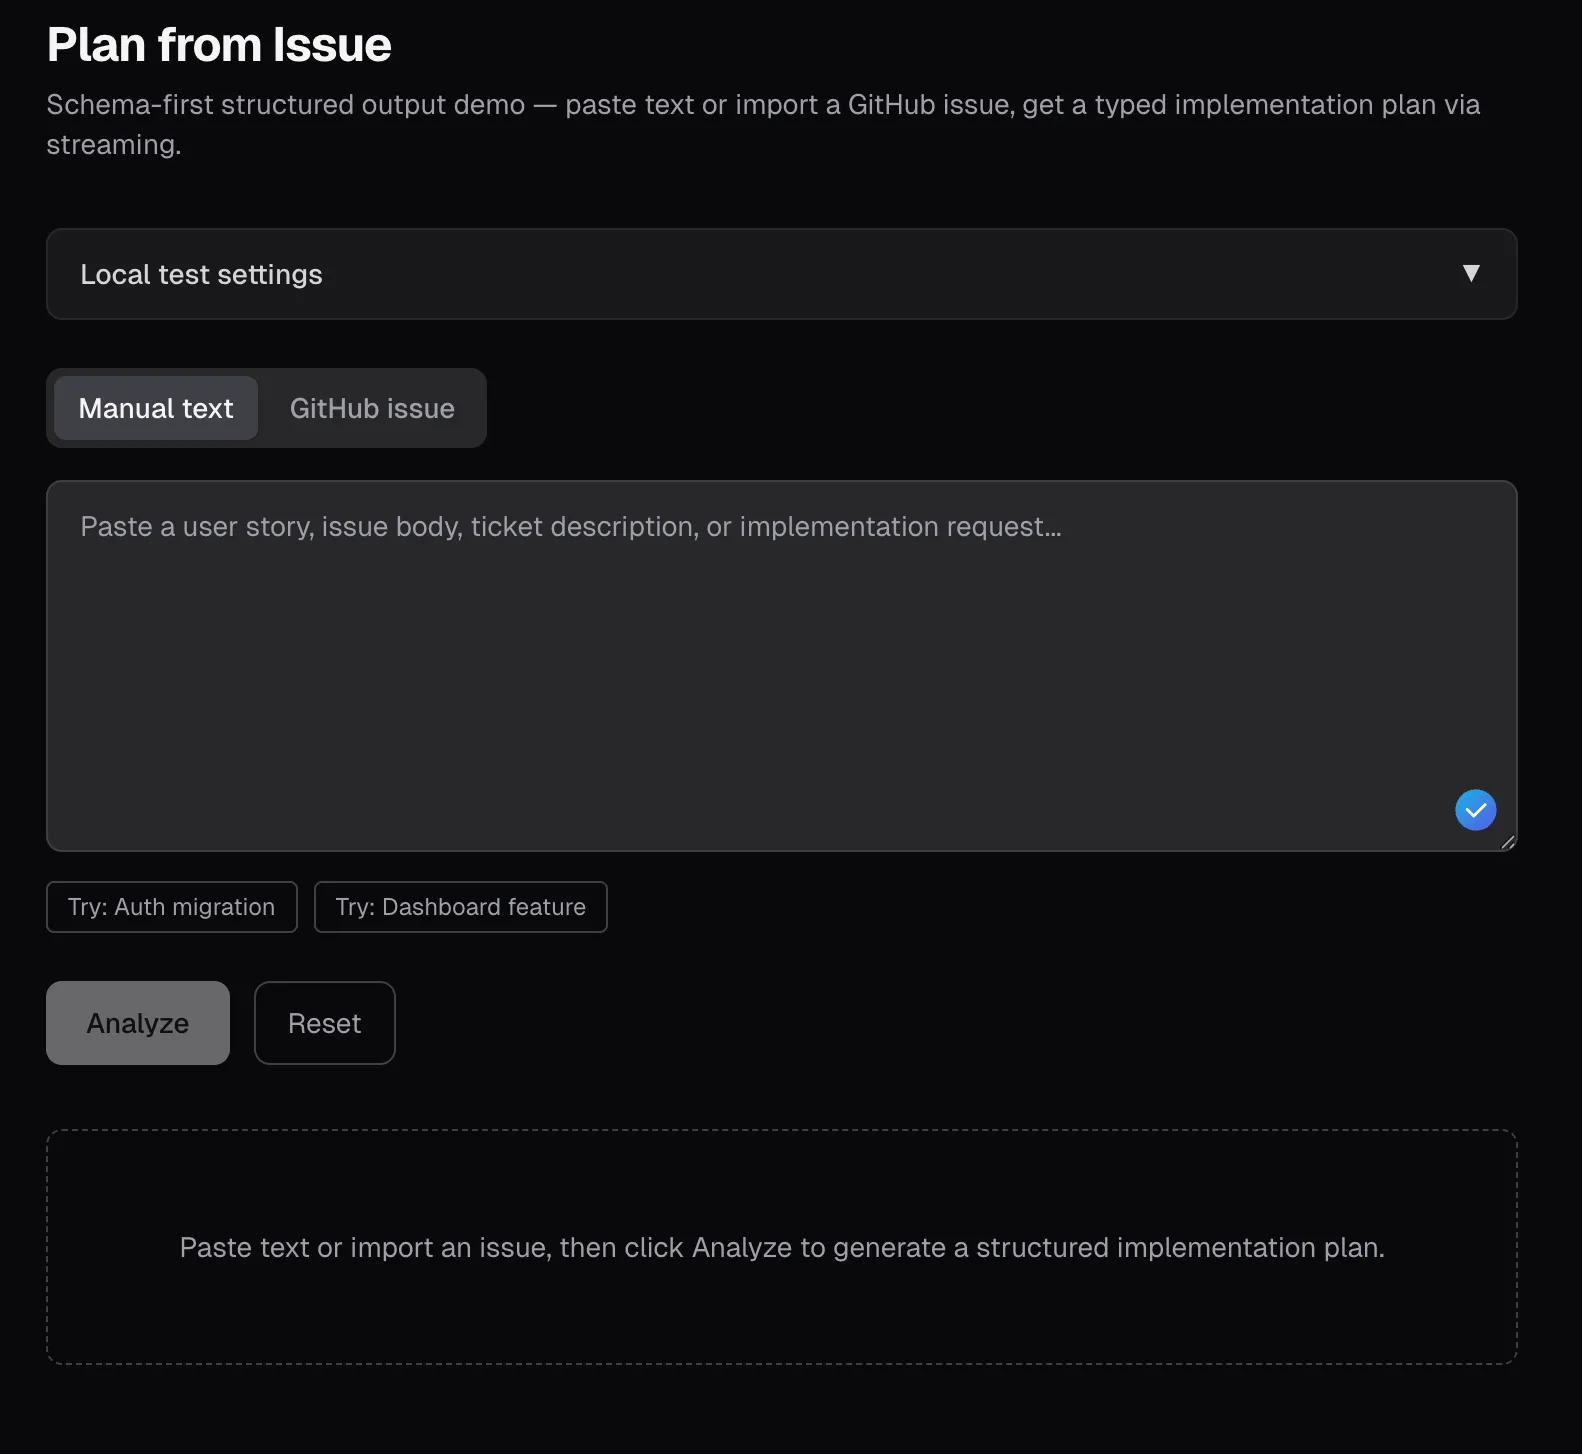
I webappen som ble laget, kan brukeren lime inn et issue i tekstfeltet eller hente det fra GitHub - og få det vist strukturert. Klart, dette er et veldig enkelt og raskt oppdiktet use case, men prinsippene og konseptene jeg forklarer, gjelder også for mer gjennomarbeidede UI-er - her er de bare lette å følge.
Contract-first i stedet for prompt-first
Med eksemplet over lot jeg Claude lage alt i én omgang - egentlig er vi allerede ferdige her. Appen fungerer (etter en prompt laget av ChatGPT).
Generert prompt for å lage demoen
You are a senior TypeScript engineer. Build a small but polished demo web app that showcases schema-first AI output using the Vercel AI SDK.
Do not ask follow-up questions. Make reasonable choices and implement the full app end-to-end. Do not leave placeholders or stubs. Keep the code compact, readable, and suitable for a public demo repo / blog post.
Goal
Build a mini web app that turns either:
- freeform story / ticket text
- a GitHub issue
into a structured implementation plan.
The point of the app is to demonstrate that the AI feature is contract-first, not chat-first.
Stack
Use:
- Next.js App Router
- TypeScript
- AI SDK
- AI SDK UI
- Zod
- @ai-sdk/openai
- minimal styling only (simple CSS or Tailwind is fine)
- no database
- no authentication system
- no server-side persistence
Non-negotiable AI SDK architecture
Use these exact patterns:
- shared Zod schema imported by both client and server
- streamText + Output.object(…) in the route handler
- experimental_useObject on the client
- createOpenAI(…) to instantiate the provider with a request-specific API key
- custom request headers from the client to the analyze route
- no plain-text fallback mode for the main analysis flow
- do not use useChat for the main experience
This app is object-generation first, not chat first.
Core JSON contract
The app must use this exact top-level JSON shape and these exact property names:
{ "summary": "string", "affectedAreas": ["frontend", "backend", "database", "infra"], "risks": ["string"], "implementationSteps": ["string"], "testIdeas": ["string"], "requiresApproval": true }Implement it as a shared Zod schema and export the inferred TypeScript type.
Schema requirements:
- summary: non-empty string
- affectedAreas: non-empty array of unique enum values, restricted to: frontend, backend, database, infra
- risks: array of strings
- implementationSteps: non-empty array of strings
- testIdeas: non-empty array of strings
- requiresApproval: boolean
Do not parse model text with regex. Do not accept “almost matching” output. The UI and server must rely on schema-validated structured output.
Men la oss gå noen steg tilbake. Normalt bygger jeg ikke noe bare for å fylle det med AI. Poenget er at dataene mine skal bearbeides og integreres intelligent i UI-et. Det finnes allerede utallige artikler om det på nettet, og AI hjelper meg utmerket med det.
Kjernepoenget er likevel: Først kommer contracten, så prompten. Jeg må vite hvilke data jeg må trekke ut strukturert, før jeg går over til å skrive og finpusse prompten. Da handler det om å liste opp helt vanlig engineering-arbeid, slik vi egentlig burde kjenne det fra før AI-æraen.
- Hvilke felt vil jeg trekke ut av de ustrukturerte dataene?
- Hvilke felt er obligatoriske? Hvilke er valgfrie?
- Hvilke verdiområder gjelder for tall og strenger? Finnes det enums?
- Hvor bør jeg begrense outputen, slik at den forblir brukbar i UI-et eller pipelinen?
Her hjelper ulike rammeverk meg, avhengig av programmeringsspråket jeg har valgt. Tar vi et av de mer moderne utviklingsmiljøene (TypeScript), kan for eksempel ai-sdk være aktuelt. Men også Java har sitt, med Spring AI, og andre programmeringsspråk har sikkert lignende verktøy. Disse rammeverkene hjelper med å samordne kommunikasjonen mot ulike modell-providere, så jeg ikke må binde meg direkte til leverandører og API-ene deres. I denne artikkelen konsentrerer jeg meg om TypeScript og ai-sdk.

Slike rammeverk har den store fordelen at de samordner API-ene til de enkelte leverandørene og gjør typiske funksjoner enkle og likeverdige å konfigurere - for eksempel structured outputs, akkurat det vi trenger.

For å konstruere denne contracten trengs det som regel en contract - først og fremst JSON-Schema. JSON-Schema beskriver contracten for JSON: Hvilke obligatoriske felt finnes? Hvilket regex må verdiene følge? Tallområder osv. - for å lage eller validere et slikt JSON-Schema kan vi bruke verktøy som https://json.ophir.dev/. Eller spørre en AI om å lage et JSON-Schema som passer behovene våre.
Den viktigste delen av AI-featuren min er ikke prompten, men kontrakten som resten av applikasjonen forventer av modellsvaret.
Med den genererte eller egenlagde contracten i bagasjen kan vi sette i gang med å formulere en passende prompt. Svaret vil helt sikkert enten følge contracten - eller en feil-contract som vi må håndtere separat, f.eks. refusal fra OpenAI.

Evals i stedet for magefølelse
Bygger du en AI-feature uten evals, tester du på brukerne.
Som beskrevet over bygget Claude en fungerende webapp til meg på første forsøk. Legger jeg inn issuet https://github.com/rubenvitt/bluelight-hub/issues/420 som eksempel, får jeg strukturert output:
{
  "summary": "Implement a Verpflegungsmanagement feature under the Betreuung area to manage feeding locations, meal planning, and distribution tracking for Einsatzkräfte and Betroffene. The change includes frontend views on the specified route and backend CRUD plus integrations for planning quantities and recording consumption.",
  "affectedAreas": [
    "frontend",
    "backend"
  ],
  "risks": [
    "Integration dependencies on Kräfte-, Betroffene-, Logistik-Modul, and Lagekarte may block parts of the feature or require fallback handling.",
    "Quantity estimation can become inconsistent if personnel and affected-person counts are unavailable, delayed, or separated differently than expected.",
    "Tracking meal status and portion counts across multiple Ausgabestellen introduces risk of incorrect state transitions or double counting.",
    "Capturing Sonderbedürfnisse must stay usable in the UI while still being detailed enough for planning."
  ],
  "implementationSteps": [
    "Add backend CRUD support for Verpflegungsstellen with fields for name, location, type, capacity, opening/output times, and responsible personnel.",
    "Add backend CRUD support for Mahlzeiten including time, type, estimated quantity, assigned Ausgabe-/Verpflegungsstelle, separated counts for Einsatzkräfte and Betroffene, Sonderbedürfnisse, and status values Geplant, In Zubereitung, Ausgabe, Abgeschlossen.",
    "Implement backend logic for quantity estimation based on the provided formula using counts from Kräfte and Betroffene where available.",
    "Add backend endpoints or service integration for recording consumption data per Mahlzeit and Ausgabe-/Verpflegungsstelle: issued portions, beverage consumption, remaining quantities, and material consumption for Logistik handoff.",
    "Build the frontend page at /app/einsatz/$einsatzId/betreuung/verpflegung with management views for Verpflegungsstellen and Mahlzeiten.",
    "Implement Verpflegungsstellen cards showing key details and current status, with create/edit/delete flows.",
    "Implement a Mahlzeiten timeline that separates planned, current, and past meals and supports status updates through the defined lifecycle.",
    "Add meal planning UI for time, type, quantity estimate, separated person counts, special needs, and assigned distribution point.",
    "Implement quick-entry controls for portion output using +/- counters and forms for beverage usage and remaining quantities.",
    "Add a dashboard view showing supply coverage as x% versorgt based on planned vs. served data.",
    "Integrate map marking of Verpflegungsstellen on the Lagekarte from the route workflow.",
    "Connect quantity planning to personnel counts from Kräfte and affected-person counts from Betroffene, and send recorded material consumption to Logistik for replenishment workflows."
  ],
  "testIdeas": [
    "Create, update, list, and delete Verpflegungsstellen with all required fields and verify they appear correctly in the management UI.",
    "Plan a Mahlzeit with separated counts for Einsatzkräfte and Betroffene and verify the estimated quantity follows the specified calculation.",
    "Verify meal status transitions from Geplant to In Zubereitung to Ausgabe to Abgeschlossen are reflected correctly in the timeline and detail views.",
    "Record portion output for a meal at a specific Verpflegungsstelle with +/- quick entry and confirm totals persist correctly.",
    "Record beverage consumption, remaining quantities, and material consumption and verify the data is stored and associated with the correct meal and location.",
    "Enter Sonderbedürfnisse such as allergies, vegetarian, halal, and confirm they are retained and visible in planning views.",
    "Verify Verpflegungsstellen are shown on the Lagekarte with the configured location.",
    "Test integration behavior when Kräfte or Betroffene counts are available versus unavailable, ensuring quantity estimation degrades predictably.",
    "Verify the dashboard coverage percentage updates as portions are issued.",
    "Confirm material consumption data is handed off correctly to the Logistik integration path."
  ],
  "requiresApproval": false
}
40 linjer resultat. LGTM. Done.
Eller… ikke?
Spørsmålet er ikke om svaret høres «smart» ut, men om det er pålitelig nok for workflowen min.
Hvordan vet jeg at resultatet er et godt resultat? Hvordan vet jeg at jeg kan stole på det? Contracten gir meg en strukturell garanti. Om innholdet holder faglig, er dermed ennå ikke besvart. Derfor er det først og fremst de faglige spørsmålene som må avklares: Er de berørte områdene fornuftig identifisert? Er risikoene brukbare? Kan jeg faktisk bruke testideene - eller er det unødvendig tull? Er approval-flagget plausibelt? Én måte å besvare disse spørsmålene fullt ut på er å gå gjennom hvert eneste svar - og besvare og vurdere spørsmålene selv. Så kan jeg justere prompten og vurdere på nytt. Men min ærlige mening om det? Det vil jeg ikke, nei! Jeg gidder ikke.
Og ja, det finnes et alternativ. Faktisk flere. OpenAI har sin egen optimizer, men det finnes også mange open source-verktøy. Ett eksempel er https://github.com/promptfoo/promptfoo.
For å holde det enkelt valgte jeg OpenAI Platform her. Der er en evaluering raskt gjort: lag en prompt (viktig: med variabel!), opprett et nytt dataset under fanen Evaluation, og legg inn testdata. Jeg tar rett og slett noen av issuene mine fra bluelight-hub-prosjektet - deretter klikker du på play, og vips kjøres prompten på listen med inputs (obs: det koster penger).
Her får vi allerede mye hjelp fra OpenAI, nesten alt kan revideres automatisk direkte der, og også JSON-schemaet vårt kan genereres. Jeg limte rett og slett inn zod-schemaet fra eksempelprosjektet - og så ble det tilhørende JSON-schemaet generert… perfekt.
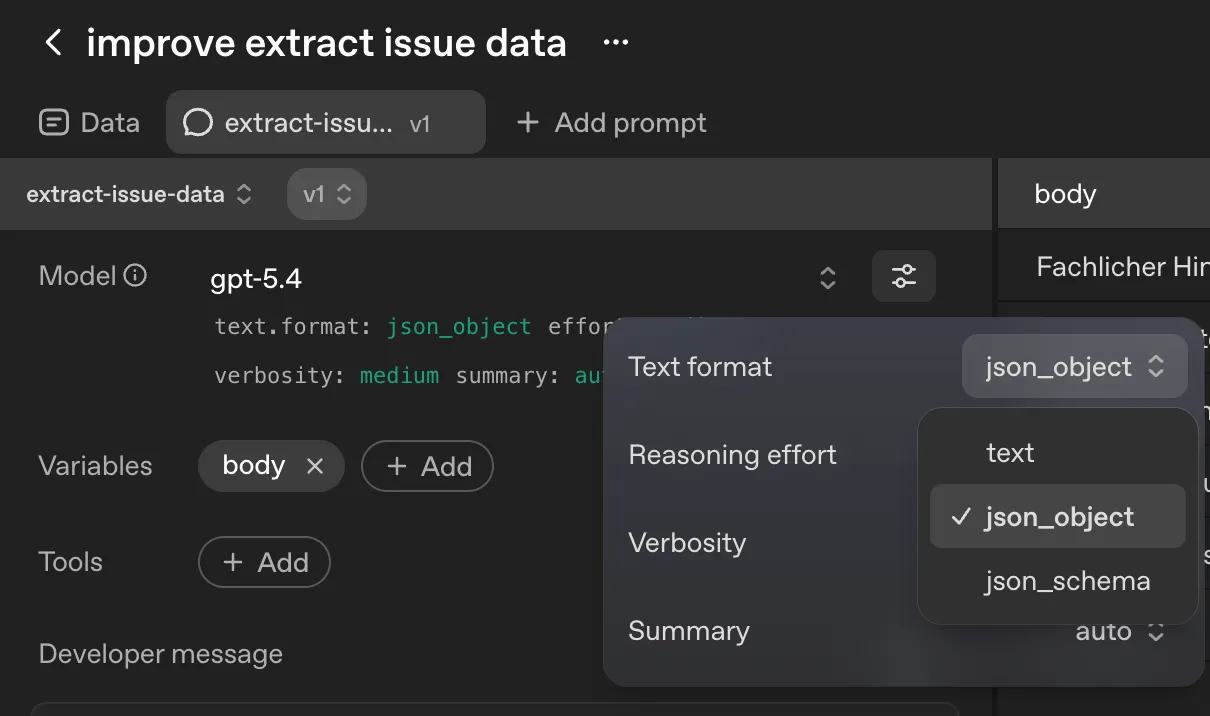
Fordelen? Vi har nå flere kolonner i eval-visningen og kan lese av hver enkelt verdi direkte og vurdere hvordan vi vil håndtere dem.
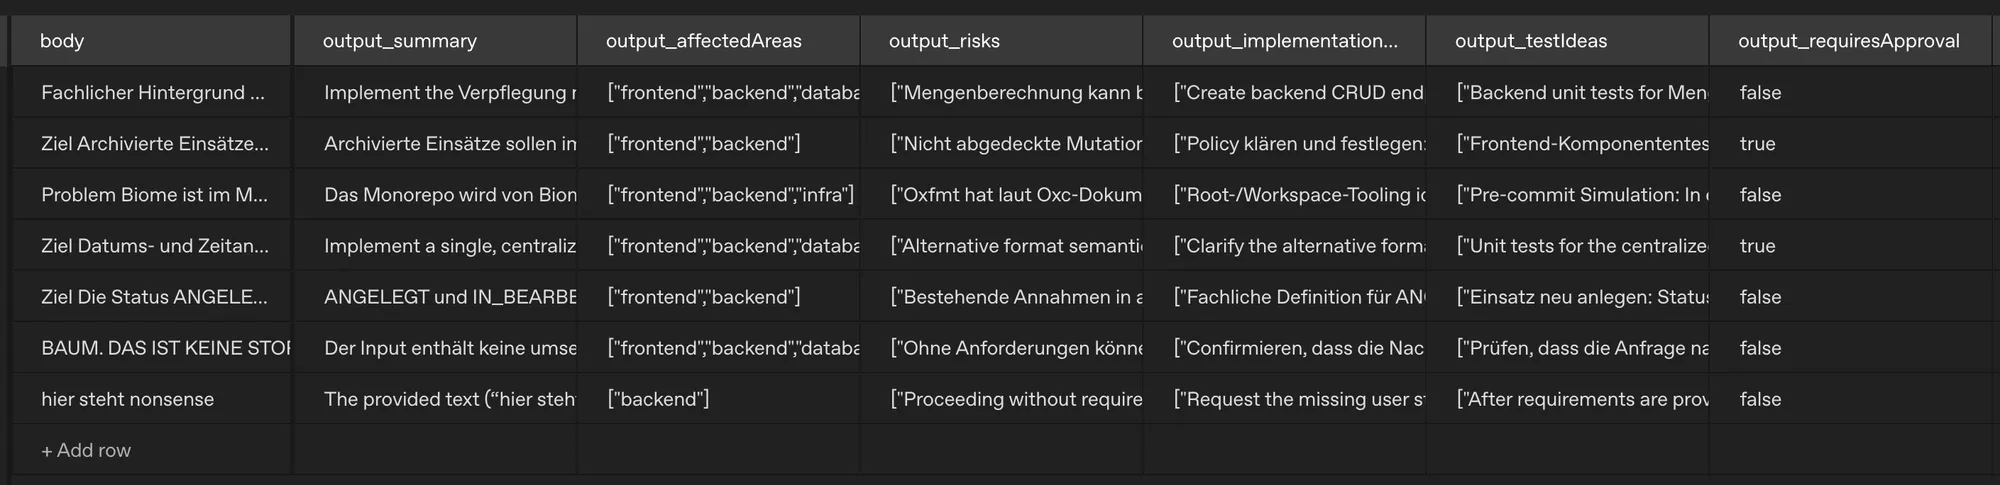
Nå kan vi begynne med selve evalueringen: Opprett nye kolonner enten for manuell gjennomgang (annotation) - eller la AI-en gå gjennom, sjekke og vurdere de enkelte svarene (grader), etter våre kriterier.
Etter en første evaluering med to kriterier blir det tydelig: Prompten vår trenger litt etterarbeid. Hva gjør vi? I dette verktøyet holder det med ett klikk på Optimize - og OpenAI tar seg av resten, basert på vurderingen fra prompt-evalueringen.
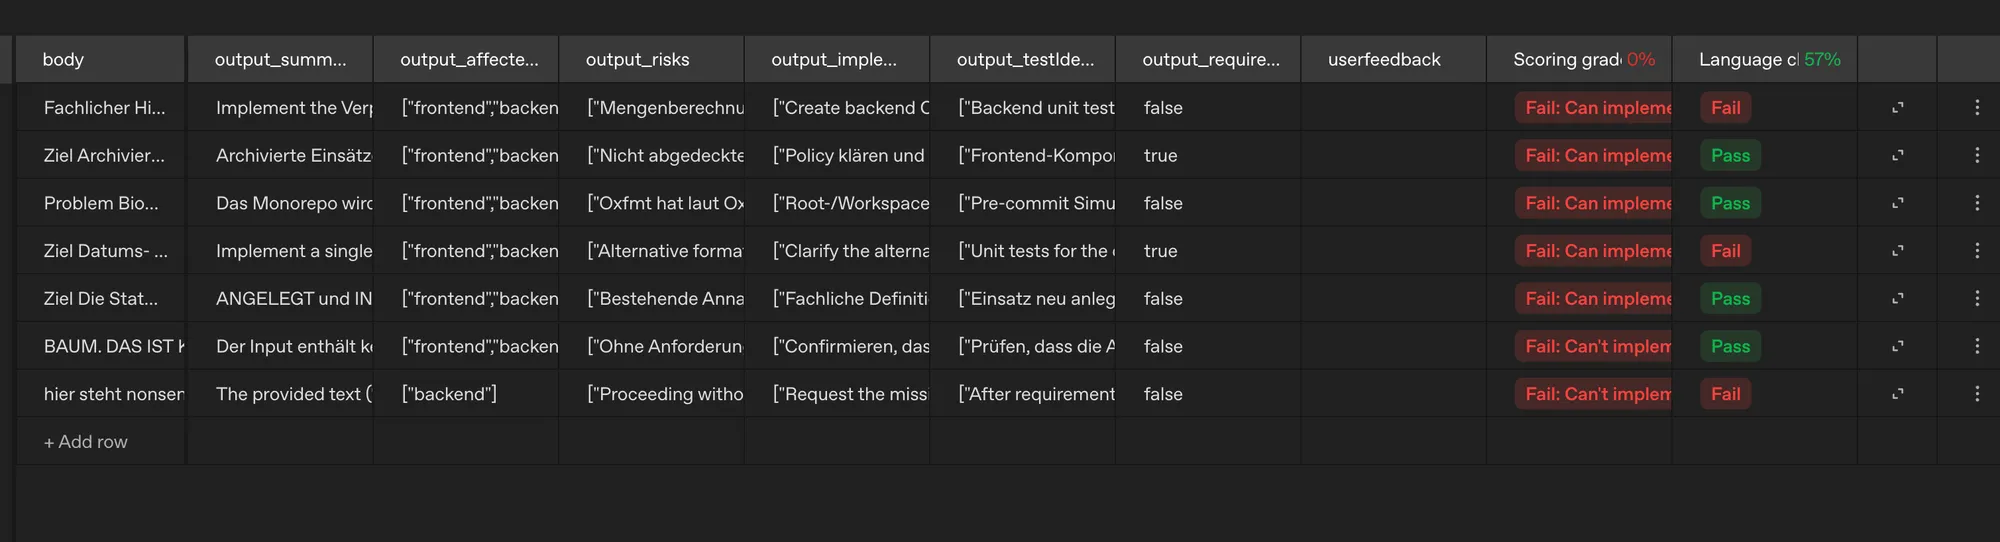
Etter litt mer optimalisering og en manuell justering (via prompt) ble resultatet litt bedre. Klart, dette er et veldig lite evalueringssett - her handler det mer om selve prinsippet. Manuell feedback har jeg også bare droppet her, selv om det i vanlige tilfeller hører med for til slutt å få fornuftige resultater.
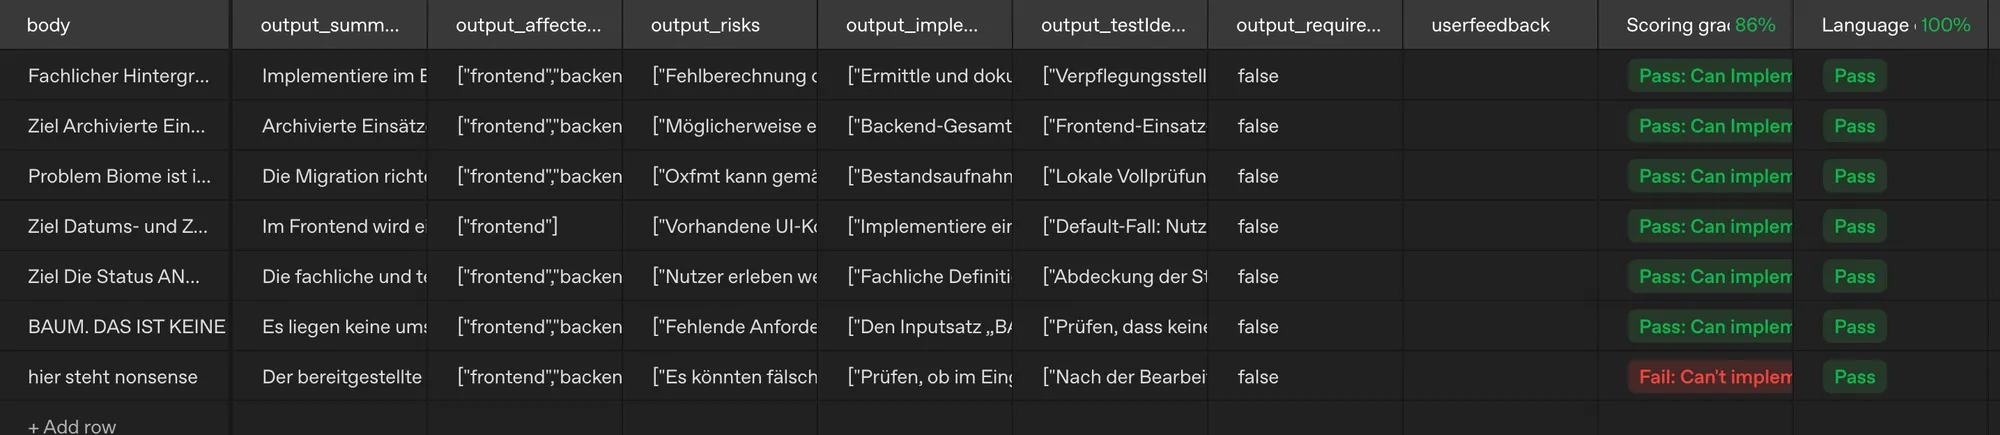
Med det flotte resultatet går jeg rett til Claude og ber om å oppdatere prompten med den nye.
Dermed har vi nå en forbedret prompt som dekker kravene våre bedre. Med structured output lager vi UI i stedet for ren tekst-output. Det var det lille innblikket. Her er det fortsatt så mye mer å oppdage, optimalisere og finpusse.
Grunnprinsippet bak evals burde likevel være tydelig: Definer mål, samle et datasett med eksempler og eventuelt forventede resultater, fastsett metrikker, sammenlign kjøringer, få dem evaluert.
Observability i stedet for black box
Når vi bygger ikke-deterministiske systemer inn i applikasjonene våre, er det desto viktigere å forstå hva som skjedde når noe går i stykker, slik at vi finner en måte å forebygge akkurat det på. Til det hører noen viktige datapunkter som vi helst vil samle inn:
- hvilken modell ble brukt?
- hvor lang tid brukte LLM-en på et svar?
- var den returnerte JSON-en gyldig i henhold til contracten?
- var det nødvendig med retries?
- eventuelt: hvilke tools ble brukt?
- hvor måtte mennesker gripe inn?
- hvor mange tokens ble brukt, og hvor høye var kostnadene knyttet til dem?
OpenTelemetry har nå konvensjoner for GenAI-applikasjoner for events, metrikker og spans. Det betyr at også AI-funksjonene kan kobles inn i observability. AI SDK-et jeg nevnte over, har også en connector som automatisk samler inn og sender slike data via rammeverket.

FullStack-delen er UI-et, ikke bare modellen
Det blir først et FullStack-tema når jeg ikke bare snakker med en modell, men designer en brukerflyt for mennesker.
Nå som vi har avtalt en fornuftig contract med LLM-en, sender den over API-et og har bygget en virkelig god prompt - hva mangler? Klart, UI-et. I starten av innlegget antydet jeg det allerede: Å bare vise litt tekst, det kan alle. Selv etter one-shot-forsøket med Claude var det riktignok ikke et chatgrensesnitt, men likevel bare tekst etter tekst på rekke og rad. Vi beveger oss nok i litt tørt terreng her - en implementeringsplan for stories - men vi får vel til noe fint i alle fall når det gjelder visningen?
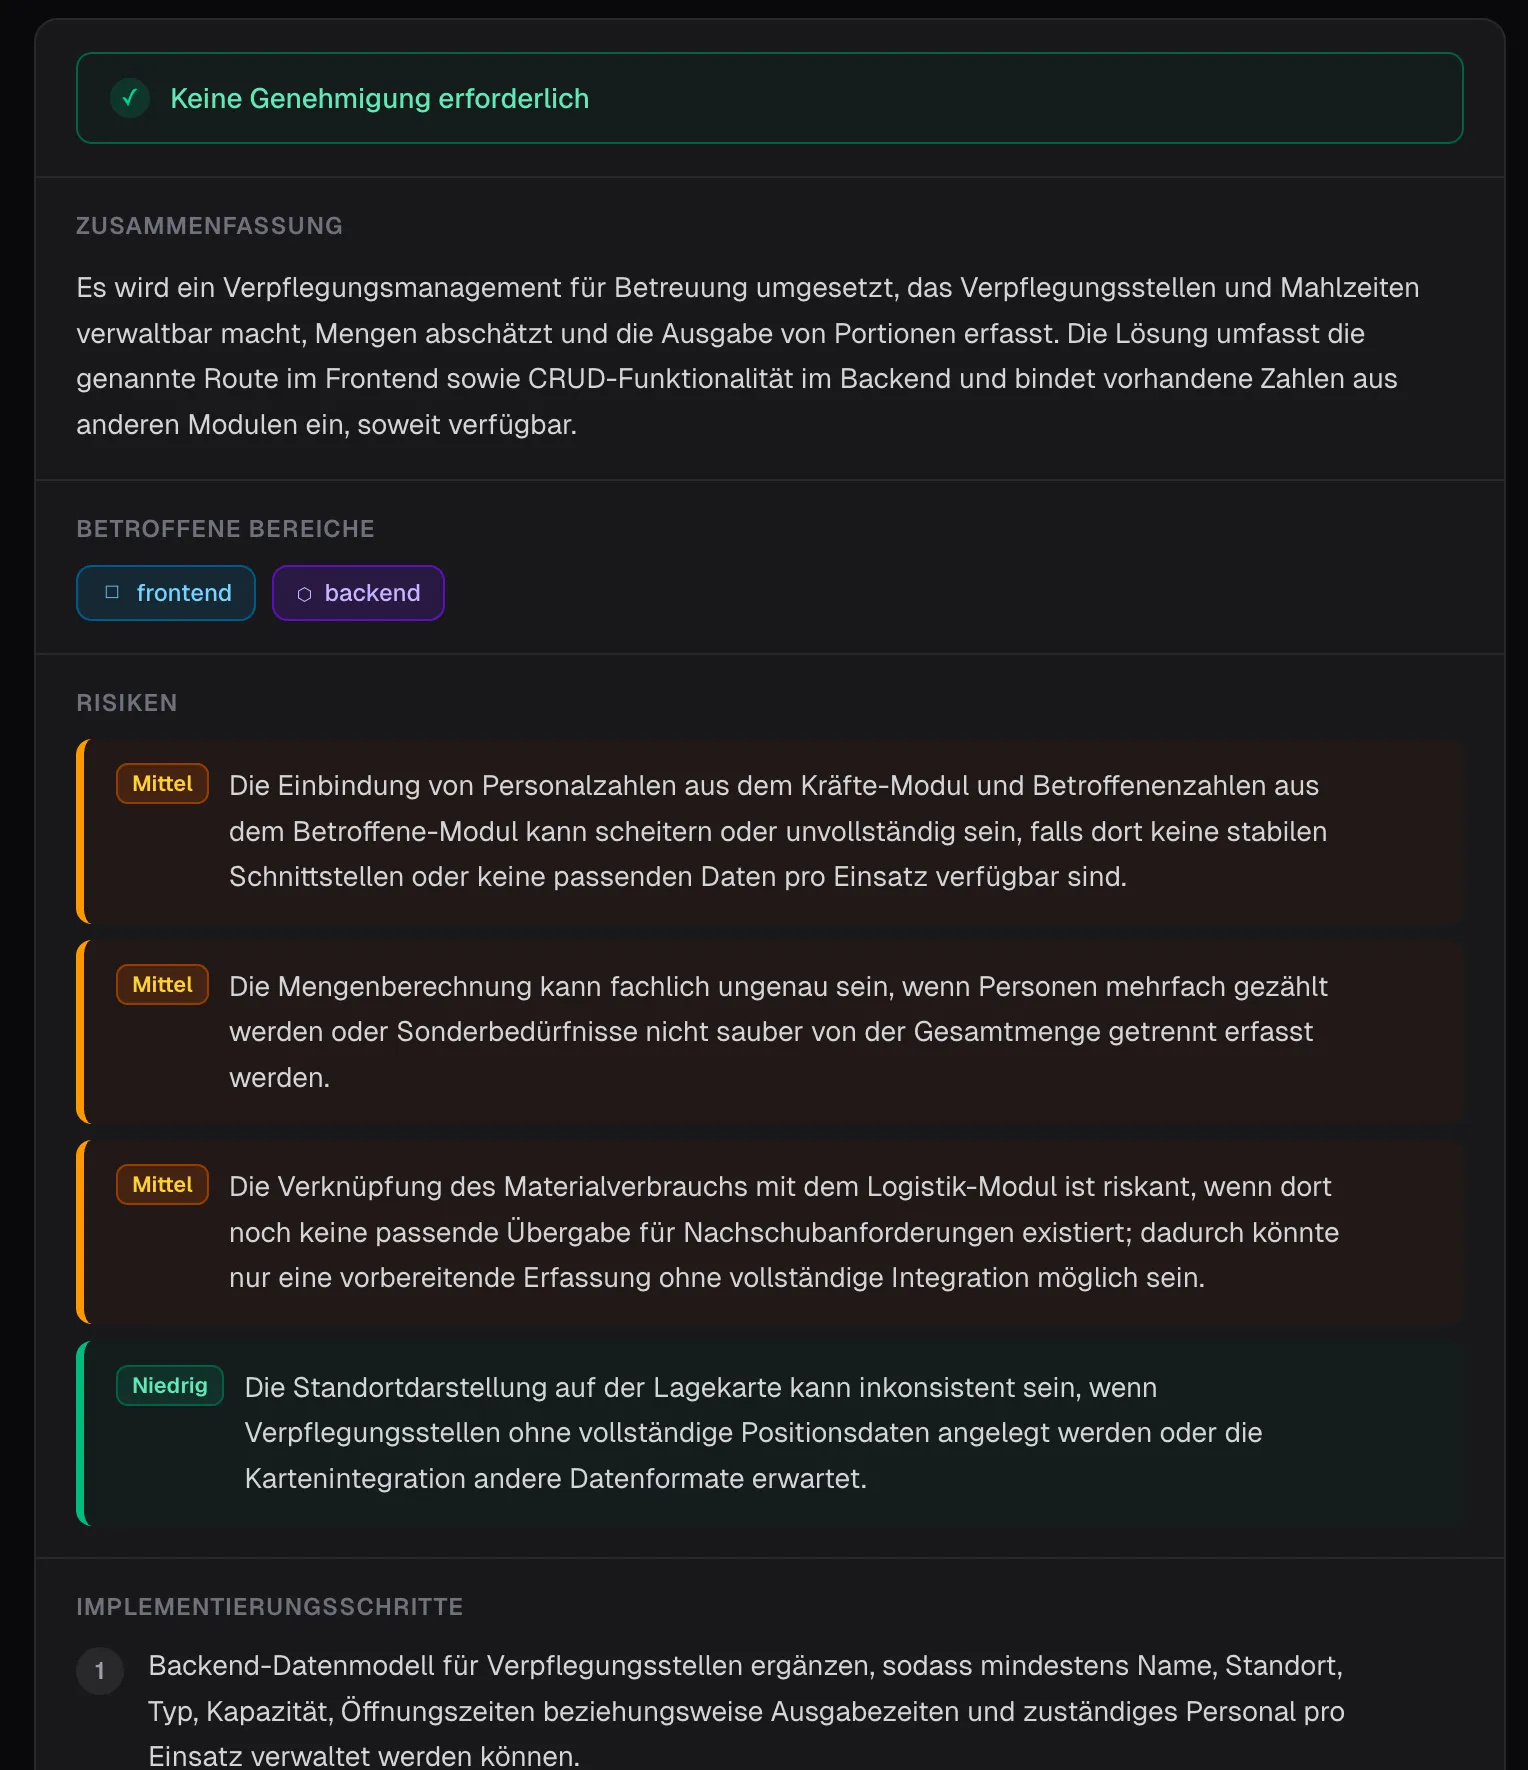
I første steg ville jeg bare at dataene skulle presenteres litt penere. Så langt, så godt - hva med et implementerings-canvas da?
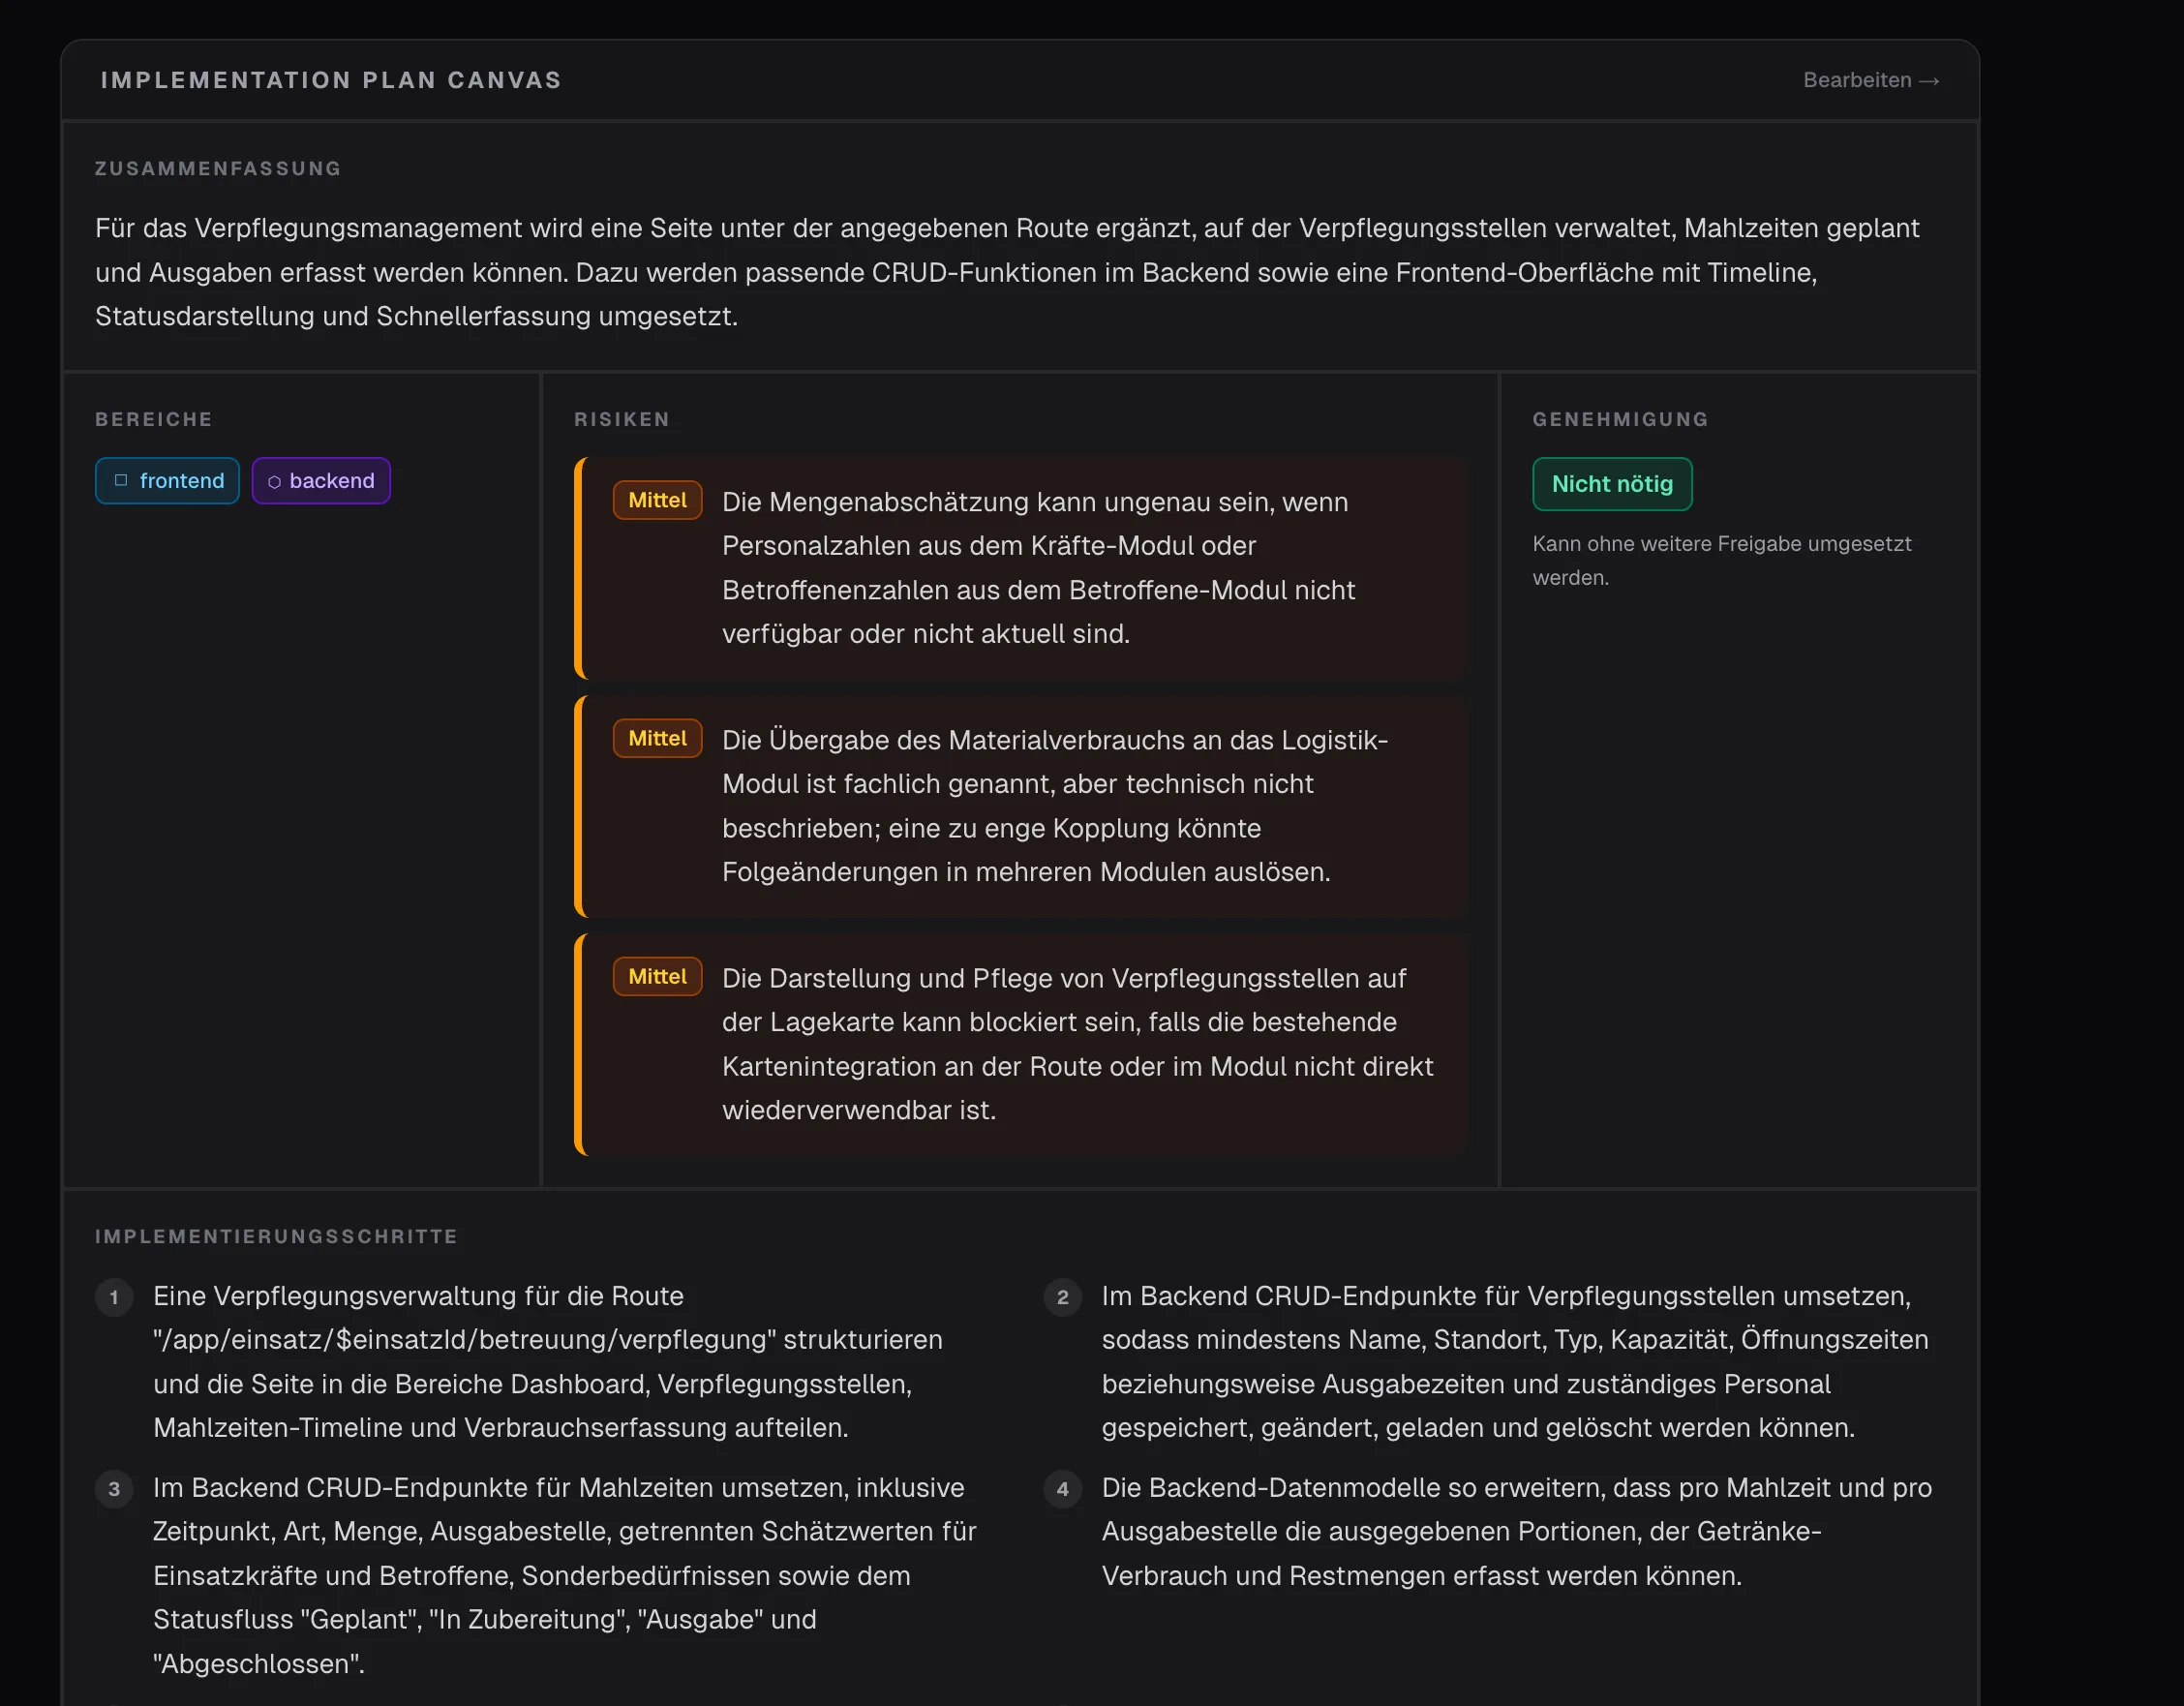
Enda en måte å vise det på - med mulighet til å redigere innholdet - men hvordan kan vi skape reell merverdi? Hvis oppgaven inneholder frontend-arbeid… burde vi ikke da generere en mockup direkte? Sagt og gjort…
Ohh, I love Agentic Engineering.
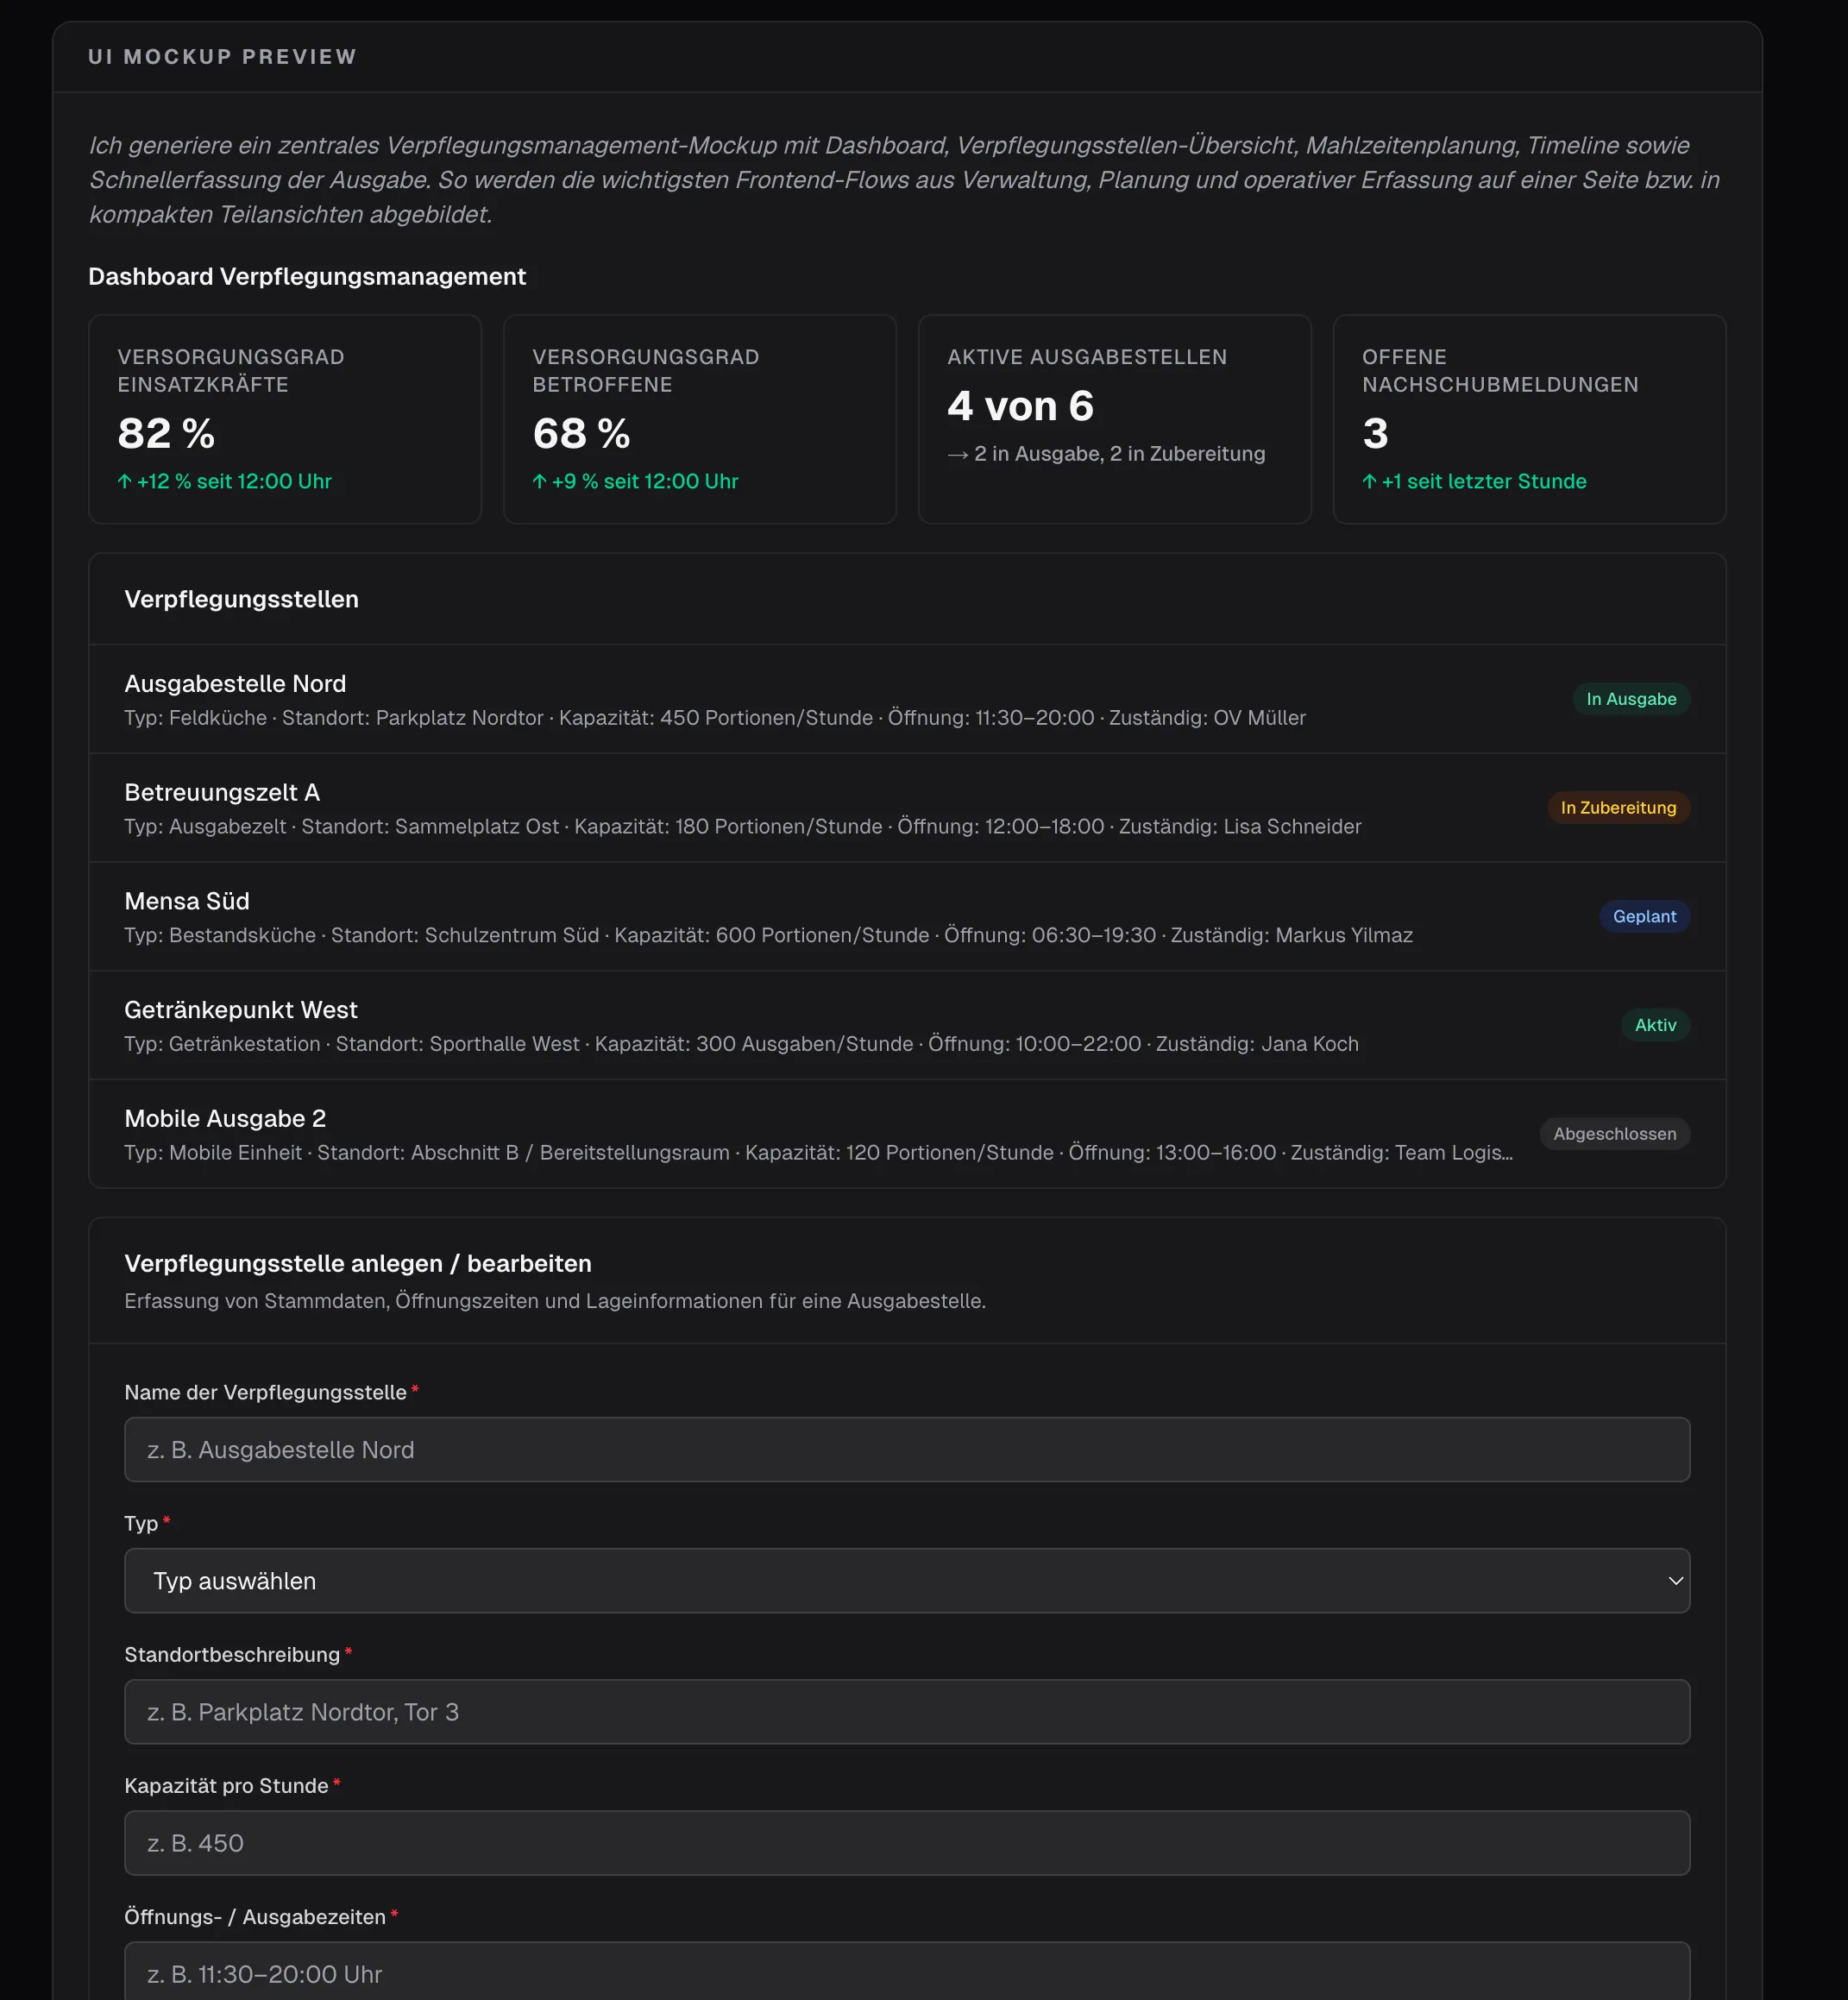
Prompt engineering er fortsatt nyttig. Men så snart modelloutput bærer ekte produktlogikk, trenger jeg først og fremst tre ting: contracts, evals og telemetri. Det er nettopp der AI Systems Engineering begynner for meg. Og der vi oppdager nye interaksjonsmønstre.
