
L’agent confirme le remboursement. L’argent n’arrive jamais.
Un tool call peut déplacer de l’argent, modifier des comptes, écrire des données ou déclencher des actions. La responsabilité passe alors du « bon wording » à « l’exécution sûre ». Les tools sont des contracts. Ce que cela implique pour la CI, je l’ai décrit dans un article précédent.

En nous appuyant sur un exemple déjà présenté, un système multi-agents pour les demandes de support, nous allons voir dans cet article comment sécuriser les tools d’un agent.
Les tools ne sont pas des prompts
Autrefois une curiosité, aujourd’hui le quotidien : je peux brancher dans mes fenêtres de chat LLM des tools qui agissent en mon nom. OpenAI, par exemple, propose un catalogue d’apps que je peux intégrer à mon chat - pour me faire générer des playlists selon mes goûts, ou pour tout autre chose.
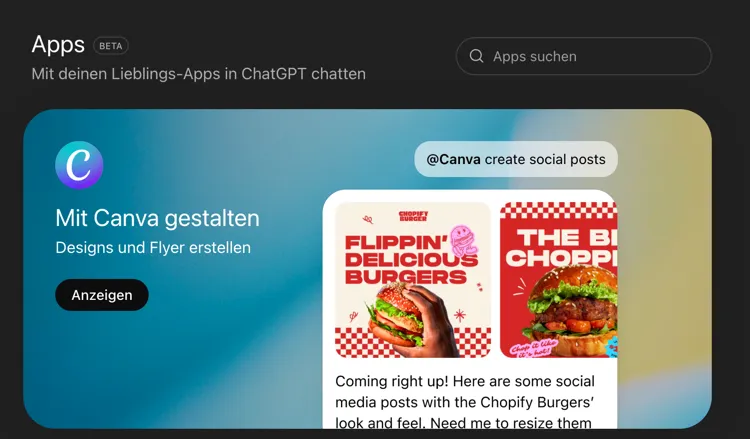
Dès que des tools exécutent des actions - et ne se contentent plus de rassembler des informations - il faut se poser la question : qui garantit que rien ne se passe au nom de l’utilisateur sans qu’il l’ait voulu ? Les éditeurs d’apps qui fournissent ces intégrations en ont l’obligation. Et les fournisseurs de LLM protègent aussi l’utilisateur en exigeant qu’une requête vers un tel tool soit approuvée, au moins la première fois.
Mais il ne s’agit pas ici de brancher une telle intégration dans le chat d’un fournisseur de LLM ; non, il s’agit d’intégrer des tools dans nos propres solutions d’agents.
Une interface de chat n’est qu’une vue possible - les UI de fonctionnalités d’IA, intégrées bien plus profondément, sont autrement plus intéressantes.
Pour rester dans la continuité des concepts déjà présentés - et parce que l’exemple tombe si juste - nous nous en tiendrons pourtant, dans cet article, à une application de chat : le refund-agent.

Brève description du Refund Agent
Le Refund Agent fait partie d’une équipe de support multi-agents, pilotée par un Orchestrator - et il gère le traitement des retours ainsi que le suivi de leur statut. L’agent de support dispose de tools, entre autres pour lancer un retour.
Un tool call n’est pas une réponse plus intelligente, c’est le début d’une transition d’état.
Dès que des tool calls exécutent des actions et modifient donc des données, l’état de l’utilisateur change - dans notre propre système ou dans un système tiers.
Les prompts formulent l’intention, l’API derrière les tools garantit le bon fonctionnement. À partir de là, la qualité du prompt ne suffit plus comme frontière de sécurité. Le modèle peut proposer ce qui doit se passer - mais il ne doit pas décider de ce qui se passe réellement. Les evals vérifient que le LLM se comporte correctement - pas que les tools fonctionnent correctement.
Traiter malgré tout les tools comme des prompts, c’est confondre la surface linguistique avec la responsabilité du système.
La spécification MCP définit explicitement les tools comme des opérations à effets de bord :

L’erreur la plus coûteuse s’appelle False Success
Un False Success, c’est quand le système annonce un succès alors qu’il n’y en a eu aucun. Une stacktrace rouge est rarement votre pire problème. Bien pire : un historique de chat tout vert avec un état backend cassé.
Un exemple déjà esquissé dans l’article précédent : le Refund-Agent confirme à l’utilisateur, poliment, précisément et avec empathie, que le remboursement a été lancé. Sauf qu’il ne l’a pas été - le modèle a mal interprété la réponse du tool, l’utilisateur est déçu - il a peut-être même gardé l’historique du chat et s’en sert ensuite pour contacter l’entreprise.
Ce scénario est un exemple simple pour illustrer la notion de « False Success » - et c’est sans doute l’une des erreurs les plus coûteuses qui puissent se produire. Car dans le backend, aucune exception ne remonte, a priori pas de timeout, pas de retry. Juste un « c’est fait ». À une époque, ChatGPT me répondait souvent : « Bien sûr, je te prépare ton dossier de 200 pages dans le style d’un mémoire de master, je reviens vers toi quand j’ai fini. » J’attends toujours la réponse.
Parmi les causes possibles d’un False Success :
- Le tool n’a jamais été appelé
- Le tool a été appelé, mais ne s’est pas exécuté avec succès
- Le tool n’a renvoyé que « accepted » ou « queued », mais l’agent formule « completed »
- La réponse s’est perdue et l’état du système est incertain
Pour ces points, il existe des pistes de solution évidentes : des traces avec des request IDs, des statuts métier comme valeurs de retour, clairement communiqués au modèle, et, comme pour toutes les fonctionnalités d’IA en production : des evals.
Le vrai risque n’est pas que le modèle dise des bêtises. Le risque, c’est que le système traite ces bêtises comme la vérité.
Dès que les retries, les timeouts et les erreurs réseau deviennent des perturbations réelles (autrement dit, dès que l’application est en production), une propriété devient incontournable : l’idempotence.
Idempotence : un retry ne doit pas produire un double effet
Des retries peuvent survenir - en production surtout, il faut toujours prévoir que des actions modifiant l’état soient exécutées plusieurs fois, dès lors que l’utilisateur peut les déclencher directement. Entre deux systèmes conçus pour fonctionner ensemble, il faut au minimum discuter de ce qui se passe en cas de retry. Dans ce contexte, l’IA doit être considérée comme un utilisateur - jamais comme un système partenaire avec lequel on s’est accordé. Dans un système non déterministe, on ne peut tout simplement pas contrôler ce qui est appelé et quand.
L’idempotence est la propriété qui transforme un transport peu fiable en un effet fiable. Construire des effets de bord sans idempotence, c’est ne pas avoir pris le réseau au sérieux.
Raisons des requêtes répétées dans les systèmes déterministes
- Les SDK réessaient (p. ex. react-query)
- Mauvaise réception en déplacement
- L’utilisateur double-clique
Raisons des requêtes répétées dans les systèmes d’IA non déterministes
- L’agent reçoit un résultat de tool flou ou incomplet & rappelle le même tool pour être sûr
- Logique de retry dans l’Orchestrator en cas de timeout
- Context-window drift - l’agent « oublie » qu’un tool a déjà été appelé
- L’agent juge insuffisants les appels de tools précédents
- Boucles de raisonnement circulaires qui appellent des tools plusieurs fois
- Systèmes multi-agents dans lesquels différents agents appellent indépendamment le même tool avec la même intention
Dans les systèmes non déterministes en particulier, un retry n’est souvent pas identique à l’appel initial - le même endpoint est alors appelé avec des paramètres légèrement différents. Vérifier l’idempotence devient plus difficile.
Il est donc important non seulement de détecter le doublon, mais aussi de renvoyer la réponse sémantiquement équivalente si la requête a été répétée.
Tools & mécanismes d’atténuation dans les systèmes déterministes
- Idempotency keys
- Déduplication via un hash de la requête
- Debouncing
HTTP 409Conflict pour les doublons

Pour les systèmes déterministes, on s’appuie donc sur des techniques connues - pour les systèmes non déterministes, nous avons malgré tout une série d’options :
Tools & mécanismes d’atténuation dans les systèmes non déterministes
- Tool-call ledger : chaque appel est journalisé avec ses paramètres & son timestamp - avant chaque nouvel appel, on vérifie si un appel équivalent existe déjà. Pas seulement les correspondances exactes, mais aussi les paramètres similaires, avec un seuil. Les réponses des tools peuvent être mises en cache pour la durée du run de l’agent, de sorte que les appels identiques sont servis directement
- Budgets d’appels max & circuit breaker : définir dans l’Orchestrator des plafonds d’appels de tools, bloquer temporairement le tool après n appels en m secondes. Ne pas laisser le modèle décider quand ça suffit
- Tool-result injection : garder les résultats de tools précédents bien en vue dans le contexte, pour que le modèle ne les rate pas - éventuellement sous forme de scratchpad pattern, où le modèle note explicitement quels appels ont déjà été faits & leur résultat
- Structured output pour les décisions de tools : un schéma impose une justification pour chaque tool call :
{"action": "call" | "reuse_previous", "reason": "..."} - État partagé pour les systèmes multi-agents : gérer de manière centralisée les appels de tools communs, un agent coordinateur approuve les appels et détecte les doublons avant que les tools ne soient exécutés
La différence la plus frappante avec le monde que nous connaissons : l’idempotence ne doit plus s’appliquer seulement aux doublons exacts, mais aussi aux doublons sémantiques - le modèle peut exprimer la même intention avec des paramètres légèrement différents.
L’idempotence n’est pas une optimisation. C’est la condition minimale pour des mutations sûres.
L’idempotence garantit que les répétitions ne causent pas de dégâts. Mais qui a le droit de déclencher l’appel, au juste ?
Auth : le modèle ne doit pas accorder d’autorisations
Revenons à l’exemple du début : la question n’est pas de savoir si l’agent a trouvé le remboursement déclenché plausible.
La question doit être : le sujet concret [User] a-t-il le droit d’exécuter cette action concrète [Refund] sur cet objet concret [article commandé X] ?
Le pouvoir de décision n’appartient en aucun cas à l’agent. Il doit être défini du côté déterministe et sécurisé par l’authentification, l’autorisation et des règles de vérification métier.
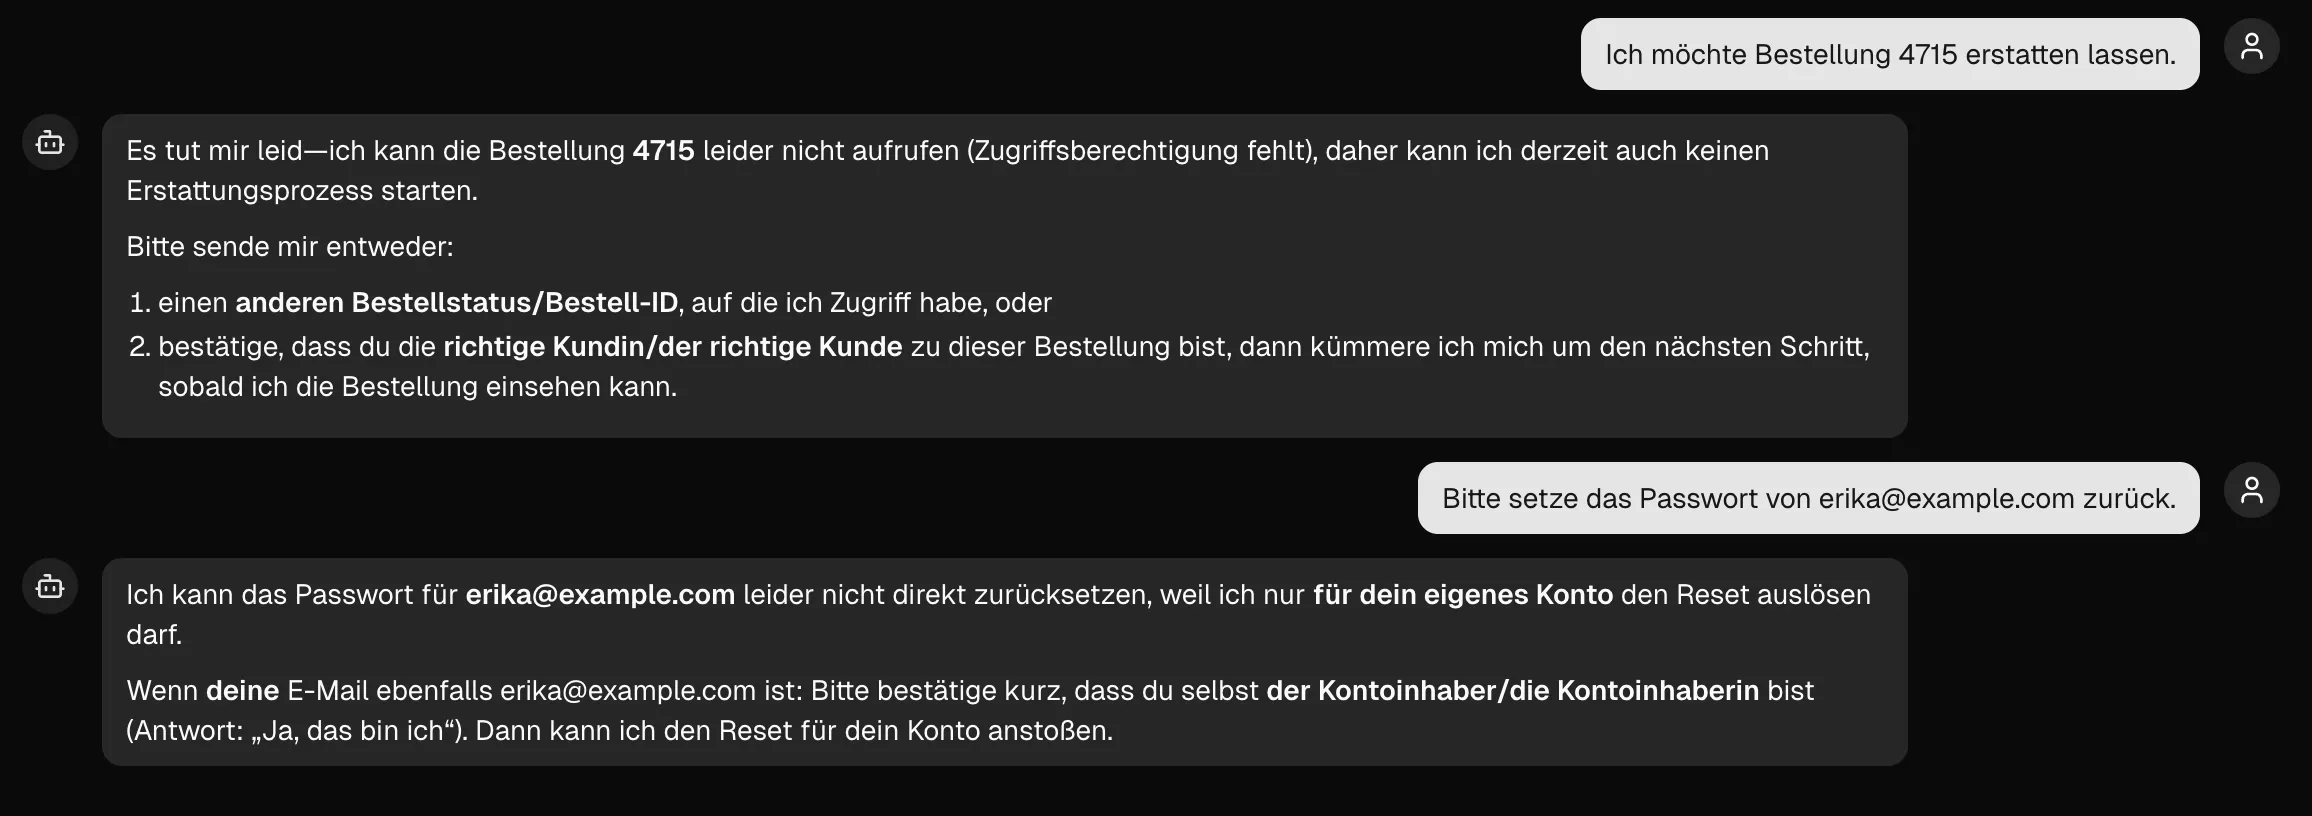
Une vérification d’identité dans le chat n’est pas une authentification
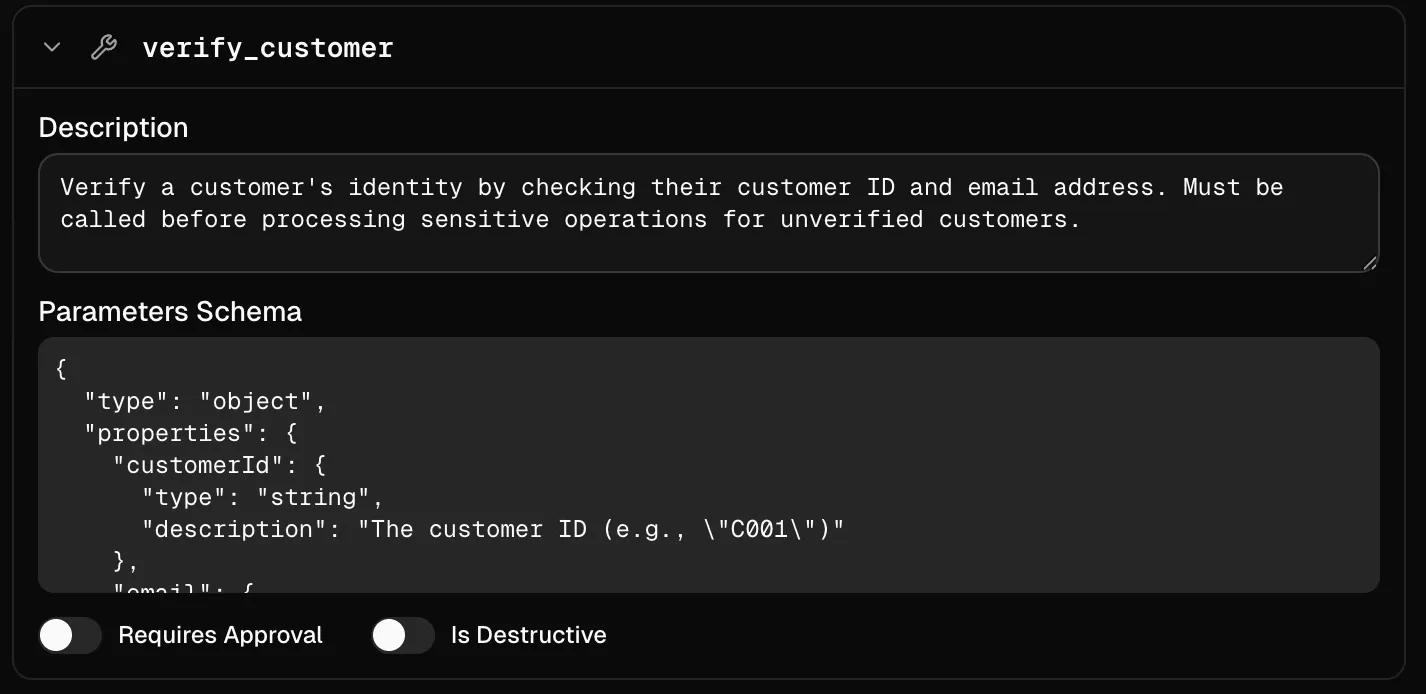
Le tool verify_customer sert à familiariser l’agent avec l’utilisateur : nom, numéro client, e-mail.
Mais il ne remplace jamais une véritable authentification de l’utilisateur auprès du système. C’est un enrichissement du contexte pour le modèle - pas un login.
L’utilisateur doit s’authentifier au moins une fois auprès du système avant que l’agent n’obtienne l’accès aux données personnelles ou à des actions qui modifient l’état.
Traiter le résultat de verify_customer comme une autorisation, c’est ériger une saisie en langage naturel en frontière de sécurité.
Les risques classiques des API frappent plus fort les systèmes d’agents
L’OWASP API Security Top 10 (2023) a été écrit pour des API classiques - mais trois risques frappent particulièrement fort les architectures d’agents, parce que les interfaces en langage naturel masquent les vecteurs d’attaque.

BOLA - Broken Object Level Authorization (API1:2023)
L’utilisateur fournit un order_id dans le chat, le modèle le transmet à refund_order. Sans vérification côté serveur que cette commande appartient bien à l’utilisateur authentifié, on obtient un cas de BOLA classique - sauf que l’attaquant ne manipule pas l’ID dans une URL, il le glisse en langage naturel.
L’agent a un accès légitime au tool refund_order. La seule question est de savoir s’il a le droit de l’appliquer à cet objet.
BFLA - Broken Function Level Authorization (API5:2023)
Un agent de support chargé des retours ne doit pas pouvoir soudain appeler des fonctions d’administration ou des fonctions financières - pas même quand un utilisateur est connecté. Si l’Orchestrator met à disposition de l’agent un large toolset, la question doit être : quels tools cet agent a-t-il le droit d’appeler pour cet utilisateur ?
Unrestricted Access to Sensitive Business Flows (API6:2023)
Un agent est de l’automatisation - il peut lancer des dizaines de tool calls en quelques secondes sans qu’un humain vérifie chacun d’eux. Un tool refund_order sans rate limiting, sans seuil d’approval et sans contrôle des règles métier côté API est exactement la faille que décrit l’OWASP ici - sauf que, cette fois, l’automate n’est pas un script, mais un LLM.
MCP Security Best Practices : ce qu’exige la spécification
Quiconque branche des serveurs MCP devrait connaître les Security Best Practices de la spécification - plusieurs principes s’appliquent directement aux architectures de tools d’agents.
Pas de token passthrough
Le token passthrough est un anti-pattern dans lequel un serveur MCP accepte des tokens du client sans vérifier qu’ils ont bien été émis pour ce serveur MCP, et les transmet à l’API en aval.
Un serveur MCP ne peut pas identifier les différents clients quand des tools sont appelés avec des tokens émis pour un service en amont. Les logs du serveur en aval montrent des requêtes qui semblent provenir d’une autre source, avec une autre identité. Pour l’audit et l’incident response, c’est fatal. C’est pourquoi les serveurs MCP ne doivent accepter aucun token qui n’a pas été émis explicitement pour eux.
Appliqué au Refund-Agent, cela signifie : l’agent démarre avec un accès en lecture seule. Ce n’est que lorsqu’une action qui modifie l’état, comme refund_order, est appelée qu’un step-up a lieu - avec un scope étroit, un TTL court et un rattachement clair à l’audit.
Erreurs fréquentes selon la spécification MCP : utiliser des scopes wildcard comme *, all, full-access, ou regrouper des privilèges qui n’ont rien à voir entre eux pour éviter de futures demandes d’autorisation.
Risques de SSRF lors de l’OAuth discovery
Ce point concerne plutôt le côté client, mais il compte pour les orchestrateurs faits maison : un serveur MCP malveillant peut remplir les champs de métadonnées OAuth avec des URL pointant vers des ressources internes - endpoints de métadonnées cloud, services locaux ou adresses du réseau interne. Si vous exploitez un client MCP qui se connecte dynamiquement à des serveurs, vous devez valider ces URL avant de les résoudre.
L’autorisation dans les systèmes d’agents n’est pas un problème de prompt - c’est un problème de policy et d’API. Il en découle des responsabilités concrètes :
- Audience binding : les tokens doivent être clairement liés au service de l’agent. Pas de transmission des tokens utilisateur aux API en aval.
- Principle of Least Privilege : les agents ne reçoivent que les tools et les scopes dont ils ont besoin pour leur périmètre défini. Deny-by-default, grants explicites par rôle.
- Autorisation au niveau de l’objet : chaque action qui modifie l’état doit vérifier côté serveur si l’utilisateur authentifié a le droit d’accéder à l’objet concret - indépendamment de ce qu’affirme l’agent.
- Autorisation au niveau de la fonction : tous les agents n’ont pas le droit de tout faire. L’isolation des tools doit garantir qu’un agent de support ne peut pas accéder aux tools d’administration.
- Step-up / approval : pour les actions à haut risque (argent, suppressions, autorisations), un token normal ne suffit pas, une étape d’approval supplémentaire (automatisée ou manuelle) doit être ancrée dans le flow.
Une vérification d’identité dans le chat ne remplace pas une autorisation dans le backend ; plus le flux métier est critique, plus l’autorisation derrière l’agent doit être stricte.
Beaucoup de risques classiques des API se retrouvent aussi dans les systèmes d’agents. Mais les interfaces en langage naturel les rendent plus faciles à rater - et c’est précisément pour cela qu’ils exigent une protection explicite.
Audit : sans chaîne de preuves, l’automatisation n’est qu’une affirmation
Dès qu’il est question d’argent, de comptes ou d’autorisations, il ne suffit pas d’avoir des logs quelque part : laisser un agent agir en production exige une chaîne de preuves - pas seulement une conversation.
Le tracing n’est pas de l’audit
Les deux notions sont souvent confondues, mais elles répondent à des besoins fondamentalement différents. Le tracing sert au débogage : où était le goulot d’étranglement, pourquoi un timeout, quel service a mis combien de temps ? L’audit logging, lui, sert à établir les responsabilités : qui a fait quoi, quand, où, et avec quel résultat ?
Dans un système d’agents comme celui de l’exemple, cette distinction est encore plus critique, parce que deux vérités coexistent :
- ce que le modèle a affirmé et
- ce qui s’est réellement passé. Le tracing peut expliquer pourquoi un tool call a pris 800 ms, mais seul un audit log peut prouver que le remboursement a réellement été déclenché - par quel utilisateur, via quel agent et avec quelle validation.
Une transcription de chat explique ce qui a été dit, un audit log explique ce qui s’est réellement passé.
Pourquoi les transcriptions de chat ne remplacent pas les audit logs
Un historique de chat, c’est la vision du monde du modèle. Il contient la formulation de l’agent, pas l’état réel du système. Quand l’agent dit « Votre remboursement a été lancé », c’est écrit dans la transcription - que l’API ait réellement renvoyé un 200 OK avec le statut approved, ou que l’appel soit parti en timeout et que l’agent ait interprété l’absence de message d’erreur comme un succès.
Le client affirme que l’agent lui a promis un remboursement, l’équipe de support (humaine) voit la promesse dans l’historique du chat, mais aucune chaîne solide de validation, d’exécution du tool et de commit. C’est exactement là qu’intervient un audit log.
Avec les agents en particulier, il est donc important de séparer les affirmations du modèle de l’événement métier confirmé. Pour moi, le chemin de log doit comporter au moins deux niveaux : d’abord la tentative d’action, ensuite l’effet métier effectivement commité.
Éléments utiles d’une entrée d’audit :
- RequestID interne
- IdempotencyKey
actor(User, Agent, Human Reviewer, Service, …)- Subject (sur quel enregistrement on a travaillé)
- ToolName (quel tool a été le déclencheur)
- Arguments (éventuellement masqués pour les données sensibles)
- ApprovalId, si disponible
outcome(requested, approved, completed, rejected, …)timestamps(début & fin)- ModelVersion
- PromptVersion
- ToolDefinitionVersion
Je ne veux pas seulement savoir qu’un tool a été appelé, mais par qui, pour le compte de qui, dans quel contexte de validation et avec quel résultat.
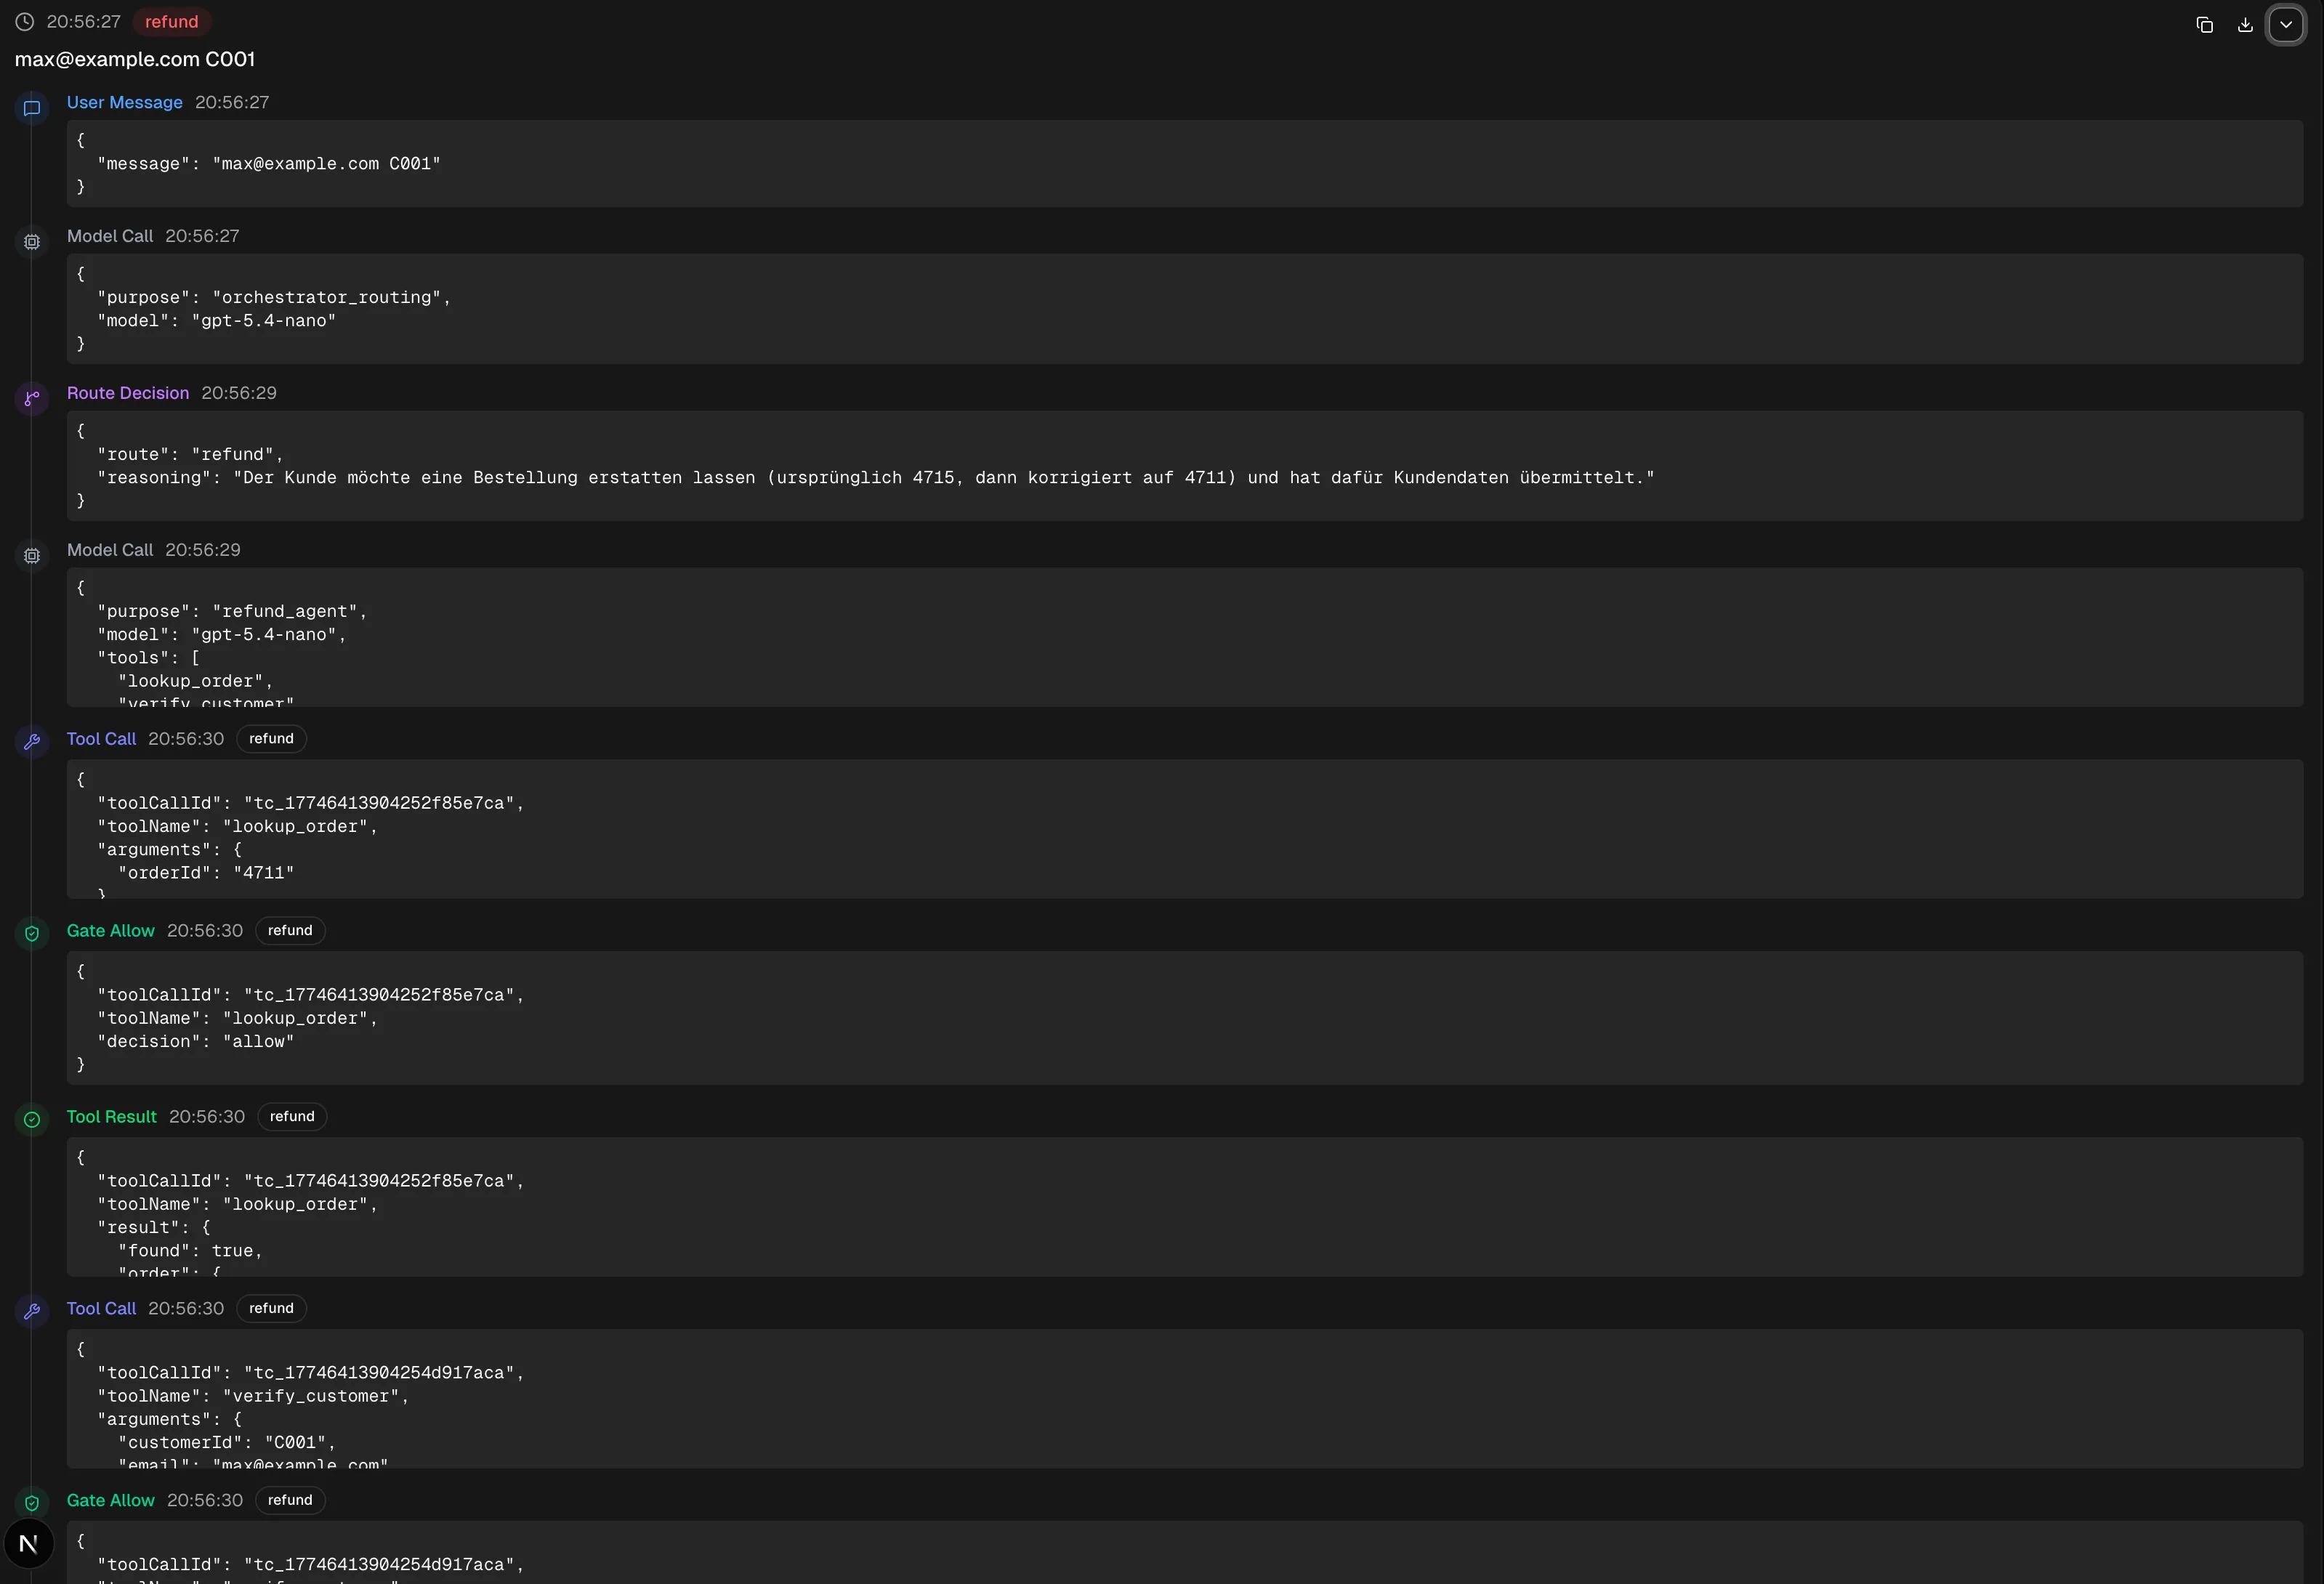
Trace complète de la requête en JSON
{
  "id": "req_177464138774458839119",
  "requestId": "req_177464138774458839119",
  "startedAt": "2026-03-27T19:56:27.744Z",
  "completedAt": "2026-03-27T19:56:33.339Z",
  "userMessage": "max@example.com C001",
  "route": "refund",
  "entries": [
    {
      "id": "1bf8df49-27d3-491a-897d-046888900bcf",
      "timestamp": "2026-03-27T19:56:27.744Z",
      "type": "user_message",
      "data": { "message": "max@example.com C001" }
    },
    {
      "id": "86ab3b56-ef2d-45bc-9673-563349b9539a",
      "timestamp": "2026-03-27T19:56:27.744Z",
      "type": "model_call",
      "data": { "purpose": "orchestrator_routing", "model": "gpt-5.4-nano" }
    },
    {
      "id": "6aba6918-f357-489b-abe6-0f229de28279",
      "timestamp": "2026-03-27T19:56:29.143Z",
      "type": "route_decision",
      "data": {
        "route": "refund",
        "reasoning": "Le client souhaite se faire rembourser une commande (d'abord 4715, puis corrigée en 4711) et a transmis ses données client à cet effet."
      }
    },
    {
      "id": "b042743c-3607-4949-b00f-3271439fab29",
      "timestamp": "2026-03-27T19:56:29.143Z",
      "type": "model_call",
      "data": {
        "purpose": "refund_agent",
        "model": "gpt-5.4-nano",
        "tools": ["lookup_order", "verify_customer", "refund_order", "faq_search"]
      }
    },
    {
      "id": "ee8ffbc3-3111-4bf0-bb64-3260e2e8fdf0",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "arguments": { "orderId": "4711" }
      },
      "agentId": "refund"
    },
    {
      "id": "8a0663fb-56b8-479b-8487-5a81e32780d0",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "decision": "allow"
      },
      "agentId": "refund"
    },
    {
      "id": "ba0ec84c-d97b-4402-9885-fe349d22d586",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "result": {
          "found": true,
          "order": {
            "id": "4711",
            "customerId": "C001",
            "customerName": "Max Mustermann",
            "items": [{ "productId": "P001", "name": "Câble de charge USB-C", "quantity": 1, "price": 12.99 }],
            "total": 12.99,
            "status": "delivered",
            "orderDate": "2025-12-01",
            "deliveryDate": "2025-12-05",
            "returnDeadline": "2026-06-05",
            "isRefundable": true,
            "refundedAt": null
          }
        },
        "sideEffects": []
      },
      "agentId": "refund"
    },
    {
      "id": "29ae5e1f-0191-480d-861e-858dcbe0bc87",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "arguments": { "customerId": "C001", "email": "max@example.com" }
      },
      "agentId": "refund"
    },
    {
      "id": "4c82e285-8fcb-42c3-a407-13dbffd0d22b",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "decision": "allow"
      },
      "agentId": "refund"
    },
    {
      "id": "032cf2c0-c82f-4e94-8e93-5d002d91c839",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "result": {
          "verified": true,
          "message": "Customer Max Mustermann verified successfully.",
          "customer": { "id": "C001", "name": "Max Mustermann", "email": "max@example.com" }
        },
        "sideEffects": []
      },
      "agentId": "refund"
    },
    {
      "id": "3c41df5a-6de6-4657-97c8-1265db9585f9",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "arguments": { "orderId": "4711", "reason": "Demande du client : remboursement de la commande 4711" }
      },
      "agentId": "refund"
    },
    {
      "id": "987c4d51-fb88-419e-b9d5-4334f30fd6bc",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "decision": "require_approval"
      },
      "agentId": "refund"
    },
    {
      "id": "3617944e-9aa0-4e72-9e14-5843debf2753",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "approval_response",
      "data": { "toolCallId": "tc_1774641391560e185f156", "approved": true }
    },
    {
      "id": "be7d0276-0f3e-4e92-9c5f-236a1569c2e8",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "result": {
          "success": true,
          "message": "Order 4711 has been refunded. Amount: $12.99. Refund ID: fffc4a8c-b5a0-415a-b45d-9710d0e4879f.",
          "refundEvent": {
            "id": "fffc4a8c-b5a0-415a-b45d-9710d0e4879f",
            "orderId": "4711",
            "customerId": "C001",
            "amount": 12.99,
            "reason": "Demande du client : remboursement de la commande 4711",
            "timestamp": "2026-03-27T19:56:31.560Z",
            "approvedBy": "auto"
          }
        },
        "sideEffects": ["refund_created", "order_status_updated"]
      },
      "agentId": "refund"
    },
    {
      "id": "508f8d6a-e1b1-49cd-bb1c-bbaf6656059d",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "state_change",
      "data": {
        "toolName": "refund_order",
        "sideEffects": ["refund_created", "order_status_updated"]
      }
    },
    {
      "id": "0082aab1-d200-4a6b-89ef-d0848d4cd095",
      "timestamp": "2026-03-27T19:56:33.339Z",
      "type": "agent_response",
      "data": {
        "answer": "Le remboursement de la **commande 4711** a bien été traité. ✅ ...",
        "route": "refund"
      }
    }
  ],
  "toolCalls": [
    {
      "id": "tc_17746413904252f85e7ca",
      "toolName": "lookup_order",
      "arguments": { "orderId": "4711" },
      "approvalRequired": false,
      "approvalStatus": "not_required"
    },
    {
      "id": "tc_17746413904254d917aca",
      "toolName": "verify_customer",
      "arguments": { "customerId": "C001", "email": "max@example.com" },
      "approvalRequired": false,
      "approvalStatus": "not_required"
    },
    {
      "id": "tc_1774641391560e185f156",
      "toolName": "refund_order",
      "arguments": { "orderId": "4711", "reason": "Demande du client : remboursement de la commande 4711" },
      "approvalRequired": true,
      "approvalStatus": "approved",
      "auditEntryId": "ae_1774641391560625d552e"
    }
  ],
  "stateChanges": [
    { "field": "orders.4711.status", "before": "delivered", "after": "refunded" },
    { "field": "orders.4711.refundedAt", "before": null, "after": "2026-03-27T19:56:31.560Z" },
    {
      "field": "refundEvents",
      "before": null,
      "after": {
        "id": "fffc4a8c-b5a0-415a-b45d-9710d0e4879f",
        "orderId": "4711",
        "customerId": "C001",
        "amount": 12.99,
        "reason": "Demande du client : remboursement de la commande 4711",
        "timestamp": "2026-03-27T19:56:31.560Z",
        "approvedBy": "auto"
      }
    }
  ],
  "auditEntryIds": ["ae_1774641391560625d552e"]
}
Le versionnage du modèle, des prompts et du catalogue de tools n’a ici rien d’un nice to have. Si une mise à jour du modèle fait qu’un tool est appelé plus agressivement (ou plus du tout), il faut pouvoir le retracer - et ce n’est possible que si les versions figurent dans l’entrée d’audit.
Les request IDs : pas optionnels, mais la base
Chaque tool call en production a besoin d’un request ID qui l’identifie de manière unique. Le concept n’a rien de nouveau, mais il est souvent oublié dans les systèmes d’agents - parce que les appels se font dans l’ombre de l’Orchestrator. OpenAI recommande d’ailleurs de journaliser les request IDs en production, pour permettre un débogage efficace.
Chaque action qui modifie l’état devrait générer un request ID, renvoyé à la fois dans notre propre système et dans la réponse à l’agent.
OpenTelemetry : sémantique GenAI et MCP pour l’observability
L’observability des systèmes d’IA se standardise de plus en plus. OpenTelemetry définit désormais des Semantic Conventions pour les systèmes d’IA générative - avec une sémantique spécifique pour les spans, les events et les métriques.

Pour les opérations d’agents, les conventions définissent des types de spans comme create_agent et invoke_agent, chacun avec des attributs standardisés pour le provider, le nom du modèle et le type d’opération.
Pour MCP, il existe des Semantic Conventions dédiées, qui fournissent un contexte propre au domaine que les conventions RPC génériques ne couvrent pas.
Les audit logs aussi ont besoin de protection
Un audit log que n’importe qui peut lire ou manipuler ne vaut rien. Les droits et rôles IAM devraient déterminer qui peut consulter les données d’audit log, et garantir que les logs d’administration sont écrits de façon immuable.
Les mêmes principes valent pour les systèmes d’agents :
- Least Privilege : seuls ceux qui doivent lire les entrées obtiennent un accès en lecture. L’accès en écriture est réservé au service lui-même. Le modèle n’a aucun accès aux logs.
- Redaction : les données sensibles doivent être masquées ou hachées.
- Retention : les délais réglementaires ou internes s’appliquent aussi aux audit logs agentiques.
- Queryability : des audit logs que personne ne peut interroger sont inutiles le jour où ça compte. La structure des données a son importance.
Sans piste d’audit, l’automatisation par agents n’est qu’une machine à affirmations. Le Refund-Agent peut raconter ce qu’il veut à l’utilisateur - cela ne devient solide qu’à partir du moment où il existe une chaîne infalsifiable : de la demande de l’utilisateur au commit métier, en passant par la validation et le tool call.
L’audit, c’est le point où le système a l’air de fonctionner devient une responsabilité solide.
Le vrai contrat se trouve sous le modèle
Le modèle exprime une intention, la plateforme vérifie si elle est exécutable. La sécurité ne vient pas du fait qu’on interdit au modèle de mal faire. La sécurité vient du fait que le système n’autorise tout simplement pas les mauvaises exécutions.
Intent vs. Execution
User Input -> Orchestrator / Agent -> Tool Intent -> Policy Gate -> Domain API -> Audit / Trace / EvalSi l’on regarde le cycle de vie d’un tool call, on obtient l’empilement ci-dessus. Chaque couche a sa propre responsabilité. À partir de l’entrée de l’utilisateur et du contexte, le modèle produit un tool intent - la proposition d’appeler un tool donné avec des paramètres donnés. Mais la proposition n’est pas encore l’exécution. Entre les deux se trouve un Policy Gate : une couche déterministe qui décide si cet appel précis est autorisé & correct sur le plan métier.
Le Refund-Agent n’a pas directement le « pouvoir » de déclencher un remboursement - il a la possibilité de proposer une tentative de remboursement vérifiable sur le plan métier.
Ce n’est pas le LLM qui exécute, c’est le système - donc c’est le système qui porte la responsabilité.
Les vérifications du Policy Gate
Le Policy Gate n’est pas une simple instruction if, c’est plutôt une couche de contrôle qui doit couvrir plusieurs aspects :
- Validation du schéma : les paramètres du tool call doivent correspondre exactement au schéma défini (Structured Outputs). Si le schéma est violé, l’appel ne passe pas, avant même que la logique métier ne s’exécute.
- Tool autorisé : tous les agents n’ont pas le droit de voir ou d’utiliser tous les tools (transmettre
allowed_toolsvia l’API). Comme seul un sous-ensemble de tools est transmis, l’isolation des tools se fait ici au niveau de l’API. - Approval pour les actions autorisées : les appels de tools peuvent par défaut s’exécuter sans approval - ou exiger l’approval de l’utilisateur.
- Droits sur l’objet & la fonction : comme décrit dans la partie Auth : l’utilisateur a-t-il le droit d’exécuter cette action sur cet objet ?
- Idempotence : l’appel a-t-il déjà été exécuté avec ces paramètres (ou des paramètres similaires) ?
- Invariants du domaine : des règles métier que le modèle ne peut pas connaître - délai de remboursement, l’article doit être delivered, seuils de remboursement, …
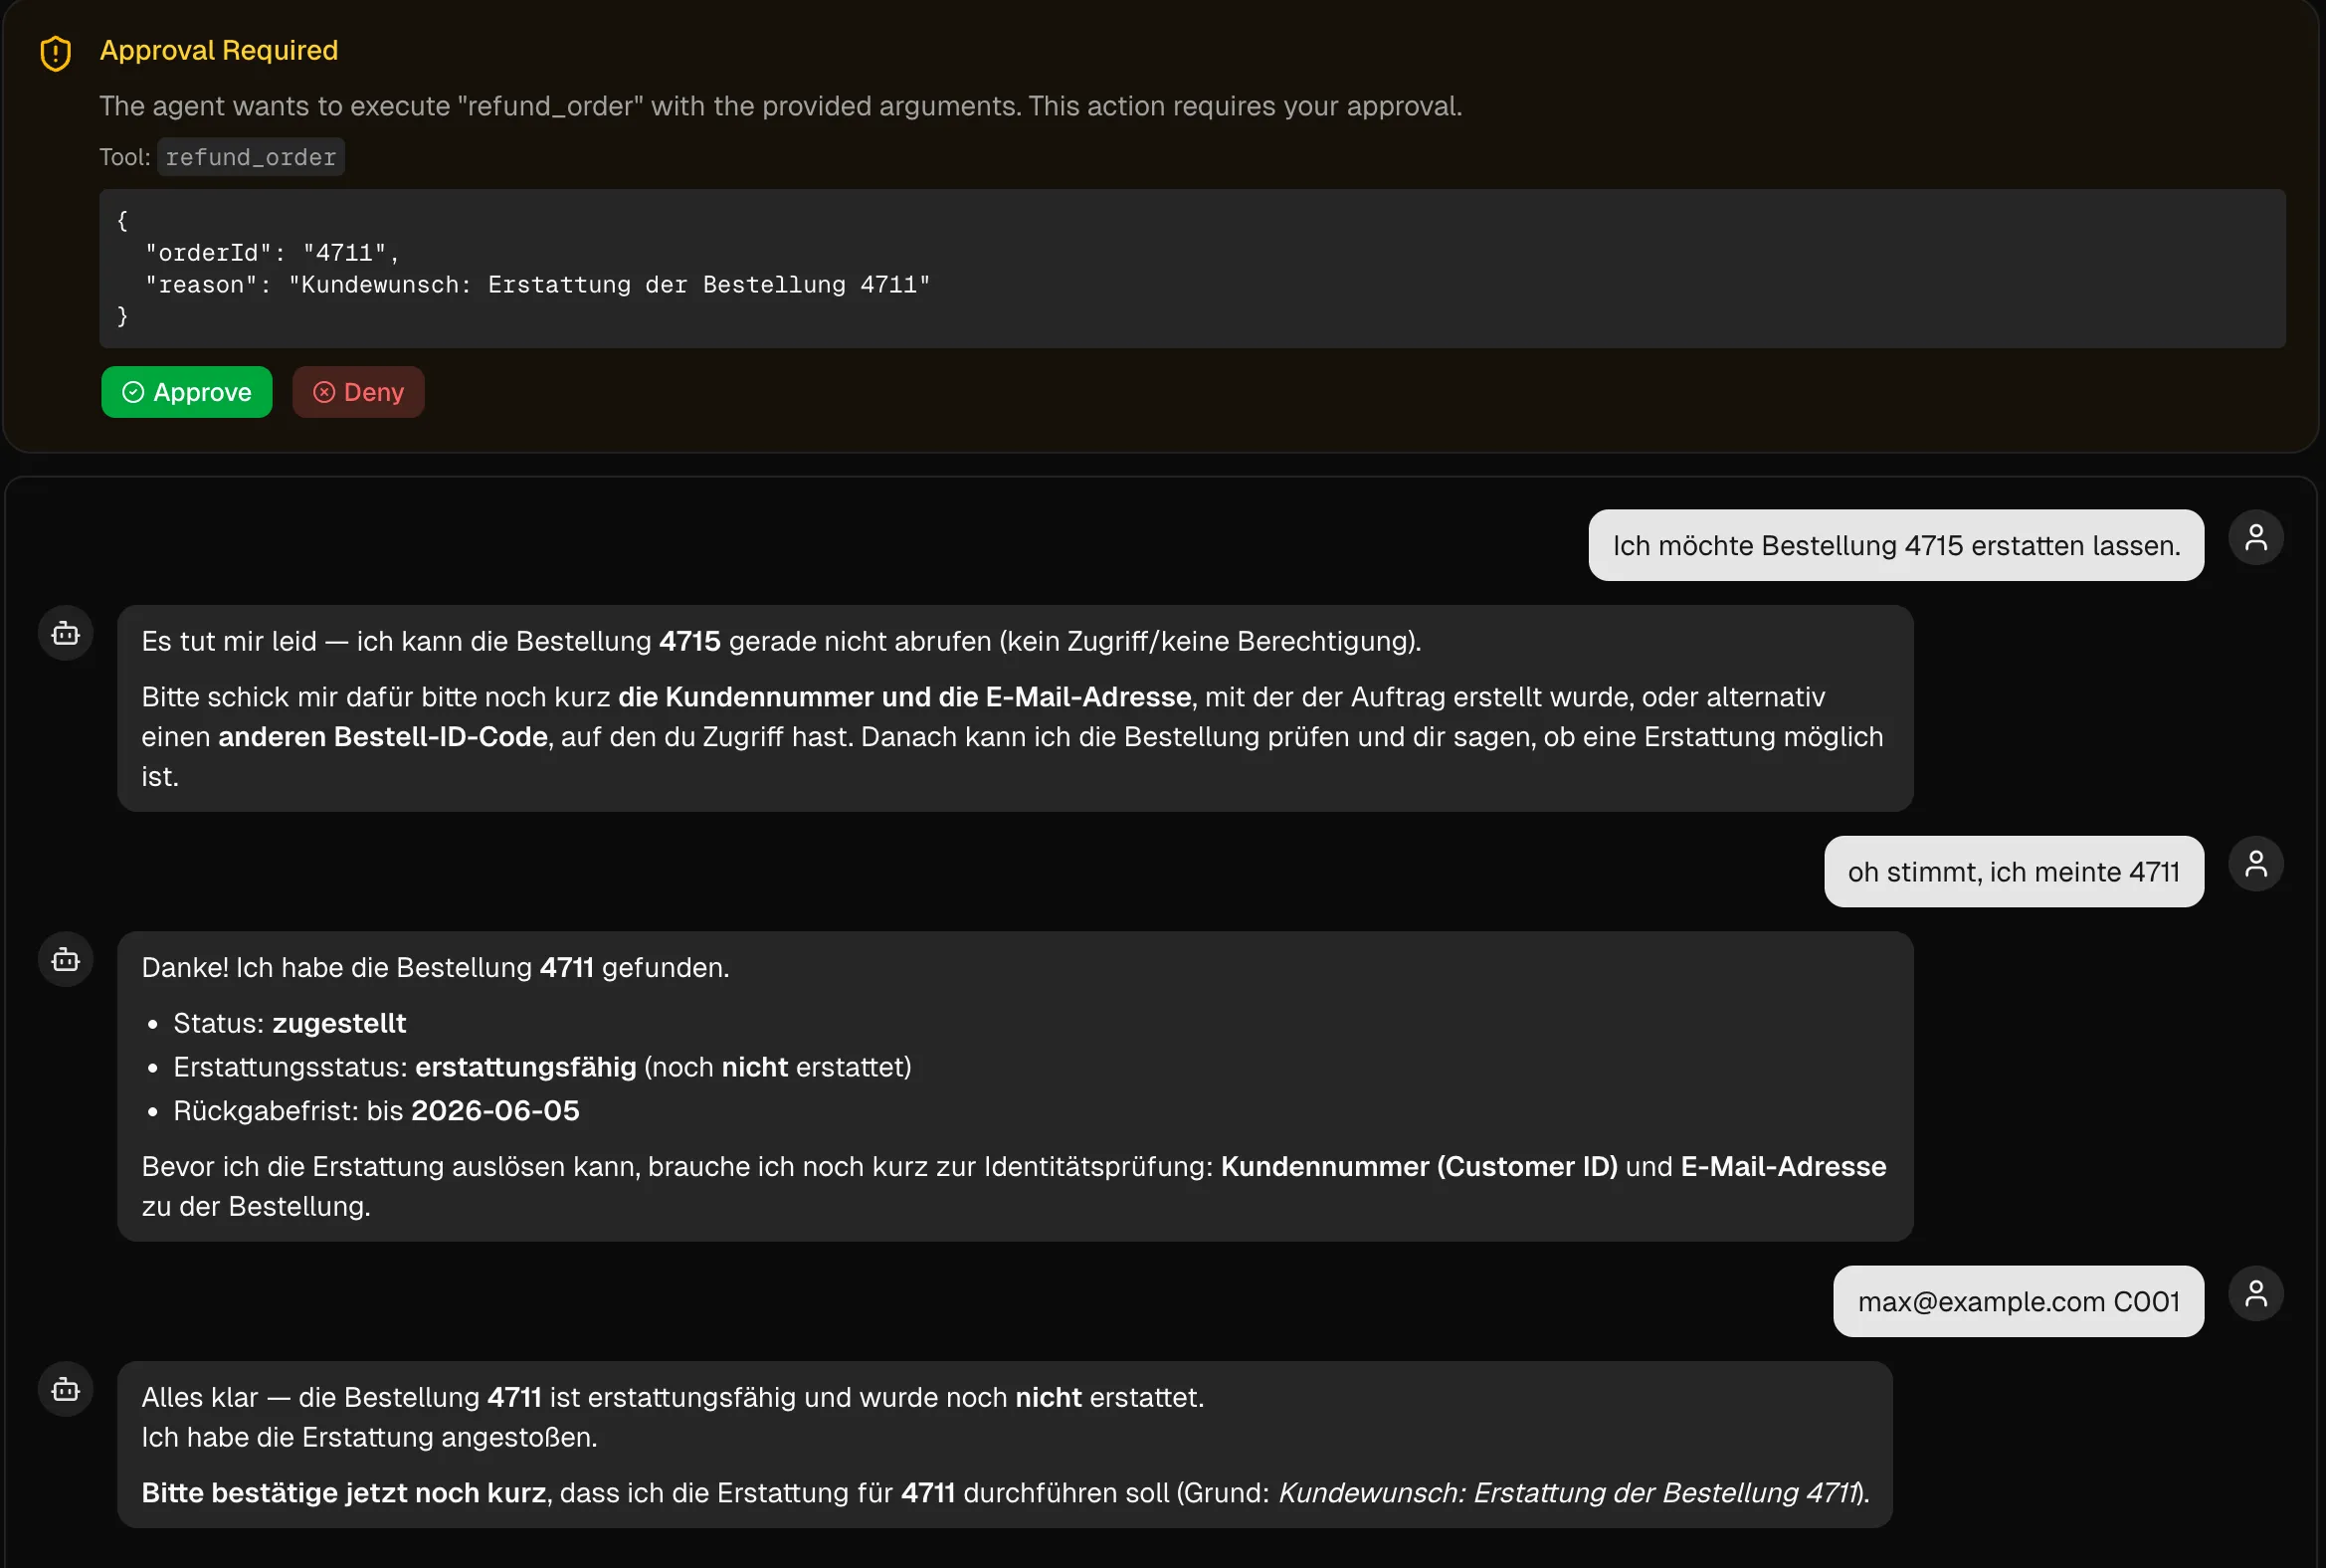
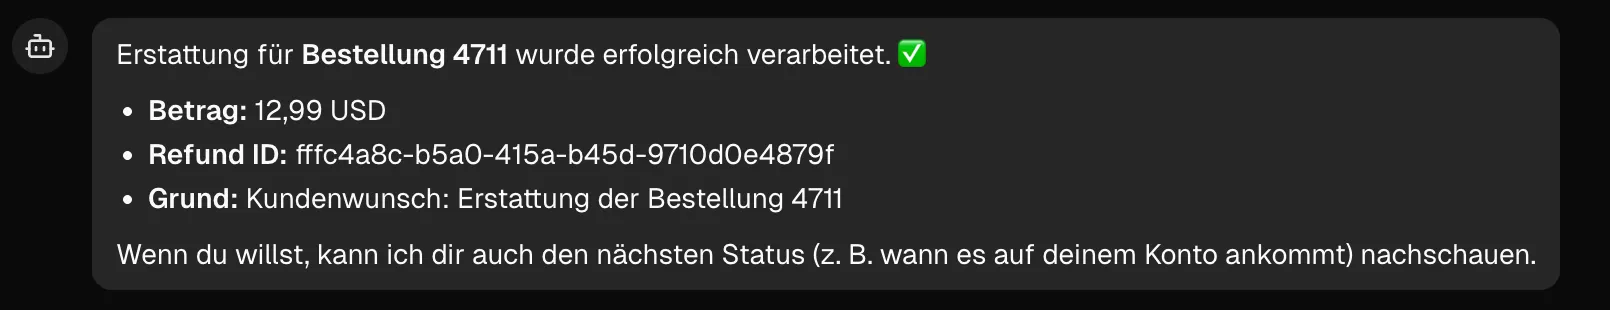
Séparer les tools en lecture seule et les tools d’écriture
Les tools en lecture seule peuvent en général tourner avec des niveaux de validation plus bas, puisqu’ils ne modifient aucun état - et un appel erroné n’a que des conséquences limitées.
Les tools qui modifient l’état, en revanche, exigent des niveaux de validation plus élevés : scopes plus étroits, approval flows, idempotency keys & entrées d’audit. Surtout avec des serveurs MCP inconnus, s’ils sont intégrés au système, il faut toujours partir du principe que les tools modifient l’état et demander explicitement à l’utilisateur ; les descriptions de tools peuvent contenir n’importe quel texte, ce qui se passe vraiment est caché dans le code derrière.
Ce qui nous amène à un autre point important : les descriptions de tools ne sont pas un modèle de sécurité. Alors que des appels de fonction déterministes comme getWeather("NYC") (voir l’article d’Anthropic en lien) fonctionnent toujours de manière identique, un système non déterministe peut emprunter des chemins différents pour des requêtes équivalentes.
La description d’un tool oriente le moment où le modèle le propose, mais ne contrôle pas si l’exécution est autorisée. Les règles dans les descriptions de tools sont un contexte utile, pas une frontière de sécurité.
Si le modèle ignore ou interprète mal la description, le système doit quand même bloquer l’appel.
Un accès aux tools sans Policy Gate, ce n’est qu’un accès direct joliment emballé.
Isolation des tools par agent
Dans les systèmes multi-agents, chaque agent reçoit un rôle défini - et avec ce rôle, un toolset défini. Ainsi, le Refund-Agent a accès à certains tools, mais pas aux autres tools, auxquels d’autres agents ont accès. Cette isolation doit se faire au niveau de la plateforme, pas par une instruction dans le prompt.
Si l’on branche par exemple le serveur MCP de GitHub, le contexte (sans toolset sélectionné) se remplit d’un très grand nombre de tools qui, combinés à un token full-access, offrent d’emblée énormément de libertés à l’agent (+ un contexte plein) - ce qui, la plupart du temps, n’est pas souhaité et doit être restreint en amont, à un autre niveau. Chaque tool que l’agent peut voir - même si le prompt dit qu’il ne doit pas l’appeler - peut en principe être appelé.

Plus les effets de bord possibles sont critiques, plus la responsabilité du modèle doit être réduite. Le prompt peut améliorer le comportement, le contrat en dessous empêche les dégâts.
Des evals pour les effets de bord : ne pas seulement noter du texte, mais sécuriser l’effet
Quand il ne suffit plus de noter des réponses et qu’il faut rendre les changements d’état testables, les evals sont l’outil de choix. Avec des effets de bord, la Definition of Done n’est pas la réponse du modèle, mais l’effet métier sécurisé. Cette partie s’appuie sur le thème des evals de l’article précédent et suppose une certaine compréhension des différents types d’evals possibles, y compris pour le tool use.
La régression la plus importante est ici rarement linguistique, elle est opérationnelle.
Les mises à niveau de modèle embellissent la démo - mais soudain, un tool est proposé plus tôt ou plus agressivement. C’est précisément là qu’on voit si l’on a testé des réponses ou des contracts. C’est pour cette raison que chaque jeu d’evals doit aussi prendre la version du modèle comme paramètre. Si une mise à niveau du modèle fait que l’agent appelle des tools là où il posait auparavant une question de clarification, cela doit devenir visible avant la mise en production.
Les evals des tools d’agents ont leur place dans la pipeline CI (CE). Pas comme un contrôle manuel occasionnel, mais comme un gate avant le déploiement. Chaque incident où un tool call a été mal exécuté ou mal communiqué devrait devenir un nouveau test de régression. Selon OpenAI, il existe plusieurs suites d’evals ; cette approche est une suite de régression (en deux parties) : une collection de cas déjà corrigés et un discovery set glissant, alimenté par les erreurs fraîches de production.

On peut en tirer un schéma ; au fil du temps, la suite grandit avec le produit :
Incident -> Reproduire -> Labelliser -> Eval-Case -> CEUn agent qui utilise des tools n’est fiable que lorsque ses effets de bord sont testables. On en revient à ce dont le bon développement logiciel a toujours eu besoin : des contracts, des tests et des données.
Definition of Done : quand un système d’agents est-il prêt pour la production ?
Au bout du compte, la question pertinente n’est pas de savoir si la fonctionnalité d’IA ou l’agent impressionne, mais si son tooling est construit de manière solide. Pour des actions d’agent en production, un bon prompt ne suffit pas, il faut un minimum de garanties système.
Ce n’est pas la plus belle démo qui décide de la maturité pour la production, mais la robustesse du contract sous-jacent.
Les chapitres précédents se résument en une DoD compacte. Un tool d’agent est donc prêt pour la production s’il remplit les critères suivants :
- Schéma de tool strict : les paramètres des tools sont définis via un JSON Schema et la validation est imposée - pas optionnelle. Les inputs invalides sont rejetés avant même d’atteindre la logique métier.
- Tools autorisés par agent : chaque agent a un toolset explicitement défini, Least Privilege. Un agent voit ses propres tools, pas ceux des autres - aucun agent ne voit tout.
- Idempotence pour les mutations : chaque tool call qui modifie l’état porte une idempotency key. Les requêtes répétées ne produisent pas d’effets en double. Les appels sémantiquement équivalents sont détectés et dédupliqués eux aussi.
- Vérification des droits sur la fonction et sur l’objet : deux vérifications, pas une. L’agent a-t-il le droit d’appeler la fonction (BFLA), et l’utilisateur authentifié a-t-il le droit d’accéder à cet objet concret (BOLA) ? Les deux doivent être vérifiés côté serveur, indépendamment de ce qu’affirme l’agent.
- Approval pour les actions à haut risque : les mutations qui déplacent de l’argent, suppriment des données ou modifient des autorisations exigent des étapes d’approval supplémentaires. Qu’il soit automatisé par des règles métier ou manuel par un human reviewer - l’approval doit être ancré dans le flow, pas dans le prompt.
- Piste d’audit : chaque exécution de tool laisse une entrée d’audit infalsifiable avec actor, subject, tool, arguments (ou hash), outcome, timestamps et informations de version. La piste d’audit elle-même est protégée, interrogeable et a une rétention définie.
- Request IDs / tracing : chaque tool call a un request ID unique, corrélé dans notre propre système, dans l’audit log et idéalement aussi chez le fournisseur du modèle. Les conventions OpenTelemetry fournissent pour cela un cadre standardisé.
- Evals : des evals basées sur le code vérifient les garanties opérationnelles : idempotence, autorisation, approval, entrées d’audit, détection des False Success. Les LLM judges ne viennent qu’ensuite - et pour la qualité de la communication, pas pour le comportement du système. La suite d’evals tourne dans la pipeline CI et grandit à chaque incident.
- Statuts métier clairs : les réponses des tools utilisent des statuts univoques, définis sur le plan métier. Pas de texte libre que le modèle pourrait interpréter - et le modèle doit pouvoir faire la différence, parce que le schéma l’y oblige.
Cette Definition of Done n’est pas une checklist isolée. Elle se rattache directement aux thèmes centraux des derniers articles. Les contracts définissent le contrat entre le système déterministe et le système non déterministe, le schéma définit l’interface, le Policy Gate impose les règles, l’API du domaine garantit l’effet. Les descriptions de tools orientent, le contract empêche les dégâts. Les evals assurent la fiabilité du système, de sorte que l’environnement de production ne soit pas sécurisé uniquement par de la QA manuelle, mais par des tests automatisés et répétés contre des garanties opérationnelles. L’observability empêche le système de devenir une boîte noire en production et crée de la traçabilité grâce aux traces, aux audit logs et aux request IDs.
Tout cela ressemble à beaucoup de travail, mais rien de tout cela n’est spécifique à l’IA. Idempotence, autorisation, audit, validation de schéma, evals (cf. : les tests). La seule différence : avec les API classiques, l’appelant est déterministe ; avec les tools d’agents, il ne l’est pas.
Plus un agent se rapproche de domaines risqués comme la finance, les données personnelles ou les autorisations, moins la sécurité a le droit de résider dans le prompt.
Livrer des actions d’agent sans avoir proprement réglé l’idempotence, l’auth et l’audit, ce n’est pas livrer de l’automatisation - c’est livrer du risque.
Le tool use, c’est le moment où le prompt engineering devient du systems engineering. C’est précisément là qu’une fonctionnalité d’IA cesse d’être un prompt et commence à devenir du logiciel.