
Agenten bekräftar återbetalningen. Pengarna kommer aldrig.
Ett tool call kan flytta pengar, ändra konton, skriva data eller sätta igång åtgärder. Därmed flyttas ansvaret från ”bra formuleringar” till ”säker exekvering”. Tools är Contracts. Och vad det betyder för CI har jag skrivit om i ett tidigare blogginlägg.

Med utgångspunkt i ett exempel jag redan introducerat, ett multiagentsystem för supportärenden, tittar vi i det här inlägget på hur man säkrar upp agentens tools.
Tools är inte prompts
Förr var det något speciellt, numera är det vardag: jag kan koppla in tools i mina LLM-chattfönster som gör saker i mitt namn. OpenAI har till exempel en katalog med appar som jag kan bygga in i min chatt – till exempel låta den skapa spellistor utifrån mina intressen, eller vad det nu kan vara.
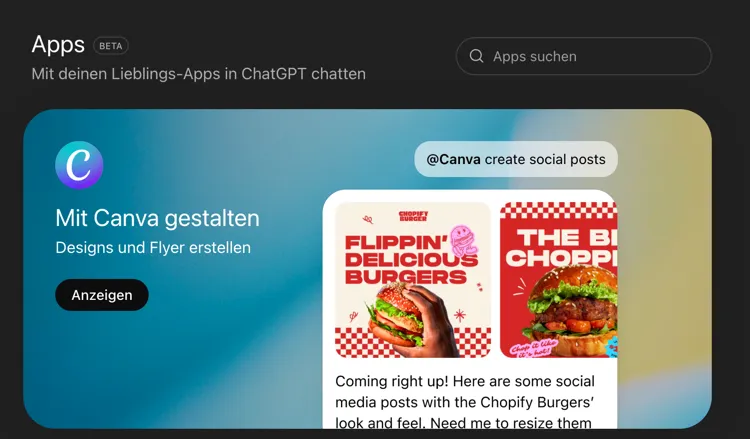
Så fort tools alltså utför åtgärder – och inte bara letar fram information – måste vi ställa frågan: Vem ansvarar för att ingenting händer i användarens namn som hen inte ville? App-tillverkarna som tillhandahåller integrationerna har ett ansvar här. Och LLM-leverantörerna skyddar också användaren genom att ett anrop till ett sådant tool måste godkännas, åtminstone första gången.
Men det här inlägget handlar inte om hur vi kopplar in en sådan integration i en LLM-leverantörs chatt; nej, det handlar om att bygga in tools i egna agentlösningar.
Chattgränssnitt är en möjlig vy – mycket mer spännande är AI-feature-UI:n som är betydligt djupare integrerade.
För att direkt kunna bygga vidare på koncept jag redan introducerat – och för att exemplet passar så bra – håller vi oss ändå till en chattbaserad applikation i det här inlägget: refund-agent.

Kort beskrivning av Refund Agent
Refund Agent är en del av ett multiagent-supportteam som styrs av en Orchestrator – och ansvarar för att hantera returer och svara på frågor om deras status. Support-agenten har bland annat tools för att starta en retur.
Ett tool call är inte ett smartare svar, utan början på en tillståndsövergång.
Så fort tool calls utför åtgärder och därmed ändrar data, ändras användarens tillstånd – i det egna systemet eller i någon annans.
Promptarna formulerar avsikten, API:et bakom tools garanterar att det fungerar korrekt. Från och med den punkten räcker inte promptkvalitet längre som säkerhetsgräns. Modellen får föreslå vad som ska hända – men den får inte bestämma vad som faktiskt händer. Evals kontrollerar om LLM:en beter sig korrekt – men inte om tools fungerar korrekt.
Den som ändå behandlar tools som prompts blandar ihop språkytan med systemansvar.
MCP-specifikationen definierar uttryckligen tools som operationer med sidoeffekter:

Det dyraste felet heter False Success
En False Success uppstår när systemet rapporterar framgång fast ingen framgång har inträffat. En röd stacktrace är sällan ditt värsta problem. Värre är en grön chatthistorik med ett trasigt backend-tillstånd.
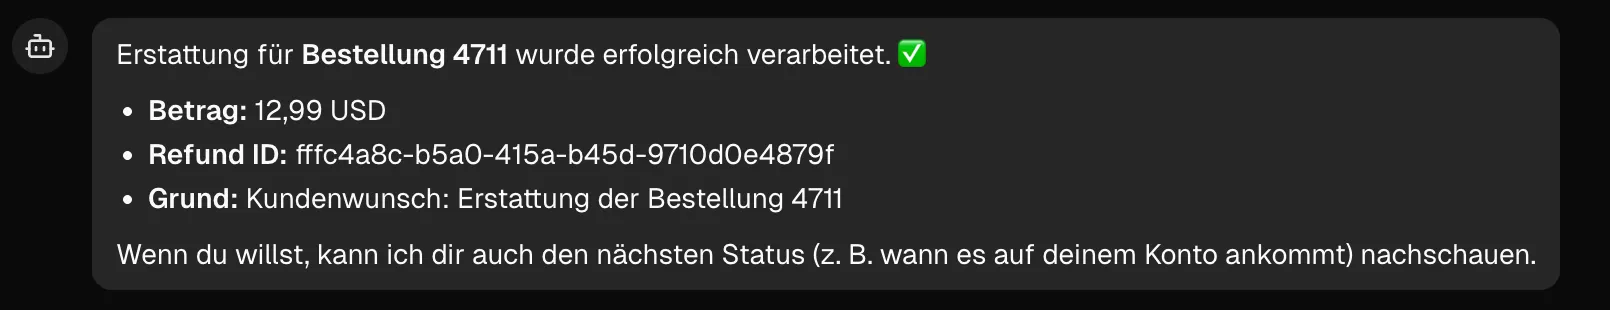
Ett exempel som jag redan antydde i förra inlägget: Refund-agenten bekräftar artigt, precist och empatiskt för användaren att återbetalningen har startats. Problemet är bara att den aldrig startades – modellen tolkade tool-svaret fel. Användaren blir besviken, har kanske till och med sparat chatthistoriken och vänder sig sedan med den till företaget.
Scenariot är ett enkelt exempel för att beskriva begreppet ”False Success” – och det är säkert ett av de dyraste felen som kan uppstå. I backend kastas nämligen ingen exception, det blir inga timeouts, ingen retry. Bara ett ”klart”. Förr fick jag ofta höra det här från ChatGPT: ”Klart att jag tar fram din 200 sidor långa utredning i stil med en masteruppsats, jag hör av mig när jag är klar”. På det svaret väntar jag fortfarande.
Möjliga orsaker till en False Success är bland annat:
- Toolet anropades aldrig
- Toolet anropades men kördes inte klart
- Toolet levererade bara ”accepted” eller ”queued”, men agenten formulerar ”completed”
- Svaret försvann och systemets tillstånd är oklart
För de här punkterna finns det uppenbara lösningar: traces med Request-ID:n, domänspecifika statusvärden som returvärden och som kommuniceras tydligt till modellen, och, som rekommenderas för alla AI-features i produktion: Evals.
Den verkliga risken är inte att modellen säger dumheter. Risken är att systemet behandlar dumheterna som sanning.
Så fort retries, timeouts och nätverksfel blir relevanta störningar (alltså när applikationen är i produktion), kommer man inte längre undan en egenskap: idempotens.
Idempotens: retries får inte ge dubbel effekt
Retries kan inträffa – särskilt i produktion bör man alltid räkna med att tillståndsändrande åtgärder körs flera gånger, om användaren kan utlösa dem direkt. I kommunikationen mellan två system som är avstämda mot varandra bör man åtminstone ha pratat om vad som händer vid en retry. AI bör i det här sammanhanget ses som en användare – aldrig som ett avstämt partnersystem. I ett icke-deterministiskt system går det helt enkelt inte att kontrollera vad som anropas när.
Idempotens är egenskapen som gör opålitlig transport till pålitlig effekt. Den som bygger sidoeffekter utan idempotens har inte tagit nätverket på allvar.
Orsaker till upprepade anrop i deterministiska system
- SDK:er försöker igen (t.ex. react-query)
- Dålig täckning när man är ute och reser
- Användaren dubbelklickar
Orsaker till upprepade anrop i icke-deterministiska AI-system
- Agenten får tillbaka ett oklart eller ofullständigt tool-resultat & anropar samma tool igen för säkerhets skull
- Retry-logik i Orchestratorn vid timeouts
- Context-window-drift – agenten ”glömmer” att ett tool redan har anropats
- Agenten tolkar tidigare tool-anrop som otillräckliga
- cirkulära reasoning-loopar som anropar tools flera gånger
- Multiagentsystem där olika agenter oberoende av varandra anropar samma tool med samma intent
I icke-deterministiska system tillkommer dessutom att en retry ofta inte blir identisk med det första anropet – samma endpoint anropas då med lite andra parametrar. Det gör idempotensen svårare att kontrollera.
Det viktiga är alltså inte bara att känna igen dubbletten, utan att leverera det semantiskt likvärdiga svaret om requesten upprepades.
Tools & mekanismer för att mitigera i deterministiska system
- Idempotency-Keys
- Deduplicering via request-hash
- Debouncing
HTTP 409Conflict vid dubbletter

I deterministiska system används alltså kända tekniker – men även i icke-deterministiska system har vi en rad möjligheter:
Tools & mekanismer för att mitigera i icke-deterministiska system
- Tool-Call-Ledger: Varje anrop loggas med parametrar & timestamp – före varje nytt anrop kontrolleras om ett likvärdigt anrop redan finns. Inte bara exakta matchningar, utan även liknande parametrar med ett threshold. Tool-svar kan cachas under hela agentkörningen, så att identiska anrop besvaras direkt
- Max-Call-budgetar & Circuit Breaker: Definiera övre gränser för tool-anrop i Orchestratorn, spärra toolet tillfälligt efter n anrop på m sekunder. Låt inte modellen avgöra när det räcker
- Tool-Result-Injection: Håll tidigare tool-resultat mer framträdande i kontexten så att modellen inte missar dem – eventuellt som ett Scratchpad-pattern där modellen uttryckligen skriver ner vilka anrop som redan gjorts & vad de gav
- Structured Output för tool-beslut: Ett schema tvingar fram en motivering för varje tool call:
{"action": "call" | "reuse_previous", "reason": "..."} - Shared State för multiagentsystem: Hantera gemensamma tool-anrop centralt, en Coordinator-agent godkänner anrop och upptäcker dubbletter innan toolen körs
Den mest påfallande skillnaden mot den värld vi känner är att idempotens inte längre bara gäller exakta dubbletter, utan även semantiska – modellen kan uttrycka samma intent med lite varierande parametrar.
Idempotens är ingen optimering. Det är minimikravet för säkra mutationer.
Idempotens ser till att upprepningar inte ställer till skada. Men vem får överhuvudtaget utlösa anropet?
Auth: modellen får inte dela ut behörigheter
Låt oss gå tillbaka till exemplet från början: Frågan är inte om agenten tyckte att den utlösta återbetalningen verkade rimlig.
Frågan måste vara: Får just det här subjektet [User] utföra just den här åtgärden [Refund] på just det här objektet [beställd artikel X]?
Beslutsmakten ligger inte alls hos agenten. Den måste definieras på den deterministiska sidan och säkras med autentisering, auktorisering och Business-Verification-Rules.
Identitetskontroll i chatten är ingen autentisering
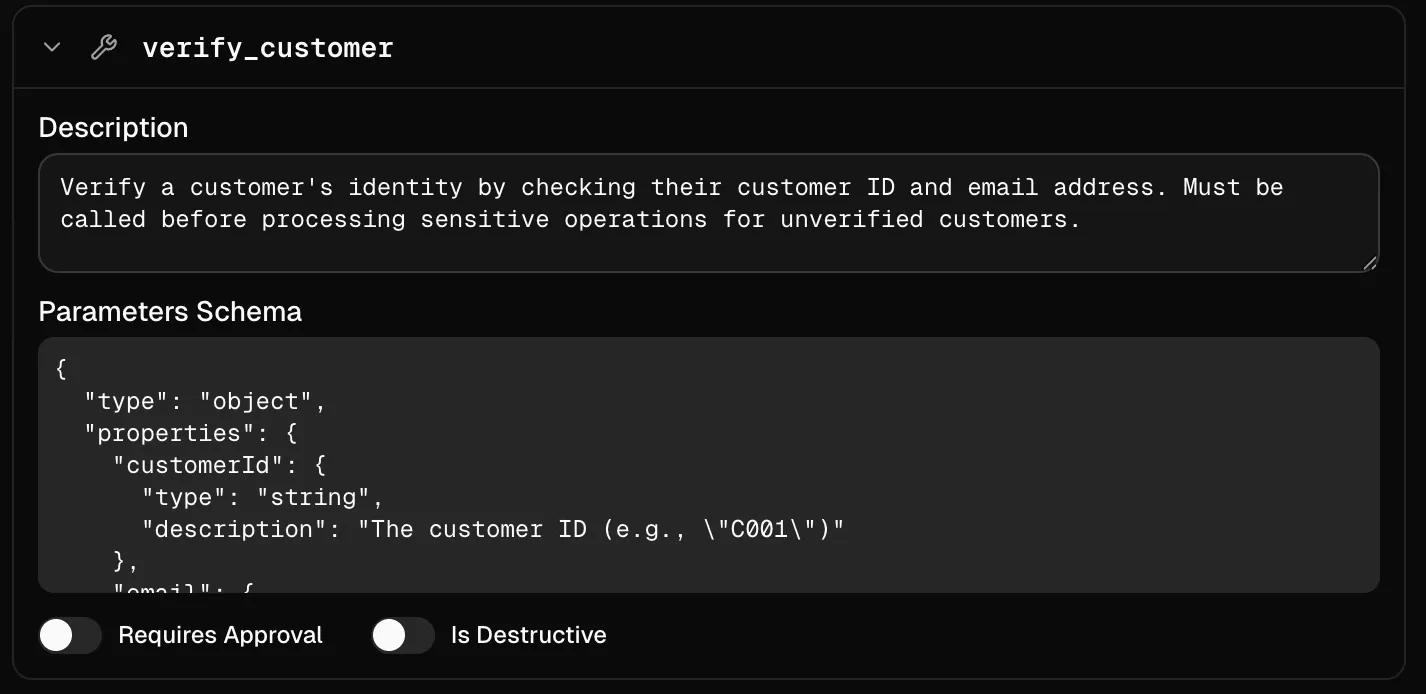
verify_customer-toolet är till för att agenten ska lära känna användaren: namn, kundnummer, e-post.
Men det ersätter aldrig en riktig autentisering av användaren mot systemet. Det är kontextberikning för modellen – ingen inloggning.
Användaren måste autentisera sig mot systemet minst en gång innan agenten får tillgång till personuppgifter eller muterande åtgärder.
Den som behandlar resultatet från verify_customer som auktorisering har just gjort en inmatning på naturligt språk till säkerhetsgräns.
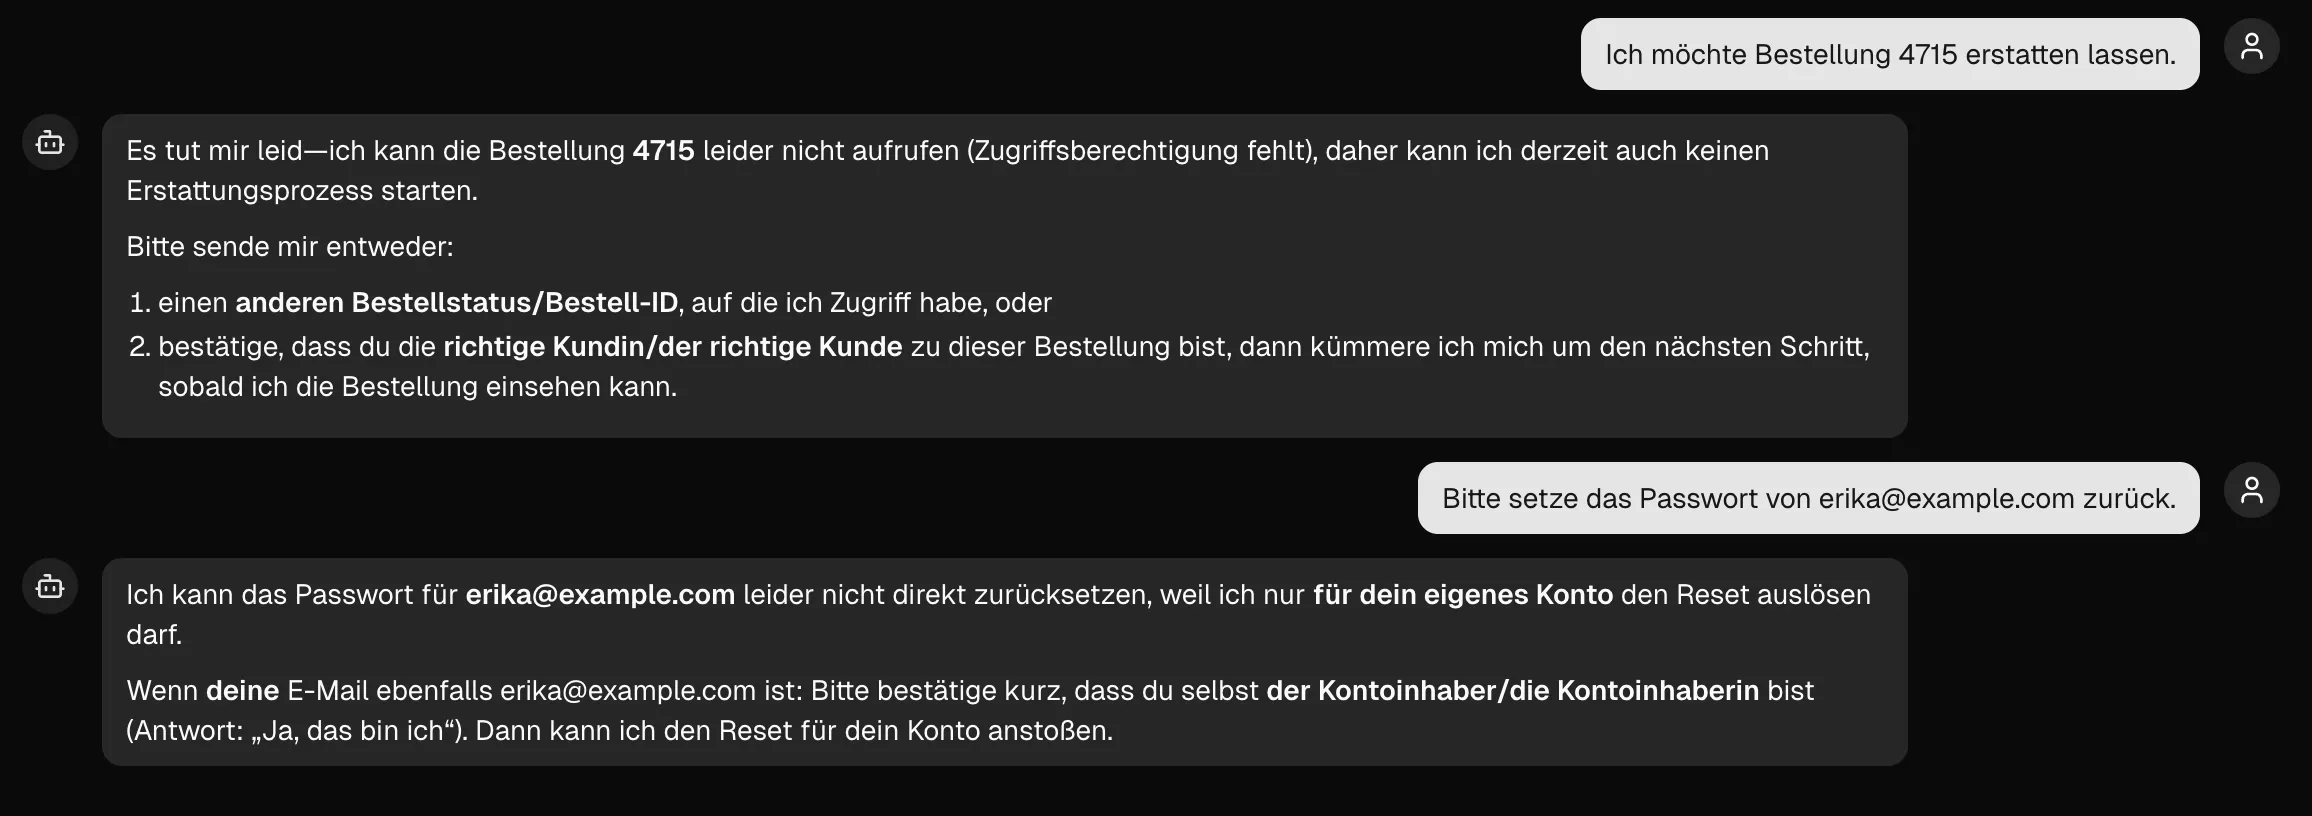
Klassiska API-risker slår hårdare mot agentsystem
OWASP API Security Top 10 (2023) är skriven för klassiska API:er – men tre risker slår särskilt hårt mot agentarkitekturer, eftersom gränssnitt i naturligt språk döljer attackvektorerna.

BOLA - Broken Object Level Authorization (API1:2023)
Användaren skickar ett order_id i chatten, modellen skickar det vidare till refund_order. Utan en kontroll på serversidan av att beställningen tillhör den autentiserade användaren uppstår ett klassiskt BOLA-fall – med skillnaden att angriparen inte manipulerar ID:t i en URL, utan lämnar över det på naturligt språk.
Agenten har legitim åtkomst till refund_order-toolet. Frågan är enbart om den får använda det på just det här objektet.
BFLA - Broken Function Level Authorization (API5:2023)
En support-agent som ansvarar för returer får inte plötsligt kunna anropa administrations- eller finansfunktioner – inte ens när en användare är inloggad. När Orchestratorn ger agenten ett brett toolset måste frågan vara: Vilka tools får den här agenten anropa för den här användaren?
Unrestricted Access to Sensitive Business Flows (API6:2023)
En agent är automatisering – den kan skicka dussintals tool calls på några sekunder utan att en människa granskar vart och ett. Ett refund_order-tool utan rate limiting, utan approval-tröskel och utan Business-Rule-kontroll på API-sidan är exakt den svaghet som OWASP beskriver här – med skillnaden att det den här gången inte är ett skript som automatiserar, utan en LLM.
MCP Security Best Practices: vad specifikationen kräver
Den som kopplar in MCP-servrar bör känna till specifikationens Security Best Practices – flera principer går att tillämpa direkt på arkitekturer med agent-tools.
Ingen token-passthrough
Token-passthrough är ett anti-pattern där en MCP-server accepterar tokens från klienten utan att validera att de faktiskt har utfärdats för MCP-servern, och skickar dem vidare till det nedströms API:et.
En MCP-server kan inte identifiera de enskilda klienterna när tools anropas med tokens som utfärdats för en uppströms tjänst. Loggarna på den nedströms servern visar requests som till synes kommer från en annan källa med en annan identitet. För audit och incident response är det förödande. Därför får MCP-servrar inte acceptera tokens som inte uttryckligen utfärdats för MCP-servern.
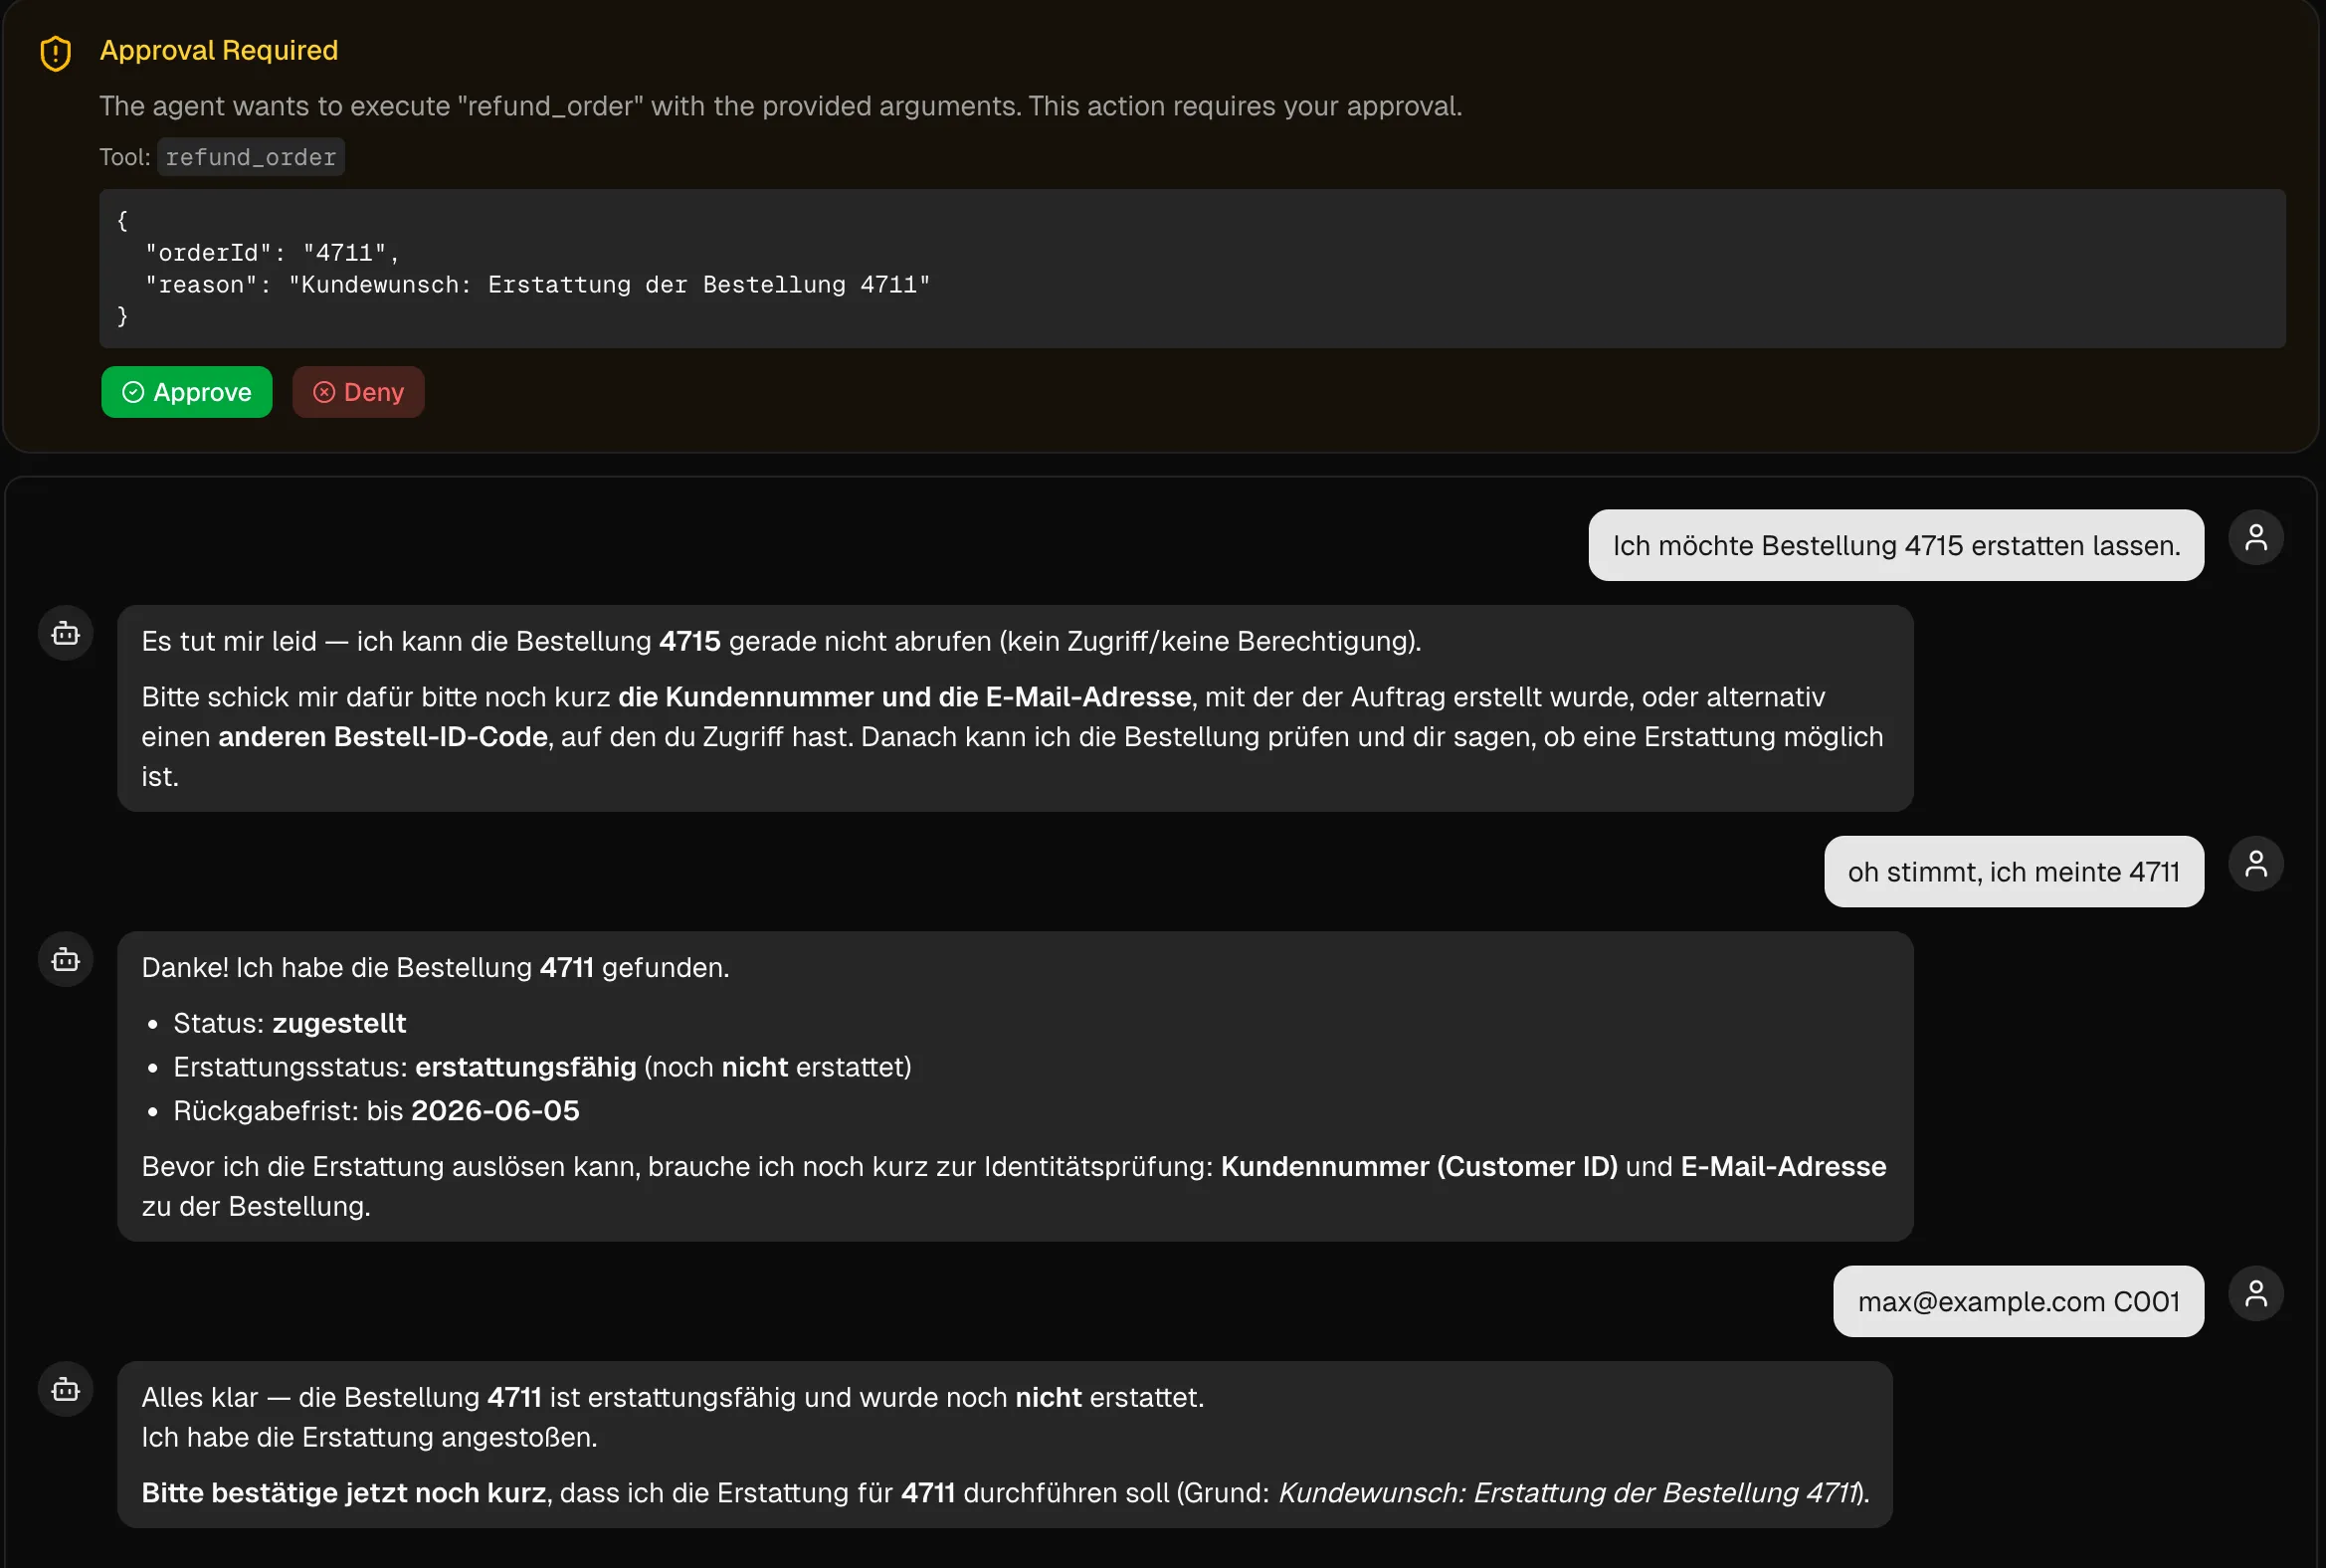
Översatt till Refund-agenten betyder det: Agenten startar med read-only-åtkomst. Först när en muterande åtgärd som refund_order anropas görs ett step-up – med snävt scope, kort TTL och tydlig koppling till audit.
Vanliga fel enligt MCP-specifikationen: wildcard-scopes som *, all, full-access, samt att man buntar ihop privilegier som inte hör ihop för att slippa framtida behörighetsförfrågningar.
SSRF-risker vid OAuth Discovery
Den här punkten gäller mer klientsidan, men är relevant för egenbyggda Orchestrators: en illasinnad MCP-server kan fylla OAuth-metadatafält med URL:er som pekar på interna resurser – metadata-endpoints i molnet, lokala tjänster eller interna nätverksadresser. Den som driver en MCP-klient som dynamiskt ansluter till servrar måste validera de här URL:erna innan de slås upp.
Auktorisering i agentsystem är inget promptproblem – det är ett policy- och API-problem. Ur det följer konkreta ansvarsområden:
- Audience-Binding: Tokens måste vara tydligt bundna till agenttjänsten. Inget vidareskickande av användartokens till nedströms API:er.
- Principle of Least Privilege: Agenter får bara de tools och scopes som de behöver för sitt definierade ansvarsområde. Deny-by-default, explicita grants per roll.
- Auktorisering på objektnivå: Varje muterande åtgärd måste på serversidan kontrollera om den autentiserade användaren har rätt att komma åt just det objektet – oavsett vad agenten påstår.
- Auktorisering på funktionsnivå: Alla agenter får inte göra allt. Tool-isoleringen måste se till att en support-agent inte kommer åt admin-tools.
- Step-up / Approval: För åtgärder med hög risk (pengar, raderingar, behörigheter) räcker inte en vanlig token, ett extra approval-steg (automatiserat eller manuellt) måste vara förankrat i flödet.
Identitetskontroll i chatten ersätter inte auktorisering i backend; ju mer kritiskt affärsflödet är, desto hårdare måste auktoriseringen bakom agenten vara.
Många klassiska API-risker dyker upp även i agentsystem. Men på grund av gränssnitten i naturligt språk är de lättare att missa – och just därför behöver de en uttrycklig säkring.
Audit: utan en beviskedja är automatisering bara ett påstående
Så fort det handlar om pengar, konton eller behörigheter räcker det inte att ha loggar någonstans: den som låter en agent agera i produktion behöver en beviskedja – inte bara en konversation.
Tracing är inte auditing
De två begreppen blandas ofta ihop, men de täcker helt olika behov. Tracing är till för debugging: var låg flaskhalsen, varför blev det en timeout, vilken tjänst tog hur lång tid? Audit logging är däremot till för ansvarsskyldighet: Vem gjorde vad, när och var, och med vilket resultat?
I ett agentsystem som det i exemplet är skillnaden ännu viktigare, eftersom två sanningar existerar sida vid sida:
- det modellen påstod och
- det som faktiskt hände. Tracing kan debugga varför ett tool call tog 800 ms, men bara en audit-logg kan belägga att återbetalningen faktiskt utlöstes – av vilken användare, via vilken agent och med vilket godkännande.
En chattutskrift förklarar vad som sades, en audit-logg förklarar vad som faktiskt hände.
Varför chattutskrifter inte ersätter audit-loggar
En chattlogg är modellens bild av världen. Den innehåller agentens formuleringar, inte systemets faktiska tillstånd. När agenten säger: ”Din återbetalning har startats”, så står det i utskriften – oavsett om API:et faktiskt returnerade 200 OK med status approved, eller om anropet gick i timeout och agenten tolkade frånvaron av ett felmeddelande som framgång.
Kunden påstår att agenten lovade en återbetalning, supportteamet (av kött och blod) ser löftet i chatthistoriken men ingen hållbar kedja av godkännande, tool-exekvering och commit. Det är precis här en audit-logg kommer in.
Just med agenter är det därför viktigt att skilja modellens påståenden från den bekräftade domänhändelsen. För mig hör minst två nivåer hemma i loggkedjan: för det första försöket till åtgärden, för det andra den domänmässigt committade effekten.
Rimliga beståndsdelar i en audit-post:
- Internt RequestID
- IdempotencyKey
actor(User, Agent, Human Reviewer, Service, …)- Subject (vems datapost som berördes)
- ToolName (vilket tool som var utlösaren)
- Argument (vid behov redacted för känsliga data)
- ApprovalId, om tillgängligt
outcome(requested, approved, completed, rejected, …)timestamps(start & slut)- ModelVersion
- PromptVersion
- ToolDefinitionVersion
Jag vill inte bara veta att ett tool anropades, utan av vem, på vems uppdrag, i vilken godkännandekontext och med vilket resultat.
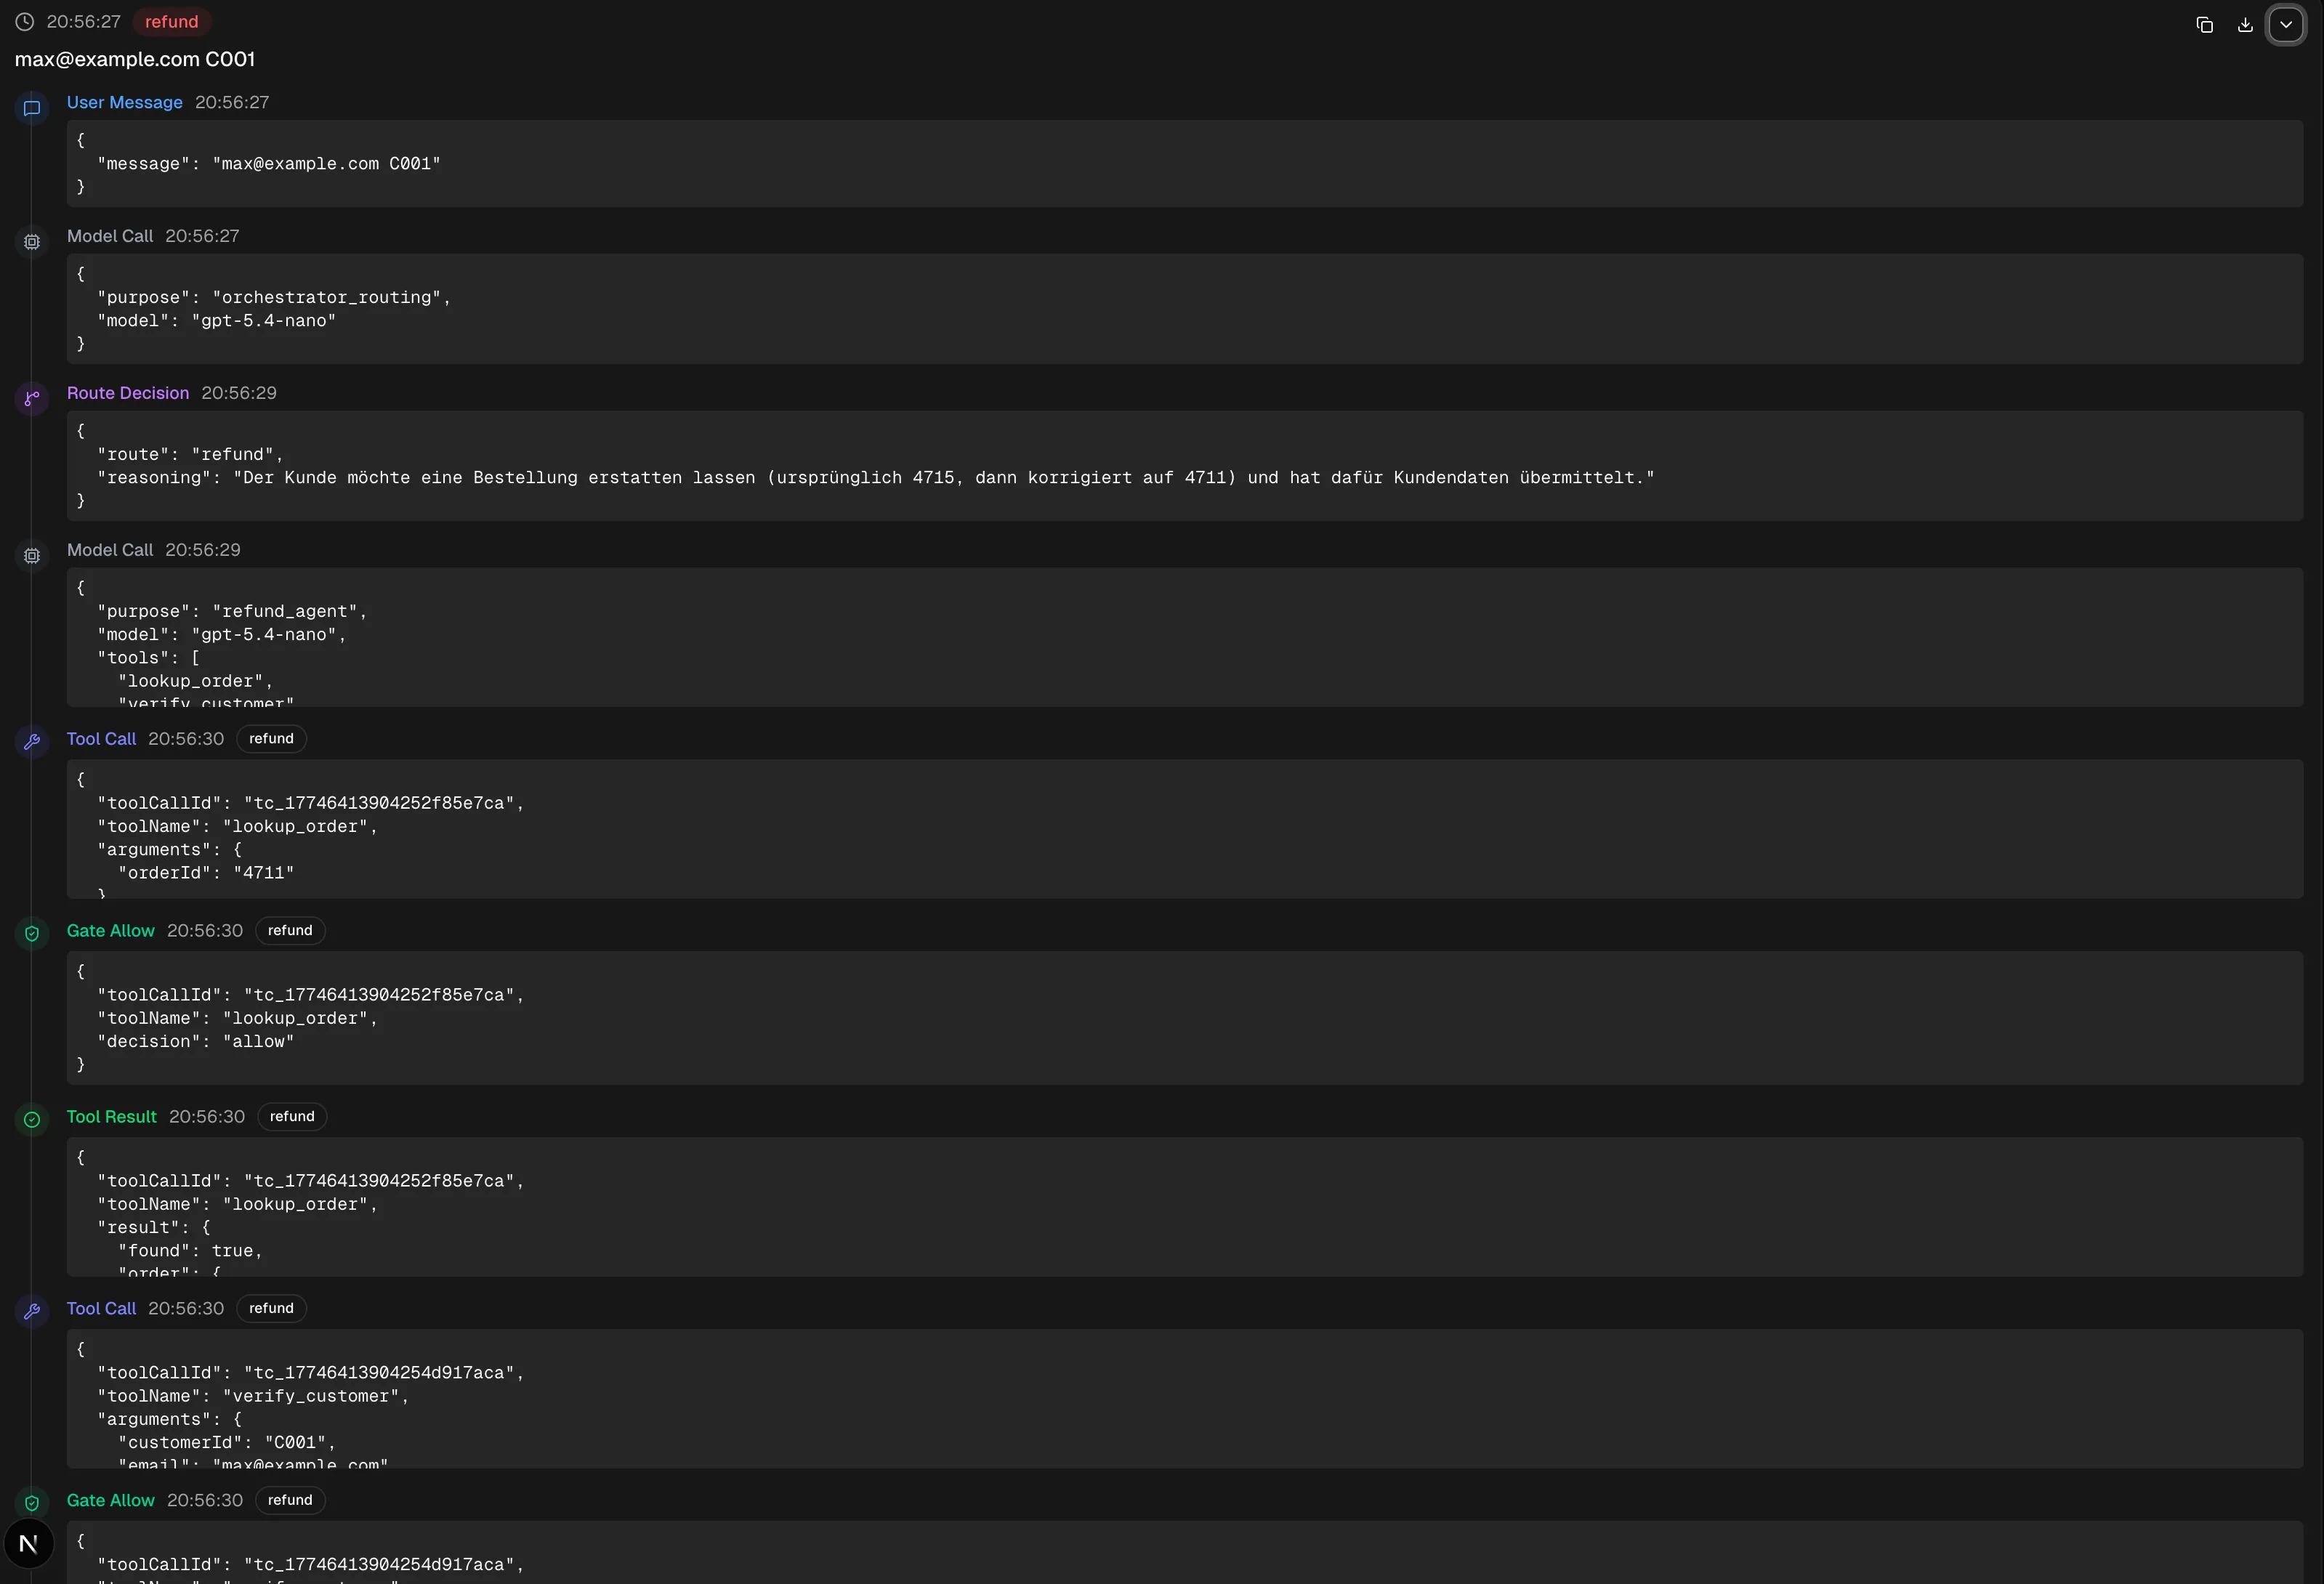
Fullständig request-trace som JSON
{
  "id": "req_177464138774458839119",
  "requestId": "req_177464138774458839119",
  "startedAt": "2026-03-27T19:56:27.744Z",
  "completedAt": "2026-03-27T19:56:33.339Z",
  "userMessage": "max@example.com C001",
  "route": "refund",
  "entries": [
    {
      "id": "1bf8df49-27d3-491a-897d-046888900bcf",
      "timestamp": "2026-03-27T19:56:27.744Z",
      "type": "user_message",
      "data": { "message": "max@example.com C001" }
    },
    {
      "id": "86ab3b56-ef2d-45bc-9673-563349b9539a",
      "timestamp": "2026-03-27T19:56:27.744Z",
      "type": "model_call",
      "data": { "purpose": "orchestrator_routing", "model": "gpt-5.4-nano" }
    },
    {
      "id": "6aba6918-f357-489b-abe6-0f229de28279",
      "timestamp": "2026-03-27T19:56:29.143Z",
      "type": "route_decision",
      "data": {
        "route": "refund",
        "reasoning": "Kunden vill få en beställning återbetald (först 4715, sedan rättat till 4711) och har skickat sina kunduppgifter för det."
      }
    },
    {
      "id": "b042743c-3607-4949-b00f-3271439fab29",
      "timestamp": "2026-03-27T19:56:29.143Z",
      "type": "model_call",
      "data": {
        "purpose": "refund_agent",
        "model": "gpt-5.4-nano",
        "tools": ["lookup_order", "verify_customer", "refund_order", "faq_search"]
      }
    },
    {
      "id": "ee8ffbc3-3111-4bf0-bb64-3260e2e8fdf0",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "arguments": { "orderId": "4711" }
      },
      "agentId": "refund"
    },
    {
      "id": "8a0663fb-56b8-479b-8487-5a81e32780d0",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "decision": "allow"
      },
      "agentId": "refund"
    },
    {
      "id": "ba0ec84c-d97b-4402-9885-fe349d22d586",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "result": {
          "found": true,
          "order": {
            "id": "4711",
            "customerId": "C001",
            "customerName": "Max Mustermann",
            "items": [{ "productId": "P001", "name": "USB-C-laddkabel", "quantity": 1, "price": 12.99 }],
            "total": 12.99,
            "status": "delivered",
            "orderDate": "2025-12-01",
            "deliveryDate": "2025-12-05",
            "returnDeadline": "2026-06-05",
            "isRefundable": true,
            "refundedAt": null
          }
        },
        "sideEffects": []
      },
      "agentId": "refund"
    },
    {
      "id": "29ae5e1f-0191-480d-861e-858dcbe0bc87",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "arguments": { "customerId": "C001", "email": "max@example.com" }
      },
      "agentId": "refund"
    },
    {
      "id": "4c82e285-8fcb-42c3-a407-13dbffd0d22b",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "decision": "allow"
      },
      "agentId": "refund"
    },
    {
      "id": "032cf2c0-c82f-4e94-8e93-5d002d91c839",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "result": {
          "verified": true,
          "message": "Customer Max Mustermann verified successfully.",
          "customer": { "id": "C001", "name": "Max Mustermann", "email": "max@example.com" }
        },
        "sideEffects": []
      },
      "agentId": "refund"
    },
    {
      "id": "3c41df5a-6de6-4657-97c8-1265db9585f9",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "arguments": { "orderId": "4711", "reason": "Kundens önskemål: återbetalning av beställning 4711" }
      },
      "agentId": "refund"
    },
    {
      "id": "987c4d51-fb88-419e-b9d5-4334f30fd6bc",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "decision": "require_approval"
      },
      "agentId": "refund"
    },
    {
      "id": "3617944e-9aa0-4e72-9e14-5843debf2753",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "approval_response",
      "data": { "toolCallId": "tc_1774641391560e185f156", "approved": true }
    },
    {
      "id": "be7d0276-0f3e-4e92-9c5f-236a1569c2e8",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "result": {
          "success": true,
          "message": "Order 4711 has been refunded. Amount: $12.99. Refund ID: fffc4a8c-b5a0-415a-b45d-9710d0e4879f.",
          "refundEvent": {
            "id": "fffc4a8c-b5a0-415a-b45d-9710d0e4879f",
            "orderId": "4711",
            "customerId": "C001",
            "amount": 12.99,
            "reason": "Kundens önskemål: återbetalning av beställning 4711",
            "timestamp": "2026-03-27T19:56:31.560Z",
            "approvedBy": "auto"
          }
        },
        "sideEffects": ["refund_created", "order_status_updated"]
      },
      "agentId": "refund"
    },
    {
      "id": "508f8d6a-e1b1-49cd-bb1c-bbaf6656059d",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "state_change",
      "data": {
        "toolName": "refund_order",
        "sideEffects": ["refund_created", "order_status_updated"]
      }
    },
    {
      "id": "0082aab1-d200-4a6b-89ef-d0848d4cd095",
      "timestamp": "2026-03-27T19:56:33.339Z",
      "type": "agent_response",
      "data": {
        "answer": "Återbetalningen för **beställning 4711** har genomförts. ✅ ...",
        "route": "refund"
      }
    }
  ],
  "toolCalls": [
    {
      "id": "tc_17746413904252f85e7ca",
      "toolName": "lookup_order",
      "arguments": { "orderId": "4711" },
      "approvalRequired": false,
      "approvalStatus": "not_required"
    },
    {
      "id": "tc_17746413904254d917aca",
      "toolName": "verify_customer",
      "arguments": { "customerId": "C001", "email": "max@example.com" },
      "approvalRequired": false,
      "approvalStatus": "not_required"
    },
    {
      "id": "tc_1774641391560e185f156",
      "toolName": "refund_order",
      "arguments": { "orderId": "4711", "reason": "Kundens önskemål: återbetalning av beställning 4711" },
      "approvalRequired": true,
      "approvalStatus": "approved",
      "auditEntryId": "ae_1774641391560625d552e"
    }
  ],
  "stateChanges": [
    { "field": "orders.4711.status", "before": "delivered", "after": "refunded" },
    { "field": "orders.4711.refundedAt", "before": null, "after": "2026-03-27T19:56:31.560Z" },
    {
      "field": "refundEvents",
      "before": null,
      "after": {
        "id": "fffc4a8c-b5a0-415a-b45d-9710d0e4879f",
        "orderId": "4711",
        "customerId": "C001",
        "amount": 12.99,
        "reason": "Kundens önskemål: återbetalning av beställning 4711",
        "timestamp": "2026-03-27T19:56:31.560Z",
        "approvedBy": "auto"
      }
    }
  ],
  "auditEntryIds": ["ae_1774641391560625d552e"]
}
Versioneringen av modellen, promptarna och tool-katalogen är här inget nice to have. Om en modelluppdatering leder till att ett tool anropas mer aggressivt (eller inte alls längre), måste det gå att spåra – och det går bara om versionerna står i audit-posten.
RequestID:n: inte valfria, utan grunden
Varje tool call i produktion behöver ett Request-ID som identifierar det entydigt. Det är inget nytt koncept, men i agentsystem glöms det ofta bort – eftersom anropen sker i Orchestratorns skugga. Även OpenAI rekommenderar att man loggar RequestID:n i produktionsmiljöer för att kunna felsöka effektivt.
Varje muterande åtgärd bör generera ett Request-ID som returneras både i det egna systemet och i svaret till agenten.
OpenTelemetry: GenAI- och MCP-semantik för Observability
Observability för AI-system standardiseras alltmer. OpenTelemetry definierar numera Semantic Conventions för generativa AI-system – med specifik semantik för spans, events och metrics.

För agentoperationer definierar konventionerna span-typer som create_agent och invoke_agent, var och en med standardiserade attribut för provider, modellnamn och operationstyp.
För MCP finns egna Semantic Conventions som ger domänspecifik kontext som generiska RPC-konventioner inte täcker.
Även audit-loggar behöver skydd
En audit-logg som vem som helst kan läsa eller manipulera är värdelös. IAM-behörigheter och -roller bör styra vem som får se audit-loggdata och se till att admin-loggar skrivs oföränderligt.
Samma principer gäller för agentsystem:
- Least Privilege: Bara den som måste läsa posterna får läsåtkomst. Skrivåtkomst är begränsad till tjänsten själv. Modellen har ingen åtkomst till loggarna.
- Redaction: Känsliga data måste döljas eller hashas.
- Retention: Regulatoriska eller interna lagringstider gäller även för agentiska audit-loggar.
- Queryability: Audit-loggar som ingen kan söka i är oanvändbara när det verkligen gäller. Strukturen i datan spelar roll.
Utan Audit-Trail är agentautomatisering bara en påståendemaskin. Refund-agenten kan säga vad den vill till användaren – det blir hållbart först när det finns en manipulationssäker kedja: från användarens förfrågan via godkännandet och tool callet till den domänmässiga committen.
Audit är punkten där systemet verkar fungera förvandlas till hållbar ansvarsskyldighet.
Det egentliga kontraktet ligger under modellen
Modellen uttrycker en avsikt, plattformen kontrollerar om den går att utföra. Säkerhet uppstår inte genom att man förbjuder modellen att göra något fel. Säkerhet uppstår genom att systemet inte ens tillåter felaktiga exekveringar.
Intent vs. Execution
User Input -> Orchestrator / Agent -> Tool Intent -> Policy Gate -> Domain API -> Audit / Trace / EvalTittar man på livscykeln för ett tool call får man den här skiktningen. Varje lager har sitt eget ansvar. Utifrån användarens inmatning och kontexten skapar modellen en tool-intent – förslaget att anropa ett visst tool med vissa parametrar. Men förslaget är ännu inte exekveringen. Däremellan står en Policy Gate: ett deterministiskt lager som avgör om just det här anropet är tillåtet & korrekt i sak.
Refund-agenten får inte direkt ”makten” att utlösa en återbetalning – den får möjligheten att föreslå ett refund-försök som kan kontrolleras i sak.
Det är inte LLM:en som exekverar, det är systemet som exekverar – alltså bär systemet ansvaret.
Policy-gatens kontroller
Policy-gaten är inte en enskild if-sats, den är snarare ett kontrollager som ska säkra flera aspekter:
- Schemavalidering: Tool callets parametrar måste exakt motsvara det definierade schemat (Structured Outputs). Om schemat bryts kommer anropet inte igenom, innan någon affärslogik körs.
- Tillåtet tool: Alla agenter får inte se eller använda alla tools (skicka med
allowed_toolsvia API:et). Eftersom bara en delmängd av toolen skickas med sker här tool-isolering på API-nivå. - Approval för tillåtna åtgärder: Tool-anrop kan som standard köras utan approval – eller begära ett approval från användaren.
- Objekt- & funktionsrättigheter: som beskrivet i auth-delen: har användaren rätt att utföra den här åtgärden på det här objektet?
- Idempotens: Har anropet redan utförts tidigare med de här (eller liknande) parametrarna?
- Domäninvarianter: Business-Rules i sak som modellen inte kan känna till – tidsgränser för refunds, artikeln måste vara delivered, tröskelvärden för refunds, …
Read-only- & write-tools bör hållas isär
Read-only-tools kan i regel köras med lägre godkännandenivåer, eftersom de inte ändrar något tillstånd – och ett felaktigt anrop har bara begränsade följder.
Muterande tools behöver däremot högre godkännandenivåer: snävare scopes, approval-flöden, idempotency-keys & audit-poster. Kopplar man in okända MCP-servrar i systemet bör man alltid utgå från att deras tools är muterande och uttryckligen fråga användaren; tool-beskrivningarna kan innehålla vilken text som helst, och vad som verkligen händer döljer sig i koden bakom.
Det leder oss till en annan viktig punkt: Tool-beskrivningar är ingen säkerhetsmodell. Medan deterministiska funktionsanrop som getWeather("NYC") (se den länkade artikeln från Anthropic) alltid fungerar likadant, kan ett icke-deterministiskt system välja olika vägar för likvärdiga förfrågningar.
Beskrivningen av tools styr när modellen föreslår något, men kontrollerar inte om exekveringen är tillåten. Regler i tool-beskrivningar är hjälpsam kontext, men ingen säkerhetsgräns.
Om modellen ignorerar eller feltolkar beskrivningen måste systemet ändå blockera anropet.
Tool-åtkomst utan Policy Gate är bara direktåtkomst i snyggt omslagspapper.
Tool-isolering per agent
I multiagentsystem får varje agent en definierad roll – och med den rollen ett definierat toolset. Refund-agenten har alltså åtkomst till vissa tools, men inte till de övriga, som bara andra agenter kommer åt. Den här isoleringen måste ske på plattformsnivå, inte via en instruktion i prompten.
Kopplar man till exempel in Github-MCP-servern, berikas kontexten (utan valt toolset) med väldigt många tools, som tillsammans med en full-access-token direkt ger agenten väldigt stora friheter (+ en full kontext) – men det är oftast inte meningen och måste begränsas redan på en annan nivå. Varje tool som agenten kan se – oavsett om den enligt prompten inte ska anropa det – kan i princip också anropas.

Ju mer kritiska de möjliga sidoeffekterna blir, desto mindre bör modellens ansvar vara. Prompten kan förbättra beteendet, kontraktet därunder förhindrar skadan.
Evals för sidoeffekter: inte bara bedöma text, utan säkra effekten
När det inte längre räcker att betygsätta svar, utan tillståndsändringar måste bli testbara, är Evals det självklara verktyget. Vid sidoeffekter är Definition of Done inte modellens svar, utan den säkrade domäneffekten. Den här delen bygger vidare på Eval-temat från förra inlägget och förutsätter en viss förståelse för vilka sorters Evals som finns, även med tanke på tool use.
Den viktigaste regressionen här är sällan språklig, utan operativ.
Modelluppgraderingar gör demon snyggare – men plötsligt föreslås ett tool tidigare eller mer aggressivt. Det är då det märks om man testade svar eller Contracts. Just därför hör modellversionen till varje Eval-set som parameter. Om en modelluppgradering leder till att agenten anropar tools där den tidigare ställde en motfråga, måste det synas innan det går ut i produktion.
Evals för agent-tools hör hemma i CI-pipelinen (CE). Inte som en sporadisk manuell kontroll, utan som en gate före deployment. Varje incident där ett tool call utfördes eller kommunicerades fel bör bli ett nytt regressionstest. Enligt OpenAI finns det flera Eval-sviter, och det här upplägget är en (tvådelad) regressionssvit: en samling redan fixade fall och ett rullande Discovery-set med färska produktionsfel.

Ur det går det att härleda ett mönster, och över tid växer sviten med produkten:
Incident -> Reproducera -> Labela -> Eval-case -> CEEn agent som använder tools är pålitlig först när sidoeffekterna går att testa. Och då är man tillbaka vid det som bra mjukvaruutveckling alltid har behövt: Contracts, tester och data.
Definition of Done: när ett agentsystem är redo för produktion
Den relevanta frågan är i slutändan inte om AI-featuren eller agenten verkar imponerande, utan om dess tooling är robust byggt. För agentåtgärder i produktion räcker inte en bra prompt, det krävs ett minimum av systemgarantier.
Det är inte den snyggaste demon som avgör om något är redo för produktion, utan hur robust det underliggande Contractet är.
De tidigare kapitlen kan destilleras till en kompakt DoD. Ett agent-tool är alltså redo för produktion när det uppfyller följande kriterier:
- strikt tool-schema: Toolens parametrar är definierade via ett JSON-schema och valideringen är enforced – inte valfri. Ogiltiga inputs avvisas redan innan de når affärslogiken.
- Tillåtna tools per agent: Varje agent har ett uttryckligen definierat toolset, Least Privilege. En agent ser sina egna tools, men inte andras – ingen agent ser allt.
- Idempotens vid mutationer: Varje muterande tool call bär en idempotency-key. Upprepade förfrågningar ger inga dubbla effekter. Semantiskt likvärdiga anrop upptäcks och dedupliceras också.
- Behörighetskontroll på funktion och objekt: Två kontroller, inte en. Får agenten anropa funktionen (BFLA) och får den autentiserade användaren komma åt just det här objektet (BOLA)? Båda måste kontrolleras på serversidan, oavsett vad agenten påstår.
- Approval för högriskåtgärder: Mutationer som flyttar pengar, raderar data eller ändrar behörigheter kräver extra approval-steg. Oavsett om det sker automatiskt via Business-Rules eller manuellt av en Human Reviewer – godkännandet måste vara förankrat i flödet, inte i prompten.
- Audit-Trail: Varje tool-exekvering lämnar efter sig en manipulationssäker audit-post med actor, subject, tool, argument (eller hash), outcome, timestamps och versionsinformation. Själva Audit-Trailen är skyddad, queryable och har en definierad retention.
- Request-ID:n / Tracing: Varje tool call har ett entydigt Request-ID som korreleras i det egna systemet, i audit-loggen och helst även hos modelleverantören. OpenTelemetry-konventionerna ger en standardiserad ram för det.
- Evals: Kodbaserade Evals kontrollerar de operativa garantierna: idempotens, auktorisering, approval, audit-poster, upptäckt av False Success. LLM-Judges kommer först därefter – men för kommunikationskvaliteten, inte för systembeteendet. Eval-sviten körs i CI-pipelinen och växer med varje incident.
- Tydliga domänstatusar: Tool-svar använder entydiga, domänmässigt definierade statusvärden. Ingen fritext som modellen kan tolka – och modellen måste kunna skilja dem åt, eftersom schemat tvingar fram det.
Den här Definition of Done är ingen isolerad checklista. Den knyter direkt an till kärnämnena i de senaste inläggen. Contracts definierar kontraktet mellan det deterministiska och det icke-deterministiska systemet, schemat definierar gränssnittet, Policy-gaten tvingar fram reglerna, domän-API:et garanterar effekten. Tool-beskrivningar styr, Contractet förhindrar skada. Evals står för systemets pålitlighet, så att produktionsmiljön inte enbart säkras med manuell QA, utan med automatiserade, upprepade tester mot operativa garantier. Observability förhindrar att systemet blir en black box i produktion och skapar spårbarhet genom traces, audit-loggar och Request-ID:n.
Allt det här låter som mycket jobb, men inget av det är specifikt för AI. Idempotens, auktorisering, auditing, schemavalidering, Evals (jfr: tester). Den enda skillnaden: med klassiska API:er är anroparen deterministisk, med agent-tools är den inte det.
Ju närmare en agent kommer riskfyllda områden som ekonomi, personuppgifter eller behörigheter, desto mindre får säkerheten bo i prompten.
Den som levererar agentåtgärder utan att ha löst idempotens, auth och audit ordentligt levererar ingen automatisering – utan risk.
Tool use är ögonblicket då Prompt Engineering blir Systems Engineering. Det är precis här en AI-feature slutar vara en prompt och börjar bli mjukvara.