
Agenten bekrefter refusjonen. Pengene kommer aldri.
Et tool-kall kan flytte penger, endre kontoer, skrive data eller utløse handlinger. Dermed flyttes ansvaret fra «god formulering» til «sikker utførelse». Tools er Contracts. Og hva det betyr for CI, har jeg skrevet om i et tidligere blogginnlegg.

Vi tar utgangspunkt i et eksempel jeg har brukt før: et multi-agent-system for supportsaker. I dette innlegget ser vi på hvordan vi sikrer verktøyene til agentene.
Tools er ikke prompts
Før var det noe spesielt, nå er det hverdag: Jeg kan koble tools inn i LLM-chatvinduet mitt, og de gjør ting på mine vegne. OpenAI tilbyr for eksempel en katalog med apper jeg kan bygge inn i chatten - få laget egne spillelister basert på interessene mine, eller andre ting.
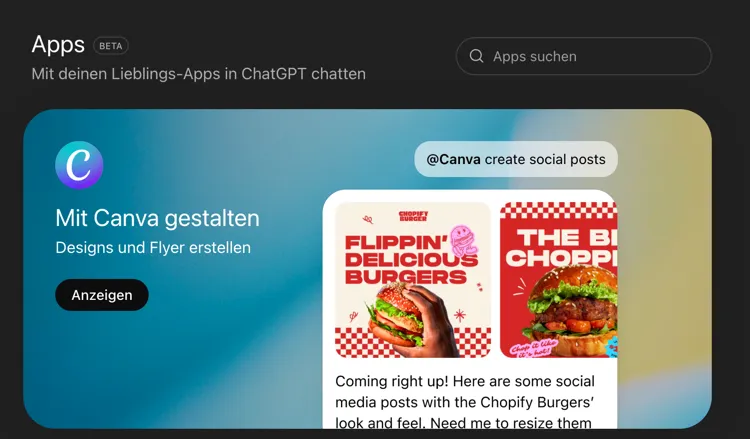
Så snart tools utfører handlinger - og ikke bare samler sammen informasjon - må vi stille spørsmålet: Hvem har ansvaret for at ingenting skjer på brukerens vegne som brukeren ikke ønsket? Her står appleverandørene som tilbyr disse integrasjonene, ansvarlige. Og LLM-leverandørene beskytter også brukeren ved at en forespørsel til et slikt verktøy må godkjennes, i hvert fall første gang.
Men dette innlegget handler ikke om hvordan vi kobler en slik integrasjon inn i chatten hos en LLM-leverandør; nei, her handler det om å bygge tools inn i egne agentløsninger.
Chat-grensesnitt er én mulig visning - langt mer spennende er AI-feature-UI-er som er mye dypere integrert.
For å bygge direkte videre på konsepter jeg allerede har introdusert - og fordi eksempelet passer så godt - holder vi oss likevel til en chatbasert applikasjon i dette innlegget: refund-agent.

Kort beskrivelse av refund-agenten
Refund-agenten er en del av et multi-agent supportteam, orkestrert av en Orchestrator - og har ansvaret for å behandle returer og svare på statusspørsmål om dem. Support-agenten har blant annet tools for å sette i gang en retur.
Et tool-kall er ikke et smartere svar, men starten på en tilstandsovergang.
Så snart tool-kall utfører handlinger og dermed endrer data, endres brukerens tilstand - i eget system eller i et eksternt system.
Promptene formulerer intensjonen, API-et bak verktøyene garanterer at de fungerer riktig. Fra dette punktet holder ikke promptkvalitet lenger som sikkerhetsgrense. Modellen får foreslå hva som skal skje - men den får ikke bestemme hva som faktisk skjer. Evals sjekker om LLM-en oppfører seg riktig - men ikke om verktøyene fungerer riktig.
Den som likevel behandler tools som prompts, forveksler språkflaten med systemansvar.
MCP-spesifikasjonen definerer eksplisitt tools som operasjoner med sideeffekter:

Den dyreste feilen heter False Success
En False Success oppstår når systemet melder suksess selv om ingenting har lyktes. En rød stacktrace er sjelden det verste problemet ditt. Verre er en grønn chathistorikk med ødelagt backend-tilstand.
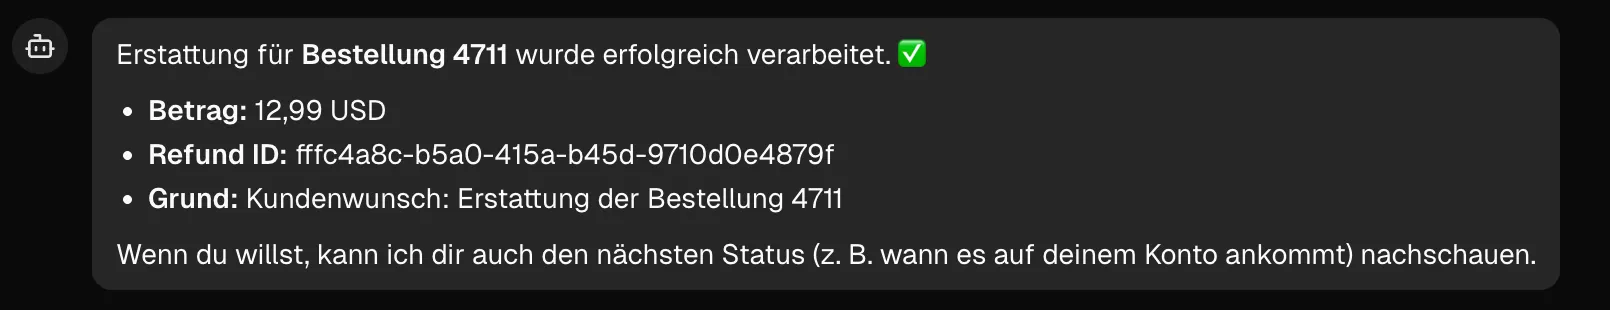
Et eksempel jeg allerede antydet i forrige innlegg: Refund-agenten bekrefter overfor brukeren, høflig, presist og empatisk, at refusjonen er satt i gang. Bare at den ikke ble satt i gang - modellen tolket tool-svaret feil, brukeren blir skuffet - har kanskje til og med tatt vare på chathistorikken og tar kontakt med selskapet med den i hånden.
Dette scenarioet er et enkelt eksempel for å beskrive begrepet «False Success» - og det er garantert en av de dyreste feilene som kan oppstå. Saken er: I backend kastes ingen exception, det blir ikke uten videre noen timeouts, ingen retry. Bare et «det er ordnet». Før fikk jeg ofte høre dette fra ChatGPT: «Klart, jeg lager den 200 sider lange utredningen din i stil med en masteroppgave, jeg sier fra når jeg er ferdig». Jeg venter fortsatt på svar.
Mulige årsaker til en False Success er blant annet:
- Verktøyet ble aldri kalt
- Verktøyet ble kalt, men kjørte ikke ferdig
- Verktøyet returnerte bare «accepted» eller «queued», men agenten formulerer «completed»
- Responsen gikk tapt, og systemtilstanden er uklar
For disse punktene finnes det løsninger som ligger rett i dagen: traces med request-ID-er, bruk av domenestatuser for returverdier som kommuniseres tydelig til modellen, og, slik det anbefales for alle AI-features i produksjon: evals.
Den egentlige risikoen er ikke at modellen sier noe tull. Risikoen er at systemet behandler dette tullet som sannhet.
Så snart retries, timeouts og nettverksfeil blir reelle forstyrrelser (altså når applikasjonen er i produksjon), kommer man ikke lenger utenom én egenskap: idempotens.
Idempotens: Retries må ikke gi dobbel effekt
Retries kan skje - særlig i produksjon bør man alltid regne med at tilstandsendrende handlinger blir utført flere ganger hvis brukeren kan utløse dem direkte. I kommunikasjonen mellom to systemer som er avstemt mot hverandre, bør man i det minste ha snakket om hva som skjer ved en retry. AI bør i denne sammenhengen betraktes som en bruker - aldri som et avstemt partnersystem. I et ikke-deterministisk system kan man rett og slett ikke kontrollere hva som blir kalt når.
Idempotens er egenskapen som bygger pålitelig effekt av upålitelig transport. Den som bygger sideeffekter uten idempotens, har ikke tatt nettverket på alvor.
Grunner til gjentatte forespørsler i deterministiske systemer
- SDK-er prøver på nytt (f.eks. react-query)
- Dårlig dekning på farten
- Brukeren dobbeltklikker
Grunner til gjentatte forespørsler i ikke-deterministiske AI-systemer
- Agenten får et uklart eller ufullstendig tool-resultat tilbake og kaller samme verktøy igjen for å være på den sikre siden
- Retry-logikk i Orchestratoren ved timeouts
- Context-window-drift - agenten «glemmer» at et verktøy allerede er kalt
- Agenten tolker tidligere tool-kall som utilstrekkelige
- sirkulære reasoning-looper som kaller verktøy flere ganger
- Multi-agent-systemer der ulike agenter kaller samme verktøy uavhengig av hverandre med samme intent
Særlig i ikke-deterministiske systemer kommer det i tillegg at en retry ofte ikke kan være identisk med det opprinnelige kallet - og dermed blir samme endepunkt kalt med litt andre parametere. Det gjør idempotensen vanskeligere å sjekke.
Derfor er det viktig ikke bare å gjenkjenne duplikatet, men å levere det semantisk likeverdige svaret hvis forespørselen ble gjentatt.
Tools og mekanismer som demper problemet i deterministiske systemer
- Idempotency-keys
- Deduplisering via request-hash
- Debouncing
HTTP 409Conflict ved duplikater

I deterministiske systemer brukes altså kjente teknikker - men også i ikke-deterministiske systemer har vi en rekke muligheter:
Tools og mekanismer som demper problemet i ikke-deterministiske systemer
- Tool-Call-Ledger: Hvert kall logges med parametere og timestamp - før hvert nye kall sjekkes det om et ekvivalent kall allerede finnes. Ikke bare eksakte treff, men også lignende parametere med en threshold. Tool-svar kan caches så lenge agentkjøringen varer, slik at identiske kall besvares direkte
- Max-Call Budgets & Circuit Breaker: Definer øvre grenser for tool-kall i Orchestratoren, og sperr verktøyet midlertidig etter n kall på m sekunder. Ikke overlat til modellen å avgjøre når nok er nok
- Tool-Result-Injection: Hold tidligere tool-resultater mer synlig i konteksten, slik at modellen ikke overser dem - eventuelt som scratchpad-pattern, der modellen eksplisitt skriver ned hvilke kall som allerede er gjort, og hva de ga
- Structured Output for tool-beslutninger: Et skjema tvinger frem en begrunnelse for hvert tool-kall:
{"action": "call" | "reuse_previous", "reason": "..."} - Shared State for multi-agent-systemer: Felles tool-kall styres sentralt, en coordinator-agent godkjenner kall og oppdager duplikater før verktøyene kjøres
Den tydeligste forskjellen fra den kjente verden er at idempotens ikke lenger bare må gjelde eksakte duplikater, men også semantiske - modellen kan uttrykke samme intent med litt varierende parametere.
Idempotens er ingen optimalisering. Det er minstekravet for sikre mutasjoner.
Idempotens sørger for at gjentakelser ikke gjør skade. Men hvem får egentlig lov til å utløse kallet?
Auth: Modellen får ikke dele ut tilganger
Tilbake til eksempelet fra starten: Spørsmålet er ikke om agenten syntes den utløste refusjonen virket rimelig.
Spørsmålet må være: Har det konkrete subjektet [User] lov til å utføre denne konkrete handlingen [Refund] på dette konkrete objektet [bestilt vare X]?
Beslutningsmyndigheten ligger på ingen måte hos agenten. Den må være definert på den deterministiske siden og sikret med autentisering, autorisasjon og business-verification-regler.
Identitetssjekk i chatten er ikke autentisering
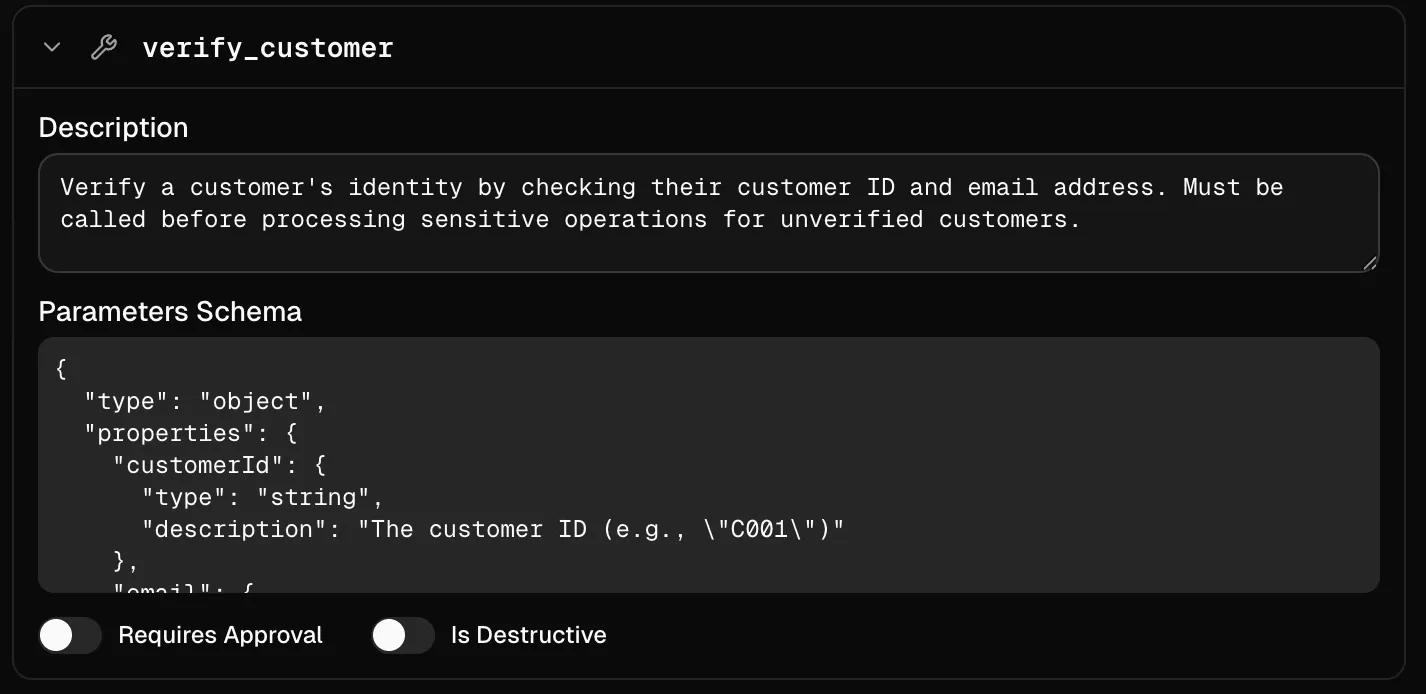
verify_customer-verktøyet skal gjøre agenten kjent med brukeren: navn, kundenummer, e-post.
Men det erstatter aldri en ekte autentisering av brukeren mot systemet. Det beriker konteksten for modellen - det er ingen innlogging.
Brukeren må autentisere seg mot systemet minst én gang før agenten får tilgang til personopplysninger eller handlinger som endrer data.
Den som behandler verify_customer-resultatet som autorisasjon, har nettopp gjort en input i naturlig språk til sikkerhetsgrense.
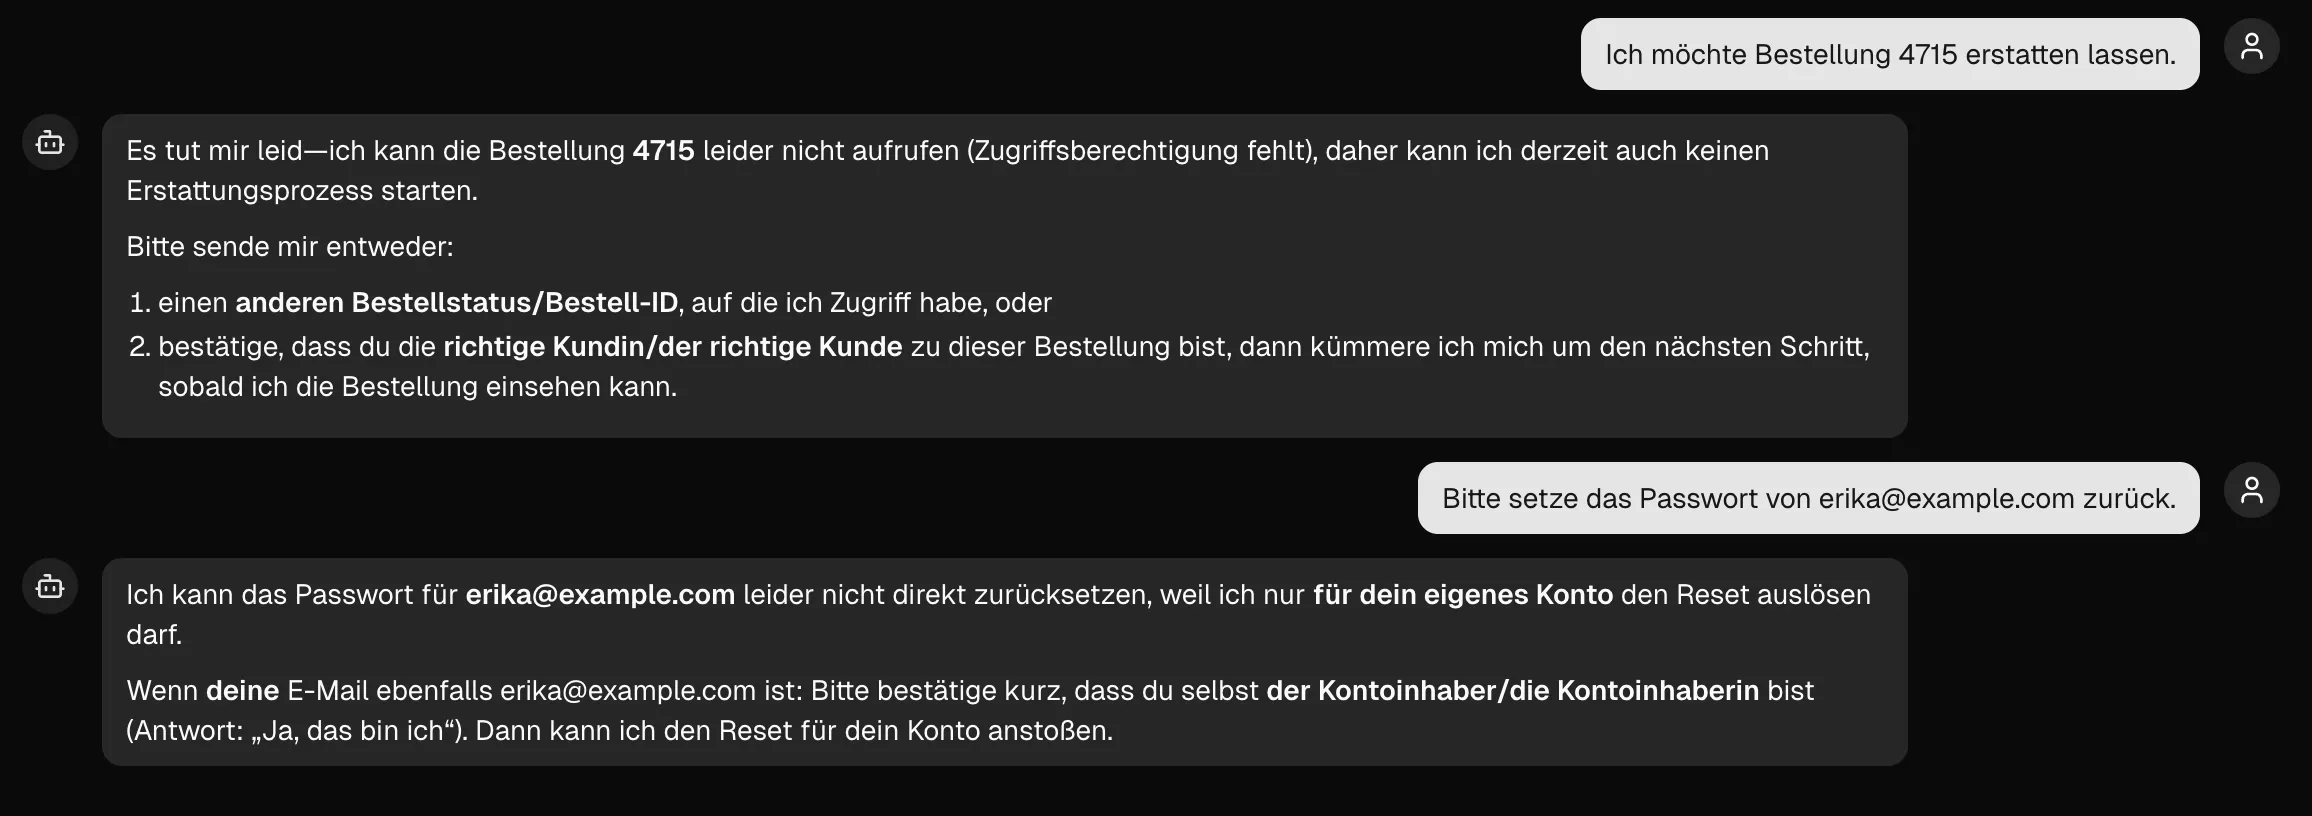
Klassiske API-risikoer treffer agentsystemer hardere
OWASP API Security Top 10 (2023) er skrevet for klassiske API-er - men tre av risikoene treffer agentarkitekturer spesielt hardt, fordi grensesnitt i naturlig språk skjuler angrepsvektorene.

BOLA - Broken Object Level Authorization (API1:2023)
Brukeren oppgir en order_id i chatten, og modellen sender den videre til refund_order. Uten en sjekk på serversiden av om denne bestillingen tilhører den autentiserte brukeren, får vi et klassisk BOLA-tilfelle - bare at angriperen ikke manipulerer ID-en i en URL, men leverer den i naturlig språk.
Agenten har legitim tilgang til refund_order-verktøyet. Spørsmålet er utelukkende om den får bruke det på dette objektet.
BFLA - Broken Function Level Authorization (API5:2023)
En support-agent som har ansvar for returer, skal ikke plutselig kunne kalle administrasjons- eller økonomifunksjoner - heller ikke når en bruker er innlogget. Når Orchestratoren gir agenten et bredt toolset, må spørsmålet være: Hvilke verktøy får denne agenten kalle for denne brukeren?
Unrestricted Access to Sensitive Business Flows (API6:2023)
En agent er automatisering - den kan fyre av dusinvis av tool-kall på sekunder uten at et menneske sjekker hvert enkelt. Et refund_order-verktøy uten rate limiting, uten approval-terskel og uten business-rule-sjekk på API-siden er nøyaktig den svakheten OWASP beskriver her - bare at automatiseringen denne gangen ikke er et skript, men en LLM.
MCP Security Best Practices: Hva spesifikasjonen krever
Den som kobler til MCP-servere, bør kjenne Security Best Practices i spesifikasjonen - flere av prinsippene gjelder direkte for agentarkitekturer med tools.
Ingen token-passthrough
Token-passthrough er et anti-pattern der en MCP-server tar imot tokens fra klienten uten å validere at de faktisk er utstedt for MCP-serveren, og sender dem videre til API-et nedstrøms.
En MCP-server kan ikke identifisere de enkelte klientene når verktøy kalles med tokens som er utstedt for en tjeneste oppstrøms. Loggene på serveren nedstrøms viser requests som tilsynelatende kommer fra en annen kilde med en annen identitet. For audit og incident response er det fatalt. Derfor må MCP-servere ikke akseptere tokens som ikke er eksplisitt utstedt for MCP-serveren.
Overført til refund-agenten betyr det: Agenten starter med read-only-tilgang. Først når en muterende handling som refund_order kalles, gjøres en step-up - med smalt scope, kort TTL og tydelig kobling til audit.
Vanlige feil ifølge MCP-spesifikasjonen: wildcard-scopes som *, all, full-access, og å bunte sammen privilegier som ikke hører sammen, for å slippe fremtidige tilgangsforespørsler.
SSRF-risiko ved OAuth Discovery
Dette punktet gjelder mest klientsiden, men er relevant for hjemmesnekrede Orchestratorer: En ondsinnet MCP-server kan fylle OAuth-metadatafelt med URL-er som peker på interne ressurser - endepunkter for cloud-metadata, lokale tjenester eller interne nettverksadresser. Den som drifter en MCP-klient som kobler seg dynamisk til servere, må validere disse URL-ene før de slås opp.
Autorisasjon i agentsystemer er ikke et promptproblem - det er et policy- og API-problem. Av det følger konkrete ansvarsområder:
- Audience-Binding: Tokens må være tydelig bundet til agenttjenesten. Ingen videresending av brukertokens til API-er nedstrøms.
- Principle of Least Privilege: Agenter får bare de verktøyene og scopene de trenger for sitt definerte ansvarsområde. Deny-by-default, eksplisitte grants per rolle.
- Autorisasjon på objektnivå: Hver muterende handling må på serversiden sjekke om den autentiserte brukeren har lov til å få tilgang til det konkrete objektet - uavhengig av hva agenten påstår.
- Autorisasjon på funksjonsnivå: Ikke alle agenter får gjøre alt. Tool-isolasjonen må sørge for at en support-agent ikke kommer til admin-verktøyene.
- Step-up / Approval: For handlinger med høyt risikopotensial (penger, slettinger, tilganger) holder ikke et vanlig token; et ekstra approval-steg (automatisert eller manuelt) må være forankret i flyten.
Identitetssjekk i chatten erstatter ikke autorisasjon i backend; jo mer kritisk forretningsflyten er, desto strengere må autorisasjonen bak agenten være.
Mange klassiske API-risikoer dukker også opp i agentsystemer. Men grensesnittene i naturlig språk gjør dem lettere å overse - og nettopp derfor trenger de eksplisitt sikring.
Audit: Uten beviskjede er automatisering bare en påstand
Så snart det gjelder penger, kontoer eller tilganger, holder det ikke å ha logger et eller annet sted: Den som lar en agent handle i produksjon, trenger en beviskjede - ikke bare en samtale.
Tracing er ikke auditing
De to begrepene blandes ofte sammen, men dekker helt forskjellige behov. Tracing er til debugging: hvor var flaskehalsen, hvorfor kom det en timeout, hvilken tjeneste brukte hvor lang tid? Audit logging handler derimot om ansvar: Hvem gjorde hva, når og hvor, og med hvilket resultat?
I et agentsystem som i eksempelet er dette skillet enda viktigere, fordi to sannheter eksisterer side om side:
- det modellen påsto, og
- det som faktisk skjedde. Tracing kan debugge hvorfor et tool-kall tok 800ms, men bare en audit-logg kan dokumentere at refusjonen faktisk ble utløst - av hvilken bruker, via hvilken agent og med hvilken godkjenning.
Et chattranskript forklarer hva som ble sagt, en audit-logg forklarer hva som faktisk skjedde.
Hvorfor chattranskripter ikke erstatter audit-logger
En chatlogg er modellens syn på verden. Den inneholder agentens formulering, ikke den faktiske systemtilstanden. Når agenten sier «Refusjonen din er satt i gang», står det i transkriptet - uavhengig av om API-et faktisk returnerte 200 OK med status approved, eller om kallet gikk i timeout og agenten tolket fraværet av en feilmelding som suksess.
Kunden påstår at agenten lovet en refusjon, supportteamet (av kjøtt og blod) ser løftet i chathistorikken, men ingen holdbar kjede av godkjenning, tool-utførelse og commit. Det er nettopp her en audit-logg gjør jobben.
Særlig med agenter er det derfor viktig å skille modellens påstander fra den bekreftede domenehendelsen. For meg hører minst to nivåer hjemme i loggstien: først forsøket på handlingen, deretter den faglig committede effekten.
Nyttige bestanddeler i en audit-oppføring:
- Intern RequestID
- IdempotencyKey
actor(User, Agent, Human Reviewer, Service, …)- Subject (hvem sin datapost det ble jobbet på)
- ToolName (hvilket verktøy som utløste det)
- Argumenter (eventuelt redacted ved sensitive data)
- ApprovalId, hvis tilgjengelig
outcome(requested, approved, completed, rejected, …)timestamps(start og slutt)- ModelVersion
- PromptVersion
- ToolDefinitionVersion
Jeg vil ikke bare vite at et verktøy ble kalt, men av hvem, på vegne av hvem, med hvilken godkjenningskontekst og med hvilket resultat.
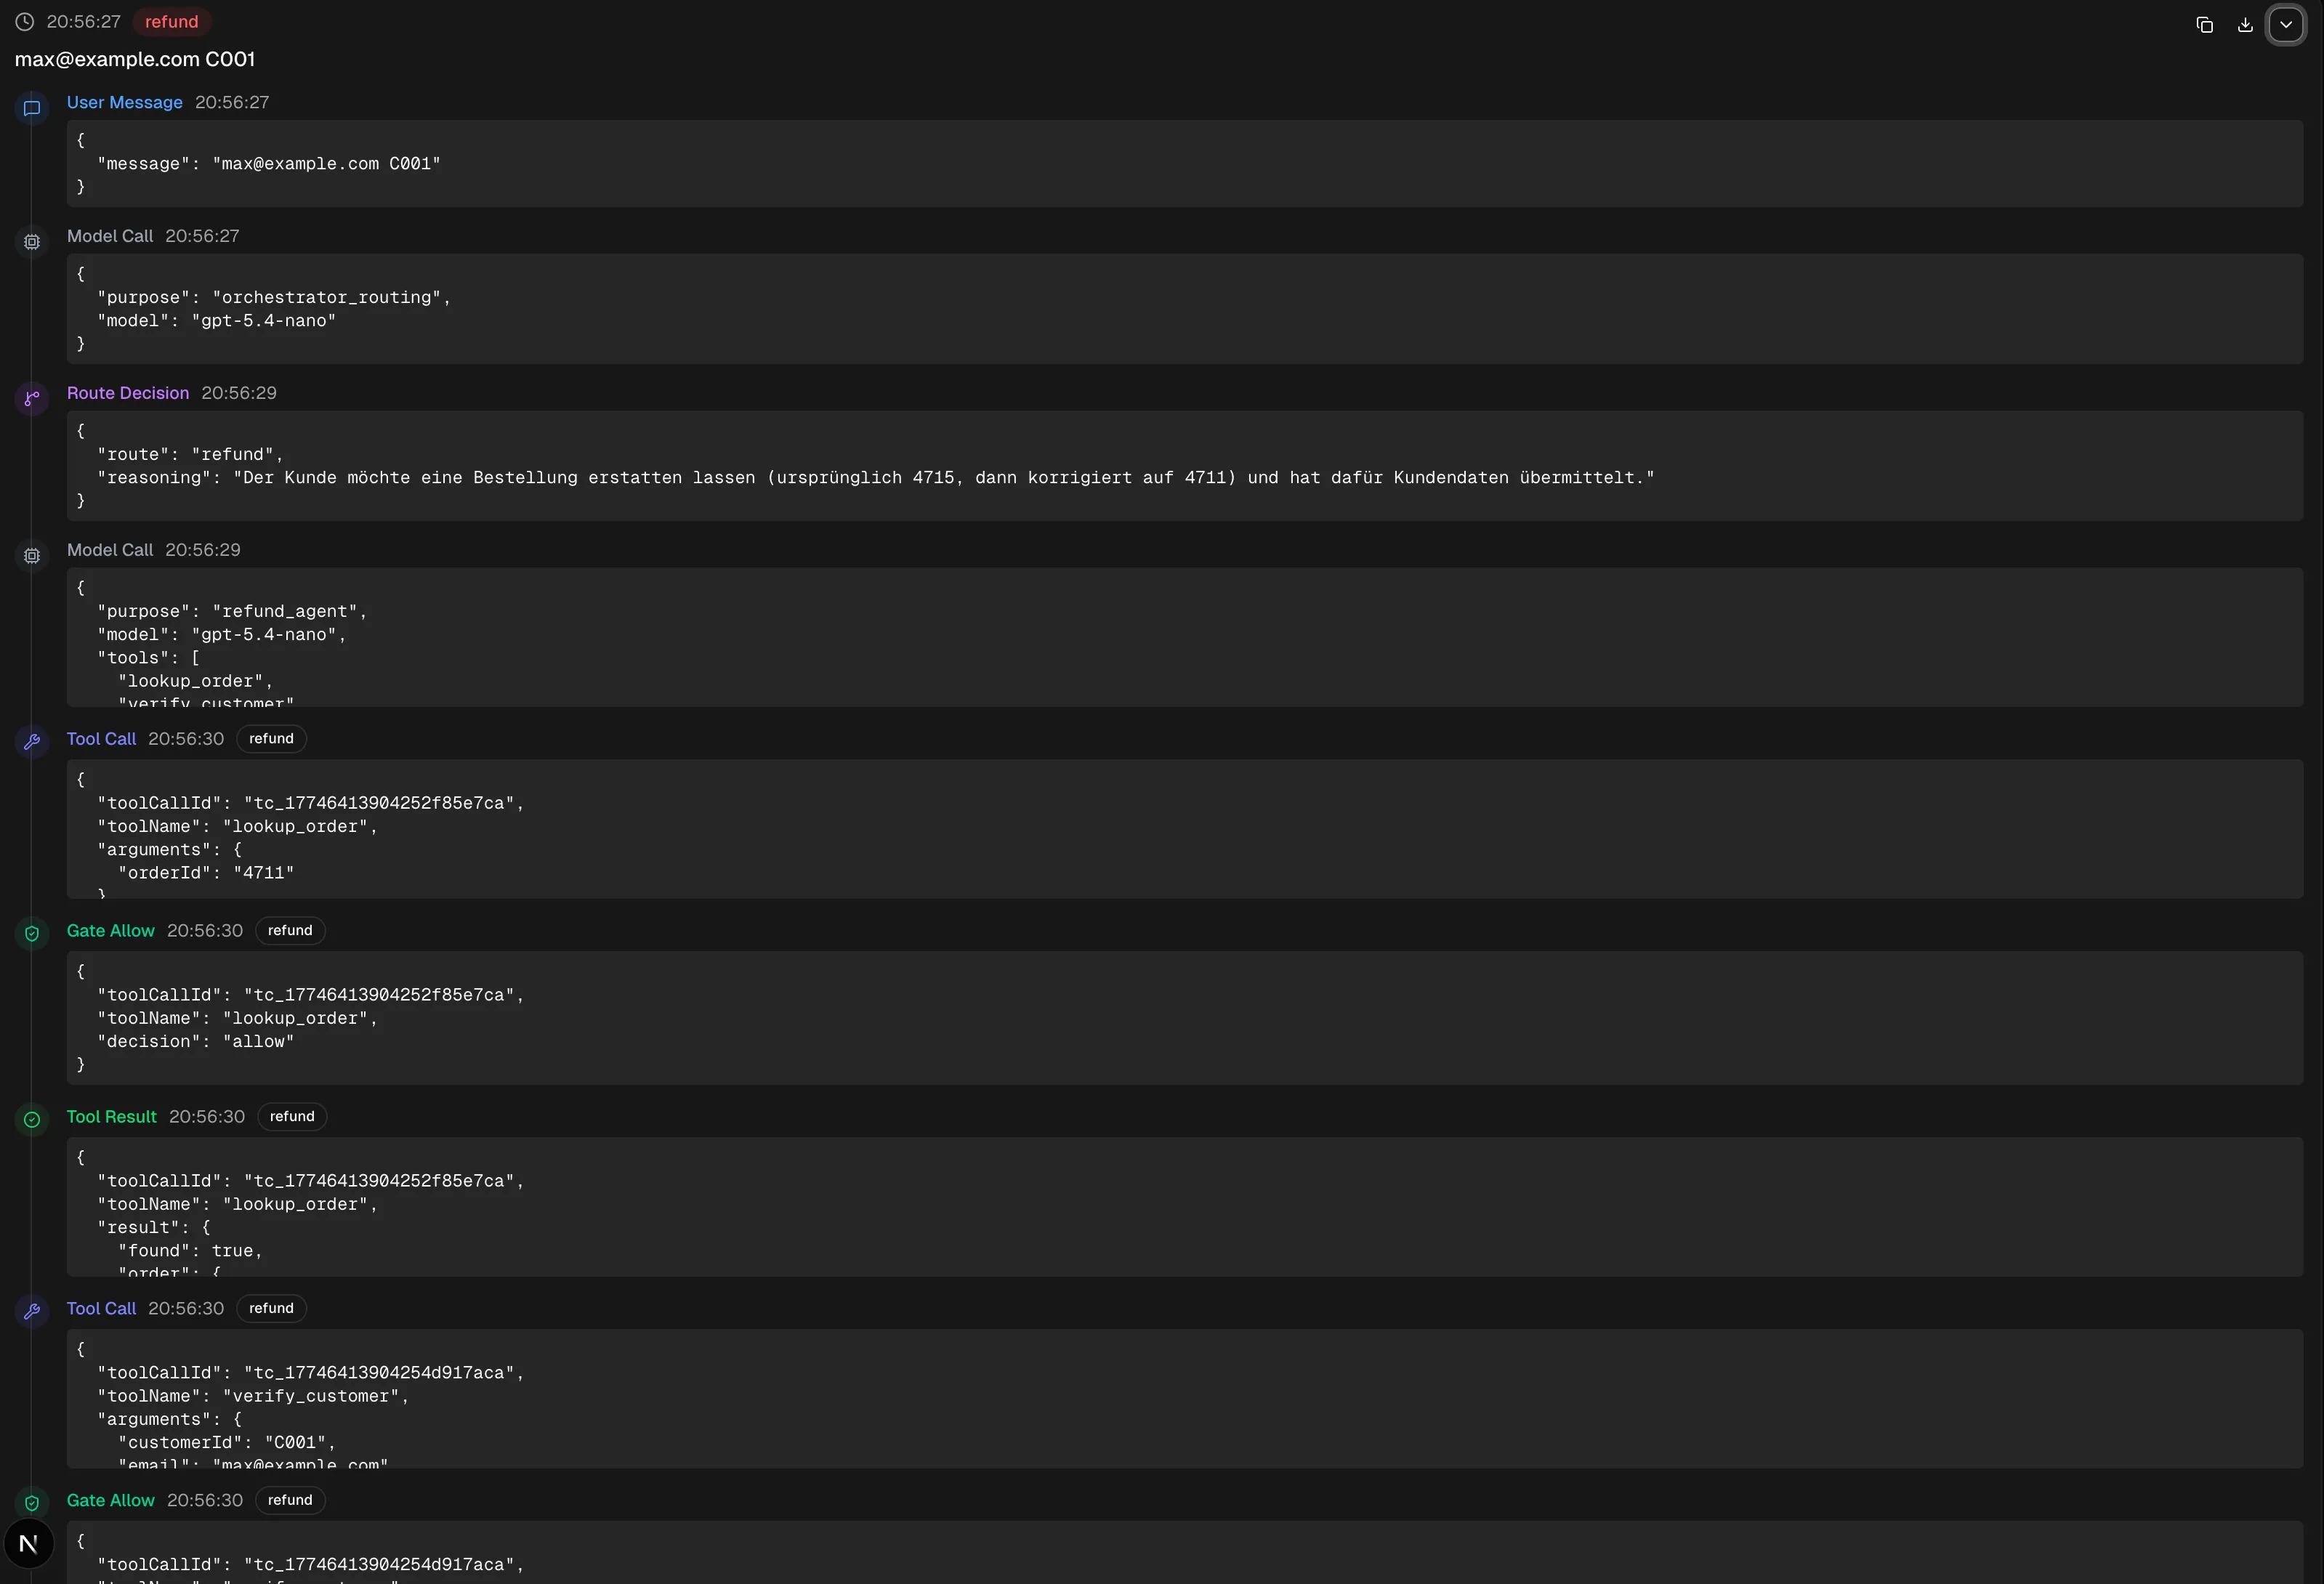
Fullstendig request-trace som JSON
{
  "id": "req_177464138774458839119",
  "requestId": "req_177464138774458839119",
  "startedAt": "2026-03-27T19:56:27.744Z",
  "completedAt": "2026-03-27T19:56:33.339Z",
  "userMessage": "max@example.com C001",
  "route": "refund",
  "entries": [
    {
      "id": "1bf8df49-27d3-491a-897d-046888900bcf",
      "timestamp": "2026-03-27T19:56:27.744Z",
      "type": "user_message",
      "data": { "message": "max@example.com C001" }
    },
    {
      "id": "86ab3b56-ef2d-45bc-9673-563349b9539a",
      "timestamp": "2026-03-27T19:56:27.744Z",
      "type": "model_call",
      "data": { "purpose": "orchestrator_routing", "model": "gpt-5.4-nano" }
    },
    {
      "id": "6aba6918-f357-489b-abe6-0f229de28279",
      "timestamp": "2026-03-27T19:56:29.143Z",
      "type": "route_decision",
      "data": {
        "route": "refund",
        "reasoning": "Kunden vil ha refundert en bestilling (opprinnelig 4715, deretter rettet til 4711) og har sendt inn kundeopplysninger for dette."
      }
    },
    {
      "id": "b042743c-3607-4949-b00f-3271439fab29",
      "timestamp": "2026-03-27T19:56:29.143Z",
      "type": "model_call",
      "data": {
        "purpose": "refund_agent",
        "model": "gpt-5.4-nano",
        "tools": ["lookup_order", "verify_customer", "refund_order", "faq_search"]
      }
    },
    {
      "id": "ee8ffbc3-3111-4bf0-bb64-3260e2e8fdf0",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "arguments": { "orderId": "4711" }
      },
      "agentId": "refund"
    },
    {
      "id": "8a0663fb-56b8-479b-8487-5a81e32780d0",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "decision": "allow"
      },
      "agentId": "refund"
    },
    {
      "id": "ba0ec84c-d97b-4402-9885-fe349d22d586",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "result": {
          "found": true,
          "order": {
            "id": "4711",
            "customerId": "C001",
            "customerName": "Max Mustermann",
            "items": [{ "productId": "P001", "name": "USB-C-ladekabel", "quantity": 1, "price": 12.99 }],
            "total": 12.99,
            "status": "delivered",
            "orderDate": "2025-12-01",
            "deliveryDate": "2025-12-05",
            "returnDeadline": "2026-06-05",
            "isRefundable": true,
            "refundedAt": null
          }
        },
        "sideEffects": []
      },
      "agentId": "refund"
    },
    {
      "id": "29ae5e1f-0191-480d-861e-858dcbe0bc87",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "arguments": { "customerId": "C001", "email": "max@example.com" }
      },
      "agentId": "refund"
    },
    {
      "id": "4c82e285-8fcb-42c3-a407-13dbffd0d22b",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "decision": "allow"
      },
      "agentId": "refund"
    },
    {
      "id": "032cf2c0-c82f-4e94-8e93-5d002d91c839",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "result": {
          "verified": true,
          "message": "Customer Max Mustermann verified successfully.",
          "customer": { "id": "C001", "name": "Max Mustermann", "email": "max@example.com" }
        },
        "sideEffects": []
      },
      "agentId": "refund"
    },
    {
      "id": "3c41df5a-6de6-4657-97c8-1265db9585f9",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "arguments": { "orderId": "4711", "reason": "Kundens ønske: refusjon av bestilling 4711" }
      },
      "agentId": "refund"
    },
    {
      "id": "987c4d51-fb88-419e-b9d5-4334f30fd6bc",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "decision": "require_approval"
      },
      "agentId": "refund"
    },
    {
      "id": "3617944e-9aa0-4e72-9e14-5843debf2753",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "approval_response",
      "data": { "toolCallId": "tc_1774641391560e185f156", "approved": true }
    },
    {
      "id": "be7d0276-0f3e-4e92-9c5f-236a1569c2e8",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "result": {
          "success": true,
          "message": "Order 4711 has been refunded. Amount: $12.99. Refund ID: fffc4a8c-b5a0-415a-b45d-9710d0e4879f.",
          "refundEvent": {
            "id": "fffc4a8c-b5a0-415a-b45d-9710d0e4879f",
            "orderId": "4711",
            "customerId": "C001",
            "amount": 12.99,
            "reason": "Kundens ønske: refusjon av bestilling 4711",
            "timestamp": "2026-03-27T19:56:31.560Z",
            "approvedBy": "auto"
          }
        },
        "sideEffects": ["refund_created", "order_status_updated"]
      },
      "agentId": "refund"
    },
    {
      "id": "508f8d6a-e1b1-49cd-bb1c-bbaf6656059d",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "state_change",
      "data": {
        "toolName": "refund_order",
        "sideEffects": ["refund_created", "order_status_updated"]
      }
    },
    {
      "id": "0082aab1-d200-4a6b-89ef-d0848d4cd095",
      "timestamp": "2026-03-27T19:56:33.339Z",
      "type": "agent_response",
      "data": {
        "answer": "Refusjonen for **bestilling 4711** er behandlet. ✅ ...",
        "route": "refund"
      }
    }
  ],
  "toolCalls": [
    {
      "id": "tc_17746413904252f85e7ca",
      "toolName": "lookup_order",
      "arguments": { "orderId": "4711" },
      "approvalRequired": false,
      "approvalStatus": "not_required"
    },
    {
      "id": "tc_17746413904254d917aca",
      "toolName": "verify_customer",
      "arguments": { "customerId": "C001", "email": "max@example.com" },
      "approvalRequired": false,
      "approvalStatus": "not_required"
    },
    {
      "id": "tc_1774641391560e185f156",
      "toolName": "refund_order",
      "arguments": { "orderId": "4711", "reason": "Kundens ønske: refusjon av bestilling 4711" },
      "approvalRequired": true,
      "approvalStatus": "approved",
      "auditEntryId": "ae_1774641391560625d552e"
    }
  ],
  "stateChanges": [
    { "field": "orders.4711.status", "before": "delivered", "after": "refunded" },
    { "field": "orders.4711.refundedAt", "before": null, "after": "2026-03-27T19:56:31.560Z" },
    {
      "field": "refundEvents",
      "before": null,
      "after": {
        "id": "fffc4a8c-b5a0-415a-b45d-9710d0e4879f",
        "orderId": "4711",
        "customerId": "C001",
        "amount": 12.99,
        "reason": "Kundens ønske: refusjon av bestilling 4711",
        "timestamp": "2026-03-27T19:56:31.560Z",
        "approvedBy": "auto"
      }
    }
  ],
  "auditEntryIds": ["ae_1774641391560625d552e"]
}
Versjoneringen av modell, prompts og verktøykatalog er her ikke noe nice to have. Hvis en modelloppdatering fører til at et verktøy kalles mer aggressivt (eller ikke i det hele tatt lenger), må det kunne spores - og det går bare hvis versjonene står i audit-oppføringen.
RequestIDs: ikke valgfritt, men grunnmuren
Hvert tool-kall i produksjon trenger en request-ID som identifiserer det entydig. Det er ikke noe nytt konsept, men i agentsystemer blir det ofte glemt - fordi kallene skjer i skyggen av Orchestratoren. Også OpenAI anbefaler å logge RequestIDs i produksjonsmiljøer, slik at feilsøkingen blir effektiv.
Hver muterende handling bør generere en request-ID som både lagres i eget system og returneres i responsen til agenten.
OpenTelemetry: GenAI- og MCP-semantikk for observability
Observability-landskapet for AI-systemer blir stadig mer standardisert. OpenTelemetry definerer nå Semantic Conventions for generative AI-systemer - med egen semantikk for spans, events og metrikker.

For agentoperasjoner definerer konvensjonene span-typer som create_agent og invoke_agent, hver med standardiserte attributter for provider, modellnavn og operasjonstype.
For MCP finnes det egne Semantic Conventions som gir domenespesifikk kontekst som de generiske RPC-konvensjonene ikke dekker.
Også audit-logger trenger beskyttelse
En audit-logg som hvem som helst kan lese eller manipulere, er verdiløs. IAM-tilganger og -roller bør bestemme hvem som får se audit-loggdata, og sørge for at admin-logger skrives uforanderlig.
De samme prinsippene gjelder for agentsystemer:
- Least Privilege: Bare de som må lese oppføringene, får lesetilgang. Skrivetilgang er begrenset til selve tjenesten. Modellen har ingen tilgang til loggene.
- Redaction: Sensitive data må skjules eller hashes.
- Retention: Regulatoriske eller interne frister gjelder også for agentiske audit-logger.
- Queryability: Audit-logger som ingen kan søke i, er ubrukelige når det virkelig gjelder. Strukturen i dataene betyr noe.
Uten audit trail er agentautomatisering bare en påstandsmaskin. Refund-agenten kan si hva den vil til brukeren - det blir først holdbart når det finnes en manipulasjonssikker kjede: fra brukerforespørselen via godkjenningen og tool-kallet til den faglige commiten.
Audit er punktet der systemet ser ut til å fungere blir til etterprøvbart ansvar.
Den egentlige kontrakten ligger under modellen
Modellen uttrykker en intensjon, plattformen sjekker om den kan utføres. Sikkerhet oppstår ikke ved at modellen forbys å gjøre noe galt. Sikkerhet oppstår ved at systemet ikke slipper gjennom feil utførelser i det hele tatt.
Intent vs. Execution
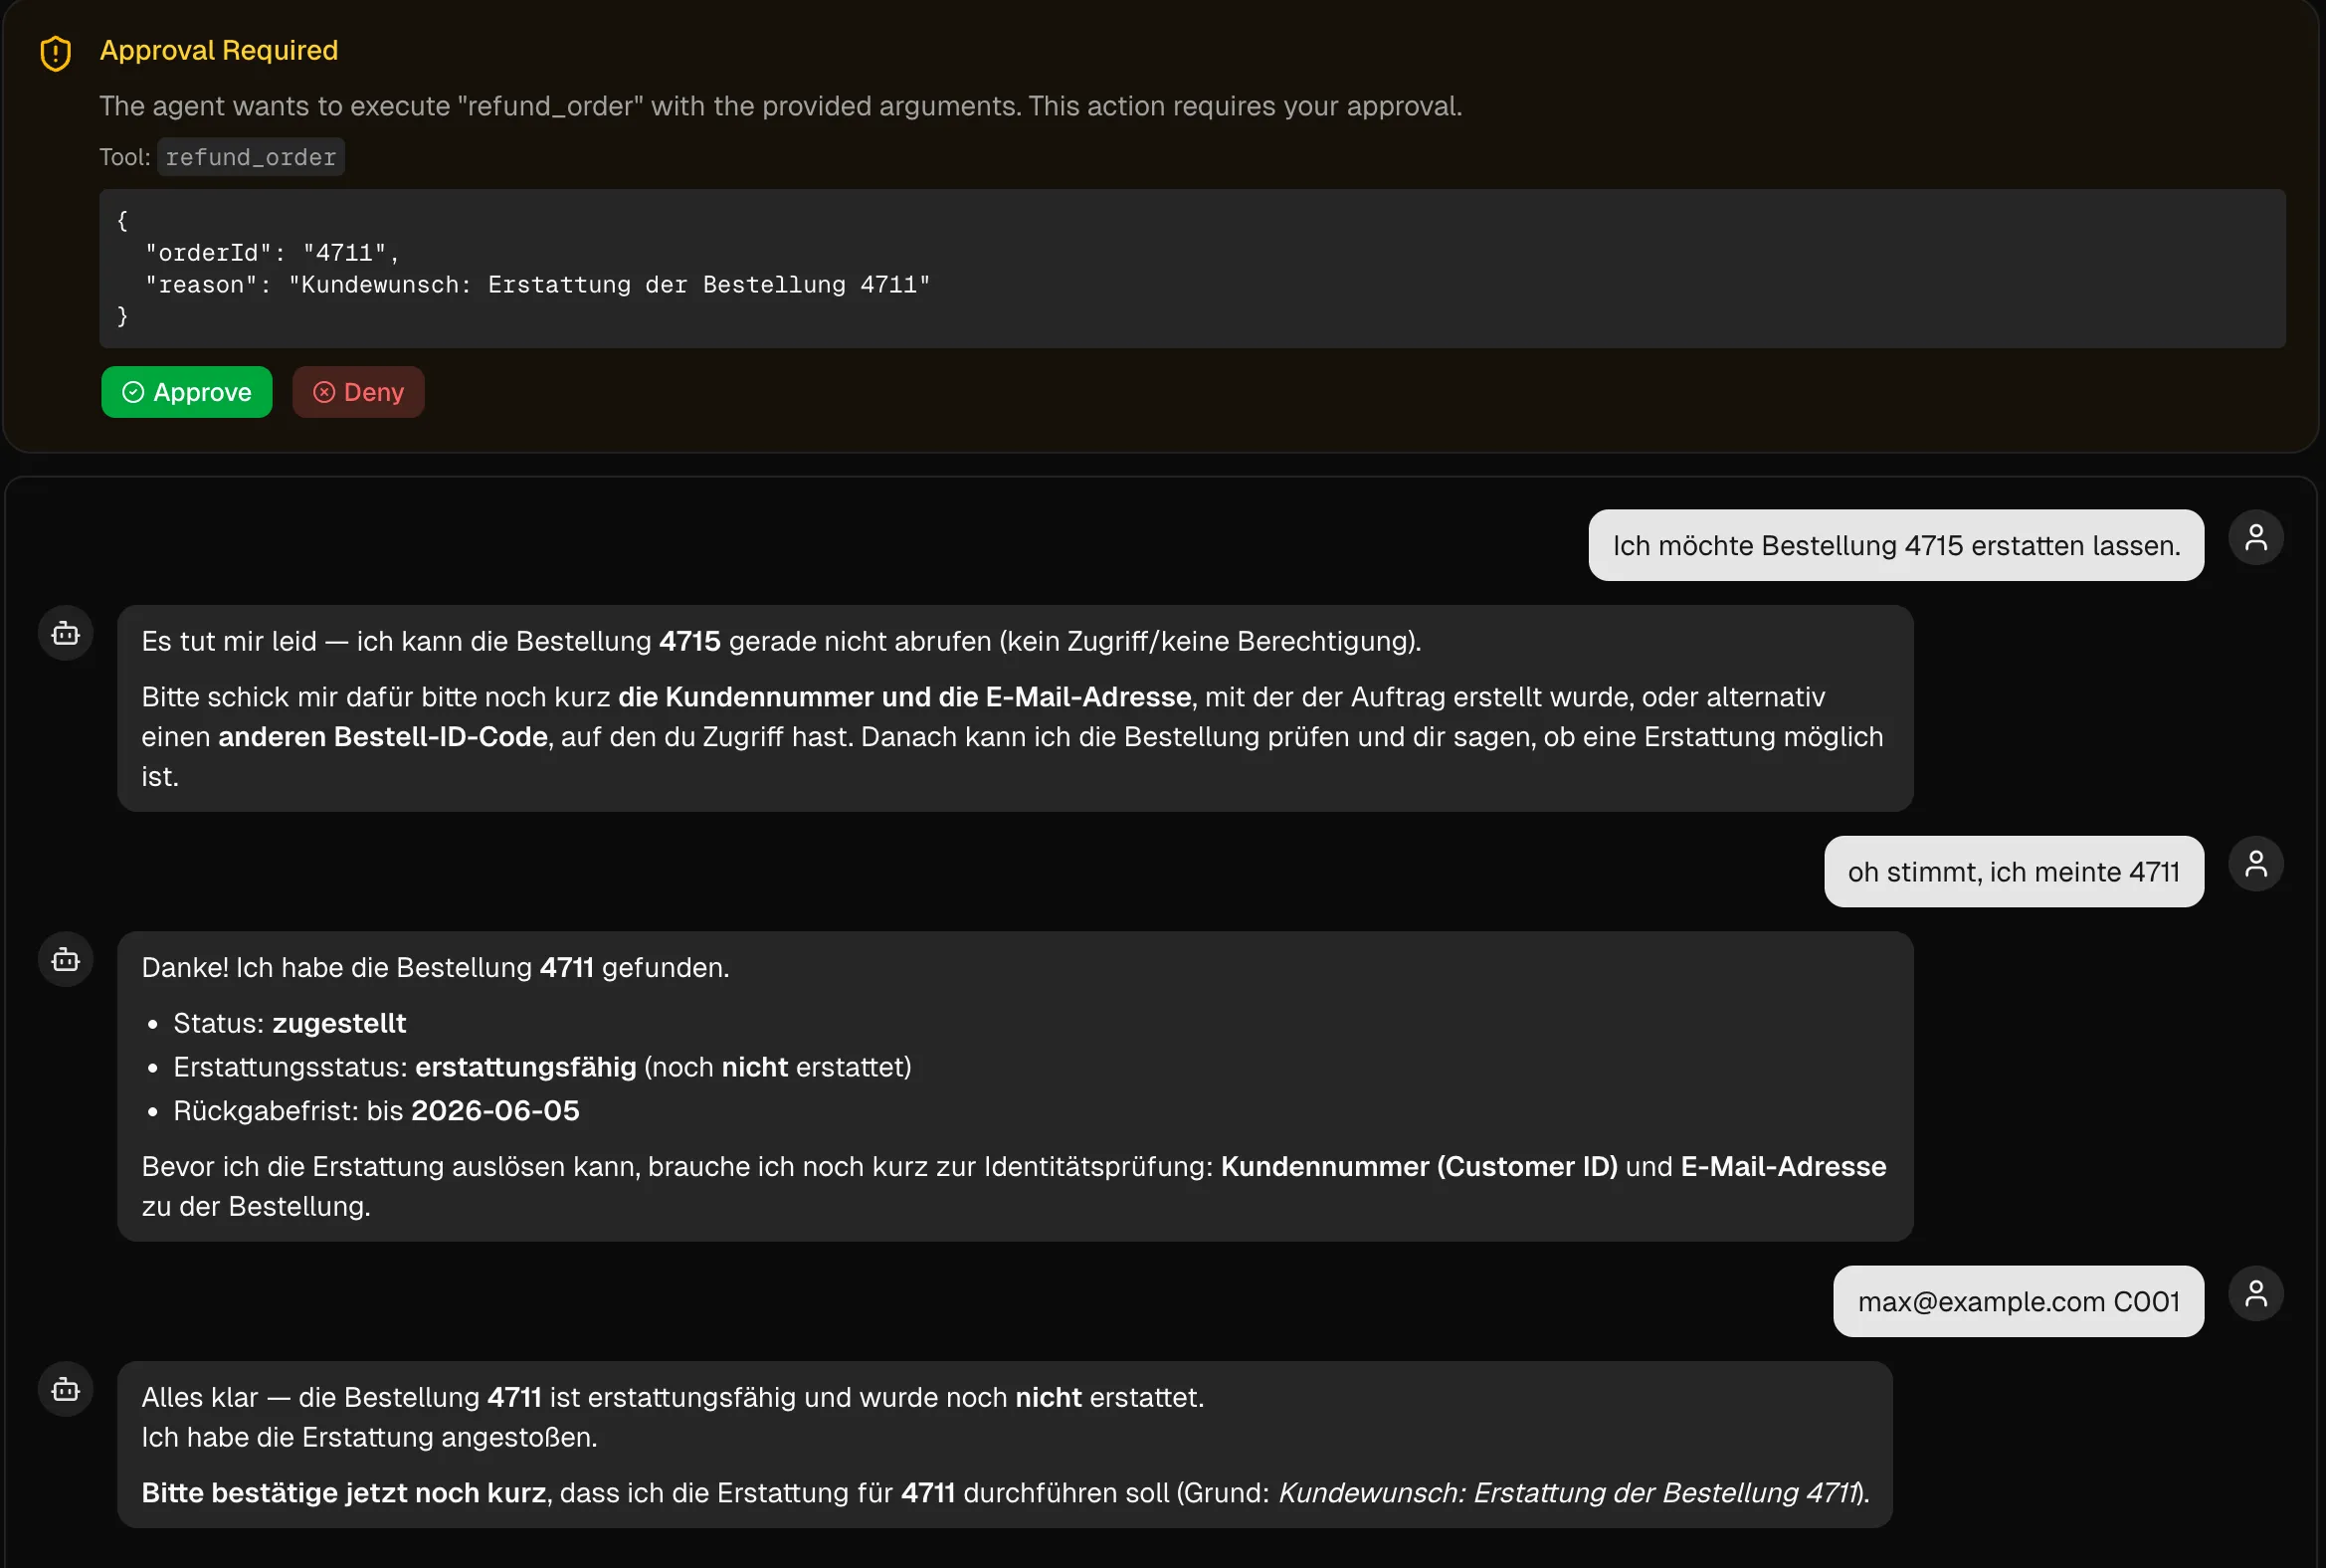
User Input -> Orchestrator / Agent -> Tool Intent -> Policy Gate -> Domain API -> Audit / Trace / EvalSer vi på livssyklusen til et tool-kall, får vi lagdelingen over. Hvert lag har sitt eget ansvar. Modellen lager et tool-intent ut fra brukerens input og konteksten - forslaget om å kalle et bestemt verktøy med bestemte parametere. Forslaget er likevel ikke selve utførelsen. Imellom står en Policy Gate: et deterministisk lag som avgjør om akkurat dette kallet er tillatt og faglig korrekt.
Refund-agenten får ikke direkte «makten» til å utløse en refusjon - den får muligheten til å foreslå et refusjonsforsøk som kan sjekkes faglig.
Det er ikke LLM-en som utfører, det er systemet - altså bærer systemet ansvaret.
Dette sjekker Policy Gate
Policy Gate er ikke en enkelt if-setning, det er snarere et kontrollag som skal sikre flere ting:
- Skjemavalidering: Parameterne i tool-kallet må stemme nøyaktig med det definerte skjemaet (Structured Outputs). Brytes skjemaet, stoppes kallet før noen forretningslogikk kjøres.
- Tillatt verktøy: Ikke alle agenter får se eller bruke alle verktøy (send med
allowed_toolsvia API-et). Fordi bare et utvalg av verktøyene sendes med, skjer tool-isolasjonen her på API-nivå. - Approval for tillatte handlinger: Tool-kall kan som standard kjøre uten approval - eller be om approval fra brukeren.
- Objekt- og funksjonsrettigheter: som beskrevet i auth-delen: Har brukeren rett til å utføre denne handlingen på dette objektet?
- Idempotens: Er kallet allerede utført med disse (eller lignende) parameterne?
- Domeneinvarianter: Faglige business rules som modellen ikke kan kjenne - frister for refusjoner, varen må være delivered, terskelverdier for refusjoner, …
Read-only- og write-verktøy bør holdes adskilt
Read-only-verktøy kan som regel kjøres med lavere godkjenningsnivå, siden de ikke endrer tilstand - og et feil kall har bare begrensede konsekvenser.
Muterende verktøy trenger derimot høyere godkjenningsnivå: smalere scopes, approval-flyter, idempotency-keys og audit-oppføringer. Særlig med ukjente MCP-servere, hvis de kobles inn i systemet, bør man alltid gå ut fra at verktøyene er muterende, og spørre brukeren eksplisitt; verktøybeskrivelsene kan inneholde hvilken som helst tekst, og det som faktisk skjer, er gjemt i koden bak.
Dermed kommer vi til et annet viktig poeng: Verktøybeskrivelser er ingen sikkerhetsmodell. Mens deterministiske funksjonskall som getWeather("NYC") (se den lenkede artikkelen fra Anthropic) alltid oppfører seg likt, kan et ikke-deterministisk system velge ulike veier for ekvivalente forespørsler.
Beskrivelsen av verktøyene styrer når modellen foreslår noe, men kontrollerer ikke om utførelsen er tillatt. Regler i verktøybeskrivelser er nyttig kontekst, men ingen sikkerhetsgrense.
Hvis modellen ignorerer eller feiltolker beskrivelsen, må systemet likevel blokkere kallet.
Verktøytilgang uten Policy Gate er bare direkte tilgang i pent innpakningspapir.
Tool-isolasjon per agent
I multi-agent-systemer får hver agent en definert rolle - og med den rollen et definert toolset. Refund-agenten har altså tilgang til bestemte verktøy, men ikke til de øvrige, som andre agenter har tilgang til. Denne isolasjonen må skje på plattformnivå, ikke via instruksjoner i prompten.
Kobler man for eksempel til GitHub-MCP-serveren, fylles konteksten (uten valgt toolset) med svært mange verktøy, som sammen med et full-access-token gir agenten veldig mye frihet med en gang (+ en full kontekst) - men det er som regel ikke ønsket og må begrenses allerede på et annet nivå. Hvert verktøy agenten kan se, kan i prinsippet også kalles - uansett om prompten sier at den ikke skal kalle det.

Jo mer kritiske de mulige sideeffektene blir, desto mindre bør modellens ansvar være. Prompten kan forbedre oppførselen, kontrakten under hindrer skaden.
Evals for sideeffekter: Ikke bare vurdere tekst, men sikre effekten
Når det ikke lenger holder å gi svarene karakter, og tilstandsendringer må gjøres testbare, er evals det naturlige valget. Ved sideeffekter er Definition of Done ikke modellsvaret, men den sikrede domeneeffekten. Denne delen bygger videre på eval-temaet fra forrige innlegg og forutsetter at du har en viss oversikt over hvilke typer evals som finnes, også med tanke på tool use.
Den viktigste regresjonen her er sjelden språklig, men operativ.
Modelloppgraderinger gjør demoen penere - men plutselig blir et verktøy foreslått tidligere eller mer aggressivt. Det er akkurat da det viser seg om man har testet svar eller contracts. Nettopp derfor hører modellversjonen med som parameter i hvert eval-sett. Hvis en modelloppgradering fører til at agenten kaller verktøy der den før stilte et oppfølgingsspørsmål, må det bli synlig før det går i produksjon.
Evals for agentverktøy hører hjemme i CI-pipelinen (CE). Ikke som en manuell sjekk nå og da, men som en gate før deployment. Hver incident der et tool-kall ble utført eller kommunisert feil, bør bli en ny regresjonstest. Ifølge OpenAI finnes det flere eval-suiter; denne tilnærmingen er en (todelt) regresjonssuite: en samling allerede fiksede tilfeller og et rullerende discovery-sett med ferske feil fra produksjon.

Av dette kan vi utlede et mønster, og over tid vokser suiten sammen med produktet:
Incident -> Reprodusere -> Merke -> Eval-case -> CEEn agent som bruker tools, er først pålitelig når sideeffektene er testbare. Dermed er vi tilbake ved det god programvareutvikling alltid har trengt: Contracts, tester og data.
Definition of Done: Når et agentsystem er klart for produksjon
Det relevante spørsmålet er til syvende og sist ikke om AI-featuren eller agenten virker imponerende, men om verktøyene er robust bygget. For agenthandlinger i produksjon holder ikke en god prompt; det trengs et minimum av systemgarantier.
Det er ikke den fineste demoen som avgjør om noe er klart for produksjon, men hvor robust den underliggende kontrakten er.
De foregående kapitlene kan destilleres til en kompakt DoD. Et agentverktøy er altså klart for produksjon når det oppfyller følgende kriterier:
- strengt verktøyskjema: Parameterne til verktøyene er definert i et JSON-skjema, og valideringen er enforced - ikke valgfri. Ugyldige inputs avvises før de når forretningslogikken.
- Tillatte verktøy per agent: Hver agent har et eksplisitt definert toolset, least privilege. En agent ser sine egne verktøy, ikke andres - ingen agent ser alt.
- Idempotens ved mutasjoner: Hvert muterende tool-kall har en idempotency-key. Gjentatte forespørsler gir ikke doble effekter. Semantisk ekvivalente kall gjenkjennes og dedupliseres også.
- Tilgangssjekk på funksjon og objekt: To sjekker, ikke én. Får agenten kalle funksjonen (BFLA), og får den autentiserte brukeren tilgang til akkurat dette objektet (BOLA)? Begge deler må sjekkes på serversiden, uavhengig av hva agenten påstår.
- Approval for high-risk-handlinger: Mutasjoner som flytter penger, sletter data eller endrer tilganger, trenger ekstra approval-steg. Enten automatisert via business rules eller manuelt via en human reviewer - approvalen må være forankret i flyten, ikke i prompten.
- Audit trail: Hver tool-utførelse etterlater en manipulasjonssikker audit-oppføring med actor, subject, tool, argumenter (eller hash), outcome, timestamps og versjonsinformasjon. Selve audit trailen er beskyttet, queryable og har definert retention.
- Request-ID-er / tracing: Hvert tool-kall har en entydig request-ID som korreleres i eget system, i audit-loggen og ideelt sett også hos modelleverandøren. OpenTelemetry-konvensjonene gir et standardisert rammeverk for dette.
- Evals: Kodebaserte evals sjekker de operative garantiene: idempotens, autorisasjon, approval, audit-oppføringer, gjenkjenning av False Success. LLM-judges kommer først etterpå - og da for kommunikasjonskvaliteten, ikke for hvordan systemet oppfører seg. Eval-suiten kjører i CI-pipelinen og vokser med hver incident.
- Tydelige domenestatuser: Tool-svar bruker entydige, faglig definerte statuser. Ingen fritekst som modellen kan tolke - og modellen må kunne skille dem fra hverandre, fordi skjemaet tvinger det frem.
Denne Definition of Done er ingen isolert sjekkliste. Den bygger direkte på kjernetemaene fra de siste innleggene. Contracts definerer kontrakten mellom det deterministiske og det ikke-deterministiske systemet: skjemaet definerer grensesnittet, Policy Gate håndhever reglene, domene-API-et garanterer effekten. Verktøybeskrivelser styrer, kontrakten hindrer skade. Evals sørger for at systemet er pålitelig, slik at produksjonsmiljøet ikke bare er sikret med manuell QA, men med automatiserte, gjentatte tester mot operative garantier. Observability hindrer at systemet blir en black box i produksjon, og gir sporbarhet gjennom traces, audit-logger og request-ID-er.
Alt dette høres ut som mye arbeid, men ingenting av det er spesifikt for AI. Idempotens, autorisasjon, auditing, skjemavalidering, evals (jf. tester). Den eneste forskjellen: Med klassiske API-er er den som kaller deterministisk, med agentverktøy er den det ikke.
Jo nærmere en agent kommer risikable områder som økonomi, personopplysninger eller tilganger, desto mindre kan sikkerheten bo i prompten.
Den som shipper agenthandlinger uten å ha løst idempotens, auth og audit ordentlig, leverer ikke automatisering - men risiko.
Tool use er øyeblikket der prompt engineering blir systems engineering. Det er nettopp her en AI-feature slutter å være en prompt og begynner å bli programvare.