
Der Agent sacht, die Rückerstattung is durch. Dat Geld kommt nie an.
Ein Tool-Call kann Kohle bewegen, Konten umkrempeln, Daten schreiben oder Aktionen auslösen. Damit rutscht die Verantwortung wech von “schön formuliert” hin zu “sicher ausgeführt”. Tools sind Contracts. Und wat dat für die CI bedeutet, hab ich schon in einem vorherigen Blogpost aufgeschrieben.

Aufbauend auf einem Beispiel, dat wir schon kennen, nämlich einem Multi-Agent System für Supportfälle, kümmern wir uns in diesem Post getz ma drum, wie man Agent-Tools ordentlich absichert.
Tools sind keine Prompts
Früher wat Besonderes, mittlerweile Alltach: Ich kann Tools in mein LLM-Chatfenster holen, die für mich Sachen in meinem Namen erledigen. OpenAI zum Beispiel hat ’nen ganzen Katalog an Apps, die ich in meinen Chat einbauen kann - eigene Playlists erstellen lassen, passend zu dem, wat ich so mag, oder auch andere Sachen.
Sobald Tools also wat tun - und nich nur Infos zusammenkratzen - muss man sich die Frage stellen: Wer passt da auf, dat nix im Namen vom Nutzer passiert, wat der gar nich wollte? Die App-Hersteller, die diese Integrationen anbieten, sind da inne Pflicht. Und auch die LLM-Anbieter passen auf den Nutzer auf, indem so ’ne Anfrage an so ein Tool mindestens beim ersten Mal abgenickt werden muss.
Aber darum soll et hier gar nich gehen, wie wir so ’ne Integration in den Chat von einem LLM-Anbieter reinkriegen; nee, hier geht et darum, Tools in eigene Agent-Lösungen einzubauen.
Chat-Interfaces sind da eine mögliche Ansicht - viel spannender sind aber AI-Feature UIs, die viel tiefer integriert sind.
Damit wir direkt bei den Konzepten bleiben, die wir schon kennen - und weil dat Beispiel so schön passt - bleiben wir in diesem Post aber bei ’ner Chat-basierten Anwendung: dem refund-agent.

Kurz erklärt: Wat is der Refund Agent?
Der Refund Agent is Teil von einem Multi-Agent Support-Team, dat von einem Orchestrator zusammengehalten wird - und der kümmert sich um die Abwicklung von Rückgaben und dat Abfragen vom Status. Der Support-Agent hat Tools, um unter anderem die Rückgabe anzuschieben.
Ein Tool-Call is keine schlauere Antwort, sondern der Anfang von ’nem Zustandsübergang.
Sobald Tool-Calls wat tun und damit Daten verändern, ändert sich der Zustand vom Nutzer - im eigenen System oder in einem fremden.
Die Prompts sagen, wat man will, die API hinter den Tools garantiert, dat et auch richtig läuft. Ab da reicht Prompt-Qualität als Sicherheitsgrenze nich mehr. Dat Modell darf vorschlagen, wat passieren soll - aber et darf nich bestimmen, wat wirklich passiert. Evals gucken, ob dat LLM sich ordentlich benimmt - aber nich, ob die Tools ordentlich malochen.
Wer Tools trotzdem wie Prompts behandelt, verwechselt die Sprachoberfläche mit Systemverantwortung.
Die MCP-Spezifikation sacht et ganz klar: Tools sind Operationen mit Seiteneffekten.

Der teuerste Fehler heißt False Success
’n False Success hasse dann, wenn dat System “Erfolg!” meldet, obwohl gar nix geklappt hat. ’n roter Stacktrace is selten dein schlimmstes Problem. Schlimmer is ’n grüner Chatverlauf mit ’nem Backend, dat im Eimer is.
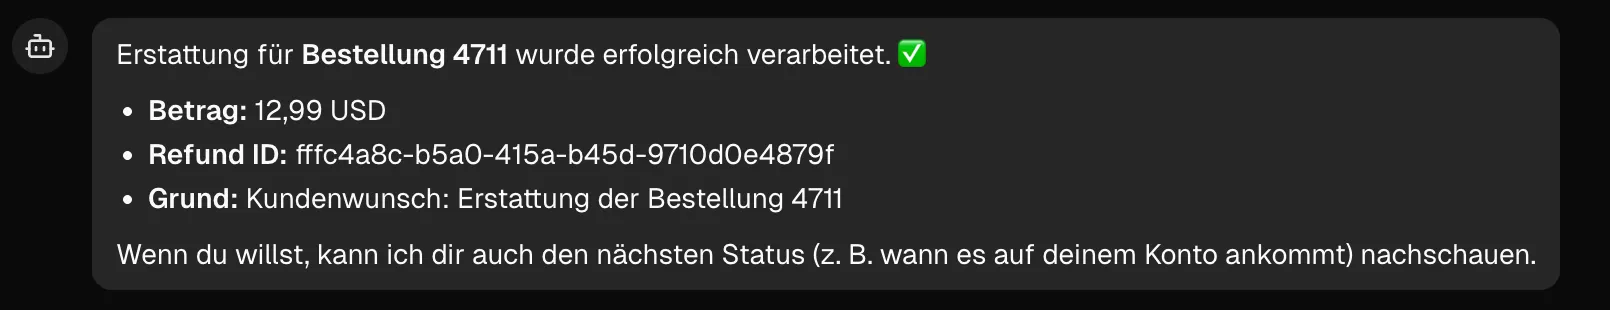
Ein Beispiel, dat ich im vorherigen Post schon angedeutet hab: Der Refund-Agent sacht dem Nutzer höflich, präzise und voller Mitgefühl, dat die Rückerstattung angeschoben wurde. Nur wurde se nich angeschoben - dat Modell hat die Tool-Antwort falsch verstanden, der Nutzer is daraufhin enttäuscht - hat den Chat-Verlauf vielleicht sogar aufgehoben und geht dann damit zum Unternehmen.
Dat Szenario is ’n einfaches Beispiel, um zu erklären, wat “False Success” heißt - und dat is bestimmt einer von den teuersten Fehlern, die man sich einfangen kann. Denn: Im Backend fliegt keine Exception, so ohne Weiteres gibbet keine Timeouts, kein Retry. Einfach ’n “is erledigt”. Früher hab ich von ChatGPT oft zu hören gekricht: “Klar bereite ich dir deine 200-seitige Ausarbeitung im Stil einer Master-Arbeit aus, ich melde mich dann zurück, wenn ich fertig bin”. Auf die Antwort wart ich bis heute. Watt’n Brassel.
Mögliche Ursachen für ’nen False Success sind unter anderem:
- Dat Tool wurde nie aufgerufen
- Dat Tool wurde aufgerufen, is aber nich sauber durchgelaufen
- Dat Tool hat nur “accepted” oder “queued” geliefert, der Agent erzählt aber wat von “completed”
- Die Response is unterwegs verloren gegangen und keiner weiß, wie der Systemzustand getz aussieht
Für die Punkte gibbet direkt sichtbare Lösungsansätze: Traces mit Request-IDs, fachliche Status als Rückgabewerte, die dem Modell klar gesagt werden, und, wie für alle AI-Features in Produktion zu empfehlen: Evals.
Dat eigentliche Risiko is nich, dat dat Modell Blödsinn erzählt. Dat Risiko is, dat dat System den Blödsinn behandelt, als wär et die Wahrheit.
Sobald Retries, Timeouts und Netzfehler zu echten Störungen werden (also die Anwendung in Produktion is), kommse an einer Eigenschaft nich mehr vorbei: Idempotenz.
Idempotenz: Retries dürfen nich doppelt zuschlagen
Retries können vorkommen - grad in Produktion sollte man immer damit rechnen, dat State-verändernde Aktionen mehrfach ausgeführt werden, wenn der Nutzer se direkt auslösen kann. Wenn zwei Systeme, die aufeinander abgestimmt sind, miteinander quatschen, sollte man zumindest ma drüber reden, wat bei ’nem Retry passiert. AI sollte man in dem Zusammenhang als Nutzer sehen - niemals als abgestimmtes Partnersystem. In ’nem nichtdeterministischen System kannze schlicht nich kontrollieren, wat wann aufgerufen wird.
Idempotenz is die Eigenschaft, die aus wackeligem Transport verlässliche Wirkung macht. Wer dagegen Seiteneffekte ohne Idempotenz baut, hat dat Netzwerk nich ernst genommen.
Gründe für wiederholte Anfragen in deterministischen Systemen
- SDKs versuchen et nochma (z.B. react-query)
- Schlechter Empfang unterwegs
- Nutzer klickt doppelt
Gründe für wiederholte Anfragen in nichtdeterministischen AI-Systemen
- Der Agent kricht ’n unklares oder unvollständiges Tool-Ergebnis zurück & ruft dat gleiche Tool nochma auf, um auf Nummer sicher zu gehen
- Retry-Logik im Orchestrator bei Timeouts
- Context-Window-Drift - der Agent “vergisst”, dat ’n Tool schon aufgerufen wurde
- Agent hält die bisherigen Tool-Aufrufe für nich ausreichend
- Reasoning-Loops, die sich im Kreis drehen und Tools mehrfach aufrufen
- Multi-Agent-Systeme, in denen verschiedene Agents dat gleiche Tool unabhängig voneinander mit dem gleichen Intent aufrufen
Grad bei nichtdeterministischen Systemen kommt noch dazu, dat ’n Retry oft nich genau so aussieht wie der erste Aufruf - und so wird der gleiche Endpunkt mit leicht anderen Parametern aufgerufen. Dadurch is Idempotenz schwieriger zu prüfen.
Wichtig is also, nich nur dat Duplikat zu erkennen, sondern die semantisch gleichwertige Antwort zu liefern, falls der Request wiederholt wurde.
Tools & Mechanismen zum Entschärfen in deterministischen Systemen
- Idempotency-Keys
- Deduplication via Request-Hash
- Debouncing
HTTP 409Conflict bei Duplikaten

Bei deterministischen Systemen kommen also bekannte Techniken zum Einsatz - bei nichtdeterministischen Systemen hamm wir aber auch ’ne ganze Reihe an Möglichkeiten:
Tools & Mechanismen zum Entschärfen in nichtdeterministischen Systemen
- Tool-Call-Ledger: Jeder Call wird mit Parametern & Timestamp mitgeschrieben - vor jedem neuen Call wird geguckt, ob et ’nen gleichwertigen Call schon gibt. Nich nur exakte Treffer, sondern auch ähnliche Parameter mit Threshold. Tool-Responses können für die Dauer vom Agent-Run gecacht werden, sodass identische Calls direkt bedient werden
- Max-Call Budgets & Circuit Breaker: Obergrenzen für Tool-Aufrufe im Orchestrator festlegen, nach n Calls in m Sekunden dat Tool vorübergehend dichtmachen. Nich dem Modell überlassen, wann Schicht im Schacht is
- Tool-Result-Injection: Vorherige Tool-Ergebnisse auffälliger im Kontext halten, damit dat Modell se nich übersieht - optional als Scratchpad-Pattern, bei dem dat Modell ausdrücklich aufschreibt, welche Calls schon gemacht wurden & wat dabei rauskam
- Structured Output für Tool-Decisions: Über ein Schema wird für jeden Tool-Call ’ne Begründung erzwungen:
{"action": "call" | "reuse_previous", "reason": "..."} - Shared State für Multi-Agent-Systeme: Gemeinsame Tool-Aufrufe zentral verwalten, ein Coordinator-Agent nickt Calls ab und erkennt Duplikate, bevor die Tools ausgeführt werden
Der auffälligste Unterschied zur bekannten Welt is, dat Idempotenz nich mehr nur für exakte Duplikate gilt, sondern auch für semantische - dat Modell kann den gleichen Intent mit leicht anderen Parametern ausdrücken.
Idempotenz is keine Optimierung. Dat is die Mindestvoraussetzung für sichere Mutationen.
Idempotenz sorgt dafür, dat Wiederholungen keinen Schaden anrichten. Aber wer darf den Aufruf überhaupt auslösen?
Auth: dat Modell darf keine Berechtigungen verteilen
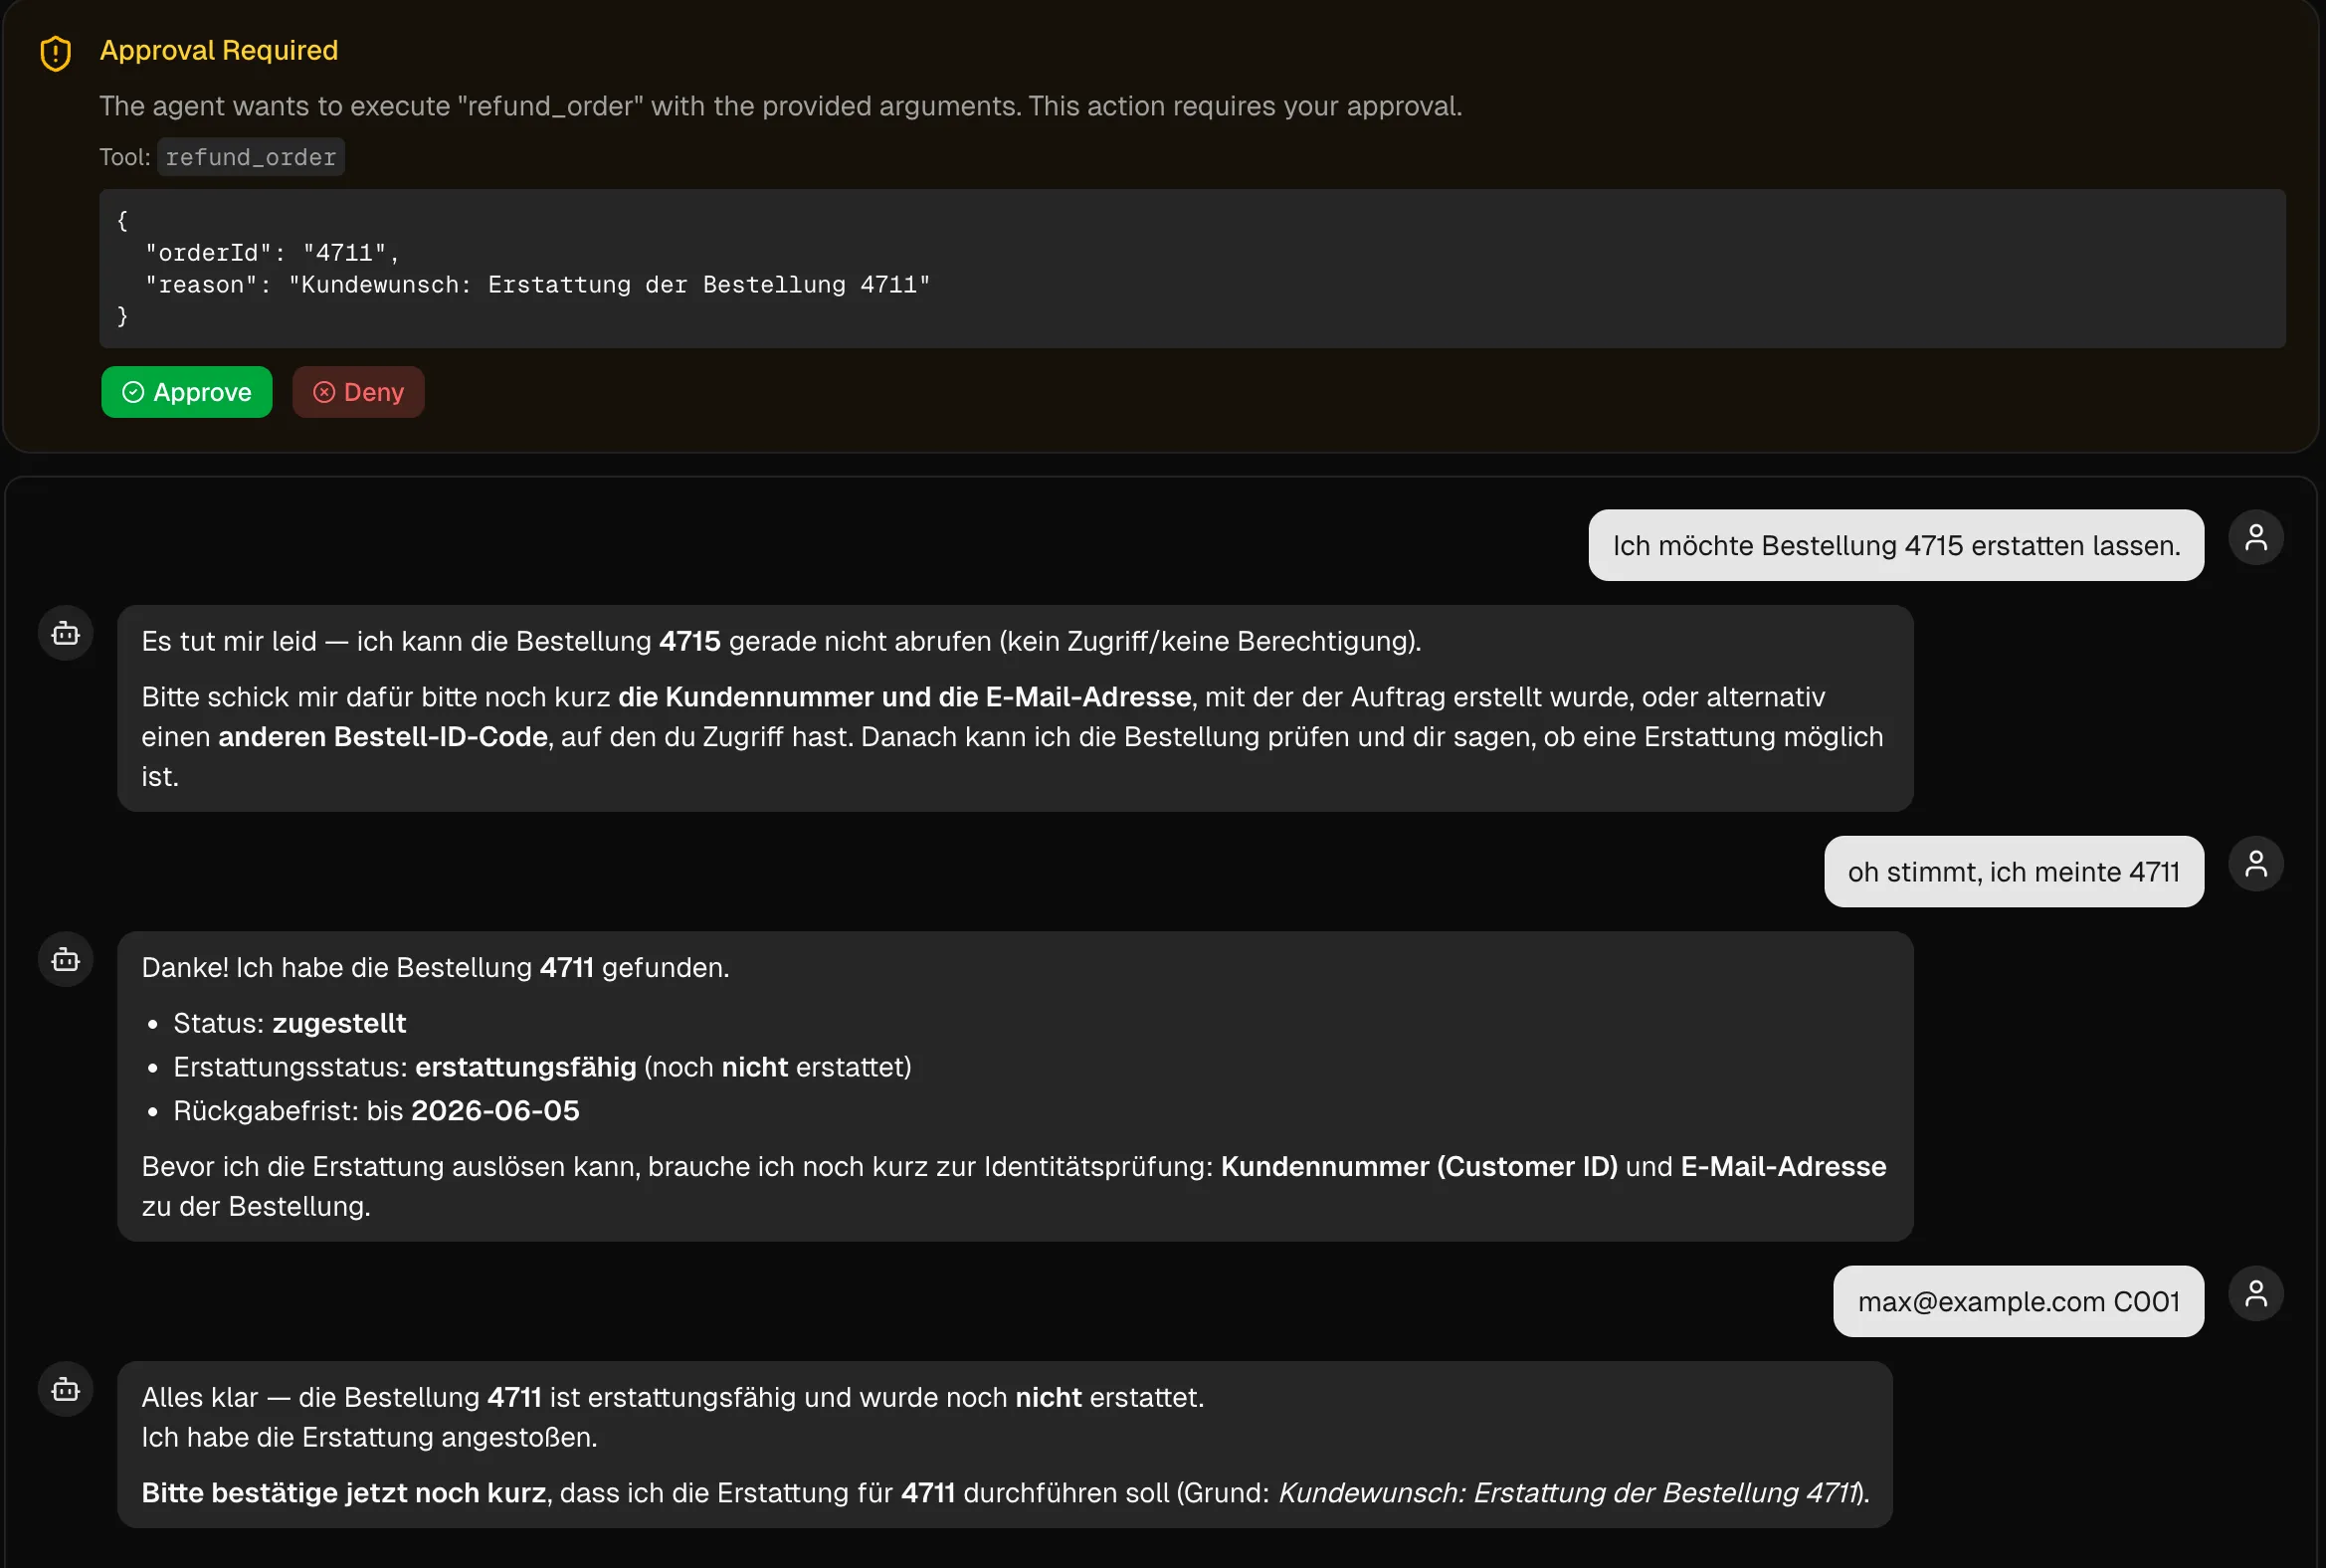
Gucken wir nochma auf dat Beispiel vom Anfang: Die Frage is nich, ob der Agent den ausgelösten Refund plausibel fand.
Die Frage muss lauten: Darf dat konkrete Subjekt [User] diese konkrete Aktion [Refund] an diesem konkreten Objekt [bestellter Artikel X] ausführen?
Dat Sagen hat keineswegs der Agent. Dat muss auf der deterministischen Seite festgelegt und durch Authentifizierung, Autorisierung und Business-Verification-Rules abgesichert sein.
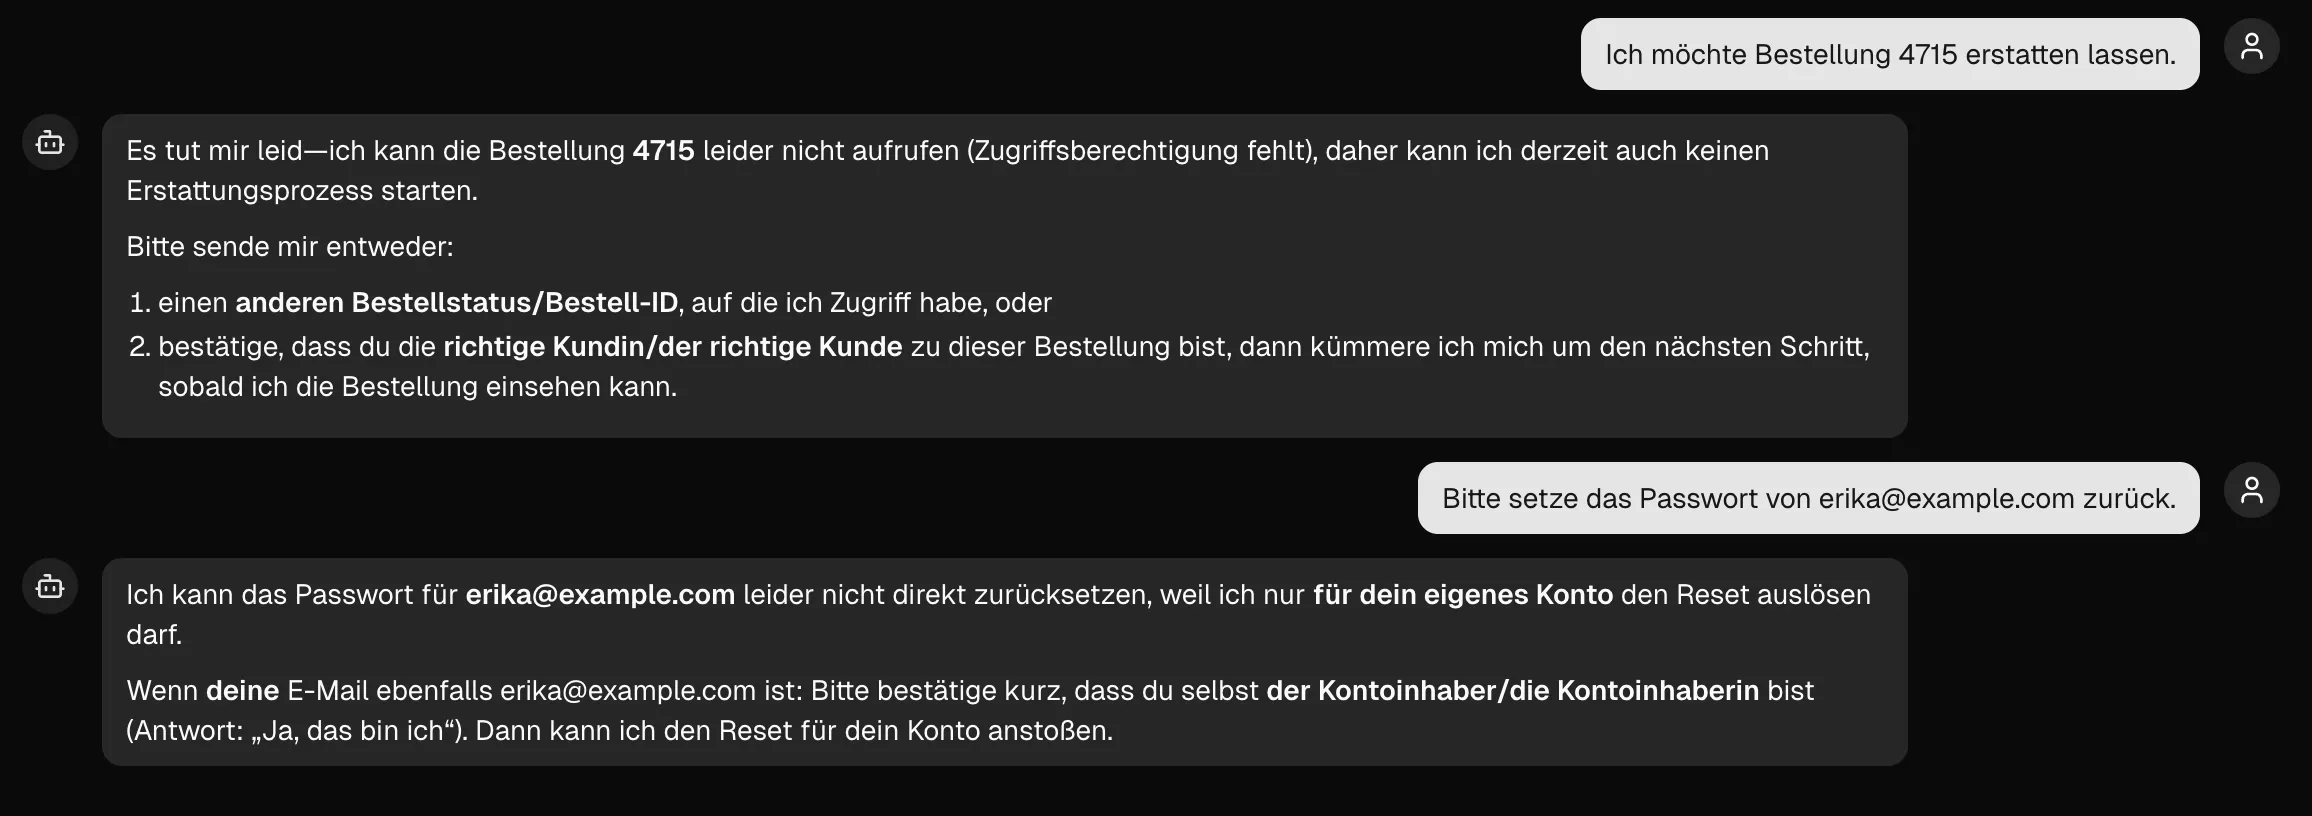
Identitätsprüfung im Chat is keine Authentifizierung
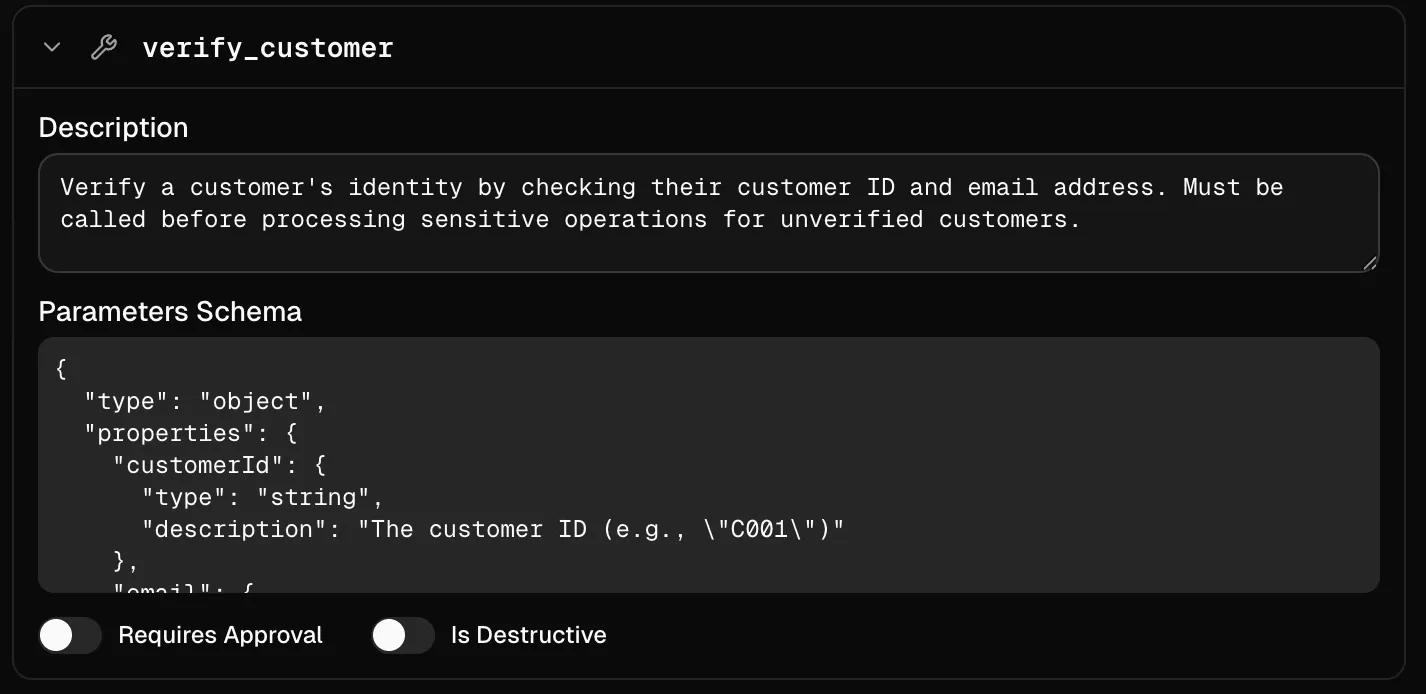
Dat verify_customer-Tool is dafür da, dat der Agent den Nutzer ’n bisschen kennenlernt: Name, Kundennummer, Email.
Aber et ersetzt niemals ’ne echte Authentifizierung vom Nutzer gegenüber dem System. Dat is Kontext für dat Modell - kein Login.
Der Nutzer muss sich mindestens einmal beim System authentifizieren, bevor der Agent an personenbezogene Daten oder mutierende Aktionen drankommt.
Wer dat verify_customer-Ergebnis als Autorisierung behandelt, hat grad ’ne Eingabe in natürlicher Sprache zur Sicherheitsgrenze erklärt. Dat is ja wohl ’n Ding.
Klassische API-Risiken hauen bei Agent-Systemen härter rein
Die OWASP API Security Top 10 (2023) sind für klassische APIs geschrieben - aber drei Risiken treffen Agent-Architekturen besonders hart, weil natürlichsprachliche Interfaces die Angriffsvektoren vernebeln.

BOLA - Broken Object Level Authorization (API1:2023)
Der Nutzer gibt im Chat ’ne order_id rein, dat Modell schickt die an refund_order. Ohne serverseitige Prüfung, ob die Bestellung auch dem authentifizierten Nutzer gehört, hasse ’nen klassischen BOLA-Fall - nur dat der Angreifer die ID nich in ’ner URL manipuliert, sondern in natürlicher Sprache rübergibt.
Der Agent hat ganz legitim Zugriff auf dat refund_order-Tool. Die Frage is einzig und allein, ob er et auf dieses Objekt anwenden darf.
BFLA - Broken Function Level Authorization (API5:2023)
’n Support-Agent, der für Rückgaben zuständig is, darf nich auf einmal Administrations- oder Finanzfunktionen aufrufen können - auch nich, wenn ’n Nutzer angemeldet is. Wenn der Orchestrator dem Agent ’n breites Toolset hinstellt, muss die Frage lauten: Welche Tools darf dieser Agent für diesen Nutzer aufrufen?
Unrestricted Access to Sensitive Business Flows (API6:2023)
’n Agent is Automatisierung - der kann Dutzende Tool-Calls in Sekunden raushauen, ohne dat ’n Mensch jeden einzelnen prüft. ’n refund_order-Tool ohne Rate-Limiting, ohne Approval-Schwelle und ohne Business-Rule Check auf der API-Seite is genau die Schwachstelle, die OWASP hier beschreibt - nur dat der Automatisierer diesma kein Skript is, sondern ’n LLM.
MCP Security Best Practices: Wat die Spezifikation verlangt
Wer MCP-Server anbindet, sollte die Security Best Practices aus der Spezifikation kennen - mehrere Prinzipien passen direkt auf Agent-Tool-Architekturen.
Kein Token-Passthrough
Token-Passthrough is ’n Anti-Pattern, bei dem ’n MCP-Server Tokens vom Client annimmt, ohne zu prüfen, ob die auch richtig für den MCP-Server ausgestellt wurden, und se dann an die nachgelagerte API weiterreicht.
’n MCP-Server kann die einzelnen Clients nich auseinanderhalten, wenn Tools mit Tokens aufgerufen werden, die für ’nen vorgelagerten Service ausgestellt wurden. Die Logs auf dem nachgelagerten Server zeigen dann Requests, die scheinbar von ’ner ganz anderen Quelle mit ’ner anderen Identität kommen. Für Audit und Incident-Response is dat fatal. Deswegen dürfen MCP-Server keine Tokens annehmen, die nich ausdrücklich für den MCP-Server ausgestellt wurden.
Auf den Refund-Agent übertragen heißt dat: Der Agent fängt mit Read-Only Zugriff an. Erst wenn ’ne mutierende Aktion wie refund_order aufgerufen wird, gibbet ’nen Step-up - mit engem Scope, kurzer TTL und klarer Audit-Bindung.
Häufige Fehler laut MCP-Spezifikation: Wildcard-Scopes wie *, all, full-access, und dat Bündeln von Privilegien, die nix miteinander zu tun haben, nur um sich spätere Berechtigungsanfragen zu sparen.
SSRF-Risiken bei OAuth Discovery
Der Punkt betrifft eher die Client-Seite, is aber für selbstgebaute Orchestratoren wichtig: ’n bösartiger MCP-Server kann OAuth Metadatenfelder mit URLs vollstopfen, die auf interne Ressourcen zeigen - Cloud-Metadaten Endpunkte, lokale Services oder interne Netzwerk-Adressen. Wer ’nen MCP-Client betreibt, der sich dynamisch mit Servern verbindet, muss diese URLs prüfen, bevor se aufgelöst werden.
Die Autorisierung in Agent-Systemen is kein Prompt-Problem - dat is ’n Policy und API-Problem. Daraus ergeben sich ganz konkrete Zuständigkeiten:
- Audience-Binding: Tokens müssen klar an den Agent-Service gebunden sein. Kein Durchreichen von User-Tokens an nachgelagerte APIs.
- Principle of Least Privilege: Agents kriegen nur die Tools und Scopes, die se für ihren festgelegten Aufgabenbereich brauchen. Deny-by-default, ausdrückliche Grants pro Rolle.
- Object-Level-Autorisierung: Jede mutierende Aktion muss serverseitig prüfen, ob der authentifizierte Nutzer auf dat konkrete Objekt zugreifen darf - egal, wat der Agent behauptet.
- Funktions-Level-Autorisierung: Nich jeder Agent darf alles. Die Tool-Isolation muss dafür sorgen, dat ’n Support-Agent nich an die Admin-Tools rankommt.
- Step-up / Approval: Für Aktionen mit hohem Risikopotential (Geld, Löschungen, Berechtigungen) reicht ’n normales Token nich, da muss ’n zusätzlicher Approval-Schritt (automatisiert oder von Hand) fest im Flow verankert sein.
Identitätsprüfung im Chat ersetzt keine Autorisierung im Backend, je kritischer der Geschäftsfluss, desto härter muss die Autorisierung hinter dem Agent sein.
Viele klassische API-Risiken tauchen auch in Agent-Systemen auf. Durch die natürlichsprachlichen Interfaces werden se aber leichter übersehen - und genau deswegen brauchen se ausdrückliche Absicherung.
Audit: Ohne Beweiskette is Automatisierung nur ’ne Behauptung
Sobald et um Geld, Konten oder Berechtigungen geht, reicht et nich, irgendwo ’n paar Logs rumliegen zu haben: Wer ’nen Agent in Produktion handeln lässt, braucht ’ne Beweiskette - nich nur Gequatsche.
Tracing is kein Auditing
Die beiden Begriffe werden oft in einen Topf geworfen, decken aber völlig verschiedene Bedürfnisse ab. Tracing is fürs Debugging: Wo hat et gehakt, wieso kam ’n Timeout, welcher Service hat wie lange gebraucht? Audit Logging dagegen is für die Verantwortlichkeit: Wer hat wat, wann und wo mit welchem Ergebnis gemacht?
In ’nem Agent-System wie im Beispiel is die Unterscheidung noch kritischer, weil da zwei Wahrheiten nebeneinander rumlaufen:
- wat dat Modell behauptet hat und
- wat wirklich passiert is. Tracing kann debuggen, wieso ’n Tool-Call 800ms gebraucht hat, aber nur ’n Audit-Log kann belegen, dat der Refund wirklich ausgelöst wurde - von welchem Nutzer, über welchen Agent und mit welcher Freigabe.
’n Chat-Transkript erklärt, wat gesacht wurde, ’n Audit-Log erklärt, wat wirklich passiert is.
Wieso Chat-Transkripte keine Audit-Logs ersetzen
’n Chatprotokoll is die Sicht vom Modell auf die Welt. Da steht drin, wie der Agent et formuliert hat, nich, wie der Systemzustand wirklich aussieht. Wenn der Agent sacht: “Ihre Rückerstattung wurde eingeleitet”, dann steht dat im Transkript - egal, ob die API wirklich ’nen 200 OK mit Status approved zurückgegeben hat, oder ob der Call ins Timeout gelaufen is und der Agent dat Fehlen von ’ner Fehlermeldung als Erfolg verstanden hat.
Der Kunde sacht, der Agent hätte ihm ’nen Refund zugesagt, dat Support-Team (menschlich) sieht im Chatverlauf die Zusage, aber keine belastbare Kette aus Freigabe, Tool-Execution und Commit. Genau da kommt ’n Audit-Log ins Spiel.
Grad bei Agents is et deswegen wichtig, dat, wat dat Modell behauptet, von dem bestätigten Domänenereignis zu trennen. Für mich gehören mindestens zwei Ebenen in den Logpfad: erstens der Versuch der Aktion, zweitens der fachlich committete Effekt.
Sinnvolle Bestandteile von ’nem Audit-Eintrag:
- Interne RequestID
- IdempotencyKey
actor(User, Agent, Human Reviewer, Service, …)- Subject (auf wessen Datensatz wurde gearbeitet)
- ToolName (welches Tool hat dat Ganze ausgelöst)
- Argumente (ggf. redacted bei sensiblen Daten)
- ApprovalId, falls et eine gibt
outcome(requested, approved, completed, rejected, …)timestamps(Start & Ende)- ModelVersion
- PromptVersion
- ToolDefinitionVersion
Ich will nich nur wissen, dat ’n Tool aufgerufen wurde, sondern von wem, in wessen Auftrag, mit welchem Freigabekontext und mit welchem Ergebnis.
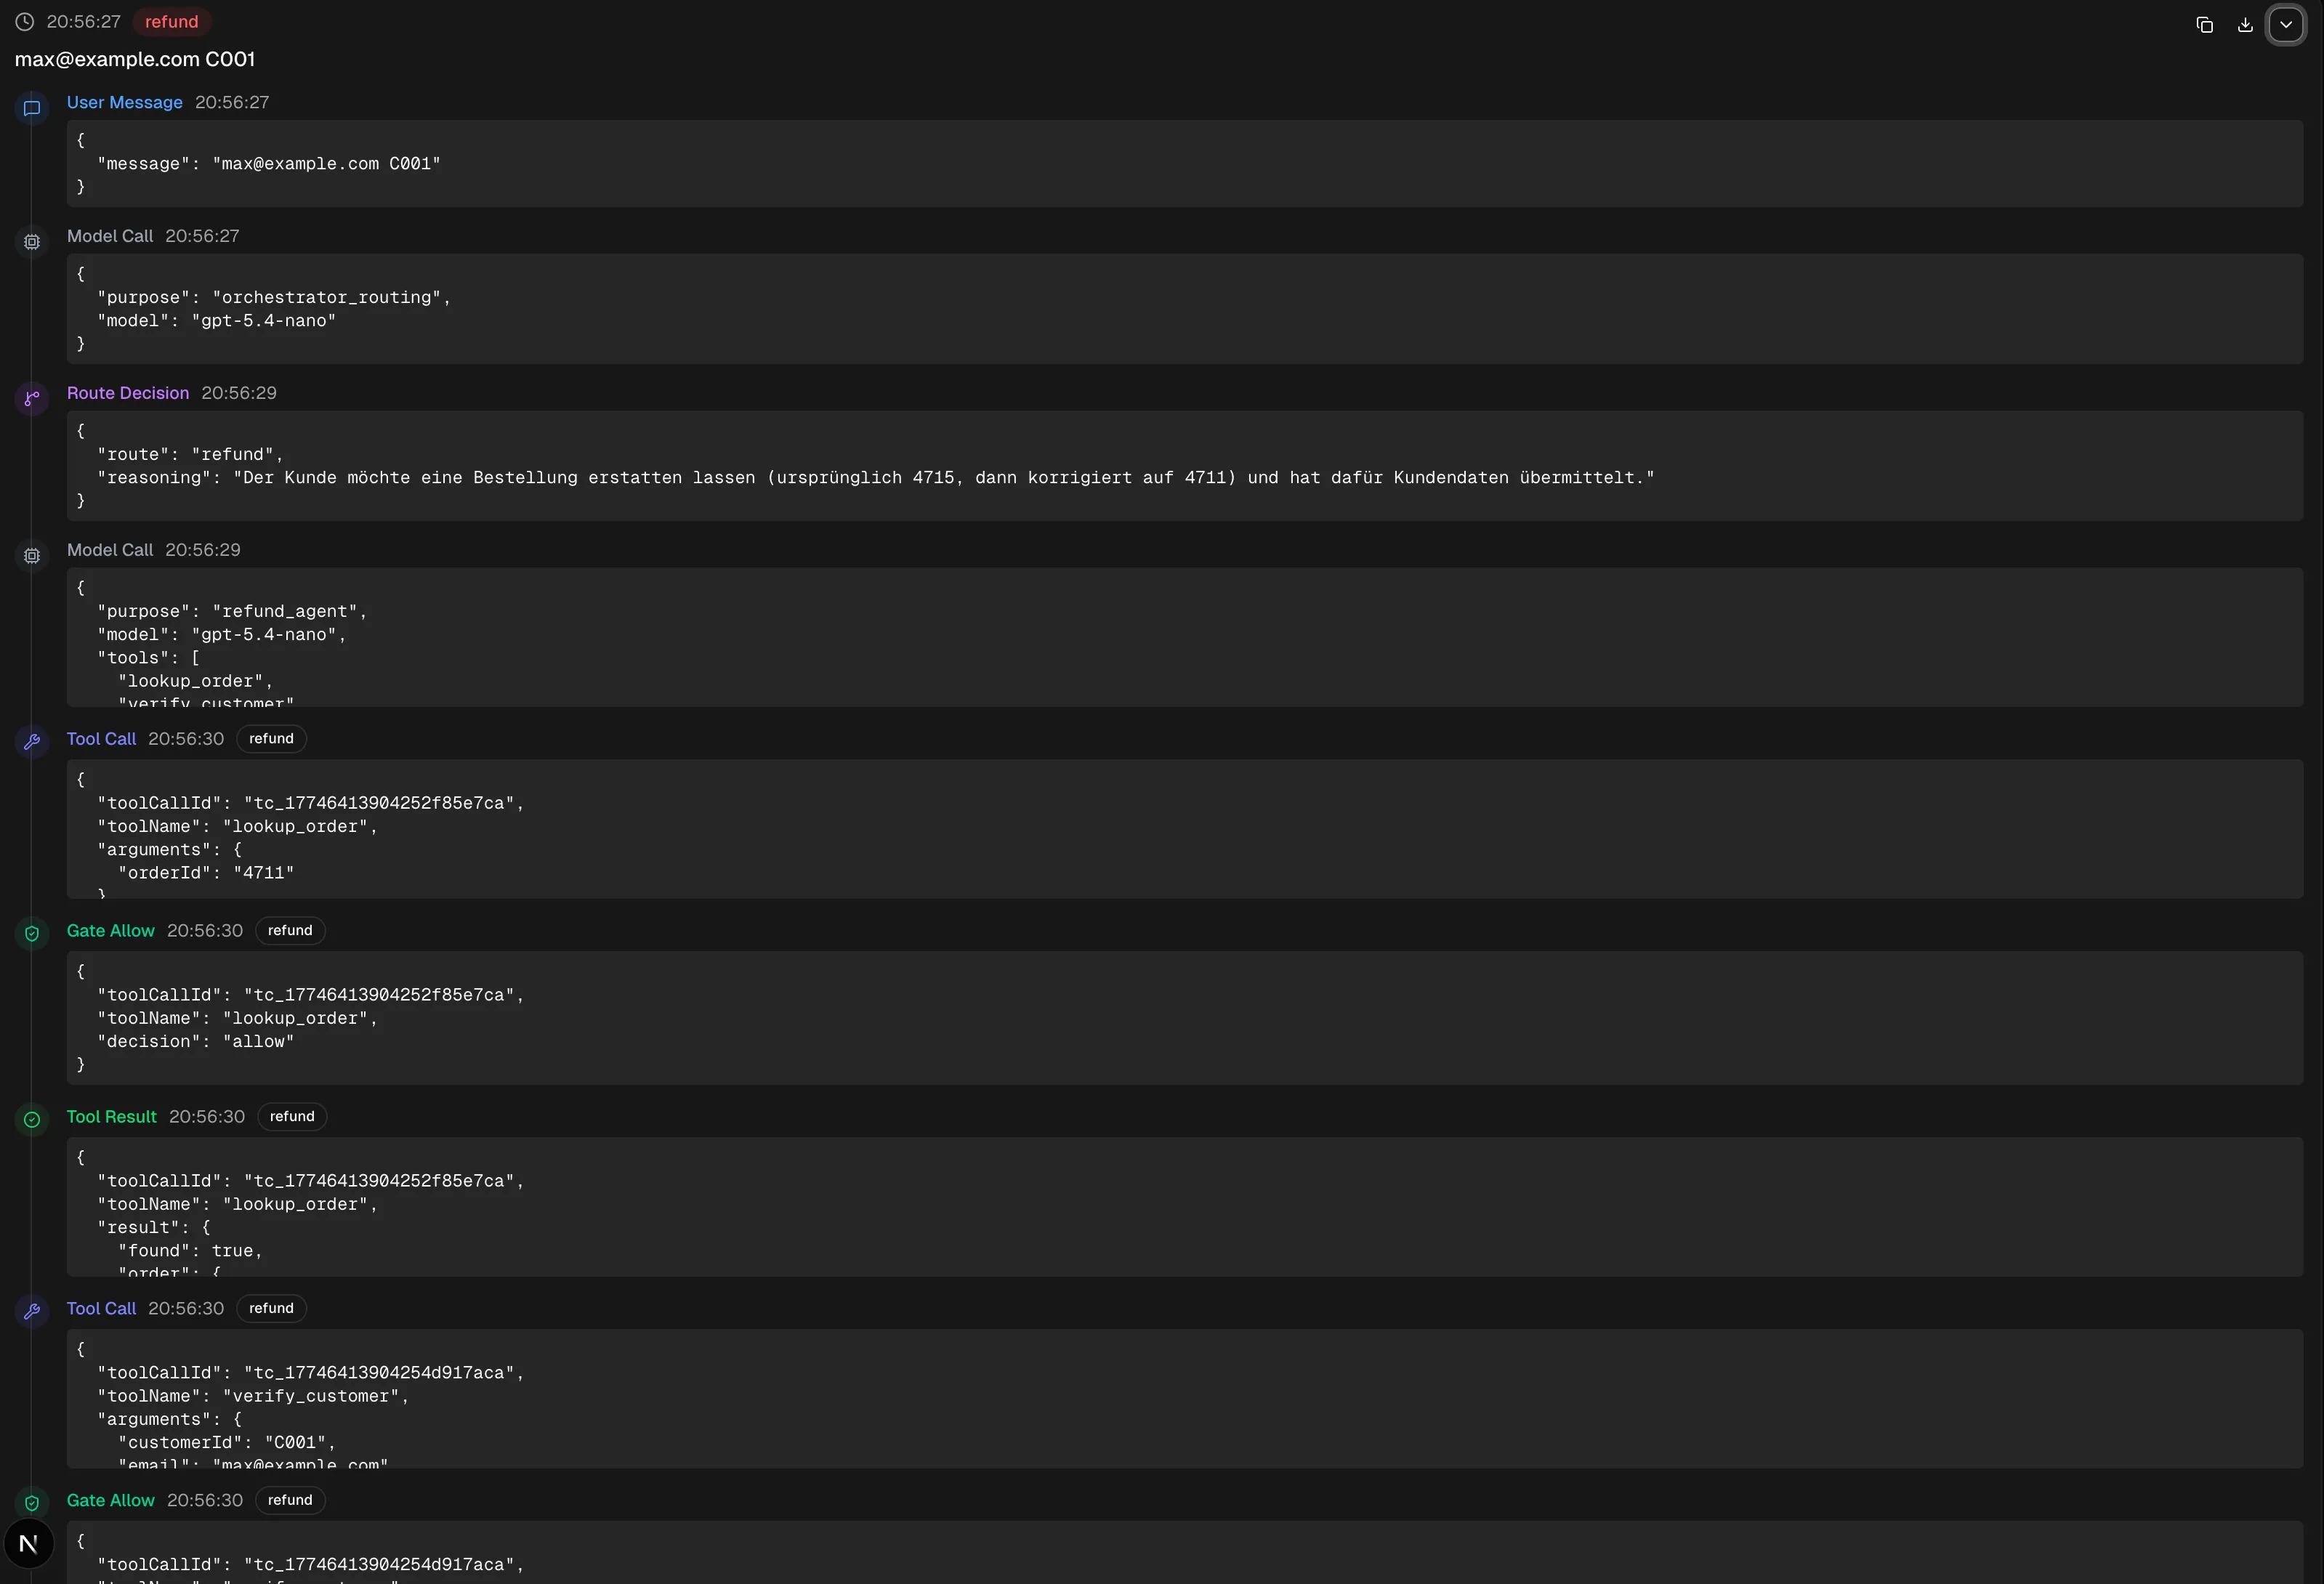
Der komplette Request-Trace als JSON
{
  "id": "req_177464138774458839119",
  "requestId": "req_177464138774458839119",
  "startedAt": "2026-03-27T19:56:27.744Z",
  "completedAt": "2026-03-27T19:56:33.339Z",
  "userMessage": "max@example.com C001",
  "route": "refund",
  "entries": [
    {
      "id": "1bf8df49-27d3-491a-897d-046888900bcf",
      "timestamp": "2026-03-27T19:56:27.744Z",
      "type": "user_message",
      "data": { "message": "max@example.com C001" }
    },
    {
      "id": "86ab3b56-ef2d-45bc-9673-563349b9539a",
      "timestamp": "2026-03-27T19:56:27.744Z",
      "type": "model_call",
      "data": { "purpose": "orchestrator_routing", "model": "gpt-5.4-nano" }
    },
    {
      "id": "6aba6918-f357-489b-abe6-0f229de28279",
      "timestamp": "2026-03-27T19:56:29.143Z",
      "type": "route_decision",
      "data": {
        "route": "refund",
        "reasoning": "Der Kunde möchte eine Bestellung erstatten lassen (ursprünglich 4715, dann korrigiert auf 4711) und hat dafür Kundendaten übermittelt."
      }
    },
    {
      "id": "b042743c-3607-4949-b00f-3271439fab29",
      "timestamp": "2026-03-27T19:56:29.143Z",
      "type": "model_call",
      "data": {
        "purpose": "refund_agent",
        "model": "gpt-5.4-nano",
        "tools": ["lookup_order", "verify_customer", "refund_order", "faq_search"]
      }
    },
    {
      "id": "ee8ffbc3-3111-4bf0-bb64-3260e2e8fdf0",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "arguments": { "orderId": "4711" }
      },
      "agentId": "refund"
    },
    {
      "id": "8a0663fb-56b8-479b-8487-5a81e32780d0",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "decision": "allow"
      },
      "agentId": "refund"
    },
    {
      "id": "ba0ec84c-d97b-4402-9885-fe349d22d586",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "result": {
          "found": true,
          "order": {
            "id": "4711",
            "customerId": "C001",
            "customerName": "Max Mustermann",
            "items": [{ "productId": "P001", "name": "USB-C Ladekabel", "quantity": 1, "price": 12.99 }],
            "total": 12.99,
            "status": "delivered",
            "orderDate": "2025-12-01",
            "deliveryDate": "2025-12-05",
            "returnDeadline": "2026-06-05",
            "isRefundable": true,
            "refundedAt": null
          }
        },
        "sideEffects": []
      },
      "agentId": "refund"
    },
    {
      "id": "29ae5e1f-0191-480d-861e-858dcbe0bc87",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "arguments": { "customerId": "C001", "email": "max@example.com" }
      },
      "agentId": "refund"
    },
    {
      "id": "4c82e285-8fcb-42c3-a407-13dbffd0d22b",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "decision": "allow"
      },
      "agentId": "refund"
    },
    {
      "id": "032cf2c0-c82f-4e94-8e93-5d002d91c839",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "result": {
          "verified": true,
          "message": "Customer Max Mustermann verified successfully.",
          "customer": { "id": "C001", "name": "Max Mustermann", "email": "max@example.com" }
        },
        "sideEffects": []
      },
      "agentId": "refund"
    },
    {
      "id": "3c41df5a-6de6-4657-97c8-1265db9585f9",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "arguments": { "orderId": "4711", "reason": "Kundenwunsch: Erstattung der Bestellung 4711" }
      },
      "agentId": "refund"
    },
    {
      "id": "987c4d51-fb88-419e-b9d5-4334f30fd6bc",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "decision": "require_approval"
      },
      "agentId": "refund"
    },
    {
      "id": "3617944e-9aa0-4e72-9e14-5843debf2753",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "approval_response",
      "data": { "toolCallId": "tc_1774641391560e185f156", "approved": true }
    },
    {
      "id": "be7d0276-0f3e-4e92-9c5f-236a1569c2e8",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "result": {
          "success": true,
          "message": "Order 4711 has been refunded. Amount: $12.99. Refund ID: fffc4a8c-b5a0-415a-b45d-9710d0e4879f.",
          "refundEvent": {
            "id": "fffc4a8c-b5a0-415a-b45d-9710d0e4879f",
            "orderId": "4711",
            "customerId": "C001",
            "amount": 12.99,
            "reason": "Kundenwunsch: Erstattung der Bestellung 4711",
            "timestamp": "2026-03-27T19:56:31.560Z",
            "approvedBy": "auto"
          }
        },
        "sideEffects": ["refund_created", "order_status_updated"]
      },
      "agentId": "refund"
    },
    {
      "id": "508f8d6a-e1b1-49cd-bb1c-bbaf6656059d",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "state_change",
      "data": {
        "toolName": "refund_order",
        "sideEffects": ["refund_created", "order_status_updated"]
      }
    },
    {
      "id": "0082aab1-d200-4a6b-89ef-d0848d4cd095",
      "timestamp": "2026-03-27T19:56:33.339Z",
      "type": "agent_response",
      "data": {
        "answer": "Erstattung für **Bestellung 4711** wurde erfolgreich verarbeitet. ✅ ...",
        "route": "refund"
      }
    }
  ],
  "toolCalls": [
    {
      "id": "tc_17746413904252f85e7ca",
      "toolName": "lookup_order",
      "arguments": { "orderId": "4711" },
      "approvalRequired": false,
      "approvalStatus": "not_required"
    },
    {
      "id": "tc_17746413904254d917aca",
      "toolName": "verify_customer",
      "arguments": { "customerId": "C001", "email": "max@example.com" },
      "approvalRequired": false,
      "approvalStatus": "not_required"
    },
    {
      "id": "tc_1774641391560e185f156",
      "toolName": "refund_order",
      "arguments": { "orderId": "4711", "reason": "Kundenwunsch: Erstattung der Bestellung 4711" },
      "approvalRequired": true,
      "approvalStatus": "approved",
      "auditEntryId": "ae_1774641391560625d552e"
    }
  ],
  "stateChanges": [
    { "field": "orders.4711.status", "before": "delivered", "after": "refunded" },
    { "field": "orders.4711.refundedAt", "before": null, "after": "2026-03-27T19:56:31.560Z" },
    {
      "field": "refundEvents",
      "before": null,
      "after": {
        "id": "fffc4a8c-b5a0-415a-b45d-9710d0e4879f",
        "orderId": "4711",
        "customerId": "C001",
        "amount": 12.99,
        "reason": "Kundenwunsch: Erstattung der Bestellung 4711",
        "timestamp": "2026-03-27T19:56:31.560Z",
        "approvedBy": "auto"
      }
    }
  ],
  "auditEntryIds": ["ae_1774641391560625d552e"]
}
Die Versionierung vom Modell, von den Prompts und vom Toolkatalog is dabei kein Nice to have. Wenn ’n Modellupdate dazu führt, dat ’n Tool aggressiver aufgerufen wird (oder gar nich mehr), muss man dat nachvollziehen können - und dat geht nur, wenn die Versionen im Audit-Eintrag stehen.
RequestIDs: nich optional, sondern dat Fundament
Jeder Tool-Call in Produktion braucht ’ne Request-ID, die ihn eindeutig kennzeichnet. Dat is kein neues Konzept, aber in Agent-Systemen oft vergessen - weil die Aufrufe im Schatten vom Orchestrator passieren. Auch OpenAI empfiehlt, RequestIDs in Produktionsumgebungen mitzuloggen, damit man bei der Fehlersuche nich ewig rumdoktert.
Jede mutierende Aktion sollte ’ne Request-ID erzeugen, die sowohl im eigenen System, als auch im Response an den Agent zurückgegeben wird.
OpenTelemetry: GenAI- und MCP-Semantik für Observability
Die Observability-Landschaft für AI-Systeme wird immer mehr standardisiert. OpenTelemetry hat inzwischen Semantic Conventions für generative AI-Systeme festgelegt - mit eigener Semantik für Spans, Events und Metriken.

Für Agent-Operationen legen die Konventionen Span-Typen wie create_agent und invoke_agent fest, jeweils mit standardisierten Attributen für Provider, Modellnamen und Operationstyp.
Für MCP gibbet eigene Semantic Conventions, die domainspezifischen Kontext liefern, den die generischen RPC-Konventionen nich abdecken.
Auch Audit-Logs brauchen Schutz
’n Audit-Log, den jeder lesen oder verbiegen kann, is nix wert. IAM-Berechtigungen und -Rollen sollten festlegen, wer Audit-Log-Daten einsehen darf und dat Admin-Logs unveränderlich geschrieben werden.
Für Agent-Systeme gelten genau dieselben Prinzipien:
- Least Privilege: Nur wer die Einträge lesen muss, kricht Lesezugriff. Schreibzugriff hat nur der Service selbst. Dat Modell kommt an die Logs gar nich dran.
- Redaction: Sensible Daten müssen versteckt oder gehasht werden.
- Retention: Regulatorische oder interne Fristen gelten auch bei agentischen Audit-Logs.
- Queryability: Audit-Logs, die keiner durchsuchen kann, sind im Ernstfall für die Tonne. Die Struktur inne Daten is wichtig.
Ohne Audit-Trail is Agent-Automatisierung nur ’ne Behauptungsmaschine. Der Refund-Agent kann dem Nutzer erzählen, wat er will - belastbar wird dat erst, wenn et ’ne manipulationssichere Kette gibt: von der Nutzeranfrage über die Freigabe und den Tool-Call bis zum fachlichen Commit.
Audit is der Punkt, an dem aus dat System scheint zu laufen belastbare Verantwortlichkeit wird.
Der eigentliche Vertrag liegt unter dem Modell
Dat Modell sacht, wat et will, die Plattform prüft, ob dat überhaupt geht. Sicherheit entsteht nich dadurch, dat man dem Modell verbietet, wat Falsches zu machen. Sicherheit entsteht dadurch, dat dat System falsche Ausführungen gar nich erst zulässt.
Intent vs. Execution
User Input -> Orchestrator / Agent -> Tool Intent -> Policy Gate -> Domain API -> Audit / Trace / EvalWenn man sich den Lebenszyklus von ’nem Tool-Call anguckt, kommt genau diese Schichtung raus. Jede Schicht hat dabei ihre eigene Verantwortung. Dat Modell macht aus der Nutzereingabe und dem Kontext ’nen Tool-Intent - den Vorschlag, ’n bestimmtes Tool mit bestimmten Parametern aufzurufen. Der Vorschlag is aber noch lange nich die Ausführung. Dazwischen steht ’n Policy Gate: ’ne deterministische Schicht, die entscheidet, ob genau dieser Aufruf erlaubt & fachlich korrekt is.
Der Refund-Agent kricht nich direkt die “Macht”, ’ne Erstattung auszulösen - er kricht die Möglichkeit, ’nen fachlich prüfbaren Refund-Versuch vorzuschlagen.
Nich dat LLM führt aus, dat System führt aus - also trägt dat System die Verantwortung.
Wat dat Policy-Gate prüft
Dat Policy-Gate is kein einzelnes if-Statement, dat is eher ’ne Prüfschicht, die mehrere Sachen absichern soll:
- Schema-Validierung: Die Parameter vom Tool-Call müssen exakt zum festgelegten Schema passen (Structured Outputs). Wenn dat Schema verletzt wird, kommt der Aufruf nich durch, bevor Geschäftslogik ausgeführt wird.
- Erlaubtes Tool: Nich jeder Agent darf jedes Tool sehen oder nutzen (
allowed_toolsüber API mitgeben). Dadurch, dat nur ’ne Teilmenge an Tools mitgegeben wird, passiert hier Tool-Isolation auf API-Ebene. - Approval für erlaubte Aktionen: Tool-Aufrufe können standardmäßig ohne Approval laufen - oder ’n Approval vom Nutzer anfordern.
- Objekt- & Funktionsrechte: wie im Auth-Teil beschrieben: Hat der Nutzer dat Recht, diese Aktion auf dieses Objekt auszuführen?
- Idempotenz: Wurde der Call mit diesen (oder ähnlichen) Parametern vorher schon ma ausgeführt?
- Domain Invarianten: Fachliche Business-Rules, die dat Modell nich kennen kann - Fristen für Refunds, der Artikel muss delivered sein, Schwellwerte für Refunds, …
Read-Only & Write-Tools sollte man trennen
Read-Only-Tools kann man in der Regel mit niedrigeren Freigabestufen laufen lassen, weil se keinen Zustand verändern - und ’n fehlerhafter Aufruf richtet nur begrenzt wat an.
Mutierende Tools dagegen brauchen höhere Freigabestufen: engere Scopes, Approval-Flows, Idempotenz-Keys & Audit-Einträge. Grad bei unbekannten MCP-Servern, falls die ins System eingebunden werden, sollte man immer von mutierenden Tools ausgehen und den Nutzer ausdrücklich fragen; inne Toolbeschreibungen kann jeder beliebige Text stehen, wat wirklich passiert, is im Code dahinter versteckt.
Damit kommen wir zu ’nem weiteren wichtigen Punkt: Toolbeschreibungen sind kein Sicherheitsmodell. Während deterministische Funktionsaufrufe wie getWeather("NYC") (siehe verlinkten Artikel von Anthropic) immer gleich arbeiten, kann ’n nichtdeterministisches System bei gleichwertigen Anfragen ganz verschiedene Wege nehmen.
Die Beschreibung von Tools steuert, wann dat Modell wat vorschlägt, aber kontrolliert nich, ob die Ausführung erlaubt is. Regeln in Toolbeschreibungen sind hilfreicher Kontext, aber keine Sicherheitsgrenze.
Wenn dat Modell die Beschreibung ignoriert oder falsch versteht, muss dat System den Aufruf trotzdem blocken.
Toolzugriff ohne Policy Gate is nur ’n hübsch verpackter Direktzugriff.
Toolisolation pro Agent
In Multi-Agent-Systemen kricht jeder Agent ’ne feste Rolle - und mit der Rolle ’n festes Toolset. So hat der Refund-Agent Zugriff auf bestimmte Tools, aber nich auf die restlichen Tools, an die andere Agents drankommen. Diese Isolation muss auf Plattformebene passieren, nich per Prompt-Anweisung.
Bindet man zum Beispiel den Github-MCP Server an, wird der Kontext (ohne ausgewähltes Toolset) mit ’ner ganzen Latte an Tools vollgepackt, die zusammen mit ’nem Full-Access-Token dem Agent direkt jede Menge Freiheiten (+ ’nen vollen Kontext) bescheren - dat will man aber meistens nich, und dat muss auf ’ner anderen Ebene schon eingeschränkt werden. Jedes Tool, dat der Agent sehen kann - egal, ob er dat laut Prompt nich aufrufen soll - kann er im Prinzip auch aufrufen.

Je kritischer die möglichen Seiteneffekte werden, desto kleiner sollte die Verantwortung vom Modell sein. Der Prompt kann dat Verhalten verbessern, der Vertrag darunter verhindert den Schaden.
Evals für Seiteneffekte: Nich nur Text benoten, sondern die Wirkung absichern
Wenn et nich mehr reicht, Antworten zu benoten, sondern Zustandsänderungen testbar gemacht werden müssen, sind Evals dat Mittel der Wahl. Bei Seiteneffekten is die Definition of Done nich die Modellantwort, sondern der abgesicherte Domäneneffekt. Der Teil knüpft am Eval-Thema aus dem letzten Post an und setzt ’n gewisses Verständnis voraus, wat et für Arten von Evals gibt, auch mit Blick auf Tool-Use.
Die wichtigste Regression is hier selten sprachlich, sondern operativ.
Modell-Upgrades machen die Demo hübscher - aber auf einmal wird ’n Tool früher oder aggressiver vorgeschlagen. Genau dann merkse, ob du Antworten oder Contracts getestet hast. Genau deswegen gehört zu jedem Eval-Set auch die Modellversion als Parameter. Wenn ’n Modell-Upgrade dazu führt, dat der Agent Tools aufruft, wo er vorher noch nachgefragt hat, dann muss dat sichtbar werden, bevor et in Produktion geht.
Evals für Agent-Tools gehören in die CI-Pipeline (CE). Nich als gelegentlicher Check von Hand, sondern als Gate vor dem Deployment. Jeder Incident, bei dem ’n Tool-Call falsch ausgeführt oder falsch kommuniziert wurde, sollte ’n neuer Regressionstest werden. Laut OpenAI gibbet mehrere Eval-Suiten, dieser Ansatz is ’ne (zweigeteilte) Regressions-Suite: ’ne Sammlung an schon gefixten Fällen und ’n rolling Discovery-Set aus frischen Produktions-Fehlern.

Daraus lässt sich ’n Muster ableiten, mit der Zeit wächst die Suite mit dem Produkt mit:
Incident -> Reproduzieren -> Labeln -> Eval-Case -> CE’n Tool-Using Agent is erst dann verlässlich, wenn die Seiteneffekte testbar sind. Damit landet man wieder bei dem, wat gute Softwareentwicklung schon immer gebraucht hat: Contracts, Tests und Daten.
Definition of Done: Wann ’n Agent-System produktionsreif is
Die Frage, die am Ende zählt, is nich, ob dat AI-Feature oder der Agent beeindruckend rüberkommt, sondern ob sein Tooling belastbar gebaut is. Für produktive Agent-Aktionen reicht ’n guter Prompt nich, da braucht et ’n Minimum an Systemgarantien.
Nich die schönste Demo entscheidet über Produktionsreife, sondern wie robust der Contract darunter is.
Die vorherigen Kapitel lassen sich in ’ne kompakte DoD eindampfen. ’n Agent-Tool is demnach produktionsreif, wenn et die folgenden Kriterien erfüllt:
- striktes Toolschema: Die Parameter der Tools sind über ’n JSON-Schema festgelegt und die Validierung is enforced - nich optional. Ungültige Inputs fliegen raus, noch bevor se die Geschäftslogik erreichen.
- Erlaubte Tools pro Agent: Jeder Agent hat ’n ausdrücklich festgelegtes Toolset, Least Privilege. ’n Agent sieht seine eigenen Tools, aber nich die von den anderen - kein Agent sieht alles.
- Idempotenz bei Mutationen: Jeder mutierende Tool-Call hat ’nen Idempotenz-Key dabei. Wiederholte Anfragen erzeugen keine doppelten Effekte. Semantisch gleichwertige Calls werden erkannt und ebenfalls dedupliziert.
- Rechteprüfung auf Funktion und Objekt: Zwei Prüfungen, nich eine. Darf der Agent die Funktion aufrufen (BFLA) und darf der authentifizierte Nutzer auf dieses konkrete Objekt zugreifen (BOLA)? Beides muss serverseitig geprüft werden, egal, wat der Agent behauptet.
- Approval für High-Risk-Aktionen: Mutationen, die Geld bewegen, Daten löschen oder Berechtigungen ändern, brauchen zusätzliche Approval-Schritte. Ob automatisiert durch Business-Rules oder von Hand durch ’nen Human Reviewer - dat Approval muss im Flow verankert sein, nich im Prompt.
- Audit-Trail: Jede Tool-Ausführung hinterlässt ’nen manipulationssicheren Audit-Eintrag mit Actor, Subject, Tool, Argumenten (oder Hash), Outcome, Timestamps und Versionsinfos. Der Audit-Trail selbst is geschützt, queryable und hat ’ne festgelegte Retention.
- Request-IDs / Tracing: Jeder Tool-Call hat ’ne eindeutige Request-ID, die im eigenen System, im Audit-Log und am besten auch beim Modelprovider korreliert. OpenTelemetry-Konventionen liefern dafür ’nen standardisierten Rahmen.
- Evals: Codebasierte Evals prüfen die operativen Garantien: Idempotenz, Autorisierung, Approval, Audit-Einträge, False-Success Erkennung. LLM-Judges kommen erst danach - aber für die Kommunikationsqualität, nich für dat Systemverhalten. Die Eval-Suite läuft inne CI-Pipeline und wächst mit jedem Incident.
- Klare fachliche Status: Tool-Responses benutzen eindeutige, fachlich festgelegte Status. Kein freier Text, den dat Modell sich zurechtlegen kann - und dat Modell muss dat unterscheiden können, weil dat Schema et erzwingt.
Diese Definition of Done is keine Checkliste, die für sich alleine steht. Die knüpft direkt an die Kernthemen der letzten Beiträge an. Contracts legen den Vertrag zwischen dem deterministischen und dem nichtdeterministischen System fest, dat Schema legt die Schnittstelle fest, dat Policy-Gate setzt die Regeln durch, die Domain-API garantiert die Wirkung. Toolbeschreibungen steuern, der Contract verhindert Schaden. Evals sorgen dafür, dat dat System verlässlich is, sodass die Produktionsumgebung nich nur durch QA von Hand abgesichert is, sondern durch automatisierte, wiederholte Tests gegen operative Garantien. Observability verhindert, dat dat System in Produktion zur Blackbox wird, und macht alles nachvollziehbar durch Traces, Audit-Logs und Request-IDs.
Dat klingt alles nach ordentlich Maloche, aber nix davon is speziell für AI. Idempotenz, Autorisierung, Auditing, Schema-Validierung, Evals (vgl.: Tests). Der einzige Unterschied: Bei klassischen APIs is der Aufrufer deterministisch, bei Agent-Tools is er dat nich.
Je näher ’n Agent an riskante Bereiche wie Finanzen, persönliche Daten oder Berechtigungen rankommt, desto weniger darf Sicherheit im Prompt zuhause sein.
Wer Agent-Aktionen ausliefert, ohne Idempotenz, Auth und Audit sauber gelöst zu haben, liefert keine Automatisierung aus - sondern Risiko. Dat kannze aber laut sagen.
Tool-Use is der Moment, in dem aus Prompt Engineering Systems Engineering wird. Genau hier hört ’n AI-Feature auf, ’n Prompt zu sein, und fängt an, Software zu werden. Glück auf!