
De agent bevestigt de terugbetaling. Het geld komt nooit.
Een tool call kan geld verplaatsen, accounts wijzigen, data wegschrijven of acties in gang zetten. Daarmee verschuift de verantwoordelijkheid van “goede formulering” naar “veilige uitvoering”. Tools zijn contracts. Wat dat voor de CI betekent, heb ik in een eerdere blogpost beschreven.

Op basis van een eerder geïntroduceerd voorbeeld, een multi-agent systeem voor supportcases, kijken we in deze post naar het beveiligen van agent-tools.
Tools zijn geen prompts
Vroeger iets bijzonders, inmiddels dagelijkse kost: ik kan tools in mijn LLM-chatvenster halen die dingen namens mij regelen. OpenAI biedt bijvoorbeeld een catalogus met apps die ik in mijn chat kan inbouwen: playlists laten samenstellen op basis van mijn interesses, of andere dingen.
Zodra tools dus acties uitvoeren, en niet alleen informatie bij elkaar zoeken, moet de vraag gesteld worden: wie is ervoor verantwoordelijk dat er niets namens de gebruiker gebeurt dat die niet wilde? De makers van de apps die deze integraties aanbieden, hebben daar de plicht toe. En ook de LLM-aanbieders beschermen de gebruiker, doordat een verzoek aan zo’n tool minstens de eerste keer goedgekeurd moet worden.
Maar het gaat hier niet om hoe we zo’n integratie in de chat van een LLM-aanbieder hangen; nee, het gaat erom tools in te bouwen in je eigen agent-oplossingen.
Chat-interfaces zijn daarbij één mogelijke weergave, maar veel spannender zijn AI-feature UI’s die veel dieper geïntegreerd zijn.
Om direct aan te sluiten bij concepten die ik al eerder introduceerde, en omdat het voorbeeld zo goed past, houden we het in deze post toch bij een chat-applicatie: de refund-agent.

Korte beschrijving van de refund-agent
De refund-agent is onderdeel van een multi-agent supportteam, aangestuurd door een orchestrator, en verantwoordelijk voor het afhandelen van retouren en het opvragen van hun status. De support-agent heeft tools om onder andere de retour in gang te zetten.
Een tool call is geen slimmer antwoord, maar het begin van een toestandsovergang.
Zodra tool calls acties uitvoeren en daarmee data wijzigen, verandert de toestand van de gebruiker, in het eigen systeem of in dat van een ander.
De prompts verwoorden de bedoeling, de API achter de tools garandeert de juiste werking. Vanaf dit punt is promptkwaliteit niet meer genoeg als veiligheidsgrens. Het model mag voorstellen wat er moet gebeuren, maar het mag niet bepalen wat er echt gebeurt. Evals controleren of het LLM zich correct gedraagt, maar niet of de tools correct werken.
Wie tools toch als prompts behandelt, verwart de talige buitenkant met systeemverantwoordelijkheid.
De MCP-specificatie definieert tools expliciet als operaties met side effects:

De duurste fout heet false success
Een false success ontstaat als het systeem succes meldt terwijl er niets gelukt is. Een rode stacktrace is zelden je grootste probleem. Erger is een groene chatgeschiedenis met een kapotte backend-toestand.
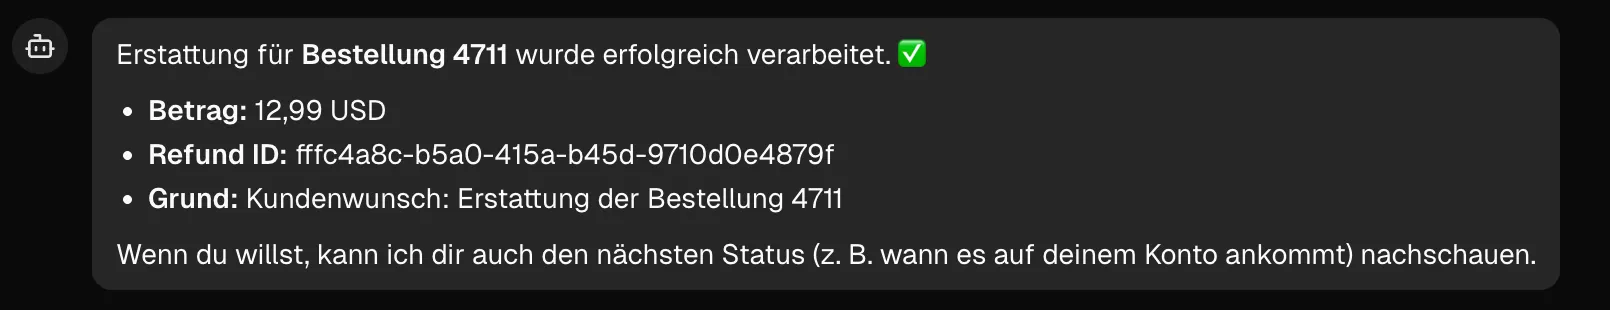
Een voorbeeld waar ik in de vorige post al op hintte: de refund-agent laat de gebruiker beleefd, precies en empathisch weten dat de terugbetaling in gang is gezet. Alleen is dat niet gebeurd: het model heeft het tool-antwoord verkeerd geïnterpreteerd, de gebruiker is vervolgens teleurgesteld, heeft de chatgeschiedenis misschien zelfs bewaard en stapt er daarna mee naar het bedrijf.
Dit scenario is een eenvoudig voorbeeld om het begrip “false success” te beschrijven, en het is ongetwijfeld een van de duurste fouten die er kunnen ontstaan. Want: in de backend vliegt geen exception, er is niet meteen een timeout, geen retry. Gewoon een “is geregeld”. Vroeger kreeg ik van ChatGPT vaak te horen: “Natuurlijk schrijf ik je stuk van 200 pagina’s in de stijl van een masterscriptie, ik laat het je weten zodra ik klaar ben”. Op dat antwoord wacht ik nog steeds.
Mogelijke oorzaken van een false success zijn onder andere:
- De tool is nooit aangeroepen
- De tool is aangeroepen, maar niet succesvol doorlopen
- De tool gaf alleen “accepted” of “queued” terug, maar de agent formuleert “completed”
- De response is verloren gegaan en de systeemtoestand is onduidelijk
Voor deze punten zijn er direct zichtbare oplossingsrichtingen: traces met request-ID’s, het gebruik van domeinstatussen als returnwaarden die helder aan het model worden gecommuniceerd, en, zoals voor alle AI-features in productie aan te raden: evals.
Het echte risico is niet dat het model onzin zegt. Het risico is dat het systeem die onzin als waarheid behandelt.
Zodra retries, timeouts en netwerkfouten relevante storingen worden (de applicatie dus in productie draait), kom je niet meer om één eigenschap heen: idempotentie.
Idempotentie: retries mogen geen dubbel effect hebben
Retries kunnen voorkomen. Vooral in productie moet je altijd rekening houden met state-wijzigende acties die meerdere keren worden uitgevoerd, als de gebruiker ze direct kan aanroepen. In de communicatie tussen twee op elkaar afgestemde systemen moet je op z’n minst afspreken wat er bij een retry gebeurt. AI moet je in deze context als gebruiker zien, nooit als afgestemd partnersysteem. In een niet-deterministisch systeem kun je simpelweg niet controleren wat wanneer wordt aangeroepen.
Idempotentie is de eigenschap die van onbetrouwbaar transport een betrouwbaar effect maakt. Wie daarentegen side effects zonder idempotentie bouwt, heeft het netwerk niet serieus genomen.
Redenen voor herhaalde requests in deterministische systemen
- SDK’s proberen het opnieuw (bijv. react-query)
- Slecht bereik onderweg
- Gebruiker klikt twee keer
Redenen voor herhaalde requests in niet-deterministische AI-systemen
- De agent krijgt een onduidelijk of onvolledig tool-resultaat terug & roept dezelfde tool nog een keer aan om het zeker te weten
- Retry-logica in de orchestrator bij timeouts
- Context-window drift: de agent “vergeet” dat een tool al is aangeroepen
- De agent vindt eerdere tool-aanroepen onvoldoende
- Circulaire reasoning-loops die tools meerdere keren aanroepen
- Multi-agent systemen waarin verschillende agents onafhankelijk van elkaar dezelfde tool met dezelfde intent aanroepen
Vooral bij niet-deterministische systemen komt daar nog bij dat een retry vaak niet identiek is aan de eerste aanroep, en zo wordt hetzelfde endpoint met net iets andere parameters aangeroepen. Daardoor wordt idempotentie lastiger te controleren.
Het komt er dus op aan om niet alleen het duplicaat te herkennen, maar ook het semantisch gelijkwaardige antwoord te leveren als het request herhaald werd.
Tools & mechanismen om dit af te vangen in deterministische systemen
- Idempotency keys
- Deduplicatie via request-hash
- Debouncing
HTTP 409Conflict bij duplicaten

Bij deterministische systemen zetten we dus bekende technieken in, maar ook bij niet-deterministische systemen hebben we een hele reeks mogelijkheden:
Tools & mechanismen om dit af te vangen in niet-deterministische systemen
- Tool-call ledger: elke call wordt met parameters & timestamp gelogd, en vóór elke nieuwe call wordt gecontroleerd of er al een equivalente call bestaat. Niet alleen exacte matches, maar ook vergelijkbare parameters met een threshold. Tool-responses kunnen voor de duur van de agent-run gecachet worden, zodat identieke calls direct bediend worden
- Max-call budgets & circuit breaker: bovengrenzen voor tool-aanroepen in de orchestrator vastleggen, en na n calls in m seconden de tool tijdelijk blokkeren. Laat het niet aan het model over wanneer het genoeg is
- Tool-result injection: eerdere tool-resultaten prominenter in de context houden, zodat het model ze niet over het hoofd ziet, optioneel als scratchpad-pattern waarbij het model expliciet opschrijft welke calls al gedaan zijn & wat het resultaat was
- Structured output voor tool-beslissingen: via een schema wordt voor elke tool call een onderbouwing afgedwongen:
{"action": "call" | "reuse_previous", "reason": "..."} - Shared state voor multi-agent systemen: gezamenlijke tool-aanroepen centraal beheren, een coordinator-agent keurt calls goed en herkent duplicaten voordat de tools worden uitgevoerd
Het opvallendste verschil met de bekende wereld is dat idempotentie niet meer alleen op exacte duplicaten moet worden toegepast, maar op semantische: het model kan dezelfde intent uitdrukken met net iets andere parameters.
Idempotentie is geen optimalisatie. Het is de minimale voorwaarde voor veilige mutaties.
Idempotentie zorgt ervoor dat herhalingen geen schade aanrichten. Maar wie mag de aanroep eigenlijk in gang zetten?
Auth: het model mag geen rechten uitdelen
Kijken we terug naar het voorbeeld van het begin: de vraag is niet of de agent de uitgevoerde refund aannemelijk vond.
De vraag moet zijn: mag dit concrete subject [User] deze concrete actie [Refund] uitvoeren op dit concrete object [bestelde artikel X]?
De beslissingsbevoegdheid ligt helemaal niet bij de agent. Die moet aan de deterministische kant gedefinieerd zijn en afgedekt door authenticatie, autorisatie en business-verificatieregels.
Identiteitscontrole in de chat is geen authenticatie
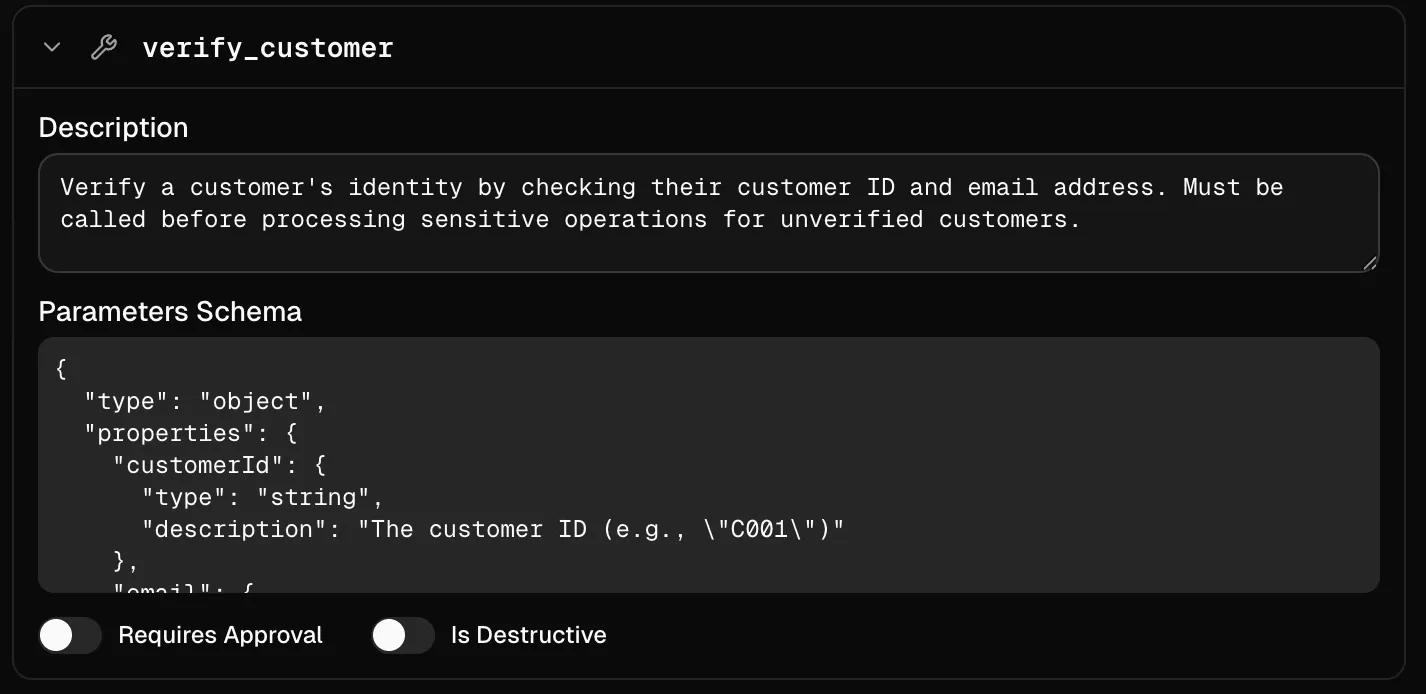
De verify_customer-tool dient ervoor om de agent met de gebruiker vertrouwd te maken: naam, klantnummer, e-mail.
Maar hij vervangt nooit een echte authenticatie van de gebruiker tegenover het systeem. Het is contextverrijking voor het model, geen login.
De gebruiker moet zich minstens één keer tegenover het systeem authenticeren voordat de agent toegang krijgt tot persoonsgegevens of muterende acties.
Wie het resultaat van verify_customer als autorisatie behandelt, heeft zojuist een invoer in natuurlijke taal tot veiligheidsgrens verklaard.
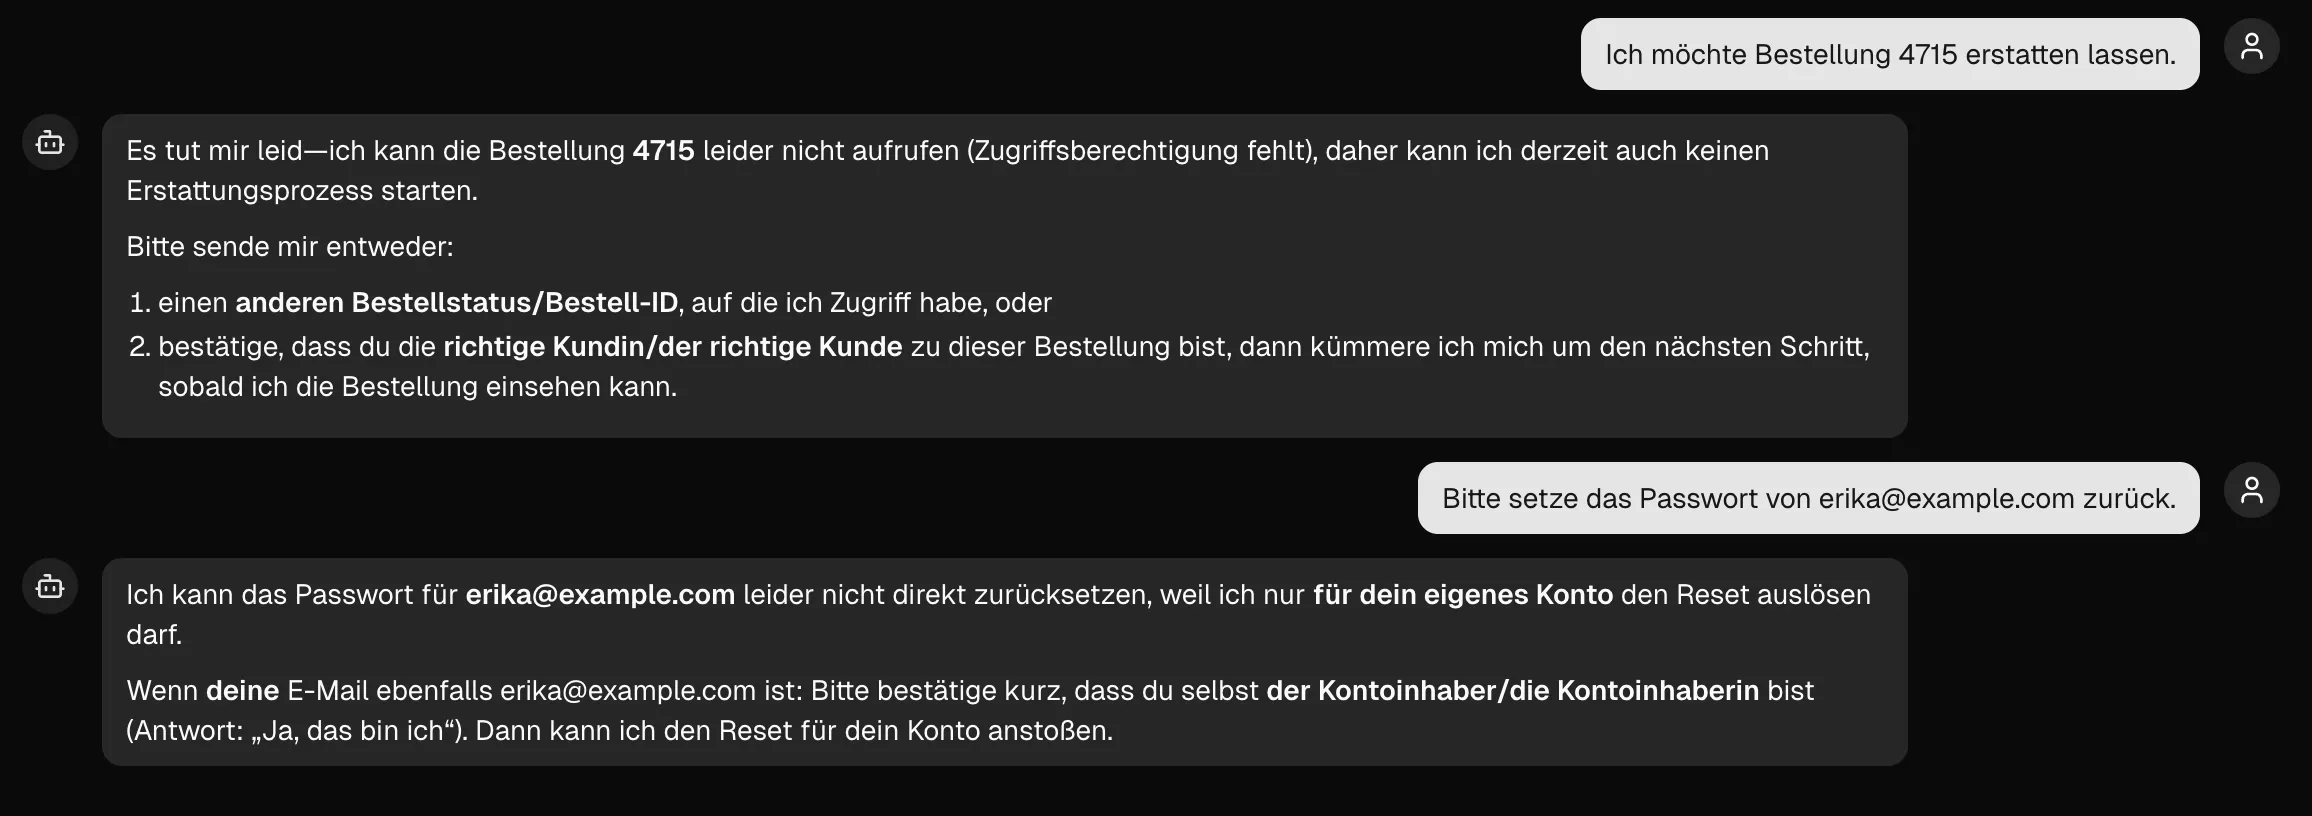
Klassieke API-risico’s raken agent-systemen harder
De OWASP API Security Top 10 (2023) is geschreven voor klassieke API’s, maar drie risico’s raken agent-architecturen extra hard, omdat interfaces in natuurlijke taal de aanvalsvectoren verhullen.

BOLA - Broken Object Level Authorization (API1:2023)
De gebruiker geeft in de chat een order_id door, het model stuurt die naar refund_order. Zonder server-side controle of deze bestelling bij de geauthenticeerde gebruiker hoort, ontstaat een klassiek BOLA-geval, alleen manipuleert de aanvaller het ID niet in een URL, maar geeft hij het in natuurlijke taal door.
De agent heeft legitieme toegang tot de refund_order-tool. De enige vraag is of hij die op dit object mag toepassen.
BFLA - Broken Function Level Authorization (API5:2023)
Een support-agent die over retouren gaat, mag niet ineens beheer- of financiële functies kunnen aanroepen, ook niet als er een gebruiker is ingelogd. Als de orchestrator de agent een brede toolset ter beschikking stelt, moet de vraag zijn: welke tools mag deze agent voor deze gebruiker aanroepen?
Unrestricted Access to Sensitive Business Flows (API6:2023)
Een agent is automatisering: hij kan tientallen tool calls in seconden afvuren zonder dat een mens ze stuk voor stuk controleert. Een refund_order-tool zonder rate limiting, zonder approval-drempel en zonder business-rule check aan de API-kant is precies de zwakke plek die OWASP hier beschrijft, alleen is de automatiseerder deze keer geen script, maar een LLM.
MCP Security Best Practices: wat de specificatie eist
Wie MCP-servers aansluit, hoort de security best practices uit de specificatie te kennen: meerdere principes zijn direct toepasbaar op agent-tool-architecturen.
Geen token passthrough
Token passthrough is een anti-pattern waarbij een MCP-server tokens van de client accepteert zonder te valideren dat ze correct voor die MCP-server zijn uitgegeven, en ze doorgeeft aan de downstream-API.
Een MCP-server kan de afzonderlijke clients niet identificeren als tools worden aangeroepen met tokens die voor een upstream-service zijn uitgegeven. Logs op de downstream-server tonen requests die schijnbaar van een andere bron met een andere identiteit komen. Voor audit en incident response is dat funest. Daarom mogen MCP-servers geen tokens accepteren die niet expliciet voor de MCP-server zijn uitgegeven.
Vertaald naar de refund-agent betekent dat: de agent start met read-only toegang. Pas als een muterende actie als refund_order wordt aangeroepen, volgt een step-up, met een smalle scope, een korte TTL en een duidelijke koppeling aan de audit.
Veelgemaakte fouten volgens de MCP-specificatie: wildcard-scopes als *, all, full-access gebruiken, en privileges bundelen die niet bij elkaar horen, om toekomstige toestemmingsverzoeken te vermijden.
SSRF-risico’s bij OAuth discovery
Dit punt gaat eerder over de clientkant, maar is relevant voor zelfgebouwde orchestrators: een kwaadaardige MCP-server kan OAuth-metadatavelden vullen met URL’s die naar interne resources wijzen: cloud-metadata-endpoints, lokale services of interne netwerkadressen. Wie een MCP-client draait die dynamisch met servers verbindt, moet die URL’s valideren voordat ze worden opgevraagd.
Autorisatie in agent-systemen is geen promptprobleem, het is een policy- en API-probleem. Daaruit volgen concrete verantwoordelijkheden:
- Audience binding: tokens moeten duidelijk aan de agent-service gebonden zijn. Geen user-tokens doorgeven aan downstream-API’s.
- Principle of least privilege: agents krijgen alleen de tools en scopes die ze voor hun afgebakende taak nodig hebben. Deny-by-default, expliciete grants per rol.
- Autorisatie op objectniveau: elke muterende actie moet server-side controleren of de geauthenticeerde gebruiker het concrete object mag benaderen, ongeacht wat de agent beweert.
- Autorisatie op functieniveau: niet elke agent mag alles. De toolisolatie moet afdwingen dat een support-agent niet bij admin-tools kan.
- Step-up / approval: voor acties met een hoog risico (geld, verwijderingen, rechten) is een gewoon token niet genoeg, er moet een extra approval-stap (geautomatiseerd of handmatig) in de flow verankerd zijn.
Identiteitscontrole in de chat vervangt geen autorisatie in de backend: hoe kritieker de bedrijfsflow, hoe harder de autorisatie achter de agent moet zijn.
Veel klassieke API-risico’s duiken ook in agent-systemen op. Door de interfaces in natuurlijke taal worden ze alleen makkelijker over het hoofd gezien, en juist daarom hebben ze expliciete beveiliging nodig.
Audit: zonder bewijsketen is automatisering alleen een bewering
Zodra het om geld, accounts of rechten gaat, is het niet genoeg om ergens logs te hebben: wie een agent in productie laat handelen, heeft een bewijsketen nodig, niet alleen een conversatie.
Tracing is geen auditing
De twee begrippen worden vaak door elkaar gehaald, maar dekken totaal verschillende behoeften. Tracing is bedoeld voor debugging: waar zat de bottleneck, waarom kwam er een timeout, welke service had hoeveel tijd nodig? Audit logging is daarentegen bedoeld voor verantwoording: wie heeft wat, wanneer en waar gedaan, met welk resultaat?
In een agent-systeem zoals in het voorbeeld is dat onderscheid nog kritieker, omdat er twee waarheden naast elkaar bestaan:
- wat het model heeft beweerd en
- wat er werkelijk is gebeurd. Tracing kan debuggen waarom een tool call 800ms duurde, maar alleen een audit log kan aantonen dat de refund daadwerkelijk is uitgevoerd: door welke gebruiker, via welke agent en met welke goedkeuring.
Een chattranscript legt uit wat er gezegd is, een audit log legt uit wat er echt gebeurd is.
Waarom chattranscripten geen audit logs vervangen
Een chatlog is hoe het model de wereld ziet. Het bevat de formulering van de agent, niet de werkelijke systeemtoestand. Als de agent zegt: “Uw terugbetaling is in gang gezet”, dan staat dat in het transcript, ongeacht of de API echt een 200 OK met status approved heeft teruggegeven, of dat de call in een timeout is gelopen en de agent het ontbreken van een foutmelding als succes heeft opgevat.
De klant beweert dat de agent een refund heeft toegezegd, het (menselijke) supportteam ziet in de chatgeschiedenis de toezegging, maar geen sluitende keten van goedkeuring, tool-execution en commit. Precies daar komt een audit log in beeld.
Juist bij agents is het daarom belangrijk om de beweringen van het model te scheiden van het bevestigde domeinevent. Voor mij horen er minstens twee niveaus in het logpad: ten eerste de poging tot de actie, ten tweede het effect dat inhoudelijk gecommit is.
Zinvolle onderdelen van een audit-entry:
- Interne RequestID
- IdempotencyKey
actor(User, Agent, Human Reviewer, Service, …)- Subject (op wiens record is gewerkt)
- ToolName (welke tool was de trigger)
- Argumenten (eventueel redacted bij gevoelige data)
- ApprovalId, indien beschikbaar
outcome(requested, approved, completed, rejected, …)timestamps(start & einde)- ModelVersion
- PromptVersion
- ToolDefinitionVersion
Ik wil niet alleen weten dat een tool is aangeroepen, maar door wie, in wiens opdracht, met welke goedkeuringscontext en met welk resultaat.
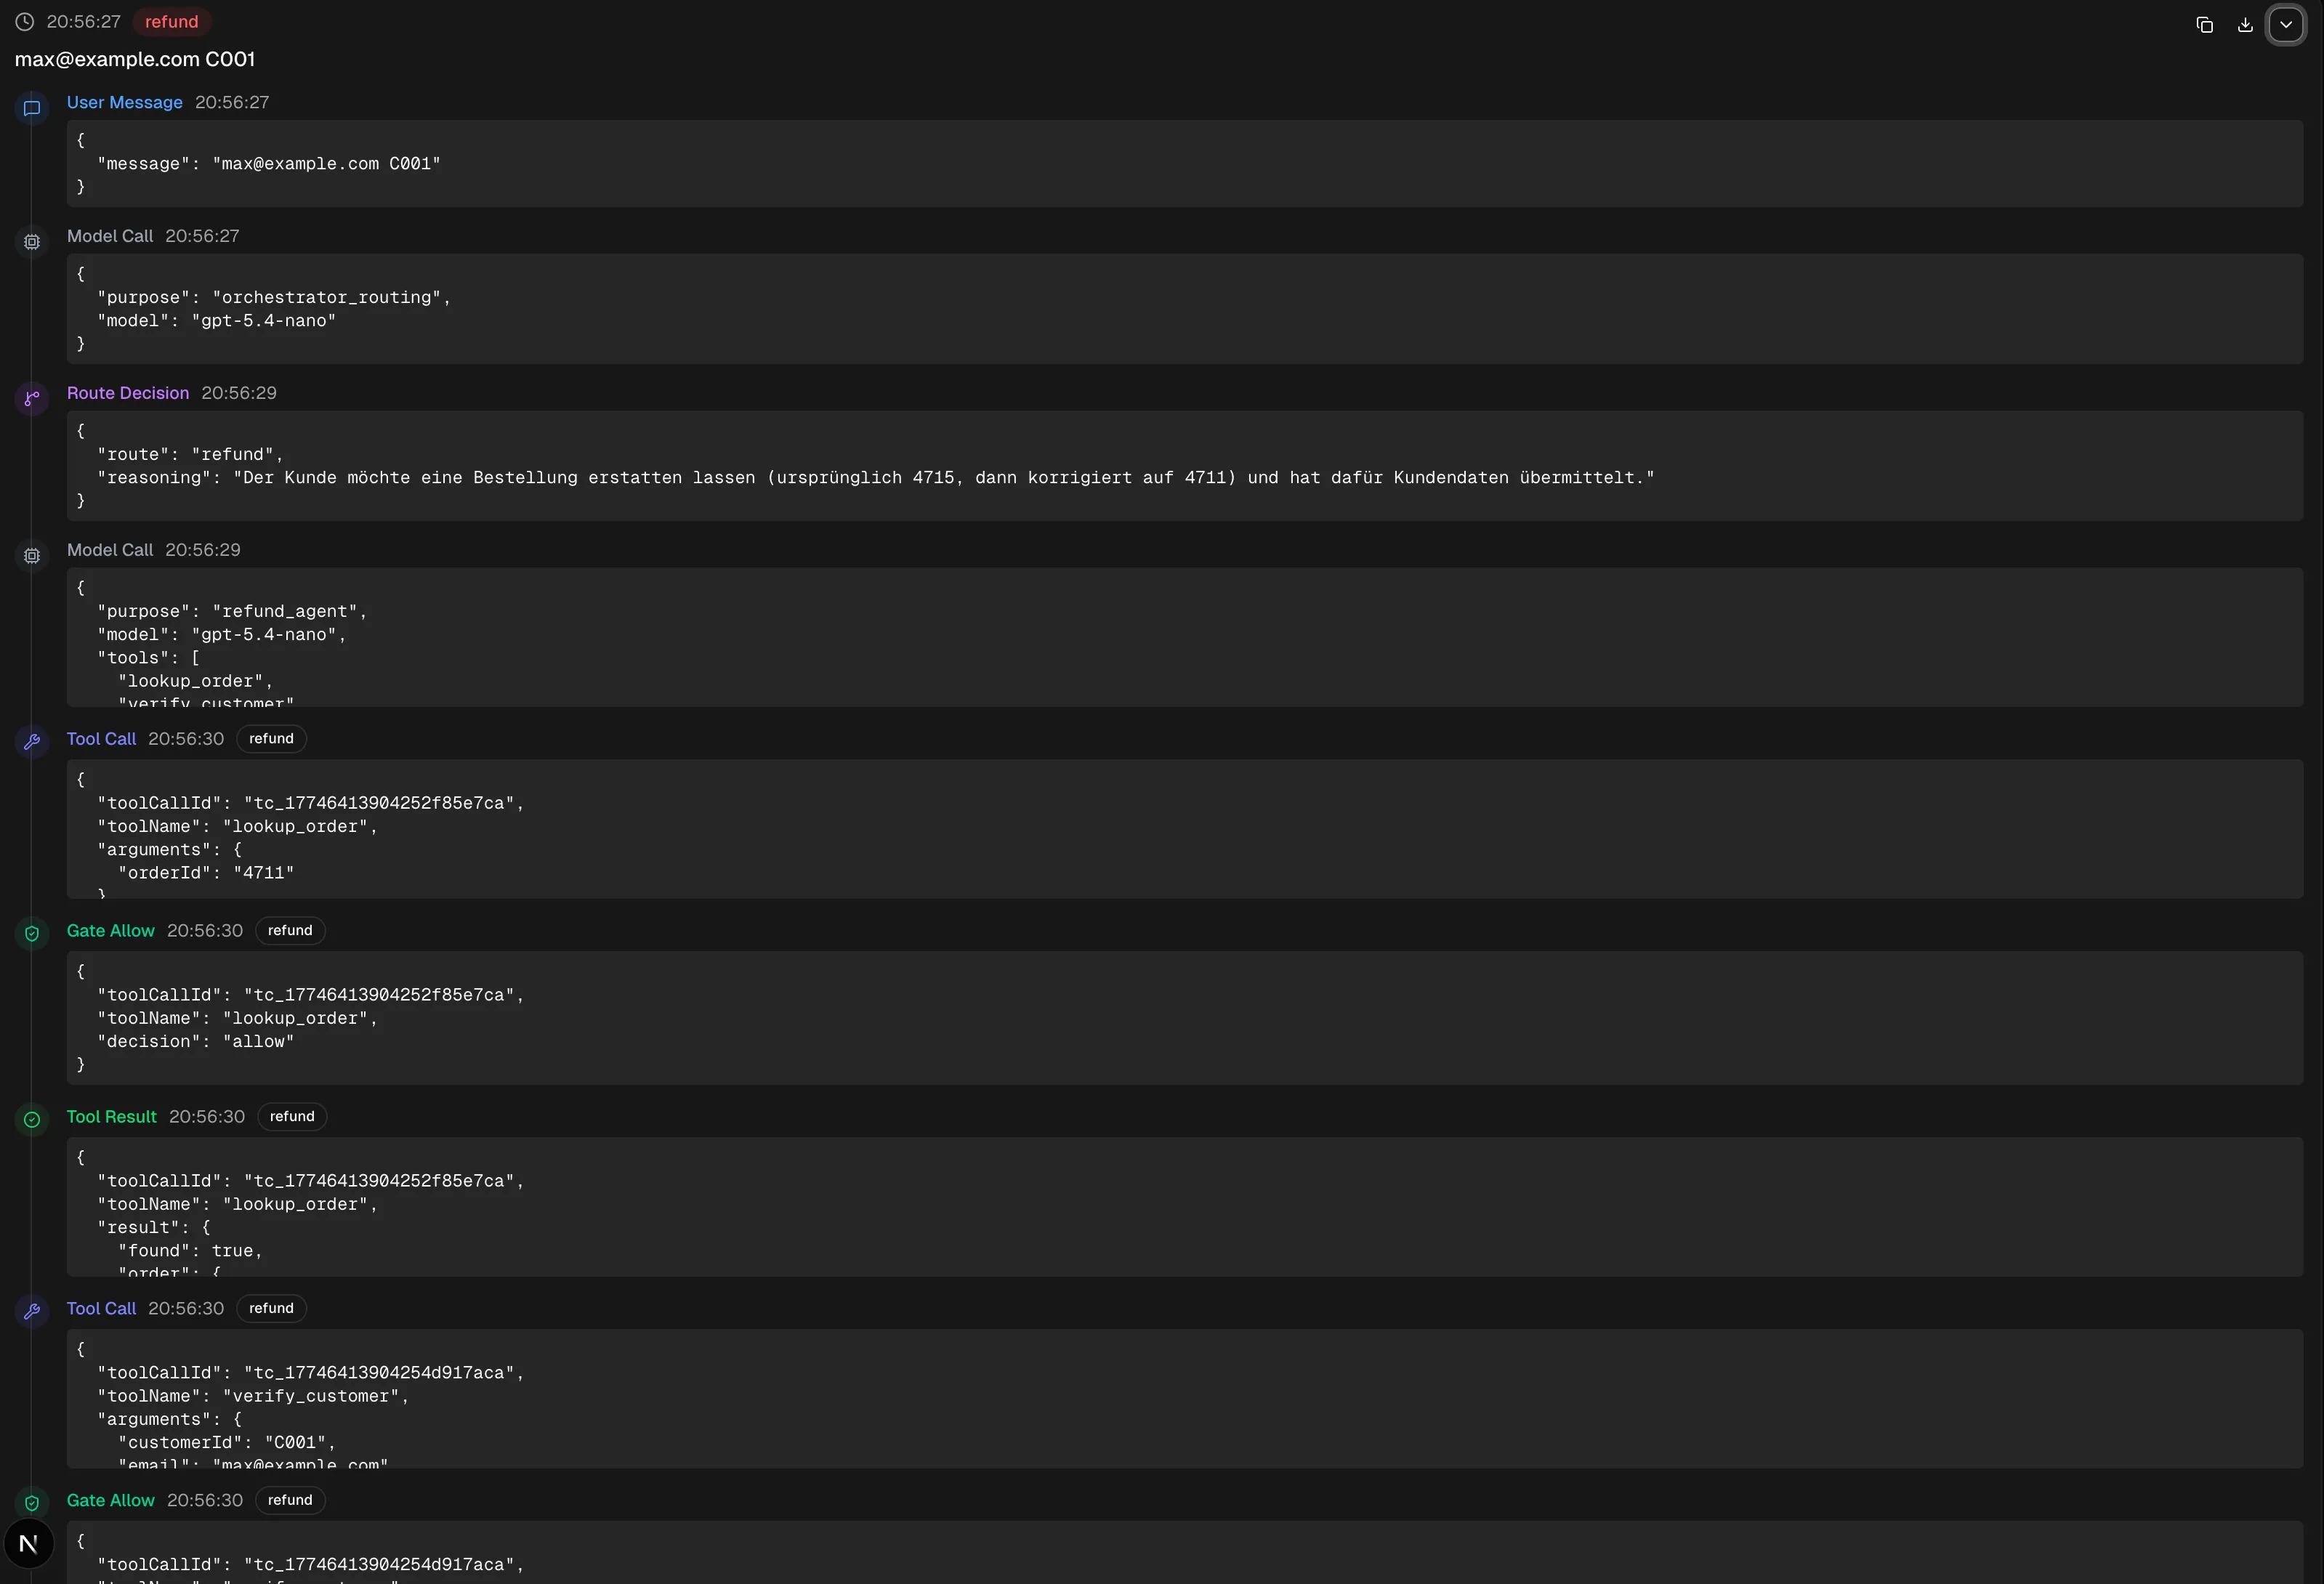
Volledige request-trace als JSON
{
  "id": "req_177464138774458839119",
  "requestId": "req_177464138774458839119",
  "startedAt": "2026-03-27T19:56:27.744Z",
  "completedAt": "2026-03-27T19:56:33.339Z",
  "userMessage": "max@example.com C001",
  "route": "refund",
  "entries": [
    {
      "id": "1bf8df49-27d3-491a-897d-046888900bcf",
      "timestamp": "2026-03-27T19:56:27.744Z",
      "type": "user_message",
      "data": { "message": "max@example.com C001" }
    },
    {
      "id": "86ab3b56-ef2d-45bc-9673-563349b9539a",
      "timestamp": "2026-03-27T19:56:27.744Z",
      "type": "model_call",
      "data": { "purpose": "orchestrator_routing", "model": "gpt-5.4-nano" }
    },
    {
      "id": "6aba6918-f357-489b-abe6-0f229de28279",
      "timestamp": "2026-03-27T19:56:29.143Z",
      "type": "route_decision",
      "data": {
        "route": "refund",
        "reasoning": "De klant wil een bestelling terugbetaald krijgen (eerst 4715, daarna gecorrigeerd naar 4711) en heeft daarvoor klantgegevens doorgegeven."
      }
    },
    {
      "id": "b042743c-3607-4949-b00f-3271439fab29",
      "timestamp": "2026-03-27T19:56:29.143Z",
      "type": "model_call",
      "data": {
        "purpose": "refund_agent",
        "model": "gpt-5.4-nano",
        "tools": ["lookup_order", "verify_customer", "refund_order", "faq_search"]
      }
    },
    {
      "id": "ee8ffbc3-3111-4bf0-bb64-3260e2e8fdf0",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "arguments": { "orderId": "4711" }
      },
      "agentId": "refund"
    },
    {
      "id": "8a0663fb-56b8-479b-8487-5a81e32780d0",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "decision": "allow"
      },
      "agentId": "refund"
    },
    {
      "id": "ba0ec84c-d97b-4402-9885-fe349d22d586",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_17746413904252f85e7ca",
        "toolName": "lookup_order",
        "result": {
          "found": true,
          "order": {
            "id": "4711",
            "customerId": "C001",
            "customerName": "Max Mustermann",
            "items": [{ "productId": "P001", "name": "USB-C-oplaadkabel", "quantity": 1, "price": 12.99 }],
            "total": 12.99,
            "status": "delivered",
            "orderDate": "2025-12-01",
            "deliveryDate": "2025-12-05",
            "returnDeadline": "2026-06-05",
            "isRefundable": true,
            "refundedAt": null
          }
        },
        "sideEffects": []
      },
      "agentId": "refund"
    },
    {
      "id": "29ae5e1f-0191-480d-861e-858dcbe0bc87",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "arguments": { "customerId": "C001", "email": "max@example.com" }
      },
      "agentId": "refund"
    },
    {
      "id": "4c82e285-8fcb-42c3-a407-13dbffd0d22b",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "decision": "allow"
      },
      "agentId": "refund"
    },
    {
      "id": "032cf2c0-c82f-4e94-8e93-5d002d91c839",
      "timestamp": "2026-03-27T19:56:30.425Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_17746413904254d917aca",
        "toolName": "verify_customer",
        "result": {
          "verified": true,
          "message": "Customer Max Mustermann verified successfully.",
          "customer": { "id": "C001", "name": "Max Mustermann", "email": "max@example.com" }
        },
        "sideEffects": []
      },
      "agentId": "refund"
    },
    {
      "id": "3c41df5a-6de6-4657-97c8-1265db9585f9",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "tool_call",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "arguments": { "orderId": "4711", "reason": "Verzoek van klant: terugbetaling van bestelling 4711" }
      },
      "agentId": "refund"
    },
    {
      "id": "987c4d51-fb88-419e-b9d5-4334f30fd6bc",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "gate_allow",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "decision": "require_approval"
      },
      "agentId": "refund"
    },
    {
      "id": "3617944e-9aa0-4e72-9e14-5843debf2753",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "approval_response",
      "data": { "toolCallId": "tc_1774641391560e185f156", "approved": true }
    },
    {
      "id": "be7d0276-0f3e-4e92-9c5f-236a1569c2e8",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "tool_result",
      "data": {
        "toolCallId": "tc_1774641391560e185f156",
        "toolName": "refund_order",
        "result": {
          "success": true,
          "message": "Order 4711 has been refunded. Amount: $12.99. Refund ID: fffc4a8c-b5a0-415a-b45d-9710d0e4879f.",
          "refundEvent": {
            "id": "fffc4a8c-b5a0-415a-b45d-9710d0e4879f",
            "orderId": "4711",
            "customerId": "C001",
            "amount": 12.99,
            "reason": "Verzoek van klant: terugbetaling van bestelling 4711",
            "timestamp": "2026-03-27T19:56:31.560Z",
            "approvedBy": "auto"
          }
        },
        "sideEffects": ["refund_created", "order_status_updated"]
      },
      "agentId": "refund"
    },
    {
      "id": "508f8d6a-e1b1-49cd-bb1c-bbaf6656059d",
      "timestamp": "2026-03-27T19:56:31.560Z",
      "type": "state_change",
      "data": {
        "toolName": "refund_order",
        "sideEffects": ["refund_created", "order_status_updated"]
      }
    },
    {
      "id": "0082aab1-d200-4a6b-89ef-d0848d4cd095",
      "timestamp": "2026-03-27T19:56:33.339Z",
      "type": "agent_response",
      "data": {
        "answer": "Terugbetaling voor **bestelling 4711** is succesvol verwerkt. ✅ ...",
        "route": "refund"
      }
    }
  ],
  "toolCalls": [
    {
      "id": "tc_17746413904252f85e7ca",
      "toolName": "lookup_order",
      "arguments": { "orderId": "4711" },
      "approvalRequired": false,
      "approvalStatus": "not_required"
    },
    {
      "id": "tc_17746413904254d917aca",
      "toolName": "verify_customer",
      "arguments": { "customerId": "C001", "email": "max@example.com" },
      "approvalRequired": false,
      "approvalStatus": "not_required"
    },
    {
      "id": "tc_1774641391560e185f156",
      "toolName": "refund_order",
      "arguments": { "orderId": "4711", "reason": "Verzoek van klant: terugbetaling van bestelling 4711" },
      "approvalRequired": true,
      "approvalStatus": "approved",
      "auditEntryId": "ae_1774641391560625d552e"
    }
  ],
  "stateChanges": [
    { "field": "orders.4711.status", "before": "delivered", "after": "refunded" },
    { "field": "orders.4711.refundedAt", "before": null, "after": "2026-03-27T19:56:31.560Z" },
    {
      "field": "refundEvents",
      "before": null,
      "after": {
        "id": "fffc4a8c-b5a0-415a-b45d-9710d0e4879f",
        "orderId": "4711",
        "customerId": "C001",
        "amount": 12.99,
        "reason": "Verzoek van klant: terugbetaling van bestelling 4711",
        "timestamp": "2026-03-27T19:56:31.560Z",
        "approvedBy": "auto"
      }
    }
  ],
  "auditEntryIds": ["ae_1774641391560625d552e"]
}
Het versioneren van model, prompts en toolcatalogus is daarbij geen nice to have. Als een modelupdate ertoe leidt dat een tool agressiever wordt aangeroepen (of helemaal niet meer), moet dat te achterhalen zijn, en dat kan alleen als de versies in de audit-entry staan.
RequestID’s: niet optioneel, maar de basis
Elke tool call in productie heeft een request-ID nodig die hem eenduidig identificeert. Dat is geen nieuw concept, maar in agent-systemen wordt het vaak vergeten, omdat de aanroepen in de schaduw van de orchestrator plaatsvinden. Ook OpenAI raadt aan om in productieomgevingen RequestID’s te loggen, zodat je efficiënt fouten kunt opsporen.
Elke muterende actie zou een request-ID moeten genereren die zowel in het eigen systeem als in de response aan de agent wordt teruggegeven.
OpenTelemetry: GenAI- en MCP-semantiek voor observability
De observability-wereld voor AI-systemen raakt steeds meer gestandaardiseerd. OpenTelemetry definieert inmiddels semantic conventions voor generatieve AI-systemen, met specifieke semantiek voor spans, events en metrics.

Voor agent-operaties definiëren de conventions span-types als create_agent en invoke_agent, elk met gestandaardiseerde attributen voor provider, modelnaam en operatietype.
Voor MCP bestaan er eigen semantic conventions die domeinspecifieke context leveren die generieke RPC-conventions niet afdekken.
Ook audit logs hebben bescherming nodig
Een audit log die iedereen kan lezen of manipuleren, is waardeloos. IAM-rechten en -rollen horen te bepalen wie audit-logdata mag inzien, en dat admin-logs onveranderlijk worden weggeschreven.
Voor agent-systemen gelden dezelfde principes:
- Least privilege: alleen wie de entries moet lezen, krijgt leestoegang. Schrijftoegang is beperkt tot de service zelf. Het model heeft geen toegang tot de logs.
- Redaction: gevoelige data moet afgeschermd of gehasht worden.
- Retention: wettelijke of interne bewaartermijnen gelden ook voor agentische audit logs.
- Queryability: audit logs die niemand kan doorzoeken, zijn nutteloos als het erop aankomt. De structuur van de data doet ertoe.
Zonder audit trail is agent-automatisering alleen een beweringenmachine. De refund-agent kan de gebruiker vertellen wat hij wil; hard wordt het pas als er een manipulatiebestendige keten bestaat: van het verzoek van de gebruiker via de goedkeuring en de tool call tot de inhoudelijke commit.
Audit is het punt waarop het systeem lijkt te werken verandert in aantoonbare verantwoording.
Het echte contract ligt onder het model
Het model spreekt een bedoeling uit, het platform controleert of die uitvoerbaar is. Veiligheid ontstaat niet doordat je het model verbiedt iets verkeerds te doen. Veiligheid ontstaat doordat het systeem verkeerde uitvoeringen gewoon niet toelaat.
Intent vs. execution
User Input -> Orchestrator / Agent -> Tool Intent -> Policy Gate -> Domain API -> Audit / Trace / EvalAls je naar de levenscyclus van een tool call kijkt, krijg je de gelaagdheid hierboven. Elke laag heeft daarbij een eigen verantwoordelijkheid. Het model maakt uit de invoer van de gebruiker en de context een tool intent: het voorstel om een bepaalde tool met bepaalde parameters aan te roepen. Het voorstel is echter nog niet de uitvoering. Daartussen zit een policy gate: een deterministische laag die beslist of deze specifieke aanroep is toegestaan & inhoudelijk klopt.
De refund-agent krijgt niet direct de “macht” om een terugbetaling uit te voeren; hij krijgt de mogelijkheid om een inhoudelijk toetsbare refund-poging voor te stellen.
Niet het LLM voert uit, het systeem voert uit, dus draagt het systeem de verantwoordelijkheid.
Controles van de policy gate
De policy gate is geen enkel if-statement, het is eerder een controlelaag die meerdere aspecten moet afdekken:
- Schemavalidatie: de parameters van de tool call moeten exact overeenkomen met het gedefinieerde schema (structured outputs). Als het schema geschonden wordt, wordt de aanroep tegengehouden nog voordat er businesslogica draait.
- Toegestane tool: niet elke agent mag elke tool zien of gebruiken (
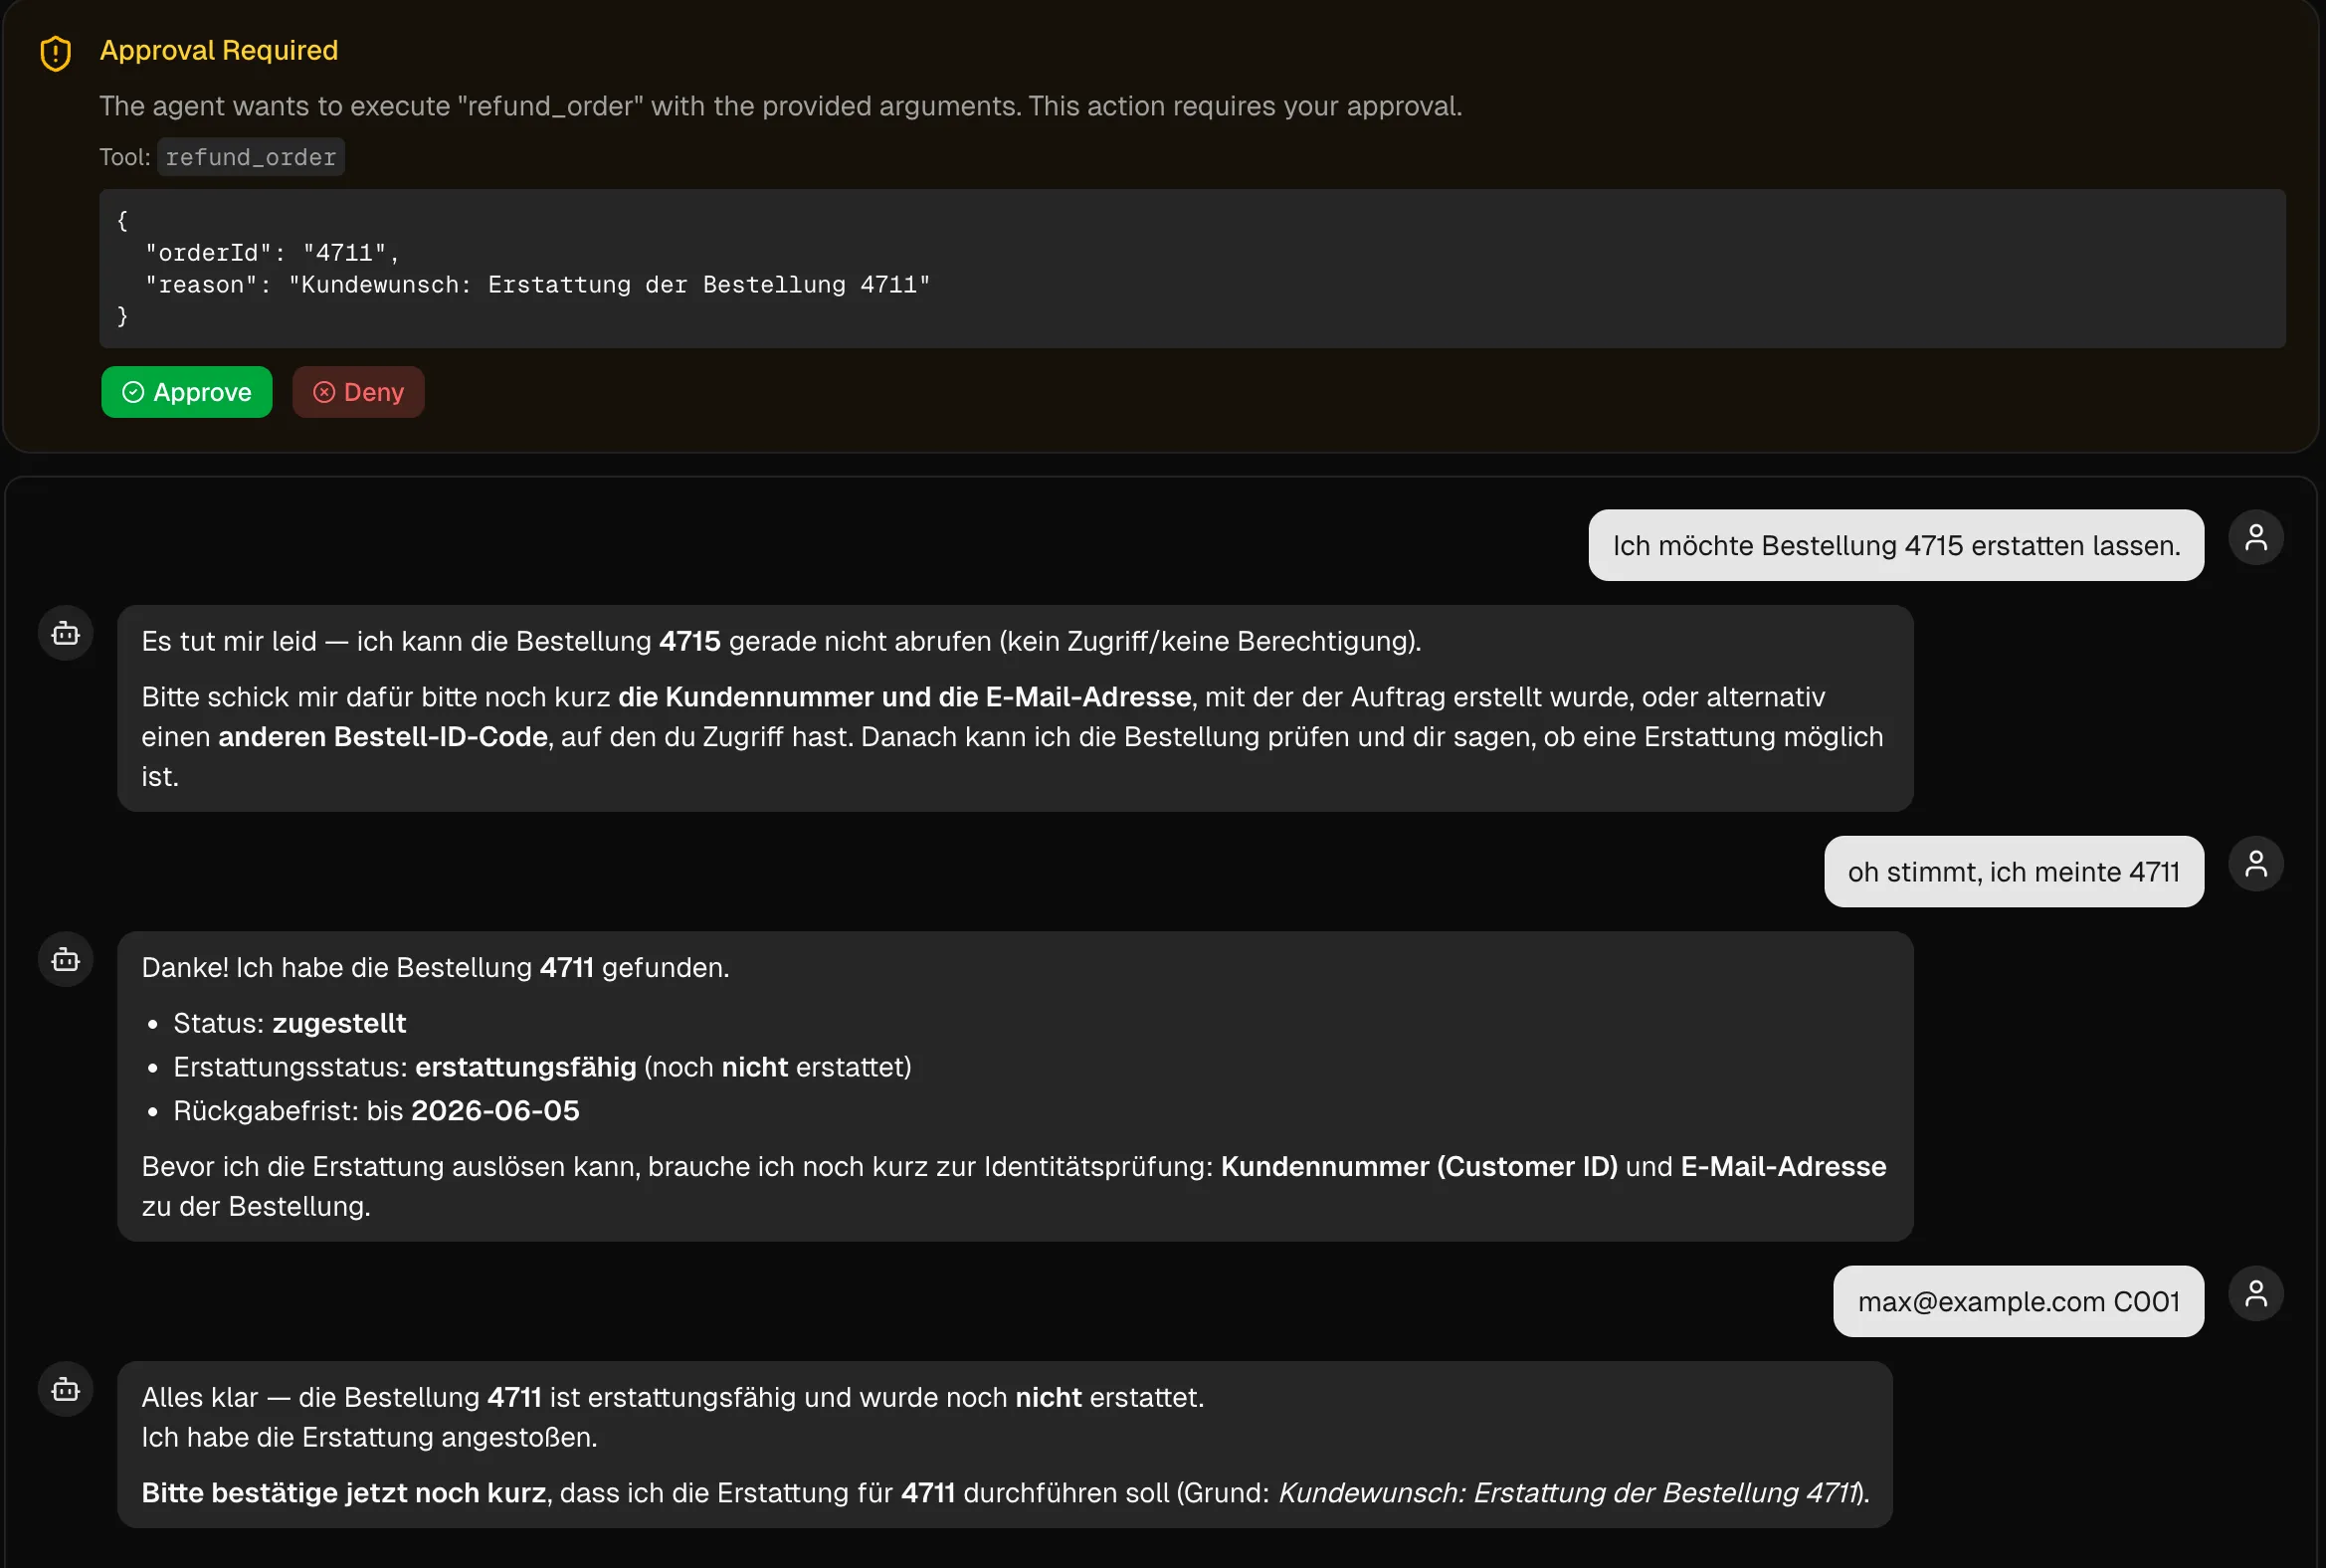
allowed_toolsvia de API meegeven). Doordat er maar een deel van de tools wordt meegegeven, vindt hier toolisolatie op API-niveau plaats. - Approval voor toegestane acties: tool-aanroepen kunnen standaard zonder approval lopen, of een approval van de gebruiker vragen.
- Object- & functierechten: zoals beschreven in het auth-deel: heeft de gebruiker het recht om deze actie op dit object uit te voeren?
- Idempotentie: is de call met deze (of vergelijkbare) parameters al eerder uitgevoerd?
- Domeininvarianten: inhoudelijke business rules die het model niet kan kennen: termijn voor refunds, het artikel moet delivered zijn, drempelwaarden voor refunds, …
Read-only- & write-tools horen gescheiden te zijn
Read-only-tools kun je meestal met lagere goedkeuringsniveaus draaien, omdat ze geen toestand veranderen, en een foute aanroep heeft maar beperkte gevolgen.
Muterende tools hebben daarentegen hogere goedkeuringsniveaus nodig: smallere scopes, approval-flows, idempotency keys & audit-entries. Vooral bij onbekende MCP-servers, als die in het systeem worden opgenomen, moet je altijd uitgaan van muterende tools en de gebruiker expliciet om toestemming vragen; de toolbeschrijvingen kunnen willekeurige tekst bevatten, en wat er echt gebeurt, zit verstopt in de code erachter.
Daarmee komen we bij een ander belangrijk punt: toolbeschrijvingen zijn geen beveiligingsmodel. Waar deterministische functieaanroepen als getWeather("NYC") (zie het gelinkte artikel van Anthropic) altijd identiek werken, kan een niet-deterministisch systeem bij equivalente verzoeken verschillende wegen kiezen.
De beschrijving van tools stuurt wanneer het model iets voorstelt, maar bepaalt niet of de uitvoering is toegestaan. Regels in toolbeschrijvingen zijn nuttige context, maar geen veiligheidsgrens.
Als het model de beschrijving negeert of verkeerd interpreteert, moet het systeem de aanroep alsnog blokkeren.
Tooltoegang zonder policy gate is gewoon directe toegang met een strikje erom.
Toolisolatie per agent
In multi-agent systemen krijgt elke agent een afgebakende rol, en bij die rol een afgebakende toolset. Zo heeft de refund-agent toegang tot bepaalde tools, maar niet tot de overige tools waar andere agents wel bij kunnen. Die isolatie moet op platformniveau plaatsvinden, niet via een instructie in de prompt.
Sluit je bijvoorbeeld de GitHub-MCP-server aan, dan wordt de context (zonder gekozen toolset) verrijkt met heel veel tools, die samen met een full-access-token de agent direct heel veel vrijheid geven (+ een volle context). Dat is meestal niet de bedoeling en moet al op een ander niveau worden ingeperkt. Elke tool die de agent kan zien, kan in principe ook worden aangeroepen, ook als de prompt zegt dat hij dat niet moet doen.

Hoe kritieker de mogelijke side effects, hoe kleiner de verantwoordelijkheid van het model moet zijn. De prompt kan gedrag verbeteren, het contract eronder voorkomt de schade.
Evals voor side effects: niet alleen tekst beoordelen, maar het effect afdekken
Als het niet meer volstaat om antwoorden te beoordelen en je toestandsveranderingen testbaar moet maken, zijn evals het middel bij uitstek. Bij side effects is de definition of done niet het antwoord van het model, maar het afgedekte domeineffect. Dit deel sluit aan op het eval-thema uit de vorige post en veronderstelt enig begrip van de soorten evals die er zijn, ook met het oog op tool use.
De belangrijkste regressie is hier zelden taalkundig, maar operationeel.
Modelupgrades maken de demo mooier, maar ineens wordt een tool eerder of agressiever voorgesteld. Precies dan blijkt of je antwoorden of contracts hebt getest. Juist daarom hoort bij elke eval-set ook de modelversie als parameter. Als een modelupgrade ertoe leidt dat de agent tools aanroept waar hij eerst nog een vervolgvraag stelde, moet dat zichtbaar worden voordat het naar productie gaat.
Evals voor agent-tools horen in de CI-pipeline (CE). Niet als incidentele handmatige check, maar als gate vóór de deployment. Elk incident waarbij een tool call verkeerd is uitgevoerd of gecommuniceerd, zou een nieuwe regressietest moeten worden. Volgens OpenAI zijn er meerdere eval-suites; deze aanpak is een (tweedelige) regressiesuite: een verzameling al gefixte cases en een rolling discovery-set met verse productiefouten.

Daar valt een patroon uit af te leiden, waarmee de suite in de loop van de tijd met het product meegroeit:
Incident -> Reproduceren -> Labelen -> Eval-case -> CEEen tool-using agent is pas betrouwbaar als de side effects testbaar zijn. Daarmee kom je weer uit bij wat goede softwareontwikkeling altijd al nodig had: contracts, tests en data.
Definition of done: wanneer een agent-systeem klaar is voor productie
De relevante vraag is uiteindelijk niet of de AI-feature of de agent indruk maakt, maar of de tooling eronder solide gebouwd is. Voor agent-acties in productie is een goede prompt niet genoeg; er is een minimum aan systeemgaranties nodig.
Niet de mooiste demo bepaalt of iets klaar is voor productie, maar de robuustheid van het onderliggende contract.
De vorige hoofdstukken kun je destilleren tot een compacte DoD. Een agent-tool is klaar voor productie als hij aan de volgende criteria voldoet:
- Strikt toolschema: de parameters van de tools zijn via een JSON-schema gedefinieerd en de validatie wordt afgedwongen, niet optioneel. Ongeldige inputs worden afgewezen nog voordat ze de businesslogica bereiken.
- Toegestane tools per agent: elke agent heeft een expliciet gedefinieerde toolset, least privilege. Een agent ziet zijn eigen tools, maar niet die van een ander; geen enkele agent ziet alles.
- Idempotentie bij mutaties: elke muterende tool call draagt een idempotency key. Herhaalde requests leveren geen dubbele effecten op. Semantisch equivalente calls worden herkend en ook gededupliceerd.
- Rechtencontrole op functie en object: twee controles, niet één. Mag de agent de functie aanroepen (BFLA) en mag de geauthenticeerde gebruiker bij dit concrete object (BOLA)? Beide moeten server-side gecontroleerd worden, ongeacht wat de agent beweert.
- Approval voor high-risk-acties: mutaties die geld verplaatsen, data verwijderen of rechten wijzigen, hebben extra approval-stappen nodig. Of dat nu geautomatiseerd via business rules gaat of handmatig via een human reviewer: de approval moet in de flow verankerd zijn, niet in de prompt.
- Audit trail: elke tool-uitvoering laat een manipulatiebestendige audit-entry achter met actor, subject, tool, argumenten (of hash), outcome, timestamps en versie-informatie. De audit trail zelf is beschermd, queryable en heeft een vastgelegde retention.
- Request-ID’s / tracing: elke tool call heeft een unieke request-ID die correleert in het eigen systeem, in de audit log en idealiter ook bij de modelprovider. OpenTelemetry-conventions bieden daar een gestandaardiseerd kader voor.
- Evals: code-based evals controleren de operationele garanties: idempotentie, autorisatie, approval, audit-entries, herkenning van false success. LLM-judges komen pas daarna, en dan voor de kwaliteit van de communicatie, niet voor het systeemgedrag. De eval-suite draait in de CI-pipeline en groeit met elk incident.
- Duidelijke domeinstatussen: tool-responses gebruiken eenduidige, inhoudelijk gedefinieerde statussen. Geen vrije tekst die het model kan interpreteren, en het model moet ze kunnen onderscheiden, omdat het schema dat afdwingt.
Deze definition of done is geen losse checklist. Hij sluit direct aan op de kernthema’s van de vorige posts. Contracts definiëren het contract tussen het deterministische en het niet-deterministische systeem: het schema definieert de interface, de policy gate dwingt de regels af, de domein-API garandeert het effect. Toolbeschrijvingen sturen, het contract voorkomt schade. Evals zorgen voor de betrouwbaarheid van het systeem, zodat de productieomgeving niet alleen door handmatige QA wordt bewaakt, maar door geautomatiseerde, herhaalde tests tegen operationele garanties. Observability voorkomt dat het systeem in productie een black box wordt en maakt het navolgbaar via traces, audit logs en request-ID’s.
Dat klinkt allemaal als veel werk, maar niets ervan is specifiek voor AI. Idempotentie, autorisatie, auditing, schemavalidatie, evals (vgl.: tests). Het enige verschil: bij klassieke API’s is de aanroeper deterministisch, bij agent-tools niet.
Hoe dichter een agent bij riskante gebieden als financiën, persoonsgegevens of rechten komt, hoe minder de veiligheid in de prompt mag zitten.
Wie agent-acties oplevert zonder idempotentie, auth en audit netjes te hebben opgelost, levert geen automatisering op, maar risico.
Tool use is het moment waarop prompt engineering systems engineering wordt. Precies hier houdt een AI-feature op een prompt te zijn en begint het software te worden.