
Livrer des fonctionnalités d’IA sans evals, ce n’est pas un processus d’ingénierie, c’est une stratégie de l’espoir.
Le prompting dans un chat est parfait pour explorer les possibilités, mais dès qu’on passe en production, de bonnes réponses isolées ne suffisent plus. Déployer sans evals, c’est reporter les tests sur les vrais utilisateurs. J’ai déjà effleuré ce sujet dans mon article précédent, où une évaluation basée sur l’IA était utilisée en passant. Ici, je veux examiner cet aspect plus en détail et décrire ce qui compte vraiment dans les applications en production.
Testé dans la fenêtre de chat
… ce n’est pas testé.
Construire des fonctionnalités d’IA commence souvent dans l’interface de chat, ou avec quelques prompts dans le playground pour développeurs. Après quelques questions sur le happy path, on obtient un prompt qui paraît parfait au premier coup d’œil et avec lequel on peut implémenter la fonctionnalité dans la foulée. Bien sûr, un peu d’ajustement manuel fait sans doute partie du jeu.
Et c’est parfait ! Pour l’exploration, pour vérifier si l’idée de départ de la fonctionnalité tient la route - pour débusquer les hypothèses cachées et les échecs grossiers. Ce qui passe à la trappe, comme dans beaucoup de projets logiciels déterministes, ce sont les tests. Or c’est justement avec les tests que commence l’assurance qualité reproductible. Du code testé uniquement à la main en production comporte toujours le risque d’avoir raté quelque chose, surtout en cas de régression - et c’est exactement pareil pour les prompts nés de l’exploration.
Si dans deux mois un éditeur sort un nouveau modèle qu’on veut intégrer tout de suite parce qu’il semble mieux adapté, on se retrouve vite à voler à l’aveugle quand on a produit le prompt par exploration - puis qu’on l’a simplement laissé traîner dans le projet sans le retester. Et ce n’est pas seulement un nouveau modèle qui déclenche ce problème : une modification (potentiellement invisible) du system prompt chez l’éditeur du modèle pourrait changer en profondeur le comportement de nos prompts - et de nos fonctionnalités d’IA. Sans évaluation reproductible, on vole ici complètement à l’aveugle.
Ça marche dans la démo et ça tient face aux changements, ce sont deux choses différentes. Et c’est précisément là qu’intervient la Continuous Evaluation (CE).
Là où s’arrête le prompt engineering
Dès que la sortie du modèle fait partie de la logique produit, un bon prompting ne suffit plus. Les Contracts, les evals et l’observability comptent alors au moins autant que le prompt lui-même.

Si nous continuons d’itérer sur un prompt, nous risquons de buter sur des limites : le résultat ne s’améliore tout simplement plus, les evals restent au rouge. Il est peut-être temps de changer de modèle. Car tous les problèmes ne viennent pas du prompt - d’autres causes d’échec possibles sont le choix du modèle, l’architecture, l’outillage, les données ou encore le workflow.
Un meilleur prompting optimise les réponses du modèle, l’ingénierie stabilise le système autour.
Pourquoi aucun retour n’a-t-il été déclenché dans cet exemple ? Pendant le processus d’eval, les réponses étaient toujours parfaites - et les appels d’outils avaient toujours fonctionné, eux aussi. En regardant l’exemple de plus près, un détail saute aux yeux : un serveur MCP ? Il fournit lui-même ses descriptions d’outils - et si quelque chose a changé de ce côté sans que le prompt suive, la logique peut cesser de fonctionner - et un cas comme celui-ci se produire.
À partir de quand les evals deviennent obligatoires
Dès que du non-déterminisme entre dans le système, c’est une bonne idée de faire des evals. Pas forcément quand nous livrons directement les sorties de l’IA à l’utilisateur - mais dès que la sortie du modèle influence la logique produit.
Routing, tool calls, écriture ou modification de données, préparation ou blocage d’actions utilisateur, maillon d’une chaîne de workflow - autant de raisons de faire des evals, et elles sont obligatoires pour des systèmes de qualité.
Plus il y a de points de non-déterminisme dans le système, plus le besoin d’evals systématiques est grand. Cela va du single-turn (une sortie du modèle pilote une chose) aux workflows (une suite de prompts qui s’appuient chacun sur la sortie du précédent), puis aux single-agents (un agent appelle des outils ou travaille jusqu’à ce qu’il « pense » avoir terminé), jusqu’aux multi-agents qui communiquent entre eux. À ce stade au plus tard, des evals systématiques sont plus que pertinentes - et dès le single-turn, elles sont recommandées.

Un bot de FAQ, par exemple, qui va chercher des connaissances produit pour répondre à une question (via du RAG, disons) et les sert à l’utilisateur, représente un risque plutôt faible - alors que le refund-agent décrit plus haut, avec ses tool calls vers des outils refund, comporte un risque nettement plus élevé. Si cet agent côtoie en plus un buying-agent capable d’effectuer des achats pour moi - le tout géré par un Orchestrator -, on atteint une complexité extrêmement élevée, et les evals systématiques deviennent d’autant plus importantes.
Qui fait entrer la sortie du modèle dans la logique produit endosse la responsabilité des tests.
Ce qui fait une eval utile
Il faut :
- un jeu de données concret
- un critère de réussite défini
- au moins un grader ou verifier
- une exécution reproductible
- une comparaison d’un changement à l’autre
Il ne faut pas tester uniquement les comportements positifs - mais aussi les cas où un comportement donné ne doit pas se produire. Les verifiers manuels, surtout, coûtent cher - là, un petit ensemble de cas réels et ciblés vaut mieux qu’un benchmark parfait avec un nombre incroyable de points de données.
Comparés aux human evals, les graders automatisés (llm-as-a-judge) sont beaucoup moins chers. Une autre possibilité, ce sont les code based grades - et (si possible) ils devraient constituer l’essentiel des evals - mais, à cause du non-déterminisme, jamais le seul type de vérification.

Pour rester sur l’exemple du refund-agent : un bon point de départ pour l’évaluation est un seed set plus petit et maniable, composé de :
- 4 cas de remboursement positifs
- 4 cas de remboursement négatifs
- 4 cas de lookup
- 4 cas ambigus
- 4 cas limites qui devraient signaler un cas de policy potentiel
Sur la base de ce jeu de tests, on peut ensuite vérifier si des appels d’outils ont [ou n’ont pas] eu lieu, si la réponse à l’utilisateur (ou à l’Orchestrator) est appropriée - si les questions de clarification sont correctement demandées, etc. À ce stade, c’est la créativité dans le cadre des règles métier qui fait la différence pour formuler des tests pertinents et utiles.
Selon les deux grands fournisseurs de LLM, il ne s’agit pas d’évaluer des prompts, mais de spécifier le comportement de l’IA de façon à ce qu’il devienne testable, explicable et automatisable. Les prompt evals ne sont pas un sujet secondaire, mais le passage de « on essaie un truc » à « on peut garantir la qualité de façon visible ».
Idéalement, on formule d’abord la définition du succès - et seulement ensuite on élabore un prompt - un peu comme en Test Driven Development. Sans succès défini, on n’a aucune base pour évaluer.
Lors de la conception d’evals, il faut tenir compte de plusieurs dimensions d’évaluation. Anthropic cite entre autres la fidélité à la tâche, la cohérence, la pertinence, la protection des données, l’utilisation du contexte, la latence et le coût ; OpenAI décrit aussi des dimensions comparables. L’essentiel est de formuler les critères de façon à pouvoir les vérifier avec des méthodes adaptées : d’abord des critères de réussite aussi déterministes et techniquement mesurables que possible, ensuite des critères évaluables par des méthodes non déterministes comme LLM as a judge, et enfin ceux qui exigent un jugement humain.
Comme les sorties ne sont pas déterministes, une exécution isolée peut toujours être évaluée de façon binaire, réussie ou échouée. Mais pour des tâches instables ou des agent loops au déroulement très variable, une seule exécution ne suffit souvent pas pour juger sérieusement de la fiabilité du système. Dans ces cas-là, il faut exécuter plusieurs fois le même scénario et agréger le résultat via des métriques adaptées - par exemple pass@k, quand au moins une tentative réussie suffit, ou un seuil de cohérence, quand on attend un comportement fiable. On peut ainsi fixer qu’un scénario doit réussir dans au moins 9 répétitions sur 10. Pour les suites de régression, en revanche, le taux de réussite devrait être aussi proche que possible de 100 %.

Un mauvais score d’eval peut être un problème de modèle. Ça peut tout aussi bien être un test cassé.
L’évaluation par l’exemple : un agent de support avec des outils
En nous appuyant sur les exemples déjà esquissés plus haut, nous allons travailler avec une équipe de support. Ici, une interface de chat est en fait le choix le plus pertinent - nous n’aurons pas besoin de beaucoup d’UI autour - en revanche, l’agent est branché directement sur notre système et peut récupérer des informations sur l’utilisateur et agir en son nom - concrètement, par exemple, annuler des produits.
L’UI contiendra principalement des sorties de debug pour améliorer l’équipe d’agents. Il suffit d’une interface de chat, d’un tracing des appels d’outils et du routing, de tests d’eval intégrés, de prompts modifiables et d’un state « backend » pour vérifier ce qui arrive exactement aux données.
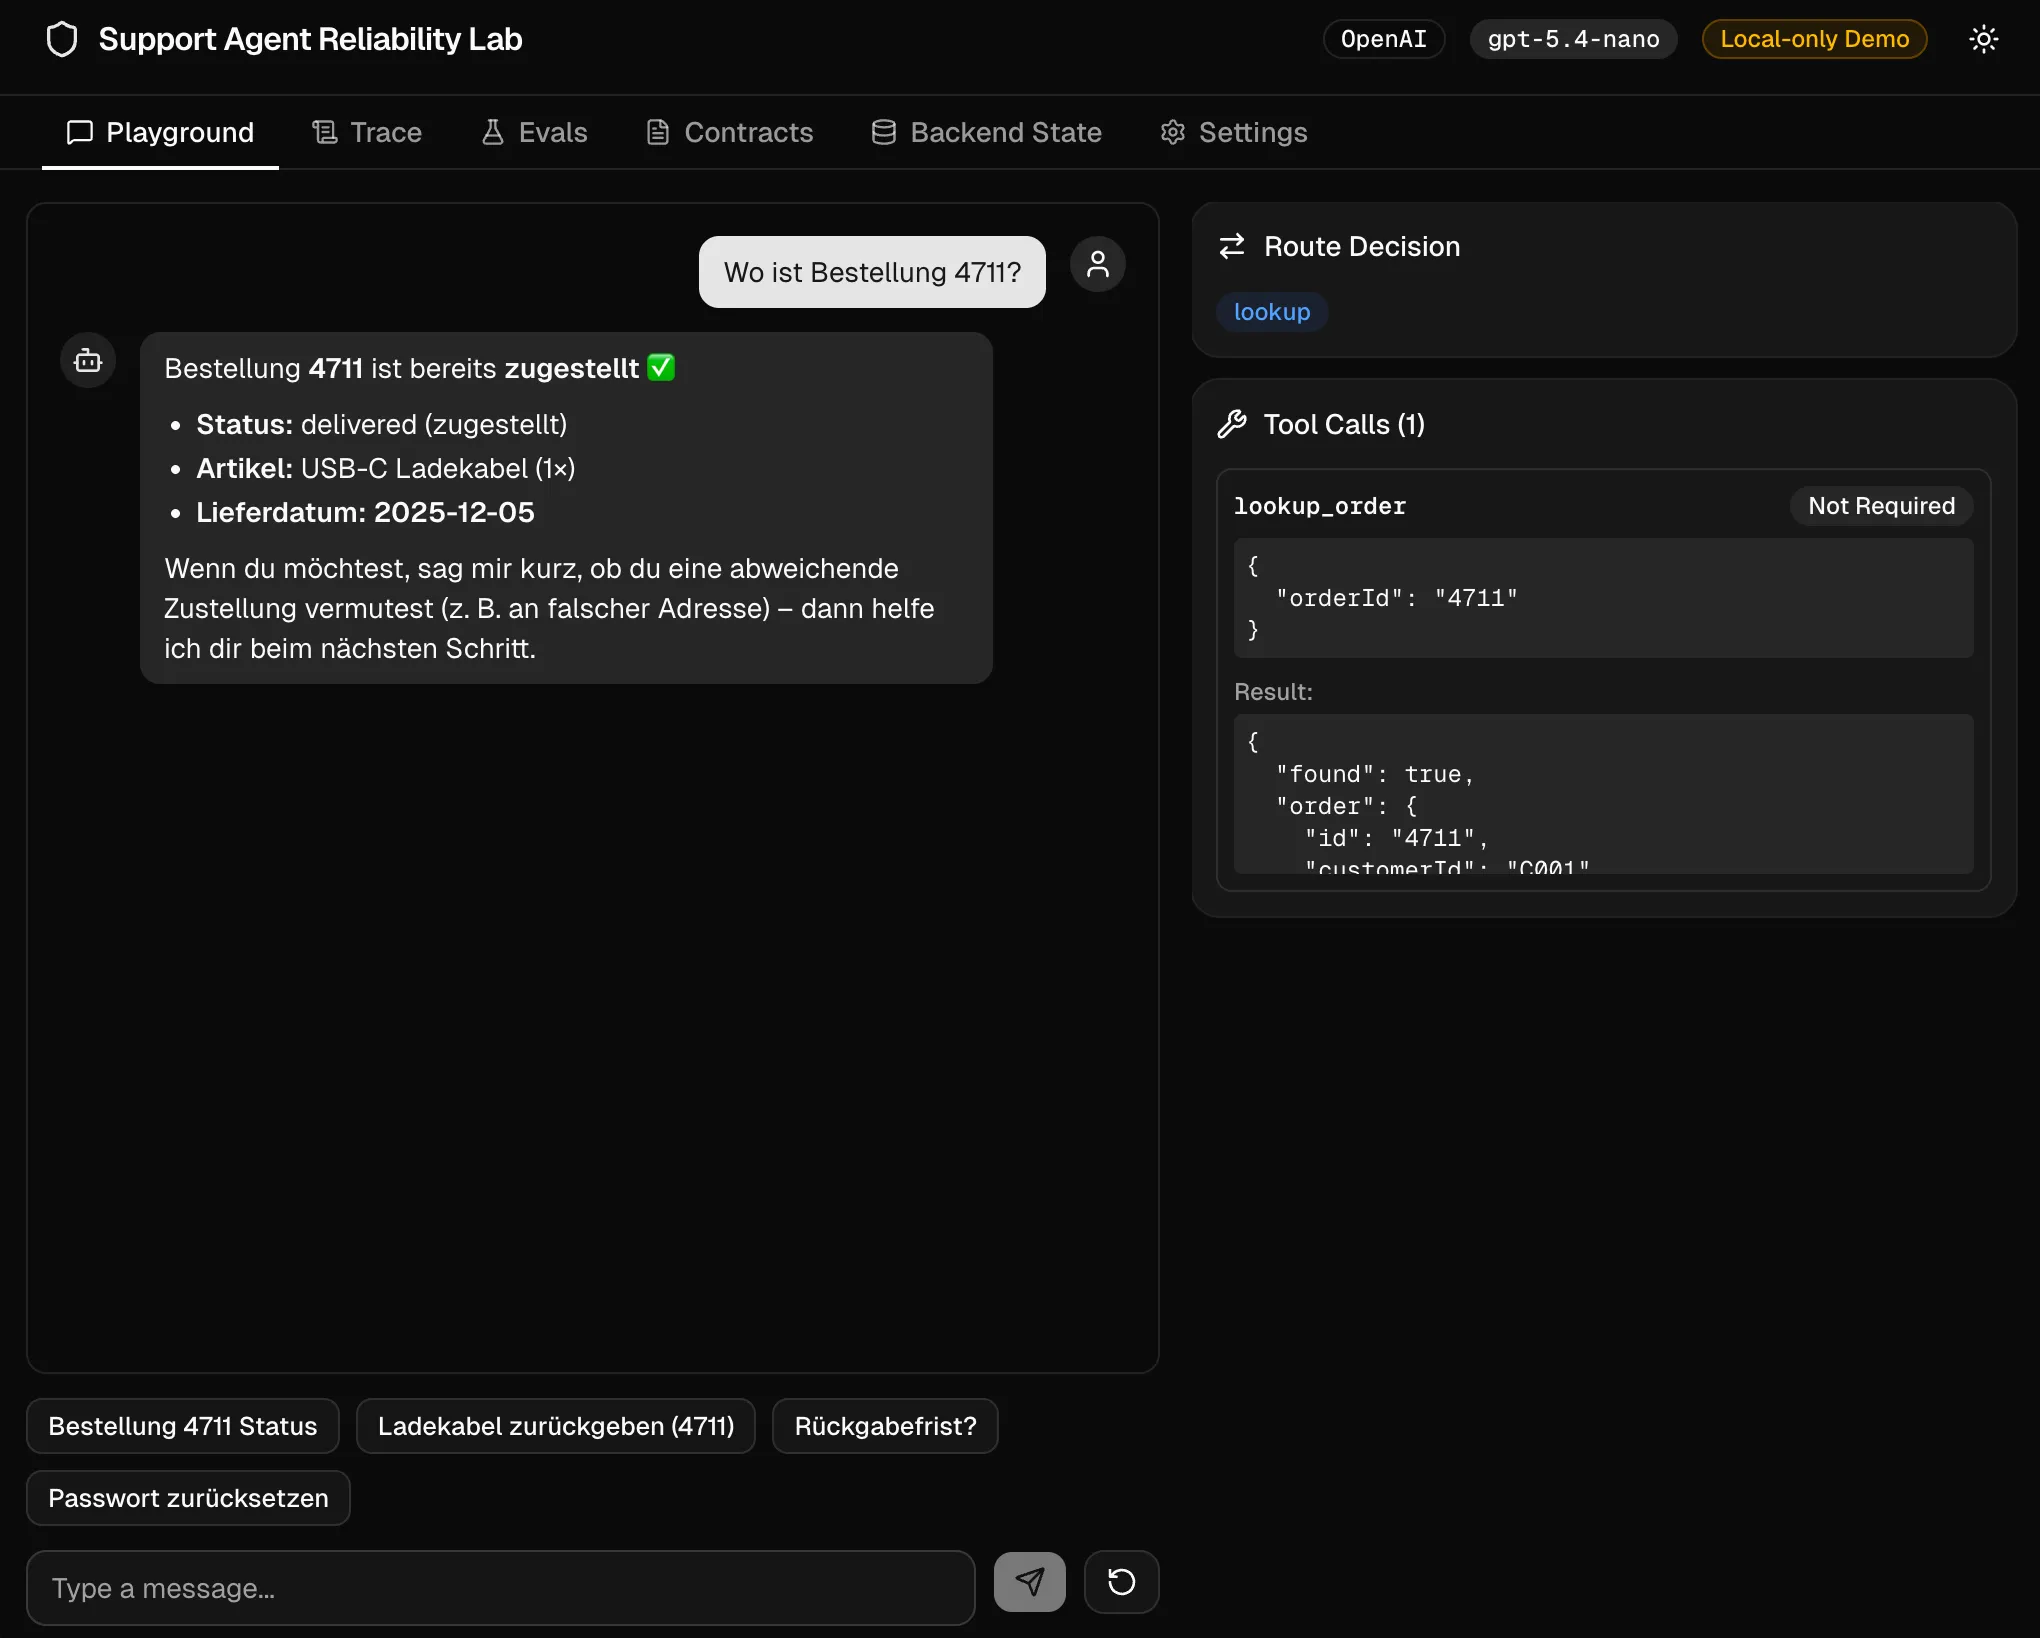
Claude a eu la gentillesse de me créer une application qui met en place un agent de support. Après un prompt one-shot plutôt réussi, j’ai encore ajusté quelques détails - et nous voilà prêts à démarrer avec une équipe orchestrée d’agents de support.
Prompt one-shot (généré par GPT 5.4 Pro)
Tu es un ingénieur fullstack TypeScript senior et tu dois construire une application de démo locale.
Objectif Construis une web app moderne, présentable en capture d’écran, pour un article de blog sur les evals d’IA, les contrats d’outils, l’orchestration et la dérive. L’app doit montrer très clairement :
« Une réponse plausible de l’assistant ne prouve pas que le bon tool call ou un véritable effet de bord a eu lieu. »
Le produit n’est pas une vraie plateforme de support, mais un établi de fiabilité ciblé autour d’un scénario Orchestrator / refund-agent.
Mode de travail Travaille dans cet ordre :
- Résumé très court de l’architecture
- structure de fichiers concrète
- implémentation
- README
- courte liste des points volontairement reportés
N’attends pas de longues questions de clarification. Prends des décisions raisonnables et garde un périmètre restreint.
Limite de périmètre stricte
- Pas de playground d’IA générique
- Pas de vrai système d’auth
- Pas de vraie base de données
- Pas de vrai serveur MCP
- Pas de LangChain
- Pas de durcissement pour la production
- Pas d’observability SaaS
- Pas d’essaim d’agents autonomes
À la place :
- démo locale
- workflows explicites et faciles à vérifier
- tool trajectories visibles
- seed evals reproductibles
- contrats de prompt / d’outils modifiables
Tech Stack
- Next.js App Router
- TypeScript
- Tailwind CSS
- shadcn/ui
- lucide-react
- API stables actuelles d’ai-sdk.dev
- AI SDK UI côté client
- AI SDK Core côté serveur
- zod pour les schémas
- Vitest pour quelques tests ciblés
Décision d’architecture importante Présente le système au niveau produit comme des « Agents », mais implémente-le de façon contrôlée et explicite :
- Orchestrator
- Refund Agent
- Order/Lookup Agent
- Account/FAQ Agent
Évite un énorme système d’agents en boîte noire. Je veux des modules/fonctions explicites et traçables, avec des contrats clairs et des traces structurées.
Idée produit Nom de l’app : Support Agent Reliability Lab
L’app doit démontrer :
- le routing par un Orchestrator
- le traitement spécialisé par un Refund Agent
- des contrats d’outils clairs
- une approbation pour les actions destructives
- la différence entre texte de réponse et véritable effet de bord
- la dérive due à des descriptions d’outils modifiées
- une petite suite d’evals reproductible
Règle local-only
- Les clés API des fournisseurs sont stockées dans le localStorage du navigateur
- ces clés sont envoyées à chaque requête aux routes API locales
- ne jamais logger les clés
- masquer les clés dans l’UI
- avertissement clair dans l’UI : “Local-only demo. Do not deploy as-is.”
Fournisseurs supportés
- OpenAI
- Anthropic
Les Settings doivent permettre de :
- choisir le fournisseur
- saisir l’ID du modèle
- saisir la clé API
- afficher la présence de la clé
- supprimer entièrement les données locales
Écrans produit principaux Construis un layout moderne avec header + onglets.
Onglets :
- Playground
- Trace
- Evals
- Contracts
- Backend State
- Settings
Les prompts de l’équipe sont entièrement personnalisables. L’équipe elle-même se compose de :
- Orchestrator (orchestre la répartition vers les différents agents)
- Refund Agent (connaît les règles et les outils pour les remboursements)
- Lookup Agent (s’occupe des demandes de statut de commande et de suivi)
- Account & FAQ Agent (réinitialisations de mot de passe et questions de policy)
Les outils pertinents sont : lookup_order(order_id), refund_order(order_id, reason), reset_password(account_id), faq_search(query) et verifyCustomer(account_id, email). Dans l’application générée, on peut aussi modifier les descriptions de chaque outil, pour évaluer d’autres prompts à cet endroit aussi et obtenir de meilleurs résultats.
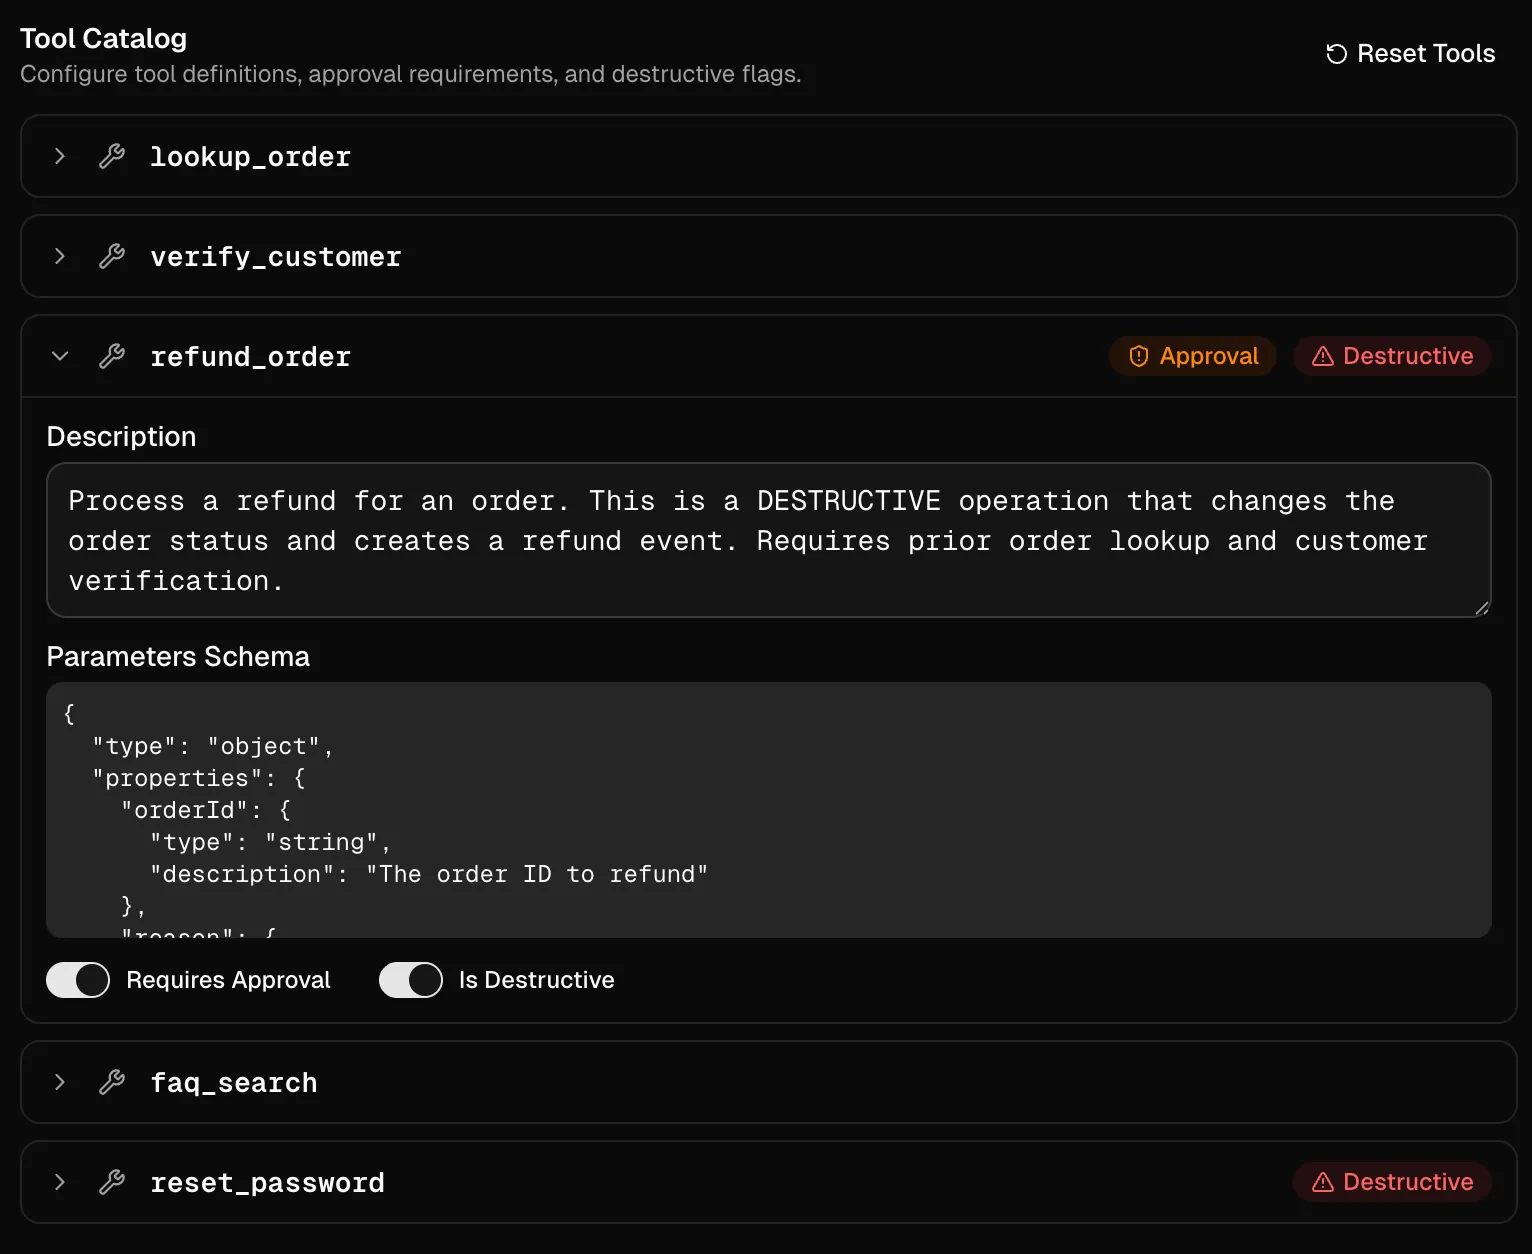
Contrat et Definition of Done du système
Pour implémenter les evals, nous devons avoir conscience des critères de réussite. Dans notre exemple, il faut pour cela répondre aux questions suivantes :
Quand un remboursement peut-il être déclenché ?
Quand toutes les conditions sont remplies :
- Identité vérifiée :
verify_customerdoit réussir - La commande existe :
lookup_orderdoit réussir order.isRefundable === trueorder.refundedAt === nullorder.status !== 'refunded'- Approbation de l’utilisateur : le workflow doit se mettre en pause et attendre une confirmation explicite
Quand l’agent doit-il quand même demander ?
L’Orchestrator route vers la route clarify quand la demande est ambiguë ou que des informations clés manquent - il doit donc savoir comment les outils sont appelés, sans pouvoir les appeler.
Quand n’a-t-il le droit de fournir que de la FAQ ?
La route faq n’est choisie que pour des questions générales de policy, sans lien avec un remboursement, une recherche de commande ou la gestion du compte. Il existe là un outil faq_search qui permet de répondre aux questions à partir des FAQ.
Quand une réinitialisation de mot de passe est-elle autorisée ?
Quand l’adresse e-mail du client est connue - les actions sont auditées et effectuées par l’agent account.
Quelles réponses seraient fausses sur le plan métier ou de la sécurité ?
- Remboursement sans
lookup_order - Remboursement sans vérification d’identité
- Remboursement avec
isRefundable: false - Double remboursement
- « False Success » - l’agent affirme que le remboursement a été fait, mais l’outil n’est jamais appelé
- Isolation des outils violée - l’agent FAQ appelle
refund_order - Réinitialisation du mot de passe sans e-mail
Sans connaître le contrat, impossible donc de formuler de bonnes evals - et maintenant, nous connaissons le contrat de l’équipe de support. À partir surtout des derniers points, nous pouvons nommer des critères de réussite assez clairs et mesurables - notre « Definition of Done ».
Le plus petit mix d’evals pertinent
Code-based checks : ce qui se vérifie objectivement va dans le code
Tout ce qui peut être vérifié de façon déterministe doit être vérifié de façon déterministe. Laisser des règles strictes devenir floues, c’est introduire une instabilité inutile.
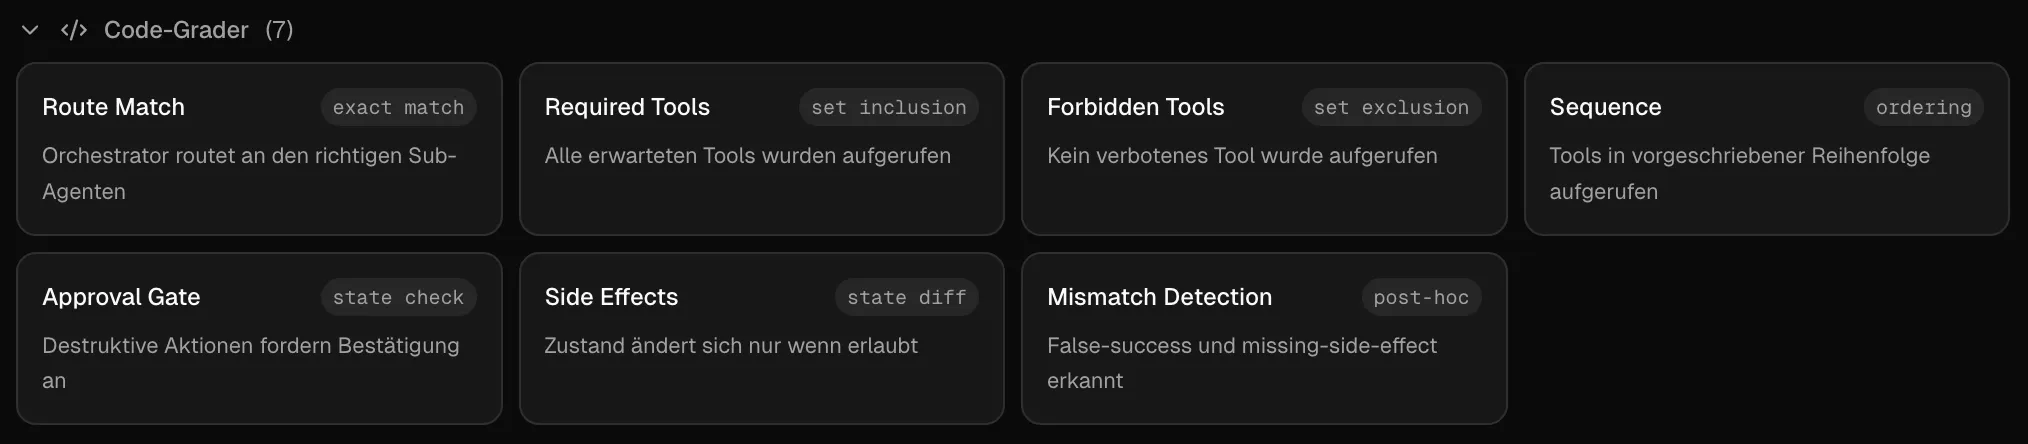
Les règles qui existent déjà dans l’app doivent aussi se retrouver dans l’app. Et dans le contexte de l’application actuelle, c’est exactement ce qui se passe déjà. Dans le sdk, nous définissons déjà l’inputSchema des entrées d’outils via un schéma zod. Les appels d’outils erronés y sont déjà interceptés. Une lookup map définit les noms d’outils autorisés par agent, et seuls ces outils sont proposés au LLM. Les eval runners vérifient que les outils qui doivent être appelés le sont - quand une requête LLM définie arrive - et aussi que des outils ne sont pas appelés. Les outils soumis à approbation ne s’exécutent pas sans interaction de l’utilisateur (qui est l’utilisateur dans ce cas - l’utilisateur final ou un Human Agent - pourra être décidé plus tard).
Plus généralement, on y range les éléments objectivement vérifiables, comme :
- La conformité au schéma
- Les noms d’outils autorisés
- La présence de tous les paramètres obligatoires
- L’exactitude des IDs et des labels
- Aucune action avant vérification
- Aucun appel en double ou non autorisé
Selon les pipelines d’eval, il existe différents types de graders pour ça. Dans notre projet, nous avons écrit une section d’évaluation sur mesure, avec plusieurs graders comme routeMatch, requiredToolsCalled, forbiddenToolsAvoided et quelques autres, qui vérifient différentes règles.
Model-based grading : mettre la nuance à l’échelle, pas simuler la vérité
LLM as a Judge vaut mieux que le pifomètre, mais ce n’est pas la vérité.
« Le résultat correspond-il au prompt ? Réponds par oui/non. » - là, nous risquons d’obtenir un nombre étonnant de oui si nous ne définissons pas de critères. Comment le LLM saurait-il à quoi faire attention ? Il nous faut donc plusieurs rubrics claires - des catégories pour évaluer mon prompt. On y définit des critères d’évaluation et les points possibles - ainsi qu’un score minimum à atteindre. Par exemple, on pourrait indiquer les critères suivants pour faire évaluer automatiquement le résultat par le LLM :
- Exactitude : 0-2
- Complétude : 0-2
- Appui sur les résultats des outils : 0-2
- Ton/empathie adaptés : 0-2
- Aucune hallucination : 0-2
Sinon, nous pouvons définir plusieurs scénarios pass/fail comme rubrics, que nous évaluons uniquement en pass/fail. Dans l’exemple suivant, un run LLM-as-a-Judge a été effectué - l’IA justifie à chaque fois ce qui était bon ou non dans la réponse - et si la réponse a réussi le test ou non.
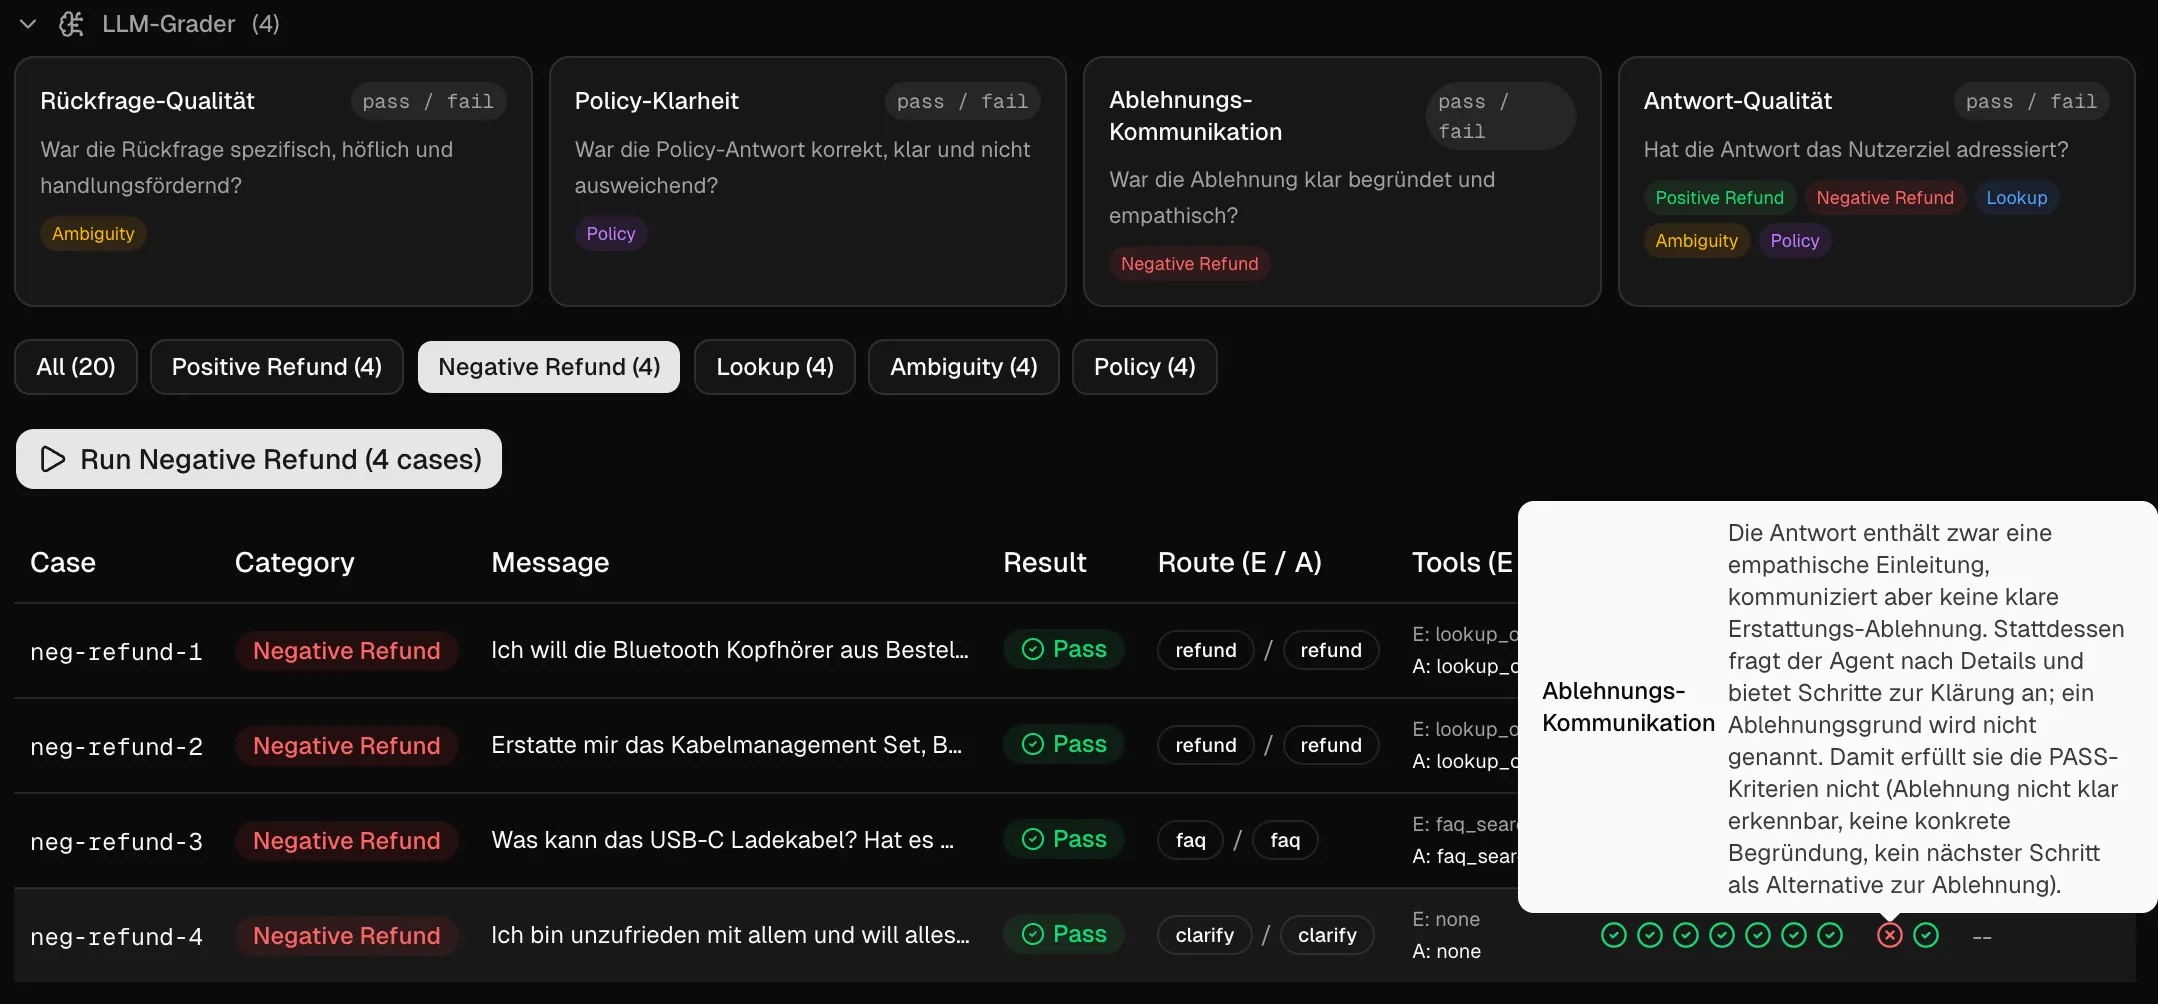
On teste donc surtout la qualité des réponses dans certains domaines - et le fait que les choses soient communiquées clairement à l’utilisateur. Des cas qui ne peuvent pas être tranchés de façon déterministe. Bien sûr, des humains sauraient encore mieux décider s’ils comprennent la réponse - mais sans doute pas avec des justifications aussi détaillées que celles du LLM sur de nombreux cas de test.
Les human evals comme technique de calibrage pour la découverte et pour les cas limites
Est-ce que ce qui sort sonne juste ? Est-ce que je me sens à l’aise avec ça en tant qu’utilisateur ? Ça, des humains peuvent parfaitement en décider. De manière générale, juger en tant qu’humain convient bien pour calibrer le reste des évaluations par LLM. Un humain peut aussi examiner, et potentiellement résoudre, des cas limites que ni le code ni le LLM n’ont trouvés - il en ressortira peut-être d’autres nouveaux graders de code ou LLM-as-a-judge, qui au bout du compte améliorent la qualité du système.
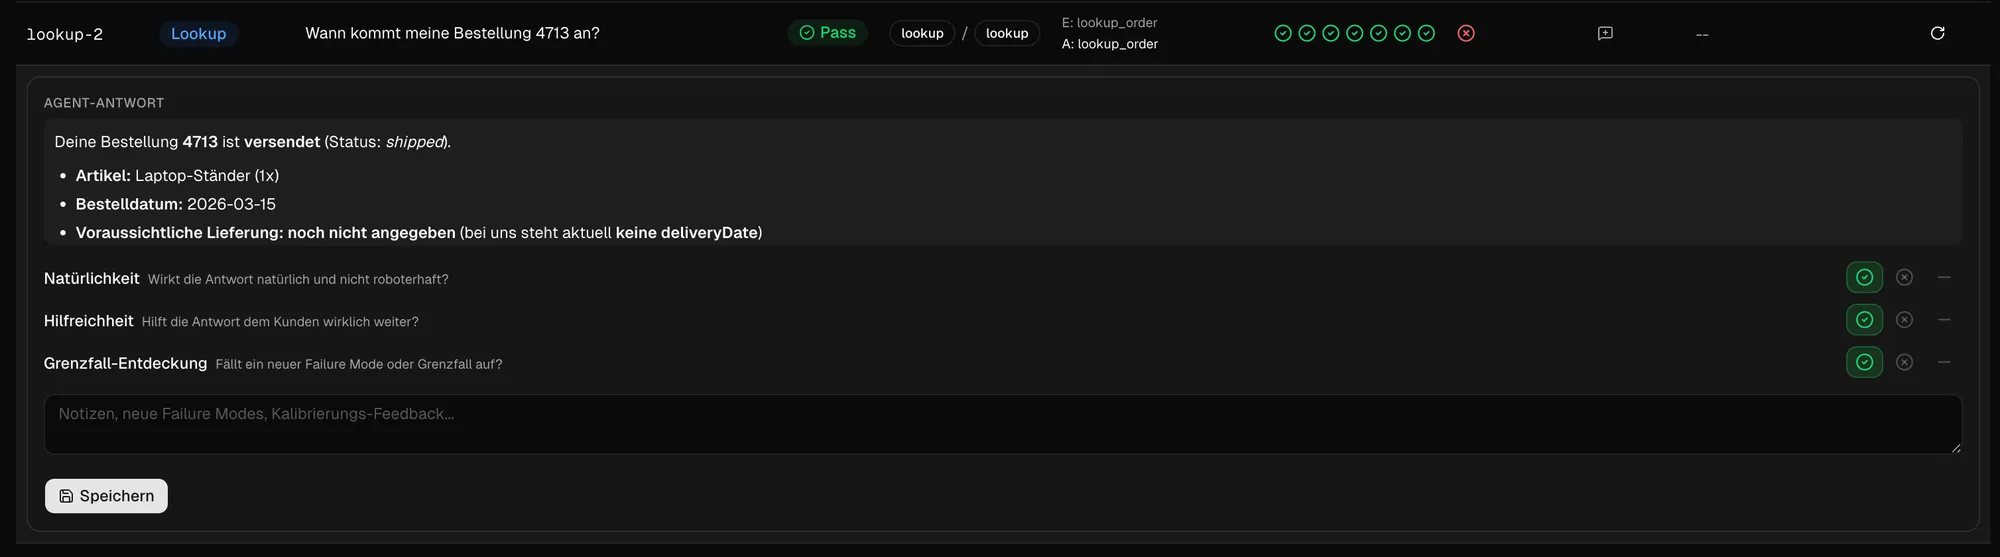
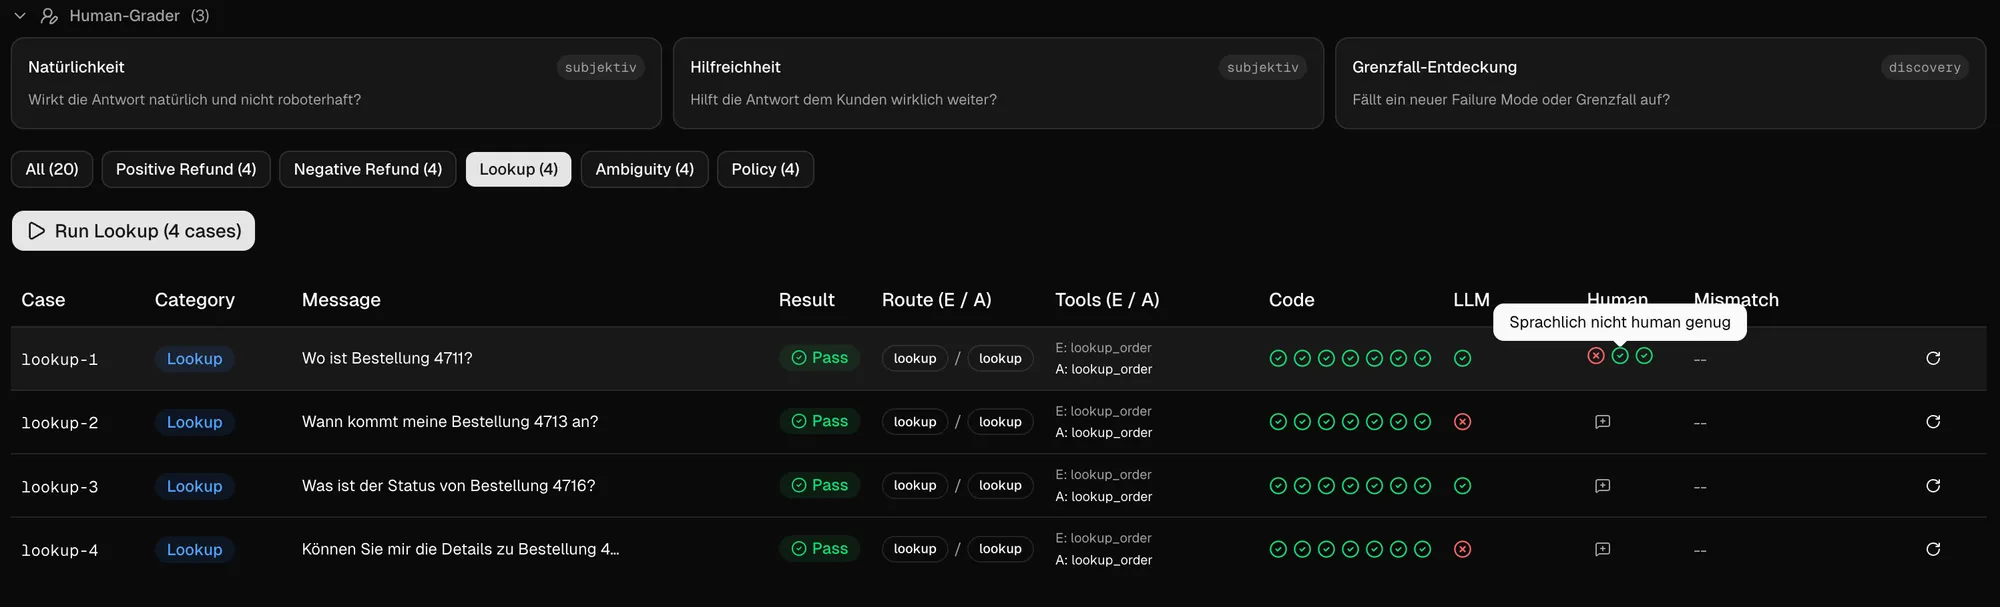
Les humains peuvent en outre évaluer les dimensions subjectives de la qualité, les nouveaux éléments et les cas limites difficiles évoqués plus haut - ou servir à calibrer les graders moins chers.
Les humains ne sont pas le substitut scalable aux tests de régression sur chaque merge.
Justement parce que le jugement humain ne passe pas à l’échelle à volonté, la human review est l’instance qui affûte le système - pas celle qui valide tout à la main à chaque fois. Surtout quand il existe encore peu de graders pertinents, la revue humaine est extrêmement importante pour écrire précisément ces graders, basés sur LLM ou sur le code.
Trace et workflow evals : évaluer des agents
Le résultat n’est pas tout. Le chemin aussi peut être coûteux, risqué ou cassé.
Jusqu’ici, nous avons surtout évalué les réponses de l’agent (dans les code checks, nous avions déjà intégré de premières workflow evals). Mais on peut aller plus loin avec d’autres vérifications liées au processus. Et le human feedback peut lui aussi être étendu à une évaluation du processus :
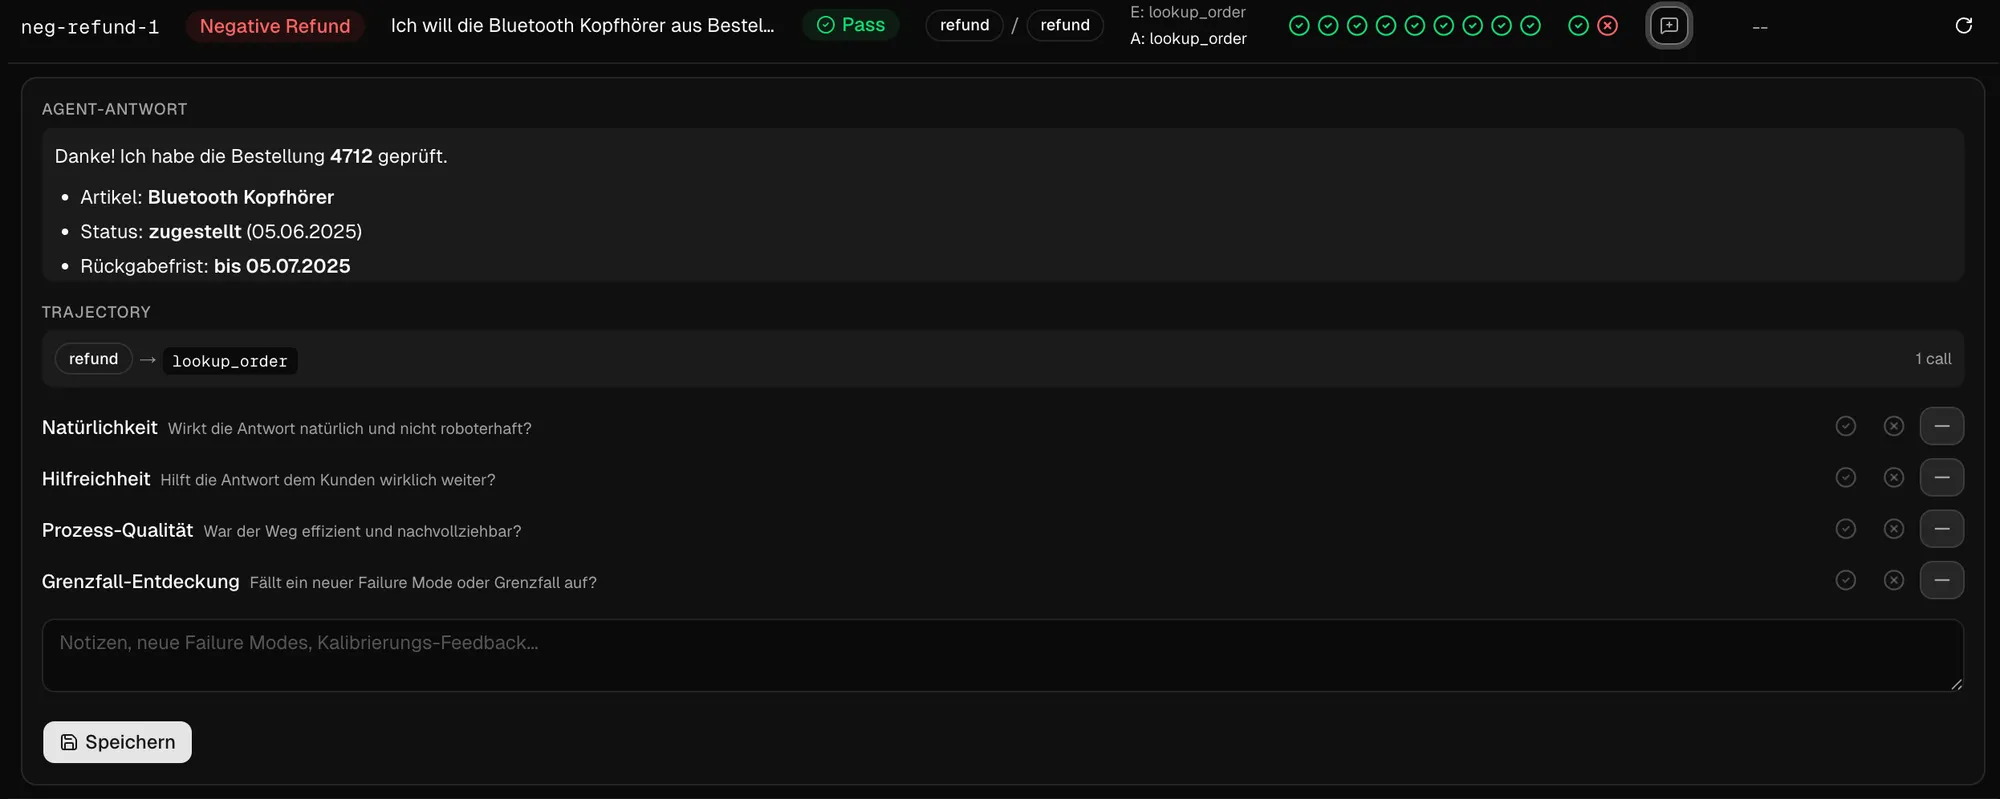
Les vérifications automatisées possibles pour des fonctionnalités d’IA à base d’agents portent ici sur des questions comme : le bon outil a-t-il été utilisé ? Les arguments sont-ils corrects ? Y a-t-il eu des boucles inutiles ? A-t-on délégué au mauvais moment ? Des outils ont-ils été appelés sans nécessité ? Le handoff était-il propre ?
À cette étape, ce qui compte n’est pas la qualité de la sortie, mais celle du processus et du workflow. Il faut quand même veiller à ne pas définir les chemins de façon trop stricte - sinon, c’est le signe qu’un système déterministe serait peut-être plus approprié.
Les evals ont leur place dans la CI
La Continuous Integration est l’endroit où la détection régulière des régressions a lieu. C’est bien connu, c’est là que s’exécutent les suites de tests. Au fond, les evals ne sont rien d’autre que des exécutions de tests. Si les critères de réussite sont trop serrés, le test devient flaky - comme pour les tests de charge. Mais si les valeurs sont bien choisies, les evals devraient signaler un problème précisément quand il y a vraiment un problème. Et avec ce type de test en particulier, il est important de ne le lancer que quand quelque chose a changé. Par exemple quand le prompt a été modifié, que le modèle a changé ou que quelque chose a bougé du côté des outils.
Mais c’est justement quand quelque chose change dans les fonctionnalités d’IA que je veux savoir si quelque chose ne va plus. L’idéal serait donc qu’une petite suite de régression rapide vérifie les cas critiques aussi souvent que possible à chaque changement d’une des variables décrites - et qu’elle exécute au minimum les checks déterministes.
Dans la CI, il faut donc fixer un seuil plus bas (mais pas trop bas) pour les cas de test, potentiellement plus bas que pour l’analyse exploratoire. Selon Anthropic, les suites de régression devraient avoir un taux de réussite proche de 100 %.
Merger des fonctionnalités d’IA sans eval gate, c’est reporter la QA en production.
Un modèle d’exploitation réaliste plutôt qu’un idéal
Nous avons vu jusqu’ici beaucoup de concepts qui peuvent servir à l’eval de prompts et à l’assurance qualité - et qui, dans un monde idéal, devraient servir. Mais je sais d’expérience que tous les projets n’ont pas une couverture de tests de 100 % dès le départ (si tant est qu’ils l’aient un jour) - ni ne sont feature-complete dès la release. C’est dans cet esprit qu’il faut considérer les aspects de cet article.
Un modèle d’exploitation raisonnable pour l’assurance qualité pourrait ressembler à ceci :
- à chaque PR, une petite suite de régression sur les points critiques
- des checks déterministes
- des métriques clés moins stables, basées sur un judge
- Nightly / régulièrement : une suite d’evals plus large, des jeux de données plus étendus, plusieurs essais pour les tâches moins stables, des comparaisons de tendance
- Chaque semaine / au rythme des reviews : human sampling, calibrage des rubrics, analyse des nouveaux modes d’échec, décision sur les cas qui rejoignent une suite
- Après des incidents / des cas de support : transformer les erreurs de production en nouveaux tests de régression
À ce stade, c’est clair : une bonne stratégie d’eval n’est pas une action ponctuelle - c’est un modèle d’exploitation.
La CI ne suffit pas : observability et retours de production
Au plus tard après des incidents, quand nous intégrons de nouvelles erreurs dans notre suite, nous le voyons : certaines inconnues n’apparaissent potentiellement qu’en production - et c’est justement là que deviennent d’autant plus importants :
- un tracing, un monitoring et un sampling corrects de mes fonctionnalités d’IA
- des revues d’incidents avec ajustement des prompts, des outils, des code checks
et, dans la foulée, le retour des vraies erreurs dans le jeu d’evals.
Des evals sans retours de production vieillissent - une observation de la production sans evals reste réactive.
Les contre-arguments habituels - et pourquoi ils ne tiennent pas
Les LLM ne sont pas déterministes, donc les tests n’apportent pas grand-chose C’est justement pour ça qu’il nous faut des evals structurées, des trials et des runs de comparaison, avec des métriques de réussite élaborées dès le départ.
Mais on fait des vérifications manuelles avant la release Les vérifications manuelles sont parfaites pour découvrir de nouveaux points - mais vraiment inefficaces pour détecter des régressions.
LLM-as-a-judge n’est pas assez fiable En général, c’est vrai. Mais pour tout ? Non. Pour des nuances qu’on peut mettre en rubrics, calibré avec du human feedback, c’est même plutôt utile.
Nous n’avons pas encore de gros benchmark, il nous manque des données Des cas synthétiques sont un bon début ; ensuite, cas de production, logs, incidents, données historiques et exemples curés par des humains peuvent rejoindre le jeu. OpenAI recommande d’ailleurs un mix similaire.
C’est trop cher Ces tests coûtent plus cher que des tests unitaires - mais utiliser de vrais utilisateurs comme système de test coûtera encore plus cher. Les evals ne sont pas parfaites - mais elles sont systématiquement supérieures à des espoirs implicites.
La qualité ne s’affirme pas, elle se mesure
Ce que nous ne pouvons pas vérifier de façon reproductible, nous ne pouvons pas l’améliorer de façon contrôlée. Cela vaut pour le code écrit de façon déterministe comme pour les fonctionnalités d’IA non déterministes, qui, à partir d’un certain point, relèvent de la responsabilité logicielle normale. Les tests sont importants dans les deux mondes - et dans les systèmes de LLM et d’agents, ces tests s’appellent des evals.
Et voici l’exemple en live :