
Wer AI-Features ohne Evals rausschiebt, hat keinen Engineering-Prozess, sondern ’n Hoffnungsmodell.
Prompting im Chat is super, um auszuprobieren, wat überhaupt geht. Aber sobald dat in Produktion geht, reichen ’n paar gute Einzelantworten nich mehr. Wer ohne Evals deployt, der schiebt dat Testen an echte Nutzer wech. Kurz angerissen hab ich dat Thema schon in meinem letzten Post, wo ich auf die Schnelle ’ne AI-basierte Evaluierung benutzt hab. Hier will ich genau den Aspekt ma genauer auseinandernehmen und beschreiben, worauf et in Produktionsanwendungen ankommt.
Im Chatfenster getestet
… is nich getestet.
Dat Bauen von AI-Features fängt oft inne Chat-UI an oder mit ’n paar Prompts im Playground für Developer. Nach ’n paar Happy-Path-Fragen hamwa einen, auf den ersten Blick perfekten, Prompt, mit dem man dat Feature direkt umsetzen kann. Klar, ’n bisschen manuelles Nachjustieren gehört wohl dazu.
Und genau dat is perfekt! Für die Exploration, um auszuprobieren, ob die eigentliche Idee vom Feature aufgeht - um versteckte Annahmen und grobe Bauchlandungen aufzudecken. Wat dabei auf der Strecke bleibt, wie in vielen deterministischen Softwareprojekten auch, is dat Testen. Und grad beim Testen fängt die reproduzierbare Qualitätssicherung an. Code, der nur von Hand getestet in Produktion landet, kommt immer mit der Gefahr, dat man wat übersehen hat, vor allem bei Regressionen - und genau datselbe gilt für Prompts, die beim Rumprobieren entstanden sind.
Kommt in zwei Monaten ’n neues Modell von irgend’nem Hersteller raus, dat direkt rein soll, weil et besser zu passen scheint, dann fliegen wir ganz schnell blind - wenn wir den Prompt beim Rumprobieren gebaut und dann einfach im Projekt liegen gelassen haben, ohne nochma zu testen. Aber nich nur ’n neues Modell tritt dat los, auch ’ne (womöglich unsichtbare) Änderung am System Prompt vom Modellhersteller könnte dat Verhalten von unseren Prompts - und AI-Features - komplett umkrempeln. Ohne reproduzierbare Evaluation sind wir hier im reinsten Blindflug. Wie nachts im Stollen ohne Grubenlampe.
Läuft inne Demo und hält auch bei Änderungen - dat sind zwei Paar Schuhe. Und genau da setzt die Continuous Evaluation (CE) an.
Wo Prompt Engineering aufhört
Sobald Modelloutput Teil von der Produktlogik wird, reicht gutes Prompting nich mehr. Dann zählen Contracts, Evals und Observability mindestens genauso viel wie der Prompt selbst.

Wenn wir immer weiter am Prompt rumdrehen, stoßen wir womöglich an Grenzen: Dat Ergebnis wird einfach nich besser, die Evals bleiben rot. Kann sein, dat et Zeit is, dat Modell zu wechseln. Denn nich jedes Problem liegt am Prompt - weitere Gründe, warum wat schiefgeht, sind Modellwahl, Architektur, Tooling, Daten oder auch der Workflow.
Besseres Prompting macht die Modellantworten besser, Engineering macht dat System drumrum stabil.
Woran liegt dat in dem Beispiel, dat keine Retoure ausgelöst wurde? Im Eval-Prozess waren die Antworten immer tipptopp - und die Toolaufrufe haben auch immer funktioniert. Guckt man sich dat Beispiel an, fällt auf: ein MCP-Server? Der liefert seine Tool-Beschreibungen selbst aus - und wenn sich da wat geändert hat, der Prompt aber nich dazu passt, dann kann die Logik nich mehr funktionieren - und so’n Fall tritt auf.
Ab wann Evals Pflicht sind
Sobald Nichtdeterminismus ins System kommt, isset ’ne gute Idee, Evals zu fahren. Nich unbedingt, wenn wir die AI-Ausgaben direkt dem Nutzer hinlegen - aber auf jeden Fall dann, wenn der Modelloutput die Produktlogik beeinflusst.
Routing, Tool-Calls, Daten schreiben oder ändern, Nutzeraktionen vorbereiten oder verhindern, Teil von ’ner Workflowkette - dat alles sind Gründe, Evals zu fahren - und für Systeme, die wat taugen sollen, sind se Pflicht.
Je mehr Stellen für Nichtdeterminismus im System et gibt, desto größer der Bedarf an systematischen Evals. Dat geht von Single-Turn (ein Modelloutput steuert eine Sache) über Workflows (’ne Reihe von Prompts, die jeweils auf dem Output vom vorherigen aufbauen), über Single-agents (ein Agent ruft so lange Tools auf oder malocht, bis er “denkt”, er wär fertig) bis hin zu Multi-agents, die untereinander quatschen. Spätestens da isset mehr als relevant, systematische Evals zu fahren - empfohlen isset schon bei Single-Turns.

Zum Beispiel hat ’n FAQ-Bot, der sich Produktwissen zu ’ner Frage über z.B. RAG zusammensucht und dem Nutzer hinlegt, eher ’n niedriges Risiko - während der Refund-Agent von oben mit Tool-Calls an refund-Tools deutlich mehr Risiko mitbringt. Sitzt der Agent dann noch neben ’nem Buying-Agent, der für mich Sachen kaufen kann - und wird von ’nem Orchestrator verwaltet, dann hamwa ’ne extrem hohe Komplexität - und die systematischen Evals werden umso wichtiger.
Wer Modelloutput in die Produktlogik übernimmt, übernimmt auch die Testverantwortung. Butter bei die Fische.
Wat ’ne brauchbare Eval ausmacht
Wat man braucht:
- Einen konkreten Datensatz
- ein festgelegtes Erfolgskriterium
- mindestens einen Grader oder Verifier
- einen reproduzierbaren Lauf
- einen Vergleich über Änderungen hinweg
Nich nur positives Verhalten sollte man testen - sondern auch, wenn bestimmtes Verhalten nich auftreten soll. Vor allem manuelle Verifier sind teuer - da lohnt sich ’ne kleine, echte, zielgerichtete Fallmenge eher als ’n perfekter Benchmark mit unfassbar vielen Datenpunkten.
Im Vergleich zu human evals sind automatisiert bewertende Grader (llm-as-a-judge) viel günstiger. ’Ne weitere Möglichkeit sind Code based grades - und (wenn et geht) sollten die den Hauptteil der Evals ausmachen - aber wegen dem Nichtdeterminismus niemals die einzige Art der Verifikation sein.

Um beim Beispiel vom Refund-Agent zu bleiben: Ein guter Einstieg in die Evaluierung is ’n kleineres, handliches Seed-Set aus:
- 4 positiven Refund-Fällen
- 4 negativen Refund-Fällen
- 4 Lookup-Fällen
- 4 Ambiguitäts-Fällen
- 4 Grenzfällen, die ’nen möglichen Policy-Fall melden sollten
Auf Basis von dem Testset kann man dann abprüfen, ob Toolaufrufe [nich] stattgefunden haben, ob die Response an den Nutzer (oder Orchestrator) angemessen is - ob korrekt nachgefragt wird usw. An dem Punkt kommt et auf die Kreativität innerhalb der Business-Regeln an, um sinnvolle und hilfreiche Tests zu formulieren.
Laut den beiden großen LLM-Anbietern geht et nich darum, Prompts zu bewerten, sondern darum, AI-Verhalten so zu spezifizieren, dat et testbar, erklärbar und automatisierbar wird. Die Prompt Evals sind dabei kein Nebenkriegsschauplatz, sondern der Übergang von “wir probieren ma wat aus” zu “wir können Qualität sichtbar absichern”.
Am besten schreibt man zuallererst die Erfolgsdefinition auf - und erst danach erarbeitet man ’nen Prompt - so ähnlich wie bei Test Driven Development. Ohne festgelegten Erfolg kannze auf keiner Basis evaluieren.
Beim Entwurf von Evals muss man mehrere Bewertungsdimensionen im Blick haben. Anthropic nennt unter anderem Aufgabentreue, Konsistenz, Relevanz, Datenschutz, Kontextnutzung, Latenz und Kosten; OpenAI beschreibt auch vergleichbare Dimensionen. Entscheidend is dabei, die Kriterien so zu formulieren, dat se mit passenden Methoden überprüfbar sind: zuerst möglichst deterministische, technisch messbare Erfolgskriterien, danach Kriterien, die sich mit nichtdeterministischen Verfahren wie LLMs as a judge bewerten lassen, und zum Schluss die, wo ’n Mensch drübergucken muss.
Weil die Ausgaben nich deterministisch sind, kann man ’nen einzelnen Lauf weiterhin binär als bestanden oder nich bestanden bewerten. Bei wackeligen Aufgaben oder Agent Loops, die jedes Mal anders verlaufen, reicht ein einzelner Lauf aber oft nich, um die Zuverlässigkeit vom System vernünftig zu beurteilen. In so Fällen sollte man datselbe Szenario mehrmals laufen lassen und dat Ergebnis über passende Metriken zusammenfassen - etwa mit pass@k, wenn mindestens ein erfolgreicher Versuch zählt, oder über ’ne Konsistenzschwelle, wenn verlässliches Verhalten erwartet wird. So kann man zum Beispiel festlegen, dat ’n Szenario in mindestens 9 von 10 Wiederholungen bestehen muss. Für Regressions-Suiten sollte die Passrate dagegen möglichst nah an 100 % liegen.

’N schlechter Eval-Score kann ’n Modellproblem sein. Kann aber genauso gut ’n kaputter Test sein.
Evaluation by Example: Ein Support-Agent mit Tools
Auf Basis von den Beispielen, die wir oben schon angerissen haben, wollen wir mit ’nem Support-Team arbeiten. Tatsächlich is an der Stelle ’n Chat-Interface am sinnvollsten - wir brauchen zwar nich viel UI drumrum - dafür hängt der Agent direkt an unserm System und kann Infos zum Nutzer abrufen und Sachen im Namen vom Nutzer erledigen - konkret z.B. Produkte stornieren.
Die UI hat vor allem Debug-Ausgaben, um dat Agent-Team besser zu machen. Da reicht ’n Chat-Interface, Tracing von den Tool-Aufrufen und Routings, eingebaute Eval-Tests, editierbare Prompts und ’n “Backend”-State, um zu prüfen, wat genau mit den Daten passiert.
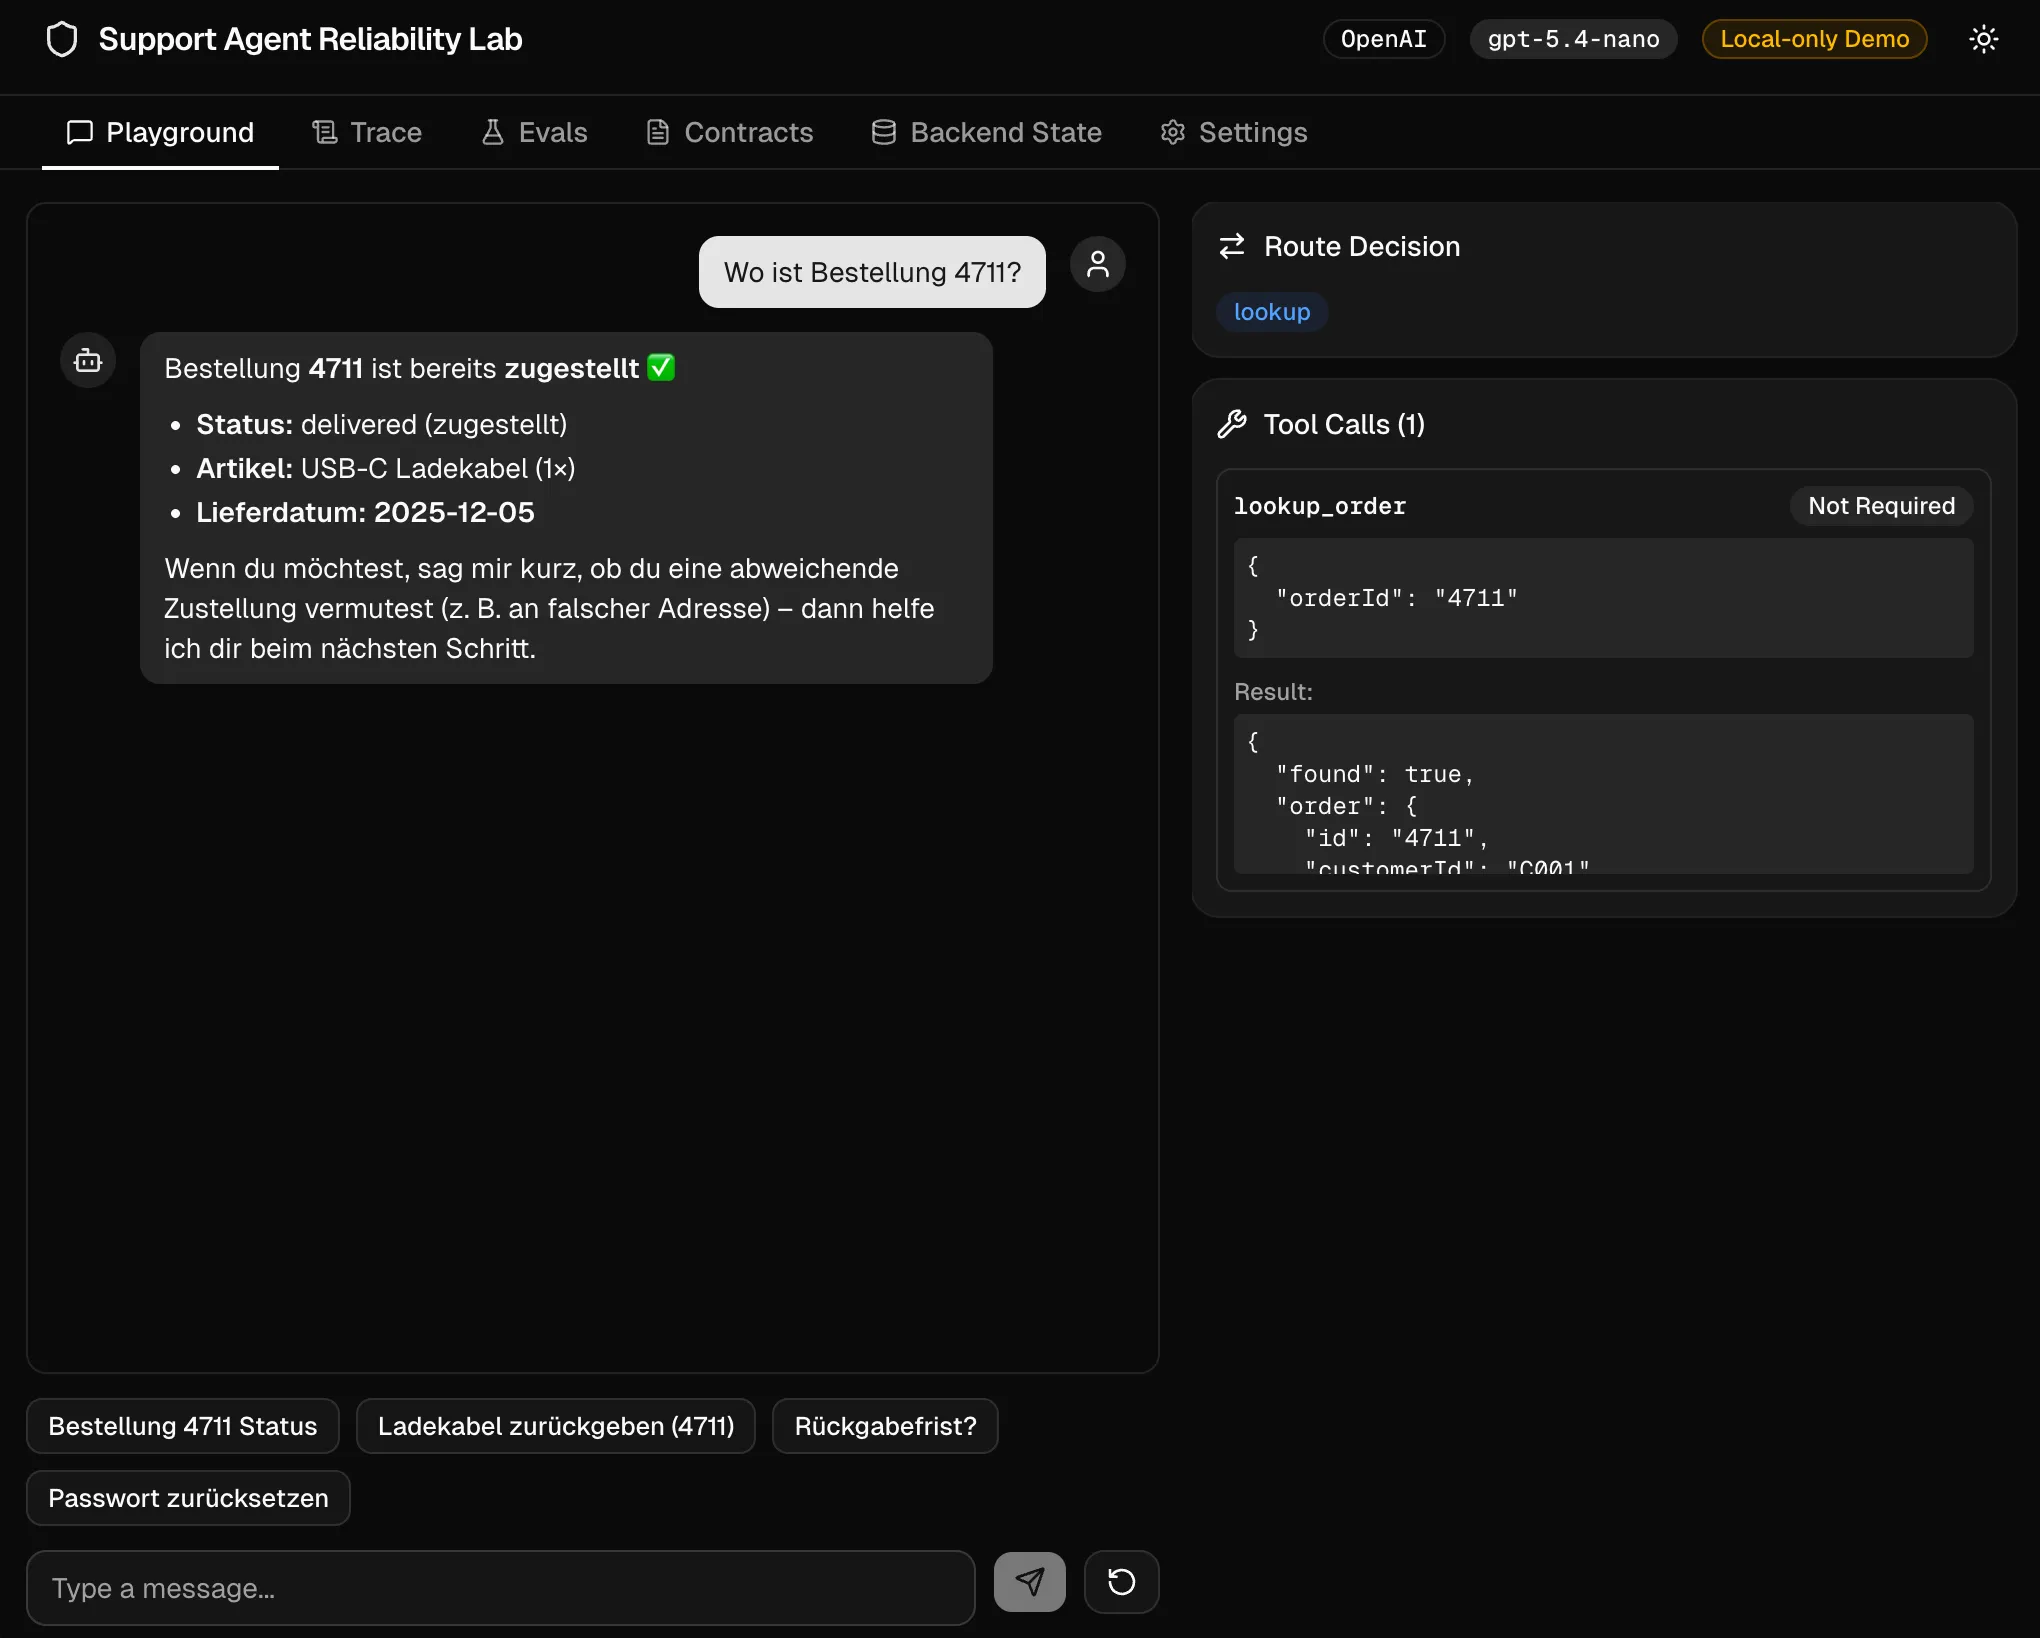
Claude hat mir netterweise ’ne Anwendung gebaut, die ’nen Support-Agent anlegt. Nach ’nem ziemlich erfolgreichen One-Shot-Prompt hab ich noch Kleinkram angepasst - und schon können wir loslegen mit ’nem orchestrierten Support-Agent-Team.
One-Shot Prompt (generiert von GPT 5.4 Pro)
Du bist ’n senior Fullstack TypeScript Engineer und sollst ’ne lokale Demo-Anwendung bauen.
Ziel Bau ’ne moderne, screenshot-taugliche Web-App für ’nen Blogpost über AI-Evals, Tool-Verträge, Orchestrierung und Drift. Die App soll glasklar zeigen:
“’Ne plausible Assistant-Antwort is kein Beweis dafür, dat der richtige Tool-Call oder ’n echter Seiteneffekt stattgefunden hat.”
Dat Produkt is keine echte Support-Plattform, sondern ’ne fokussierte Reliability-Werkbank rund um ’n Orchestrator-/Refund-Agent-Szenario.
Arbeitsmodus Arbeite in dieser Reihenfolge:
- Ganz kurze Architekturzusammenfassung
- konkrete Dateistruktur
- Implementierung
- README
- kurze Liste mit Punkten, die bewusst nach hinten geschoben sind
Wart nich auf breite Rückfragen. Triff vernünftige Entscheidungen und halt den Scope eng.
Strikte Scope-Grenze
- Kein generischer AI-Playground
- Kein echtes Auth-System
- Keine echte Datenbank
- Kein echter MCP-Server
- Kein LangChain
- Keine Produktions-Härtung
- Keine SaaS-Observability
- Kein autonomer Agent-Schwarm
Stattdessen:
- lokale Demo
- explizite, gut prüfbare Workflows
- sichtbare Tool-Trajectories
- reproduzierbare Seed-Evals
- editierbare Prompt-/Tool-Contracts
Tech Stack
- Next.js App Router
- TypeScript
- Tailwind CSS
- shadcn/ui
- lucide-react
- aktuelle stabile APIs aus ai-sdk.dev
- AI SDK UI im Client
- AI SDK Core im Server
- zod für Schemas
- Vitest für ’n paar gezielte Tests
Wichtige Architekturentscheidung Stell dat System auf Produktebene als “Agents” dar, aber bau et kontrolliert und explizit:
- Orchestrator
- Refund Agent
- Order/Lookup Agent
- Account/FAQ Agent
Lass die Finger von ’nem riesigen Black-Box-Agentensystem. Ich will explizite, nachvollziehbare Module/Funktionen mit klaren Verträgen und strukturierten Traces.
Produktidee App-Name: Support Agent Reliability Lab
Die App soll zeigen:
- Routing durch ’nen Orchestrator
- spezialisierte Bearbeitung durch ’nen Refund Agent
- klare Tool-Verträge
- Approval für destruktive Aktionen
- Unterschied zwischen Antworttext und echtem Seiteneffekt
- Drift durch geänderte Tool-Beschreibungen
- kleine reproduzierbare Eval-Suite
Local-only Regel
- Provider API Keys werden im Browser localStorage gespeichert
- die Keys gehen pro Request an die lokalen API-Routen
- Keys niemals loggen
- Keys inne UI maskieren
- klare Warnung inne UI: “Local-only demo. Do not deploy as-is.”
Provider Support
- OpenAI
- Anthropic
Settings sollen erlauben:
- Provider auswählen
- Modell-ID eingeben
- API-Key eingeben
- anzeigen, ob ’n Key da is
- lokale Daten komplett löschen
Zentrale Produkt-Screens Bau ’n modernes Layout mit Header + Tabs.
Tabs:
- Playground
- Trace
- Evals
- Contracts
- Backend State
- Settings
Die Prompts vom Team sind komplett anpassbar. Dat Team selbst besteht aus:
- Orchestrator (verteilt anne einzelnen Agents)
- Refund Agent (kennt die Regeln und Tools für Refunds)
- Lookup Agent (kümmert sich um Bestellstatus- & Tracking-Anfragen)
- Account & FAQ Agent (Passwort-Resets & Policy-Fragen)
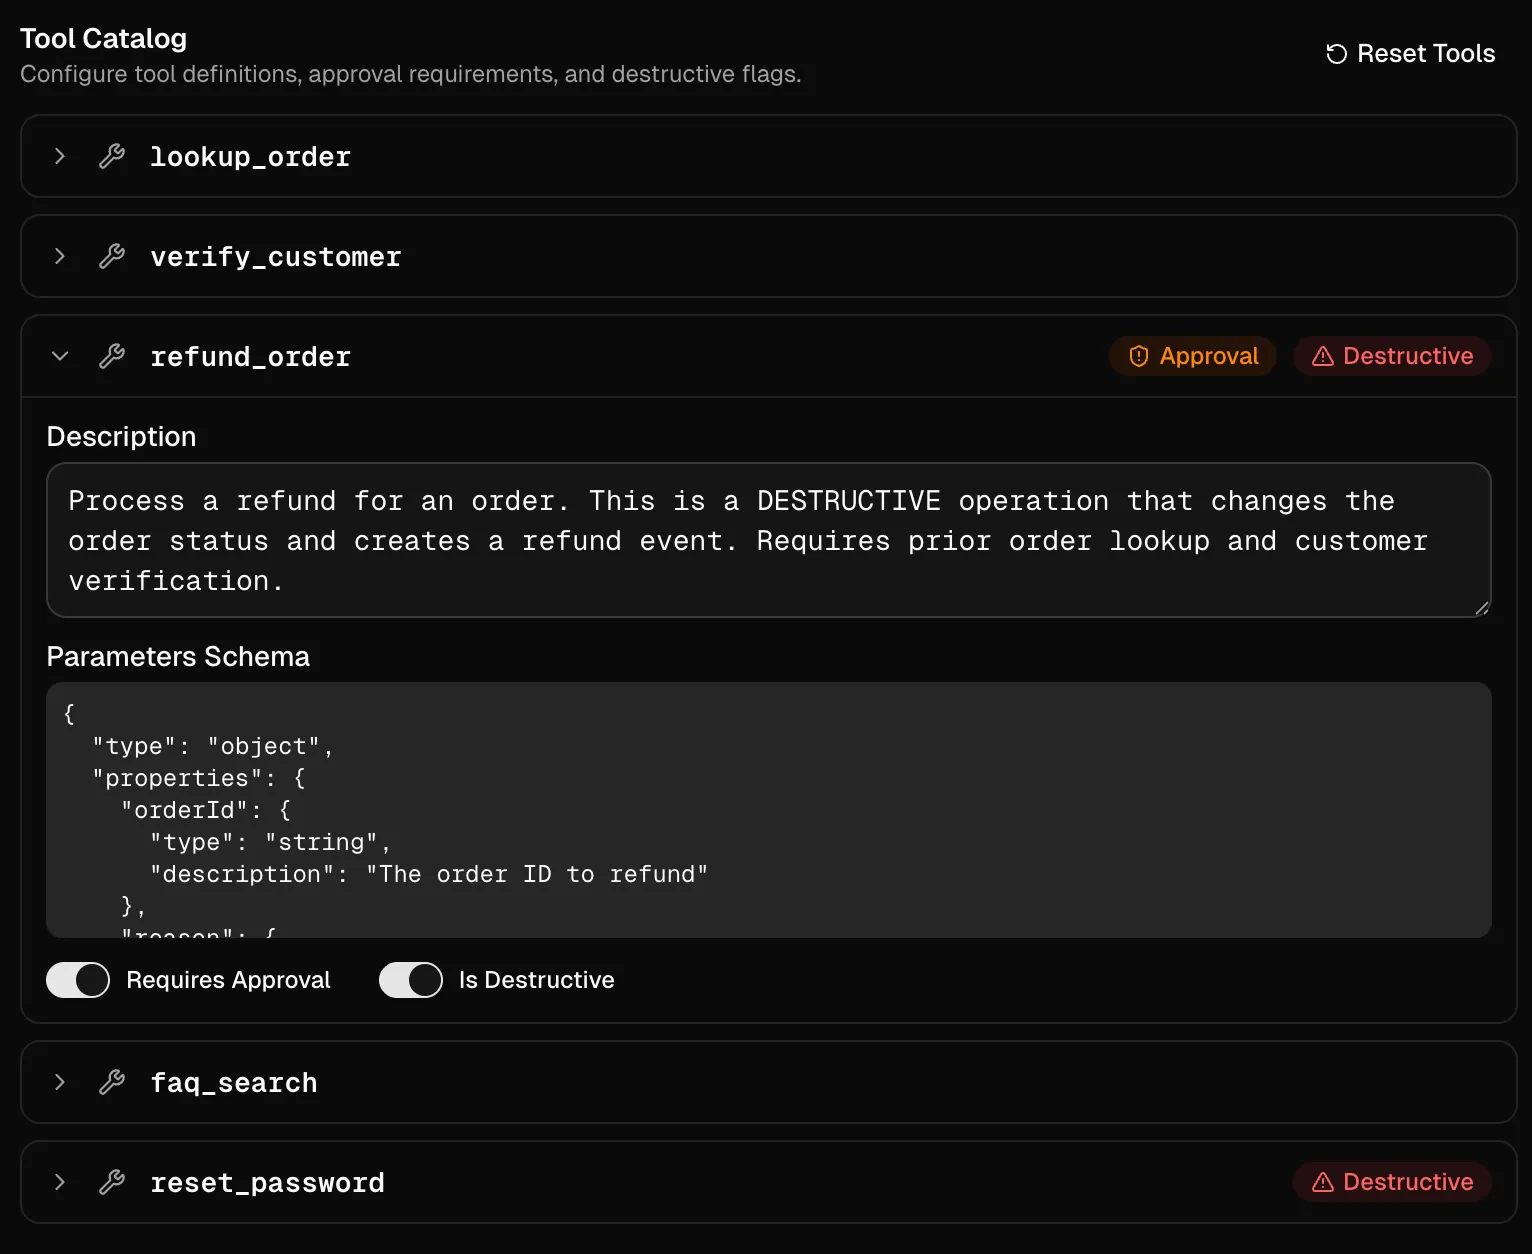
Die relevanten Tools sind dabei: lookup_order(order_id), refund_order(order_id, reason), reset_password(account_id), faq_search(query) und verifyCustomer(account_id, email). Inne generierten Anwendung kannze auch die jeweiligen Toolbeschreibungen anpassen, um auch da andere Prompts zu evaluieren und bessere Ergebnisse rauszuholen.
Vertrag & Definition of Done vom System
Um die Evals zu bauen, sollten wir wissen, wat überhaupt als Erfolg zählt. Dafür müssen wir in unserm Beispiel folgende Fragen beantworten:
Wann darf ’n Refund ausgelöst werden?
Wenn alle Bedingungen erfüllt sind:
- Identität verifiziert:
verify_customermuss erfolgreich sein - Order existiert:
lookup_ordermuss erfolgreich sein order.isRefundable === trueorder.refundedAt === nullorder.status !== 'refunded'- User-Approval: Der Workflow sollte pausieren und auf ’ne ausdrückliche Bestätigung warten
Wann muss der Agent doch nachfragen?
Der Orchestrator routet zur clarify-Route, wenn die Anfrage mehrdeutig is oder wichtige Infos fehlen - der sollte also wissen, wie die Tools aufgerufen werden, ohne se selbst aufrufen zu können.
Wann darf er nur FAQ liefern?
Die Route faq wird nur bei allgemeinen Policy-Fragen genommen, die nix mit Refund, Order-Lookup oder Kontoverwaltung zu tun haben. Da gibt et ’n faq_search-Tool, über dat Fragen aus den FAQs beantwortet werden können.
Wann is ’n Passwort-Reset in Ordnung?
Wenn die E-Mail-Adresse vom Kunden bekannt is - die Aktionen werden auditiert und vom account-Agent durchgeführt.
Welche Antworten wären fachlich oder sicherheitstechnisch verkehrt?
- Refund ohne
lookup_order - Refund ohne Identitätsprüfung
- Refund bei
isRefundable: false - Doppelter Refund
- “False Success” - Agent behauptet, dat refunded wurde, aber dat Tool wird nie aufgerufen
- Tool-Isolation verletzt - FAQ-Agent ruft
refund_orderauf - Passwort-Reset ohne Email
Ohne den Vertrag zu kennen, kannze also keine guten Evals formulieren - und getz kennen wir den Vertrag vom Support-Team. Vor allem anhand der letzten Punkte können wir ziemlich klare, messbare Erfolgskriterien benennen - unsere “Definition of Done”.
Der kleinste sinnvolle Eval-Mix
Code-based checks: Wat objektiv prüfbar is, gehört in den Code
Alles, wat man deterministisch prüfen kann, sollte man auch deterministisch prüfen. Denn wer harte Regeln weich werden lässt, baut sich unnötig Wackelei ein.
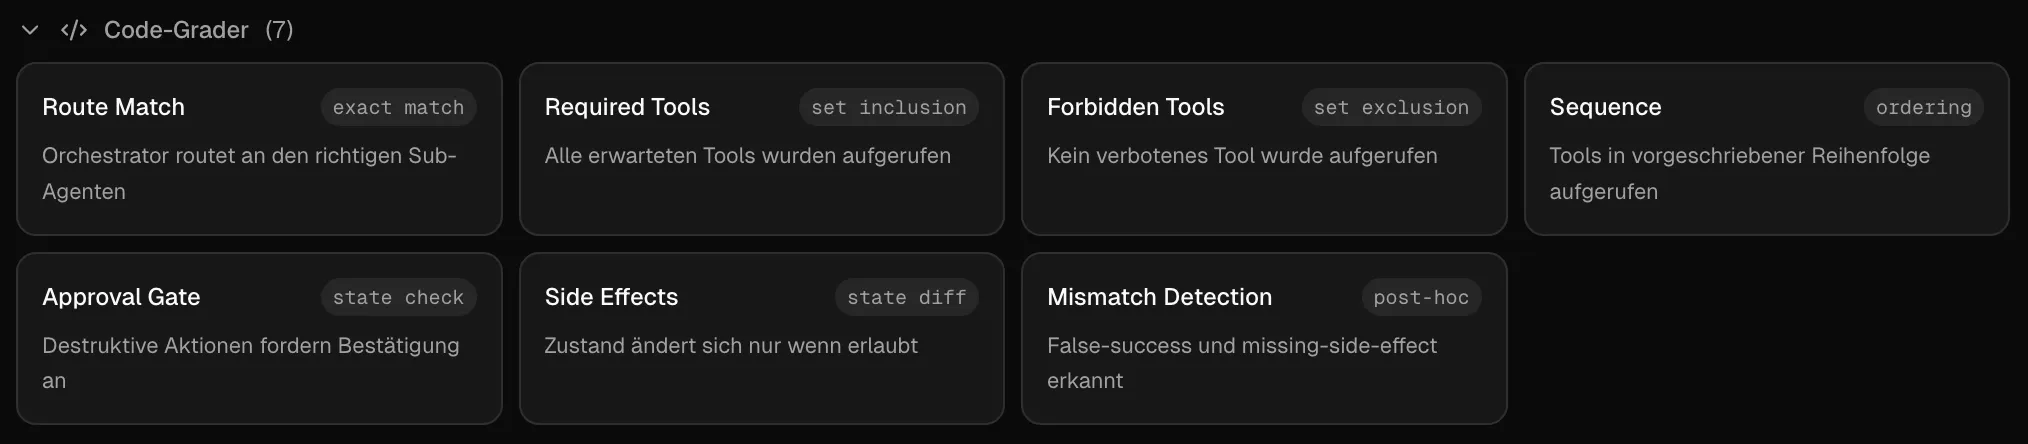
Regeln, die et inne App schon gibt, die sollten sich auch inne App wiederfinden. Und im Kontext von der aktuellen Anwendung passiert genau dat auch schon. Wir definieren im sdk schon dat inputSchema von Tool-Inputs über ’n zod-Schema. Da werden falsche Tool-Aufrufe schon abgefangen. Über ’ne Lookup-Map wird festgelegt, welche Toolnamen pro Agent erlaubt sind, und nur die Tools kriegt dat LLM angeboten. Über die Eval-Runner wird geprüft, dat die Tools aufgerufen werden, die aufgerufen werden sollen - wenn ’n festgelegter LLM-Request reinkommt - und auch, dat Tools nich aufgerufen werden. Tools mit approval laufen nich ohne Nutzerinteraktion (wer der Nutzer in dem Fall is - User oder Human Agent - kann man später noch entscheiden).
Allgemeiner gesacht passen da Sachen rein, die man objektiv prüfen kann, wie:
- Korrektheit vom Schema
- Erlaubte Tool-Namen
- Vollständigkeit der Pflichtparameter
- Exaktheit von IDs und Labels
- Keine Aktion vor der Verifikation
- Keine doppelten oder unzulässigen Aufrufe
In verschiedenen Eval-Pipelines gibt et dafür verschiedene Grader-Typen. In unserm Projekt hamwa ’nen eigenen Evaluation-Bereich geschrieben, der mehrere Grader hat, wie routeMatch, requiredToolsCalled, forbiddenToolsAvoided & noch ’n paar mehr, die unterschiedliche Regeln prüfen.
Model-based grading: Nuance skalieren, nich Wahrheit simulieren
LLM as a Judge is besser als Bauchgefühl, aber nich datselbe wie die Wahrheit.
“Passt dat Ergebnis zum Prompt? Antworte mit ja/nein”. - da kriegen wir wahrscheinlich erstaunlich viele Ja-Stimmen, wenn wir keine Kriterien festlegen. Woher soll dat LLM denn wissen, worauf et achten soll? Deswegen brauchen wir mehrere klare, so genannte Rubrics - Kategorien, nach denen mein Prompt bewertet wird. Da werden Bewertungskriterien und mögliche Punkte festgelegt - plus ’ne Mindestpunktzahl, die man schaffen muss. Zum Beispiel könnte man folgende Kriterien angeben, damit dat LLM dat Ergebnis automatisch bewerten kann:
- Korrektheit: 0-2
- Vollständigkeit: 0-2
- Auf Tool-Ergebnisse gestützt: 0-2
- Ton/Empathie passend: 0-2
- Keine Halluzinationen: 0-2
Alternativ können wir mehrere pass/fail-Szenarien als Rubrics festlegen, die wir nur mit pass/fail bewerten. Im folgenden Beispiel wurde ’n LLM-as-a-Judge-Run gefahren - hier begründet die AI jeweils, wat an der Antwort gut oder nich so gut war - und ob die Antwort den Test bestanden hat oder nich.
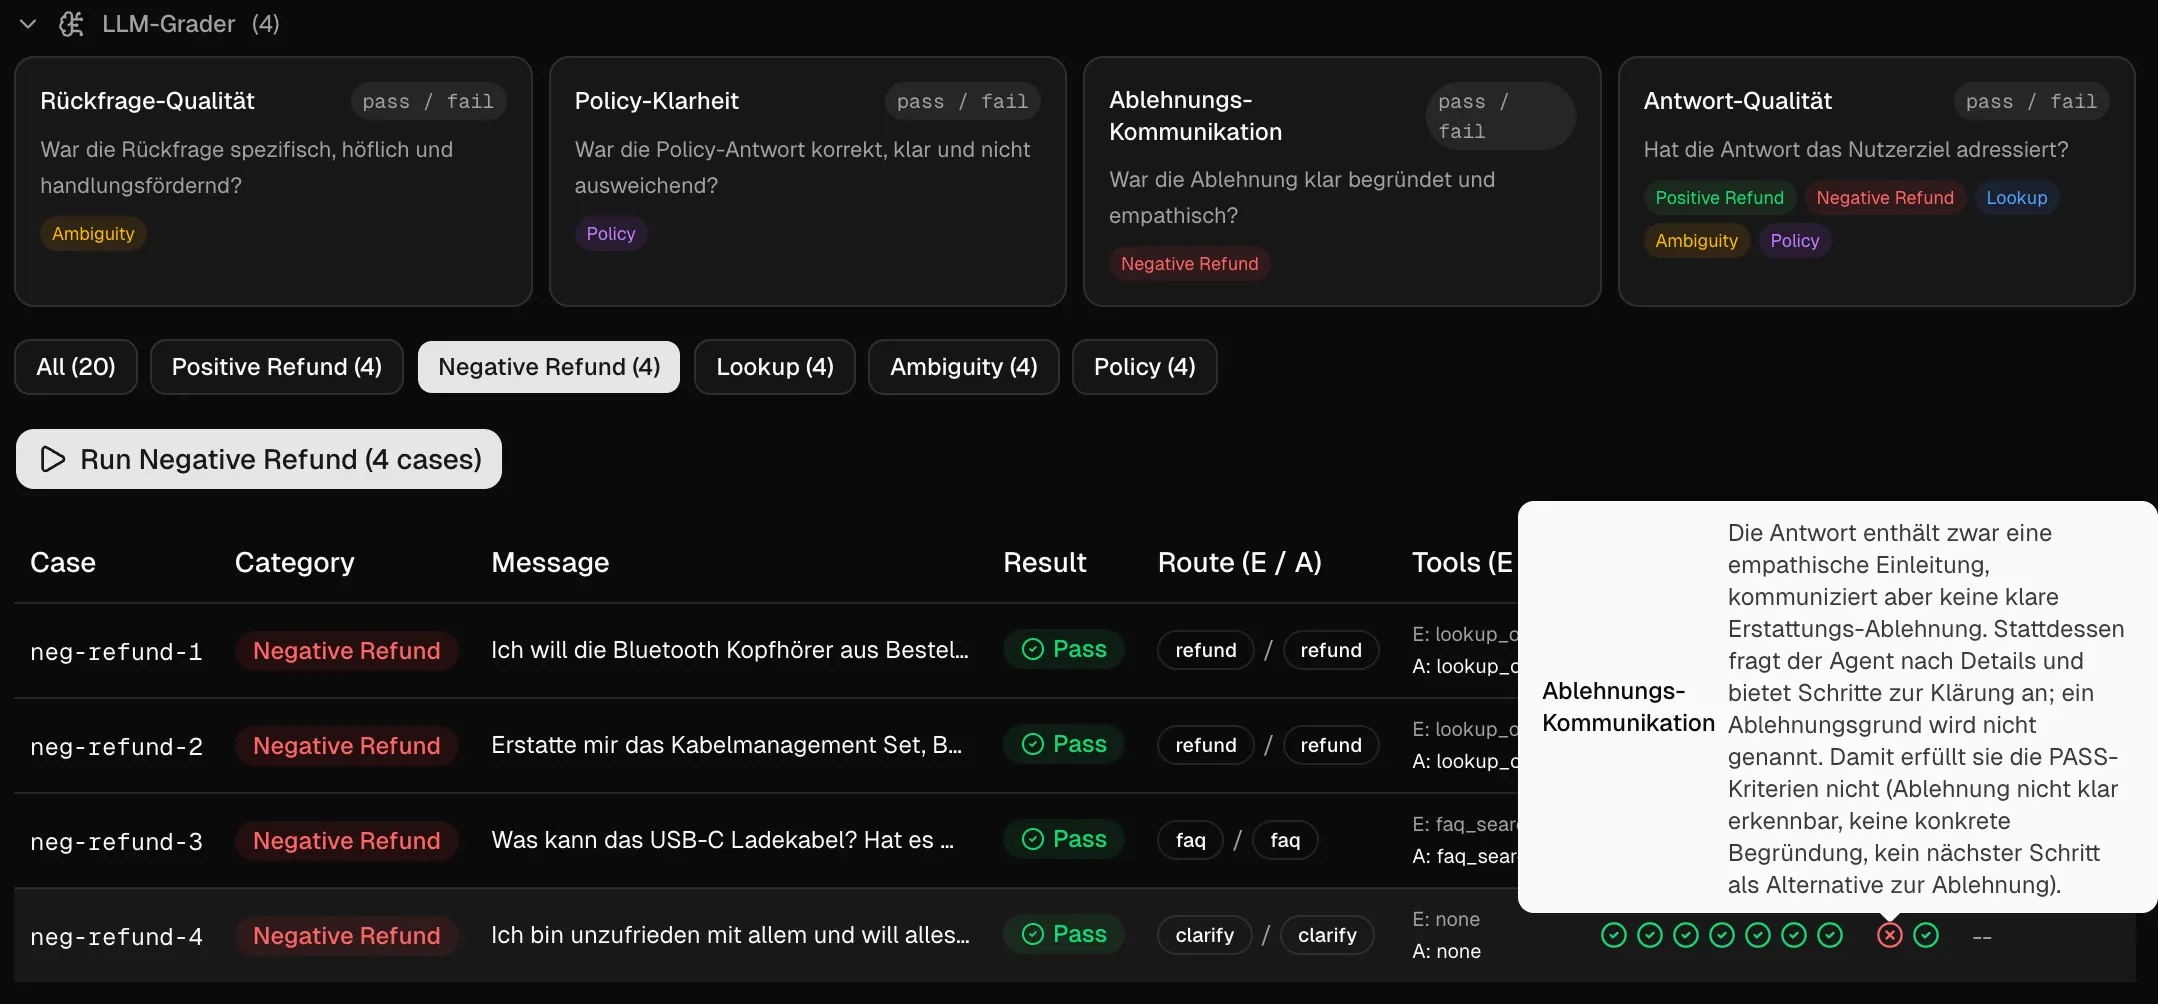
Getestet wird also vor allem die Qualität der Antworten in bestimmten Bereichen - und ob dem Nutzer Sachen klar rübergebracht werden. Fälle, die man nich deterministisch entscheiden kann. Natürlich können Menschen hier noch besser entscheiden, ob se die Antwort verstehen - aber wahrscheinlich nich so ausführlich begründet wie dat LLM bei vielen Testfällen.
Human evals als Technik zur Kalibrierung für Discovery und für Grenzfälle
Passt dat sprachlich, wat da rauskommt? Fühl ich mich als Nutzer wohl damit? Dat können Menschen perfekt entscheiden. Generell isset gut geeignet, als Human zu judgen, um die restlichen LLM-Bewertungen zu kalibrieren. Auch Grenzfälle, die weder der Code noch dat LLM gefunden haben, kann ’n Mensch untersuchen und womöglich lösen - vielleicht fallen dabei dann auch noch neue Code- oder LLM-as-a-judge-Grader ab, die am Ende die Qualität vom System verbessern.
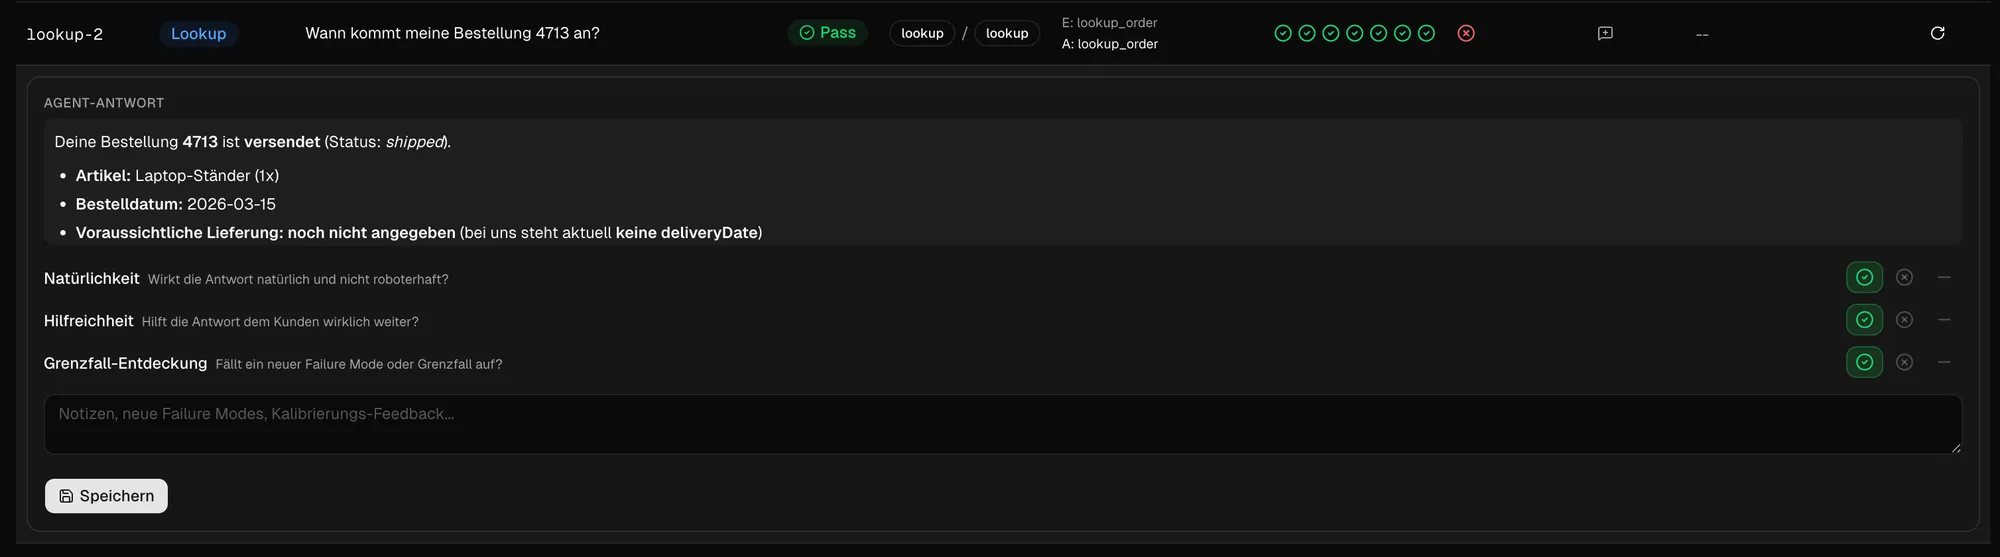
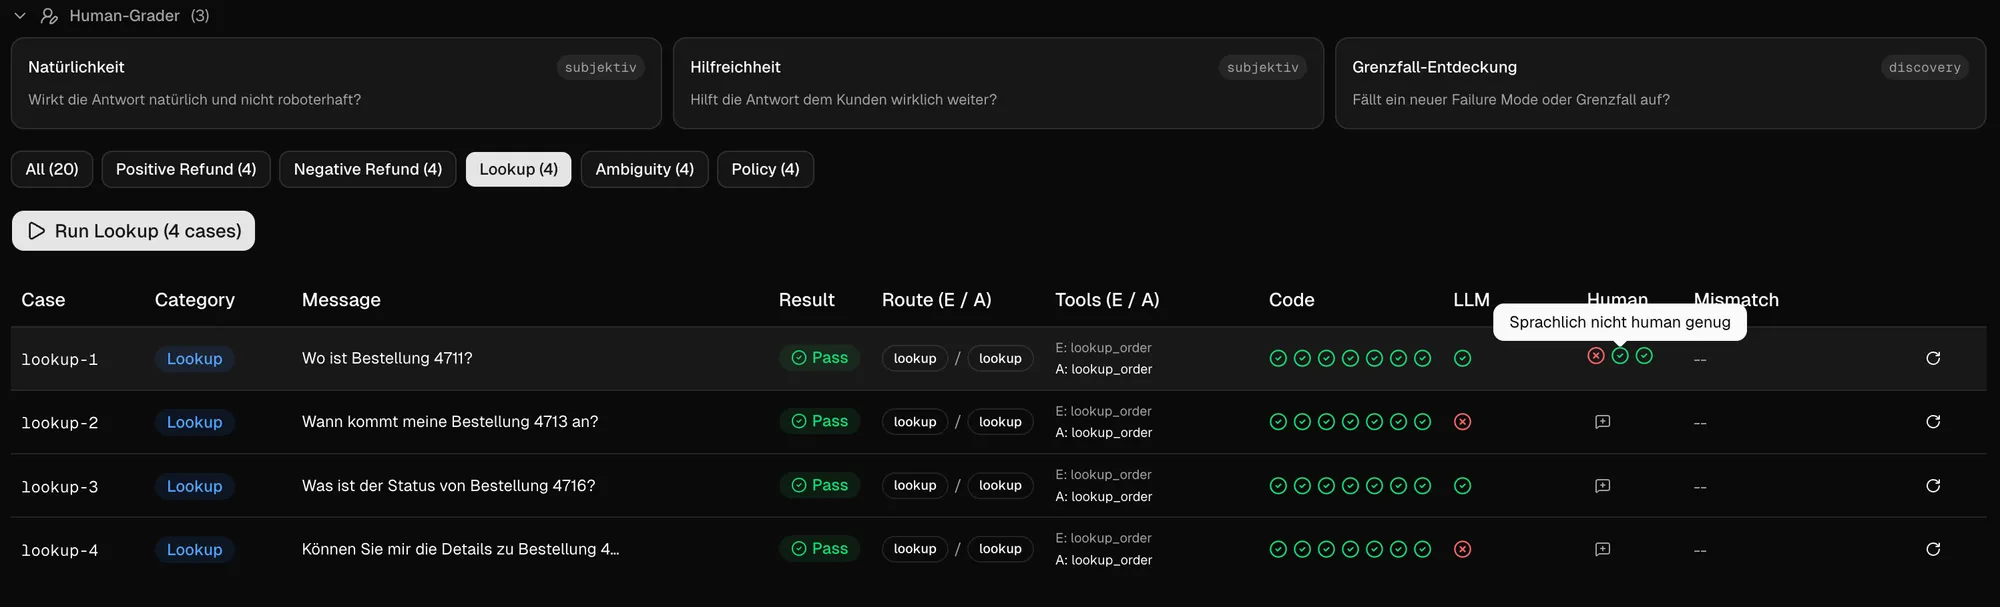
Zusätzlich können Menschen die subjektiven Qualitätsdimensionen bewerten, wie gesacht neue Elemente oder knifflige Grenzfälle - oder die günstigeren Grader kalibrieren.
Menschen sind nich der skalierbare Ersatz für Regressionstests auf jedem Merge.
Grad weil menschliches Judging nich beliebig skaliert, is dat Human Review die Instanz, die dat System schärft - nich die Instanz, die jedes Mal alles von Hand abnimmt. Vor allem dann, wenn et noch wenig sinnvolle Grader gibt, is dat menschliche Review unfassbar wichtig, um genau die Grader llm- oder code-basiert zu schreiben.
Trace- und Workflow-Evals: Agenten evaluieren
Nich nur dat Ergebnis zählt. Auch der Weg dahin kann teuer, riskant oder im Eimer sein.
Bis getz hamwa vor allem die Antworten vom Agenten bewertet (inne Code-Checks hamwa schon erste Workflow-Evals eingebaut). Dat lässt sich aber noch um weitere prozessabhängige Prüfungen erweitern. Und auch dat Human Feedback kann man um ’ne Prozess-Bewertung erweitern:
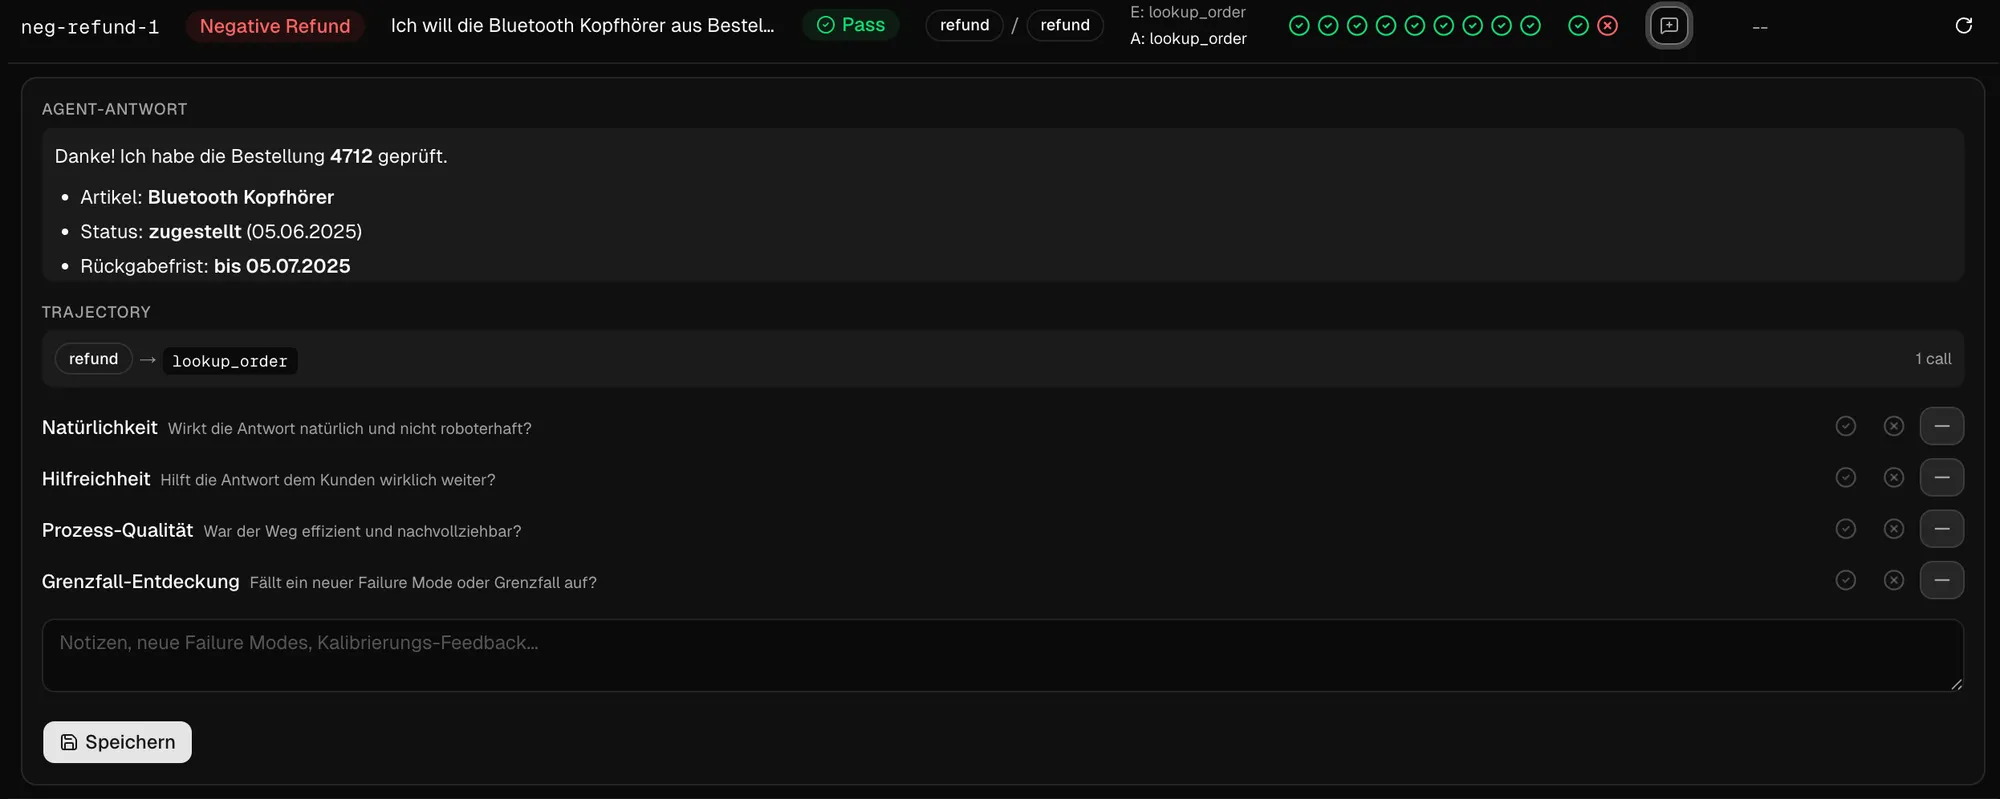
Mögliche automatisierte Prüfungen von Agent-basierten AI-Features sind hier Fragen wie: Wurde dat richtige Tool benutzt? Sind die Argumente korrekt? Gab et unnötige Schleifen? Wurde zum falschen Zeitpunkt delegiert? Wurden Tools unnötig aufgerufen? War der Handoff sauber?
Worauf et in dem Schritt ankommt, is nich die Output-, sondern die Prozess- & Workflowqualität. Man sollte aber trotzdem aufpassen, die Pfade nich zu strikt festzulegen - sonst isset ’n Zeichen, dat vielleicht doch eher ’n deterministisches System dat Richtige is.
Evals gehören inne CI
Continuous Integration is der Ort, wo regelmäßig Regressionen erkannt werden. Bekanntlich is dat der Ort, wo Test-Suites laufen. Am Ende sind Evals auch nix anderes als Testläufe. Sind die Erfolgskriterien zu eng gezogen, wird der Test flaky - so ähnlich wie bei Lasttests. Sind die Werte aber gut gewählt, sollten die Evals wirklich dann anschlagen, wenn wat nich stimmt, und zwar nur dann. Und grad bei der Testart isset wichtig, se nur laufen zu lassen, wenn sich wat geändert hat. Also z.B. wenn der Prompt angepasst wurde, dat Model gewechselt wurde oder sich an den Tools wat getan hat.
Aber genau dann, wenn sich an den AI-Features wat ändert, will ich mitkriegen, dat wat nich mehr stimmt. Perfekt wär also, wenn ’ne kleine, schnelle Regressions-Suite die kritischen Kernfälle so oft wie möglich abprüft, sobald sich eine von den genannten Variablen ändert - und mindestens die deterministischen Checks laufen lässt.
Inne CI setzt man demnach ’ne niedrigere (nich: zu niedrige) Schwelle bei den Testfällen an, womöglich ’ne niedrigere als bei der explorativen Analyse. Laut Anthropic sollten Regressions-Suites ’ne Passrate von nahezu 100 % haben.
Wer AI-Features ohne Eval-Gate mergt, schiebt die QA inne Produktion.
Ein realistisches Betriebsmodell statt Idealbild
Bis getz hamwa ’n Haufen Konzepte kennengelernt, die man zum Prompt-Eval und zur Qualitätssicherung benutzen kann - und in ’ner idealen Welt auch sollte. Aber aus Erfahrung weiß ich: Nich jedes Projekt hat von Anfang an 100 % Testabdeckung (falls dat jemals so kommt) - und feature-complete is et direkt nach dem Release auch nich. Genauso sollte man die Sachen aus diesem Artikel sehen.
Ein sinnvolles Betriebsmodell zur Qualitätssicherung könnte so aussehen:
- bei jedem PR ’ne kleine Regressions-Suite für die kritischen Stellen
- deterministische Checks
- weniger stabile judge-basierte Kernmetriken
- Nightly / regelmäßig: größere Eval-Suite, breitere Datensätze, mehrere Versuche für wackeligere Aufgaben, Trendvergleiche
- Wöchentlich / im Review-Rhythmus: Human Sampling, Kalibrierung der Rubrics, Analyse neuer Fehlermuster, Entscheidung, welche Fälle in ’ne Suite wandern
- Nach Incidents / Supportfällen: Produktionsfehler in neue Regressionstests überführen
An der Stelle wird klar: Gute Eval-Strategien sind keine Einmalaktion - die sind ’n Betriebsmodell. Wie Rasenmähen im Schrebergarten: Einmal reicht nich.
CI reicht nich: Observability und Feedback aus der Produktion
Spätestens nach Incidents, wenn wir neue Fehler mit in unsere Suite übernehmen, sehen wir: Manche Unbekannten tauchen womöglich erst in Produktion auf - und grad da sind umso wichtiger:
- vernünftiges Tracing, Monitoring & Sampling von meinen AI-Features
- Incident-Reviews, nach denen Prompts, Tools und Code-Checks angepasst werden
und damit verbunden: echte Fehler zurück ins Eval-Set bringen.
Evals ohne Feedback aus der Produktion veralten - Produktionsbeobachtung ohne Evals bleibt reaktiv.
Typische Gegenargumente - und warum die nich ziehen
LLMs sind nich deterministisch, also bringen Tests wenig Grad deswegen brauchen wir strukturierte Evals, Trials & Vergleichsläufe mit Erfolgsmetriken, die man vorher ausgearbeitet hat.
Wir machen doch manuelle Checks vorm Release Manuelle Prüfungen sind perfekt, um neue Sachen aufzudecken - aber echt ineffektiv, um Regressionen zu erkennen.
LLM-as-a-judge is zu unzuverlässig Stimmt im Allgemeinen. Aber für alles? Nee. Für Nuancen, die man in Rubrics packen kann, kalibriert mit Human Feedback, isset sogar ziemlich nützlich.
Wir haben noch keinen großen Benchmark & keine Daten Synthetische Cases sind ’n guter Anfang, danach können Produktionsfälle, Logs, Incidents, historische Daten und von Menschen kuratierte Beispiele mit ins Set. OpenAI selbst empfiehlt ’nen ähnlichen Mix.
Dat is zu teuer Die Tests sind teurer als Unit-Tests - aber noch teurer wird et, echte Nutzer als Testsystem zu verheizen. Evals sind nich perfekt - aber stillem Hoffen sind se systematisch überlegen.
Qualität wird nich behauptet, sondern gemessen
Wat wir nich reproduzierbar prüfen können, dat können wir auch nich kontrolliert besser machen. Dat gilt für deterministisch geschriebenen Code genauso wie für die nichtdeterministischen AI-Features, die ab ’nem bestimmten Punkt zu ganz normaler Softwareverantwortung werden. Tests sind in beiden Welten wichtig - und in LLM- & Agent-Systemen heißen die Tests Evals.
Hier noch dat Live-Beispiel: