
Den som leverer AI-funksjoner uten evals, har ingen engineering-prosess, bare en strategi basert på håp.
Prompting i chatten er perfekt for å utforske hva som er mulig, men så snart det skal i produksjon, holder det ikke med gode enkeltsvar. Den som deployer uten evals, skyver testingen over på ekte brukere. Jeg var kort innom dette temaet allerede i forrige innlegg, der jeg raskt tok i bruk en AI-basert evaluering. Her vil jeg se nærmere på nettopp dette aspektet og beskrive hva som betyr noe i produksjonsapplikasjoner.
Testet i chatvinduet
… er ikke testet.
Å bygge AI-funksjoner begynner ofte i chat-UI-et eller med noen prompter i en playground for utviklere. Etter noen happy path-spørsmål har vi en prompt som ved første øyekast er perfekt, og som funksjonen kan bygges rett på. Litt manuell finjustering hører vel med.
Og akkurat det er perfekt! For utforskningen, for å prøve ut om selve ideen bak funksjonen holder - for å avdekke skjulte antagelser og grove bom. Det som faller av lasset, som i mange deterministiske programvareprosjekter, er testingen. Og det er nettopp i testingen at reproduserbar kvalitetssikring begynner. Kode i produksjon som bare er testet manuelt, kommer alltid med risikoen for at man har oversett noe, særlig når det gjelder regresjoner - og nøyaktig det samme gjelder prompter som er laget under utforskning.
Kommer det en ny modell fra en leverandør om to måneder, som skal integreres med en gang fordi den virker bedre egnet, flyr vi fort i blinde hvis prompten ble til gjennom utforskning - og deretter bare ble liggende i prosjektet uten å bli testet på nytt. Men det er ikke bare en ny modell som setter i gang denne prosessen; også en (potensielt usynlig) endring i system-prompten hos modellleverandøren kan endre oppførselen til promptene våre - og AI-funksjonene våre - fra grunnen av. Uten reproduserbar evaluering flyr vi her rett og slett i blinde.
Fungerer i demoen og holder når ting endres - det er to forskjellige ting. Og det er akkurat her Continuous Evaluation (CE) kommer inn.
Der prompt engineering slutter
Så snart modelloutput blir en del av produktlogikken, holder det ikke lenger med god prompting. Da teller Contracts, evals og Observability minst like mye som selve prompten.

Fortsetter vi å iterere på en prompt, kan vi støte på grenser: Resultatet blir rett og slett ikke bedre, evalene forblir røde. Da kan det være på tide å bytte modell. For ikke alle problemer skyldes prompten - andre grunner til at ting feiler, kan være modellvalg, arkitektur, tooling, data eller arbeidsflyten.
Bedre prompting optimaliserer modellens svar, engineering stabiliserer systemet rundt.
Hvorfor ble det ikke startet noen retur i eksempelet? I eval-prosessen var svarene alltid perfekte - og verktøykallene fungerte også hver gang. Ser man nærmere på eksempelet, legger man merke til: en MCP-server? Den leverer sine egne verktøybeskrivelser - og har noe endret seg der uten at prompten passer til det lenger, kan logikken slutte å fungere - og et slikt tilfelle kan oppstå.
Når evals blir et must
Så snart ikke-determinisme kommer inn i systemet, er det lurt å kjøre evals. Ikke nødvendigvis når vi leverer AI-outputen rett til brukeren - men i hvert fall når modelloutputen påvirker produktlogikken.
Routing, tool-calls, skrive eller endre data, forberede eller hindre brukerhandlinger, inngå i en kjede av arbeidsflyter - alt dette er grunner til å kjøre evals - og de er et must for systemer av høy kvalitet.
Jo flere steder i systemet der ikke-determinisme kan slippe inn, desto større er behovet for systematiske evals. Det spenner fra single-turn (én modelloutput styrer én ting) via workflows (en rekke prompter som bygger på outputen fra den forrige) og single-agents (en agent kaller verktøy eller jobber helt til den «tror» den er ferdig) til multi-agents som kommuniserer med hverandre. Da er det i hvert fall mer enn relevant - og allerede for single-turn anbefalt - å kjøre systematiske evals.

En FAQ-bot som for eksempel henter produktkunnskap til et spørsmål via RAG og viser det til brukeren, innebærer en ganske lav risiko - mens refund-agenten beskrevet over, med tool-calls mot refund-verktøy, bærer med seg en klart høyere risiko. Sitter denne agenten i tillegg ved siden av en buying-agent som kan gjøre kjøp for meg - og styres av en orchestrator, har vi ekstremt høy kompleksitet - og de systematiske evalene blir desto viktigere.
Den som tar modelloutput inn i produktlogikken, tar på seg testansvar.
Hva som kjennetegner en brukbar eval
Det du trenger:
- Et konkret datasett
- et definert suksesskriterium
- minst én grader eller verifier
- en reproduserbar kjøring
- en sammenligning på tvers av endringer
Det er ikke bare ønsket oppførsel som bør testes - også oppførsel som ikke skal forekomme. Særlig manuelle verifiers er dyre - der lønner det seg mer med et lite, ekte og målrettet sett av caser enn med en perfekt benchmark med utrolig mange datapunkter.
Sammenlignet med human evals er automatiserte gradere (LLM-as-a-judge) mye billigere. En annen mulighet er kodebaserte gradere - og (der det er mulig) bør disse utgjøre hoveddelen av evalene - men på grunn av ikke-determinismen aldri være den eneste formen for verifisering.

For å bli i eksempelet med refund-agenten: En passende start på evalueringen er et mindre, håndterbart seed-sett bestående av:
- 4 positive refund-caser
- 4 negative refund-caser
- 4 lookup-caser
- 4 tvetydige caser
- 4 grensetilfeller som bør flagge en potensiell policy-sak
Basert på dette testsettet kan vi så sjekke om verktøykall [ikke] har skjedd, om svaret til brukeren (eller orchestratoren) er passende - om det blir stilt riktige oppfølgingsspørsmål, og så videre. Her handler det om å være kreativ innenfor forretningsreglene og formulere tester som gir mening og faktisk hjelper.
Ifølge de to store LLM-leverandørene handler det ikke om å vurdere prompter, men om å spesifisere AI-atferd slik at den blir testbar, forklarbar og mulig å automatisere. Prompt-evals er dermed ikke et sidespor, men overgangen fra «vi prøver noe» til «vi kan sikre kvaliteten og vise det».
Aller helst formulerer vi suksessdefinisjonen først - og lager prompten etterpå - omtrent som i Test Driven Development. Uten en definert suksess finnes det ikke noe grunnlag å evaluere ut fra.
Når man designer evals, må man ta hensyn til flere vurderingsdimensjoner. Anthropic nevner blant annet oppgavetroskap, konsistens, relevans, personvern, kontekstbruk, latens og kostnader; OpenAI beskriver også lignende dimensjoner. Det avgjørende er å formulere kriteriene slik at de kan etterprøves med egnede metoder: først mest mulig deterministiske, teknisk målbare suksesskriterier, så kriterier som kan vurderes med ikke-deterministiske metoder som LLM-as-a-judge, og til slutt de som krever menneskelig vurdering.
Siden outputen ikke er deterministisk, kan én enkelt kjøring fortsatt vurderes binært som bestått eller ikke bestått. Ved ustabile oppgaver eller agent-looper med svært varierende forløp holder én kjøring likevel ofte ikke for å vurdere systemets pålitelighet på en meningsfull måte. I slike tilfeller bør samme scenario kjøres flere ganger og resultatet aggregeres via passende metrikker - for eksempel med pass@k når minst ett vellykket forsøk teller, eller med en konsistensterskel når man forventer pålitelig oppførsel. Slik kan man for eksempel fastsette at et scenario må bestå i minst 9 av 10 gjentakelser. For regresjonssuiter bør pass-raten derimot ligge så nær 100 % som mulig.

En dårlig eval-score kan være et modellproblem. Den kan like gjerne være en ødelagt test.
Evaluering ved eksempel: En support-agent med verktøy
Med utgangspunkt i eksemplene vi allerede har vært innom, vil vi jobbe med et support-team. Her er et chat-grensesnitt faktisk det mest fornuftige - vi trenger riktignok ikke mye UI rundt - til gjengjeld er agenten koblet direkte til systemet vårt og kan hente informasjon om brukeren og gjøre ting på vegne av brukeren - helt konkret for eksempel kansellere produkter.
UI-et vil først og fremst inneholde debug-output for å forbedre agent-teamet. Der holder det med et chat-grensesnitt, tracing av verktøykall og routing, innebygde eval-tester, redigerbare prompter og en «backend»-tilstand for å sjekke hva som faktisk skjer med dataene.
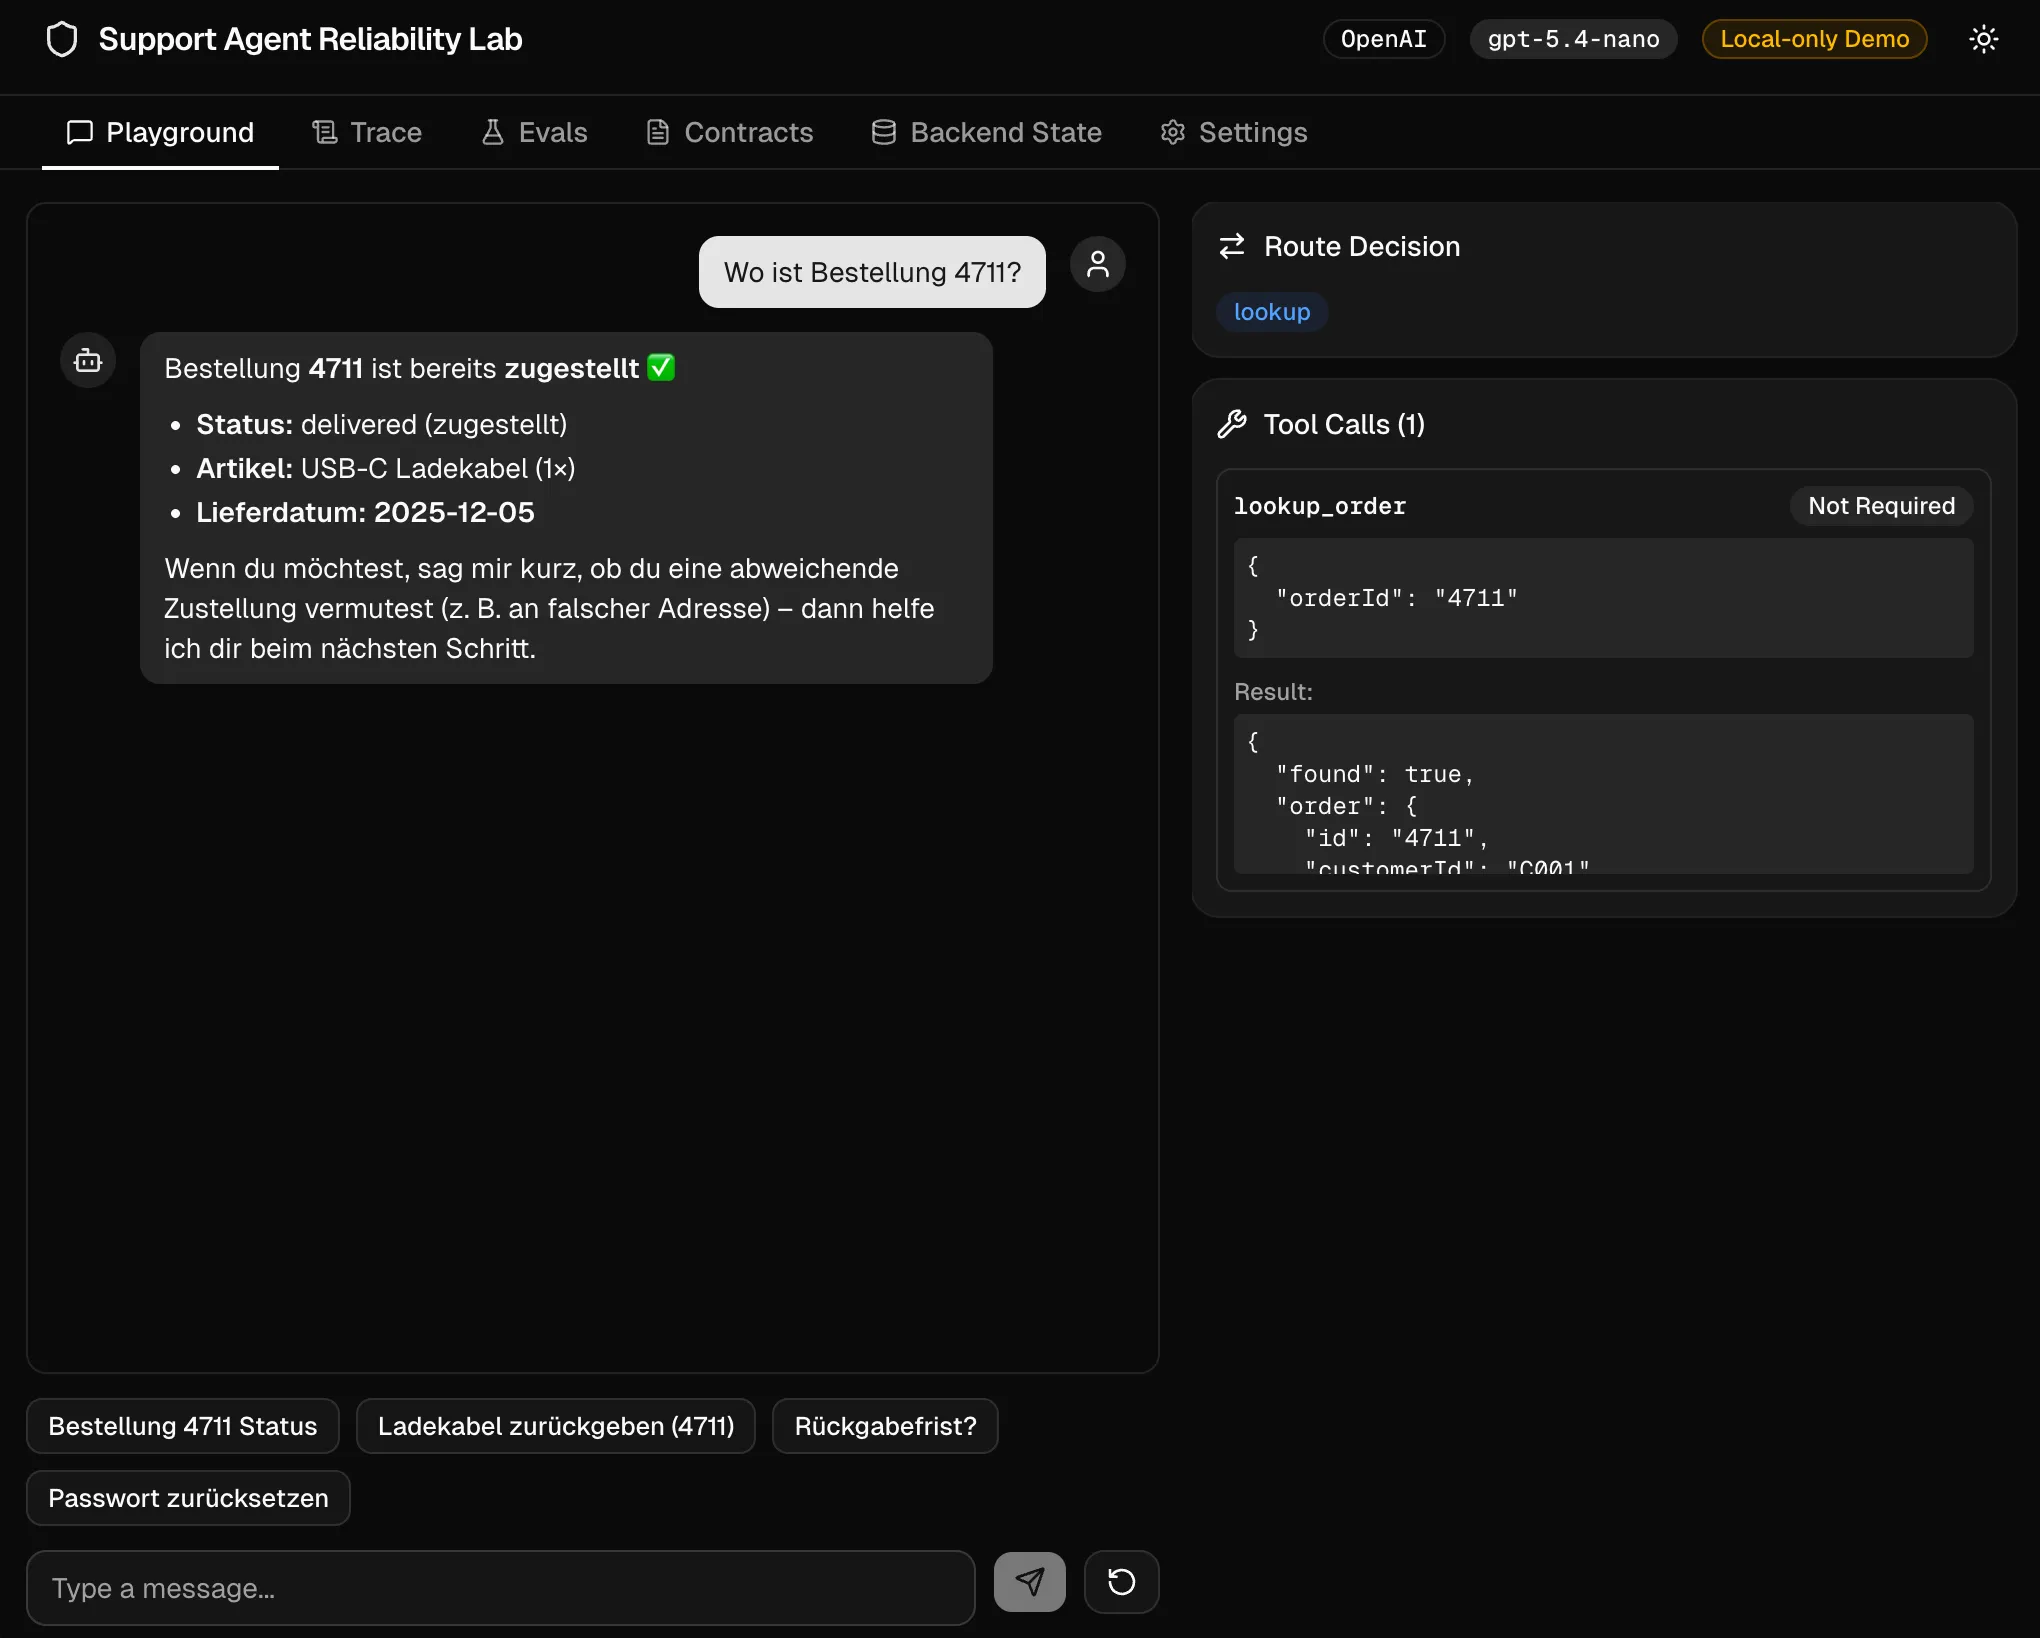
Claude var så snill å lage en applikasjon for meg som setter opp en support-agent. Etter en ganske vellykket one-shot-prompt justerte jeg noen småting - og så er vi i gang med et orkestrert team av support-agenter.
One-shot-prompt (generert av GPT 5.4 Pro)
Du er en senior fullstack TypeScript-engineer og skal bygge en lokal demo-applikasjon.
Mål Bygg en moderne webapp som egner seg for skjermbilder, til et blogginnlegg om AI-evals, verktøykontrakter, orkestrering og drift. Appen skal vise krystallklart:
«Et plausibelt svar fra assistenten er ikke noe bevis for at riktig tool-call eller en faktisk sideeffekt har funnet sted.»
Produktet er ingen ekte supportplattform, men en fokusert reliability-workbench rundt et orchestrator-/refund-agent-scenario.
Arbeidsmåte Jobb i denne rekkefølgen:
- Svært kort arkitekturoppsummering
- konkret filstruktur
- Implementering
- README
- kort liste over punkter som bevisst er utsatt
Ikke vent på brede oppfølgingsspørsmål. Ta fornuftige beslutninger og hold scopet stramt.
Streng scope-grense
- Ingen generisk AI-playground
- Ikke noe ekte auth-system
- Ingen ekte database
- Ingen ekte MCP-server
- Ikke LangChain
- Ingen herding for produksjon
- Ingen SaaS-Observability
- Ingen autonom agent-sverm
I stedet:
- lokal demo
- eksplisitte, lett etterprøvbare arbeidsflyter
- synlige tool-trajectories
- reproduserbare seed-evals
- redigerbare prompt-/tool-kontrakter
Tech stack
- Next.js App Router
- TypeScript
- Tailwind CSS
- shadcn/ui
- lucide-react
- gjeldende stabile API-er fra ai-sdk.dev
- AI SDK UI i klienten
- AI SDK Core på serveren
- zod for skjemaer
- Vitest for noen målrettede tester
Viktig arkitekturbeslutning Presenter systemet på produktnivå som «agenter», men implementer det kontrollert og eksplisitt:
- Orchestrator
- Refund Agent
- Order/Lookup Agent
- Account/FAQ Agent
Unngå et gigantisk black box-agentsystem. Jeg vil ha eksplisitte, sporbare moduler/funksjoner med tydelige kontrakter og strukturerte traces.
Produktidé Appnavn: Support Agent Reliability Lab
Appen skal demonstrere:
- Routing via en orchestrator
- spesialisert behandling av en Refund Agent
- tydelige verktøykontrakter
- Approval for destruktive handlinger
- forskjellen mellom svartekst og faktisk sideeffekt
- drift som følge av endrede verktøybeskrivelser
- liten, reproduserbar eval-suite
Local-only-regel
- API-nøkler til leverandørene lagres i nettleserens localStorage
- disse nøklene sendes per request til de lokale API-rutene
- aldri logg nøkler
- masker nøkler i UI-et
- tydelig advarsel i UI-et: “Local-only demo. Do not deploy as-is.”
Leverandørstøtte
- OpenAI
- Anthropic
Innstillingene skal gjøre det mulig å:
- velge leverandør
- skrive inn modell-ID
- skrive inn API-nøkkel
- vise om en nøkkel finnes
- slette alle lokale data
Sentrale produktskjermer Bygg en moderne layout med header + faner.
Faner:
- Playground
- Trace
- Evals
- Contracts
- Backend State
- Settings
Promptene til teamet kan tilpasses fullt ut. Selve teamet består av:
- Orchestrator (orkestrerer ut til de enkelte agentene)
- Refund Agent (kjenner reglene og verktøyene for refusjoner)
- Lookup Agent (tar seg av henvendelser om ordrestatus og sporing)
- Account & FAQ Agent (tilbakestilling av passord og spørsmål om policy)
Relevante verktøy er her: lookup_order(order_id), refund_order(order_id, reason), reset_password(account_id), faq_search(query) og verifyCustomer(account_id, email). I den genererte applikasjonen kan også de enkelte verktøybeskrivelsene tilpasses, slik at vi kan evaluere andre prompter også her og få bedre resultater.
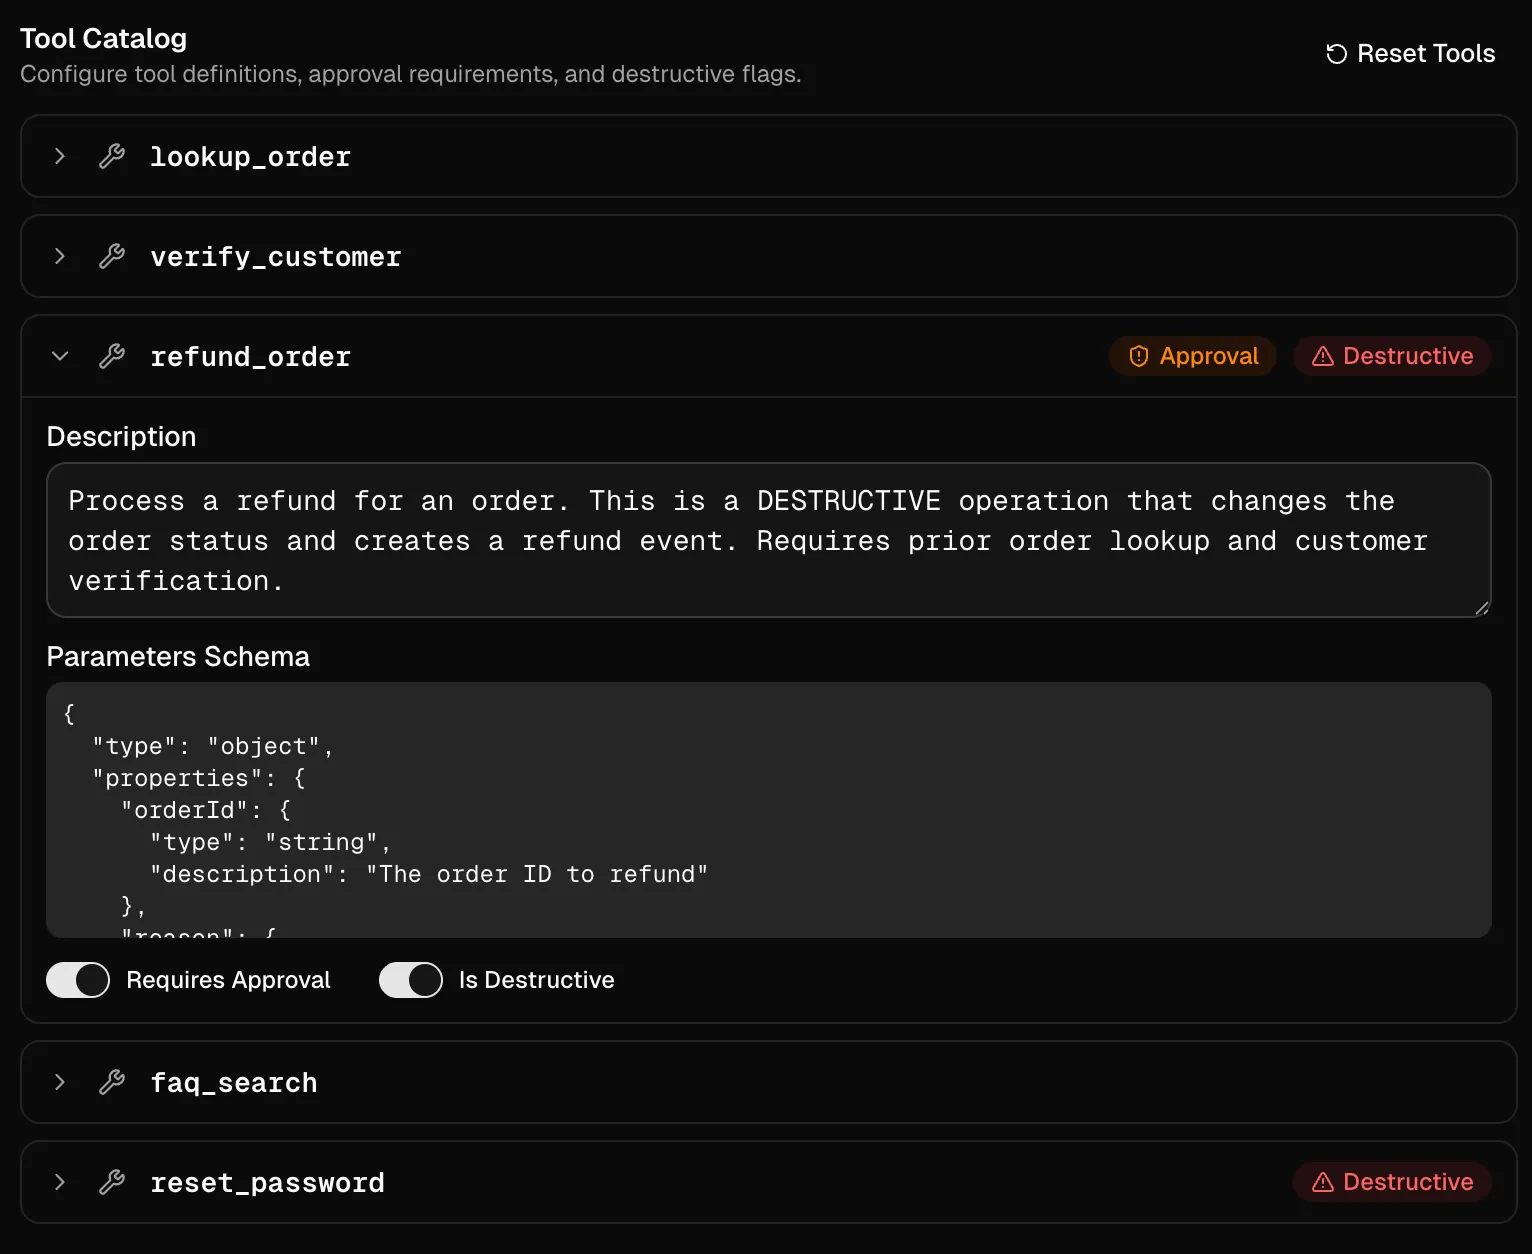
Kontrakt og Definition of Done for systemet
For å implementere evalene bør vi være bevisste på suksesskriteriene. I vårt eksempel betyr det å svare på disse spørsmålene:
Når kan en refusjon utløses?
Når alle betingelser er oppfylt:
- Identitet verifisert:
verify_customermå lykkes - Ordren finnes:
lookup_ordermå lykkes order.isRefundable === trueorder.refundedAt === nullorder.status !== 'refunded'- Brukergodkjenning: Arbeidsflyten bør pause og vente på eksplisitt bekreftelse
Når må agenten likevel spørre?
Orchestratoren router til clarify-ruten når henvendelsen er tvetydig eller mangler nøkkelinformasjon - den bør altså vite hvordan verktøyene kalles, uten å kunne kalle dem.
Når kan den bare gi FAQ-svar?
Ruten faq velges bare ved generelle policy-spørsmål som ikke har noe med refusjon, ordreoppslag eller kontoadministrasjon å gjøre. Der finnes et faq_search-verktøy som kan brukes til å besvare spørsmål fra FAQ-en.
Når er det greit å tilbakestille passord?
Når kundens e-postadresse er kjent - handlingene blir auditert og utført av account-agenten.
Hvilke svar ville vært feil faglig eller sikkerhetsmessig?
- Refusjon uten
lookup_order - Refusjon uten identitetssjekk
- Refusjon ved
isRefundable: false - Dobbel refusjon
- «False Success» - agenten påstår at refusjonen er gjort, men verktøyet blir aldri kalt
- Brudd på verktøyisolasjonen - FAQ-agenten kaller
refund_order - Tilbakestilling av passord uten e-post
Uten å kjenne kontrakten kan vi altså ikke formulere gode evals - og nå kjenner vi kontrakten til support-teamet. Særlig ut fra de siste punktene kan vi navngi ganske tydelige, målbare suksesskriterier - vår «Definition of Done».
Den minste eval-miksen som gir mening
Kodebaserte sjekker: Det som kan etterprøves objektivt, hører hjemme i koden
Alt som kan sjekkes deterministisk, bør også sjekkes deterministisk. For den som lar harde regler bli myke, bygger inn unødvendig ustabilitet.
Regler som allerede finnes i appen, bør også gjenspeiles i appen. Og i den aktuelle applikasjonen skjer akkurat det allerede. Vi definerer allerede i SDK-et inputSchema for verktøyinput via et zod-skjema. Der blir feilaktige verktøykall fanget opp. Via et lookup-map defineres tillatte verktøynavn per agent, og bare disse verktøyene tilbys LLM-en. Eval-runnerne sjekker at verktøyene som skal kalles, faktisk blir kalt når en definert LLM-request kommer inn - og også at verktøy ikke blir kalt. Verktøy med approval blir ikke utført uten brukerinteraksjon (hvem brukeren er i det tilfellet - sluttbruker eller human agent - kan avgjøres senere).
Mer generelt passer det her inn elementer som kan sjekkes objektivt, som:
- Korrekt skjema
- Tillatte verktøynavn
- Fullstendige obligatoriske parametere
- Eksakte ID-er og labels
- Ingen handling før verifisering
- Ingen doble eller ugyldige kall
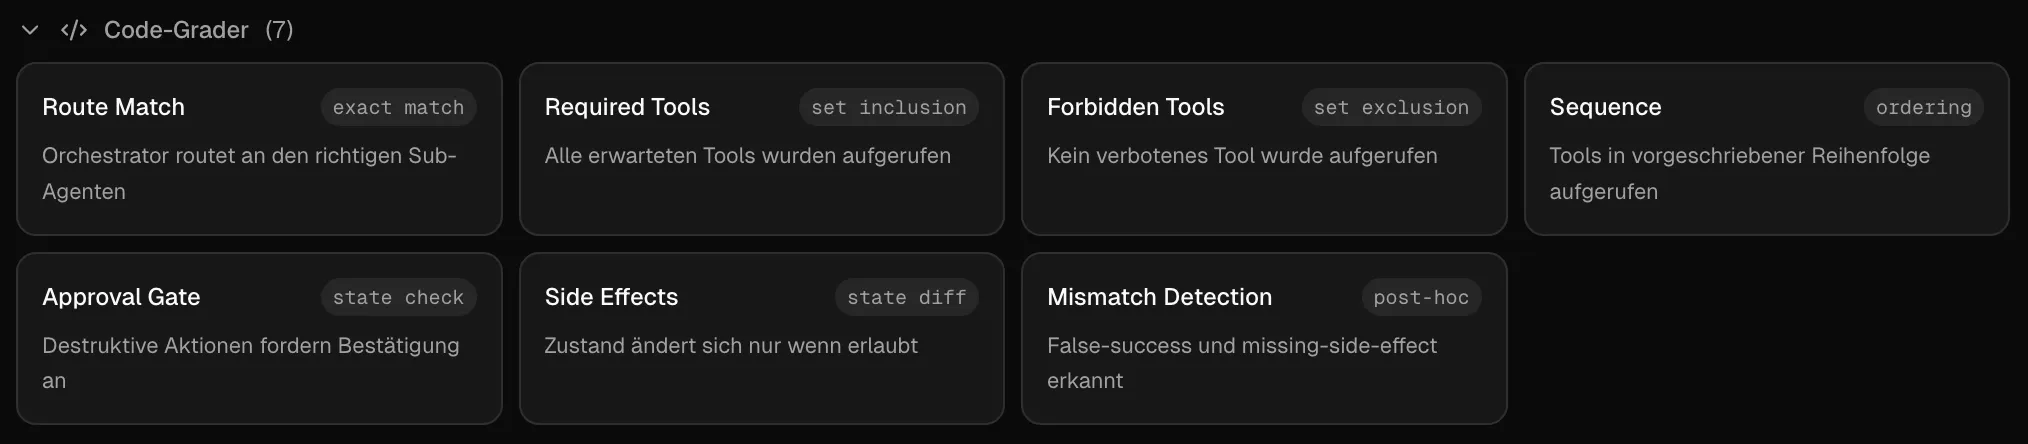
I ulike eval-pipelines finnes det ulike grader-typer for dette. I prosjektet vårt har vi skrevet et eget evalueringsområde med flere gradere, som routeMatch, requiredToolsCalled, forbiddenToolsAvoided og noen flere, som sjekker ulike regler.
Modellbasert grading: Skaler nyanser, ikke simuler sannhet
LLM-as-a-judge er bedre enn magefølelse, men ikke det samme som sannheten.
«Passer resultatet til prompten? Svar med ja/nei.» - da får vi sannsynligvis forbløffende mange ja-stemmer hvis vi ikke definerer kriterier. Hvordan skulle LLM-en vite hva den skal se etter? Derfor trenger vi flere tydelige såkalte rubrics - kategorier for å vurdere prompten min. Her defineres vurderingskriterier og mulige poeng - og en minstepoengsum som må nås. For eksempel kan følgende kriterier oppgis, slik at LLM-en kan vurdere resultatet automatisk:
- Korrekthet: 0-2
- Fullstendighet: 0-2
- Støttet av verktøyresultater: 0-2
- Passende tone/empati: 0-2
- Ingen hallusinasjoner: 0-2
Alternativt kan vi definere flere pass/fail-scenarioer som rubrics, som vi bare vurderer med pass/fail. I eksempelet under ble det gjort en LLM-as-a-judge-kjøring - her begrunner AI-en hver gang hva som var bra eller ikke bra med svaret - og om svaret besto testen eller ikke.
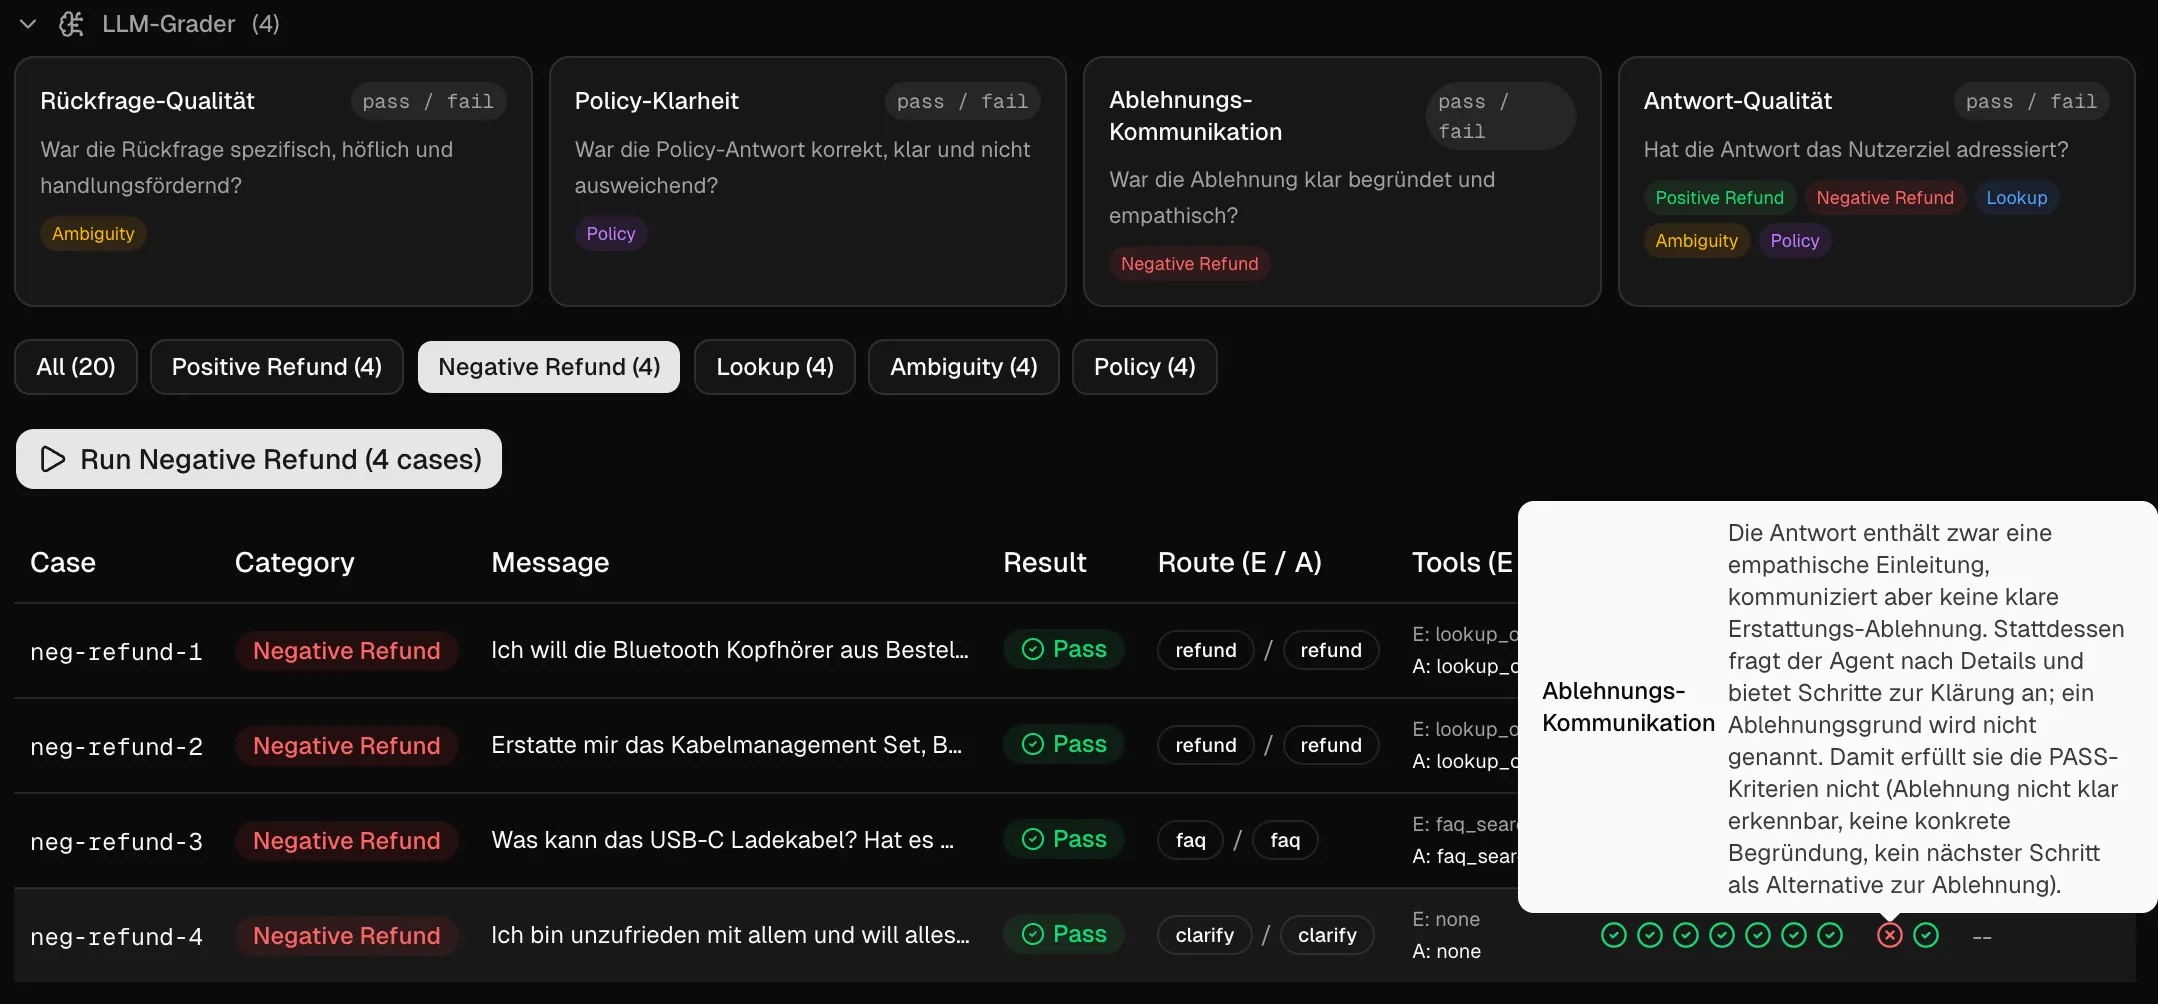
Det som testes, er altså først og fremst kvaliteten på svarene innenfor bestemte områder - og om ting blir kommunisert tydelig til brukeren. Tilfeller som ikke kan avgjøres deterministisk. Mennesker kan selvsagt avgjøre enda bedre om de forstår svaret - men neppe med like grundige begrunnelser som LLM-en over mange testcaser.
Human evals som teknikk for kalibrering, for discovery og for grensetilfeller
Sitter språket i det som kommer ut? Føler jeg meg komfortabel med det som bruker? Det er perfekt for mennesker å avgjøre. Generelt egner menneskelig judging seg godt til å kalibrere resten av LLM-vurderingene. Også grensetilfeller som verken koden eller LLM-en har funnet, kan et menneske undersøke og potensielt løse - og kanskje faller det da ut nye kode- eller LLM-as-a-judge-gradere som til syvende og sist forbedrer kvaliteten på systemet.
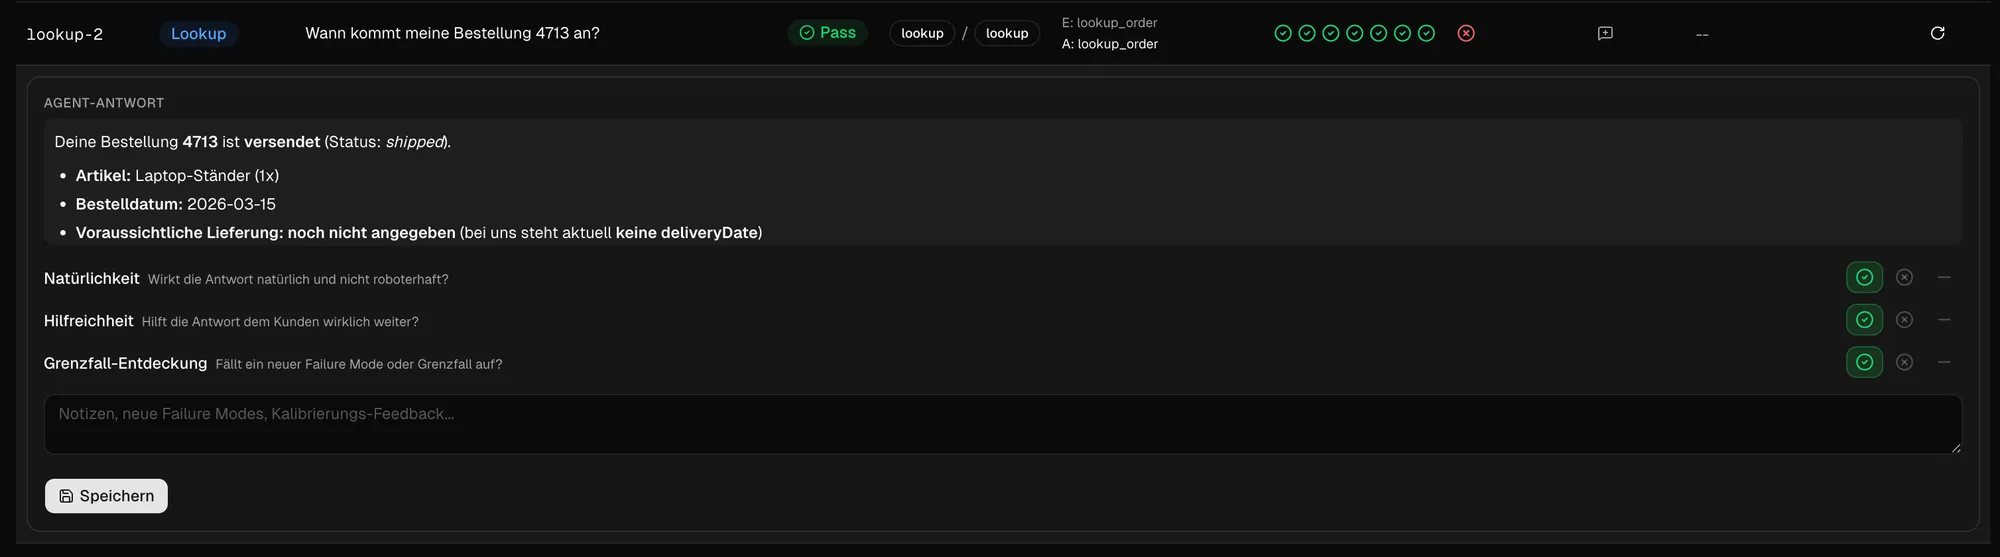
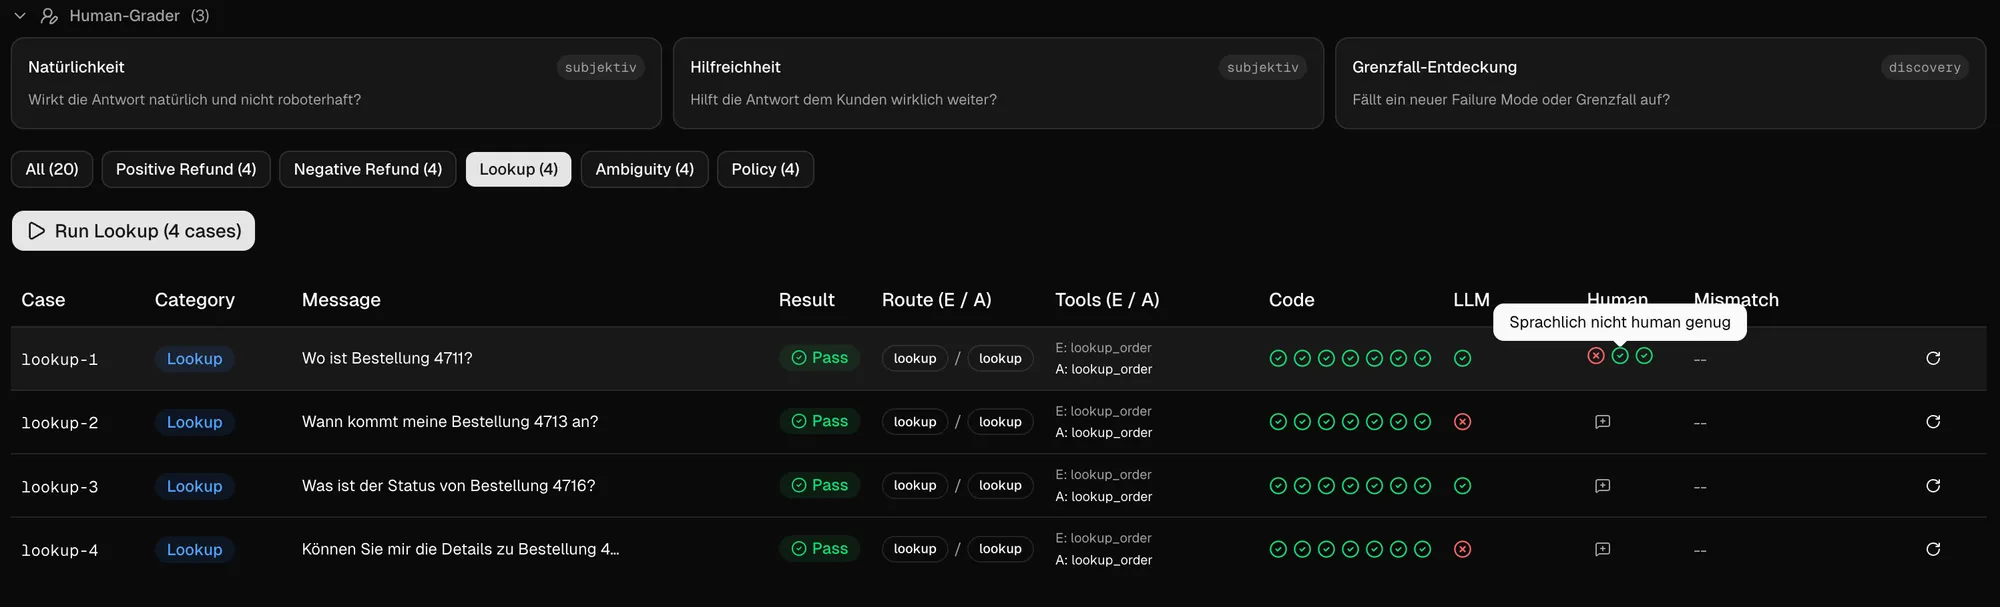
Mennesker kan i tillegg vurdere de subjektive kvalitetsdimensjonene, som nevnt nye elementer eller vanskelige grensetilfeller - eller kalibreringen av de billigere graderne.
Mennesker er ikke den skalerbare erstatningen for regresjonstester på hver merge.
Nettopp fordi menneskelig judging ikke skalerer i det uendelige, er human review den instansen som skjerper systemet - ikke den som manuelt godkjenner alt hver eneste gang. Særlig når det ennå finnes få gradere som gir mening, er menneskelig review utrolig viktig for å kunne skrive nettopp disse graderne, LLM- eller kodebasert.
Trace- og workflow-evals: Å evaluere agenter
Det er ikke bare resultatet som teller. Også veien dit kan være dyr, risikabel eller ødelagt.
Så langt har vi først og fremst vurdert svarene fra agenten (i kodesjekkene har vi allerede bygget inn de første workflow-evalene). Men dette kan utvides med flere prosessavhengige sjekker. Og også den menneskelige tilbakemeldingen kan utvides med en vurdering av prosessen:
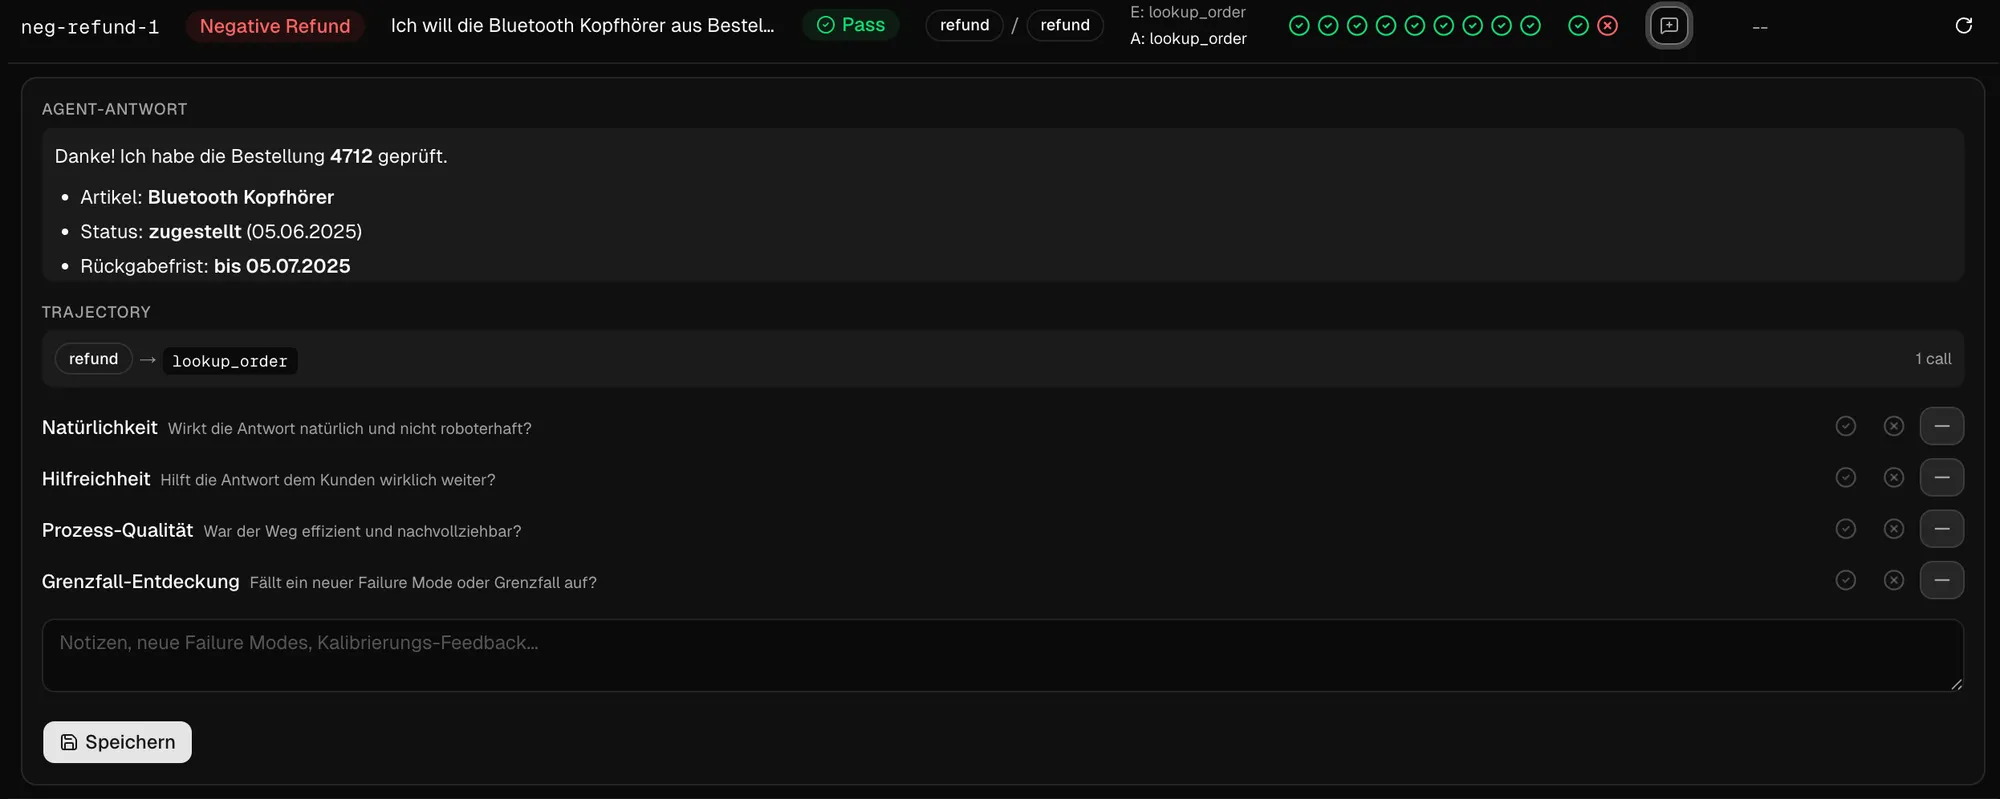
Mulige automatiserte sjekker av agent-baserte AI-funksjoner er her spørsmål som: Ble riktig verktøy brukt? Er argumentene korrekte? Var det unødvendige looper? Ble det delegert på feil tidspunkt? Ble verktøy kalt unødvendig? Var handoffen ryddig?
Det som teller i dette steget, er ikke kvaliteten på outputen, men på prosessen og arbeidsflyten. Man bør likevel passe på å ikke definere stiene for strengt - ellers er det et tegn på at et deterministisk system kanskje er det riktige likevel.
Evals hører hjemme i CI
Continuous Integration er stedet der regelmessig oppdagelse av regresjoner skjer. Som kjent er det der testsuitene kjøres. Til syvende og sist er evals heller ikke noe annet enn testkjøringer. Er suksesskriteriene for snevre, blir testen flaky - omtrent som med lasttester. Er verdiene derimot godt valgt, bør evalene virkelig bare slå ut når noe faktisk er galt. Og nettopp for denne typen tester er det viktig å bare kjøre dem når noe har endret seg. Altså for eksempel når prompten er justert, modellen er byttet eller noe er endret i verktøyene.
Men akkurat når noe endrer seg i AI-funksjonene, vil jeg få med meg at noe ikke stemmer lenger. Det perfekte ville altså vært at en liten, rask regresjonssuite sjekker de kritiske kjernecasene så ofte som mulig ved endringer i en av variablene beskrevet over - og at de deterministiske sjekkene i det minste kjøres.
I CI bør man derfor sette en lavere (ikke: for lav) terskel for testcasene, potensielt lavere enn ved den utforskende analysen. Ifølge Anthropic bør regresjonssuiter ha en pass-rate på nesten 100 %.
Den som merger AI-funksjoner uten eval-gate, flytter QA ut i produksjon.
En realistisk driftsmodell i stedet for et idealbilde
Så langt har vi blitt kjent med mange konsepter som kan brukes til prompt-evals og kvalitetssikring - og som i en ideell verden burde brukes. Men av erfaring vet jeg: Ikke alle prosjekter har 100 % testdekning fra start (om det noen gang skulle skje) - og de er heller ikke feature-complete rett etter release. Aspektene i denne artikkelen bør ses på samme måte.
En fornuftig driftsmodell for kvalitetssikring kunne sett slik ut:
- ved hver PR en liten regresjonssuite for de kritiske punktene
- deterministiske sjekker
- mindre stabile judge-baserte kjernemetrikker
- Nightly / jevnlig: større eval-suite, bredere datasett, flere forsøk for mer ustabile oppgaver, trendsammenligninger
- Ukentlig / i review-rytmen: human sampling, kalibrering av rubrics, analyse av nye feilmønstre, beslutning om hvilke caser som skal inn i en suite
- Etter incidents / supportsaker: gjøre produksjonsfeil om til nye regresjonstester
Her blir det tydelig: Gode eval-strategier er ingen engangsjobb - de er en driftsmodell.
CI holder ikke: Observability og tilbakemeldinger fra produksjon
I hvert fall etter incidents, når vi tar nye feil med inn i suiten vår, ser vi det: Noen ukjente dukker potensielt først opp i produksjon - og nettopp her blir det desto viktigere med:
- ordentlig tracing, monitorering og sampling av AI-funksjonene mine
- incident-reviews med justering av prompter, verktøy og kodesjekker
og, knyttet til dette, å føre ekte feil tilbake inn i eval-settet.
Evals uten tilbakemeldinger fra produksjon blir utdaterte - produksjonsovervåking uten evals forblir reaktiv.
Typiske motargumenter - og hvorfor de ikke holder
LLM-er er ikke deterministiske, så tester gir lite Nettopp derfor trenger vi strukturerte evals, trials og sammenligningskjøringer med suksessmetrikker som er utarbeidet på forhånd.
Vi gjør jo manuelle sjekker før release Manuelle sjekker er perfekte for å avdekke nye ting - men virkelig ineffektive for å oppdage regresjoner.
LLM-as-a-judge er for upålitelig Stemmer generelt. Men for alt? Nei. For nyanser som lar seg fange i rubrics, kalibrert med menneskelig tilbakemelding, er det faktisk ganske nyttig.
Vi har ingen stor benchmark ennå og mangler data Syntetiske caser er en god start; deretter kan produksjonscaser, logger, incidents, historiske data og eksempler kuratert av mennesker komme med i settet. OpenAI anbefaler selv en lignende miks.
Det er for dyrt Testene er dyrere enn unit-tester - men det blir enda dyrere å bruke ekte brukere som testsystem. Evals er ikke perfekte - men de er systematisk overlegne det å håpe i det stille.
Kvalitet blir ikke påstått, men målt
Det vi ikke kan sjekke reproduserbart, kan vi ikke forbedre på en kontrollert måte. Det gjelder deterministisk skrevet kode like mye som de ikke-deterministiske AI-funksjonene, som fra et visst punkt blir vanlig programvareansvar. Tester er viktige i begge verdener - og i LLM- og agent-systemer heter disse testene evals.
Her er live-eksempelet: