
Wie AI-features zonder evals uitlevert, heeft geen engineeringproces, maar een hoopmodel.
Prompting in de chat is perfect om de mogelijkheden te verkennen, maar zodra het naar productie gaat, volstaan goede losse antwoorden niet meer. Wie zonder evals deployt, schuift het testen door naar echte gebruikers. Ik heb dit onderwerp al kort aangestipt in mijn vorige post, waar ik snel een AI-gebaseerde evaluatie gebruikte. Hier wil ik precies dat aspect uitgebreider belichten en beschrijven waar het in productietoepassingen om draait.
Getest in het chatvenster
… is niet getest.
Het bouwen van AI-features begint vaak in de chat-UI of met een paar prompts in de playground voor developers. Na een paar happy-path-vragen hebben we een prompt die er op het eerste gezicht perfect uitziet en waarmee de feature direct gebouwd kan worden. Natuurlijk hoort er waarschijnlijk wat handmatig bijstellen bij.
En precies dat is perfect! Voor exploratie, om uit te proberen of het eigenlijke idee achter de feature werkt - om verborgen aannames en grove missers bloot te leggen. Wat er, net als in veel deterministische softwareprojecten, bij inschiet, is het testen. En juist bij het testen begint de reproduceerbare kwaliteitsborging. Code die uitsluitend handmatig getest in productie staat, brengt altijd het risico mee dat je iets over het hoofd hebt gezien, vooral bij regressies - en precies hetzelfde geldt voor prompts die tijdens exploratie zijn ontstaan.
Komt er over twee maanden een nieuw model van een aanbieder uit dat meteen geïntegreerd moet worden omdat het beter geschikt lijkt, dan vliegen we al snel blind als we de prompt via exploratie hebben gemaakt - en hem daarna gewoon in het project laten liggen zonder opnieuw te testen. Maar niet alleen een nieuw model zet dit proces in gang: ook een (mogelijk onzichtbare) wijziging aan de system prompt van de modelaanbieder kan het gedrag van onze prompts - en AI-features - fundamenteel veranderen. Zonder reproduceerbare evaluatie vliegen we hier echt blind.
Werkt in de demo en houdt stand bij wijzigingen - dat zijn twee verschillende dingen. En precies daar komt continuous evaluation (CE) in beeld.
Waar prompt engineering ophoudt
Zodra modeloutput deel wordt van de productlogica, volstaat goed prompten niet meer. Dan tellen contracts, evals en observability minstens zo zwaar als de prompt zelf.

Blijven we itereren op een prompt, dan lopen we mogelijk tegen grenzen aan: het resultaat wordt gewoon niet beter, de evals blijven rood. Het kan tijd zijn om het model te wisselen. Want niet elk probleem ligt aan de prompt - andere redenen voor missers zijn modelkeuze, architectuur, tooling, data of ook de workflow.
Beter prompten optimaliseert de antwoorden van het model, engineering stabiliseert het systeem eromheen.
Waardoor is er in dit voorbeeld geen retour in gang gezet? In het eval-proces waren de antwoorden altijd perfect - en ook de tool-calls werkten altijd. Kijk je naar het voorbeeld, dan valt op: een MCP-server? Die levert zijn toolbeschrijvingen zelf aan - en als daar iets veranderd is en de prompt er niet meer bij past, kan de logica niet meer werken - en kan precies zo’n geval optreden.
Vanaf wanneer evals verplicht worden
Zodra er non-determinisme in het systeem komt, is het een goed idee om evals te draaien. Niet per se als we de AI-output direct aan de gebruiker tonen - maar zeker wel zodra de modeloutput de productlogica beïnvloedt.
Routing, tool-calls, data schrijven of wijzigen, gebruikersacties voorbereiden of tegenhouden, deel van een workflowketen - dat zijn allemaal redenen om evals te draaien - en voor systemen van hoge kwaliteit zijn ze verplicht.
Hoe meer plekken voor non-determinisme er in het systeem zijn, hoe groter de behoefte aan systematische evals. Dat loopt van single-turn (één modeloutput stuurt één ding) via workflows (een reeks prompts die voortbouwen op de output van de vorige) en single-agents (een agent roept tools aan of werkt door tot hij “denkt” klaar te zijn) tot multi-agents die met elkaar communiceren. Uiterlijk daar is het meer dan relevant - en al bij single-turns aan te raden - om systematische evals te draaien.

Een FAQ-bot die bijvoorbeeld via RAG productkennis bij een vraag ophaalt en aan de gebruiker teruggeeft, brengt eerder een laag risico mee - terwijl de hierboven beschreven refund-agent met tool-calls naar refund-tools een duidelijk hoger risico meebrengt. Zit die agent dan ook nog naast een buying-agent die voor mij aankopen kan doen - en wordt het geheel beheerd door een orchestrator, dan hebben we een extreem hoge complexiteit - en worden systematische evals des te belangrijker.
Wie modeloutput in productlogica overneemt, neemt testverantwoordelijkheid over.
Wat een bruikbare eval kenmerkt
Nodig zijn:
- Een concrete dataset
- een gedefinieerd succescriterium
- minstens één grader of verifier
- een reproduceerbare run
- een vergelijking over wijzigingen heen
Niet alleen positief gedrag moet getest worden - ook wanneer bepaald gedrag niet mag optreden. Vooral handmatige verifiers zijn duur - daar loont een kleine, echte, gerichte set cases meer dan een perfecte benchmark met ongelooflijk veel datapunten.
In vergelijking met human evals zijn automatisch beoordelende graders (llm-as-a-judge) veel goedkoper. Een andere mogelijkheid zijn code-based grades - en (waar mogelijk) zouden die het grootste deel van de evals moeten vormen - maar door het non-determinisme nooit de enige vorm van verificatie.

Om bij het voorbeeld van de refund-agent te blijven: een geschikte start voor de evaluatie is een kleinere, behapbare seed-set, bestaande uit:
- 4 positieve refund-cases
- 4 negatieve refund-cases
- 4 lookup-cases
- 4 ambiguïteitscases
- 4 grensgevallen die een mogelijk policy-geval zouden moeten melden
Op basis van deze testset kan vervolgens gecontroleerd worden of tool-calls [niet] hebben plaatsgevonden, of de response aan de gebruiker (of orchestrator) passend is - of er correct om verduidelijking wordt gevraagd, enzovoort. Op dit punt komt het aan op creativiteit binnen de businessregels om zinvolle en behulpzame tests te formuleren.
Volgens de twee grote LLM-aanbieders gaat het er niet om prompts te beoordelen, maar om AI-gedrag zo te specificeren dat het testbaar, uitlegbaar en automatiseerbaar wordt. Prompt-evals zijn daarbij geen bijzaak, maar de overgang van “we proberen iets uit” naar “we kunnen kwaliteit zichtbaar borgen”.
In het beste geval formuleer je eerst de definitie van succes - en werk je pas daarna een prompt uit - vergelijkbaar met test-driven development. Zonder gedefinieerd succes valt er op geen enkele basis te evalueren.
Bij het ontwerpen van evals moet je rekening houden met meerdere beoordelingsdimensies. Anthropic noemt onder meer taakgetrouwheid, consistentie, relevantie, privacy, contextgebruik, latency en kosten; ook OpenAI beschrijft vergelijkbare dimensies. Doorslaggevend is daarbij dat je de criteria zo formuleert dat ze met geschikte methoden te controleren zijn: eerst zo deterministisch mogelijke, technisch meetbare succescriteria, daarna criteria die zich met niet-deterministische methoden zoals LLMs as a judge laten beoordelen, en tot slot criteria die een menselijk oordeel vereisen.
Omdat de outputs niet deterministisch zijn, kan een enkele run nog steeds binair als geslaagd of niet geslaagd worden beoordeeld. Bij instabiele taken of agent-loops met een sterk wisselend verloop is één run echter vaak niet genoeg om de betrouwbaarheid van het systeem zinnig te beoordelen. In zulke gevallen moet hetzelfde scenario meerdere keren worden uitgevoerd en het resultaat via geschikte metrics worden geaggregeerd - bijvoorbeeld met pass@k, als minstens één geslaagde poging telt, of via een consistentiedrempel, als betrouwbaar gedrag wordt verwacht. Zo kun je bijvoorbeeld vastleggen dat een scenario in minstens 9 van de 10 herhalingen moet slagen. Voor regressiesuites moet de passrate daarentegen zo dicht mogelijk bij 100 % liggen.

Een slechte eval-score kan een modelprobleem zijn. Maar het kan net zo goed een kapotte test zijn.
Evaluation by example: een support-agent met tools
Op basis van de voorbeelden die hierboven al zijn aangestipt, willen we met een supportteam werken. Op deze plek is een chatinterface eigenlijk het zinnigst - we hebben er niet veel UI omheen nodig - maar de agent is wel direct aan ons systeem gekoppeld en kan informatie over de gebruiker ophalen en dingen namens de gebruiker doen - concreet bijvoorbeeld producten annuleren.
De UI bevat vooral debug-output om het agent-team te verbeteren. Daar volstaat een chatinterface, tracing van de tool-calls en routings, ingebouwde eval-tests, bewerkbare prompts en een “backend”-state om te controleren wat er precies met de data gebeurt.
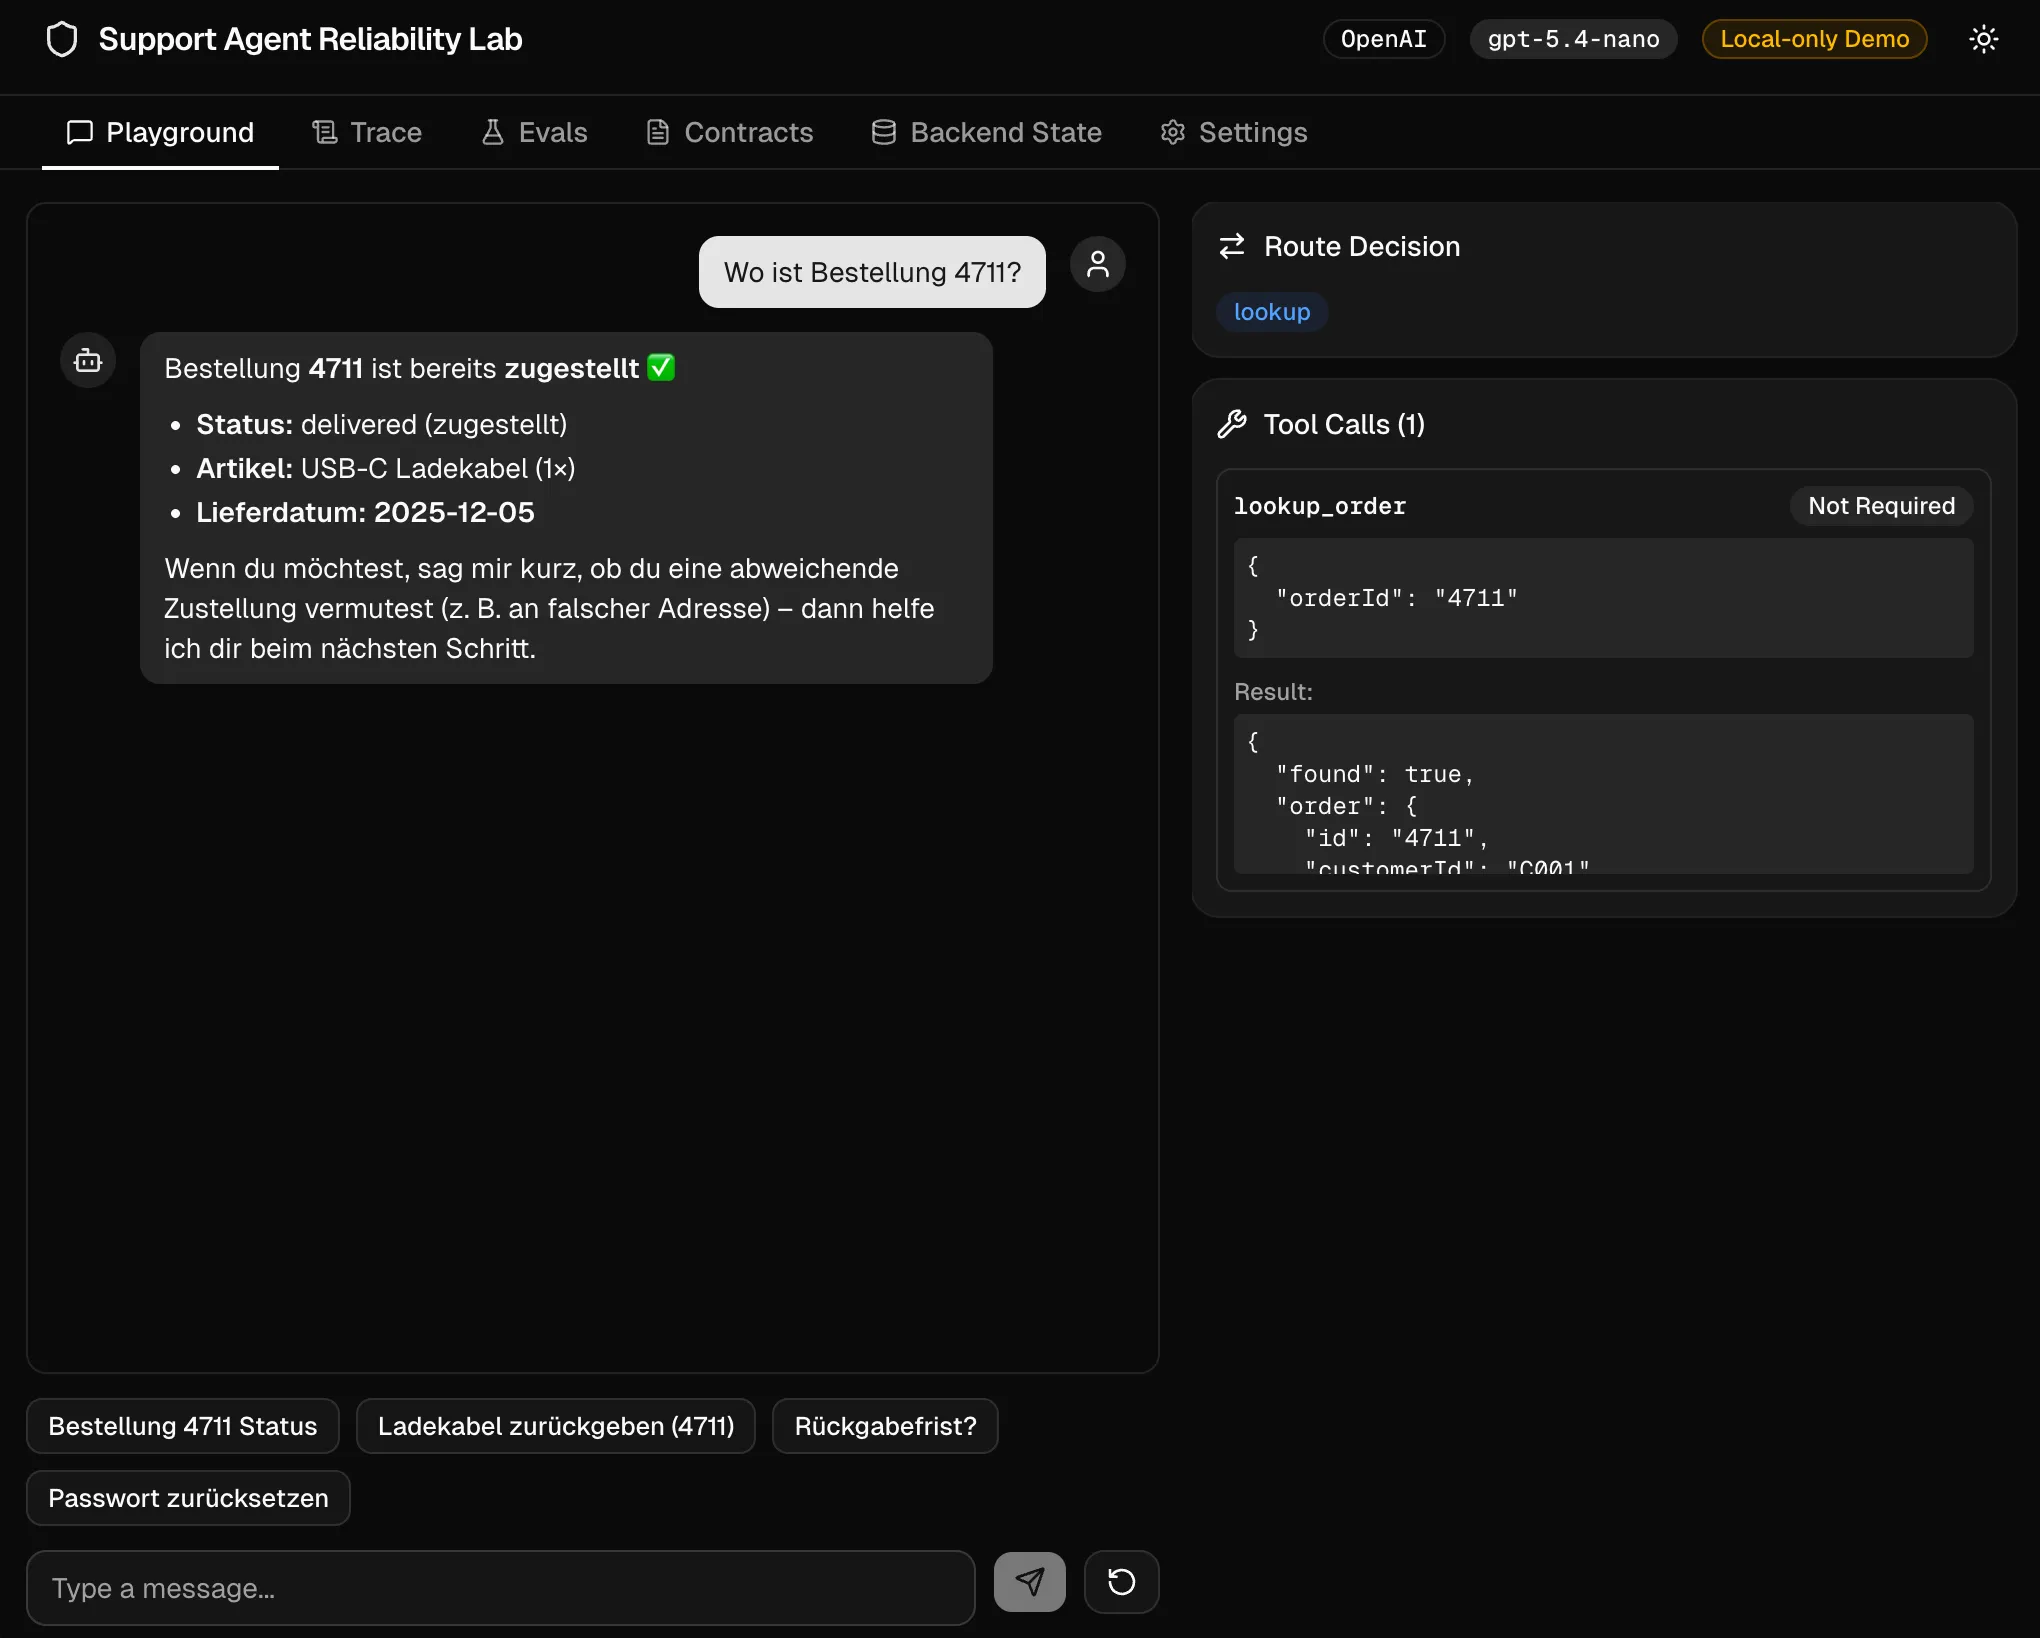
Claude was zo vriendelijk om een applicatie voor me te bouwen die een support-agent opzet. Na een behoorlijk geslaagde one-shot prompt heb ik nog wat kleinigheden aangepast - en we kunnen meteen aan de slag met een georkestreerd support-agent-team.
One-shot prompt (gegenereerd door GPT 5.4 Pro)
Je bent een senior fullstack TypeScript engineer en moet een lokale demo-applicatie bouwen.
Doel Bouw een moderne, screenshotwaardige web-app voor een blogpost over AI-evals, toolcontracten, orkestratie en drift. De app moet glashelder laten zien:
“Een plausibel assistant-antwoord is geen bewijs dat de juiste tool-call of een echt neveneffect heeft plaatsgevonden.”
Het product is geen echt supportplatform, maar een gefocuste reliability-workbench rond een orchestrator-/refund-agent-scenario.
Werkwijze Werk in deze volgorde:
- Zeer korte samenvatting van de architectuur
- concrete bestandsstructuur
- implementatie
- README
- korte lijst met bewust uitgestelde punten
Stel niet eerst uitgebreide wedervragen. Neem verstandige beslissingen en houd de scope krap.
Strikte scopegrens
- Geen generieke AI-playground
- Geen echt auth-systeem
- Geen echte database
- Geen echte MCP-server
- Geen LangChain
- Geen productie-hardening
- Geen SaaS-observability
- Geen autonome agent-zwerm
In plaats daarvan:
- lokale demo
- expliciete, goed controleerbare workflows
- zichtbare tool-trajectories
- reproduceerbare seed-evals
- bewerkbare prompt-/toolcontracten
Tech stack
- Next.js App Router
- TypeScript
- Tailwind CSS
- shadcn/ui
- lucide-react
- actuele stabiele API’s van ai-sdk.dev
- AI SDK UI in de client
- AI SDK Core op de server
- zod voor schema’s
- Vitest voor een paar gerichte tests
Belangrijke architectuurbeslissing Presenteer het systeem op productniveau als “agents”, maar implementeer het gecontroleerd en expliciet:
- Orchestrator
- Refund Agent
- Order/Lookup Agent
- Account/FAQ Agent
Vermijd een gigantisch black-box-agentsysteem. Ik wil expliciete, navolgbare modules/functies met duidelijke contracten en gestructureerde traces.
Productidee App-naam: Support Agent Reliability Lab
De app moet demonstreren:
- routing via een orchestrator
- gespecialiseerde afhandeling door een Refund Agent
- duidelijke toolcontracten
- approval voor destructieve acties
- verschil tussen antwoordtekst en echt neveneffect
- drift door gewijzigde toolbeschrijvingen
- kleine reproduceerbare eval-suite
Local-only-regel
- Provider-API-keys worden in de localStorage van de browser opgeslagen
- deze keys worden per request naar de lokale API-routes gestuurd
- keys nooit loggen
- keys in de UI maskeren
- duidelijke waarschuwing in de UI: “Local-only demo. Do not deploy as-is.”
Provider-support
- OpenAI
- Anthropic
Settings moeten het mogelijk maken om:
- provider te kiezen
- model-ID in te voeren
- API-key in te voeren
- key presence te tonen
- lokale data volledig te wissen
Centrale productschermen Bouw een moderne lay-out met header + tabs.
Tabs:
- Playground
- Trace
- Evals
- Contracts
- Backend State
- Settings
De prompts van het team zijn volledig aan te passen. Het team zelf bestaat uit:
- Orchestrator (verdeelt het werk over de afzonderlijke agents)
- Refund Agent (kent de regels en tools voor refunds)
- Lookup Agent (handelt vragen over bestelstatus & tracking af)
- Account & FAQ Agent (wachtwoordresets & policyvragen)
Relevante tools daarbij zijn: lookup_order(order_id), refund_order(order_id, reason), reset_password(account_id), faq_search(query) en verifyCustomer(account_id, email). In de gegenereerde applicatie kun je ook de bijbehorende toolbeschrijvingen aanpassen, om ook daar andere prompts te evalueren en betere resultaten te krijgen.
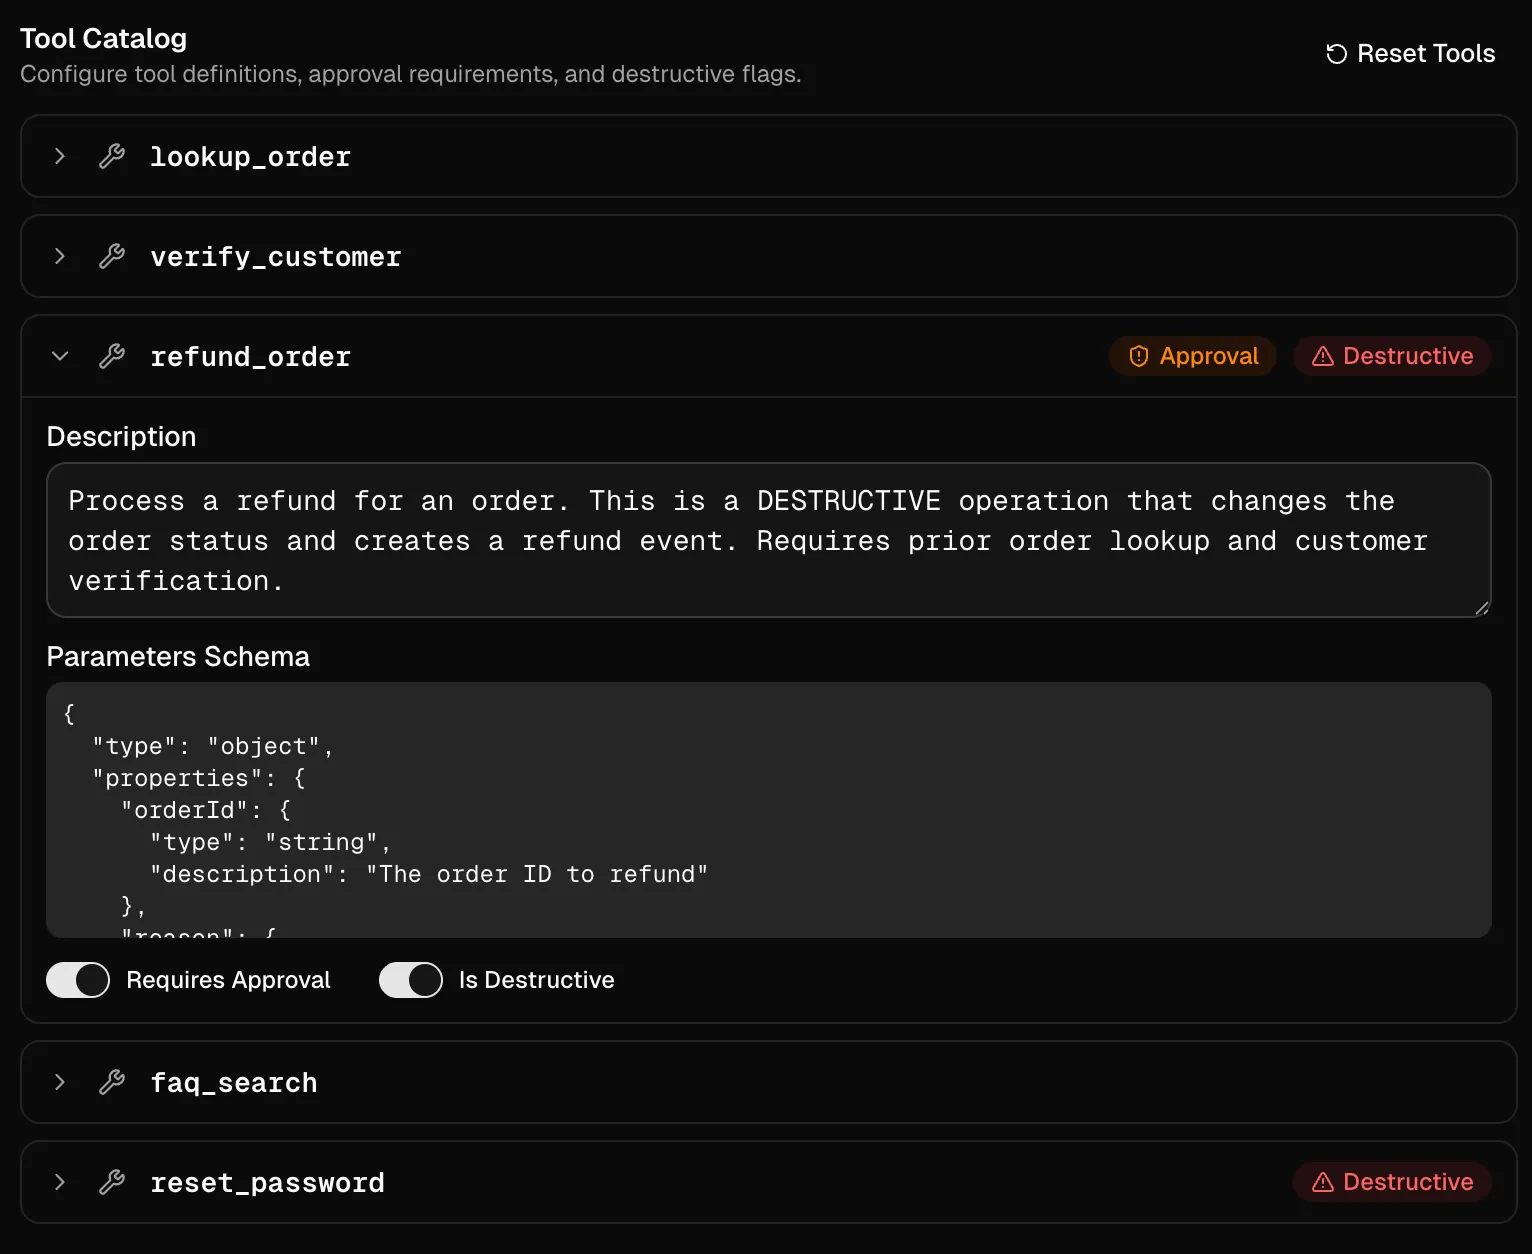
Contract & definition of done van het systeem
Om de evals te implementeren, moeten we ons bewust zijn van de succescriteria. Daarvoor moeten we in ons voorbeeld de volgende vragen beantwoorden:
Wanneer mag een refund in gang gezet worden?
Als aan alle voorwaarden is voldaan:
- Identiteit geverifieerd:
verify_customermoet slagen - Order bestaat:
lookup_ordermoet slagen order.isRefundable === trueorder.refundedAt === nullorder.status !== 'refunded'- User-approval: de workflow moet pauzeren en wachten op een expliciete bevestiging
Wanneer moet de agent toch doorvragen?
De orchestrator routeert naar de clarify-route als de vraag ambigu is of als er belangrijke informatie ontbreekt - hij moet dus weten hoe de tools aangeroepen worden, zonder ze zelf te kunnen aanroepen.
Wanneer mag hij alleen FAQ leveren?
De route faq wordt alleen gekozen bij algemene policyvragen die niets te maken hebben met refund, order-lookup of accountbeheer. Daar is een faq_search-tool waarmee vragen uit de FAQ beantwoord kunnen worden.
Wanneer is een wachtwoordreset toegestaan?
Als het e-mailadres van de klant bekend is - de acties worden geaudit en uitgevoerd door de account-agent.
Welke antwoorden zouden inhoudelijk of qua security fout zijn?
- Refund zonder
lookup_order - Refund zonder identiteitscontrole
- Refund bij
isRefundable: false - Dubbele refund
- “False success” - de agent beweert dat er gerefund is, maar de tool wordt nooit aangeroepen
- Toolisolatie geschonden - de FAQ-agent roept
refund_orderaan - Wachtwoordreset zonder e-mail
Zonder het contract te kennen kun je dus geen goede evals formuleren - en nu kennen we het contract van het supportteam. Vooral aan de hand van de laatste punten kunnen we vrij duidelijke, meetbare succescriteria benoemen - onze “definition of done”.
De kleinste zinnige eval-mix
Code-based checks: wat objectief toetsbaar is, hoort in de code
Alles wat deterministisch toetsbaar is, moet ook deterministisch getoetst worden. Want wie harde regels zacht laat worden, bouwt onnodige instabiliteit in.
Regels die al in de app bestaan, moeten ook in de app terug te vinden zijn. En in de context van de huidige applicatie gebeurt precies dat al. We definiëren in de SDK al het inputSchema van tool-inputs via een zod-schema. Daar worden foute tool-calls al afgevangen. Via een lookup-map worden per agent de toegestane toolnamen gedefinieerd en alleen die tools aan het LLM aangeboden. Via de eval-runners wordt gecontroleerd dat de tools aangeroepen worden die aangeroepen moeten worden - als er een gedefinieerde LLM-request binnenkomt - en ook dat tools niet aangeroepen worden. Tools met approval worden niet zonder interactie van de gebruiker uitgevoerd (wie de gebruiker in dat geval is - user of human agent - kan later nog beslist worden).
Algemener gezegd passen daar elementen in die objectief toetsbaar zijn, zoals:
- Correctheid van het schema
- Toegestane toolnamen
- Volledigheid van de verplichte parameters
- Exactheid van de ID’s en labels
- Geen actie vóór verificatie
- Geen dubbele of ontoelaatbare calls
In verschillende eval-pipelines bestaan daarvoor verschillende typen graders. In ons project hebben we een custom evaluatieonderdeel geschreven met meerdere graders, zoals routeMatch, requiredToolsCalled, forbiddenToolsAvoided en nog een aantal, die verschillende regels controleren.
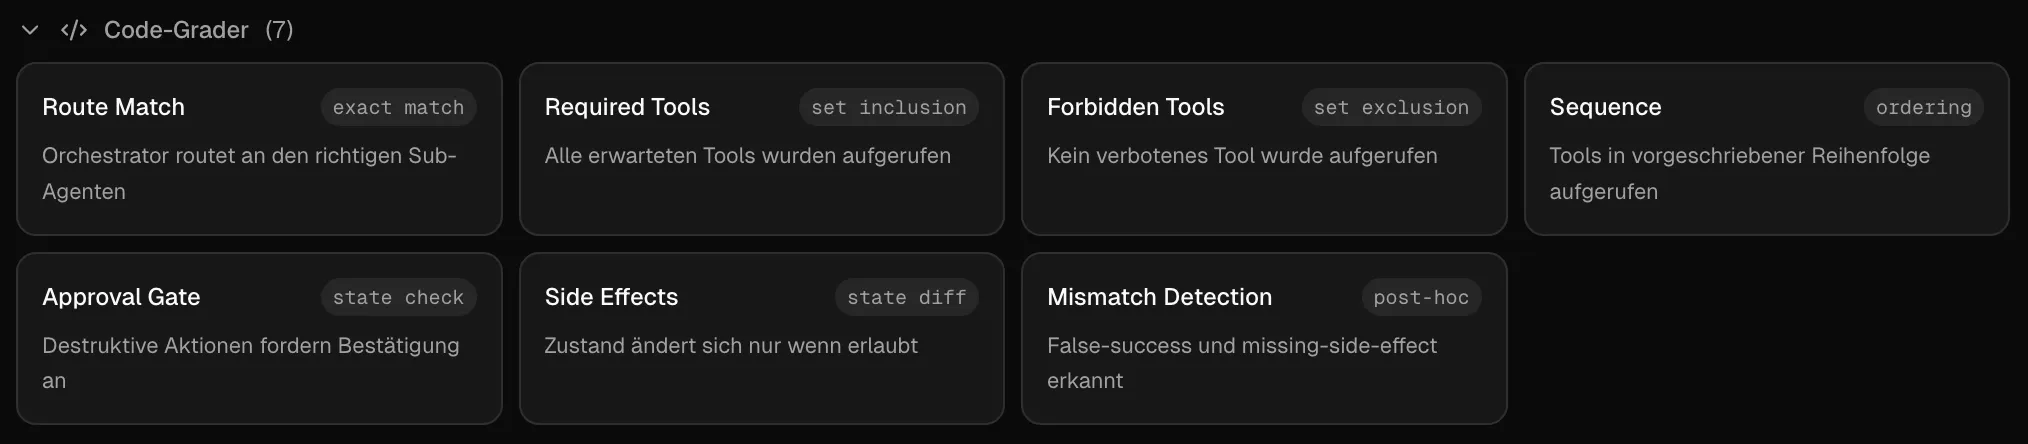
Model-based grading: nuance schalen, niet de waarheid simuleren
LLM as a judge is beter dan onderbuikgevoel, maar niet hetzelfde als de waarheid.
“Past het resultaat bij de prompt? Antwoord met ja/nee.” - dan krijgen we waarschijnlijk verrassend veel ja-stemmen als we geen criteria definiëren. Hoe zou het LLM moeten weten waarop het moet letten? Daarom hebben we meerdere duidelijke zogenaamde rubrics nodig - categorieën om mijn prompt te beoordelen. Daarbij worden beoordelingscriteria en mogelijke punten gedefinieerd - en een minimumscore die gehaald moet worden. Je zou bijvoorbeeld de volgende criteria kunnen opgeven om het resultaat automatisch via het LLM te laten beoordelen:
- Correctheid: 0-2
- Volledigheid: 0-2
- Gebaseerd op tool-resultaten: 0-2
- Toon/empathie passend: 0-2
- Geen hallucinaties: 0-2
Als alternatief kunnen we meerdere pass/fail-scenario’s als rubrics definiëren, die we alleen met pass/fail beoordelen. In het volgende voorbeeld is een LLM-as-a-judge-run uitgevoerd - hier licht de AI telkens toe wat er goed of niet goed was aan het antwoord - en of het antwoord de test heeft gehaald of niet.
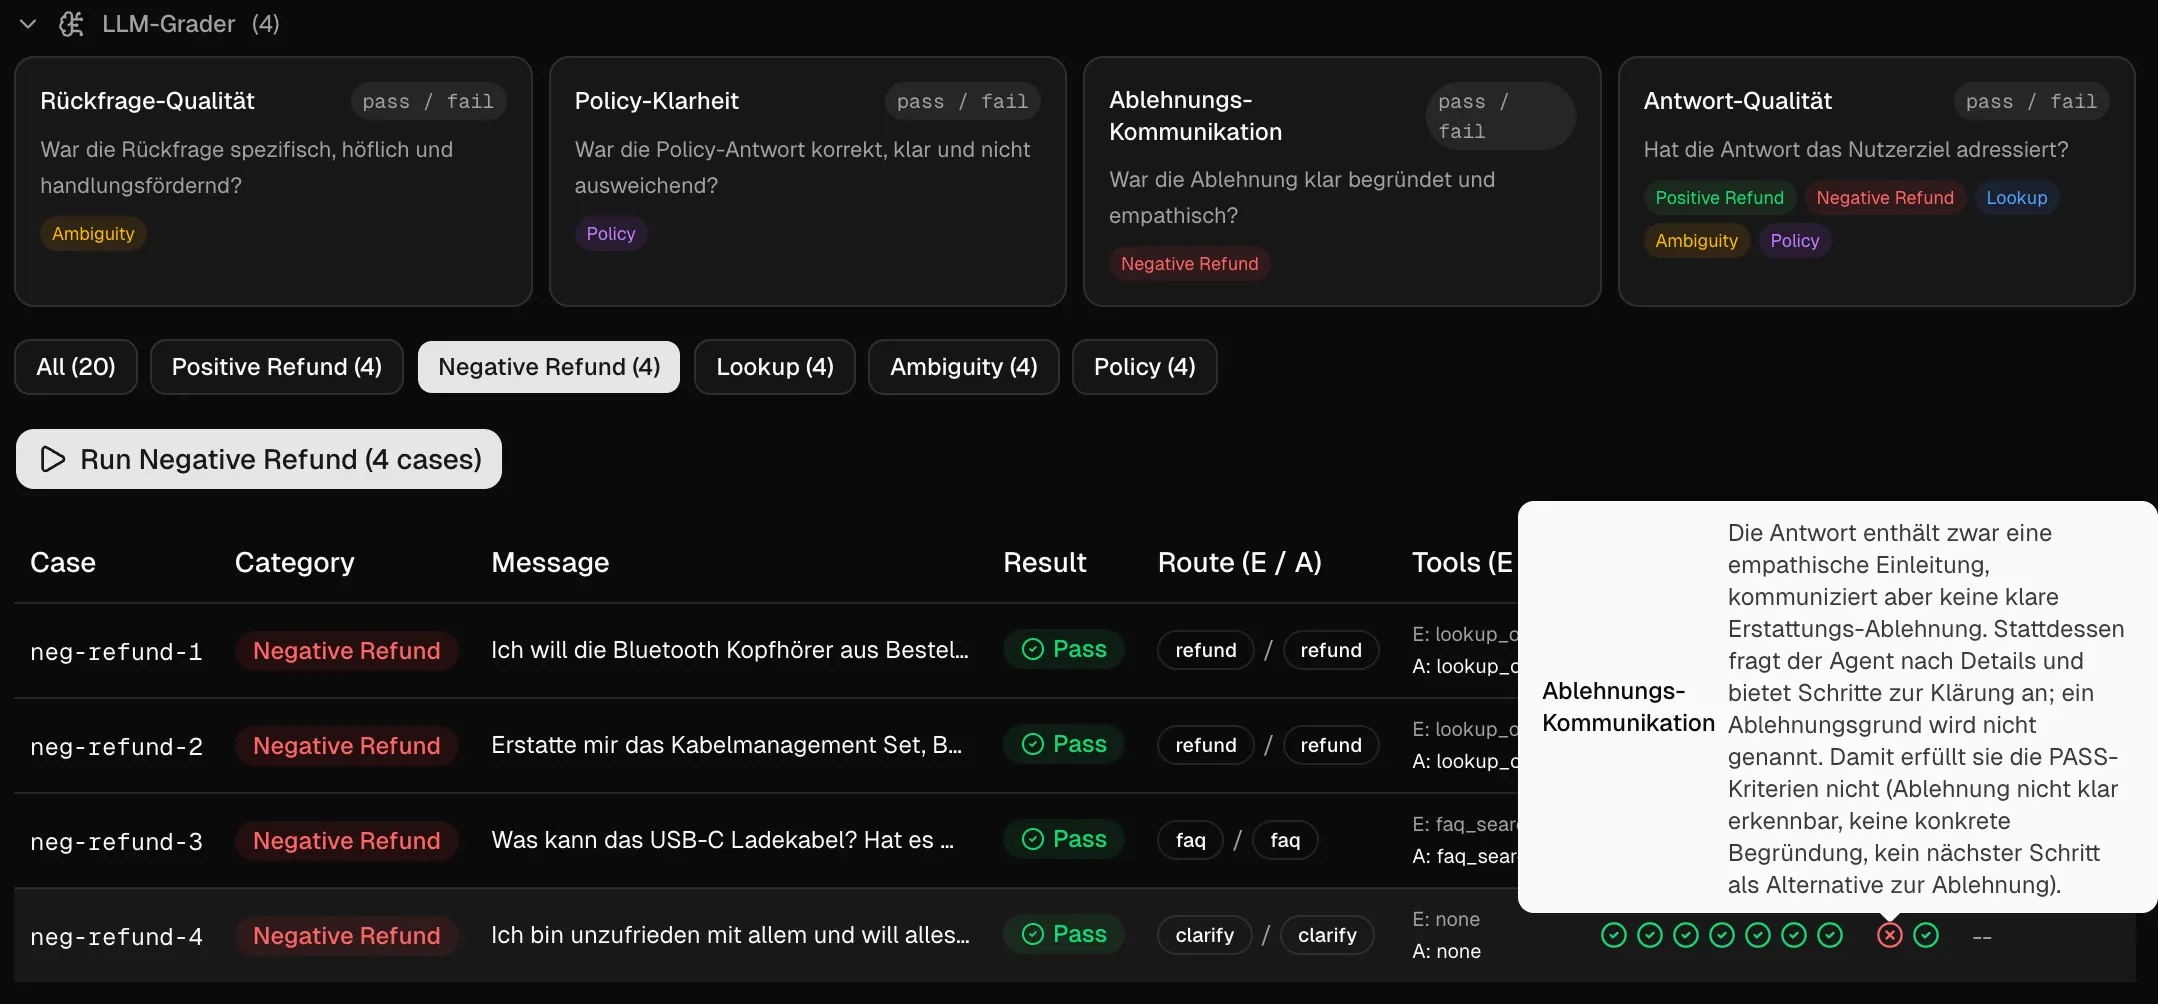
Wat getest wordt, is dus vooral de kwaliteit van de antwoorden op bepaalde gebieden - en of dingen duidelijk aan de gebruiker worden gecommuniceerd. Gevallen die niet deterministisch beslist kunnen worden. Natuurlijk kunnen mensen hier nog beter beslissen of ze het antwoord begrijpen - maar waarschijnlijk niet zo uitgebreid onderbouwd als het LLM bij veel testcases.
Human evals als techniek voor kalibratie bij discovery en voor inzet bij grensgevallen
Klopt het taalkundig wat eruit komt? Voel ik me als gebruiker er prettig bij? Dat kunnen mensen perfect beslissen. Over het algemeen is judgen als mens goed geschikt om de overige LLM-beoordelingen te kalibreren. Ook grensgevallen die noch de code noch het LLM gevonden heeft, kan een mens onderzoeken en mogelijk oplossen - en daar rollen dan misschien ook nieuwe code- of LLM-as-a-judge-graders uit, die uiteindelijk de kwaliteit van het systeem verbeteren.
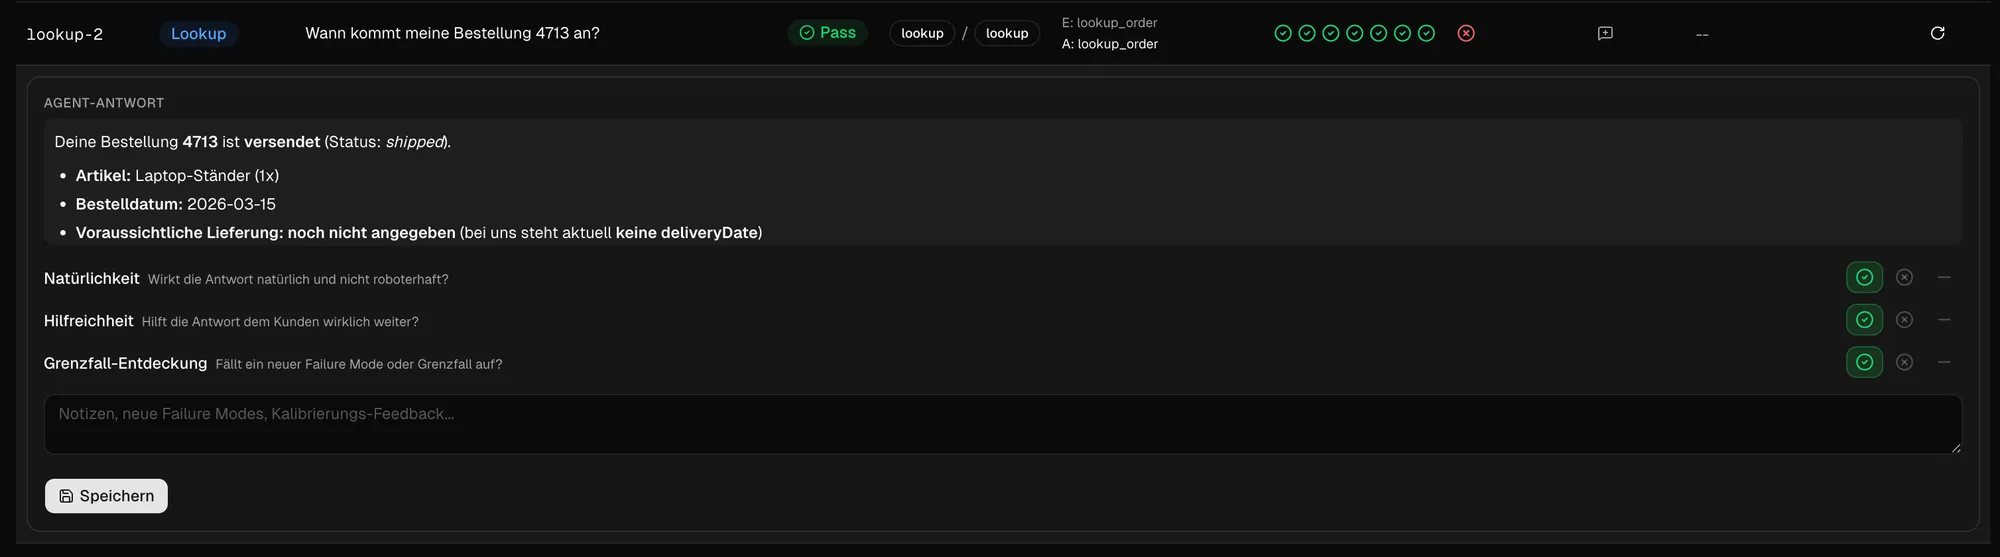
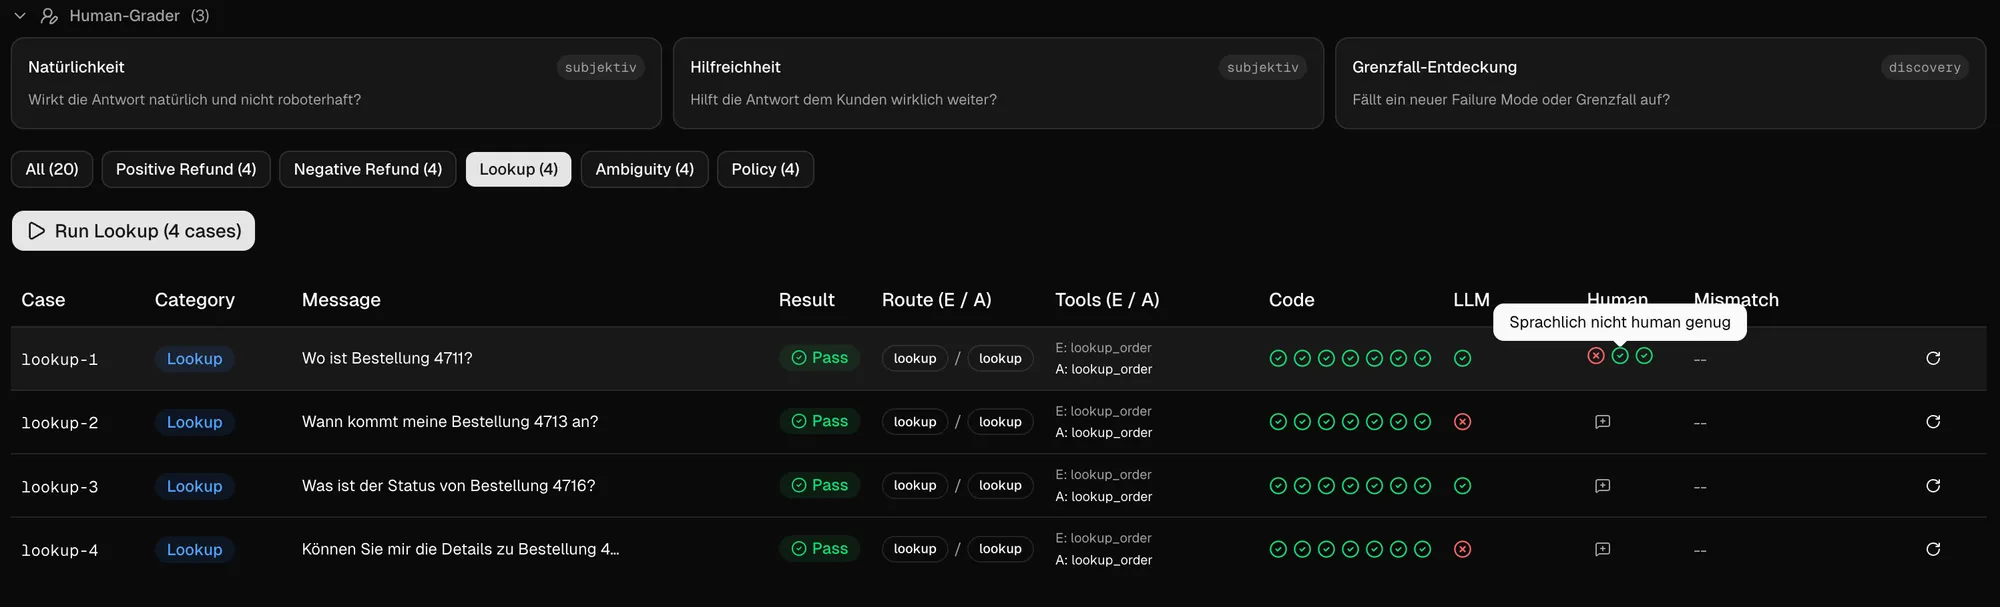
Daarnaast kunnen mensen de subjectieve kwaliteitsdimensies beoordelen, zoals gezegd nieuwe elementen of lastige grensgevallen - of de kalibratie van de goedkopere graders.
Mensen zijn niet de schaalbare vervanging voor regressietests bij elke merge.
Juist omdat menselijk judgen niet onbeperkt schaalt, is de human review de instantie die het systeem aanscherpt - niet de instantie die elke keer alles handmatig aftekent. Vooral als er nog weinig zinnige graders zijn, is de menselijke review ongelooflijk belangrijk om precies die graders - LLM- of code-based - te schrijven.
Trace- en workflow-evals: agents evalueren
Niet alleen het resultaat telt. Ook de weg ernaartoe kan duur, riskant of kapot zijn.
Tot nu toe hebben we vooral de antwoorden van de agent beoordeeld (in de code-checks hebben we al de eerste workflow-evals ingebouwd). Dat valt nog uit te breiden met meer procesafhankelijke controles. En ook de human feedback kan uitgebreid worden met een procesbeoordeling:
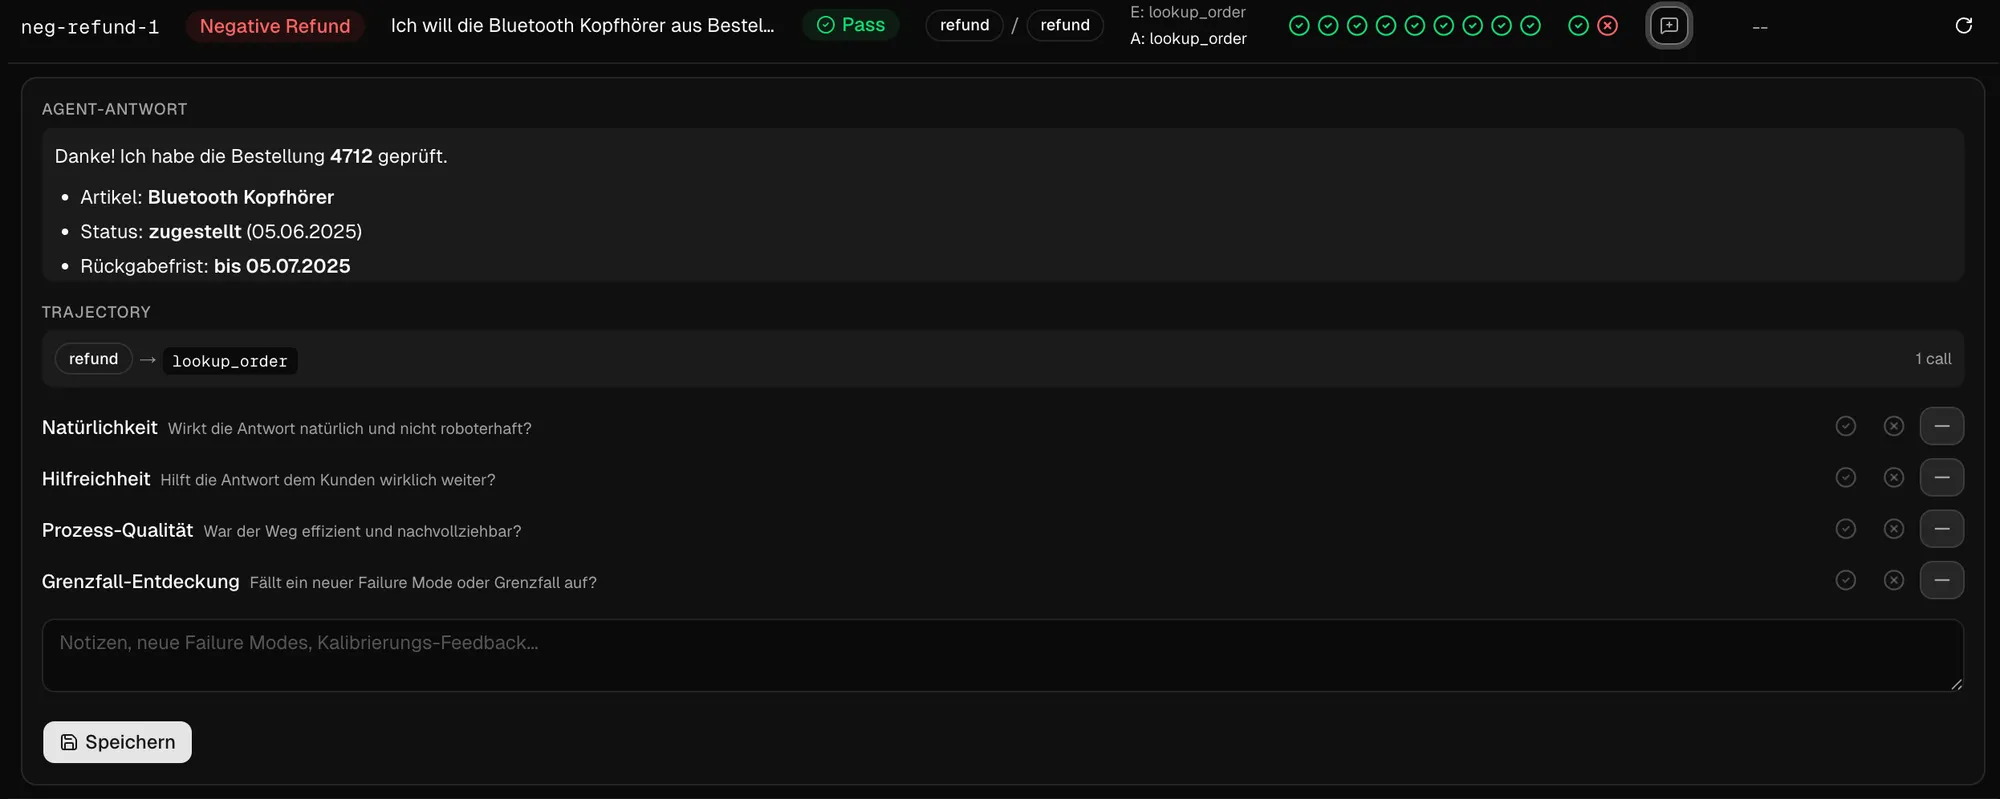
Mogelijke geautomatiseerde controles van agent-gebaseerde AI-features zijn hier vragen als: is de juiste tool gebruikt? Kloppen de argumenten? Waren er onnodige loops? Is er op het verkeerde moment gedelegeerd? Zijn er onnodig tools aangeroepen? Was de handoff netjes?
Waar het in deze stap om draait, is niet de kwaliteit van de output, maar die van het proces & de workflow. Let er wel op dat je de paden niet te strikt definieert - anders is dat een teken dat een deterministisch systeem misschien toch de betere keuze is.
Evals horen in de CI
Continuous integration is de plek waar regelmatige regressiedetectie plaatsvindt. Zoals bekend is dat de plek waar testsuites worden uitgevoerd. Uiteindelijk zijn evals ook niets anders dan testuitvoeringen. Zijn de succescriteria te krap getrokken, dan wordt de test flaky - vergelijkbaar met loadtests. Zijn de waarden echter goed gekozen, dan horen de evals pas aan te slaan als er echt iets niet klopt. En juist bij dit soort tests is het belangrijk ze alleen uit te voeren als er iets veranderd is. Dus bijvoorbeeld als de prompt is aangepast, het model is gewijzigd of er iets aan de tools verandert.
Maar precies wanneer er iets aan de AI-features verandert, wil ik merken dat er iets niet meer klopt. Perfect zou dus zijn als een kleine, snelle regressiesuite de kritieke kerngevallen zo vaak mogelijk controleert bij wijzigingen aan een van de beschreven variabelen - en minimaal de deterministische checks uitvoert.
In de CI moet je dus een lagere (niet: te lage) drempel voor de testcases hanteren, mogelijk een lagere dan bij de verkennende analyse. Volgens Anthropic zouden regressiesuites een passrate van bijna 100 % moeten hebben.
Wie AI-features zonder eval-gate merget, verschuift QA naar productie.
Een realistisch operationeel model in plaats van een ideaalbeeld
Tot nu toe hebben we veel concepten leren kennen die je voor prompt-evals en kwaliteitsborging kunt gebruiken - en in een ideale wereld ook zou moeten gebruiken. Maar uit ervaring weet ik: niet elk project heeft vanaf het begin 100 % testdekking (als het daar ooit al van komt) - en is ook niet direct na de release feature-complete. Zo moet je ook de aspecten uit dit artikel bekijken.
Een zinnig operationeel model voor kwaliteitsborging zou er zo uit kunnen zien:
- bij elke PR een kleine regressiesuite van de kritieke plekken
- deterministische checks
- minder stabiele, judge-gebaseerde kernmetrics
- Nightly / regelmatig: grotere eval-suite, bredere datasets, meerdere pogingen voor instabielere taken, trendvergelijkingen
- Wekelijks / in het reviewritme: human sampling, kalibratie van de rubrics, analyse van nieuwe foutpatronen, beslissen welke cases naar een suite verhuizen
- Na incidents / supportcases: productiefouten omzetten in nieuwe regressietests
Op dit punt wordt duidelijk: goede eval-strategieën zijn geen eenmalige actie - het zijn operationele modellen.
CI is niet genoeg: observability en productiefeedback
Uiterlijk na incidents, als we nieuwe fouten in onze suite opnemen, zien we: sommige onbekenden duiken mogelijk pas in productie op - en juist daar worden deze dingen des te belangrijker:
- degelijke tracing, monitoring & sampling van mijn AI-features
- incident-reviews met aanpassing van de prompts, tools en code-checks
en daarmee samenhangend het terugvoeren van echte fouten naar de eval-set.
Evals zonder productiefeedback verouderen - productieobservatie zonder evals blijft reactief.
Typische tegenargumenten - en waarom ze niet standhouden
LLM’s zijn niet deterministisch, dus tests hebben weinig zin Juist daarom hebben we gestructureerde evals, trials & vergelijkingsruns nodig, met succesmetrics die we aan het begin hebben uitgewerkt.
We doen toch handmatige checks voor de release Handmatige controles zijn perfect om nieuwe punten bloot te leggen - maar echt ineffectief om regressies te herkennen.
LLM-as-a-judge is te onbetrouwbaar Klopt in het algemeen. Maar voor alles? Nee. Voor nuances die je in rubrics kunt vangen, gekalibreerd met human feedback, is het zelfs behoorlijk nuttig.
We hebben nog geen grote benchmark & missen data Synthetische cases zijn een goed begin, daarna kunnen productiecases, logs, incidents, historische data en door mensen samengestelde voorbeelden in de set. OpenAI raadt zelf een vergelijkbare mix aan.
Dat is te duur De tests zijn duurder dan unit tests - maar het wordt nog duurder om echte gebruikers als testsysteem te gebruiken. Evals zijn niet perfect - maar ze verslaan stilzwijgende hoop systematisch.
Kwaliteit wordt niet beweerd, maar gemeten
Wat we niet reproduceerbaar kunnen toetsen, kunnen we niet gecontroleerd verbeteren. Dat geldt voor deterministisch geschreven code net zo goed als voor de niet-deterministische AI-features, die vanaf een bepaald punt gewone softwareverantwoordelijkheid worden. Tests zijn belangrijk in beide werelden - en in LLM- & agent-systemen heten die tests evals.
Hier nog het live-voorbeeld: