
Den som levererar AI-funktioner utan evals har ingen engineering-process, bara förhoppningar.
Att prompta i en chatt är perfekt för att utforska vad som går att göra, men så fort det ska ut i produktion räcker det inte med enstaka bra svar. Den som deployar utan evals flyttar testandet till riktiga användare. Jag snuddade vid det här ämnet redan i mitt förra inlägg, där en AI-baserad utvärdering användes i förbigående. Här vill jag belysa just den aspekten mer i detalj och beskriva vad som spelar roll i produktionsapplikationer.
Testat i chattfönstret
… är inte testat.
Att bygga AI-funktioner börjar ofta i chatt-UI:t eller med några prompts i en playground för utvecklare. Efter några happy path-frågor har vi en prompt som vid första anblick är perfekt och som funktionen kan byggas direkt på. Lite manuell finjustering hör förstås till.
Och just det är perfekt! För utforskandet, för att se om själva idén bakom funktionen håller – för att avslöja dolda antaganden och grova misslyckanden. Det som faller bort, precis som i många deterministiska mjukvaruprojekt, är testandet. Och det är just i testandet som den reproducerbara kvalitetssäkringen börjar. Kod i produktion som enbart har testats manuellt bär alltid med sig risken att något har missats, särskilt när det gäller regressioner – och exakt samma sak gäller för prompts som har tagits fram genom utforskande.
Släpper en leverantör en ny modell om två månader som ska integreras direkt, eftersom den verkar passa bättre, hamnar vi snabbt i blindflygning om vi tog fram prompten genom utforskande – och sedan bara lät den ligga kvar i projektet utan att testa igen. Men det är inte bara en ny modell som sätter igång det här. Även en (potentiellt osynlig) ändring i modelleverantörens systemprompt kan i grunden ändra beteendet hos våra prompts – och våra AI-funktioner. Utan reproducerbar utvärdering flyger vi här helt i blindo.
Fungerar i demon och håller när saker ändras – det är två olika saker. Och det är precis här continuous evaluation (CE) kommer in.
Där prompt engineering tar slut
Så fort modellens output blir en del av produktlogiken räcker det inte längre med bra promptande. Då väger contracts, evals och observability minst lika tungt som själva prompten.

Om vi fortsätter att iterera på en prompt kan vi slå i taket: resultatet blir helt enkelt inte bättre, evalsen förblir röda. Då kan det vara dags att byta modell. För alla problem sitter inte i prompten – andra orsaker till misslyckanden är val av modell, arkitektur, verktyg, data eller arbetsflödet.
Bättre promptande optimerar modellens svar, engineering stabiliserar systemet runtomkring.
Varför startades ingen retur i exemplet? I eval-processen var svaren alltid perfekta – och verktygsanropen fungerade också alltid. Tittar man närmare på exemplet slår det en: en MCP-server? Den levererar sina verktygsbeskrivningar själv – och har något ändrats där som prompten inte är anpassad till, kan logiken sluta fungera – och ett sådant fall uppstå.
När evals blir ett måste
Så fort icke-determinism kommer in i systemet är det en bra idé att köra evals. Inte nödvändigtvis när vi levererar AI-output direkt till användaren – men definitivt när modellens output påverkar produktlogiken.
Routing, tool calls, att skriva eller ändra data, att förbereda eller förhindra användaråtgärder, att vara en del av en kedja i ett arbetsflöde – allt det är skäl att köra evals. Och för system med hög kvalitet är de ett måste.
Ju fler ställen med icke-determinism som finns i systemet, desto större är behovet av systematiska evals. Det sträcker sig från single-turn (en modell-output styr en sak) via workflows (en serie prompts som bygger på föregående output) och single agents (en agent anropar verktyg eller arbetar tills den ”tycker” att den är klar) hela vägen till multi-agents som kommunicerar med varandra. Där är det i varje fall mer än relevant att köra systematiska evals, men de rekommenderas redan vid single-turn.

Som exempel innebär en FAQ-bot som hämtar produktkunskap till en fråga via t.ex. RAG och presenterar den för användaren en ganska låg risk – medan refund-agenten ovan, med tool calls till refund-verktyg, för med sig en betydligt högre risk. Sitter den agenten dessutom bredvid en buying-agent som kan göra köp åt mig – och hanteras av en orchestrator – har vi en extremt hög komplexitet, och de systematiska evalsen blir desto viktigare.
Den som låter modellens output styra produktlogiken tar på sig testansvaret.
Vad som gör en eval användbar
Det som behövs:
- Ett konkret dataset
- ett definierat framgångskriterium
- minst en grader eller verifier
- en reproducerbar körning
- en jämförelse över ändringar
Det är inte bara positivt beteende som ska testas – utan också att visst beteende inte uppstår. Framför allt manuella verifiers är dyra – där lönar sig en liten, verklighetsnära, målinriktad uppsättning fall mer än en perfekt benchmark med otroligt många datapunkter.
Jämfört med human evals är automatiserade graders (llm-as-a-judge) mycket billigare. Ett annat alternativ är kodbaserade graders – och (om möjligt) bör de utgöra huvuddelen av evalsen – men på grund av icke-determinismen aldrig vara det enda sättet att verifiera.

För att stanna vid refund-agenten: en lämplig start på utvärderingen är ett mindre, hanterbart seed-set som består av:
- 4 positiva refund-fall
- 4 negativa refund-fall
- 4 lookup-fall
- 4 tvetydiga fall
- 4 gränsfall som borde flagga ett potentiellt policyfall
Utifrån det här testsetet kan man sedan kontrollera om verktygsanrop [inte] har skett, om svaret till användaren (eller orchestratorn) är lämpligt – om motfrågor ställs korrekt och så vidare. Här handlar det om att vara kreativ inom affärsreglerna och formulera tester som är meningsfulla och hjälpsamma.
Enligt de två stora LLM-leverantörerna handlar det inte om att betygsätta prompts, utan om att specificera AI-beteende så att det blir testbart, förklarbart och automatiserbart. Prompt-evals är alltså inget sidospår, utan övergången från ”vi testar något” till ”vi kan säkra kvalitet synligt”.
I bästa fall formuleras definitionen av framgång allra först – och först därefter tas en prompt fram – ungefär som i test driven development. Utan en definierad framgång finns det ingen grund att utvärdera mot.
När man designar evals måste flera bedömningsdimensioner tas med. Anthropic nämner bland annat uppgiftstrohet, konsistens, relevans, dataskydd, användning av kontext, latens och kostnad; OpenAI beskriver också jämförbara dimensioner. Det avgörande är att formulera kriterierna så att de går att kontrollera med lämpliga metoder: först så deterministiska, tekniskt mätbara framgångskriterier som möjligt, därefter kriterier som kan bedömas med icke-deterministiska metoder som LLM as a judge, och till sist sådana som kräver en mänsklig bedömning.
Eftersom outputen inte är deterministisk kan en enskild körning fortfarande bedömas binärt som godkänd eller underkänd. Vid instabila uppgifter eller agent loops med starkt varierande förlopp räcker en enskild körning dock ofta inte för att på ett meningsfullt sätt bedöma systemets tillförlitlighet. I sådana fall bör samma scenario köras flera gånger och resultatet aggregeras med lämpliga mått – till exempel med pass@k, om minst ett lyckat försök räcker, eller via en konsistenströskel, om pålitligt beteende förväntas. Man kan till exempel bestämma att ett scenario måste gå igenom i minst 9 av 10 upprepningar. För regressionssviter bör pass rate däremot ligga så nära 100 % som möjligt.

En dålig eval-score kan vara ett modellproblem. Men det kan lika gärna vara ett trasigt test.
Evaluation by example: en supportagent med verktyg
Utifrån exemplen vi redan har snuddat vid ovan vill vi arbeta med ett supportteam. Här är ett chattgränssnitt faktiskt det vettigaste – vi kommer visserligen inte att behöva mycket UI runtomkring – men i gengäld är agenten kopplad direkt till vårt system och kan hämta information om användaren och göra saker i användarens namn – konkret t.ex. avbeställa produkter.
UI:t kommer främst att innehålla debug-output för att förbättra agentteamet. Där räcker ett chattgränssnitt, tracing av verktygsanrop och routing, inbyggda eval-tester, redigerbara prompts och ett ”backend”-state för att kontrollera exakt vad som händer med datan.
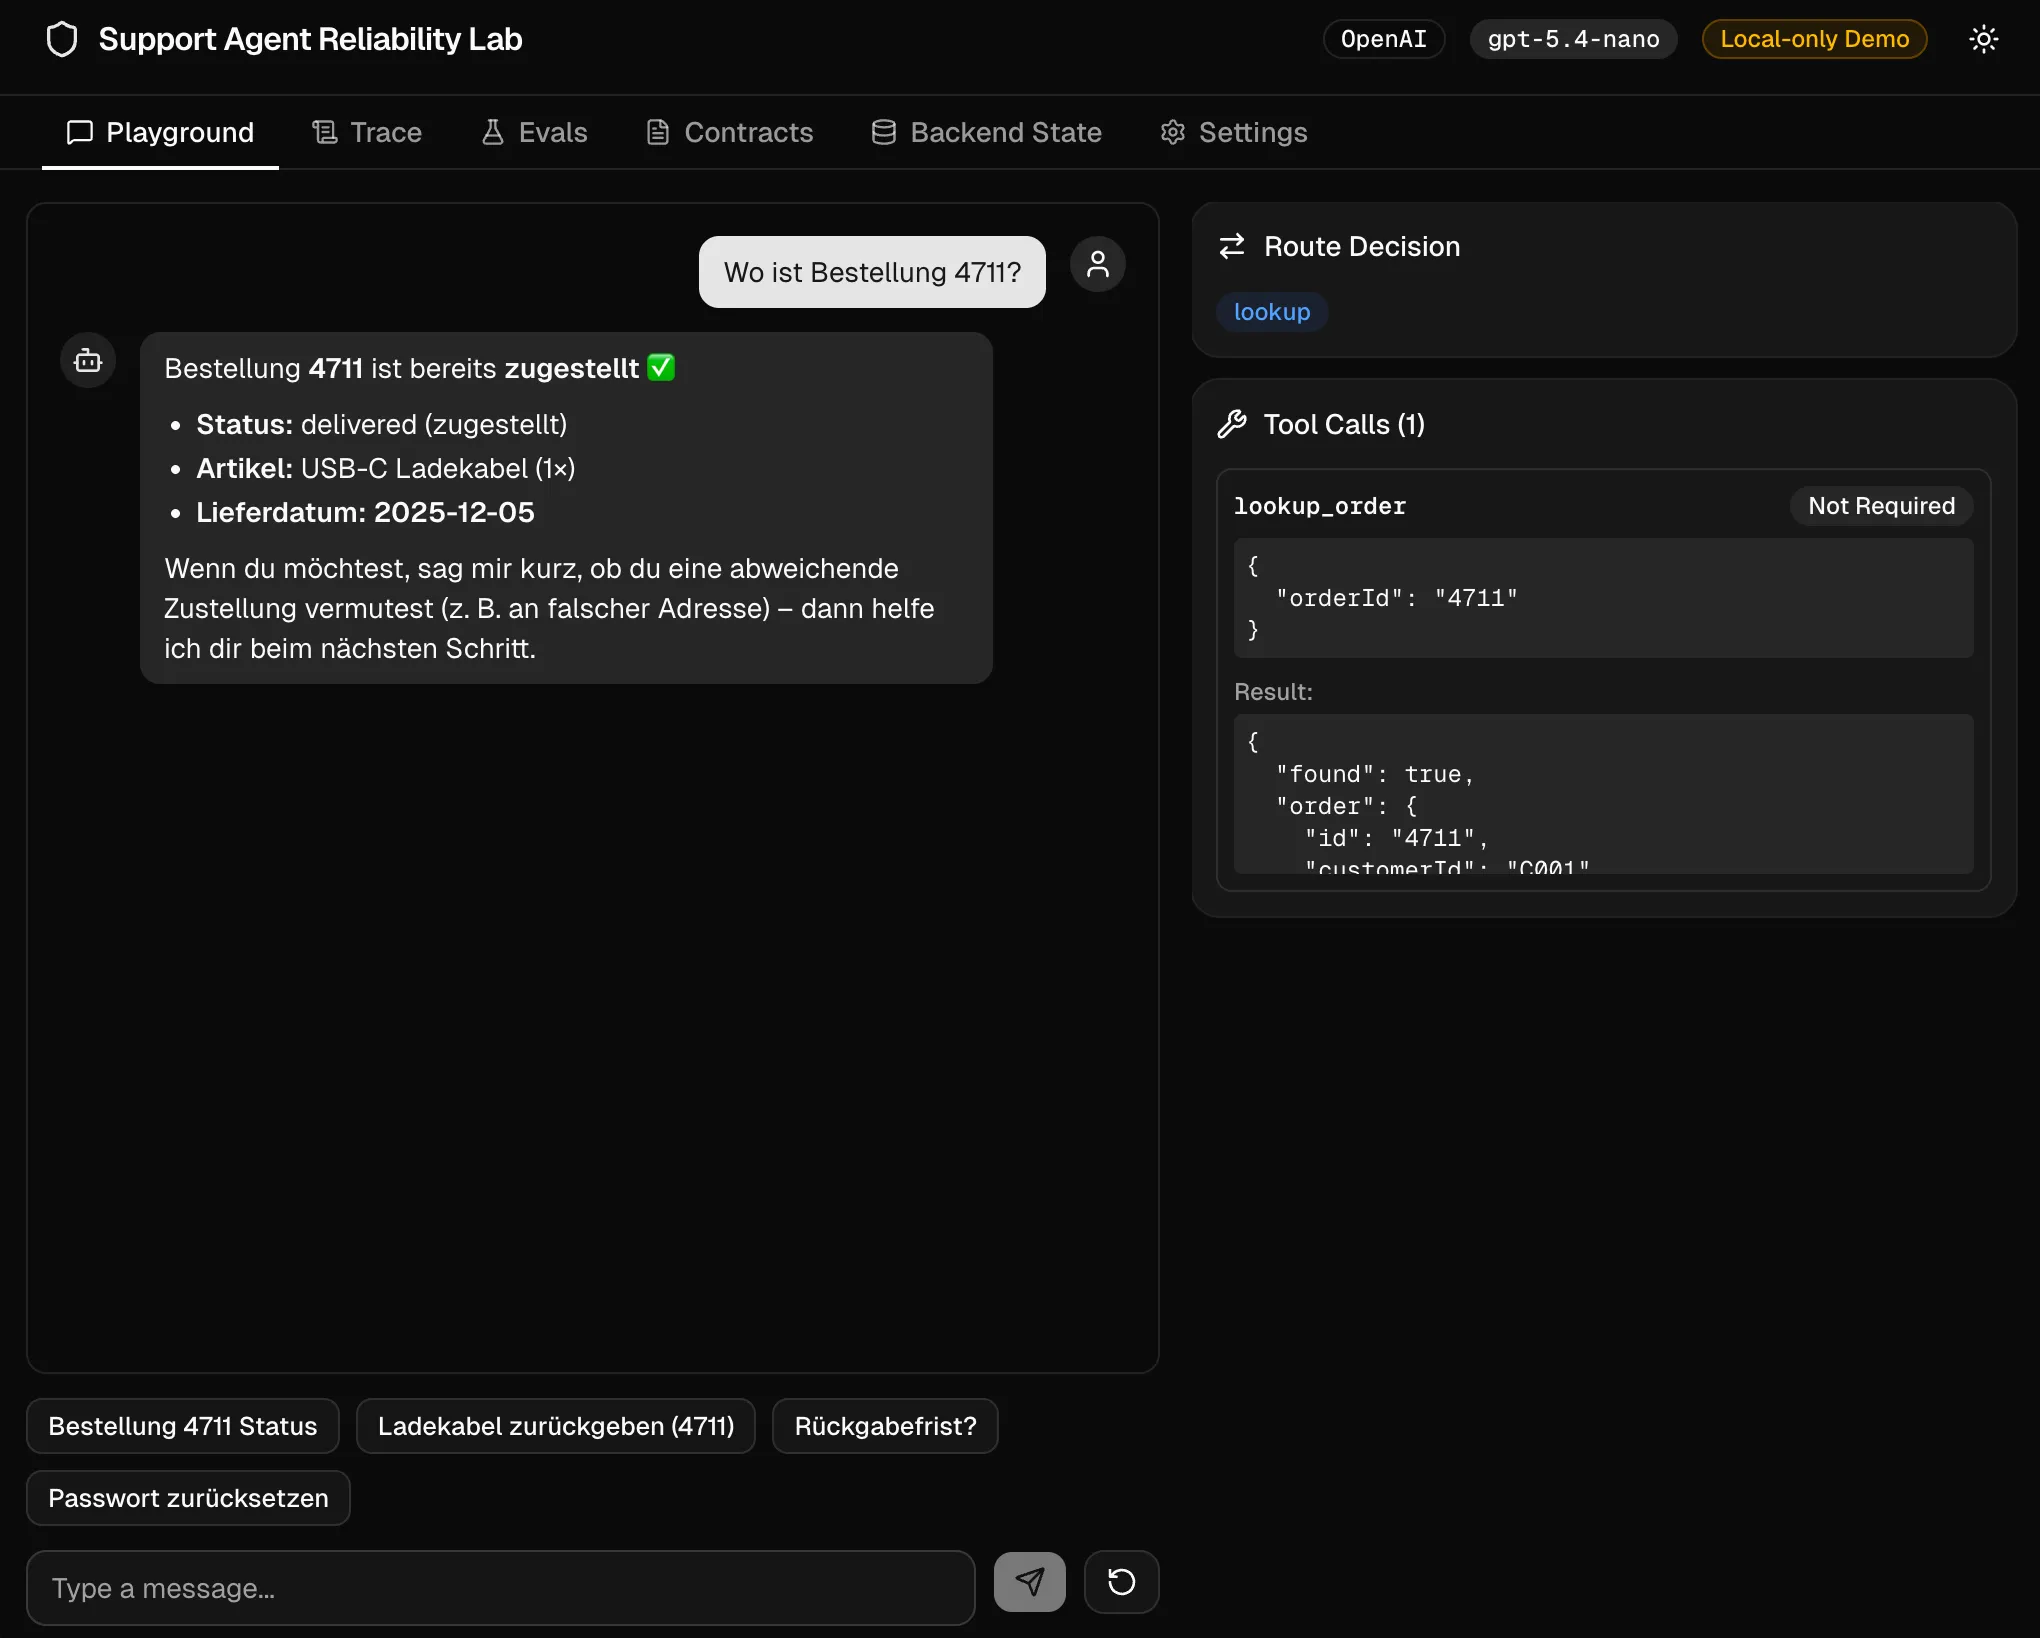
Claude var vänlig nog att bygga en applikation åt mig som sätter upp en supportagent. Efter en ganska lyckad one-shot-prompt justerade jag några småsaker – och sedan kan vi sätta igång med ett orkestrerat team av supportagenter.
One-shot-prompt (genererad av GPT 5.4 Pro)
Du är en senior fullstack TypeScript-engineer och ska bygga en lokal demoapplikation.
Mål Bygg en modern webbapp, snygg nog för skärmdumpar, till ett blogginlägg om AI-evals, verktygskontrakt, orkestrering och drift. Appen ska visa glasklart:
”Ett rimligt svar från assistenten är inget bevis för att rätt tool call eller en verklig sidoeffekt har ägt rum.”
Produkten är ingen riktig supportplattform utan en fokuserad reliability-workbench kring ett scenario med orchestrator och refund-agent.
Arbetssätt Arbeta i den här ordningen:
- Mycket kort arkitektursammanfattning
- konkret filstruktur
- implementation
- README
- kort lista över medvetet uppskjutna punkter
Stanna inte upp för breda motfrågor. Fatta rimliga beslut och håll scopet snävt.
Strikt scope-gräns
- Ingen generisk AI-playground
- Inget riktigt auth-system
- Ingen riktig databas
- Ingen riktig MCP-server
- Ingen LangChain
- Ingen härdning för produktion
- Ingen SaaS-observability
- Ingen autonom agentsvärm
I stället:
- lokal demo
- explicita arbetsflöden som är lätta att kontrollera
- synliga tool-trajectories
- reproducerbara seed-evals
- redigerbara prompt-/verktygskontrakt
Tech stack
- Next.js App Router
- TypeScript
- Tailwind CSS
- shadcn/ui
- lucide-react
- aktuella stabila API:er från ai-sdk.dev
- AI SDK UI i klienten
- AI SDK Core på servern
- zod för scheman
- Vitest för några riktade tester
Viktigt arkitekturbeslut Presentera systemet som ”agenter” på produktnivå, men implementera det kontrollerat och explicit:
- Orchestrator
- Refund Agent
- Order/Lookup Agent
- Account/FAQ Agent
Undvik ett gigantiskt black box-agentsystem. Jag vill ha explicita, spårbara moduler/funktioner med tydliga kontrakt och strukturerade traces.
Produktidé Appnamn: Support Agent Reliability Lab
Appen ska demonstrera:
- routing via en orchestrator
- specialiserad hantering av en refund-agent
- tydliga verktygskontrakt
- approval för destruktiva åtgärder
- skillnaden mellan svarstext och verklig sidoeffekt
- drift genom ändrade verktygsbeskrivningar
- en liten reproducerbar eval-svit
Local-only-regel
- Providerns API-nycklar sparas i webbläsarens localStorage
- nycklarna skickas med varje request till de lokala API-routerna
- logga aldrig nycklar
- maskera nycklar i UI:t
- tydlig varning i UI:t: “Local-only demo. Do not deploy as-is.”
Provider-stöd
- OpenAI
- Anthropic
Settings ska göra det möjligt att:
- välja provider
- ange modell-ID
- ange API-nyckel
- visa om en nyckel finns
- radera all lokal data
Centrala produktvyer Bygg en modern layout med header + flikar.
Flikar:
- Playground
- Trace
- Evals
- Contracts
- Backend State
- Settings
Teamets prompts går att anpassa helt. Själva teamet består av:
- Orchestrator (fördelar arbetet till de enskilda agenterna)
- Refund Agent (känner till reglerna och verktygen för refunds)
- Lookup Agent (tar hand om frågor om orderstatus och tracking)
- Account & FAQ Agent (lösenordsåterställningar och policyfrågor)
De relevanta verktygen är: lookup_order(order_id), refund_order(order_id, reason), reset_password(account_id), faq_search(query) och verifyCustomer(account_id, email). I den genererade applikationen går det också att ändra respektive verktygsbeskrivning, så att man kan utvärdera andra prompts även här och få bättre resultat.
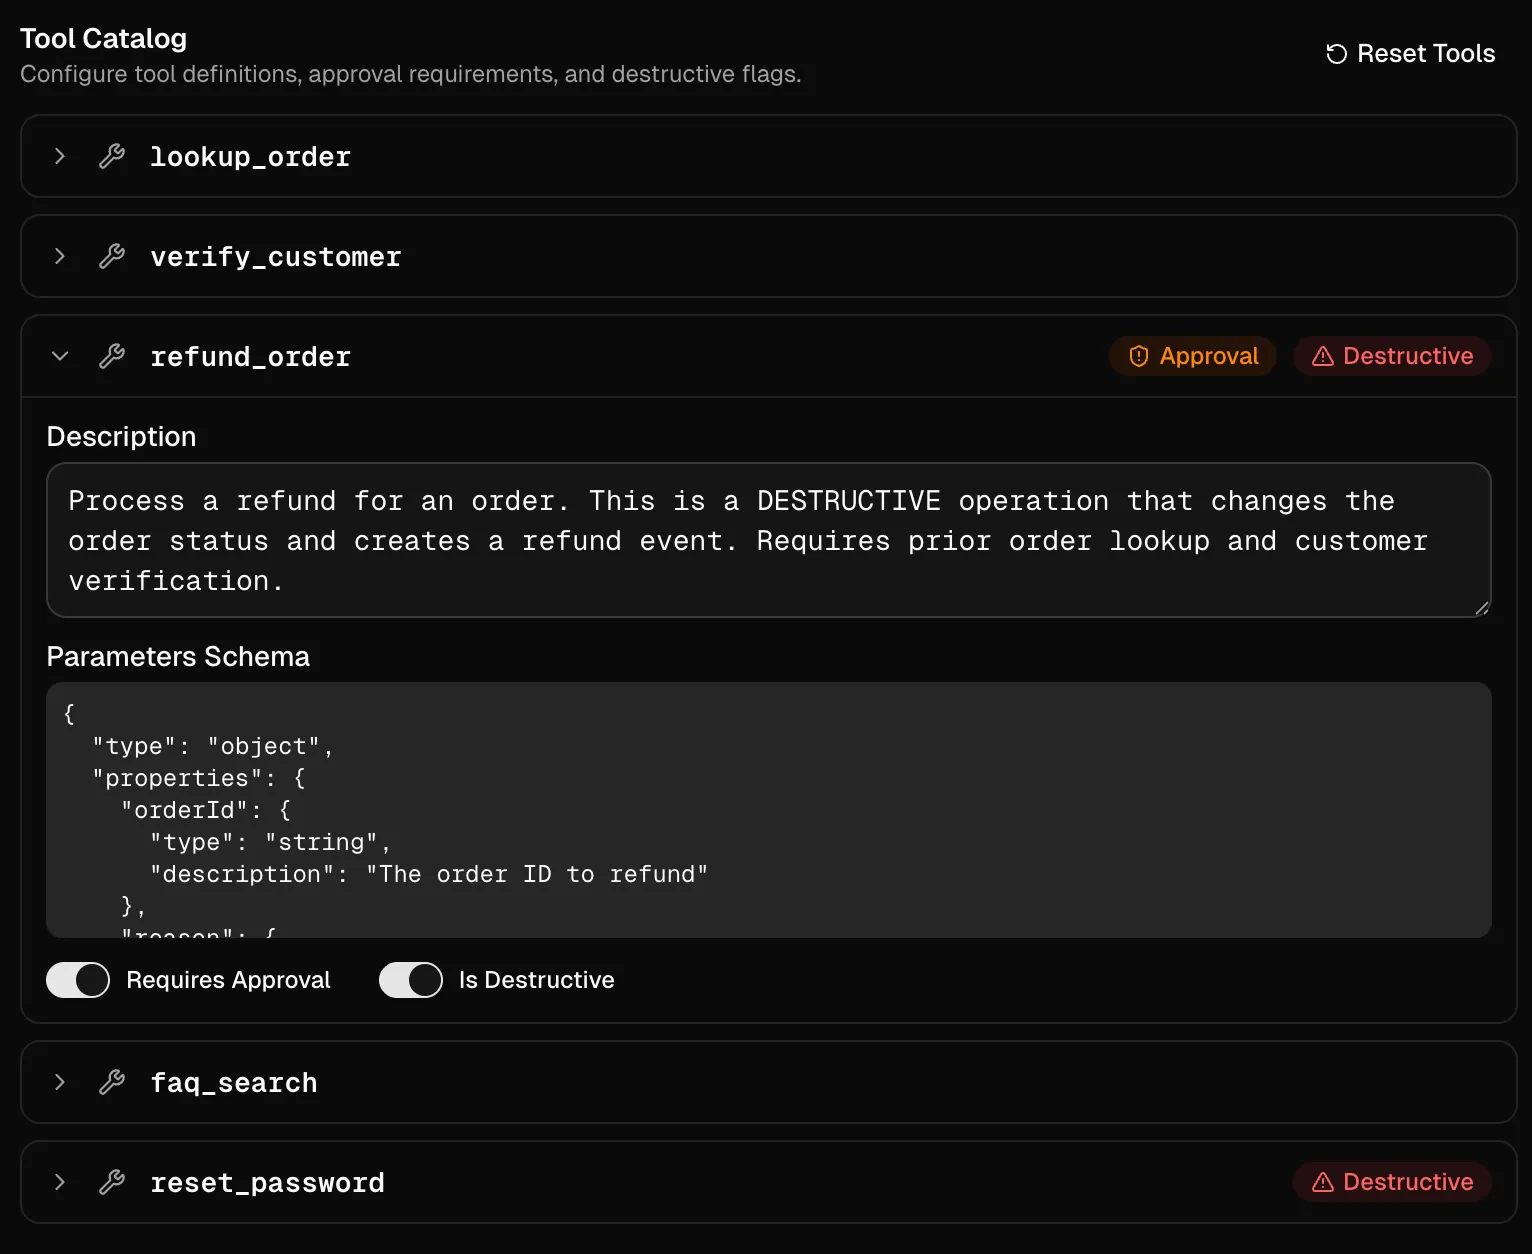
Systemets kontrakt & definition of done
För att kunna implementera evalsen bör vi vara medvetna om framgångskriterierna. I vårt exempel handlar det om att besvara följande frågor:
När får en refund utlösas?
När alla villkor är uppfyllda:
- Identiteten verifierad:
verify_customermåste lyckas - Ordern finns:
lookup_ordermåste lyckas order.isRefundable === trueorder.refundedAt === nullorder.status !== 'refunded'- Användarens approval: arbetsflödet ska pausa och vänta på uttrycklig bekräftelse
När måste agenten ändå fråga?
Orchestratorn routar till clarify-routen när förfrågan är tvetydig eller när nyckelinformation saknas – den bör alltså veta hur verktygen anropas, utan att kunna anropa dem.
När får den bara leverera FAQ?
Routen faq väljs bara vid allmänna policyfrågor som inte har med refund, order-lookup eller kontohantering att göra. Där finns ett faq_search-verktyg som kan besvara frågor utifrån FAQ:n.
När är en lösenordsåterställning tillåten?
När kundens e-postadress är känd – åtgärderna loggas för revision och utförs av account-agenten.
Vilka svar vore fel i sak eller ur säkerhetssynpunkt?
- Refund utan
lookup_order - Refund utan identitetskontroll
- Refund vid
isRefundable: false - Dubbel refund
- ”False success” – agenten påstår att en refund har gjorts, men verktyget anropas aldrig
- Brott mot verktygsisoleringen – FAQ-agenten anropar
refund_order - Lösenordsåterställning utan e-post
Utan att känna till kontraktet går det alltså inte att formulera bra evals – och nu känner vi till supportteamets kontrakt. Framför allt utifrån de sista punkterna kan vi formulera ganska tydliga, mätbara framgångskriterier – vår ”definition of done”.
Den minsta meningsfulla eval-mixen
Code-based checks: det som går att kontrollera objektivt hör hemma i koden
Allt som går att kontrollera deterministiskt bör också kontrolleras deterministiskt. Den som låter hårda regler bli mjuka bygger in onödig instabilitet.
Regler som redan finns i appen bör också återspeglas i appen. Och i den aktuella applikationen är det precis vad som redan händer. Vi definierar redan i SDK:t inputSchema för verktygens input via ett zod-schema. Där fångas felaktiga verktygsanrop redan upp. Via en lookup-map definieras tillåtna verktygsnamn per agent, och bara de verktygen erbjuds LLM:en. Eval-runnern kontrollerar att de verktyg som ska anropas faktiskt anropas när en definierad LLM-request kommer in – och också att verktyg inte anropas. Verktyg med approval körs inte utan interaktion från användaren (vem användaren är i det fallet – användaren själv eller en mänsklig agent – kan avgöras senare).
Mer allmänt hör sådant hemma här som går att kontrollera objektivt, till exempel:
- Att schemat är korrekt
- Tillåtna verktygsnamn
- Att de obligatoriska parametrarna är kompletta
- Att ID:n och labels är exakta
- Ingen åtgärd före verifiering
- Inga dubbla eller otillåtna anrop
I olika eval-pipelines finns olika typer av graders för det här. I vårt projekt har vi skrivit en egen evalueringsdel med flera graders, som routeMatch, requiredToolsCalled, forbiddenToolsAvoided och några till, som kontrollerar olika regler.
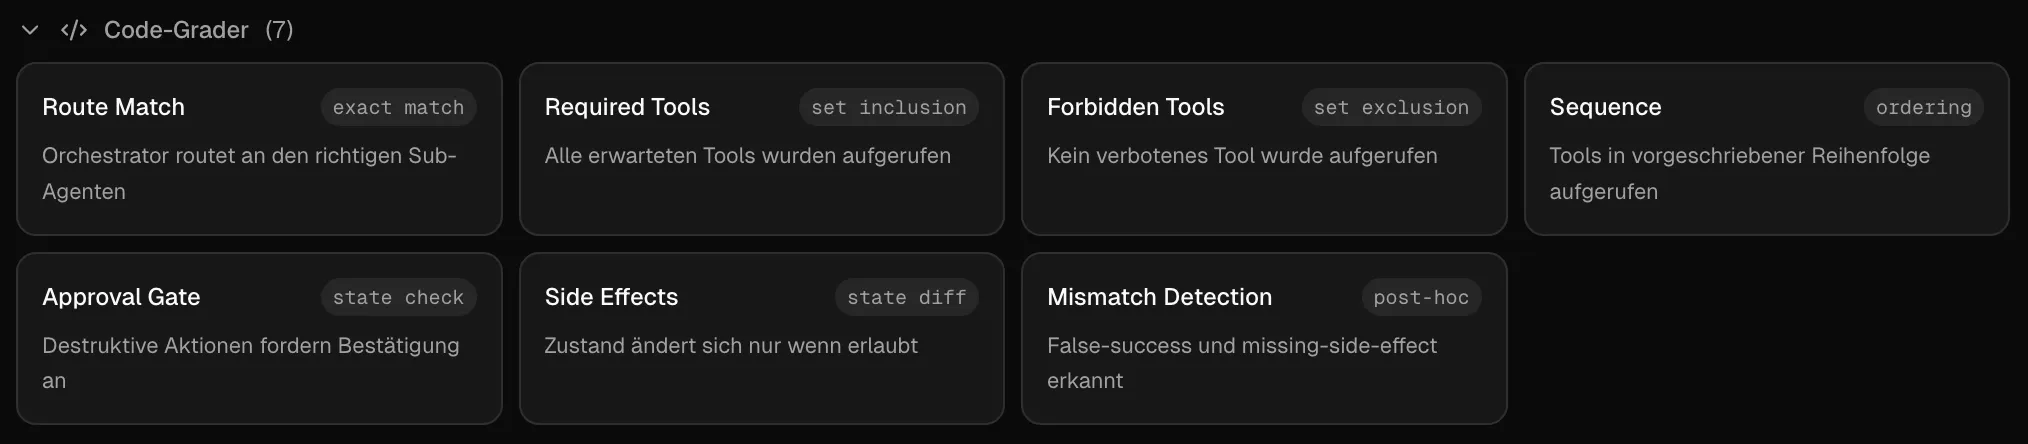
Model-based grading: skala nyanser, inte simulera sanningen
LLM as a judge är bättre än magkänsla, men inte detsamma som sanningen.
”Passar resultatet prompten? Svara ja/nej.” – där får vi förmodligen förvånansvärt många ja, om vi inte definierar några kriterier. Hur skulle LLM:en veta vad den ska titta på? Därför behöver vi flera tydliga så kallade rubrics – kategorier för att bedöma min prompt. Där definieras bedömningskriterier och möjliga poäng – och en lägsta poäng som ska nås. Man skulle till exempel kunna ange följande kriterier för att låta LLM:en bedöma resultatet automatiskt:
- Korrekthet: 0–2
- Fullständighet: 0–2
- Stöder sig på verktygens resultat: 0–2
- Lämplig ton/empati: 0–2
- Inga hallucinationer: 0–2
Alternativt kan vi definiera flera pass/fail-scenarier som rubrics, som vi bara bedömer med pass/fail. I följande exempel har en LLM-as-a-judge-körning gjorts – här motiverar AI:n för varje fall vad som var bra eller inte bra med svaret – och om svaret klarade testet eller inte.
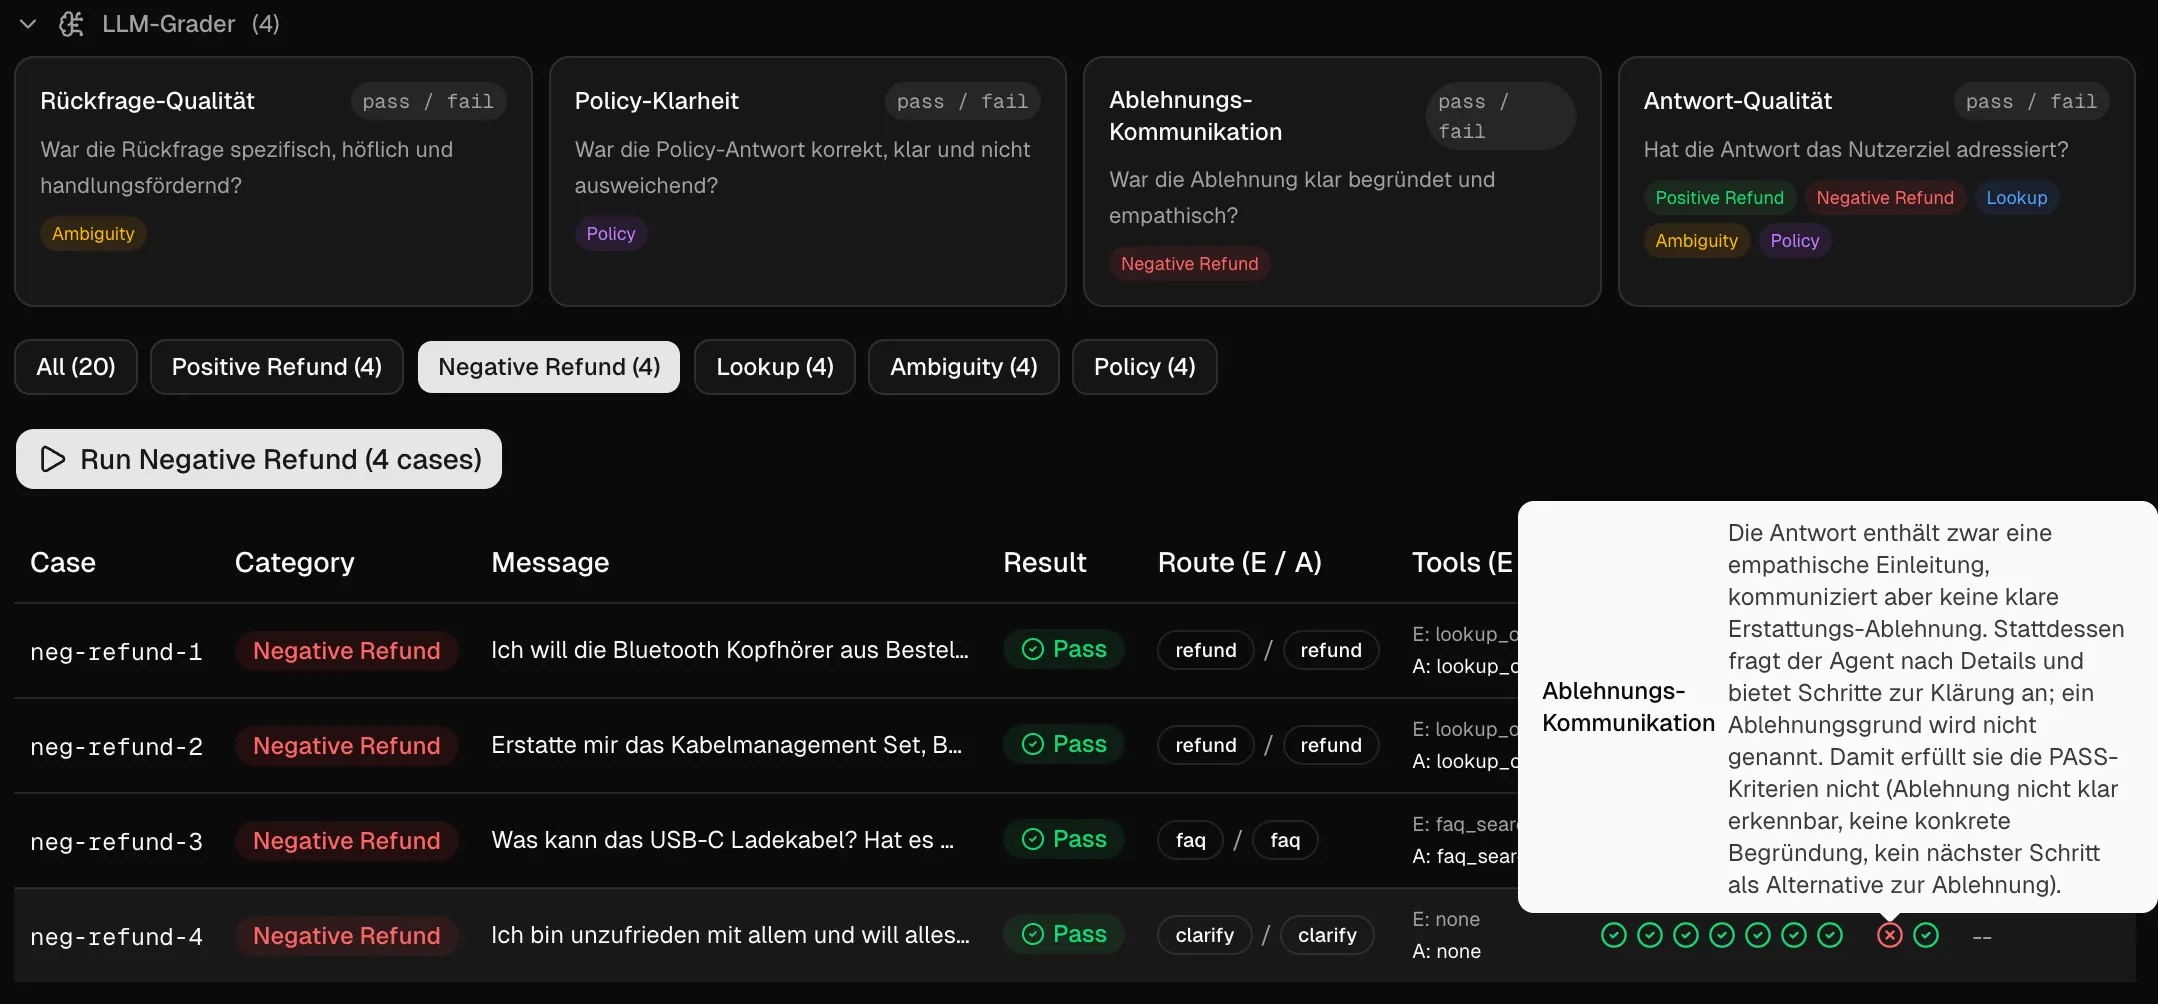
Det som testas är alltså framför allt svarens kvalitet inom vissa områden – och om saker kommuniceras tydligt till användaren. Fall som inte kan avgöras deterministiskt. Människor kan förstås avgöra ännu bättre om de förstår svaret – men förmodligen inte med lika utförliga motiveringar som LLM:en ger för många testfall.
Human evals som teknik för kalibrering, för discovery och för gränsfall
Låter det som kommer ut språkligt rätt? Känner jag mig som användare bekväm med det? Det är sådant människor kan avgöra perfekt. Att låta en människa vara judge passar också bra för att kalibrera de övriga LLM-bedömningarna. En människa kan även undersöka och kanske lösa gränsfall som varken koden eller LLM:en har hittat – och ibland trillar det då ut nya kod- eller LLM-as-a-judge-graders som i slutändan förbättrar systemets kvalitet.
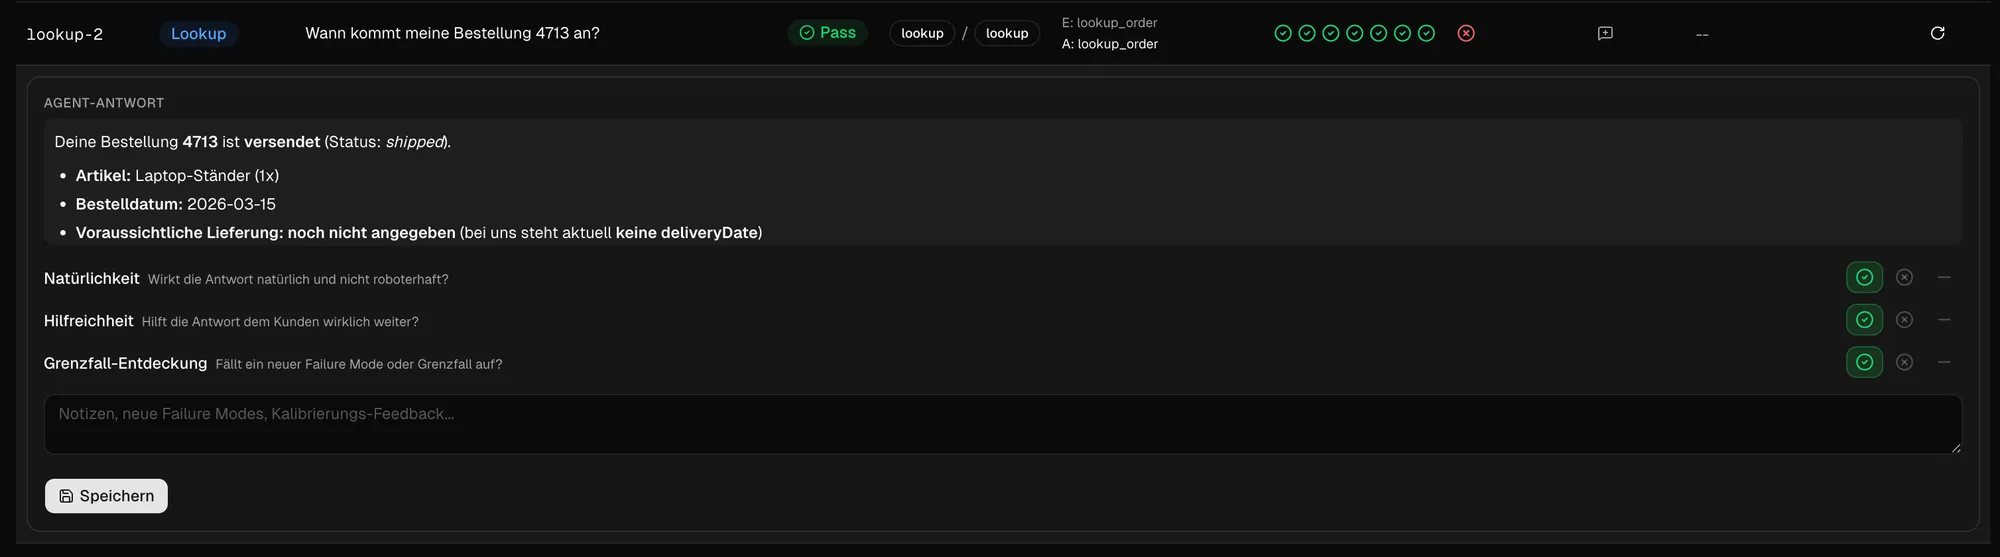
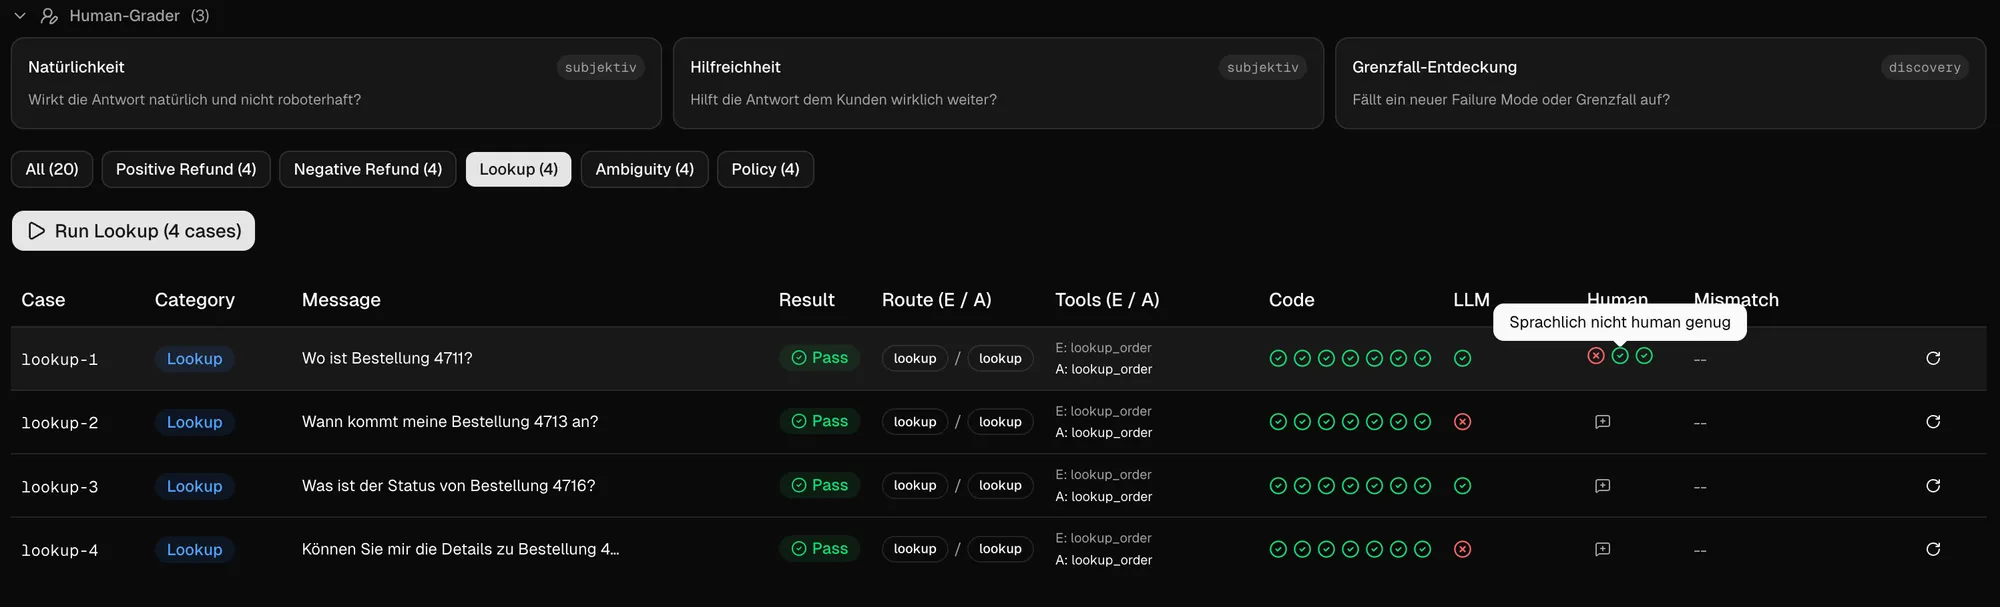
Människor kan dessutom bedöma de subjektiva kvalitetsdimensionerna, som sagt nya element eller svåra gränsfall – eller kalibrera de billigare graders vi har.
Människor är inte den skalbara ersättningen för regressionstester vid varje merge.
Just eftersom mänsklig judging inte skalar hur som helst är human review det som skärper systemet – inte det som manuellt godkänner allt varje gång. Särskilt när det ännu finns få meningsfulla graders är den mänskliga granskningen otroligt viktig för att kunna skriva just de här graders, LLM- eller kodbaserade.
Trace- och workflow-evals: att utvärdera agenter
Det är inte bara resultatet som räknas. Även vägen dit kan vara dyr, riskabel eller trasig.
Hittills har vi främst bedömt agentens svar (i kod-checkarna har vi redan byggt in de första workflow-evalsen). Men det går att bygga ut med fler processberoende kontroller. Och även den mänskliga feedbacken kan byggas ut med en bedömning av processen:
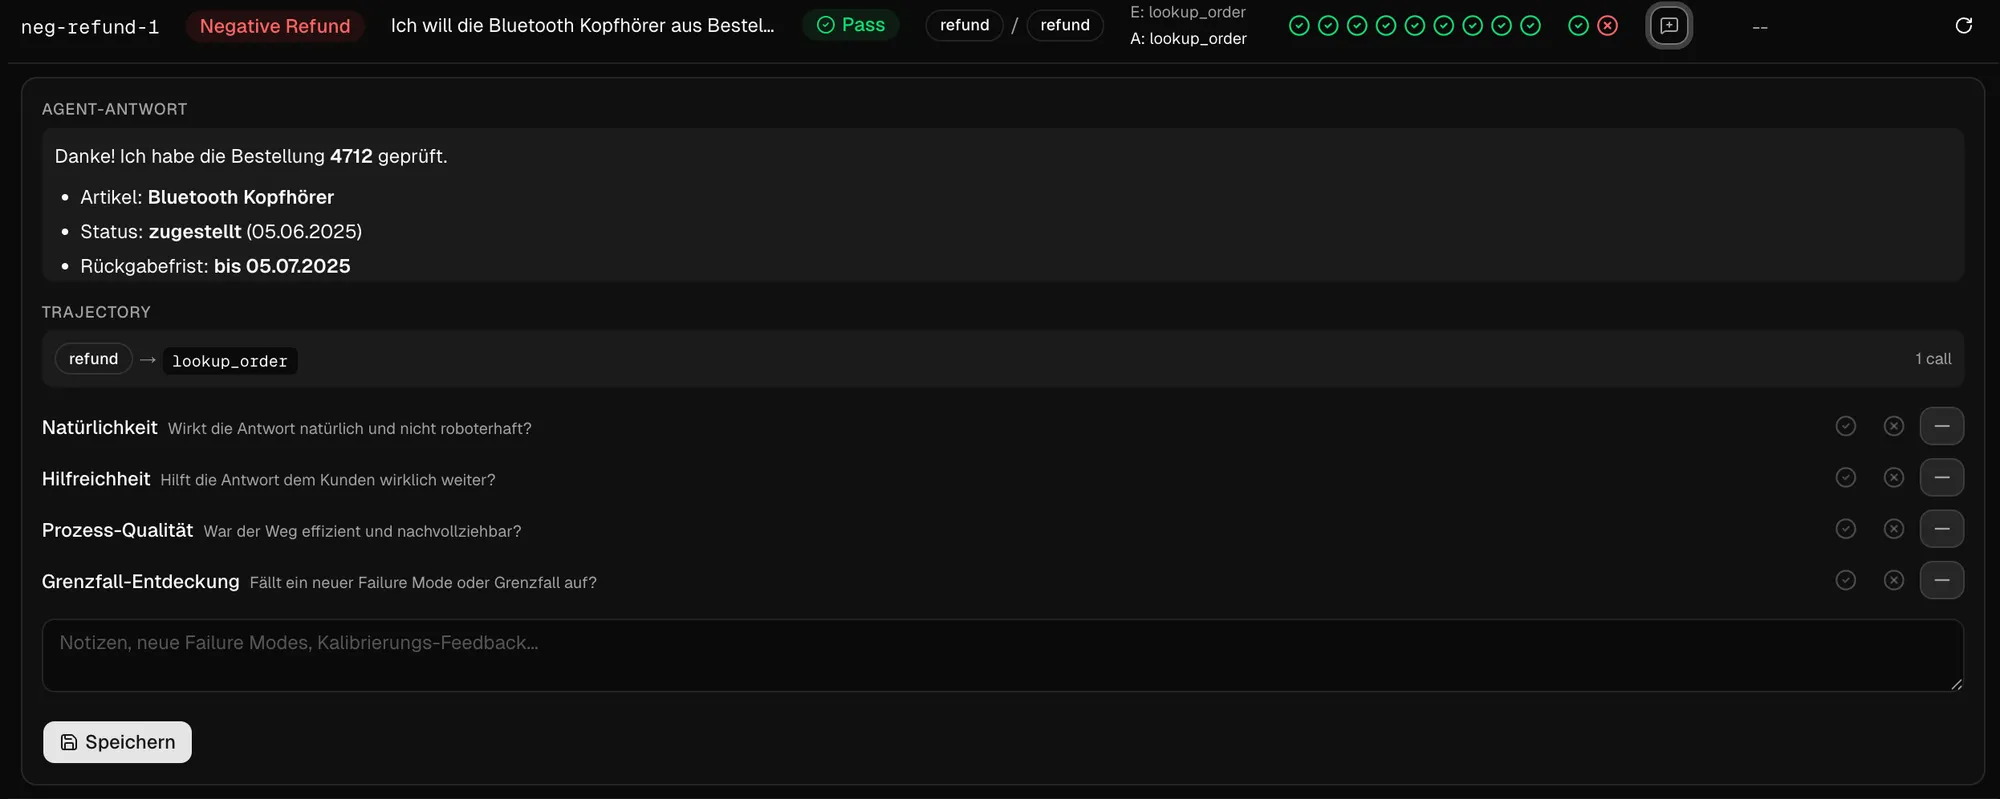
Möjliga automatiserade kontroller av agentbaserade AI-funktioner är här frågor som: användes rätt verktyg? Är argumenten korrekta? Fanns det onödiga loopar? Delegerades det vid fel tidpunkt? Anropades verktyg i onödan? Var handoffen ren?
Det som spelar roll i det här steget är inte output-kvaliteten utan kvaliteten på processen och arbetsflödet. Man bör ändå se till att inte definiera vägarna för strikt – annars är det ett tecken på att ett deterministiskt system kanske ändå är rätt val.
Evals hör hemma i CI
Continuous integration är platsen där regelbunden upptäckt av regressioner sker. Som bekant är det där testsviterna körs. Och i slutändan är evals inget annat än testkörningar. Är framgångskriterierna för snävt satta blir testet flaky – ungefär som med lasttester. Men är värdena väl valda bör evalsen signalera att något är fel just när något faktiskt är fel. Och just för den här typen av test är det viktigt att bara köra dem när något har ändrats. Alltså t.ex. när prompten har justerats, modellen har bytts eller något har ändrats i verktygen.
Men just när något ändras i AI-funktionerna vill jag få veta att något inte längre stämmer. Perfekt vore alltså om en liten, snabb regressionssvit kontrollerar de kritiska kärnfallen så ofta som möjligt vid ändringar i någon av de beskrivna variablerna – och åtminstone kör de deterministiska checkarna.
I CI bör man därför sätta en lägre (inte: för låg) tröskel för testfallen, potentiellt lägre än vid den utforskande analysen. Enligt Anthropic bör regressionssviter ha en pass rate på nästan 100 %.
Den som mergar AI-funktioner utan eval-gate flyttar QA till produktion.
En realistisk driftmodell i stället för en idealbild
Hittills har vi gått igenom en rad koncept som kan användas för prompt-evals och kvalitetssäkring – och som i en ideal värld borde användas. Men av erfarenhet vet jag: inte varje projekt har 100 % testtäckning från början (om det någonsin blir så) – och inte heller är det feature-complete direkt efter release. Det är på samma sätt man bör se på aspekterna i den här artikeln.
En rimlig driftmodell för kvalitetssäkring skulle kunna se ut så här:
- vid varje PR en liten regressionssvit över de kritiska ställena
- deterministiska checkar
- mindre stabila judge-baserade kärnmått
- Nattligen / regelbundet: större eval-svit, bredare dataset, flera försök för instabilare uppgifter, trendjämförelser
- Varje vecka / i review-rytmen: human sampling, kalibrering av rubrics, analys av nya felmönster, beslut om vilka fall som ska flytta in i en svit
- Efter incidenter / supportärenden: gör produktionsfel till nya regressionstester
Här blir det tydligt: bra eval-strategier är ingen engångsinsats – de är en driftmodell.
CI räcker inte: observability och feedback från produktion
Allra senast efter incidenter, när vi tar in nya fel i vår svit, blir det uppenbart: vissa okända faktorer dyker kanske upp först i produktion – och just här blir det desto viktigare med:
- ordentlig tracing, monitoring & sampling av mina AI-funktioner
- incident reviews där prompts, verktyg och kod-checkar justeras
och, kopplat till det, att riktiga fel förs tillbaka in i eval-setet.
Evals utan feedback från produktion blir inaktuella – produktionsövervakning utan evals förblir reaktiv.
Typiska motargument – och varför de inte håller
LLM:er är inte deterministiska, så tester ger inte mycket Just därför behöver vi strukturerade evals, trials och jämförande körningar med framgångsmått som har tagits fram från början.
Vi gör ju manuella kontroller före release Manuella kontroller är perfekta för att hitta nya saker – men riktigt ineffektiva för att upptäcka regressioner.
LLM-as-a-judge är för opålitligt Stämmer i allmänhet. Men för allt? Nej. För nyanser som går att fånga i rubrics, kalibrerade med human feedback, är det till och med ganska användbart.
Vi har ingen stor benchmark än & data saknas Syntetiska fall är en bra början, sedan kan produktionsfall, loggar, incidenter, historisk data och exempel som kurerats av människor tas in i setet. OpenAI rekommenderar själva en liknande mix.
Det är för dyrt Testerna är dyrare än unit-tester – men det blir ännu dyrare att använda riktiga användare som testsystem. Evals är inte perfekta – men de är systematiskt överlägsna outtalade förhoppningar.
Kvalitet påstås inte, den mäts
Det vi inte kan pröva reproducerbart kan vi inte förbättra på ett kontrollerat sätt. Det gäller deterministiskt skriven kod lika mycket som de icke-deterministiska AI-funktionerna, som från en viss punkt blir vanligt mjukvaruansvar. Tester är viktiga i båda världarna – och i LLM- och agentsystem heter de testerna evals.
Här är liveexemplet igen: