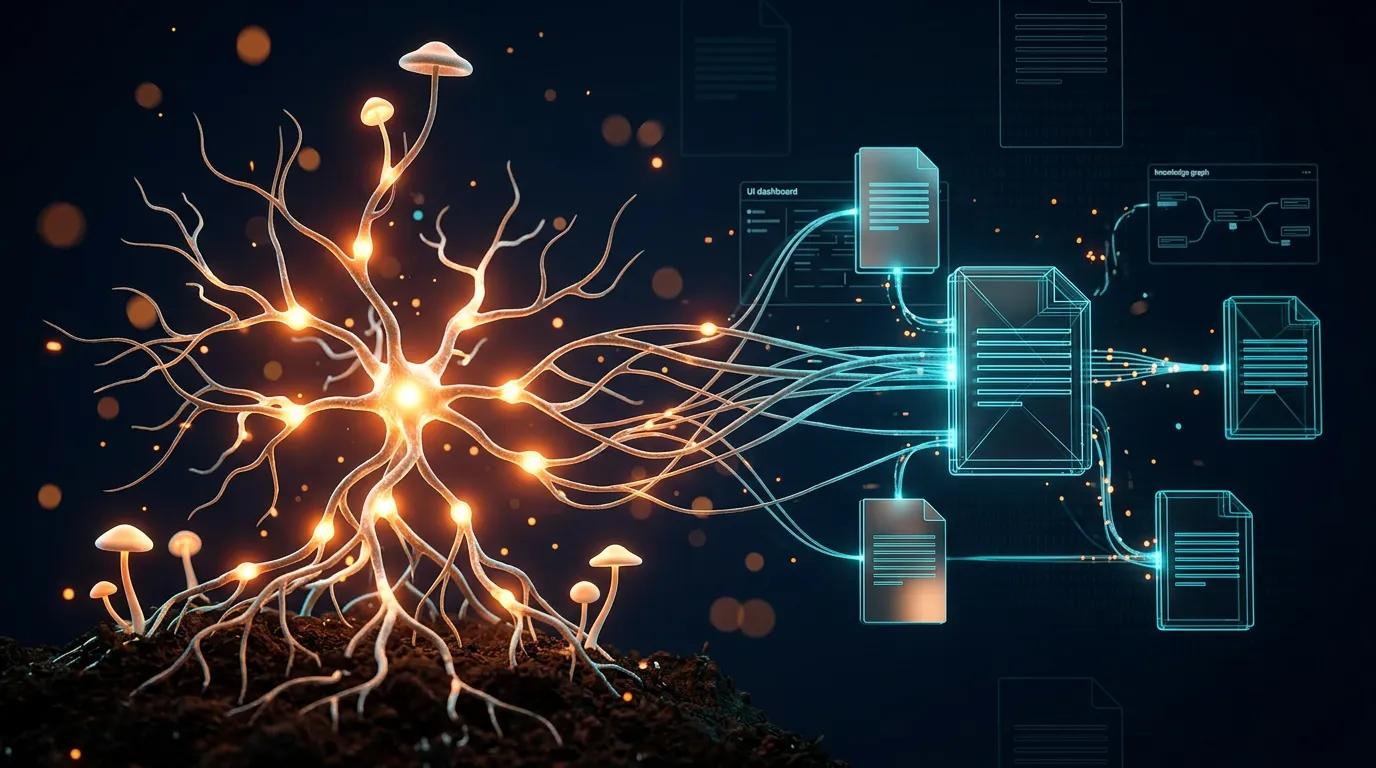
Accumuler du savoir n’a jamais été le problème. Le mobiliser au bon moment, si.
J’ai passé des années à accumuler du savoir. D’abord Notion avec un Second Brain, proprement structuré selon PARA et CODE. Puis le passage à Obsidian : des centaines de notes Markdown, des liens, des Daily Notes, des backlinks. La capture rapide depuis le téléphone fonctionne désormais ; la consultation mobile reste un concept en suspens.
Les outils se sont améliorés. L’entretien est resté mon goulot d’étranglement. Ce n’était pas la faute de l’outil, c’était que j’avais en permanence un train de retard : capturer, j’y arrive ; condenser, relier, faire le tri, non.
Ce n’est pas un échec personnel. C’est structurel. Et c’est précisément là que quelque chose est en train de bouger dans mon setup, pas parce que je serais devenu plus discipliné, mais parce que la division du travail a changé.
Pourquoi le PKM classique échoue structurellement
Les méthodes ne sont pas fausses. Elles ont simplement été conçues pour un monde où le savoir était rare et l’attention abondante. Aujourd’hui, c’est l’inverse.
Le Zettelkasten fonctionne, si vous êtes Luhmann
Niklas Luhmann a laissé environ 90 000 fiches, sur lesquelles repose pratiquement toute sa sociologie. En 2017, Sönke Ahrens a mis le système par écrit pour le reste du monde dans « How to Take Smart Notes » : atomicité, liens, reformulation avec ses propres mots, notes fleeting/literature/permanent. Ces termes sont d’ailleurs un ajout d’Ahrens ; Luhmann lui-même ne les a jamais utilisés.
Les principes sont justes. Le problème, c’est l’exécution. L’« effet Evernote », tel que le décrit zettelkasten.de, frappe tout système qui grandit : plus vous accumulez, plus l’entretien dévore d’énergie, jusqu’à ce que le retour ne justifie plus la maintenance. Qui, parmi nous, a 30 minutes par jour pour condenser ses pensées ? Voilà.
Le Second Brain a diagnostiqué son propre problème
Avec « Building a Second Brain » (CODE : Capture-Organize-Distill-Express, PARA : Projects-Areas-Resources-Archive), Tiago Forte a marqué toute une génération. Et il a lui-même nommé le problème du cimetière à notes, en substance : un Second Brain ne doit pas être un entrepôt, mais une usine qui transforme les idées en résultats concrets. Forte le formule ainsi : « information only becomes knowledge when we put it to use ».
Le diagnostic est précis. Seulement, la solution exige de nouveau de la discipline humaine. Distill et Express, c’est du travail. Beaucoup de travail. Et c’est précisément sur ces deux étapes que le système échoue en pratique, pas sur la capture.

Des outils modernes, une vieille division du travail
Obsidian, Notion, Tana : tous ont reçu des fonctionnalités d’IA ces deux dernières années. Smart Connections trouve des voisins sémantiques. Copilot for Obsidian répond à des questions sur le vault. Notion AI fournit une couche de requêtes qui, souvent, ne comprend pas les relations entre bases de données et ne voit même pas les embeds externes. Tana va le plus loin avec ses Agent Nodes, ses déclencheurs et ses Supertags. Mais Tana aussi fonctionne à base de règles, sans raisonnement autonome.
Ce sont tous des assistants. Aucun d’eux n’est mainteneur. Aucun n’écrit de nouvelles notes sans qu’on le lui demande, ne condense des thèmes, ne repère des contradictions entre anciennes et nouvelles idées ou n’archive le matériel dormant. Le travail vous reste sur les bras ; les outils le rendent seulement plus confortable.
L’angle mort commun
Zettelkasten, Second Brain ou outillage PKM moderne, peu importe : chacune de ces méthodes suppose un mainteneur humain discipliné. Quelqu’un qui range, relie, condense et trie régulièrement. Il existe en théorie. En pratique, il y a là un travailleur du savoir à l’agenda plein, déjà content s’il arrive à capturer quoi que ce soit.
Ce ne sont pas les méthodes qui ont échoué. C’est l’hypothèse selon laquelle l’humain peut être à la fois auteur, curateur et archiviste.
Le problème, ce ne sont pas les étagères. Ni les tags, ni les liens, ni les dossiers. Le problème, c’est la répartition des rôles. Et c’est exactement là qu’il faut reprendre les choses.
Mycel : la nouvelle division du travail
Quand les mainteneurs sont rares, c’est le rôle qui doit disparaître, pas le travail. C’est précisément le basculement intellectuel qu’Andrej Karpathy a résumé dans un post le 2 avril 2026 : les LLM comme curateurs de bases de connaissances personnelles. Près de 20 millions de vues, et peu après un gist avec l’esquisse de l’architecture. Karpathy y décrit son propre wiki : une centaine d’articles, environ 400 000 mots, entièrement compilés et entretenus par le LLM. Lui-même n’y touche presque plus.

L’architecture que j’ai développée en parallèle pour moi, puis affûtée à l’aide de l’esquisse de Karpathy, repose sur trois couches :
raw/- les sources immuables. Articles, transcriptions, captures d’écran, papers. Ici, le LLM ne fait que lire. Il n’écrit jamais.wiki/- le savoir compilé. Des Source-Pages par source, des Entity-Pages par personne/organisation/produit, des Concept-Pages par idée, des Synthesis-Pages qui tissent ensemble plusieurs sources, et des Question-Pages qui suivent les questions ouvertes. Entièrement écrit par le LLM.- Schéma/skills - les règles selon lesquelles on travaille. Quels types de pages existent, comment on fait les liens, à quoi ressemble un bon format de Concept-Page. Le schéma est vivant et s’affûte à chaque ingestion.
La différence avec le PKM classique, ce n’est pas « plus d’automatisation ». C’est une autre répartition des rôles. Je décide de ce qui entre et des questions que je pose au matériel. Le LLM distille, relie, entretient.
Pourquoi Mycel ?
Parce que la métaphore est précise. Le mycélium est le réseau souterrain de filaments d’un champignon. Il absorbe les nutriments, se connecte à tout ce qui est à sa portée et finit par former des fructifications : les champignons visibles, que nous prenons pour « le champignon ».
| Biologie | Système de connaissances |
|---|---|
| Absorber les nutriments | Ingérer des sources (raw/) |
| Les hyphes se connectent | Wikilinks entre les pages |
| Croissance organique | Chaque ingestion densifie le réseau |
| Fructifications | Synthèses et concepts comme résultats visibles |
| Symbiose | L’humain fait la curation, la machine compile |
Deux de ces propriétés portent toute l’architecture :
Une croissance composée. Le mycélium ne croît pas de façon linéaire, il croît de façon exponentielle. Dans ma pratique, une nouvelle source touche typiquement 5 à 20 pages existantes : elle met à jour des Entities, affûte des Concepts, ouvre ou ferme des Questions. La valeur ne réside pas dans le nombre d’entrées, mais dans la densité des liens. Compound plutôt que completeness.
Une infrastructure invisible. L’essentiel d’un mycélium se trouve sous terre. Ce qui a le plus de valeur dans le wiki, ce n’est pas le résumé isolé que je vois en surface. C’est le réseau de renvois, de contradictions entre sources et de questions ouvertes entre les deux. Les fructifications (synthèses, Concept-Pages) n’en sont que la partie émergée.
L’humain ne fait pas moins de curation. Il la fait autrement : au niveau des questions, pas au niveau des fiches.
C’est ça, la rupture. Je n’entretiens plus des notes, j’entretiens la direction. Qu’est-ce qui m’intéresse en ce moment ? Quelles questions sont ouvertes ? Où sont les contradictions ? Le LLM prend en charge la partie que les humains, structurellement, n’arrivent pas à faire passer à l’échelle : mettre à jour systématiquement tous les liens, chaque fois que du nouveau matériel arrive quelque part.
Reste une question qui s’impose dès qu’on a vu le système une fois, surtout pour celles et ceux qui ont déjà construit avec des LLM : si le LLM compile un wiki à partir du dossier raw/, est-ce que ce n’est pas simplement du RAG avec des étapes en plus ?
Le Compiled Knowledge n’est pas du RAG
Avant d’en venir au vrai sujet (retrouver son savoir), un petit détour technique s’impose. Sinon, la question du RAG reste en suspens, et elle mérite une réponse claire. Non, ce n’est pas du RAG. La différence ne tient pas au nombre d’étapes, mais au moment de la synthèse. Le RAG réfléchit au moment de répondre. Le Compiled Knowledge a déjà réfléchi avant que la question soit posée.
Avant d’aller plus loin : « Compiled Knowledge » n’est pas un terme technique établi. Vous ne le trouverez dans aucun manuel, et même dans la communauté LLM, ce n’est pas un terme consacré. Le cadrage remonte essentiellement à l’analogie du compilateur de Karpathy, en avril 2026 : les sources brutes sont traitées comme du code source, on compile d’abord, on exécute ensuite. Le résultat est plus dense, plus structuré, plus rapide à consulter. Je reprends le terme parce qu’il résume bien le principe.
Ce que fait réellement le RAG
Le RAG découpe les documents en chunks, fait passer chaque chunk dans un modèle d’embedding et range les vecteurs dans un vector store. Lors d’une requête, la question est elle aussi transformée en embedding, le store renvoie les chunks les plus similaires, et le LLM reçoit ces fragments comme contexte. Tout se passe en juste-à-temps. Le vrai travail de réflexion (qu’est-ce que ça signifie, comment ça s’articule, où ça se contredit) est délégué au modèle, à nouveau, à chaque requête.
Je parle ici du RAG classique, non agentique. Les approches modernes de recherche hybride, de re-ranking ou d’Agentic RAG brouillent la frontière : la différence devient alors une question de degré, pas de principe.
Ce que le Compiled Knowledge fait autrement
La synthèse a lieu à l’ingestion, pas au moment de répondre. Une nouvelle source n’est pas bêtement découpée et vectorisée : elle est lue, distillée et explicitement reliée au réseau existant. Il en sort des pages Markdown structurées, avec des renvois, des questions ouvertes et des contradictions documentées. Le travail coûteux est déjà fait au moment de l’absorption. La requête va chercher des idées toutes prêtes, pas des ingrédients bruts.
Les différences en pratique
Le RAG trouve un chunk similaire. Le Compiled Knowledge livre une page toute faite qui a déjà mis en relation la source A et la source B, y compris les endroits où elles se contredisent. Et pendant que le RAG repart de zéro à chaque requête, chaque nouvelle source enrichit encore le réseau composé : chaque renvoi augmente la valeur des pages déjà présentes.
Là où le modèle atteint ses limites
Pour rester honnête : dans mon setup, Mycel tourne actuellement sans infrastructure d’embedding. Ça fonctionne tant que le réseau de connaissances reste gérable et que les liens sont proprement entretenus. Est-ce que ça passe à l’échelle de dizaines de milliers de pages ? Probablement pas sans approche hybride : le Compiled Knowledge comme base curée, les embeddings comme solution de repli en plein texte pour ce qui n’a pas encore été distillé. Je ne l’ai pas encore poussé à ses limites. Quiconque prétend qu’un seul modèle règle tous les cas cherche à vous vendre quelque chose.
Mais même un wiki compilé et parfaitement entretenu ne résout pas le vrai problème. Avoir une page qui contient exactement la réponse ne sert à rien si on ne l’ouvre pas au bon moment. Ranger, c’est la moitié du chemin. L’autre moitié, c’est retrouver.
30 pages bien reliées valent plus que 200 résumés isolés. Mais les deux ne valent rien s’ils ne sont pas présents au moment décisif.
Le vrai problème n’a jamais été d’accumuler
Nous avions tout résolu. Un wiki qui s’entretient tout seul. Une croissance composée au lieu d’une date de péremption. Plus de contradictions cachées sous le tapis, plus de trois notes à moitié cuites sur le même sujet, plus de cimetière de fichiers Markdown. Sur le papier, le problème était réglé.
Et pourtant.
J’avais entretenu, relié, synthétisé mon savoir, et dans les moments où ça comptait, il ne me revenait pas. En réunion, dans la décision d’architecture, pendant une code review vite faite. Il n’était pas là. Il était dans le wiki, bien rangé, parfaitement lié, et ne m’aidait strictement en rien.
Mobiliser un savoir et le stocker sont deux disciplines différentes. C’est le constat qui dérange. Stocker est asynchrone, contrôlé, au calme. Mobiliser se passe sous pression, au milieu d’une conversation, à la seconde où la décision tombe.
Le débat classique sur le PKM a un angle mort : il tourne presque exclusivement autour de l’input. Comment j’organise ? Quel système ? Atomic Notes ou Folgezettel ? Tags ou dossiers ? L’autre moitié (qu’est-ce que je ressors, et dans quelle situation ?) reste sans réponse. Comme si retrouver allait de soi, simple sous-produit d’un bon rangement. Ce n’est pas le cas.
Avec les outils de pensée, ça devient douloureusement concret. Je connais l’inversion. Je connais le second-order thinking. Je connais Ishikawa, le pre-mortem, le coût d’opportunité. J’ai lu des livres là-dessus, pris des notes, je les ai reliées. Et pourtant, je ne les applique pas quand j’en aurais besoin.
Les modèles mentaux activent la pensée de Système 2 : lente, consciente, analytique. Seulement, sous pression, c’est le Système 1 qui prend la main. Rapide, réflexe, guidé par des schémas. C’est du moins la lecture populaire de Kahneman. Le livre sur l’étagère n’aide pas en réunion. La note dans le wiki n’aide pas dans la discussion sur la pull request. Et c’est exactement le fossé que le PKM classique n’a jamais traité : entre « je connais le concept » et « je l’utilise au bon moment ».
La conséquence est inconfortable, mais claire. Accumuler plus de savoir ne résout pas ce problème. Mieux l’organiser non plus. Même un wiki Mycel parfaitement entretenu par un LLM reste passif : il attend que je l’interroge. Et c’est justement ce que je ne fais pas au moment décisif.
Ce qu’il faut, c’est autre chose : des outils de pensée disponibles au bon moment. Pas sous forme de livre, pas sous forme de note, pas sous forme de chapitre dans le wiki. Sous forme de skill à la demande.
Accumuler du savoir, c’est la moitié du chemin. Le mobiliser au bon moment, c’est le reste, et c’est la partie la plus difficile.
Des outils de pensée à la demande
« Skill à la demande », ça sonne abstrait, alors je vais être concret : un outil de pensée ne devient un outil que s’il est à portée de main dans la situation où j’en ai besoin. Pas dix minutes plus tard. Pas après le rendez-vous. Pas le soir, quand je réalise que ce matin, j’aurais dû inverser le problème.
C’était exactement mon problème avec les frameworks pendant des années : je les connaissais. Je les avais même notés et distillés, sagement, selon CODE. Et pourtant, au moment de la décision, ils n’étaient pas là.
untools.co comme matière première

Adam Amran, designer produit tchèque, rassemble sur untools.co plus de 25 outils de pensée répartis en quatre catégories : Decision Making, Problem Solving, Systems Thinking et Communication. La mission est décrite sobrement : « Collection of thinking tools and frameworks to help you solve problems, make decisions and understand systems. »
En simple favori, le site est inutile. Comme matière première ingérée dans mon Mycel (une Concept-Page par outil, plus un skill Claude par outil, plus une Synthesis-Page qui sert d’aiguilleur), c’est autre chose.
Inversion
Ne demandez pas « comment atteindre X ? », mais « comment pourrais-je empêcher X à coup sûr ? ». La liste de ce qu’il faut éviter est souvent plus concrète que la liste des chemins possibles. Usage typique : pre-mortem avant une décision.
Second-order thinking
« And then what? » Ne pas s’arrêter à la première conséquence, mais penser aussi aux effets en cascade. Utile quand une décision a l’air manifestement bonne : c’est généralement le signal qu’il faut pousser la réflexion au moins deux niveaux plus loin.
Issue trees
Décomposition d’un problème en sous-problèmes, structurée selon le principe MECE, puis focus 80/20 sur les branches qui offrent le plus de levier. Utile quand un problème semble trop gros pour qu’on ose s’y attaquer.
Matrice d'Eisenhower
Quatre quadrants formés par l’importance et l’urgence. Elle a été popularisée par Stephen Covey dans « 7 Habits » (Habit 3 : Put First Things First). Ça a l’air banal, mais c’est le filtre le plus précis que je connaisse pour planifier une semaine, surtout pour nommer honnêtement ce qui est « urgent, mais pas important ».
Le basculement décisif
L’aiguilleur fonctionne comme une couche de routage. Je décris la situation : « Le problème est trop complexe, je ne sais pas par où commencer. » Suggestion : Issue Trees. « Je ne vois que des solutions idéales. » Suggestion : Inversion. « La décision me paraît bonne un peu trop vite. » Suggestion : Second-order thinking.
Je n’ai plus à savoir quel outil il me faut. Je dois seulement décrire ma situation. Le reste, c’est de l’aiguillage, et c’est l’assistant qui s’en charge.
Un framework que je ne peux pas mobiliser au bon moment n’est pas un outil. C’est un souvenir.
Intégration dans les routines : la Progression Phénix
Ma propre routine de productivité, que j’appelle la Progression Phénix, combine le principe du 12-Week-Year de Moran et Lennington (« In 12 weeks, there just isn’t enough time to get complacent, and urgency increases and intensifies. ») avec un rythme cyclique à cinq échelles de temps : Ère (5 ans), Cycle (6 mois), Tempête de feu (12 semaines), Feu d’une semaine (1 semaine), Flamme (2 heures).
Chaque niveau a ses propres rituels. Et c’est précisément sur ces rituels que les outils de pensée viennent se greffer.
Pour une Flamme (un bloc de deep work de 2 h), on me propose au démarrage des méthodes adaptées à la situation. Pour les revues du Feu d’une semaine, d’autres. Pour la rétrospective de la Tempête de feu, c’est l’inversion qui m’est suggérée, en guise de pre-mortem pour le cycle suivant. Dans la planification de la journée, la matrice d’Eisenhower entre en jeu quand la liste devient trop longue. Dans la planification du cycle, ce sont les First Principles, quand je remarque que je ne fais que prolonger mes objectifs au lieu de les repenser.
Je ne vais pas chercher tout cela. Le skill s’invite quand la situation s’y prête : la méthode pousse hors du Mycel comme une fructification, au bon moment.
La différence est subtile, mais décisive : l’effort cognitif qui consiste à penser au bon framework disparaît. Le framework n’est plus sur l’étagère. Il est dans la situation, sous forme de skill chargé quand le contexte s’y prête.
Plus de « si seulement j’avais pensé à l’inversion ». Plus besoin de relire de vieilles notes. L’effort de me souvenir, c’est le skill qui s’en charge.
Ça a l’air abouti. Ça ne l’est pas.
Ce qui est en train de changer, et ce qui ne fonctionne pas (encore)
Ce que je décris plus haut est une négociation en cours, pas une solution de productivité bouclée qu’on pourrait copier.
Ce qui est en train de changer
Prendre des notes n’a plus la même saveur. J’accumule moins. Pas parce que je lis moins, mais parce que je sais que le mainteneur LLM condense au moment de l’ingestion. Je n’ai plus besoin de consigner chaque passage mot pour mot pour pouvoir le retrouver plus tard. Ça change ce que je juge digne d’être noté.
Penser en frameworks est devenu plus facile. Pas parce que je connais plus de frameworks, mais parce qu’ils apparaissent au bon moment. Un skill de dialectique qui se manifeste quand je dois prendre une décision, ce n’est pas la même chose qu’un livre sur l’étagère que je devrais consulter activement.
Des connexions apparaissent que je n’aurais jamais vues. À l’ingestion naissent des wikilinks auxquels je ne serais pas arrivé seul. Certains sont triviaux, d’autres changent la manière dont je situe un sujet. C’est la partie qui ressemble le plus à de la compilation et le moins à de la recherche.
Et il reste des questions ouvertes. Comment ça passe à l’échelle au-delà de 500 pages, quand les connexions croissent de façon exponentielle ? Que se passe-t-il si je veux changer le schéma en profondeur : le mainteneur migre-t-il le wiki, ou repart-il de zéro ? Je ne sais pas.
Ce n’est pas un système de productivité fini qu’on copie. C’est une négociation en cours entre moi et une machine de plus en plus douée pour condenser le savoir. Et de plus en plus douée pour me décharger d’un travail que je ne devrais peut-être pas céder du tout. Le levier, c’est la division du travail. Je décide de ce qui est important, de ce qui reste, de la direction que prend l’ensemble. La machine distille, relie, met à disposition selon la situation. Tenir cette frontière demande du travail, et c’est ça, la vraie tâche.
L’enjeu n’est pas d’en savoir plus. L’enjeu, c’est d’avoir la bonne chose en tête au bon moment.
L’humain fait la curation, la machine compile.