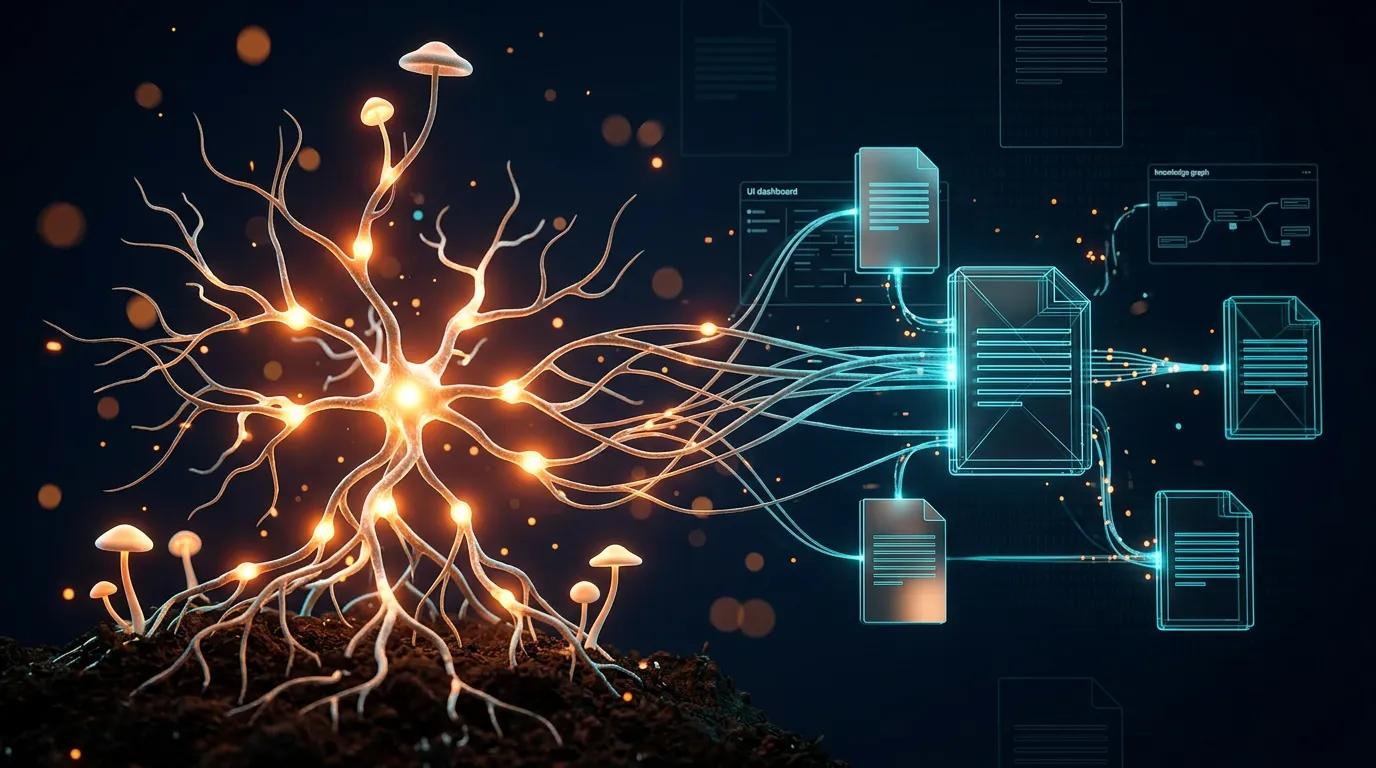
Å samle kunnskap var aldri problemet. Å aktivere den i riktig øyeblikk - det er problemet.
Jeg har brukt år på å samle kunnskap. Først Notion med Second Brain, pent strukturert etter PARA og CODE. Så byttet til Obsidian - hundrevis av Markdown-notater, koblinger, Daily Notes, backlinks. Quick Capture fra mobilen fungerer etter hvert, mens det å hente fram ting på mobilen fortsatt ikke er løst.
Verktøyene ble bedre. Vedlikeholdet forble flaskehalsen min. Det var ikke verktøyets skyld - det var fordi jeg hele tiden lå på etterskudd: å fange opp ting klarer jeg, men å fortette, koble og rydde bort klarer jeg ikke.
Det er ikke et personlig nederlag. Det er strukturelt. Og det er akkurat her noe er i ferd med å flytte seg i oppsettet mitt - ikke fordi jeg har blitt mer disiplinert, men fordi arbeidsdelingen har endret seg.
Hvorfor klassisk PKM svikter strukturelt
Metodene er ikke feil. De er bare bygget for en verden der kunnskap var knapp og oppmerksomhet var rikelig. I dag er begge deler snudd på hodet.
Zettelkasten fungerer - hvis du er Luhmann
Niklas Luhmann etterlot seg rundt 90 000 lapper, og praktisk talt hele sosiologien hans hviler på dem. Sönke Ahrens skrev ned systemet for resten av verden i 2017 i “How to Take Smart Notes”: atomicity, lenking, egne ord, fleeting/literature/permanent notes. Begrepene er forresten Ahrens’ utvidelse - Luhmann selv brukte dem aldri.
Prinsippene er riktige. Problemet er gjennomføringen. «Evernote-effekten», slik zettelkasten.de beskriver den, rammer ethvert system som vokser: Jo mer du samler, desto mer energi sluker vedlikeholdet - helt til avkastningen ikke lenger forsvarer innsatsen. Hvem av oss har 30 minutter hver dag til å fortette tankene sine? Nettopp.
Second Brain har diagnostisert sitt eget problem
Med “Building a Second Brain” (CODE: Capture-Organize-Distill-Express, PARA: Projects-Areas-Resources-Archive) satte Tiago Forte preg på en hel generasjon. Og han har selv satt navn på samle-og-glem-problemet - fritt gjengitt: En second brain skal ikke være et lagerlokale, men en fabrikk som gjør ideer om til konkrete resultater. Forte formulerer det selv slik: “information only becomes knowledge when we put it to use”.
Diagnosen er presis. Men - løsningen krever igjen menneskelig disiplin. Distill og Express er arbeid. Mye arbeid. Og det er nettopp på disse to stegene systemet svikter i praksis, ikke på Capture.

Moderne verktøy, gammel arbeidsdeling
Obsidian, Notion, Tana - alle har fått AI-funksjoner de siste to årene. Smart Connections finner semantiske naboer. Copilot for Obsidian svarer på spørsmål om vaulten. Notion AI tilbyr et query-lag som ofte ikke forstår databaserelasjoner og ikke en gang ser eksterne embeds. Tana går lengst med Agent Nodes, triggere og supertags. Men også Tana er regelbasert, ikke selvstendig tenkende.
Alt dette er assistenter. Ingen av dem er maintainer. Ingen skriver nye notater uoppfordret, fortetter temaer, oppdager motsigelser mellom gamle og nye tanker eller arkiverer stoff som har blitt liggende. Arbeidet blir hos deg - verktøyene gjør det bare mer behagelig.
Den felles blindsonen
Enten det er Zettelkasten, Second Brain eller moderne PKM-verktøy: Hver av disse metodene forutsetter en disiplinert menneskelig maintainer. En som jevnlig rydder, kobler, fortetter og sorterer bort. Den personen finnes i teorien. I praksis sitter det en kunnskapsarbeider der med full kalender, som er glad hvis han i det hele tatt får fanget opp noe.
Metodene har ikke feilet. Det som har feilet, er antakelsen om at mennesket kan være forfatter, kurator og arkivar på en gang.
Det er ikke hyllene som er problemet. Ikke taggene, ikke lenkene, ikke mappene. Problemet er rollefordelingen. Og det er akkurat der vi må ta et nytt grep.
Mycel - den nye arbeidsdelingen
Når maintainere er sjeldne, må rollen forsvinne - ikke arbeidet. Det er nettopp det tankeskiftet Andrej Karpathy pakket inn i et innlegg 2. april 2026: LLM-er som kuratorer av personlige kunnskapsbaser. Nesten 20 millioner visninger, og kort etter en gist med arkitekturskissen. Karpathy beskriver sin egen wiki: rundt 100 artikler, omtrent 400 000 ord, kompilert og vedlikeholdt fullt og helt av LLM-en - selv redigerer han den knapt lenger.

Arkitekturen jeg har utviklet for meg selv parallelt og skjerpet mot Karpathys skisse, går i tre lag:
raw/- uforanderlige kilder. Artikler, transkripsjoner, skjermbilder, papers. Her leser LLM-en bare. Det skrives aldri.wiki/- kompilert kunnskap. Source-sider per kilde, entity-sider per person/organisasjon/produkt, concept-sider per idé, synthesis-sider som vever sammen flere kilder, og question-sider som holder styr på åpne spørsmål. Skrevet i sin helhet av LLM-en.- Skjema/skills - reglene arbeidet følger. Hvilke sidetyper som finnes, hvordan det lenkes, hva som er et godt format for en concept-side. Skjemaet lever og blir skarpere for hver ingest.
Forskjellen fra klassisk PKM er ikke «mer automatisering». Det er en annen rollefordeling. Jeg bestemmer hva som kommer inn og hvilke spørsmål jeg har til materialet. LLM-en destillerer, kobler og vedlikeholder.
Hvorfor Mycel?
Fordi metaforen er presis. Et mycel er det underjordiske trådnettverket til en sopp. Det tar opp næring, kobler seg til alt innen rekkevidde og danner etter hvert fruktlegemer - de synlige soppene vi tror er «soppen».
| Biologi | Kunnskapssystem |
|---|---|
| Tar opp næring | Leser inn kilder (raw/) |
| Hyfer kobler seg sammen | Wikilinks mellom sider |
| Organisk vekst | Hver ingest gjør nettet tettere |
| Fruktlegemer | Synteser og konsepter som synlige resultater |
| Symbiose | Mennesket kuraterer, maskinen kompilerer |
To av disse egenskapene bærer hele arkitekturen:
Compound-vekst. Mycel vokser ikke lineært, det vokser eksponentielt. I min praksis berører en ny kilde typisk 5 til 20 eksisterende sider: oppdaterer entities, skjerper concepts, åpner eller lukker questions. Verdien ligger ikke i antall oppføringer, men i hvor tett koblingene er. Compound framfor completeness.
Usynlig infrastruktur. Mesteparten av et mycel ligger under jorda. Det mest verdifulle i wikien er ikke den enkelte oppsummeringen jeg ser på overflaten. Det er nettet av kryssreferanser, motsigelser mellom kilder og åpne spørsmål imellom. Fruktlegemene - synteser, concept-sider - er bare den synlige toppen.
Mennesket kuraterer ikke mindre. Det kuraterer bare annerledes: på spørsmålenes nivå, ikke på lappenes nivå.
Det er bruddet. Jeg vedlikeholder ikke notater lenger - jeg vedlikeholder retningen. Hva er jeg interessert i akkurat nå? Hvilke spørsmål er åpne? Hvor finnes motsigelsene? LLM-en tar seg av den delen mennesker strukturelt ikke får skalert: å konsekvent følge opp alle kanter, hver gang det kommer nytt materiale inn et sted.
Da står det igjen et spørsmål som melder seg så snart man har sett systemet én gang - særlig for alle som allerede har bygget med LLM-er: Når LLM-en kompilerer en wiki fra raw/-mappen, er ikke det bare RAG med flere steg?
Compiled Knowledge er ikke RAG
Før vi kommer til selve poenget - gjenfinningen - er det verdt en kort teknisk avstikker. Ellers blir RAG-spørsmålet hengende i lufta, og det fortjener et klart svar. Nei, dette er ikke RAG. Forskjellen ligger ikke i antall steg, men i når syntesen skjer. RAG tenker når den svarer. Compiled Knowledge har allerede tenkt før spørsmålet ble stilt.
Før vi går dypere: «Compiled Knowledge» er ikke et etablert fagbegrep. Du finner det ikke i noen lærebok, og heller ikke i LLM-miljøet er det et fast begrep. Vinklingen går i hovedsak tilbake til Karpathys kompilator-analogi fra april 2026 - rå kilder behandles som kildekode: først kompilere, så kjøre. Resultatet er tettere, mer strukturert og raskere å hente fram. Jeg låner begrepet fordi det treffer prinsippet godt.
Hva RAG egentlig gjør
RAG deler opp dokumenter i chunks, kjører hver chunk gjennom en embedding-modell og legger vektorene i en vector store. Ved en query blir spørsmålet også embeddet, storen leverer tilbake de mest like chunkene, og LLM-en får disse bitene som kontekst. Alt skjer just-in-time. Selve tankearbeidet - hva betyr dette, hvordan henger det sammen, hvor spriker det - delegeres på nytt til modellen ved hver eneste spørring.
Her mener jeg klassisk, ikke-agentisk RAG. Moderne tilnærminger med hybrid search, re-ranking eller agentic RAG visker ut grensen - da blir forskjellen mer gradvis enn prinsipiell.
Hva Compiled Knowledge gjør annerledes
Syntesen skjer ved ingest, ikke når svaret gis. En ny kilde blir ikke tankeløst kuttet opp og vektorisert, men lest, destillert og eksplisitt koblet inn i det eksisterende nettet. Det oppstår strukturerte Markdown-sider med kryssreferanser, åpne spørsmål og dokumenterte motsigelser. Det dyre arbeidet er allerede gjort når stoffet tas inn. Spørringen henter ferdige tanker, ikke råvarer.
Forskjellene i praksis
RAG finner en lignende chunk. Compiled Knowledge leverer en ferdig side som allerede har satt kilde A og kilde B opp mot hverandre - inkludert stedene der de motsier hverandre. Og mens RAG starter fra null ved hver query, beriker hver nye kilde compound-nettet videre: Hver kryssreferanse øker verdien av sidene som allerede finnes.
Der modellen møter grensene sine
For å være ærlig: Mycel kjører i oppsettet mitt for øyeblikket uten embedding-infrastruktur. Det fungerer så lenge kunnskapsnettet er oversiktlig og koblingene er pent vedlikeholdt. Skalerer det til titusenvis av sider? Sannsynligvis ikke uten en hybrid tilnærming - Compiled Knowledge som kuratert grunnmur, embeddings som fulltekst-fallback for det som ikke er destillert ennå. Jeg har ikke presset det til grensen ennå. Den som påstår at den ene modellen løser alle tilfeller, prøver å selge deg noe.
Men selv en perfekt vedlikeholdt, kompilert wiki løser ikke det egentlige problemet. Å ha en side som inneholder akkurat svaret, hjelper ingenting hvis den ikke blir hentet fram i riktig øyeblikk. Arkivering er halve jobben. Den andre halvparten er gjenfinning.
30 godt koblede sider er mer verdt enn 200 isolerte oppsummeringer. Men begge er verdiløse hvis de ikke er til stede i det avgjørende øyeblikket.
Det egentlige problemet var aldri innsamlingen
Vi hadde løst alt. En wiki som vedlikeholder seg selv. Compound-vekst i stedet for utløpsdato. Ingen motsigelser feid under teppet lenger, ingen tre halvferdige notater om samme tema, ingen kirkegård av Markdown-filer. På papiret var problemet ute av verden.
Og likevel.
Jeg hadde vedlikeholdt, koblet og syntetisert kunnskapen min - og i øyeblikkene der det gjaldt, kom jeg ikke på den. I møtet, i arkitekturbeslutningen, i den raske code reviewen. Der var den ikke. Den lå i wikien, pent sortert, perfekt lenket, og hjalp meg null og niks.
Å hente fram kunnskap er en annen disiplin enn å lagre den. Det er den ubehagelige erkjennelsen. Lagring er asynkron, kontrollert, i ro og mak. Gjenfinning skjer under press, midt i en samtale, i det sekundet beslutningen tas.
Den klassiske PKM-debatten har en blindsone: Den kretser nesten utelukkende rundt input. Hvordan organiserer jeg? Hvilket system? Atomic notes eller Folgezettel? Tagger eller mapper? Den andre halvparten - hva henter jeg fram i hvilken situasjon? - forblir ubesvart. Som om gjenfinning var et løst biprodukt av ryddig arkivering. Det er det ikke.
Med tenkeverktøyene blir dette smertefullt konkret. Jeg kjenner inversjon. Jeg kjenner second-order thinking. Jeg kjenner Ishikawa, pre-mortem, opportunity cost. Jeg har lest bøker om det, tatt notater, koblet dem. Og bruker dem likevel ikke når jeg trenger dem.
Mentale modeller aktiverer System 2-tenkning - den langsomme, bevisste, analytiske. Problemet: Under press tar System 1 over. Raskt, refleksstyrt, mønsterbasert. Det er i hvert fall den populære lesningen av Kahneman. Boka i hylla hjelper ikke i møtet. Notatet i wikien hjelper ikke i diskusjonen om en pull request. Og det er nettopp det gapet klassisk PKM aldri har tatt tak i: mellom «Jeg kjenner konseptet» og «Jeg bruker det i riktig øyeblikk».
Konsekvensen er ubehagelig, men klar. Å samle mer kunnskap løser ikke dette problemet. Å organisere bedre gjør det heller ikke. Selv en Mycel-wiki som vedlikeholdes perfekt av en LLM, forblir passiv - den venter til jeg spør. Og det er akkurat det jeg ikke gjør i det avgjørende øyeblikket.
Det som trengs, er noe annet: tenkeverktøy som er tilgjengelige i riktig øyeblikk. Ikke som bok, ikke som notat, ikke som kapittel i wikien. Som en skill på forespørsel.
Å samle kunnskap er halve jobben. Å aktivere den i riktig øyeblikk er resten - og den vanskeligste delen.
Tenkeverktøy på forespørsel
«Skill på forespørsel» høres abstrakt ut, så la meg gjøre det konkret: Et tenkeverktøy er først et verktøy når det er innen rekkevidde i situasjonen der jeg trenger det. Ikke ti minutter senere. Ikke etter møtet. Ikke når jeg om kvelden kommer på at jeg egentlig burde ha invertert i formiddag.
Det var nettopp mitt problem med rammeverk i årevis: Jeg kjente dem. Jeg hadde til og med notert og destillert dem, pliktoppfyllende etter CODE. Og likevel var de ikke der i beslutningsøyeblikket.
untools.co som råmateriale

Adam Amran, produktdesigner fra Tsjekkia, kuraterer over 25 tenkeverktøy på untools.co i fire kategorier: Decision Making, Problem Solving, Systems Thinking og Communication. Misjonen er tørt beskrevet: “Collection of thinking tools and frameworks to help you solve problems, make decisions and understand systems.”
Som bokmerke er siden ubrukelig. Som ingestert råmateriale i Mycel-et mitt - concept-sider per verktøy, pluss en Claude-skill per verktøy, pluss en synthesis-side som navigator - er den noe helt annet.
Inversion
Ikke spør «hvordan oppnår jeg X?», men «hvordan kan jeg garantert forhindre X?». Lista over det du bør unngå, er ofte mer konkret enn lista over veier dit. Typisk bruk: pre-mortem før en beslutning.
Second-order thinking
“And then what?” Ikke stopp ved den første konsekvensen, men tenk gjennom ringvirkningene. Slår inn når en beslutning ser åpenbart god ut - det er som regel signalet om å tenke minst to nivåer videre.
Issue trees
MECE-strukturert oppdeling av et problem i delproblemer, deretter 80/20-fokus på grenene som gir mest uttelling. Slår inn når et problem virker for stort til å ta tak i.
Eisenhower Matrix
Fire kvadranter ut fra viktighet og hast. Den ble popularisert av Stephen Covey i “7 Habits” (Habit 3: Put First Things First). Høres banalt ut, men er det mest presise filteret jeg kjenner for ukeplanlegging - særlig for å sette et ærlig navn på «haster, men er uviktig».
Den avgjørende forskyvningen
Navigatoren fungerer som et routing-lag. Jeg beskriver situasjonen: «Problemet er for komplekst, jeg vet ikke hvor jeg skal begynne.» Forslag: Issue Trees. «Jeg ser bare idealløsninger.» Forslag: Inversion. «Beslutningen føles riktig for fort.» Forslag: Second-order thinking.
Jeg trenger ikke lenger vite hvilket verktøy som passer. Jeg trenger bare å beskrive situasjonen min. Resten er navigasjon - og den tar assistenten seg av.
Et rammeverk jeg ikke kan aktivere i riktig øyeblikk, er ikke et verktøy. Det er en suvenir.
Integrasjon i rutiner - Føniks-progresjonen
Min egen produktivitetsrutine - jeg kaller den Føniks-progresjonen - kombinerer 12 Week Year-prinsippet til Moran og Lennington (“In 12 weeks, there just isn’t enough time to get complacent, and urgency increases and intensifies.”) med en syklisk rytme av fem tidsnivåer: æra (5 år), syklus (6 måneder), ildstorm (12 uker), ukesild (1 uke), flamme (2 timer).
Hvert nivå har egne ritualer. Og det er nettopp i disse ritualene tenkeverktøyene kobler seg på.
For en flamme - en deep work-blokk på to timer - får jeg ved oppstart foreslått metoder som passer situasjonen. For ukesild-reviews får jeg andre. For ildstorm-retrospektiven blir inversjon foreslått som pre-mortem for neste syklus. I dagsplanleggingen kommer Eisenhower-matrisen inn når lista blir for lang. I syklusplanleggingen first principles, når jeg merker at jeg bare skriver målene videre i stedet for å tenke dem på nytt.
Jeg henter ikke dette fram selv. Skillen melder seg når situasjonen passer - metoden vokser ut av mycelet som et fruktlegeme i riktig øyeblikk.
Forskjellen er subtil, men avgjørende: Jeg slipper den kognitive innsatsen det koster bare å komme på riktig rammeverk. Rammeverket står ikke lenger i hylla. Det er i situasjonen - som en skill som lastes når konteksten stemmer.
Ikke noe «hadde jeg bare tenkt på inversjon». Ingen blaing i gamle notater. Jobben med å huske tar skillen seg av.
Det høres ferdig ut. Det er det ikke.
Hva som endrer seg akkurat nå - og hva som (ennå) ikke fungerer
Det jeg beskriver over, er en pågående forhandling - ikke en ferdig produktivitetsløsning du kan kopiere.
Hva som endrer seg akkurat nå
Å skrive notater føles annerledes. Jeg samler mindre. Ikke fordi jeg leser mindre, men fordi jeg vet at LLM-maintaineren fortetter ved ingest. Jeg trenger ikke lenger notere hver passasje ord for ord for at den skal være mulig å finne senere. Det endrer hva jeg synes er verdt å notere.
Å tenke i rammeverk har blitt lettere. Ikke fordi jeg kjenner flere rammeverk - men fordi de dukker opp i riktig øyeblikk. En dialectic-skill som melder seg når jeg må ta en beslutning, er noe annet enn en bok i hylla som jeg aktivt måtte ha slått opp i.
Det dukker opp forbindelser jeg aldri ville ha sett. Ved ingest oppstår wikilinks jeg ikke ville kommet på alene. Noen er trivielle, noen endrer hvordan jeg plasserer et tema. Det er den delen som føles mest som kompilering og minst som søk.
Og det gjenstår åpne spørsmål. Hvordan skalerer dette forbi 500 sider, når forbindelsene vokser eksponentielt? Hva skjer når jeg vil endre skjemaet grunnleggende - migrerer maintaineren wikien, eller begynner den fra null? Jeg vet ikke.
Dette er ikke et ferdig produktivitetssystem man kopierer. Det er en pågående forhandling mellom meg og en maskin som blir stadig flinkere til å fortette kunnskap. Og stadig flinkere til å ta over arbeid som jeg kanskje ikke burde gi fra meg i det hele tatt. Vektstangen ligger i arbeidsdelingen. Jeg bestemmer hva som er viktig, hva som blir værende, hvilken retning det hele tar. Maskinen destillerer, kobler og stiller til rådighet når situasjonen krever det. Å holde den grensen er arbeid - og det er den egentlige oppgaven.
Poenget er ikke å vite mer. Poenget er å ha det riktige til stede i riktig øyeblikk.
Mennesket kuraterer, maskinen kompilerer.