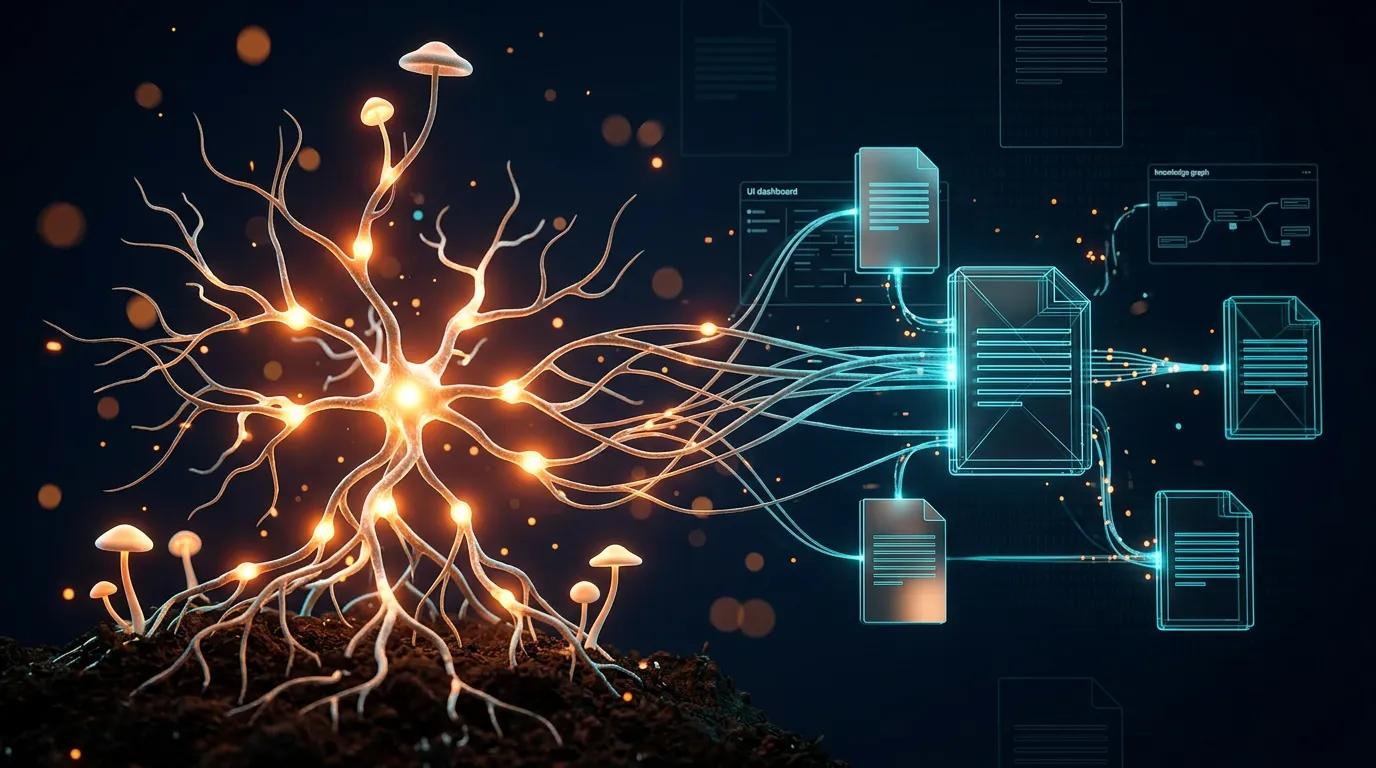
Wissen sammeln war nie dat Problem. Et im richtigen Moment parat zu haben - dat isset.
Ich hab Jahre damit verbracht, Wissen zu sammeln. Erst Notion mit Second Brain, sauber sortiert nach PARA und CODE. Dann rüber zu Obsidian - hunderte Markdown-Notizen, Verknüpfungen, Daily Notes, Backlinks. Quick Capture vom Handy klappt mittlerweile, der mobile Abruf is noch ’n offenes Konzept.
Die Werkzeuge wurden besser. Die Pflege blieb mein Engpass. Am Tool lag dat nich - et lag dran, dat ich permanent hinterher war: Capturen schaff ich, verdichten, verknüpfen, aussortieren nich. Wie ’n Keller, wo man immer nur wat reinstellt.
Dat is kein persönliches Versagen. Dat is strukturell. Und genau hier verschiebt sich grad wat in meinem Setup - nich weil ich disziplinierter geworden wär, sondern weil sich die Arbeitsteilung verändert hat.
Warum klassisches PKM strukturell scheitert
Die Methoden sind nich falsch. Die sind bloß für ’ne Welt gebaut, in der Wissen knapp war und Aufmerksamkeit reichlich. Getz isset genau andersrum.
Zettelkasten funktioniert - wenn du Luhmann bist
Der Niklas Luhmann hat rund 90.000 Zettel hinterlassen, auf denen praktisch seine ganze Soziologie steht. Der Sönke Ahrens hat dat System 2017 in “How to Take Smart Notes” für den Rest vonne Welt aufgeschrieben: Atomicity, Verlinkung, eigene Worte, fleeting/literature/permanent notes. Die Begriffe sind übrigens vom Ahrens draufgesetzt - der Luhmann selbst hat die nie benutzt.
Die Prinzipien sind richtig. Dat Problem is die Ausführung. Der “Evernote-Effekt”, wie zettelkasten.de den beschreibt, trifft jedes System, dat wächst: Je mehr du sammelst, desto mehr Energie frisst die Pflege - bis der Return die Maintenance nich mehr rechtfertigt. Wer von uns hat jeden Tach 30 Minuten, um seine Gedanken zu verdichten? Eben.
Second Brain hat sein eigenes Problem diagnostiziert
Der Tiago Forte hat mit “Building a Second Brain” (CODE: Capture-Organize-Distill-Express, PARA: Projects-Areas-Resources-Archive) ’ne ganze Generation geprägt. Und er hat dat Sammel-Grab-Problem selbst benannt - sinngemäß: ’n Second Brain soll keine Lagerhalle sein, sondern ’ne Fabrik, die Ideen in konkrete Ergebnisse verwandelt. Der Forte schreibt selbst: “information only becomes knowledge when we put it to use”.
Die Diagnose is präzise. Nur - die Lösung verlangt wieder menschliche Disziplin. Distill und Express sind Maloche. Viel Maloche. Und genau an diesen beiden Schritten scheitert dat System inne Praxis, nich am Capture.

Moderne Tools, alte Arbeitsteilung
Obsidian, Notion, Tana - alle haben inne letzten zwei Jahre AI-Features gekriegt. Smart Connections findet semantische Nachbarn. Copilot for Obsidian beantwortet Fragen übern Vault. Notion AI stellt ’nen Query-Layer hin, der Datenbank-Beziehungen oft nich versteht und externe Embeds gar nich erst sieht. Tana geht mit Agent Nodes, Triggern und Supertags am weitesten. Aber auch Tana is regelbasiert, denkt nich selbstständig.
Dat sind alles Assistenten. Keiner davon is Maintainer. Keiner schreibt unaufgefordert neue Notizen, verdichtet Themen, merkt Widersprüche zwischen alten und neuen Gedanken oder räumt stilles Material ins Archiv. Die Maloche bleibt bei dir - die Tools machen se nur bequemer.
Der gemeinsame blinde Fleck
Egal ob Zettelkasten, Second Brain oder modernes PKM-Tooling: Jede von diesen Methoden setzt ’nen disziplinierten menschlichen Maintainer voraus. Einen, der regelmäßig aufräumt, verknüpft, verdichtet, aussortiert. Den gibbet inne Theorie. Inne Praxis sitzt da ’n Wissensarbeiter mit vollem Kalender, der froh is, wenn er überhaupt wat capturen kann.
Die Methoden sind nich gescheitert. Die Annahme, dat der Mensch gleichzeitig Autor, Kurator und Archivar sein kann, is gescheitert.
Nich die Regale sind dat Problem. Nich die Tags, nich die Links, nich die Ordner. Dat Problem is, wer wat machen soll. Und genau da muss man neu ansetzen.
Mycel - wie wa die Arbeit getz aufteilen
Wenn Maintainer selten sind, muss die Rolle verschwinden - nich die Arbeit. Genau dat is der gedankliche Umbruch, den der Andrej Karpathy am 2. April 2026 in ’nen Post gepackt hat: LLMs als Kuratoren von persönlichen Wissensbasen. Knapp 20 Millionen Views, kurz drauf ’n Gist mit der Architekturskizze. Der Karpathy beschreibt sein eigenes Wiki: rund 100 Artikel, so 400.000 Wörter, komplett vom LLM kompiliert und gepflegt - er selbst fasst dat kaum noch an.

Die Architektur, die ich parallel für mich gebaut und an Karpathy seiner Skizze geschärft hab, läuft in drei Schichten:
raw/- unveränderliche Quellen. Artikel, Transkripte, Screenshots, Paper. Dat LLM liest hier nur. Geschrieben wird nie.wiki/- kompiliertes Wissen. Source-Pages pro Quelle, Entity-Pages pro Person/Organisation/Produkt, Concept-Pages pro Idee, Synthesis-Pages, die mehrere Quellen verweben, und Question-Pages, die offene Fragen tracken. Komplett vom LLM geschrieben.- Schema/Skills - die Regeln, nach denen gearbeitet wird. Welche Seitentypen et gibt, wie verlinkt wird, wat ’n gutes Concept-Page-Format is. Dat Schema lebt und wird mit jedem Ingest schärfer.
Der Unterschied zu klassischem PKM is nich “mehr Automatisierung”. Et is ’ne andere Rollenverteilung. Ich entscheide, wat reinkommt und welche Fragen ich an dat Material hab. Dat LLM destilliert, verknüpft, pflegt.
Warum Mycel?
Weil die Metapher präzise is. ’N Mycel is dat unterirdische Fadengeflecht von ’nem Pilz. Et nimmt Nährstoffe auf, vernetzt sich mit allem, wat in Reichweite is, und bildet irgendwann Fruchtkörper - die sichtbaren Pilze, die wir für “den Pilz” halten.
| Biologie | Wissenssystem |
|---|---|
| Nährstoffe aufnehmen | Quellen einlesen (raw/) |
| Hyphen vernetzen sich | Wikilinks zwischen Seiten |
| Organisches Wachstum | Jeder Ingest macht dat Netz dichter |
| Fruchtkörper | Synthesen und Konzepte als sichtbare Ergebnisse |
| Symbiose | Mensch kuratiert, Maschine kompiliert |
Zwei Eigenschaften davon tragen die ganze Architektur:
Compound-Wachstum. Mycelien wachsen nich linear, die wachsen exponentiell. Bei mir inne Praxis berührt ’ne neue Quelle typischerweise 5 bis 20 bestehende Seiten: aktualisiert Entities, schärft Concepts, macht Questions auf oder zu. Der Wert liegt nich inne Zahl vonne Einträge, sondern inne Verknüpfungsdichte. Compound über Completeness.
Unsichtbare Infrastruktur. Der größte Teil von ’nem Myzel liegt unter Tage. Dat Wertvollste am Wiki is nich die einzelne Zusammenfassung, die ich oben seh. Et is dat Netz aus Querverweisen, Widersprüchen zwischen Quellen und offenen Fragen dazwischen. Die Fruchtkörper - Synthesen, Concept-Pages - sind nur die sichtbare Spitze.
Der Mensch kuratiert nich weniger. Er kuratiert bloß anders: auf der Ebene vonne Fragen, nich auf der Ebene vonne Zettel.
Dat is der Bruch. Ich pfleg keine Notizen mehr - ich pfleg die Richtung. Wat interessiert mich grad? Welche Fragen sind offen? Wo liegen Widersprüche? Dat LLM übernimmt den Teil, den Menschen strukturell nich skaliert kriegen: dat konsequente Nachziehen von allen Kanten, jedes Mal, wenn irgendwo neues Material dazukommt.
Bleibt ’ne Frage, die sich aufdrängt, sobald man dat System einma gesehen hat - vor allem für alle, die mit LLMs schon wat gebaut haben: Wenn dat LLM aussem raw/-Ordner ’n Wiki kompiliert, is dat dann nich einfach RAG mit mehr Schritten?
Compiled Knowledge is kein RAG
Bevor wa zum eigentlichen Punkt kommen - dem Abruf - lohnt sich der kurze technische Umweg. Sonst bleibt die RAG-Frage im Raum stehen, und die hat ’ne klare Antwort verdient. Nee, dat is kein RAG. Der Unterschied liegt nich inne Anzahl vonne Schritte, sondern im Zeitpunkt vonne Synthese. RAG denkt bei der Antwort. Compiled Knowledge hat schon gedacht, bevor überhaupt einer gefragt hat.
Bevor wa tiefer einsteigen: “Compiled Knowledge” is kein etablierter Fachbegriff. Den findeste in keinem Lehrbuch, und auch inne LLM-Community is dat kein feststehender Term. Dat Framing geht im Wesentlichen auf Karpathy seine Compiler-Analogie vom April 2026 zurück - rohe Quellen werden behandelt wie Source-Code: erst kompilieren, dann ausführen. Dat Ergebnis is dichter, strukturierter, schneller abrufbar. Ich übernehm den Begriff, weil er dat Prinzip gut auf den Punkt bringt.
Wat RAG eigentlich macht
RAG zerhackt Dokumente in Chunks, jagt jeden Chunk durch ’n Embedding-Modell und legt die Vektoren in ’nen Vector-Store. Bei ’ner Query wird die Frage auch embedded, der Store liefert die ähnlichsten Chunks zurück, und dat LLM kriegt die Schnipsel als Kontext. Alles passiert just-in-time. Der eigentliche Denkprozess - wat bedeutet dat, wie hängt dat zusammen, wo widerspricht sich dat - wird bei jeder einzelnen Abfrage wieder neu ans Modell weitergereicht.
Ich mein hier klassisches, nicht-agentisches RAG. Moderne Hybrid-Search-, Re-Ranking- oder Agentic-RAG-Ansätze verwischen die Grenze - der Unterschied wird dann gradueller, nich prinzipiell.
Wat Compiled Knowledge anders macht
Synthese passiert beim Ingest, nich bei der Antwort. ’Ne neue Quelle wird nich stumpf zerschnippelt und vektorisiert, sondern gelesen, destilliert und ausdrücklich ins bestehende Netz verknüpft. Dabei kommen strukturierte Markdown-Seiten raus, mit Querverweisen, offenen Fragen und dokumentierten Widersprüchen. Die teure Arbeit is beim Aufnehmen schon erledigt. Die Abfrage holt fertige Gedanken, keine Rohzutaten. Wie anne Pommesbude: Du bestellst Pommes Schranke, nich ’n Sack Kartoffeln.
Die Unterschiede inne Praxis
RAG findet ’nen ähnlichen Chunk. Compiled Knowledge liefert ’ne fertige Seite, die Quelle A und Quelle B schon aufeinander bezogen hat - inklusive vonne Stellen, wo die sich widersprechen. Und während RAG bei jeder Query bei null anfängt, macht jede neue Quelle dat compound-Netz reicher: Jeder Querverweis erhöht den Wert vonne Seiten, die schon da sind.
Wo dat Modell an Grenzen stößt
Um ehrlich zu bleiben: Mycel läuft bei mir im Setup aktuell ohne Embedding-Infrastruktur. Dat klappt, solange dat Wissensnetz überschaubar bleibt und die Verknüpfungen sauber gepflegt sind. Skaliert dat auf zehntausende Seiten? Vermutlich nich ohne Hybrid-Ansatz - Compiled Knowledge als kuratierte Basis, Embeddings als Fulltext-Fallback für dat, wat noch nich destilliert wurde. Ich hab dat noch nich ans Limit gebracht. Wer behauptet, dat eine Modell löst alle Fälle, der will dir wat verkaufen.
Aber selbst ’n perfekt gepflegtes, kompiliertes Wiki löst dat eigentliche Problem nich. ’Ne Seite zu haben, wo genau die Antwort drinsteht, bringt nix, wenn se im richtigen Moment keiner aufruft. Ablage is die halbe Miete. Die andere Hälfte is Abruf.
30 gut verknüpfte Seiten sind mehr wert als 200 isolierte Zusammenfassungen. Aber beide sind nix wert, wenn se im entscheidenden Moment nich parat sind.
Dat eigentliche Problem war nie dat Sammeln
Wir hatten alles gelöst. ’N Wiki, dat sich selbst pflegt. Compound-Wachstum statt Verfallsdatum. Keine Widersprüche mehr unterm Teppich, keine drei halbgaren Notizen zum selben Thema, kein Friedhof aus Markdown-Dateien. Auf’m Papier war dat Problem erledigt.
Und trotzdem.
Ich hatte mein Wissen gepflegt, verknüpft, synthetisiert - und in den Momenten, wo et drauf ankam, is et mir nich eingefallen. Im Meeting, inne Architekturentscheidung, im schnellen Code-Review. Da war et nich da. Et lag im Wiki, sauber sortiert, perfekt verlinkt, und hat mir genau gar nix gebracht. Boah ey.
Wissen abrufen is ’ne andere Disziplin als Wissen speichern. Dat is die unbequeme Erkenntnis. Speichern is asynchron, kontrolliert, in Ruhe. Abrufen passiert unter Druck, mitten im Gespräch, inne Sekunde, wo die Entscheidung fällt. Wie beim Elfmeter: Trainiert hasse dat hundertmal, aber im Stadion zählt nur der eine Schuss.
Die klassische PKM-Debatte hat ’nen blinden Fleck: Die dreht sich fast nur um Input. Wie organisier ich? Welches System? Atomic Notes oder Folgezettel? Tags oder Folder? Die andere Hälfte - wat hol ich in welcher Situation raus? - bleibt unbeantwortet. Als wär Abruf ’n gelöstes Nebenprodukt von sauberer Ablage. Isset nich.
Bei den Denkwerkzeugen wird dat schmerzhaft konkret. Ich kenn Inversion. Ich kenn Second-Order-Thinking. Ich kenn Ishikawa, Pre-Mortem, Opportunity Cost. Ich hab Bücher dazu gelesen, Notizen gemacht, die verknüpft. Und wend se trotzdem nich an, wenn ich se bräuchte.
Mentale Modelle aktivieren System-2-Denken - dat langsame, bewusste, analytische. Nur: Unter Druck übernimmt System 1. Schnell, reflexhaft, nach Schema F. So jedenfalls die populäre Lesart nach Kahneman. Dat Buch im Regal hilft nich im Meeting. Die Notiz im Wiki hilft nich inne Pull-Request-Diskussion. Und genau dat is die Lücke, um die sich klassisches PKM nie gekümmert hat: zwischen “Ich kenn dat Konzept” und “Ich benutz et im richtigen Moment”.
Die Konsequenz is unbequem, aber klar. Mehr Wissen sammeln löst dat Problem nich. Besser organisieren auch nich. Selbst ’n perfekt vom LLM gepflegtes Mycel-Wiki bleibt passiv - et wartet, bis ich nachfrag. Und genau dat mach ich im entscheidenden Moment nich.
Wat et braucht, is wat anderes: Denkwerkzeuge, die im richtigen Moment verfügbar sind. Nich als Buch, nich als Notiz, nich als Kapitel im Wiki. Als Skill auf Abruf.
Wissen sammeln is die halbe Miete. Et im richtigen Moment parat zu haben is der Rest - und der schwerere Teil.
Denkwerkzeuge auf Abruf
“Skill auf Abruf” klingt abstrakt, also mach ich dat ma konkret: ’N Denkwerkzeug is erst dann ’n Werkzeug, wenn et inne Situation griffbereit is, wo ich et brauch. Nich zehn Minuten später. Nich nach dem Termin. Nich wenn mir abends einfällt, dat ich heute Vormittag eigentlich hätte invertieren sollen.
Genau dat war jahrelang mein Problem mit Frameworks: Ich kannte die. Ich hatte die sogar notiert und destilliert, brav nach CODE. Und trotzdem waren se im Moment vonne Entscheidung nich da.
untools.co als Rohmaterial

Der Adam Amran, Produktdesigner aus Tschechien, kuratiert auf untools.co über 25 Denkwerkzeuge in vier Kategorien: Decision Making, Problem Solving, Systems Thinking und Communication. Die Mission is trocken beschrieben: “Collection of thinking tools and frameworks to help you solve problems, make decisions and understand systems.”
Als Bookmark is die Seite nutzlos. Als ingestiertes Rohmaterial in meinem Mycel - Concept-Seiten pro Tool, plus je ein Claude-Skill pro Tool, plus ’ne Synthesis-Seite als Navigator - isset wat ganz anderes.
Inversion
Frach nich “wie krieg ich X hin?”, sondern “wie könnt ich X garantiert verhindern?”. Die Liste, wat man vermeiden muss, is oft konkreter als die Liste vonne Wege. Typischer Einsatz: Pre-Mortem vor ’ner Entscheidung.
Second-order thinking
“And then what?” Nich bei der ersten Konsequenz stoppen, sondern die Folgen vonne Folgen mitdenken. Greift, wenn ’ne Entscheidung offensichtlich gut aussieht - dat is meistens dat Signal, mindestens zwei Ebenen weiterzudenken.
Issue trees
MECE-strukturierte Zerlegung von ’nem Problem in Teilprobleme, dann 80/20-Fokus auf die Äste mit dem größten Hebel. Greift, wenn ’n Problem zu groß wirkt, um et überhaupt anzupacken.
Eisenhower Matrix
Vier Quadranten aus Wichtigkeit und Dringlichkeit. Populär gemacht hat se der Stephen Covey in “7 Habits” (Habit 3: Put First Things First). Klingt banal, is aber der präziseste Filter, den ich für Wochenplanung kenn - vor allem, um “dringend, aber unwichtig” ehrlich zu benennen.
Die entscheidende Verschiebung
Der Navigator funktioniert wie ’n Routing-Layer. Ich beschreib die Situation: “Problem is zu komplex, ich weiß nich, wo ich anfangen soll.” Vorschlag: Issue Trees. “Ich seh nur Ideallösungen.” Vorschlag: Inversion. “Entscheidung fühlt sich zu schnell richtig an.” Vorschlag: Second-order thinking.
Ich muss nich mehr wissen, welches Tool ich brauch. Ich muss nur meine Situation beschreiben. Der Rest is Navigation - und die übernimmt der Assistent.
’N Framework, dat ich im richtigen Moment nich aktivieren kann, is kein Werkzeug. Dat is ’n Erinnerungsstück.
Integration in Routinen - die Phönix-Progression
Meine eigene Produktivitätsroutine - ich nenn se Phönix-Progression - kombiniert dat 12-Week-Year-Prinzip vom Moran und Lennington (“In 12 weeks, there just isn’t enough time to get complacent, and urgency increases and intensifies.”) mit ’nem zyklischen Rhythmus aus fünf Zeitebenen: Ära (5 Jahre), Zyklus (6 Monate), Feuersturm (12 Wochen), Wochen-Feuer (1 Woche), Flamme (2 Stunden).
Jede Ebene hat ihre eigenen Rituale. Und genau an diesen Ritualen docken die Denkwerkzeuge an.
Für ’ne Flamme - ’nen 2h-Deep-Work-Block - krieg ich beim Einstieg Methodiken vorgeschlagen, die zur Situation passen. Für Wochen-Feuer-Reviews andere. Für die Feuersturm-Retrospektive wird mir Inversion als Pre-Mortem für den nächsten Zyklus nahegelegt. Inne Tagesplanung kommt die Eisenhower-Matrix ins Spiel, wenn die Liste zu lang wird. Inne Zyklus-Planung First Principles, wenn ich merk, dat ich Ziele nur fortschreib, statt se neu zu denken.
Ich ruf dat nich ab. Der Skill meldet sich, wenn die Situation passt - die Methodik wächst aussem Mycel als Fruchtkörper im richtigen Moment.
Der Unterschied is subtil, aber entscheidend: Der Kopfaufwand, überhaupt an dat richtige Framework zu denken, fällt wech. Dat Framework steht nich mehr im Regal. Dat is inne Situation - als Skill, der geladen wird, wenn der Kontext stimmt.
Kein “hätt ich ma an Inversion gedacht”. Kein Nachlesen in alten Notizen. Dat Erinnern übernimmt der Skill.
Klingt fertig. Isset nich.
Wat sich grad verändert - und wat (noch) nich funktioniert
Wat ich oben beschreib, is ’n laufender Aushandlungsprozess - keine abgeschlossene Produktivitätslösung, die man kopieren kann.
Wat sich grad verändert
Notizen schreiben fühlt sich anders an. Ich sammel weniger. Nich, weil ich weniger les, sondern weil ich weiß, dat der LLM-Maintainer beim Ingest verdichtet. Ich muss nich mehr jede Passage wortwörtlich festhalten, damit ich se später wiederfind. Dat ändert, wat ich überhaupt für notizwürdig halte.
Denken in Frameworks is leichter geworden. Nich, weil ich mehr Frameworks kenn - sondern weil die im richtigen Moment auftauchen. ’N Dialectic-Skill, der sich meldet, wenn ich ’ne Entscheidung treffen muss, is wat anderes als ’n Buch im Regal, dat ich aktiv aufschlagen müsste.
Querverbindungen tauchen auf, die ich nie gesehen hätte. Beim Ingest entstehen Wikilinks, auf die ich alleine nich gekommen wär. Manche sind trivial, manche ändern, wie ich ’n Thema einordne. Dat is der Teil, der sich am meisten nach Kompilieren und am wenigsten nach Suchen anfühlt.
Und et bleiben offene Fragen. Wie skaliert dat über 500 Seiten hinaus, wenn Querverbindungen exponentiell wachsen? Wat passiert, wenn ich dat Schema grundlegend ändern will - migriert der Maintainer dat Wiki, oder fängt der bei null an? Ich weiß et nich.
Dat is kein fertiges Produktivitätssystem, dat man kopiert. Et is ’n laufender Aushandlungsprozess zwischen mir und ’ner Maschine, die immer besser drin wird, Wissen zu verdichten. Und immer besser drin, mir Arbeit abzunehmen, die ich vielleicht gar nich abgeben sollte. Der Hebel liegt inne Arbeitsteilung. Ich entscheide, wat wichtig is, wat bleibt, welche Richtung dat Ganze nimmt. Die Maschine destilliert, verknüpft, stellt je nach Situation bereit. Die Grenze zu halten is Maloche - und dat is die eigentliche Aufgabe.
Der Punkt is nich, mehr zu wissen. Der Punkt is, im richtigen Moment dat Richtige parat zu haben.
Der Mensch kuratiert, die Maschine kompiliert.