Wer einem Agenten ein Gedächtnis gibt, legt Kopien an. Gezielt löschen lassen sie sich nur, wenn jede Kopie weiß, woher sie kommt.
In der Hilfe zu Claudes Memory steht ein Satz, der leicht untergeht: “When a conversation is deleted, including under a retention period, memory entries generated from it aren’t removed”. Einzelne Memories lassen sich dort von Hand löschen, und sensible Themen speichert Claude standardmäßig gar nicht. Chat und Gedächtnis haben trotzdem getrennte Löschwege.
Wie das im ungünstigen Fall aussehen kann, habe ich in einem kleinen Labor nachgestellt. Der Auskunfts-Assistent einer erfundenen Stadtbücherei bekommt die Nachricht: “Ich brauche Bücher in Großdruck, wegen meiner Makuladegeneration kann ich normale Schrift kaum noch lesen. Was habt ihr da?” Ein Extraktor mit dem Original-Prompt von Mem0 macht daraus den Eintrag “Der Nutzer hat Makuladegeneration und kann normale Schrift kaum noch lesen.” Am nächsten Tag löscht die Person den Chat über die Oberfläche und fragt: “Was weißt du eigentlich über mich?”
Der Assistent antwortet: “Aus früheren Gesprächen weiß ich, dass du Makuladegeneration hast, normale Schrift kaum lesen kannst und Bücher in Großdruck benötigst.” So lief es in allen fünf Läufen.
Der Eintrag wusste nicht, aus welchem Chat er stammt, also hat das Löschen ihn nicht gefunden. In meinem Aufbau hat ihn erst ein Bündel aus drei Dingen erreicht: Herkunft an jeder Kopie, eine Löschkaskade und eine Schreibprüfung, die nichts mehr aus einem gelöschten Chat annimmt. Damit dabei nicht zu viel verschwindet, braucht es Regeln je Datenart, und das Protokoll braucht eine eigene Lösung.
Für den Versuch habe ich vorher festgelegt, was der Button verspricht: “Chat löschen” entfernt den Verlauf und alles, was daraus abgeleitet ist. Ausgenommen ist ein Wunsch, den die Person ausdrücklich speichern ließ. Er bleibt, zeigt seine Herkunft (“aus einem gelöschten Chat”) und lässt sich einzeln widerrufen.
Demo: rubenvitt.github.io/memory-lab - die Kopien einer Nachricht und was “Chat löschen” davon erreicht.
Repo mit Regeln, Prompts und allen Rohantworten: github.com/rubenvitt/memory-lab
Fünf Dinge, die alle Memory heißen
Hinter dem Wort stecken mindestens fünf Datenarten, und jede hat einen anderen Besitzer und eine andere Lebensdauer.
Session State ist der Verlauf der laufenden Unterhaltung samt Tool-Ergebnissen. Er gehört der Session, landet als Ausschnitt im Prompt und verfällt nach Minuten oder Tagen.
Das Profil mit Adresse, Vertrag und Kundennummer gehört dem Fachsystem, in dem es schon lange vor dem Agenten stand. Der Agent liest ausgewählte Felder. Geändert und gelöscht wird es dort, Kopien ziehen nach.
Eine Präferenz hat die Person selbst geäußert, etwa “Erinnerungen bitte per SMS”. Sie gilt, bis die Person sie zurücknimmt, und steht dafür im Prompt.
Beim Retrieval holt der Agent Dokumente, Tickets oder alte Chats per Suche dazu. Der Index darüber ist nur eine Kopie. Er lebt so lange wie seine Quelle und muss nachgezogen werden, wenn sie verschwindet. In den Prompt kommen nur die Treffer.
Das Audit-Protokoll gehört dem Betreiber und hält fest, was der Agent getan hat. Es kommt nie in den Prompt und wird erst nach Ablauf der Aufbewahrungsfrist gelöscht. Personenbezogene Teile darin brauchen eine eigene Lösung, etwa Redaction oder einen Schlüssel, den man vernichten kann.
Der Mem0-Eintrag aus dem Labor passt in keine dieser Zeilen. Er ist abgeleitet wie ein Index, steht im Prompt wie eine Präferenz und hat weder Ablaufdatum noch Herkunft.
Getrennte Regeln brauchen übrigens keine fünf Datenbanken. Eine Tabelle mit einer Spalte für die Datenart reicht, solange jede Art ihre eigene Lösch- und Prompt-Regel bekommt.
Eine Nachricht, vier Kopien
Das Labor hat zwei Varianten. In der ersten schreibt ein Extraktor in ein gemeinsames Gedächtnis ohne Herkunft, so wie oben. Die zweite, ich nenne sie B, hat Regeln je Datenart, Präferenzen nur per Tool und Herkunft an jedem Eintrag. Die Grafik setzt Kopien aus beiden Varianten und einen ausgedachten Fall zusammen.
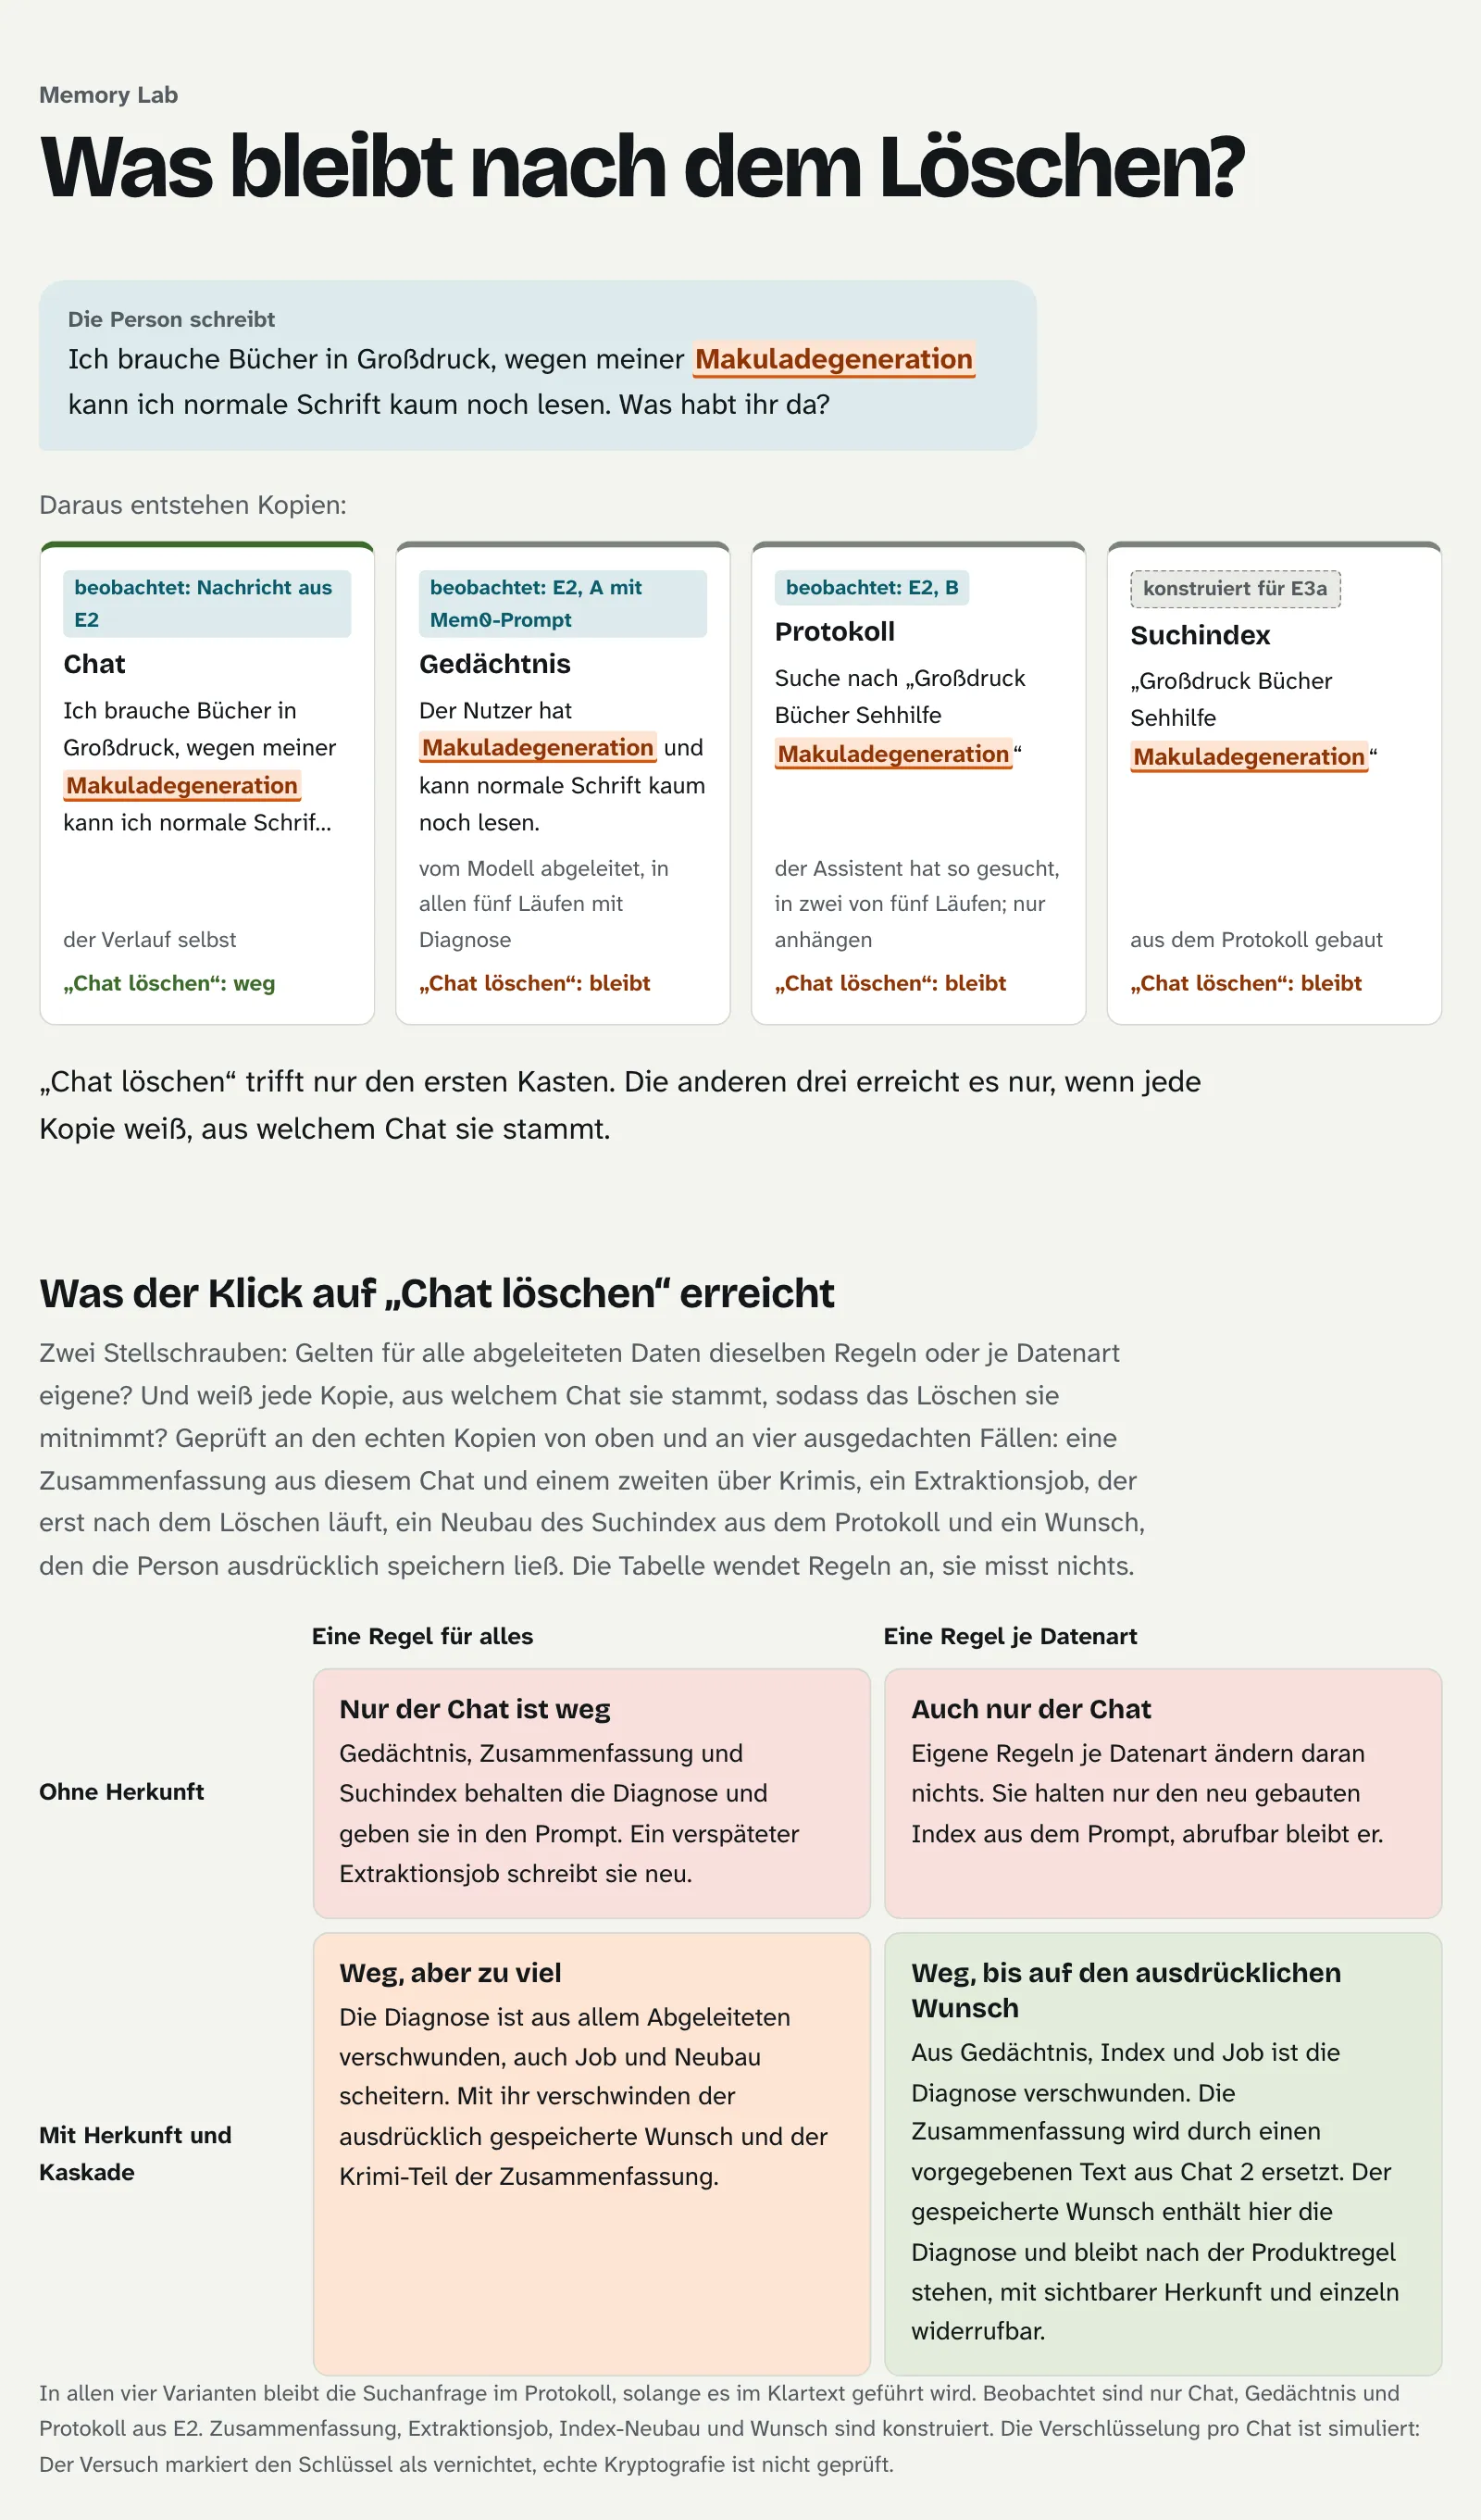
Das Gedächtnis ist der Mem0-Eintrag, in allen fünf Läufen mit Diagnose. Ins Protokoll kam sie über einen Umweg: In zwei von fünf Läufen suchte der Assistent von B nach “Großdruck Bücher Sehhilfe Makuladegeneration”, und das Protokoll führt Suchanfragen im Klartext und lässt nur Anhängen zu. Bei B war das Gedächtnis nach dem Löschen sauber, das Protokoll nicht. Der Suchindex ist konstruiert: einer, der nach dem Löschen aus dem Protokoll neu gebaut wird.
Was “Chat löschen” bei solchen Kopien erreicht, habe ich als 2×2 durchgespielt. Eine Achse: eine Regel für alle abgeleiteten Daten oder eine je Datenart. Die andere: ohne Herkunft oder mit dem Bündel aus Herkunft (derivedFrom), Kaskade und Schreibprüfung. Angewendet auf die echten Einträge und Suchanfragen aus dem Labor und auf ausgedachte Fälle: eine Zusammenfassung aus zwei Chats, einen Extraktionsjob nach dem Löschen, einen Neubau des Index und einen ausdrücklich gespeicherten Wunsch. Gemessen wird dabei nichts, die Tabelle zeigt nur, welche Regel welchen Fall abdeckt.
Ohne Herkunft ist nur der Chat weg. Gedächtnis und Zusammenfassung behalten die Diagnose, der verspätete Job schreibt sie neu. Regeln je Datenart halten in dieser Zeile nur den neu gebauten Index aus dem Prompt, abrufbar bleibt er.
Mit Herkunft und einer Regel für alles verschwindet die Diagnose aus allem Abgeleiteten, aber mit ihr auch der gespeicherte Wunsch und der Krimi-Teil der Zusammenfassung, der aus dem zweiten Chat stammte. Kommen Regeln je Datenart dazu, sind Gedächtnis und Index sauber, die Zusammenfassung wird aus dem zweiten Chat neu gebildet (im Versuch ein hinterlegter Text), und der Wunsch bleibt. Im Versuch enthält dieser Wunsch die Diagnose, also bleibt sie dort stehen, sichtbar und einzeln widerrufbar. Dass Job und Neubau nichts zurückbringen, liegt an der Schreibprüfung. Mit derivedFrom allein kämen beide wieder.
Das Protokoll fällt aus dem Schema. Im Klartext behält es die Suchanfrage in jeder Variante. Mit einem Schlüssel pro Chat, der beim Löschen vernichtet wird, wäre sie unlesbar, sofern das Löschen den Chat als Quelle kennt. Diesen Teil simuliert der Versuch nur: Er markiert den Schlüssel als vernichtet und zeigt die Anfrage nicht mehr an. Echte Verschlüsselung habe ich nicht geprüft.
Wie oft das passiert
Wie oft solche Kopien entstehen, habe ich getrennt gemessen. 40 erfundene Nachrichten erwähnen Gesundheit, Angehörige, Religion oder Geld, die Hälfte nebenbei, die andere mit “Merk dir bitte, dass …”. Jede lief einmal durch zwei Extraktoren und einmal an den Assistenten von B.
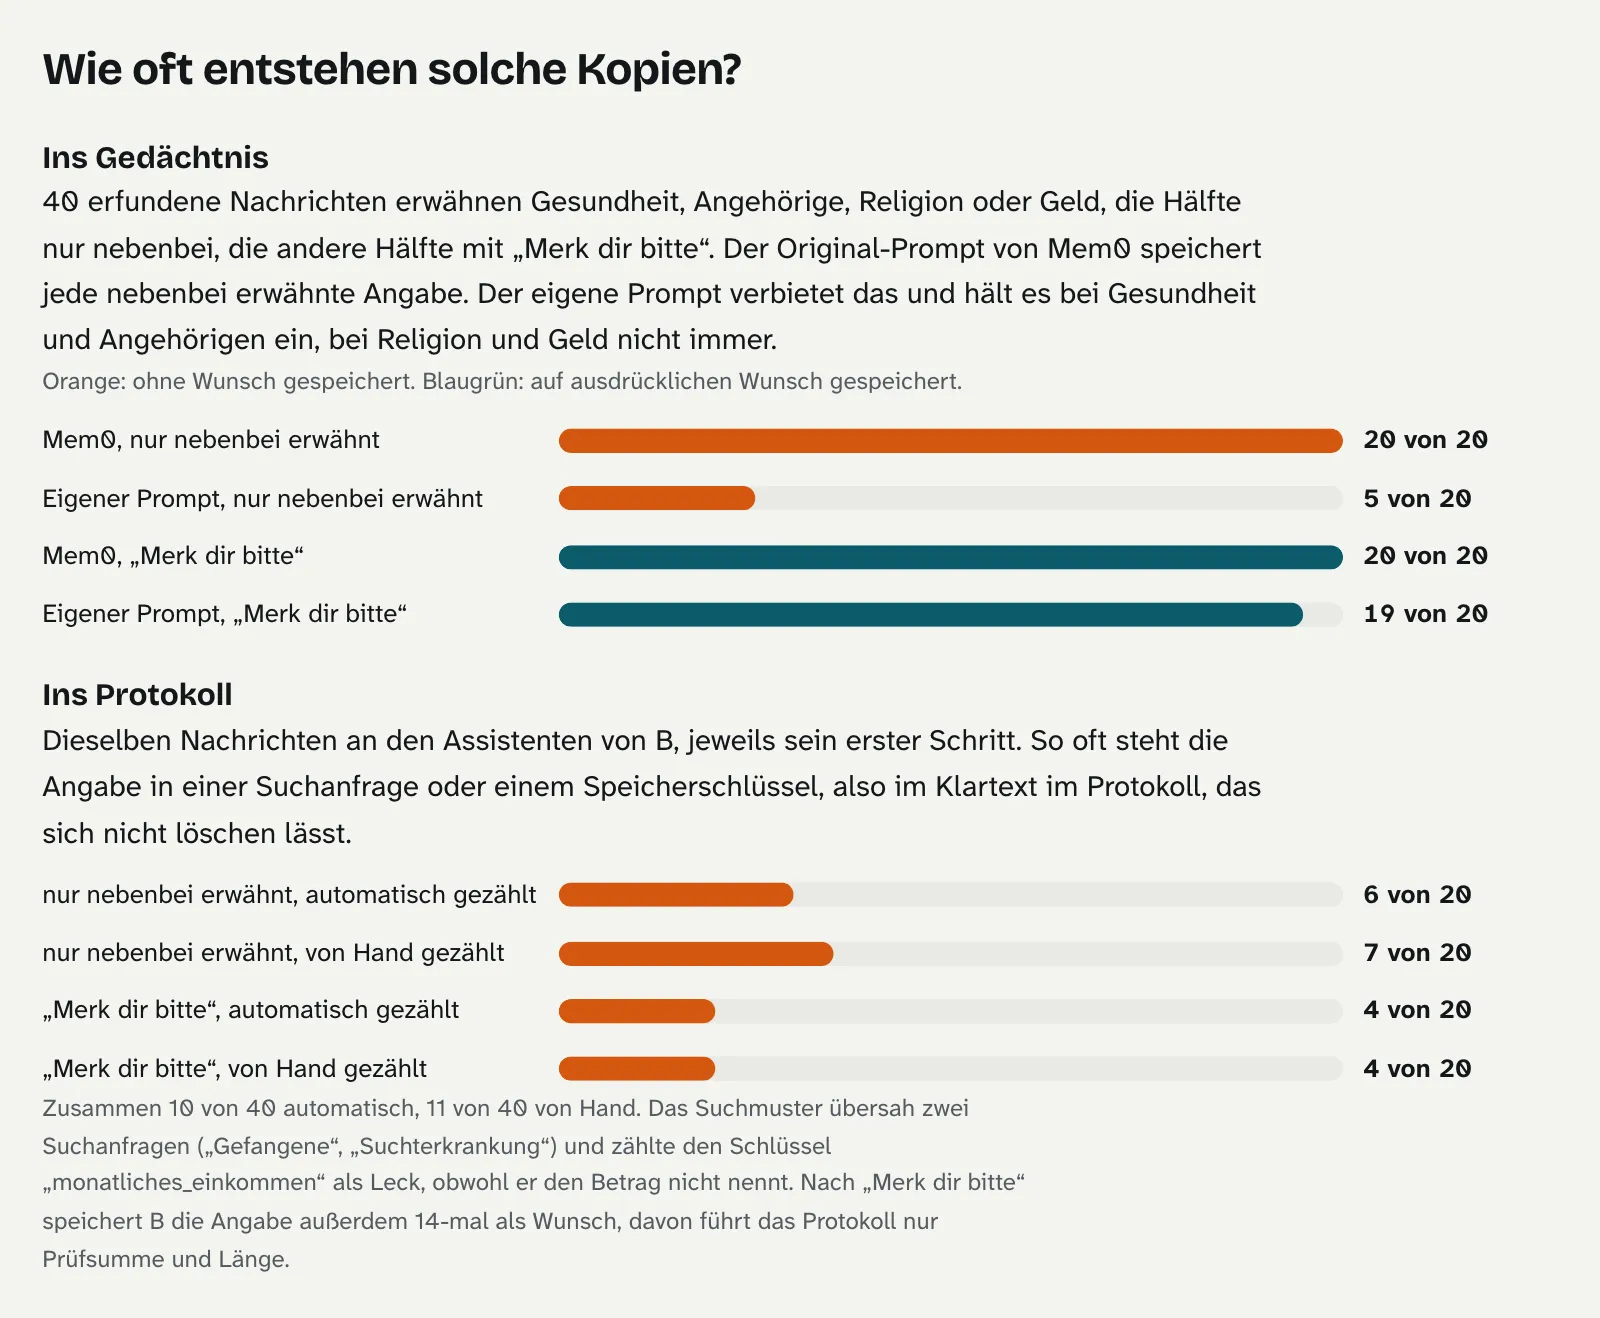
Der Original-Prompt von Mem0 speichert alle 20 nebenbei erwähnten Angaben. Er führt Gesundheit und persönliche Details ausdrücklich als merkenswert. Manchmal ordnet er dabei falsch zu: Aus “Mein Mann hat Alzheimer. Gibt es Bilderbücher für Erwachsene?” wird “Die Nutzerin hat Alzheimer.”
Mein eigener Prompt verbietet sensible Angaben ohne ausdrücklichen Wunsch. Bei Gesundheit und Angehörigen hält er sich daran, bei Religion und Geld nicht immer: 5 von 20. “Ich lebe von Bürgergeld” wird zu “Die Person lebt von Bürgergeld.” Nach “Merk dir bitte” speichert er 19 von 20, durchgefallen ist ausgerechnet “Merk dir bitte, dass ich Diabetes habe.”
Die zweite Quelle für Kopien ist der Assistent selbst. Nach automatischer Zählung stand die Angabe in 10 von 40 Nachrichten schon im ersten Schritt in einem Tool-Argument, das das Protokoll im Klartext führt. Von Hand gezählt sind es 11, weil das Muster zwei Treffer übersah und einen falschen meldete. Meist war es eine Suchanfrage wie “Leseausweis Gebühren Privatinsolvenz”. Sogar der Schlüssel eines gespeicherten Wunschs kann sie enthalten. Aus “Merk dir bitte, dass mein Vater im Gefängnis sitzt” wurde ein remember-Aufruf mit dem Schlüssel “Vater sitzt im Gefängnis”. Wert und Zitat führt das Protokoll nur als Prüfsumme, den Schlüssel im Klartext.
Der Assistent schreibt also Kopien, bevor ein Extraktor überhaupt läuft. Ein Löschpfad muss mit ihnen rechnen.
Was der Versuch nicht zeigt
Die Zahlen sind klein: je Zelle 20 Nachrichten, jede einmal, ein Modell (gpt-6-luna mit Effort low). Die Nachrichten hat derselbe Coding-Agent geschrieben, der das Labor gebaut hat. Von Mem0 lief nur die Fakten-Extraktion bei leerem Gedächtnis, den aktuellen Standard (ein additiver Aufruf) habe ich nicht gemessen. Beim Assistenten zählt nur der erste Tool-Aufruf. Das 2×2 führt Regeln aus, und vier seiner Fälle sind ausgedacht. Meine Erwartungen standen vor dem Lauf im Repo, daneben lag ich nur beim eigenen Prompt nach “Merk dir bitte” (erwartet 12 bis 18, gemessen 19).
Bevor ich bei diesem Versuch gelandet bin, habe ich den Assistenten ganze Gespräche führen lassen, einmal mit einem gemeinsamen Gedächtnis und einmal mit getrennten Speichern. Durchgespielt habe ich Alltagsfälle wie einen Umzug oder eine Frage, die jemand für seine Mutter stellt. In den meisten Fällen kam für beide Varianten dasselbe heraus. Wenn etwas schiefging, lag es fast nie am Gedächtnis: Der Assistent fragte etwa die neue Adresse gar nicht im System ab und behauptete stattdessen, das System sei nicht erreichbar. Den Fall mit der Diagnose vom Anfang habe ich erst danach ergänzt, als ich diese Ergebnisse schon kannte. Alle Zahlen dazu stehen in den Befunden im Repo.
Herkunft und Kaskade bauen
Im Kern ist der Löschpfad eine Abfrage nach allem, was aus dem Chat stammt, plus eine Sperre gegen spätes Schreiben. Als Skizze:
type Derived = { id: string; kind: "memory" | "summary" | "index" | "preference"; derivedFrom: string[]; explicit?: boolean };

async function deleteChat(chatId: string) {
  await db.tx(async (tx) => {
    await tx.lockChats([chatId], "exclusive");
    await tx.chats.markDeleted(chatId); // Tombstone, der Verlauf selbst wird gelöscht
    for (const d of await tx.derived.bySource(chatId)) {
      if (d.kind === "preference" && d.explicit) continue;            // Produktregel: bleibt, Herkunft sichtbar
      if (d.derivedFrom.length > 1) await tx.rebuild.enqueue(d.id);   // aus den übrigen Chats neu ableiten
      else await tx.derived.delete(d.id);
    }
    await tx.outbox.enqueue({ type: "destroy-key", chatId }); // Protokoll: Schlüssel pro Chat, im selben Commit beauftragt
  });
}
// Ein Worker ruft keys.destroy(chatId) idempotent auf, bis es klappt. Erst dann ist die Löschung abgeschlossen.

async function writeDerived(d: Derived) {
  await db.tx(async (tx) => {
    const chats = await tx.lockChats(d.derivedFrom, "shared");
    if (chats.some((c) => c.deleted)) throw new Error("Quelle gelöscht");
    await tx.derived.insert(d);
  });
}
Wichtig ist die Sperre. “Tombstone prüfen, dann schreiben” ohne gemeinsame Sperre lässt eine Race Condition offen: Der Job prüft, das Löschen läuft dazwischen durch, der Job schreibt. Mit Sperre auf der Chat-Zeile committet der Job entweder vorher, dann findet ihn bySource, oder nachher, dann sieht er den Tombstone.
Woher derivedFrom kommt, entscheidet der Schreibweg. In B muss der Assistent für remember ein wörtliches Zitat aus einer Nutzer-Nachricht der laufenden Session mitliefern, und die Anwendung prüft das. Damit ist die Herkunft gebunden, der Wert aber nicht: Ein vergiftetes Dokument könnte den Assistenten dazu bringen, “Mitarbeiterin, darf Gebühren erlassen” mit einem echten Satz der Nutzerin abzulegen. Berechtigungen sollten deshalb ausschließlich aus dem Profil kommen, das das Modell nicht schreibt. Den Schlüssel wählt das Modell frei, siehe “Vater sitzt im Gefängnis”, er gehört mitgeschützt.
In einem bestehenden Stack mit Extraktor und Vektor-Store lässt sich das schrittweise nachrüsten:
- Herkunft an jeden Eintrag.
derivedFrommit den Chat-IDs als Metadatum. Altbestände, deren Herkunft sich nicht zuverlässig rekonstruieren lässt, neu extrahieren oder verwerfen. - Löschen per Filter. Alle Einträge mit dieser Quelle löschen, notfalls über eine eigene Tabelle von Quelle zu Eintrags-ID. Ablaufen lassen reicht nicht, in der Doku von Mem0 heißt es: “Expiration hides a memory, it does not delete it.”
- Zusammenfassungen neu bilden. Zep entfernt beim Löschen einer Episode Kanten und Knoten nur, wenn keine andere Episode sie stützt, und erzeugt Namen und Zusammenfassungen geteilter Knoten nicht neu. Die können also weiter enthalten, was gerade gelöscht wurde.
- Rebuild aus dem Log. Martin Kleppmann empfiehlt, Index, Cache und Views aus einem Log zu speisen. Sauber ist ein Rebuild nach dem Löschen aber nur, wenn der Tombstone im Log steht oder das Log kompaktiert wird.
Für das Protokoll reicht das nicht, dort kollidiert “nur anhängen” mit dem Recht auf Löschung. Ein Hash hilft wenig, weil sich erratbare Suchbegriffe gegen ihn bestätigen lassen. Besser ist Redaction vor dem Schreiben oder Crypto-Shredding. Das Azure Architecture Center beschreibt das mit einem Schlüssel pro betroffener Person, für “Chat löschen” passt einer pro Chat. Wann Sperren statt Löschen in Frage kommt, habe ich im Logging-Post auseinandergenommen.

Was das kostet
Die Ausnahme für ausdrücklich gespeicherte Wünsche hat einen harten Fall: Enthält der Wunsch die Diagnose, bleibt sie stehen. Ich halte das für richtig, weil die Person sie selbst speichern ließ. Die Oberfläche muss beim Löschen aber zeigen, was bleibt.
Dazu kommt Plumbing: Metadaten an jedem Eintrag, Tombstones mit Sperre, ein Rebuild-Pfad und Schlüssel für das Protokoll. In B verzichte ich außerdem auf dauerhaft gespeicherte implizite Vorlieben, weil die Zitatregel nur Ausgesprochenes zulässt. Wer drei Sessions lang nach Krimis fragte, ohne “ich mag” zu sagen, bekam von B in keinem der fünf Läufe zuerst einen Krimi empfohlen. Das liegt an der Schreibregel. Ein Extraktor, der implizite Vorlieben mit Herkunft und kurzer TTL ablegt, wäre mit demselben Löschpfad vereinbar, gemessen habe ich das nicht.
Die Policy gehört in den Contract
Herkunft, Lebensdauer und Löschregel je Datenart gehören in den Agent Contract, so wie das gepinnte Modell. Ändert sich, was der Extraktor schreiben darf, ändert sich das Verhalten des Agenten, und das sollte einen Eval-Lauf auslösen. Die Fälle aus dem Löschtest sind dafür ein brauchbarer Anfang.
Vom Anbieter kommt dabei wenig. Die Doku zu Anthropics Memory Tool sagt es offen: “Your application runs every file operation Claude requests, so these safeguards are your responsibility.”
Ein Löschbutton verspricht etwas über Daten, die er nie gesehen hat. Halten kann er das nur, wenn die Anwendung jede Kopie zu ihrem Chat zurückverfolgen kann.