Donner une mémoire à un agent, c’est créer des copies. On ne peut les supprimer de façon ciblée que si chaque copie sait d’où elle vient.
Dans l’aide sur la mémoire de Claude se trouve une phrase qui passe facilement inaperçue : « When a conversation is deleted, including under a retention period, memory entries generated from it aren’t removed ». On peut y supprimer des souvenirs un par un à la main, et par défaut Claude n’enregistre pas du tout les sujets sensibles. Le chat et la mémoire ont malgré tout des chemins de suppression séparés.
J’ai reconstitué dans un petit labo ce que ça peut donner dans le pire des cas. L’assistant d’accueil d’une bibliothèque municipale imaginaire reçoit ce message : « J’ai besoin de livres en gros caractères, à cause de ma dégénérescence maculaire je n’arrive presque plus à lire les caractères normaux. Qu’est-ce que vous avez ? » Un extracteur doté du prompt original de Mem0 en tire l’entrée « L’utilisateur a une dégénérescence maculaire et n’arrive presque plus à lire les caractères normaux. » Le lendemain, la personne supprime le chat depuis l’interface et demande : « Au fait, qu’est-ce que vous savez sur moi ? »
L’assistant répond : « D’après nos conversations précédentes, je sais que vous avez une dégénérescence maculaire, que vous n’arrivez presque plus à lire les caractères normaux et que vous avez besoin de livres en gros caractères. » Même scénario dans les cinq runs.
L’entrée ne savait pas de quel chat elle venait, donc la suppression ne l’a pas trouvée. Dans mon dispositif, il a fallu une combinaison de trois choses pour l’atteindre : une provenance sur chaque copie, une suppression en cascade et un contrôle à l’écriture qui n’accepte plus rien venant d’un chat supprimé. Pour ne pas faire disparaître trop de choses au passage, il faut des règles par type de données, et le journal a besoin de sa propre solution.
Pour l’expérience, j’ai fixé à l’avance ce que promet le bouton : « Supprimer le chat » efface l’historique et tout ce qui en est dérivé. Seule exception : une préférence que la personne a explicitement demandé d’enregistrer. Celle-ci reste, affiche sa provenance (« issue d’un chat supprimé ») et peut être révoquée individuellement.
Démo : rubenvitt.github.io/memory-lab - les copies d’un message et ce que « Supprimer le chat » en atteint.
Repo avec les règles, les prompts et toutes les réponses brutes : github.com/rubenvitt/memory-lab
Cinq choses qui s’appellent toutes Memory
Derrière ce mot se cachent au moins cinq types de données, et chacun a un propriétaire et une durée de vie différents.
Le Session State, c’est l’historique de la conversation en cours, résultats des tools compris. Il appartient à la session, arrive en extrait dans le prompt et expire au bout de quelques minutes ou de quelques jours.
Le profil, avec l’adresse, le contrat et le numéro client, appartient au système métier dans lequel il figurait bien avant l’agent. L’agent en lit certains champs. On le modifie et on le supprime là-bas, les copies suivent.
Une préférence, c’est la personne elle-même qui l’a exprimée, par exemple « Les rappels par SMS, s’il vous plaît ». Elle vaut jusqu’à ce que la personne la retire, et c’est pour ça qu’elle figure dans le prompt.
Avec le Retrieval, l’agent va chercher des documents, des tickets ou d’anciens chats par une recherche. L’index qui sert à ça n’est qu’une copie. Il vit aussi longtemps que sa source et doit être mis à jour quand elle disparaît. Seuls les résultats arrivent dans le prompt.
Le journal d’audit appartient à l’exploitant et consigne ce que l’agent a fait. Il n’entre jamais dans le prompt et n’est supprimé qu’à l’expiration du délai de conservation. Les parties à caractère personnel qu’il contient ont besoin de leur propre solution, par exemple le caviardage ou une clé qu’on peut détruire.
L’entrée Mem0 du labo ne rentre dans aucune de ces cases. Elle est dérivée comme un index, figure dans le prompt comme une préférence et n’a ni date d’expiration ni provenance.
Des règles séparées n’exigent d’ailleurs pas cinq bases de données. Une table avec une colonne pour le type de données suffit, tant que chaque type a sa propre règle de suppression et sa propre règle de prompt.
Un message, quatre copies
Le labo a deux variantes. Dans la première, un extracteur écrit dans une mémoire commune sans provenance, comme plus haut. La seconde, que j’appelle B, a des règles par type de données, des préférences uniquement via un tool et une provenance sur chaque entrée. Le graphique assemble des copies issues des deux variantes et un cas imaginé.
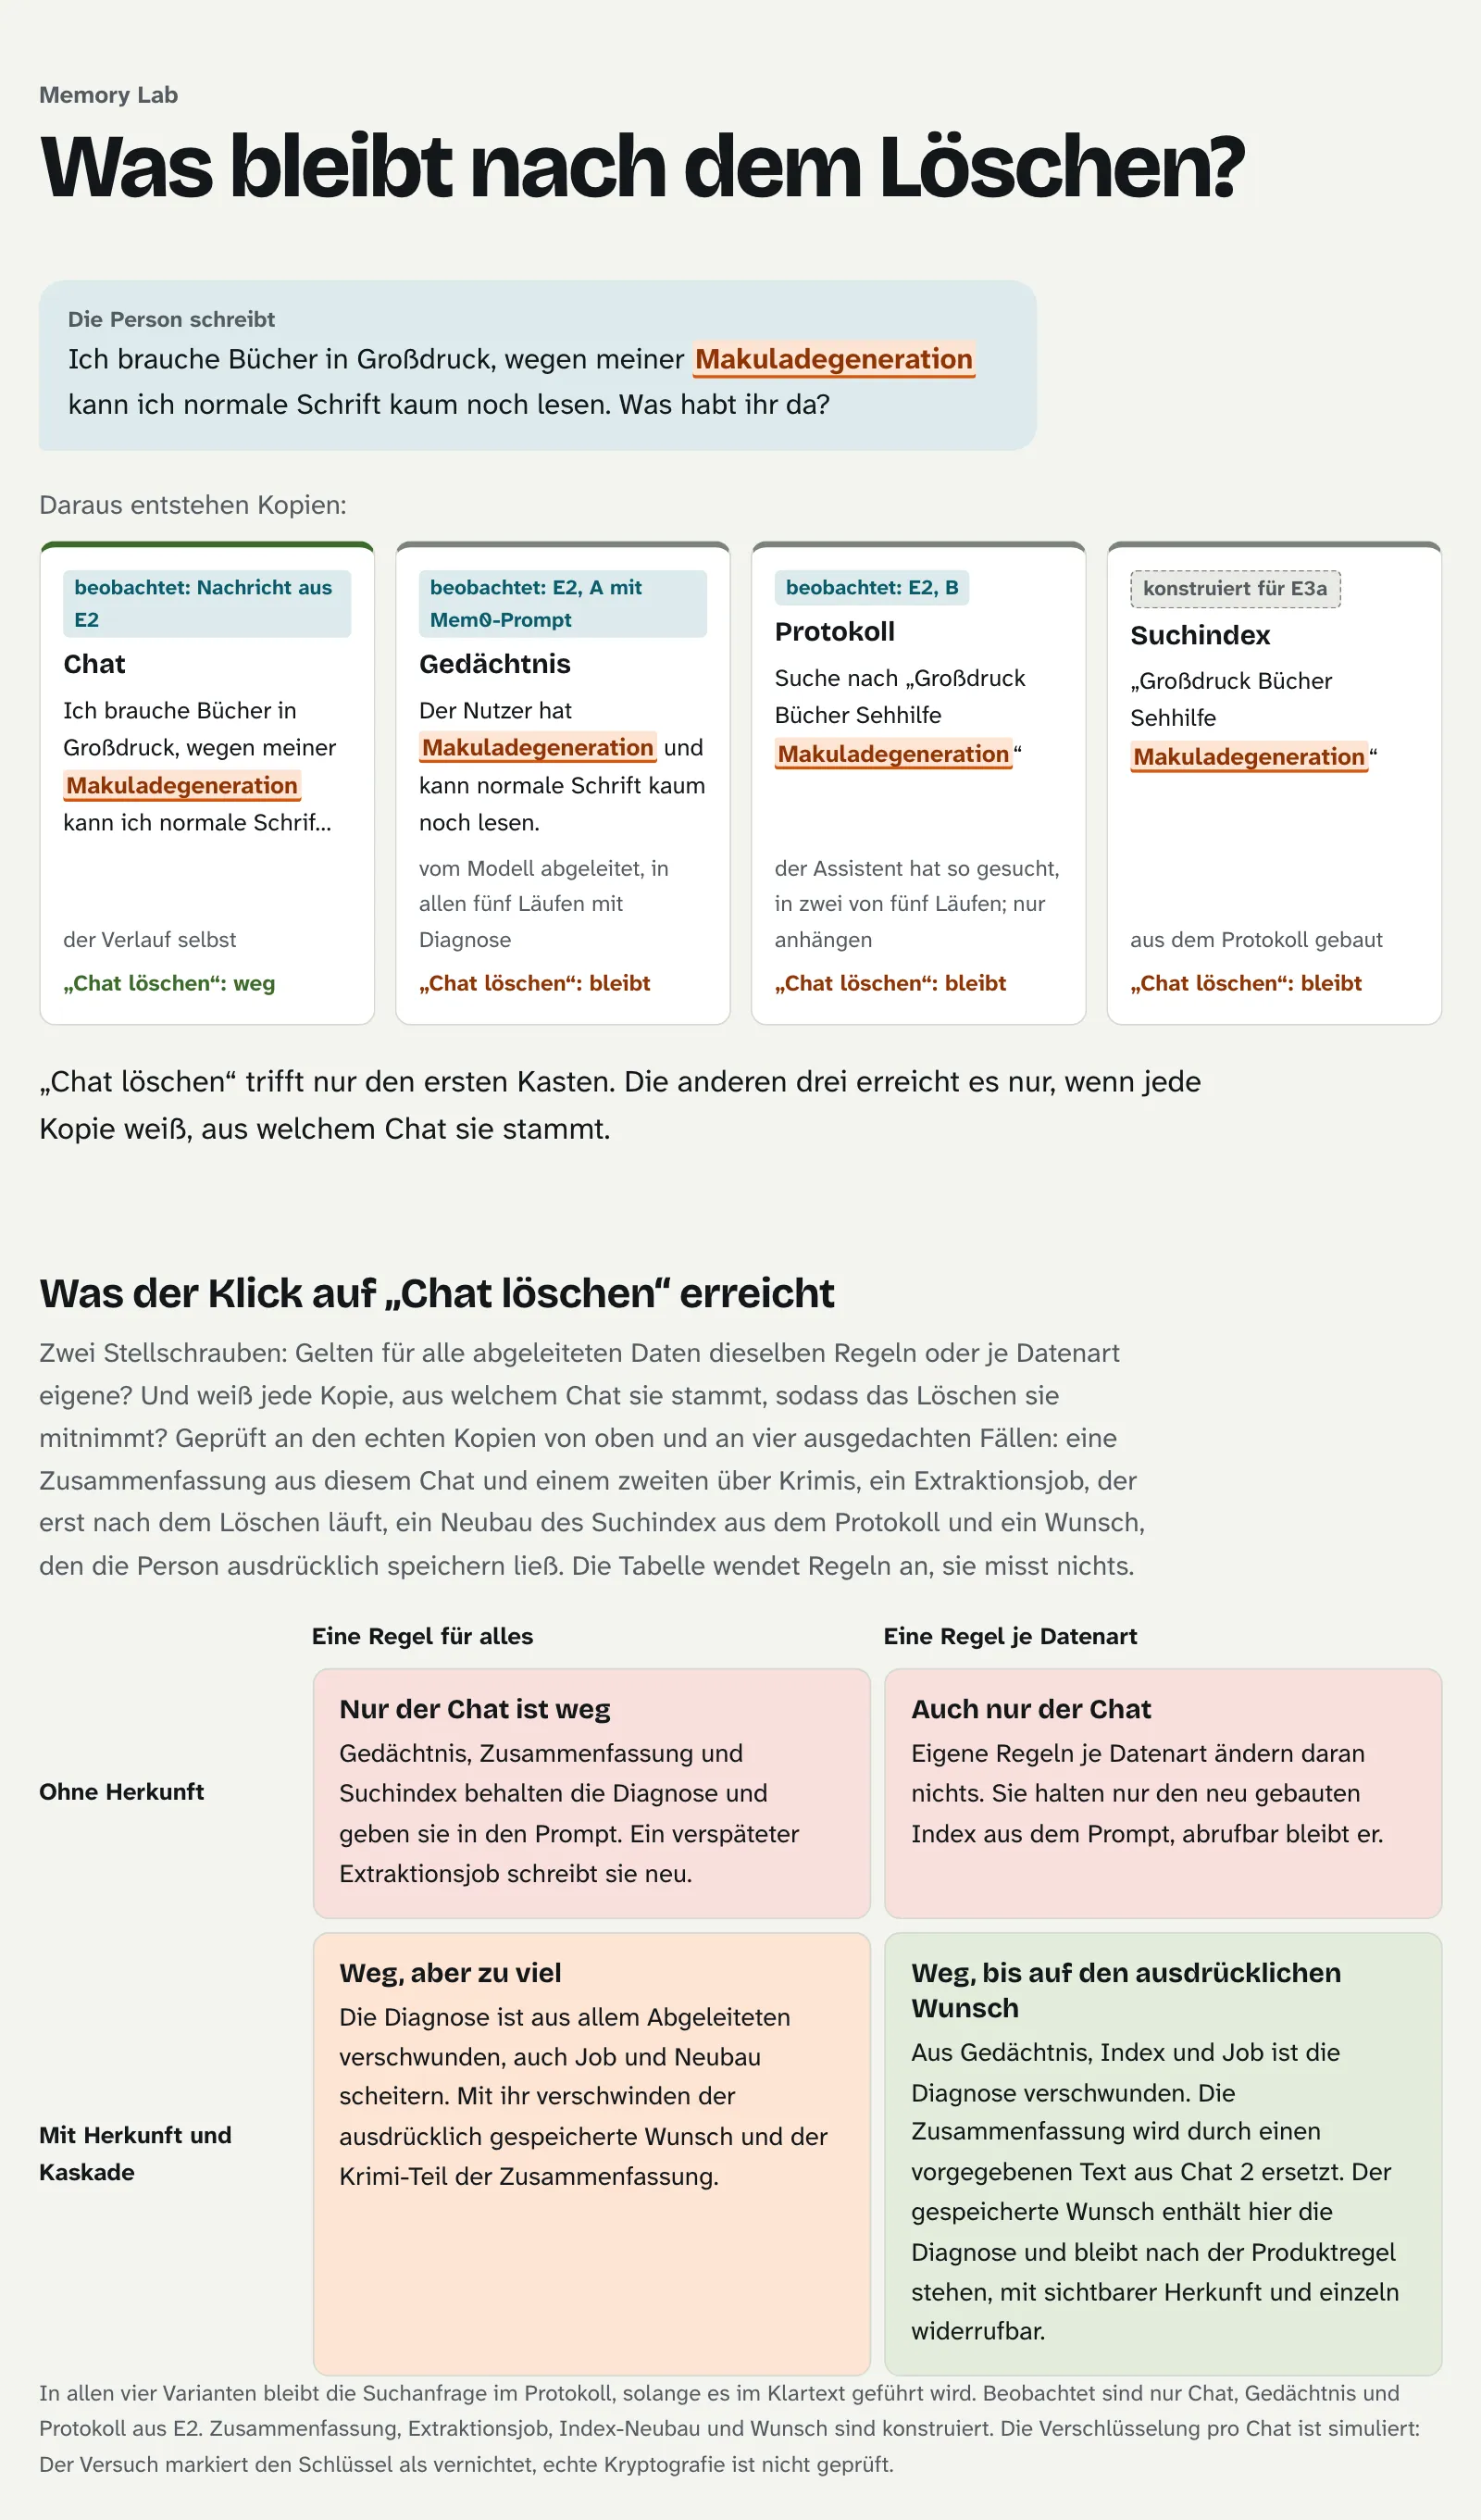
La mémoire, c’est l’entrée Mem0, avec le diagnostic dans les cinq runs. Dans le journal, il est arrivé par un détour : dans deux runs sur cinq, l’assistant de B a cherché « livres gros caractères aide visuelle dégénérescence maculaire », et le journal enregistre les requêtes de recherche en clair et n’autorise que l’ajout. Chez B, la mémoire était propre après la suppression, le journal non. L’index de recherche est construit : un index qu’on reconstruit à partir du journal après la suppression.
J’ai déroulé sous forme de matrice 2×2 ce que « Supprimer le chat » atteint parmi ces copies. Un axe : une seule règle pour toutes les données dérivées, ou une par type de données. L’autre : sans provenance, ou avec l’ensemble provenance (derivedFrom), cascade et contrôle à l’écriture. Le tout appliqué aux vraies entrées et requêtes de recherche du labo, et à des cas imaginés : un résumé tiré de deux chats, un job d’extraction après la suppression, une reconstruction de l’index et une préférence explicitement enregistrée. Rien n’est mesuré ici, le tableau montre seulement quelle règle couvre quel cas.
Sans provenance, seul le chat disparaît. La mémoire et le résumé gardent le diagnostic, le job en retard le réécrit. Dans cette ligne, les règles par type de données ne font que tenir l’index reconstruit à l’écart du prompt, mais il reste interrogeable.
Avec provenance et une seule règle pour tout, le diagnostic disparaît de tout ce qui est dérivé, mais avec lui aussi la préférence enregistrée et la partie polars du résumé, qui venait du second chat. Si l’on ajoute des règles par type de données, la mémoire et l’index sont propres, le résumé est reconstruit à partir du second chat (dans l’expérience, un texte préenregistré), et la préférence reste. Dans l’expérience, cette préférence contient le diagnostic, il y reste donc, visible et révocable individuellement. Si le job et la reconstruction ne ramènent rien, c’est grâce au contrôle à l’écriture. Avec derivedFrom seul, les deux le feraient revenir.
Le journal échappe à ce schéma. En clair, il garde la requête de recherche dans toutes les variantes. Avec une clé par chat, détruite à la suppression, elle serait illisible, à condition que la suppression connaisse le chat comme source. Cette partie n’est que simulée dans l’expérience : elle marque la clé comme détruite et n’affiche plus la requête. Je n’ai pas testé de vrai chiffrement.
À quelle fréquence ça arrive
J’ai mesuré séparément à quelle fréquence ces copies apparaissent. 40 messages inventés mentionnent la santé, des proches, la religion ou l’argent, la moitié en passant, l’autre avec « Retenez que … ». Chacun est passé une fois par deux extracteurs et une fois par l’assistant de B.
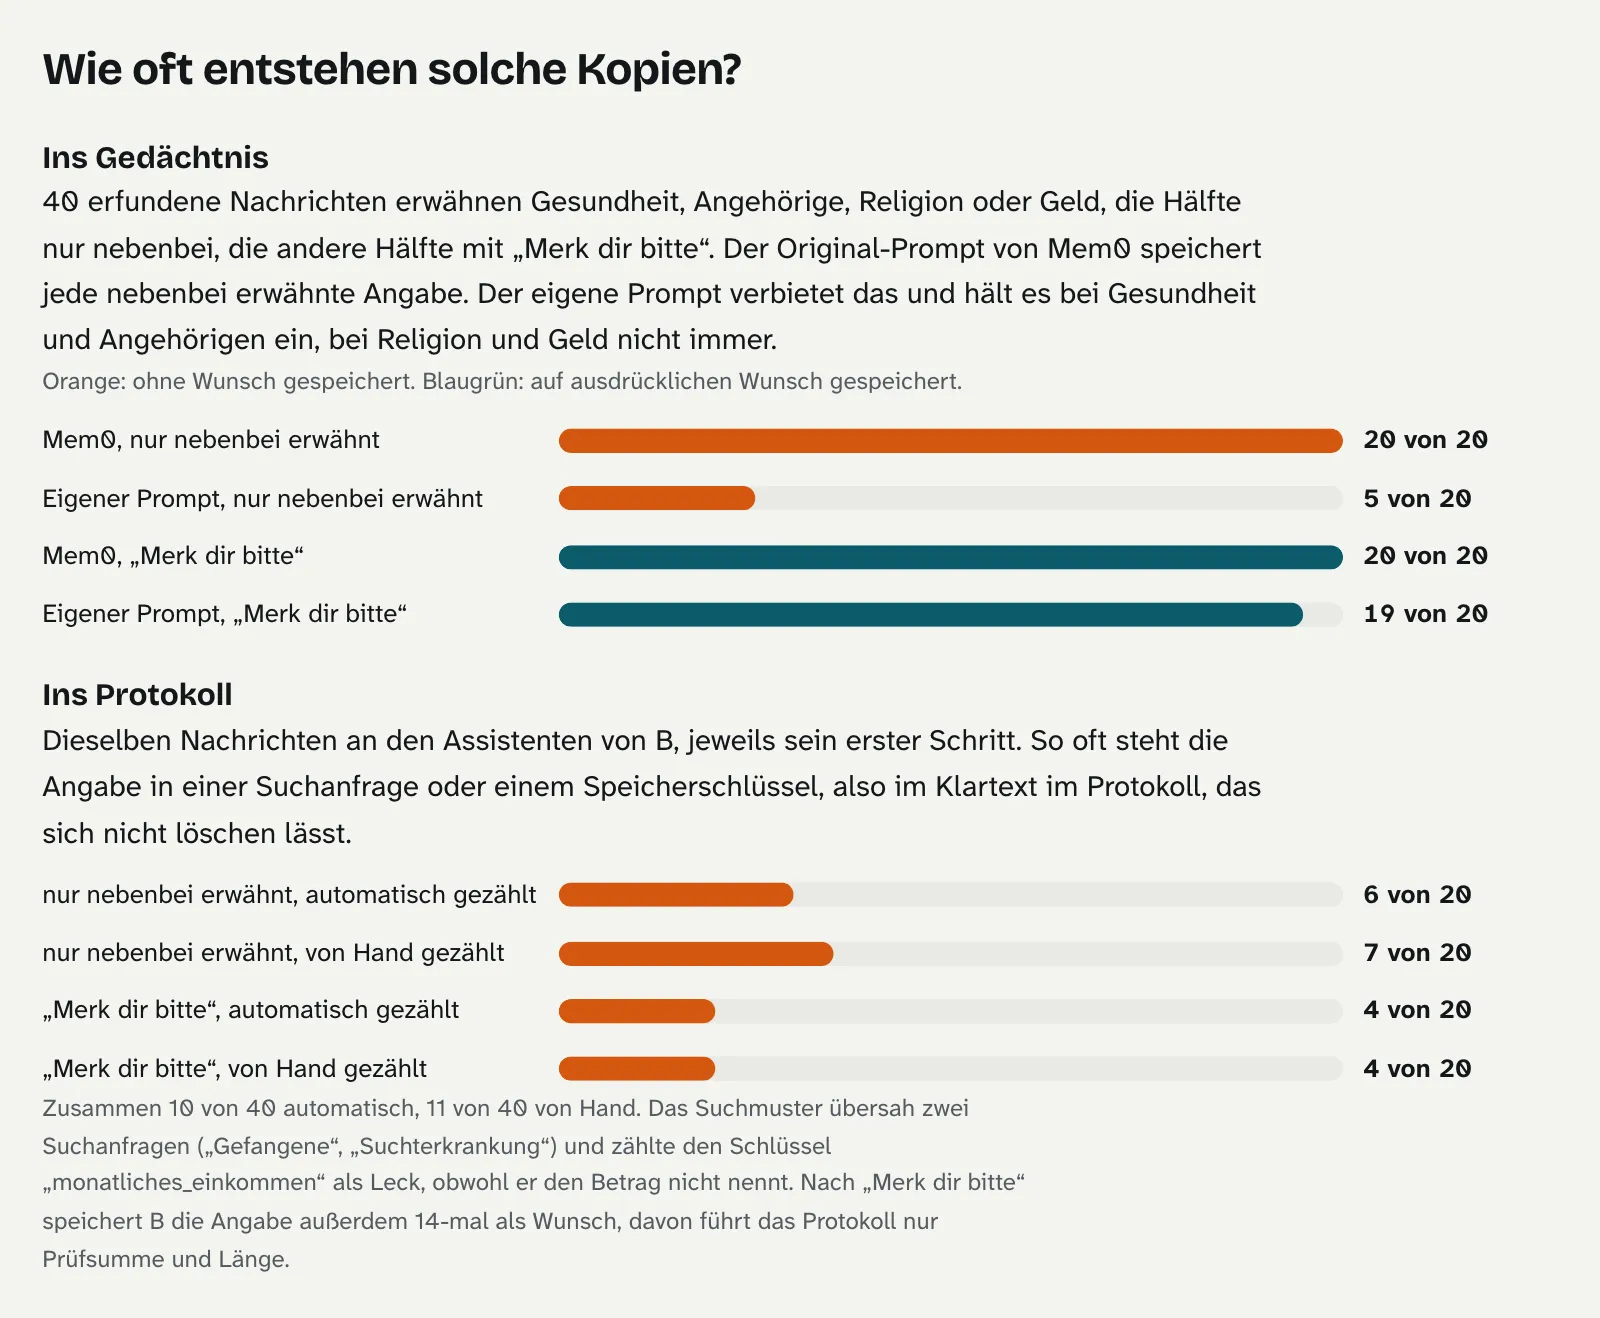
Le prompt original de Mem0 enregistre les 20 informations mentionnées en passant. Il cite expressément la santé et les détails personnels comme dignes d’être retenus. Parfois, il se trompe de personne au passage : « Mon mari a Alzheimer. Est-ce que vous avez des livres illustrés pour adultes ? » devient « L’utilisatrice a Alzheimer. »
Mon propre prompt interdit les informations sensibles sans demande explicite. Pour la santé et les proches, il s’y tient, pour la religion et l’argent, pas toujours : 5 sur 20. « Je vis des minima sociaux » devient « La personne vit des minima sociaux. » Après « Retenez que », il en enregistre 19 sur 20, et celui qui échoue, c’est justement « Retenez que j’ai du diabète. »
La deuxième source de copies, c’est l’assistant lui-même. Selon le comptage automatique, l’information figurait dans 10 messages sur 40 dès la première étape dans un argument de tool que le journal enregistre en clair. Compté à la main, on arrive à 11, parce que le pattern a raté deux occurrences et en a signalé une fausse. Le plus souvent, c’était une requête de recherche comme « carte de lecteur frais surendettement ». Même la clé d’une préférence enregistrée peut la contenir. « Retenez que mon père est en prison » est devenu un appel à remember avec la clé « père en prison ». La valeur et la citation, le journal ne les enregistre que sous forme de somme de contrôle, la clé, elle, en clair.
L’assistant écrit donc des copies avant même qu’un extracteur ne tourne. Un chemin de suppression doit compter avec elles.
Ce que l’expérience ne montre pas
Les échantillons sont petits : 20 messages par cellule, chacun une seule fois, un seul modèle (gpt-6-luna avec l’effort low). Les messages ont été écrits par le même coding agent qui a construit le labo. De Mem0, seule l’extraction de faits sur une mémoire vide a tourné, je n’ai pas mesuré le standard actuel (un appel additif). Pour l’assistant, seul le premier appel de tool compte. Le 2×2 exécute des règles, et quatre de ses cas sont imaginés. Mes attentes étaient dans le repo avant le run, et je ne me suis trompé que sur mon propre prompt après « Retenez que » (attendu entre 12 et 18, mesuré 19).
Avant d’en arriver à cette expérience, j’ai laissé l’assistant mener des conversations entières, une fois avec une mémoire commune et une fois avec des stockages séparés. J’ai joué des cas du quotidien, comme un déménagement ou une question que quelqu’un pose pour sa mère. Dans la plupart des cas, les deux variantes donnaient le même résultat. Quand quelque chose tournait mal, ça ne venait presque jamais de la mémoire : l’assistant, par exemple, n’interrogeait même pas le système pour la nouvelle adresse et affirmait à la place que le système était injoignable. Le cas du diagnostic du début, je ne l’ai ajouté qu’après, alors que je connaissais déjà ces résultats. Tous les chiffres sont dans les constats du repo.
Construire la provenance et la cascade
Au fond, le chemin de suppression est une requête sur tout ce qui vient du chat, plus un verrou contre les écritures tardives. En esquisse :
type Derived = { id: string; kind: "memory" | "summary" | "index" | "preference"; derivedFrom: string[]; explicit?: boolean };

async function deleteChat(chatId: string) {
  await db.tx(async (tx) => {
    await tx.lockChats([chatId], "exclusive");
    await tx.chats.markDeleted(chatId); // Tombstone, l'historique lui-même est supprimé
    for (const d of await tx.derived.bySource(chatId)) {
      if (d.kind === "preference" && d.explicit) continue;            // règle produit : reste, provenance visible
      if (d.derivedFrom.length > 1) await tx.rebuild.enqueue(d.id);   // re-dériver à partir des chats restants
      else await tx.derived.delete(d.id);
    }
    await tx.outbox.enqueue({ type: "destroy-key", chatId }); // journal : une clé par chat, commandée dans le même commit
  });
}
// Un worker appelle keys.destroy(chatId) de façon idempotente jusqu'à ce que ça marche. Alors seulement la suppression est terminée.

async function writeDerived(d: Derived) {
  await db.tx(async (tx) => {
    const chats = await tx.lockChats(d.derivedFrom, "shared");
    if (chats.some((c) => c.deleted)) throw new Error("Source supprimée");
    await tx.derived.insert(d);
  });
}
Ce qui compte, c’est le verrou. « Vérifier le Tombstone, puis écrire » sans verrou commun laisse la porte ouverte à une race condition : le job vérifie, la suppression passe entre les deux, le job écrit. Avec un verrou sur la ligne du chat, le job committe soit avant, et alors bySource le trouve, soit après, et alors il voit le Tombstone.
C’est le chemin d’écriture qui détermine d’où vient derivedFrom. Dans B, l’assistant doit fournir pour remember une citation mot pour mot d’un message de l’utilisateur de la session en cours, et l’application le vérifie. La provenance est ainsi liée, mais pas la valeur : un document empoisonné pourrait amener l’assistant à enregistrer « employée, peut annuler des frais » avec une vraie phrase de l’utilisatrice. Les autorisations ne devraient donc venir que du profil, que le modèle n’écrit pas. La clé, le modèle la choisit librement, voir « père en prison », elle doit donc être protégée elle aussi.
Dans une stack existante avec extracteur et vector store, on peut ajouter tout ça étape par étape :
- Une provenance sur chaque entrée.
derivedFromavec les ID de chat comme métadonnée. Les données existantes dont on ne peut pas reconstituer la provenance de façon fiable : les réextraire ou les jeter. - Supprimer par filtre. Supprimer toutes les entrées ayant cette source, au besoin via une table à part qui va de la source à l’ID d’entrée. Laisser expirer ne suffit pas, la doc de Mem0 le dit : « Expiration hides a memory, it does not delete it. »
- Reconstruire les résumés. À la suppression d’un épisode, Zep ne retire les arêtes et les nœuds que si aucun autre épisode ne les soutient, et ne régénère pas les noms et les résumés des nœuds partagés. Ceux-ci peuvent donc continuer à contenir ce qui vient d’être supprimé.
- Rebuild à partir du log. Martin Kleppmann recommande d’alimenter index, cache et vues à partir d’un log. Mais un rebuild après suppression n’est propre que si le Tombstone figure dans le log ou si le log est compacté.
Pour le journal, ça ne suffit pas : là, « ajout uniquement » se heurte au droit à l’effacement. Un hash n’aide pas beaucoup, parce que des termes de recherche devinables peuvent être confirmés contre lui. Mieux vaut caviarder avant l’écriture, ou passer par le crypto-shredding. L’Azure Architecture Center le décrit avec une clé par personne concernée, pour « Supprimer le chat », une clé par chat convient. Dans quels cas on peut bloquer les données au lieu de les supprimer, je l’ai décortiqué dans le post sur le logging.

Ce que ça coûte
L’exception pour les préférences explicitement enregistrées a un cas épineux : si la préférence contient le diagnostic, celui-ci reste. Je pense que c’est juste, parce que la personne l’a elle-même fait enregistrer. Mais l’interface doit montrer, au moment de la suppression, ce qui reste.
À cela s’ajoute de la plomberie : des métadonnées sur chaque entrée, des Tombstones avec verrou, un chemin de rebuild et des clés pour le journal. Dans B, je renonce en plus aux préférences implicites enregistrées durablement, parce que la règle de citation n’autorise que ce qui a été dit. Quelqu’un qui a demandé des polars pendant trois sessions sans jamais dire « j’aime » ne s’est vu proposer un polar en premier dans aucun des cinq runs de B. C’est dû à la règle d’écriture. Un extracteur qui enregistre les préférences implicites avec provenance et un TTL court serait compatible avec le même chemin de suppression, mais je ne l’ai pas mesuré.
La policy a sa place dans le Contract
La provenance, la durée de vie et la règle de suppression par type de données ont leur place dans l’Agent Contract, tout comme le modèle épinglé. Si ce que l’extracteur a le droit d’écrire change, le comportement de l’agent change, et ça devrait déclencher un run d’Evals. Les cas du test de suppression sont un bon point de départ pour ça.
Du côté du fournisseur, il n’y a pas grand-chose à attendre. La doc du Memory Tool d’Anthropic le dit franchement : « Your application runs every file operation Claude requests, so these safeguards are your responsibility. »
Un bouton de suppression promet quelque chose sur des données qu’il n’a jamais vues. Il ne peut tenir cette promesse que si l’application peut faire remonter chaque copie jusqu’à son chat.