Den som ger en agent ett minne skapar kopior. De går bara att radera riktat om varje kopia vet var den kommer ifrån.
I hjälpen om Claudes memory finns en mening som är lätt att missa: ”When a conversation is deleted, including under a retention period, memory entries generated from it aren’t removed”. Enskilda memories kan man radera för hand där, och känsliga ämnen sparar Claude som standard inte alls. Chatt och minne har ändå separata raderingsvägar.
Hur det kan se ut i värsta fall har jag återskapat i ett litet labb. Informationsassistenten på ett påhittat stadsbibliotek får meddelandet: ”Jag behöver böcker med stor stil, på grund av min makuladegeneration kan jag knappt läsa vanlig text längre. Vad har ni?” En extraktor med Mem0:s originalprompt gör om det till posten ”Användaren har makuladegeneration och kan knappt läsa vanlig text längre.” Dagen efter raderar personen chatten via gränssnittet och frågar: ”Vad vet du egentligen om mig?”
Assistenten svarar: ”Från tidigare samtal vet jag att du har makuladegeneration, knappt kan läsa vanlig text och behöver böcker med stor stil.” Så gick det i alla fem körningarna.
Posten visste inte vilken chatt den kom från, så raderingen hittade den aldrig. I min uppställning var det först ett paket med tre saker som nådde den: härkomst på varje kopia, en raderingskaskad och en skrivkontroll som inte tar emot något från en raderad chatt. För att inte för mycket ska försvinna på vägen behövs regler per datatyp, och loggen behöver en egen lösning.
Inför försöket bestämde jag i förväg vad knappen lovar: ”Radera chatt” tar bort historiken och allt som härletts ur den. Undantaget är en önskan som personen uttryckligen bett om att få sparad. Den finns kvar, visar sin härkomst (”från en raderad chatt”) och kan återkallas för sig.
Demo: rubenvitt.github.io/memory-lab - kopiorna av ett meddelande och vad ”Radera chatt” når av dem.
Repo med regler, prompts och alla råa svar: github.com/rubenvitt/memory-lab
Fem saker som alla kallas memory
Bakom ordet döljer sig minst fem datatyper, och var och en har en annan ägare och en annan livslängd.
Session state är historiken för det pågående samtalet, inklusive tool-resultat. Den tillhör sessionen, hamnar som utdrag i prompten och förfaller efter minuter eller dagar.
Profilen med adress, avtal och kundnummer tillhör verksamhetssystemet där den fanns långt innan agenten. Agenten läser utvalda fält. Ändringar och radering sker där, kopiorna följer efter.
En preferens har personen själv uttryckt, till exempel ”påminnelser via sms, tack”. Den gäller tills personen tar tillbaka den, och står i prompten av just det skälet.
Vid retrieval hämtar agenten dokument, ärenden eller gamla chattar via sökning. Indexet ovanpå är bara en kopia. Det lever lika länge som sin källa och måste uppdateras när den försvinner. Till prompten går bara träffarna.
Audit-loggen tillhör operatören och registrerar vad agenten har gjort. Den hamnar aldrig i prompten och raderas först när lagringstiden har löpt ut. Personuppgifter i den behöver en egen lösning, till exempel redaction eller en nyckel som går att förstöra.
Mem0-posten från labbet passar inte in på någon av de här raderna. Den är härledd som ett index, står i prompten som en preferens och har varken utgångsdatum eller härkomst.
Separata regler kräver för övrigt inte fem databaser. En tabell med en kolumn för datatypen räcker, så länge varje typ får sin egen raderings- och promptregel.
Ett meddelande, fyra kopior
Labbet har två varianter. I den första skriver en extraktor till ett gemensamt minne utan härkomst, som ovan. Den andra, jag kallar den B, har regler per datatyp, preferenser bara via tool och härkomst på varje post. Grafiken sätter ihop kopior från båda varianterna och ett påhittat fall.
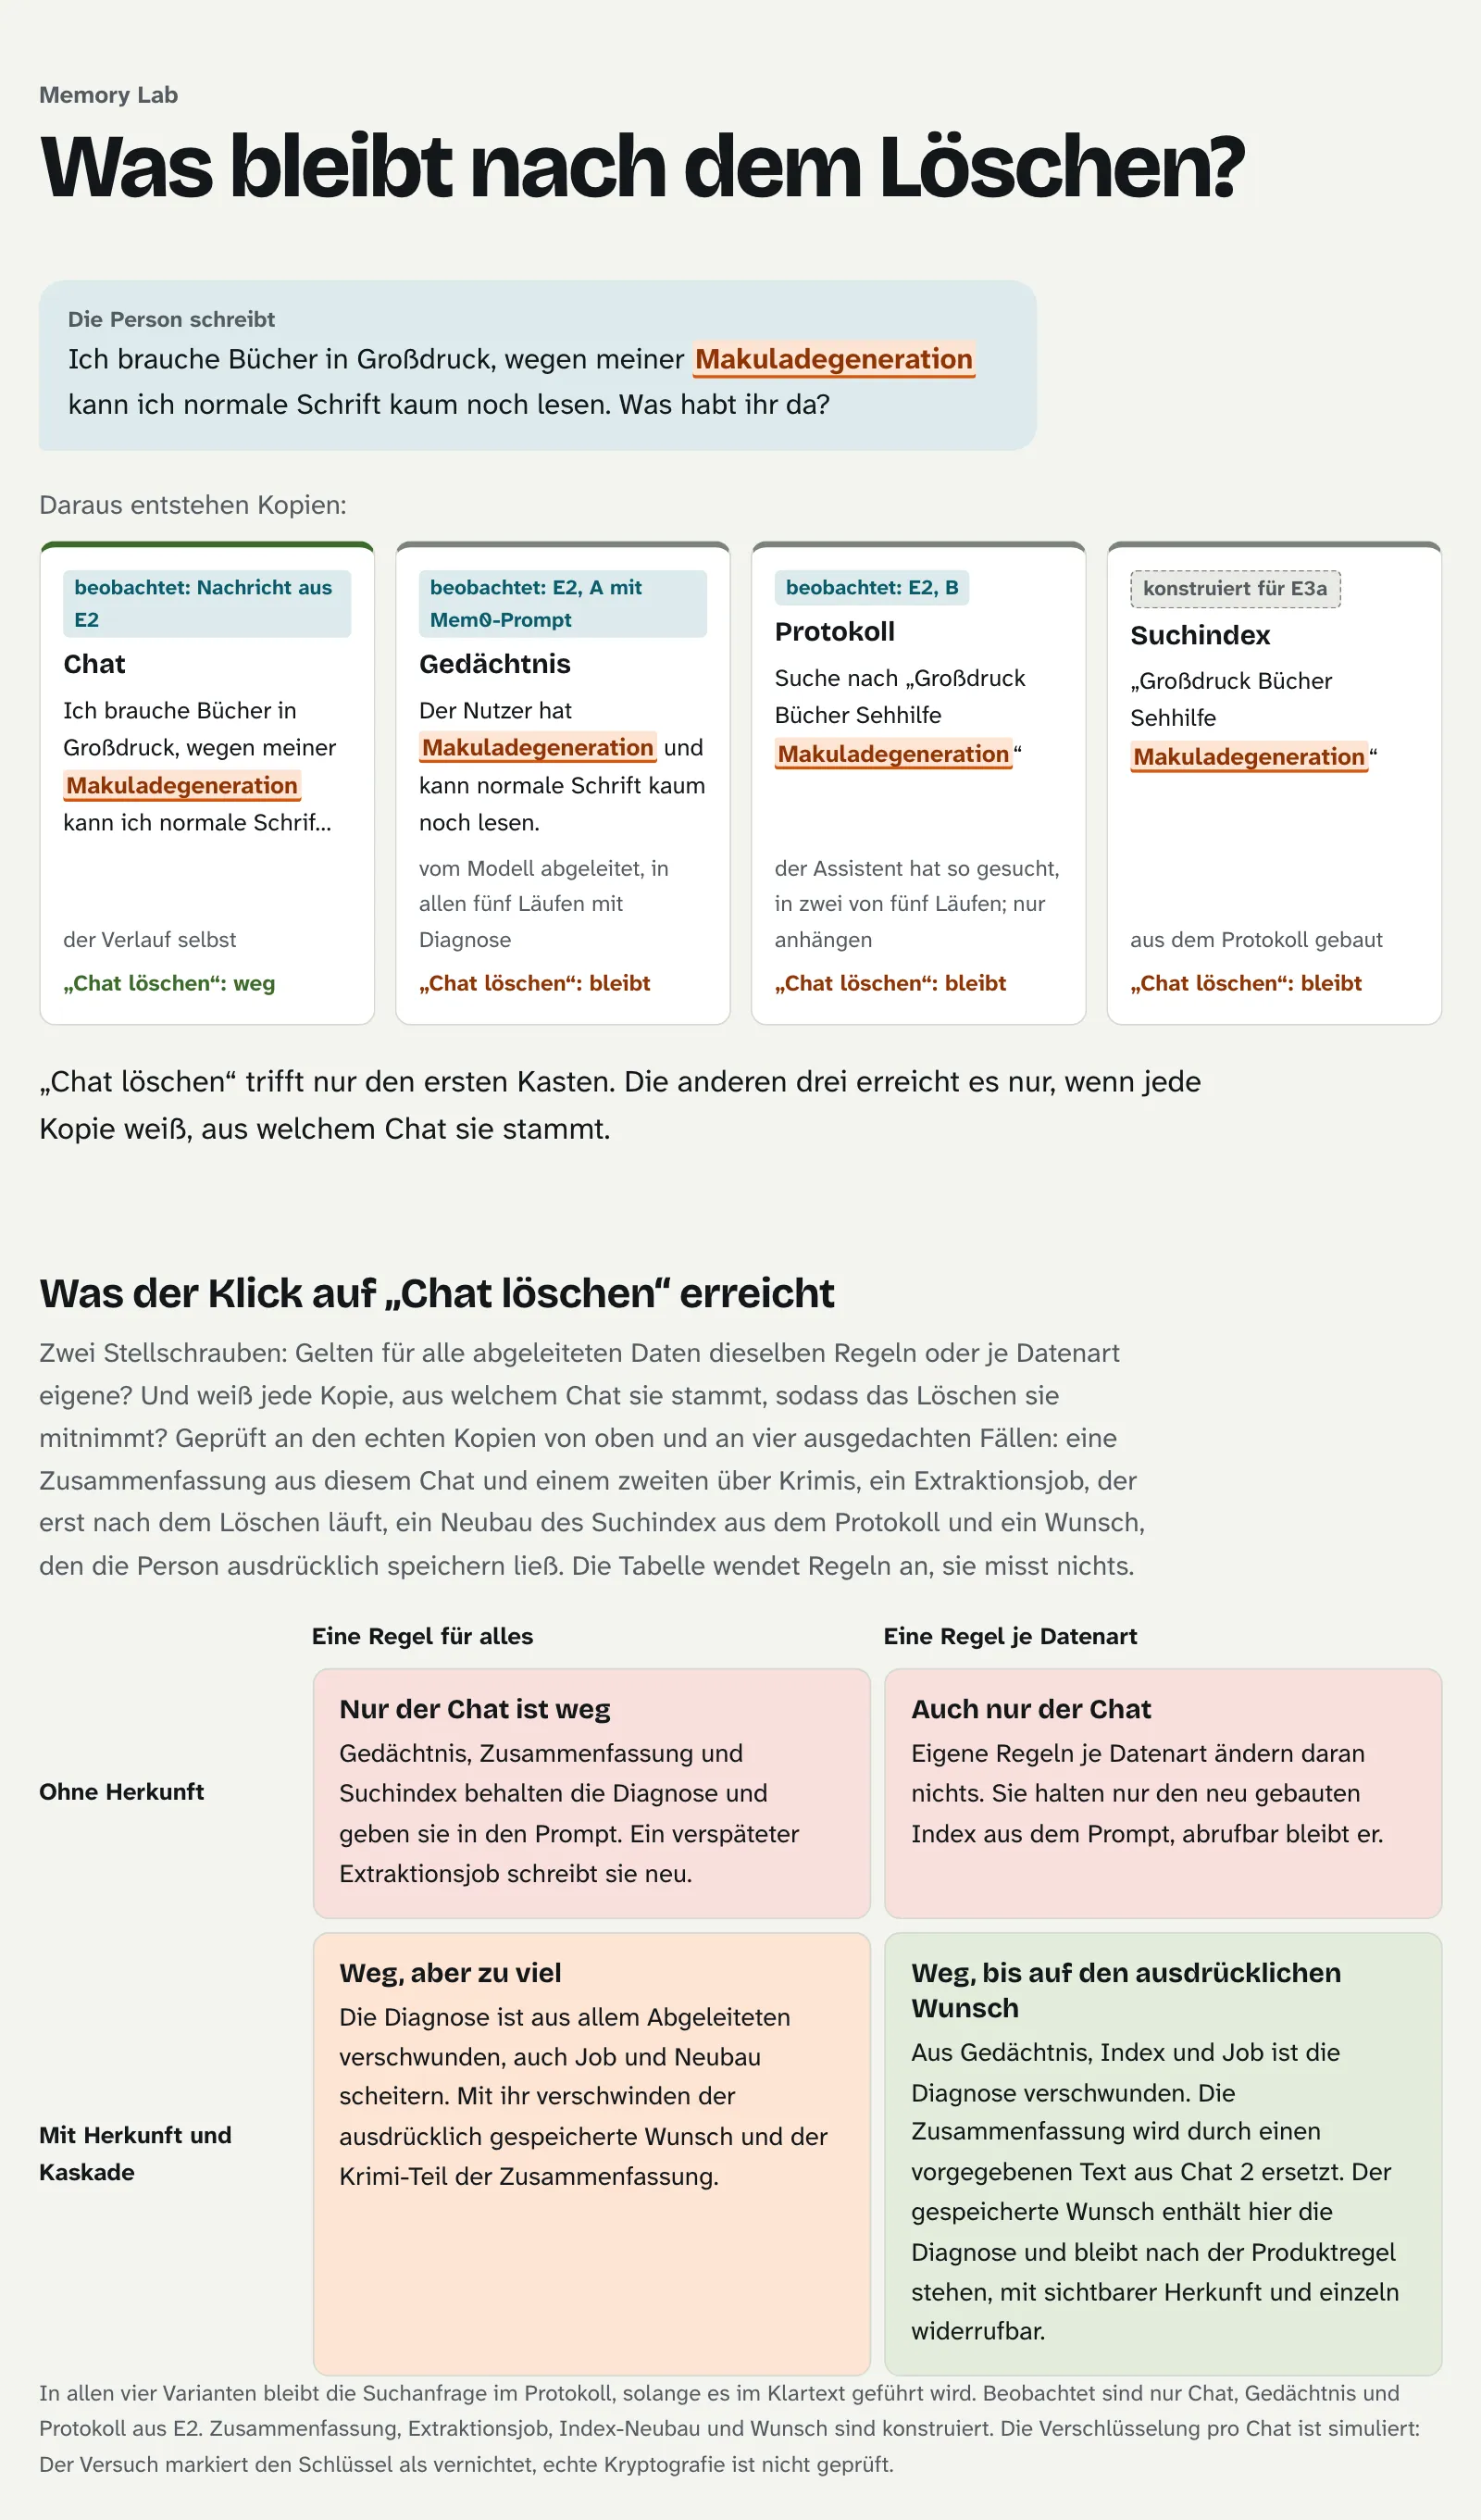
Minnet är Mem0-posten, med diagnos i alla fem körningarna. Till loggen kom den via en omväg: I två av fem körningar sökte B:s assistent efter ”böcker stor stil synhjälpmedel makuladegeneration”, och loggen sparar sökfrågor i klartext och tillåter bara tillägg. Hos B var minnet rent efter raderingen, loggen var det inte. Sökindexet är konstruerat: ett som byggs om från loggen efter raderingen.
Vad ”Radera chatt” når av sådana kopior har jag spelat igenom som en 2×2. En axel: en regel för all härledd data eller en per datatyp. Den andra: utan härkomst eller med paketet av härkomst (derivedFrom), kaskad och skrivkontroll. Tillämpat på de riktiga posterna och sökfrågorna från labbet och på påhittade fall: en sammanfattning av två chattar, ett extraktionsjobb efter raderingen, en ombyggnad av indexet och en uttryckligen sparad önskan. Ingenting mäts här, tabellen visar bara vilken regel som täcker vilket fall.
Utan härkomst är bara chatten borta. Minnet och sammanfattningen behåller diagnosen, det försenade jobbet skriver in den på nytt. Regler per datatyp håller på den här raden bara det ombyggda indexet borta från prompten, men det går fortfarande att hämta.
Med härkomst och en regel för allt försvinner diagnosen ur allt härlett, men med den också den sparade önskan och deckardelen av sammanfattningen, som kom från den andra chatten. Lägger man till regler per datatyp är minne och index rena, sammanfattningen byggs om från den andra chatten (i försöket en förberedd text), och önskan finns kvar. I försöket innehåller den önskan diagnosen, så där står den kvar, synlig och möjlig att återkalla för sig. Att jobbet och ombyggnaden inte tar tillbaka något beror på skrivkontrollen. Med bara derivedFrom skulle båda komma tillbaka.
Loggen faller utanför schemat. I klartext behåller den sökfrågan i varje variant. Med en nyckel per chatt som förstörs vid raderingen skulle den bli oläslig, förutsatt att raderingen känner till chatten som källa. Den delen simulerar försöket bara: Det markerar nyckeln som förstörd och visar inte längre frågan. Riktig kryptering har jag inte testat.
Hur ofta det händer
Hur ofta sådana kopior uppstår har jag mätt separat. 40 påhittade meddelanden nämner hälsa, anhöriga, religion eller pengar, hälften i förbigående, den andra hälften med ”Kom ihåg att …”. Varje meddelande gick en gång genom två extraktorer och en gång till B:s assistent.
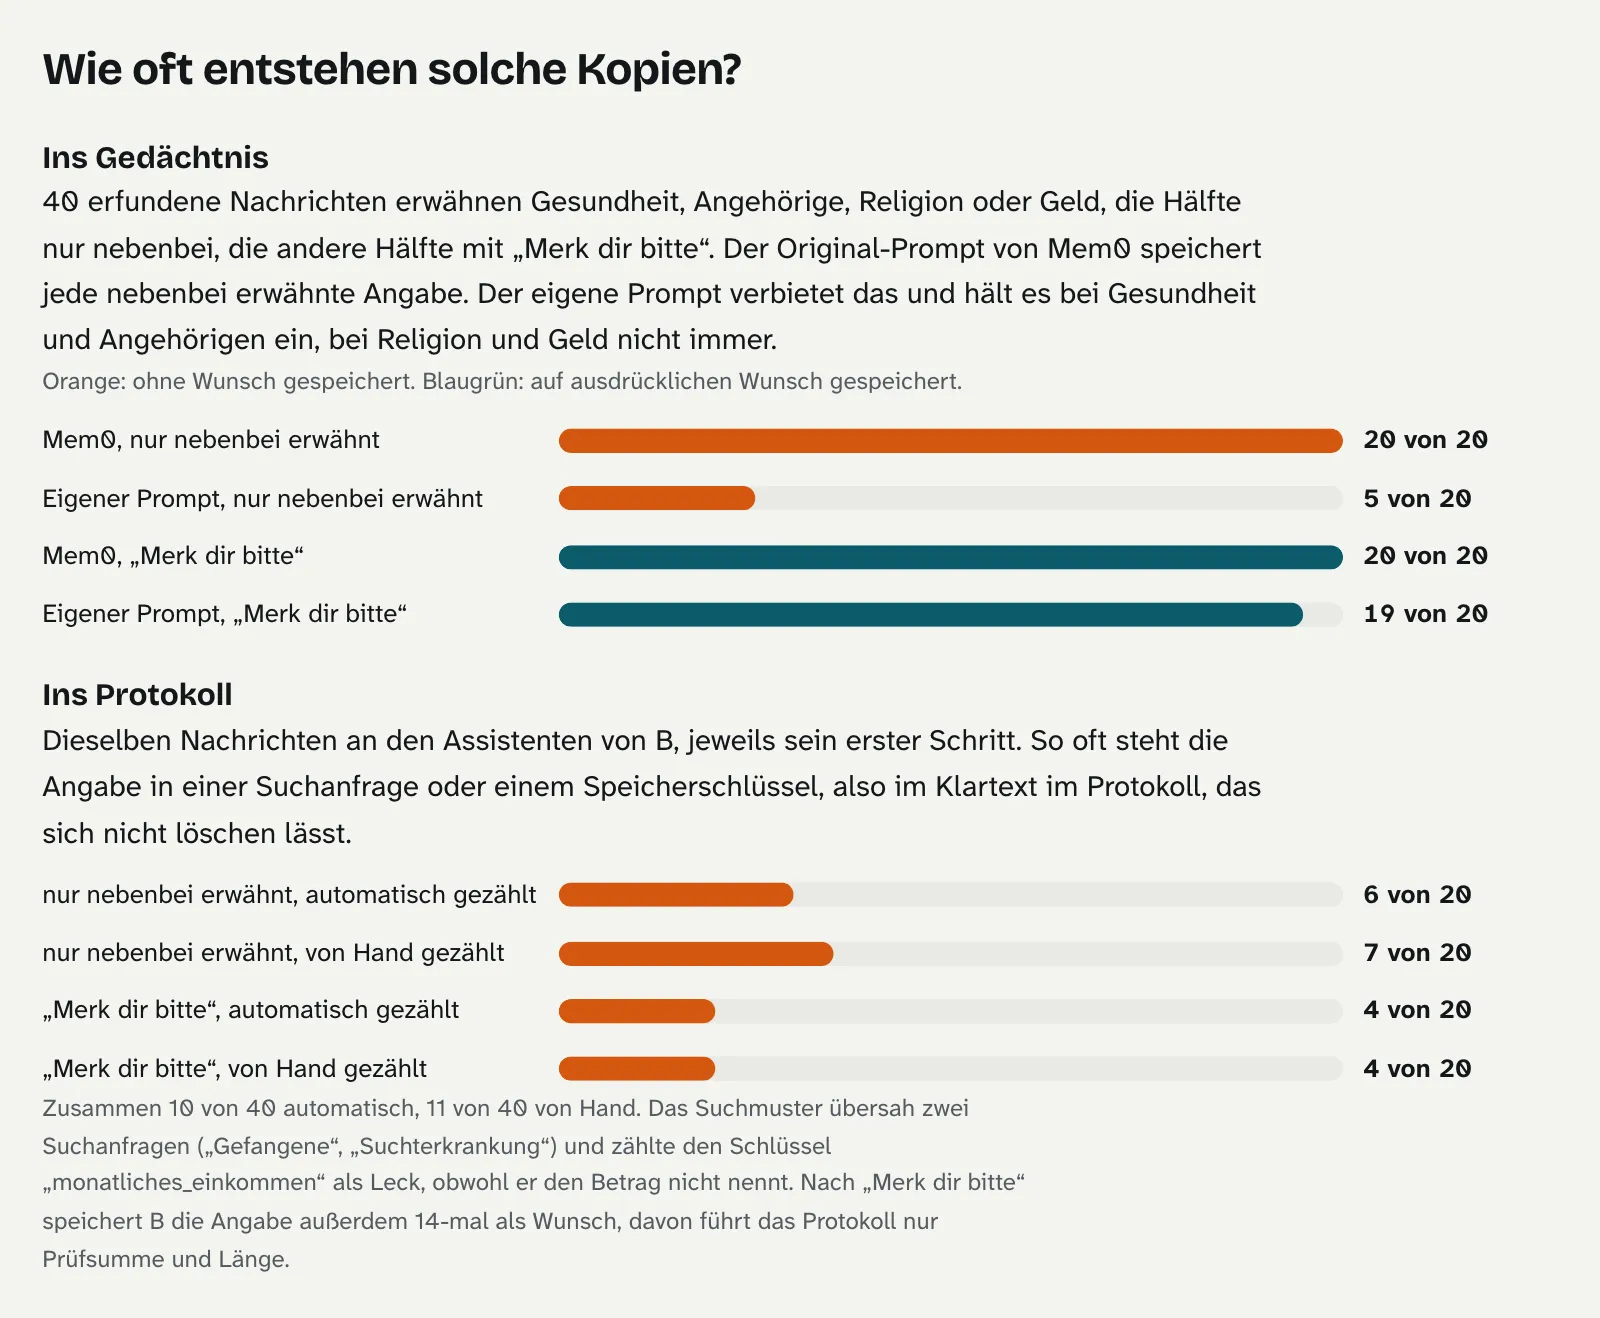
Mem0:s originalprompt sparar alla 20 uppgifter som nämns i förbigående. Den listar uttryckligen hälsa och personliga detaljer som värda att minnas. Ibland kopplar den dessutom fel: ”Min man har Alzheimers. Finns det bilderböcker för vuxna?” blir ”Användaren har Alzheimers.”
Min egen prompt förbjuder känsliga uppgifter utan uttrycklig önskan. För hälsa och anhöriga håller den sig till det, för religion och pengar inte alltid: 5 av 20. ”Jag lever på försörjningsstöd” blir ”Personen lever på försörjningsstöd.” Efter ”Kom ihåg att” sparar den 19 av 20, och den som föll bort var av alla saker ”Kom ihåg att jag har diabetes.”
Den andra källan till kopior är assistenten själv. Enligt automatisk räkning stod uppgiften i 10 av 40 meddelanden redan i första steget i ett tool-argument som loggen sparar i klartext. Räknat för hand blir det 11, eftersom mönstret missade två träffar och rapporterade en felaktig. Oftast var det en sökfråga som ”lånekort avgifter skuldsanering”. Till och med nyckeln för en sparad önskan kan innehålla den. ”Kom ihåg att min pappa sitter i fängelse” blev ett remember-anrop med nyckeln ”pappa sitter i fängelse”. Värde och citat sparar loggen bara som checksumma, nyckeln i klartext.
Assistenten skriver alltså kopior innan någon extraktor ens har kört. En raderingsväg måste räkna med dem.
Vad försöket inte visar
Siffrorna är små: 20 meddelanden per cell, vart och ett en gång, en modell (gpt-6-luna med effort low). Meddelandena skrevs av samma coding agent som byggde labbet. Av Mem0 körde bara faktaextraktionen mot ett tomt minne, den nuvarande standarden (ett additivt anrop) har jag inte mätt. Hos assistenten räknas bara det första tool-anropet. 2×2:an tillämpar regler, och fyra av dess fall är påhittade. Mina förväntningar låg i repot före körningen, och fel hade jag bara om min egen prompt efter ”Kom ihåg att” (väntat 12 till 18, uppmätt 19).
Innan jag landade i det här försöket lät jag assistenten föra hela samtal, en gång med ett gemensamt minne och en gång med separata lager. Jag spelade igenom vardagsfall som en flytt eller en fråga som någon ställer åt sin mamma. I de flesta fallen blev resultatet detsamma för båda varianterna. När något gick fel låg det nästan aldrig i minnet: Assistenten slog till exempel inte ens upp den nya adressen i systemet och påstod i stället att systemet inte gick att nå. Fallet med diagnosen från början lade jag till först efteråt, när jag redan kände till de här resultaten. Alla siffror finns i fynden i repot.
Bygga härkomst och kaskad
I grunden är raderingsvägen en sökning efter allt som kommer från chatten, plus ett lås mot sena skrivningar. Som skiss:
type Derived = { id: string; kind: "memory" | "summary" | "index" | "preference"; derivedFrom: string[]; explicit?: boolean };

async function deleteChat(chatId: string) {
  await db.tx(async (tx) => {
    await tx.lockChats([chatId], "exclusive");
    await tx.chats.markDeleted(chatId); // Tombstone, själva historiken raderas
    for (const d of await tx.derived.bySource(chatId)) {
      if (d.kind === "preference" && d.explicit) continue;            // Produktregel: finns kvar, härkomsten syns
      if (d.derivedFrom.length > 1) await tx.rebuild.enqueue(d.id);   // härled på nytt från de övriga chattarna
      else await tx.derived.delete(d.id);
    }
    await tx.outbox.enqueue({ type: "destroy-key", chatId }); // Logg: nyckel per chatt, beställd i samma commit
  });
}
// En worker anropar keys.destroy(chatId) idempotent tills det lyckas. Först då är raderingen klar.

async function writeDerived(d: Derived) {
  await db.tx(async (tx) => {
    const chats = await tx.lockChats(d.derivedFrom, "shared");
    if (chats.some((c) => c.deleted)) throw new Error("Källan raderad");
    await tx.derived.insert(d);
  });
}
Det viktiga är låset. ”Kolla tombstone, skriv sedan” utan gemensamt lås lämnar en race condition öppen: Jobbet kontrollerar, raderingen går igenom emellan, jobbet skriver. Med lås på chattraden committar jobbet antingen före, då hittar bySource det, eller efter, då ser det tombstonen.
Varifrån derivedFrom kommer avgörs av skrivvägen. I B måste assistenten för remember skicka med ett ordagrant citat ur ett användarmeddelande i den pågående sessionen, och applikationen kontrollerar det. Därmed är härkomsten bunden, men inte värdet: Ett förgiftat dokument skulle kunna få assistenten att lagra ”anställd, får efterskänka avgifter” tillsammans med en riktig mening från användaren. Behörigheter bör därför uteslutande komma från profilen, som modellen inte skriver till. Nyckeln väljer modellen fritt, se ”pappa sitter i fängelse”, så även den behöver skyddas.
I en befintlig stack med extraktor och vector store går det att bygga in steg för steg:
- Härkomst på varje post.
derivedFrommed chatt-ID:na som metadata. Gamla poster vars härkomst inte går att rekonstruera tillförlitligt extraheras på nytt eller kastas. - Radera via filter. Radera alla poster med den här källan, vid behov via en egen tabell från källa till post-ID. Att låta dem löpa ut räcker inte, i Mem0:s dokumentation står det: ”Expiration hides a memory, it does not delete it.”
- Bygg om sammanfattningar. När Zep raderar en episod tar den bara bort kanter och noder som ingen annan episod stöder, och genererar inte om namn och sammanfattningar för delade noder. De kan alltså fortfarande innehålla det som just raderades.
- Rebuild från loggen. Martin Kleppmann rekommenderar att mata index, cache och views från en logg. En rebuild efter raderingen blir dock bara ren om tombstonen står i loggen eller loggen kompakteras.
För audit-loggen räcker det inte, där krockar ”bara tillägg” med rätten till radering. En hash hjälper föga, eftersom gissningsbara sökord kan bekräftas mot den. Bättre är redaction före skrivning eller crypto-shredding. Azure Architecture Center beskriver det med en nyckel per berörd person, för ”Radera chatt” passar en per chatt. När spärrning i stället för radering kan komma i fråga har jag redt ut i inlägget om loggning.

Vad det kostar
Undantaget för uttryckligen sparade önskemål har ett svårt fall: Innehåller önskan diagnosen, står den kvar. Jag tycker att det är rätt, eftersom personen själv bad om att få den sparad. Men gränssnittet måste visa vid raderingen vad som blir kvar.
Till det kommer plumbing: metadata på varje post, tombstones med lås, en rebuild-väg och nycklar för loggen. I B avstår jag dessutom från permanent sparade implicita preferenser, eftersom citatregeln bara släpper igenom sådant som faktiskt har sagts. Den som frågade efter deckare i tre sessioner utan att säga ”jag gillar” fick av B inte en deckare som första rekommendation i någon av de fem körningarna. Det beror på skrivregeln. En extraktor som lagrar implicita preferenser med härkomst och kort TTL skulle fungera med samma raderingsväg, men det har jag inte mätt.
Policyn hör hemma i Contract
Härkomst, livslängd och raderingsregel per datatyp hör hemma i Agent Contract, precis som den pinnade modellen. Ändras vad extraktorn får skriva, ändras agentens beteende, och det borde trigga en eval-körning. Fallen från raderingstestet är en användbar början.
Från leverantören får man inte mycket hjälp. Dokumentationen för Anthropics Memory Tool säger det rakt ut: ”Your application runs every file operation Claude requests, so these safeguards are your responsibility.”
En raderingsknapp lovar något om data som den aldrig har sett. Löftet håller bara om applikationen kan spåra varje kopia tillbaka till sin chatt.