Gir du en agent hukommelse, lager du kopier. De lar seg bare slette målrettet hvis hver kopi vet hvor den kommer fra.
I hjelpesiden om Claudes memory står det en setning som er lett å overse: «When a conversation is deleted, including under a retention period, memory entries generated from it aren’t removed». Enkelte memories kan man slette for hånd der, og sensitive temaer lagrer Claude som standard ikke i det hele tatt. Likevel har chat og hukommelse hver sin vei til sletting.
Hvordan det kan se ut når det går galt, har jeg gjenskapt i et lite laboratorium. Informasjonsassistenten til et oppdiktet bybibliotek får meldingen: «Jeg trenger bøker med stor skrift, jeg har makuladegenerasjon og klarer nesten ikke å lese vanlig skrift lenger. Hva har dere?» En extractor med originalprompten til Mem0 gjør det om til oppføringen «Brukeren har makuladegenerasjon og klarer nesten ikke å lese vanlig skrift lenger.» Dagen etter sletter personen chatten via brukergrensesnittet og spør: «Hva vet du egentlig om meg?»
Assistenten svarer: «Fra tidligere samtaler vet jeg at du har makuladegenerasjon, nesten ikke klarer å lese vanlig skrift og trenger bøker med stor skrift.» Slik gikk det i alle fem kjøringene.
Oppføringen visste ikke hvilken chat den kom fra, så slettingen fant den ikke. I mitt oppsett var det først en kombinasjon av tre ting som nådde den: opphav på hver kopi, en slettekaskade og en skrivekontroll som ikke tar imot noe fra en slettet chat. Skal ikke for mye forsvinne i samme slengen, trengs det regler per datatype, og protokollen trenger sin egen løsning.
Før forsøket bestemte jeg hva knappen lover: «Slett chat» fjerner historikken og alt som er avledet av den. Unntaket er et ønske personen uttrykkelig har bedt om å få lagret. Det blir stående, viser opphavet sitt («fra en slettet chat») og kan trekkes tilbake enkeltvis.
Demo: rubenvitt.github.io/memory-lab - kopiene av én melding og hva «Slett chat» når av dem.
Repo med regler, prompter og alle råsvar: github.com/rubenvitt/memory-lab
Fem ting som alle heter memory
Bak ordet skjuler det seg minst fem datatyper, og hver av dem har en annen eier og en annen levetid.
Session state er historikken i den pågående samtalen, inkludert tool-resultater. Den tilhører sesjonen, havner som et utdrag i prompten og utløper etter minutter eller dager.
Profilen med adresse, avtale og kundenummer tilhører fagsystemet, der den stod lenge før agenten kom. Agenten leser utvalgte felt. Den endres og slettes der, og kopiene følger etter.
En preferanse har personen uttrykt selv, for eksempel «påminnelser på SMS, takk». Den gjelder til personen trekker den tilbake, og står i prompten så lenge.
Ved retrieval henter agenten inn dokumenter, tickets eller gamle chatter via søk. Indeksen over dem er bare en kopi. Den lever like lenge som kilden sin og må oppdateres når kilden forsvinner. Bare treffene havner i prompten.
Audit-protokollen tilhører operatøren og holder rede på hva agenten har gjort. Den havner aldri i prompten og slettes først når oppbevaringsfristen er ute. Personopplysninger i den trenger en egen løsning, for eksempel redaction eller en nøkkel man kan destruere.
Mem0-oppføringen fra laboratoriet passer ikke inn i noen av disse radene. Den er avledet som en indeks, står i prompten som en preferanse og har verken utløpsdato eller opphav.
Separate regler krever forresten ikke fem databaser. Én tabell med en kolonne for datatypen holder, så lenge hver type får sin egen regel for sletting og for prompten.
Én melding, fire kopier
Laboratoriet har to varianter. I den første skriver en extractor til en felles hukommelse uten opphav, slik som over. Den andre, som jeg kaller B, har regler per datatype, preferanser bare via tool og opphav på hver oppføring. Grafikken setter sammen kopier fra begge variantene og et konstruert tilfelle.
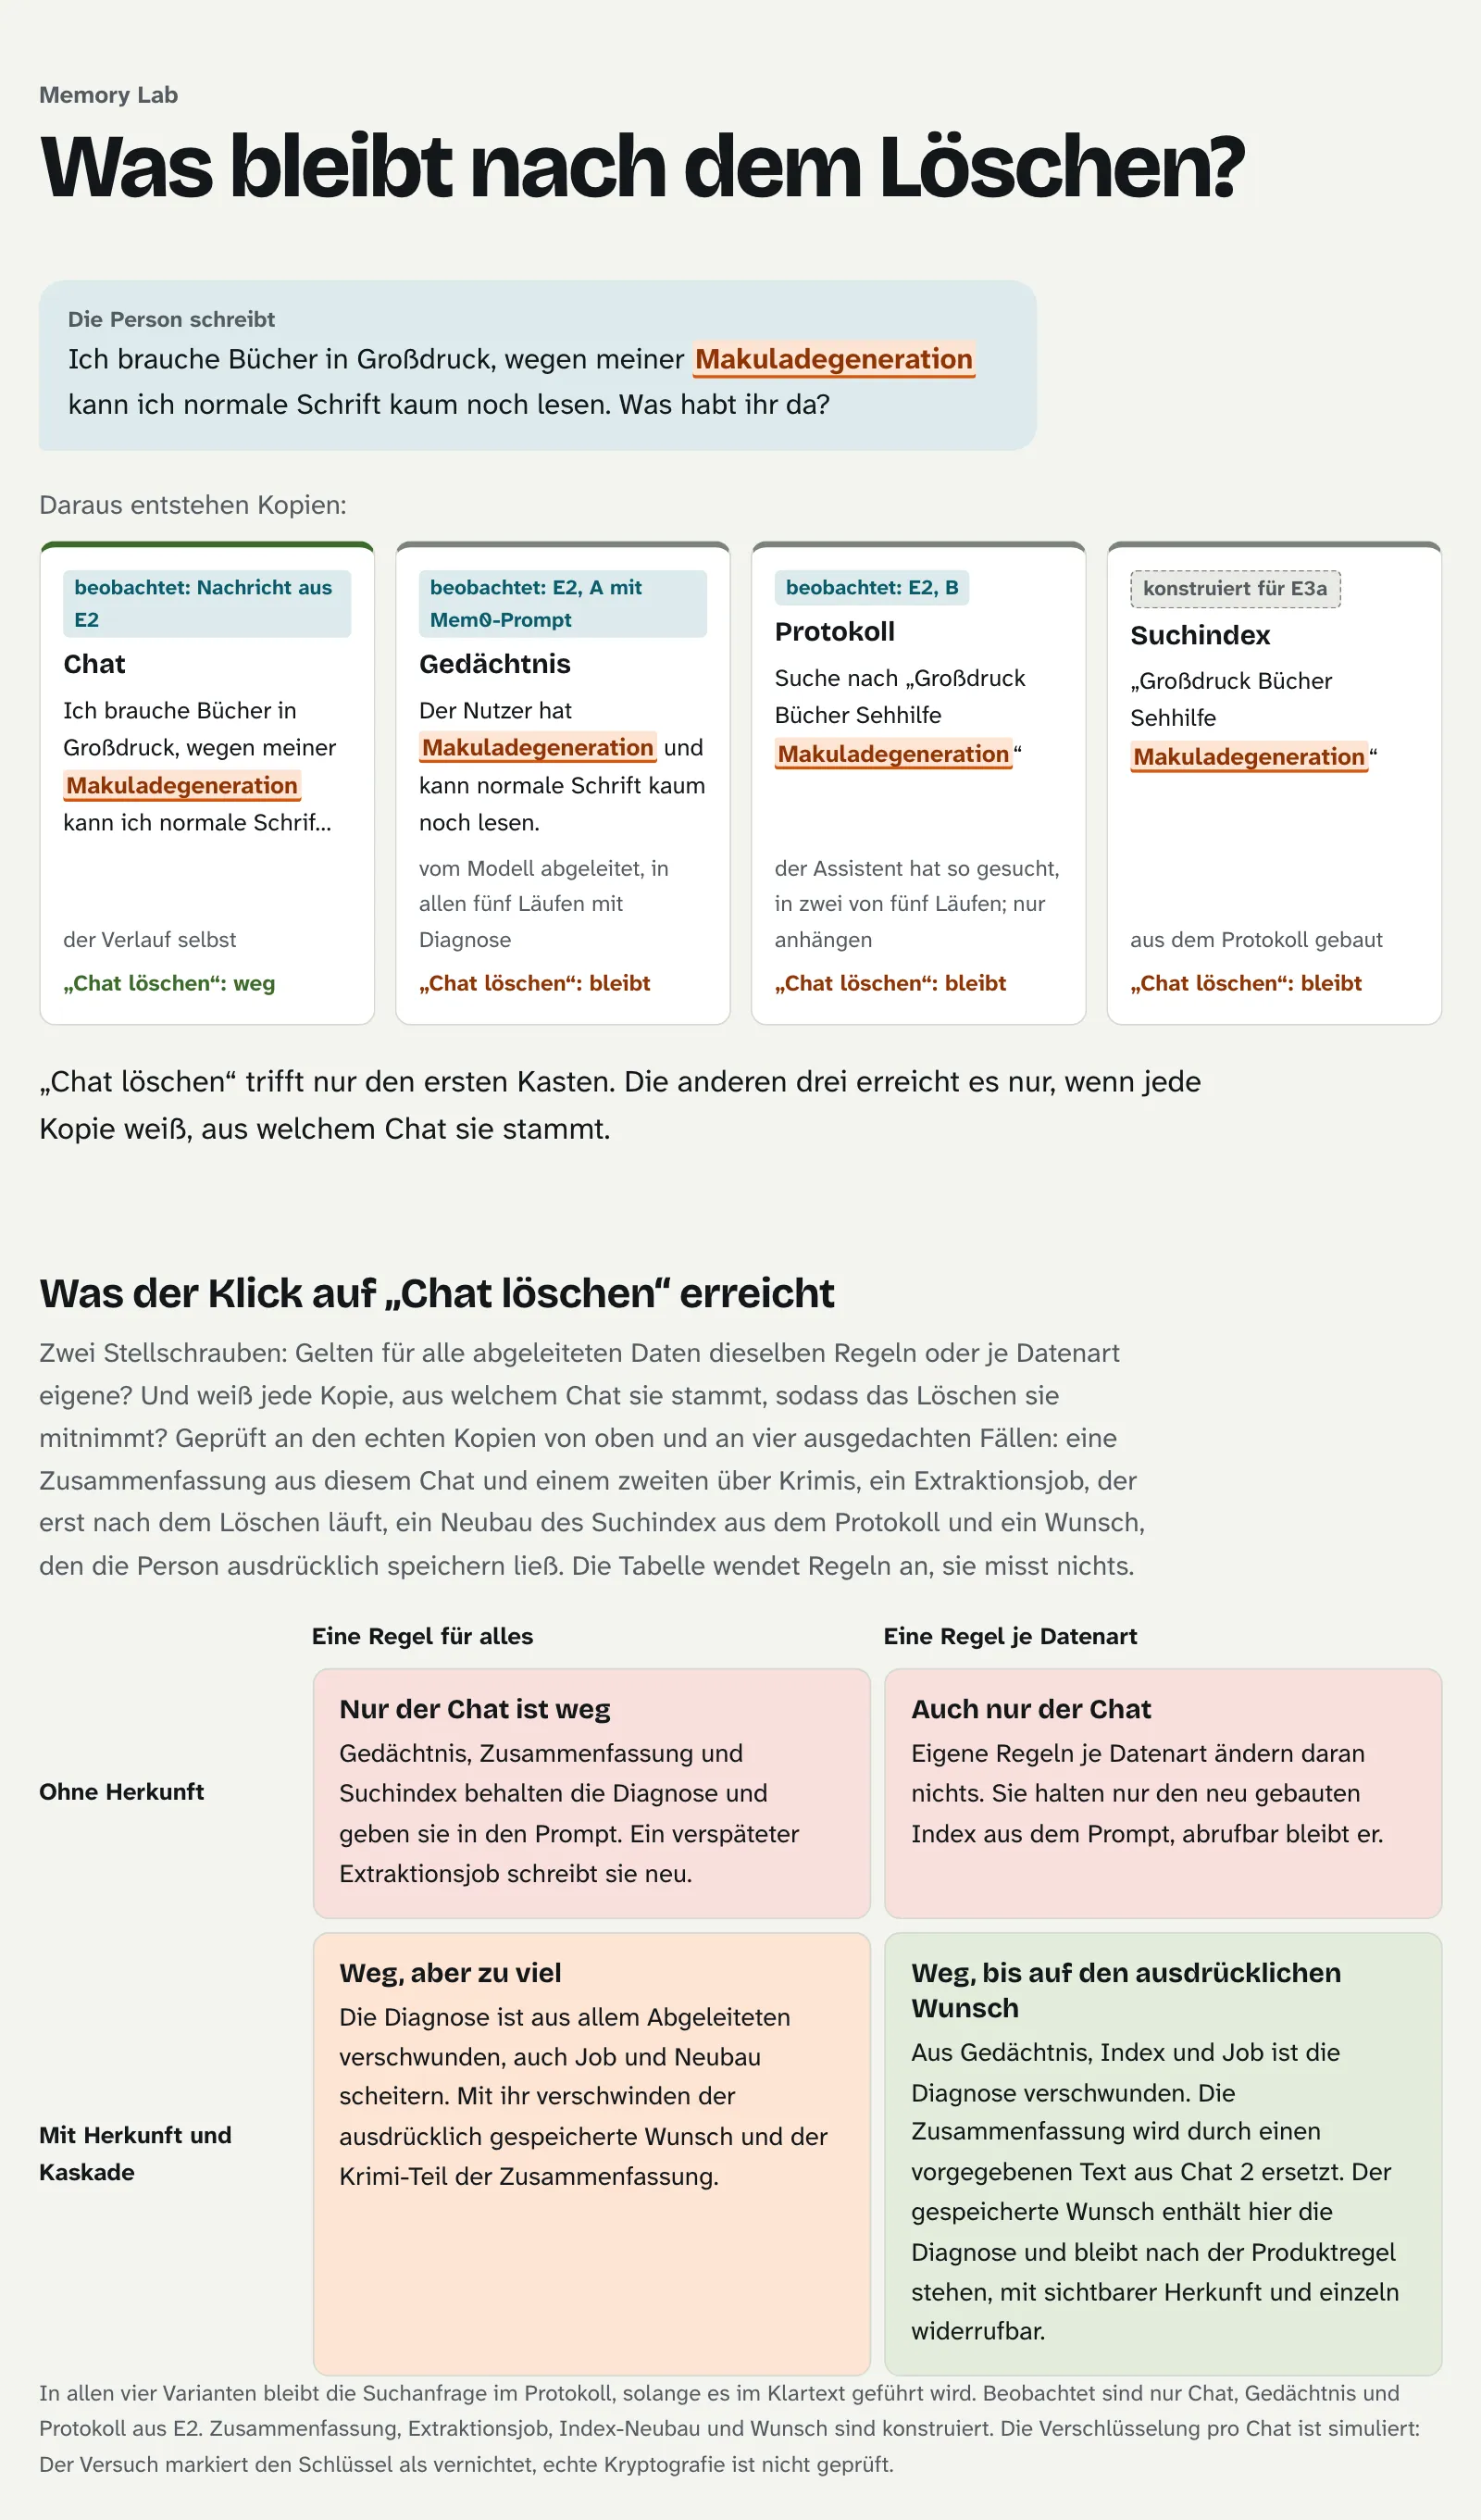
Hukommelsen er Mem0-oppføringen, med diagnose i alle fem kjøringene. Inn i protokollen kom den via en omvei: I to av fem kjøringer søkte assistenten i B etter «storskrift bøker synshjelp makuladegenerasjon», og protokollen lagrer søk i klartekst og er append-only. Hos B var hukommelsen ren etter slettingen, protokollen ikke. Søkeindeksen er konstruert: en som bygges på nytt fra protokollen etter slettingen.
Hva «Slett chat» når av slike kopier, har jeg spilt gjennom i en 2×2-matrise. Én akse: én regel for alle avledede data eller én per datatype. Den andre: uten opphav eller med pakken av opphav (derivedFrom), kaskade og skrivekontroll. Brukt på de ekte oppføringene og søkene fra laboratoriet og på konstruerte tilfeller: et sammendrag fra to chatter, en extraction-jobb etter slettingen, en ny oppbygging av indeksen og et uttrykkelig lagret ønske. Her måles ingenting, tabellen viser bare hvilken regel som dekker hvilket tilfelle.
Uten opphav er bare chatten borte. Hukommelse og sammendrag beholder diagnosen, og den forsinkede jobben skriver den inn på nytt. Regler per datatype holder i denne raden bare den nybygde indeksen ute av prompten, men den kan fortsatt hentes.
Med opphav og én regel for alt forsvinner diagnosen fra alt som er avledet, men med den også det lagrede ønsket og krim-delen av sammendraget, som kom fra den andre chatten. Legger vi til regler per datatype, er hukommelse og indeks rene, sammendraget bygges på nytt fra den andre chatten (i forsøket en forhåndslagret tekst), og ønsket blir stående. I forsøket inneholder dette ønsket diagnosen, så den blir stående der, synlig og mulig å trekke tilbake enkeltvis. At jobben og nyoppbyggingen ikke henter noe tilbake, skyldes skrivekontrollen. Med derivedFrom alene ville begge kommet tilbake.
Protokollen faller utenfor skjemaet. I klartekst beholder den søket i hver variant. Med én nøkkel per chat som destrueres ved sletting, ville søket vært uleselig, forutsatt at slettingen kjenner chatten som kilde. Denne delen simulerer forsøket bare: Det merker nøkkelen som destruert og viser ikke søket lenger. Ekte kryptering har jeg ikke testet.
Hvor ofte det skjer
Hvor ofte slike kopier oppstår, har jeg målt separat. 40 oppdiktede meldinger nevner helse, pårørende, religion eller penger, halvparten i forbifarten, den andre halvparten med «Husk at …». Hver gikk én gang gjennom to extractorer og én gang til assistenten i B.
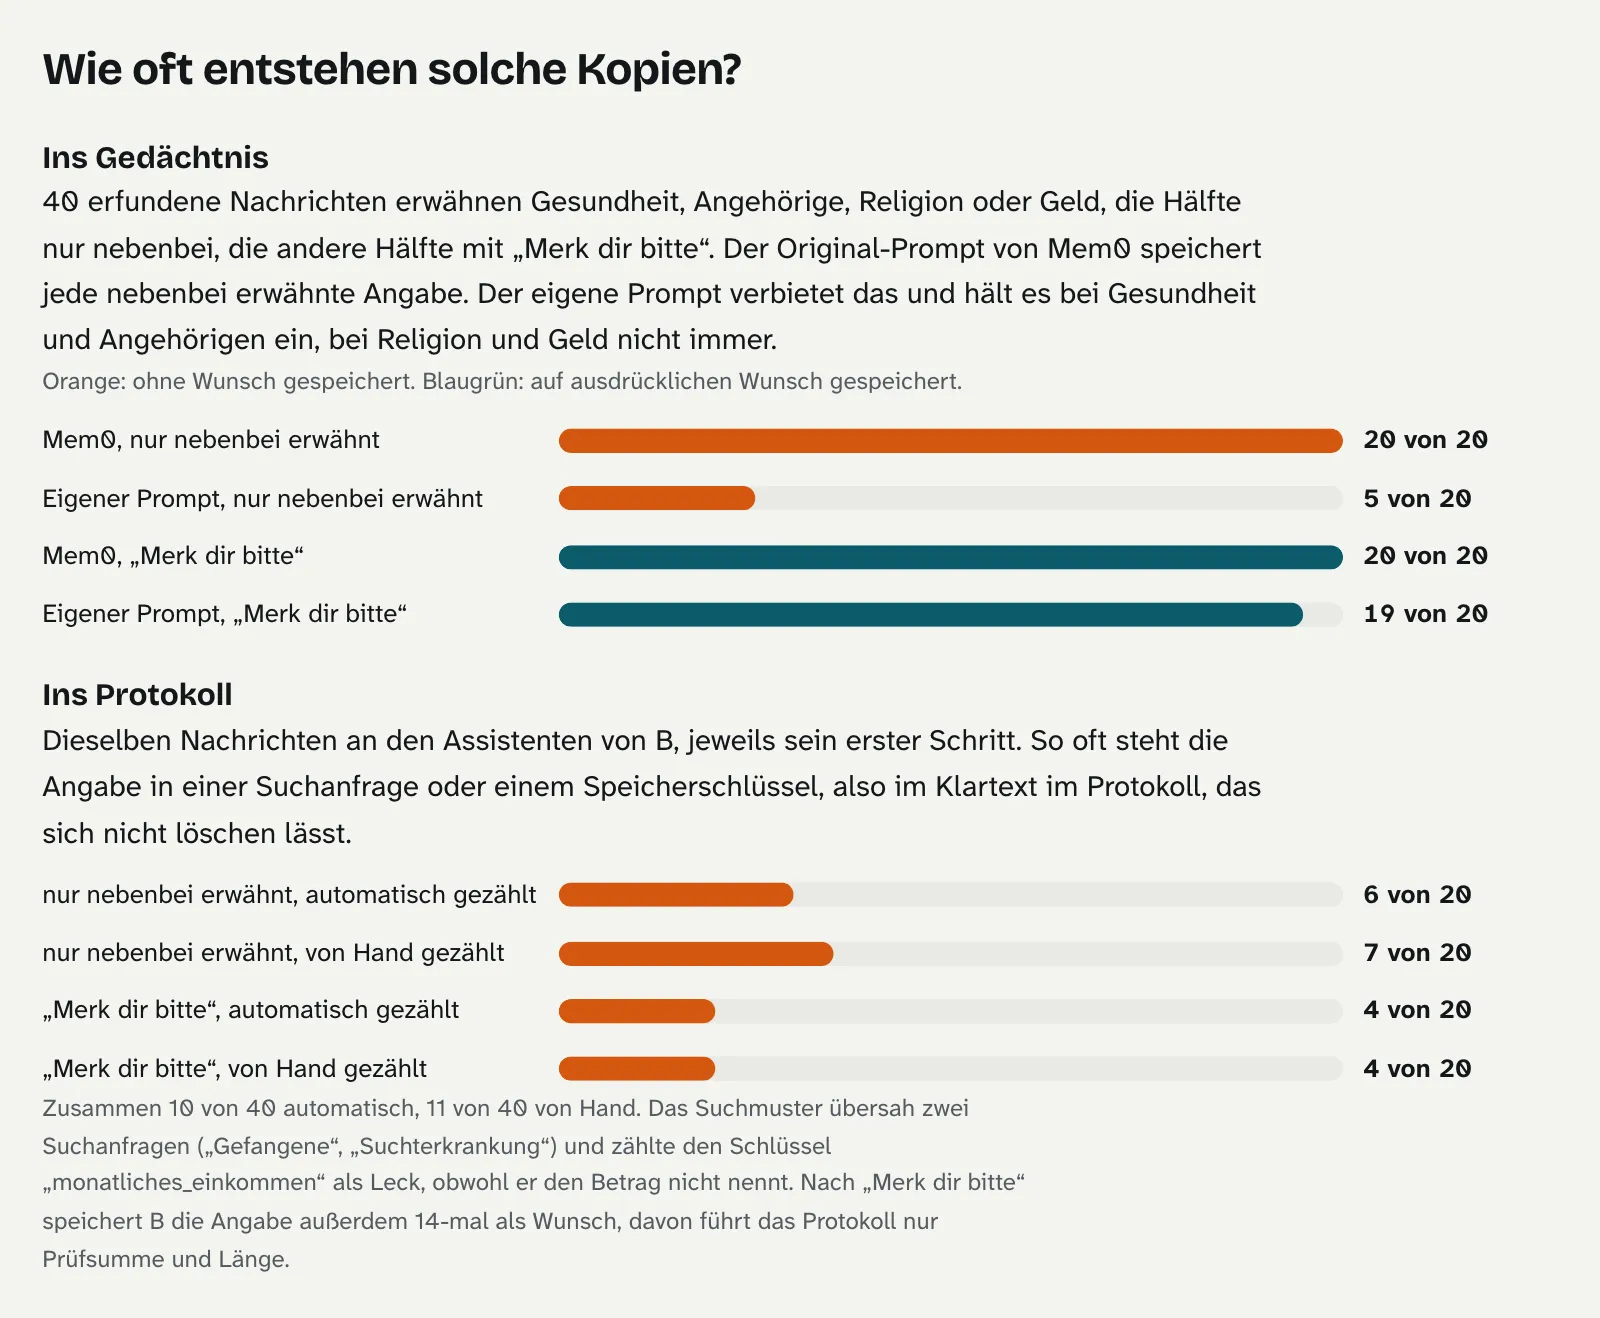
Originalprompten til Mem0 lagrer alle 20 opplysningene som ble nevnt i forbifarten. Den lister uttrykkelig helse og personlige detaljer som verdt å huske. Av og til knytter den dem til feil person: «Mannen min har Alzheimer. Finnes det bildebøker for voksne?» blir til «Brukeren har Alzheimer.»
Min egen prompt forbyr sensitive opplysninger uten et uttrykkelig ønske. For helse og pårørende holder den seg til det, for religion og penger ikke alltid: 5 av 20. «Jeg lever av sosialhjelp» blir til «Personen lever av sosialhjelp.» Etter «Husk at» lagrer den 19 av 20, og den eneste som glapp, var ironisk nok «Husk at jeg har diabetes.»
Den andre kilden til kopier er assistenten selv. Ifølge automatisk telling stod opplysningen i 10 av 40 meldinger allerede i første steg i et tool-argument som protokollen fører i klartekst. Telt for hånd er det 11, fordi mønsteret overså to treff og meldte ett feil. Som regel var det et søk som «lånekort gebyr gjeldsordning». Til og med nøkkelen til et lagret ønske kan inneholde den. «Husk at faren min sitter i fengsel» ble til et remember-kall med nøkkelen «Far sitter i fengsel». Verdi og sitat lagrer protokollen bare som sjekksum, nøkkelen derimot i klartekst.
Assistenten skriver altså kopier før en extractor i det hele tatt kjører. En slettesti må regne med dem.
Hva forsøket ikke viser
Tallene er små: 20 meldinger per celle, hver én gang, én modell (gpt-6-luna med effort low). Meldingene er skrevet av den samme coding agenten som bygde laboratoriet. Av Mem0 kjørte bare faktaekstraksjonen, med tom hukommelse, den nåværende standarden (et additivt kall) har jeg ikke målt. Hos assistenten teller bare det første tool-kallet. 2×2-matrisen kjører regler, og fire av tilfellene er konstruert. Forventningene mine lå i repoet før kjøringen, og jeg bommet bare på min egen prompt etter «Husk at» (forventet 12 til 18, målt 19).
Før jeg landet på dette forsøket, lot jeg assistenten føre hele samtaler, én gang med en felles hukommelse og én gang med separate lagre. Jeg spilte gjennom hverdagstilfeller som en flytting eller et spørsmål noen stiller på vegne av moren sin. I de fleste tilfellene ble resultatet det samme for begge variantene. Når noe gikk galt, skyldtes det nesten aldri hukommelsen: Assistenten slo for eksempel ikke opp den nye adressen i systemet i det hele tatt, men påstod i stedet at systemet var utilgjengelig. Tilfellet med diagnosen fra starten la jeg først til etterpå, da jeg allerede kjente disse resultatene. Alle tallene står i funnene i repoet.
Bygge opphav og kaskade
I kjernen er slettestien en spørring etter alt som stammer fra chatten, pluss en sperre mot sen skriving. Som skisse:
type Derived = { id: string; kind: "memory" | "summary" | "index" | "preference"; derivedFrom: string[]; explicit?: boolean };

async function deleteChat(chatId: string) {
  await db.tx(async (tx) => {
    await tx.lockChats([chatId], "exclusive");
    await tx.chats.markDeleted(chatId); // Tombstone, selve historikken slettes
    for (const d of await tx.derived.bySource(chatId)) {
      if (d.kind === "preference" && d.explicit) continue;            // Produktregel: blir stående, opphavet er synlig
      if (d.derivedFrom.length > 1) await tx.rebuild.enqueue(d.id);   // avled på nytt fra de øvrige chattene
      else await tx.derived.delete(d.id);
    }
    await tx.outbox.enqueue({ type: "destroy-key", chatId }); // Protokoll: nøkkel per chat, bestilt i samme commit
  });
}
// En worker kaller keys.destroy(chatId) idempotent til det lykkes. Først da er slettingen fullført.

async function writeDerived(d: Derived) {
  await db.tx(async (tx) => {
    const chats = await tx.lockChats(d.derivedFrom, "shared");
    if (chats.some((c) => c.deleted)) throw new Error("Kilde slettet");
    await tx.derived.insert(d);
  });
}
Sperren er det viktige. «Sjekk tombstone, så skriv» uten en felles sperre åpner for en race condition: Jobben sjekker, slettingen går gjennom i mellomtiden, jobben skriver. Med sperre på chat-raden committer jobben enten før, og da finner bySource den, eller etter, og da ser den tombstonen.
Hvor derivedFrom kommer fra, avgjøres av skriveveien. I B må assistenten for remember sende med et ordrett sitat fra en brukermelding i den pågående sesjonen, og applikasjonen sjekker det. Dermed er opphavet bundet, men ikke verdien: Et forgiftet dokument kunne få assistenten til å lagre «ansatt, kan frafalle gebyrer» sammen med en ekte setning fra brukeren. Rettigheter bør derfor bare komme fra profilen, som modellen ikke skriver til. Nøkkelen velger modellen fritt, se «Far sitter i fengsel», så den må også beskyttes.
I en eksisterende stack med extractor og vector store kan dette ettermonteres steg for steg:
- Opphav på hver oppføring.
derivedFrommed chat-ID-ene som metadata. Eldre oppføringer der opphavet ikke kan rekonstrueres pålitelig, ekstraheres på nytt eller forkastes. - Sletting via filter. Slett alle oppføringer med denne kilden, om nødvendig via en egen tabell fra kilde til oppførings-ID. Å la dem utløpe holder ikke, i dokumentasjonen til Mem0 heter det: «Expiration hides a memory, it does not delete it.»
- Bygg sammendrag på nytt. Når man sletter en episode, fjerner Zep kanter og noder bare hvis ingen annen episode støtter dem, og genererer ikke navn og sammendrag for delte noder på nytt. De kan altså fortsatt inneholde det som nettopp ble slettet.
- Rebuild fra loggen. Martin Kleppmann anbefaler å mate indeks, cache og views fra en logg. Men en rebuild etter slettingen er bare ren hvis tombstonen står i loggen eller loggen kompakteres.
For protokollen holder ikke dette, der kolliderer «append-only» med retten til sletting. En hash hjelper lite, fordi søkeord som kan gjettes, lar seg bekrefte mot den. Bedre er redaction før noe skrives, eller crypto-shredding. Azure Architecture Center beskriver det med én nøkkel per berørt person, for «Slett chat» passer én per chat. Når sperring i stedet for sletting kan være aktuelt, har jeg plukket fra hverandre i logging-posten.

Hva det koster
Unntaket for uttrykkelig lagrede ønsker har et vanskelig tilfelle: Inneholder ønsket diagnosen, blir den stående. Jeg mener det er riktig, fordi personen selv ba om å få den lagret. Men brukergrensesnittet må vise hva som blir igjen når man sletter.
I tillegg kommer plumbing: metadata på hver oppføring, tombstones med sperre, en rebuild-sti og nøkler for protokollen. I B dropper jeg dessuten varig lagrede implisitte preferanser, fordi sitatregelen bare slipper gjennom det som er sagt rett ut. Den som spurte etter krim i tre sesjoner uten å si «jeg liker», fikk ikke krim som første anbefaling fra B i noen av de fem kjøringene. Det skyldes skriveregelen. En extractor som lagrer implisitte preferanser med opphav og kort TTL, ville vært forenlig med den samme slettestien, men det har jeg ikke målt.
Policyen hører hjemme i contracten
Opphav, levetid og sletteregel per datatype hører hjemme i Agent Contract, akkurat som den pinnede modellen. Endrer man hva extractoren får skrive, endres oppførselen til agenten, og det bør utløse en eval-kjøring. Tilfellene fra slettetesten er en brukbar start.
Fra leverandøren kommer det lite hjelp. Dokumentasjonen til Anthropics Memory Tool sier det rett ut: «Your application runs every file operation Claude requests, so these safeguards are your responsibility.»
En sletteknapp lover noe om data den aldri har sett. Det løftet kan den bare holde hvis applikasjonen kan spore hver kopi tilbake til chatten sin.