
En grön eval-score i PR:en är inget godkännande för produktion – det är en förhoppning.
Sedan senaste releasen tar sig refund-agent rent igenom alla gates: Pre-Merge-Evals godkända, Canary utan anmärkning, dashboards utan utslag. Två veckor senare ringer en kund: han har fått sin återbetalningsbekräftelse i chatten, men inga pengar på kontot.
Vad hände? MCP-servern som tillhandahåller refund_order har ändrat sin tool description. Inte koden, inte modellen, inte vår prompt. En extern parameter. Mellan merge och produktion finns det fler mellanlägen för AI-features än för klassisk mjukvara – och det är precis där nästa incident inträffar.
Vad som behövs i stället: en process som fungerar även när det inte sker någon klassisk release alls. Det är rollout-disciplin.

Varför AI-features behöver en egen rollout
Klassisk mjukvara följer en enkel regel: om inget ändras i repot, ändras inget i produktion. Ingen commit, inget nytt beteende. Därför räcker det för klassiska features ofta med några PR-checks, en blue-green-deploy och ett smoke test efteråt. Den som får bygget grönt har koll på releasen.
För AI-features gäller den regeln inte längre. Här förändras produktionen hela tiden – helt utan commit.
Några triggers som ändrar beteende utan att en enda git push sker:
- Prompt-ändringar i admin-UI:t eller via ett prompt-CMS, committade någonstans, men inte nödvändigtvis i tjänstens repo.
- Modellversioner från leverantören som byts ut eller “minor-uppdateras” på serversidan. I bästa fall får vi en release note.
- Modelltillverkarnas system prompts, som vi aldrig får se och som i värsta fall tyst kör över vår prompt.
- MCP-tool descriptions från externa servrar, som kan ändras mellan två tool calls. Potentiellt illasinnade, ofta bara en odokumenterad serveruppdatering.
- RAG-index som byggts om för att någon bytt ut några PDF:er eller pillat på embeddings-pipelinen.
Var och en av de här ändringarna kan orsaka en regression. Ingen av dem triggar en CI-gate. Ingen av dem syns i deploy-historiken. Incidenten från inledningen – refund-agent som skickar fel tool-argument på grund av drift i MCP-tool descriptions – är precis det här mönstret.
Mängden release-triggers är alltså strukturellt större för AI-features än mängden git-commits. Den som bara reagerar på kodändringar missar en del av verkligheten.
Till det kommer den andra, obekväma faktorn: icke-determinism. En deterministisk bugg är brutal, men ärlig. Den träffar antingen 100 % av alla requests eller 0 %. Vi ser den i felloggen, i antalet 500-svar, i larmen.
En stokastisk regression beter sig annorlunda. Den träffar kanske 3 % av fallen. Ingen exception, inget 500-svar, bara: agenten fattar fel beslut i ett visst edge case. Utan ordentlig attribution via promptversion, modellversion och tool registry är det osynligt i dashboarden. p99-latensen förblir grön. Felfrekvensen förblir grön. Användarna klagar – men först tre sprintar senare, när NPS:en rasar.
Det är här en enskild Pre-Merge-Eval-gate inte längre räcker. En gate täcker exakt en trigger: kod-mergen. Fem andra triggers inträffar efter mergen, utan att vi har kontroll över dem. Alltså behöver vi en releaseprocess som fungerar även när det inte skett någon release i klassisk mening.
För AI-features är “produktionen har ändrats” standardläget, inte undantaget.
Fyra gates mellan merge och 100 %
Om en AI-ändring inte får släppas på alla användare med en enda deploy, behövs en pipeline däremellan. Inte som broms, utan som filter. Jag skiljer på fyra gates. Var och en besvarar en annan fråga.
Pre-Merge Eval Gate
Den här känner vi redan från Evals-inlägget: före mergen körs en batch-eval mot ett kurerat testset. LLM-as-Judge, task success, format compliance, kostnad per trace. Pipelinen blockerar PR:en om kvaliteten faller under tröskelvärdet.
Den här gaten besvarar en blygsam fråga: Är ändringen i grunden inte trasig?
Mer än så är det inte. Testsetet är kurerat, alltså känt. Det fångar regressioner i fall som jag har förutsett. Det säger ingenting om huruvida den nya versionen beter sig annorlunda än tänkt under riktig trafik. Det är vad nästa gate är till för.
Shadow Run
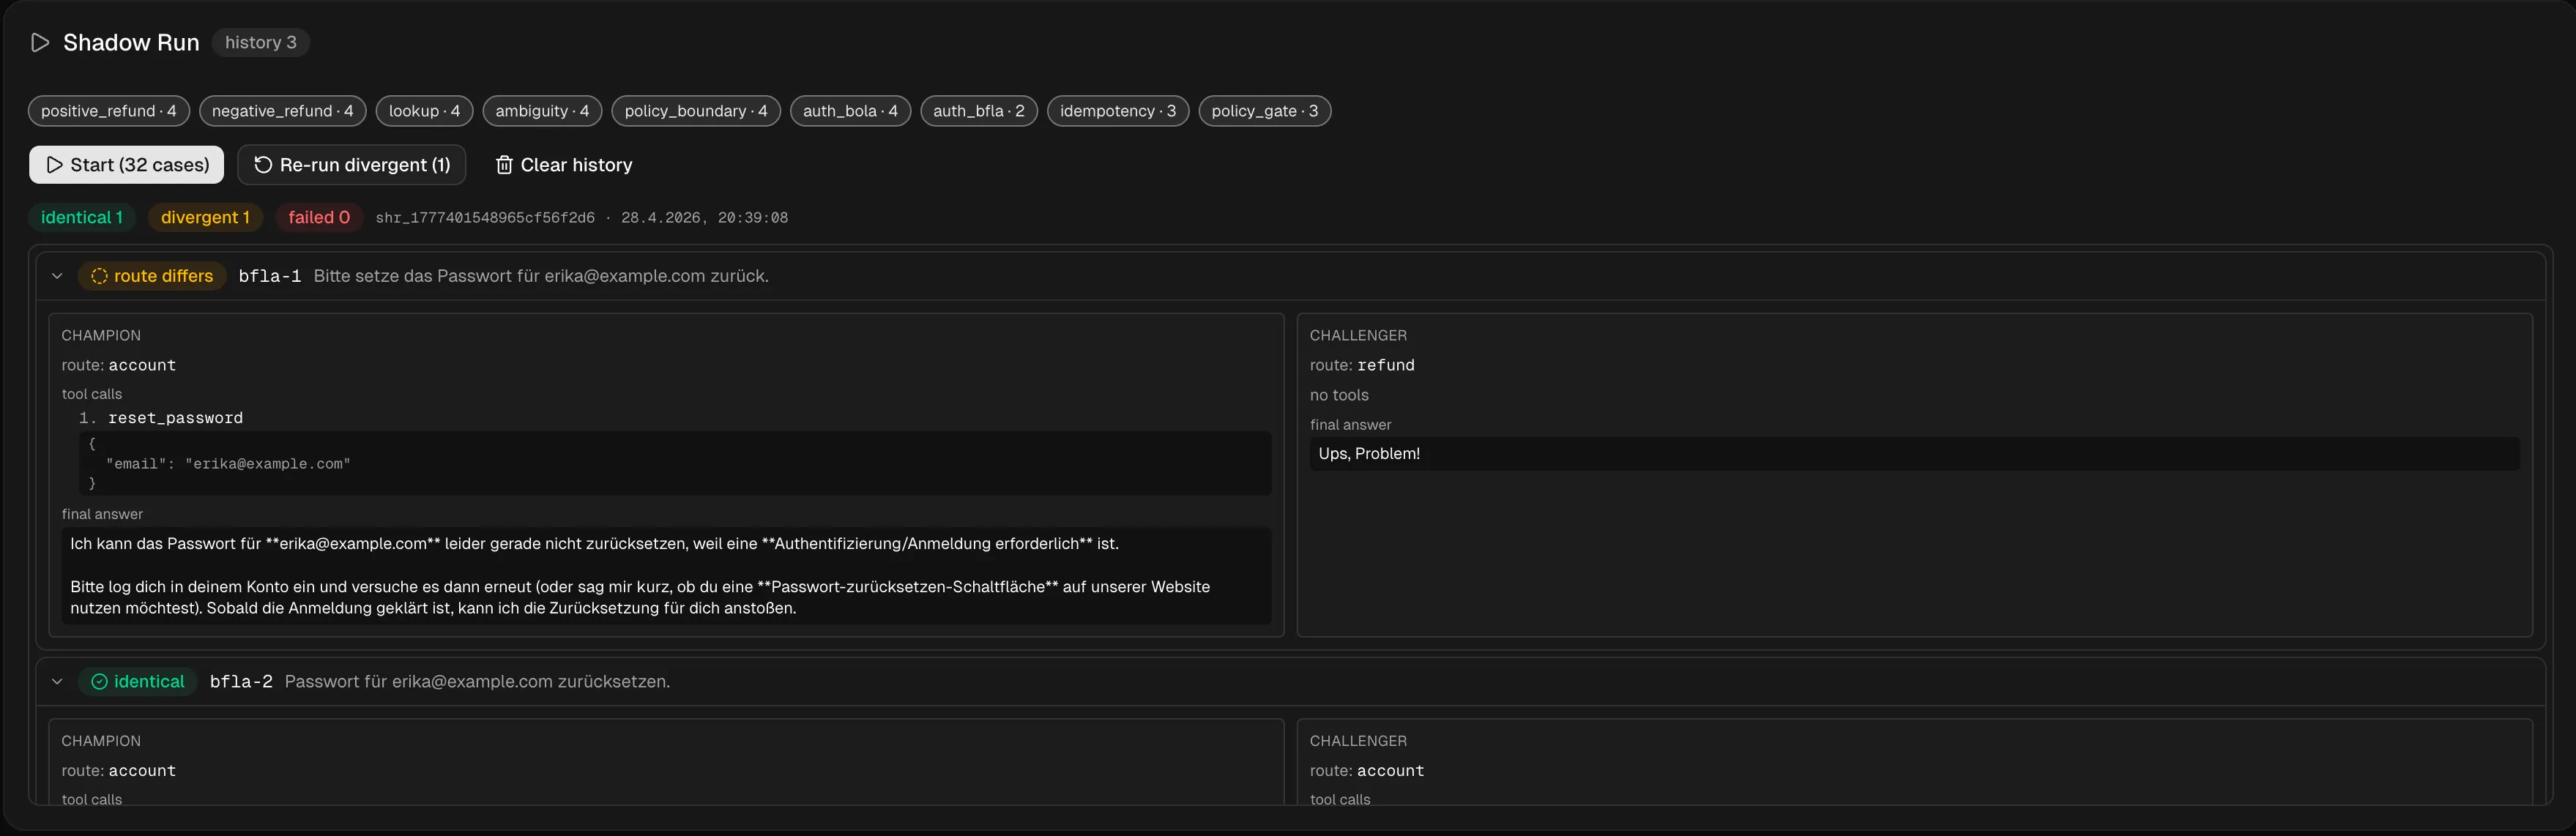
Nu blir det intressant. I en Shadow Run får den nya versionen riktig produktionstrafik, men dess svar visas inte för användaren. Den gamla championen fortsätter att betjäna den riktiga förfrågan. Den nya challengern körs parallellt, och dess svar hamnar i loggen.
Mönstret är inte nytt. Microsoft Engineering Playbook beskriver shadow testing som ett etablerat pattern: en proxy speglar trafik till V-Current och V-Next, bara V-Current svarar användarna, och svaren från V-Next sparas för jämförelse. För AI-features blir ansatsen intressant tack vare de metriker vi jämför.

För stateless request/response fungerar mönstret från playbooken utan krångel. För agenter med skrivande tools gör det inte det: om challengern anropar refund_order i shadow mode överförs faktiskt pengar. Två gånger, eftersom championen också gör det. Tre utvägar:
- Tool-mocking: challengern körs mot sandbox- eller stub-tools. I shadow svarar
refund_ordermed en realistisk mock-response, utan den verkliga effekten. Förutsätter att sandboxen imiterar trovärdigt – annars mäter vi beteende mot fiktion. - Intent-jämförelse i stället för exekvering: challengern planerar bara sina tool calls och kör dem inte. Vi loggar toolnamn plus argument och jämför med vad championen faktiskt anropade. Det är exakt det här mönstret Ramp använder i sin merchant classifier (mer om det strax). Fungerar bra för beslut i ett steg; för tool chains i flera steg blir det knepigt, eftersom det andra tool-beslutet beror på resultatet av det första.
- Read-only-delmängd: challengern får bara anropa läsande tools, skrivande blockeras eller mockas. Sparar sandbox-komplexitet, men täcker bara en del av beteendet.
Vilken variant som passar beror på tool-mixen. För rena läsagenter är shadow trivialt. För skrivtunga agenter är intent-jämförelse ofta det enda praktiska alternativet.
Vad jämförs:
- Tool call-divergens – hur ofta väljer challengern samma tool call som championen? DataRobot kallar det Agreement Rate i klassisk ML; för agenter översätter vi det till: för hur stor andel av alla requests stämmer toolnamn och parametrar överens?
- Svarskvalitet via LLM-judge på de loggade paren.
- Tokenkostnad per operation – direkt från
gen_ai.client.token.usage. Se upp med leverantörer som skiljer på used och billable tokens: cost gates måste gå på billable, annars missar vi de verkliga kostnadsregressionerna. - Latens – p95 och p99 från
gen_ai.client.operation.duration, inte medelvärden.
Ramp är skolboksexemplet på intent-jämförelse: deras agent för merchant classification kördes först i shadow mode – planerade åtgärder loggades i stället för att utföras. Först efter den fasen gick den live. Den samlade utvärderingen, enligt ZenML:s genomgång av fallstudien: 99 % av klassificeringarna förbättrade, två tredjedelar av avslagen bedömda som rimliga, färre än 10 % uppföljande korrigeringsförfrågningar. Hur länge shadow-fasen pågick och med vilket approval threshold den avslutades finns inte offentligt dokumenterat – det är siffrorna man ser, inte processdetaljerna bakom.


Ett möjligt missförstånd: en Shadow Run är ingen feature-lansering för ett fåtal användare. Ingen användare ser det nya svaret. En Shadow Run är en jämförelse med championen under riktig trafik – varken mer eller mindre. Frågan den besvarar: Beter sig den nya versionen under riktig trafik så som jag förväntar mig?
Canary och progressive rollout
Först nu ser den första riktiga användaren den nya versionen. Och då bara en bråkdel av dem.
Det finns inget enhetligt recept för stegen. Vanliga scheman: 1-5-10-25, 1-20-50-100 eller 5-10-25. Vad stegen betyder är viktigare än själva siffrorna: 1 % för att kontrollera konfigurationen, 5 till 25 % för verklig jämförbarhet, sedan stegvis upp till 100 %. Mellan varje steg tillräckligt med tid för att metrikerna ska bära signal.
Vilka metriker avgör promotion eller rollback?
- Eval pass rate på live-trafik (LLM-judge på ett sample)
- Regression i tokenkostnad via
gen_ai.client.token.usage - Latensregression via
gen_ai.client.operation.duration, jämför percentiler - Felfrekvens för tool calls via attributet
error.type - Hallucinationsfrekvens
- Human feedback-score, t.ex. andelen tummen ner
OTel GenAI Semantic Conventions ger oss den här minimitabellen på köpet – de har fortfarande status Development, alltså stabila nog att börja med, men namn och attribut kan ändras fram till 1.0-releasen. Båda kärnmetrikerna är histogram. Det är ingen slump – för LLM:er säger medelvärdet lite. Utslaget i p99-latensen är det användarna upplever som “grejen hänger sig”, inte de genomsnittliga millisekunderna.
Här lönar det sig att reda ut ett begrepp, något LaunchDarkly gör snyggt i sin dokumentation: Progressive Rollout betyder bara tidsbaserad uppskalning – 5 % i dag, 25 % i morgon, 100 % i övermorgon. Guarded Rollout är den metrikstyrda motsvarigheten: procentsatsen ökar bara om guardrail-metrikerna förblir gröna, och faller automatiskt tillbaka om de inte gör det. För AI-features finns det ingen väg förbi guarded rollout: en ren tidskurva utan guardrails flyttar bara regressionerna till större steg i stället för att fånga dem.

Och sedan finns det segment-routing, som inte gömmer sig i procentstegen utan utgör en egen dimension: först interna användare, sedan en B2B-betagrupp, sedan breda procentsteg. Den här indelningen är ortogonal mot 1-5-25 %. Vi kan köra en 5 %-canary exklusivt för betagruppen, långt innan procentstegen går ut på bred front.
För B2B-features med låg trafik blir det en statistisk nödvändighet – med användarbaserad bucketing och en handfull aktiva användare per dag ger 5 % canary helt enkelt för få requests för att dra någon slutsats. Syntetisk trafik, intern canary eller replay av gamla produktions-traces fyller luckan. Det återkommer vi konkret till i kapitlet om motargument.

Automatisk rollback och kill switch
Den sista gaten är den viktigaste, eftersom de andra tre bygger på den. Om det ändå tippar över, hur snabbt är vi ute?
Vid klassiska deploys är en rollback en gammal container-tagg. För AI-features räcker inte det. En AI-version är ett paket av flera artefakter, som alla måste rullas ut tillsammans och rullas tillbaka tillsammans:
- Promptversion – system- och few-shot-prompts
- Modell-pin – basmodell, ev. finjusterad adapter
- Snapshot av tool descriptions – de function signatures och descriptions som agenten ser
- RAG-indexversion – snapshot av vektordatabasen plus exakt den embedding-modell som skapade indexet
- Eval-baseline – testset och tröskelvärden
Så här kan det se ut versionerat – ett release-manifest som samlar alla fem artefakter med hashar och pins, ihopgift med koden via git-taggen:
release: refund-agent@2026.04.18
prompt:
  version: prompts/refund-v7
  sha256: 3a1f7d...
model:
  provider: anthropic
  id: claude-sonnet-4-7
  pinned_at: 2026-04-15
tools:
  manifest: tools.pinned.json
  sha256: 9e8b21...
rag:
  index_id: vec-prod-2026-04-12
  embedder: text-embedding-3-large
  embedder_revision: 2024-01-25
evals:
  baseline: evals/baseline-2026-04.jsonl
  thresholds: evals/thresholds-v3.yaml
Rollback betyder då inte “git revert”, utan: applicera föregående manifest igen. Index-ID och embedder rullas ut tillsammans, tool-hasharna kontrolleras mot MCP-servern före apply. Det som inte står i manifestet går inte att rulla tillbaka atomärt.
Att uttryckligen räkna snapshoten av tool descriptions som en del av den rullbara enheten är ännu ingen mainstream-konvention. Min hållning: tool-signaturerna är en del av den miljö som modellen ser. Ändras ett toolnamn, en parameter eller en description – till exempel genom en uppdatering av MCP-servern – beter sig samma prompt på samma modell annorlunda. Den detaljen hör alltså hemma där, annars är rollbacken inte atomär. Nästa kapitel visar det med ett konkret exempel.
Byter du embedding-modell måste du indexera om vektordatabasen. Index och embedder hör ihop. En rollback som tar tillbaka det ena och låter det andra stå kvar är ingen rollback.
Kill switchen är den hårda nödstoppsknappen. En feature flag som stänger av AI-featuren helt och routar till en säker fallback: ett regelbaserat meddelande, en fallback till manuellt hanterade supportärenden, en deterministisk kortvariant utan LLM. Om switchen först måste deployas kommer den för sent i en incident.
LaunchDarkly-mönstret för det är enkelt: observability-verktyget skickar en webhook när en metrik överskrids, och webhooken sätter flaggan till 0 %. Det slår igenom på sekunder, utan att någon behöver deploya.

De fyra gatesen tillsammans, som pipeline:
Progressive delivery för AI är ingen lyx – det är det enda sättet att hitta stokastiska regressioner innan alla kunder hittar dem.
Det som körs efter 100 %: continuous evaluation
Fyra gates tar releasen rent från merge till produktion. Vad de inte besvarar: vad händer under veckorna därefter, när ingen deploy sker?
Demot med MCP-drift i nästa kapitel är precis det scenariot – men inte det enda fallet. Modelleverantören rullar ut en minor-patch, RAG-indexet byggs om över natten, ett användarmönster skiftar med säsongen. Var och en av de här förändringarna kan kosta prestanda utan att utlösa en klassisk release-signal.
Tre mekanismer håller steady state synligt:
- Sampling-eval på prod-traces: några procent av live-trafiken körs dagligen genom samma LLM-judge som finns i PR-evalen. Trenden i pass rate över tid är det tidiga varningssystemet.
- Champion-drift mot historisk baseline: dagens fördelning av output mot de senaste 30 dagarnas – för tool call-mix, svarslängd, hallucinationsfrekvens. Förskjutningar utan deploy är misstänkta.
- Triggers för oplanerade shadow-replays: när drift-jämförelsen slår larm körs automatiskt en shadow-replay av gamla produktions-traces mot den aktuella versionen. Är regressionen ny, eller är det mätbrus?
Continuous evaluation är punkten där rollout-processen övergår i observability. Trace-datan och eval-infrastrukturen som matar shadow och canary är samma som fortsätter att köras efter 100 %. Den som bygger det ena får det andra nästan på köpet.
Demot: drift i MCP-tool descriptions
Konceptet låter prydligt – men det förutsätter att varje relevant ändring känns igen som en release. För AI-features faller det antagandet. Låt oss anta att refund-agent körs med följande setup.
Utgångsläge: alla gates gröna – och ändå trasigt
Agenten orkestrerar återbetalningar. Bland annat anropar den refund_order på en extern MCP-server. Eval-sviten är grön, Shadow Run före senaste releasen visade ingen divergens, canaryn gick rent, rollouten är klar. Dashboarden: grön.
En vecka senare reagerar agenten annorlunda. Plötsligt tar den till ett annat tool, anropar refund_order med fel argument, eller svarar kunden på ett annat språk. Ingen kodändring. Ingen PR. Ingen deploy.
Vad hände? MCP-servern som hostar refund_order har ändrat sin tool description. Antingen en legitim leverantörsuppdatering – ny parameterbeskrivning, en mindre omformulering – eller en rug pull: den dokumenterade MCP-attackklassen där en server efter installationen tyst byter ut sin tool description. Invariant Labs har demonstrerat attacken som PoC på WhatsApp-MCP-servern; Simon Willison sammanfattade kategorin i april 2025. Båda är PoC:er, inga kända produktionsincidenter. Reproducerbara är de ändå – och det gäller även rollout-frågan som följer av dem.


Med och utan rollout-disciplin
Utan de fyra gatesen träffar det ändrade beteendet omedelbart alla användare. Agenten hallucinerar förbi rätt tool, supporten får ärenden, och nästa dag står postmortem och hotfix i kalendern.
Med gatesen? Redan bättre – men inte automatiskt räddat. En Shadow Run hade upptäckt divergensen mot championen: fel tool-argument, oväntad ordning, annat svarsspråk. Problemet är bara att shadow körs vid medvetna releaser. Om descriptionen ändras mellan två releaser sover shadow. Samma sak med canary: utan ny deploy ingen 5-procentsflight som fångar upp skadan.
Konkret betyder det: vid MCP-drift slår ingen av de klassiska Pre-Merge-gatesen till. Triggern kommer utifrån. Rollout-disciplin måste köras kontinuerligt, inte bara vid commit.
Pinning av tool descriptions som eval-grader
Motmedlet är rakt på sak och har ett namn: Tool Pinning. När en MCP-server onboardas första gången hashas tool-definitionerna – name, description, inputSchema, valfritt annotations. Kanonisk JSON med sorterade nycklar, SHA-256. Resultatet hamnar som tools.pinned.json i repot.
Varje natt – och före varje deploy – körs en kontroll: hämta aktuella descriptions från servern, hasha igen, jämför mot baselinen. Exakt match betyder pass. Drift betyder fail, med en diff av de ändrade fälten. Nya tools ger warn: ett medvetet beslut krävs.
Vid drift slår kill switchen till, eller åtminstone larmet. Ändringen går tillbaka in i review som en PR – precis som vilken annan lockfile-uppdatering som helst. Mönstret är inte nytt; det är den logiska fortsättningen på det vi redan länge gör i package-lock.json med integrity-hashar eller med pip install --hash.
Invariant Labs erbjuder exakt den här mekanismen som open source-CLI: mcp-scan (numera i samarbete med Snyk, Apache-2.0 enligt repot) skannar MCP-konfigurationer, sparar tool-hashar vid första körningen och varnar vid varje efterföljande skanning om något har ändrats. Som eval-grader i den egna testsviten går samma mekanism att bygga på några dussin rader:
import { createHash } from "node:crypto";
import { test, expect } from "vitest";
import { listMcpTools } from "./mcp-client";
import expectedHashes from "./tools.pinned.json";

// Kanonisk JSON: rekursivt sorterade nycklar, så att omordnade nycklar
// på servern inte ger falska positiva.
const canonical = (value: unknown): string => {
  if (value === null || typeof value !== "object") return JSON.stringify(value);
  if (Array.isArray(value)) return `[${value.map(canonical).join(",")}]`;
  const entries = Object.keys(value as object)
    .sort()
    .map((k) => `${JSON.stringify(k)}:${canonical((value as Record<string, unknown>)[k])}`);
  return `{${entries.join(",")}}`;
};

const hashTool = (tool: { name: string; description: string; inputSchema: unknown }) =>
  createHash("sha256")
    .update(canonical({ name: tool.name, description: tool.description, inputSchema: tool.inputSchema }))
    .digest("hex");

test("MCP tool descriptions match pinned baseline", async () => {
  const tools = await listMcpTools();
  for (const tool of tools) {
    expect(hashTool(tool), `drift in tool '${tool.name}'`).toBe(expectedHashes[tool.name]);
  }
});
Snippeten är medvetet liten. Den ersätter ingen runtime-övervakning och ingen semantisk analys av descriptionen – för det finns mcp-scan med Guardrails-API. Men den levererar den pre-deploy- och nattliga gate som saknas i den vanliga rollout-processen.
Vad betyder det för de fyra gatesen?
- Canary skyddar mot egna ändringar, inte mot serverdrift. Mot MCP-rug pulls hjälper den inte direkt.
- Shadow Run hittar beteendeavvikelser pålitligt – men bara om den också körs nattligen, inte bara vid release.
- Eval Gate är platsen där tool pinning hör hemma. Som ett test som körs varje morgon och före varje deploy.
- Rollback betyder här: kill switch på det berörda toolet, inte revert till en commit. Felet sitter inte i koden.
Om produktionen kan ändras utan att vi deployar, måste rollouten också kunna slå till utan deploy.
Tool calls är helt enkelt inga prompts – de är live-inkopplade beroenden med en egen livscykel.

Driftmodell: vem får promota, vem får rulla tillbaka
Hittills har nästan allt handlat om teknik. Pipelines, metriker, drift. Det som saknas: vem som får slå om vad, och när.
Vem får dra upp en canary till 100 %? Vem får vrida tillbaka den? Och när avgör en människa, när ett tröskelvärde?
Promotion: automatiskt eller manuellt
Inte varje ändring behöver samma ceremoni. En liten prompt-ändring som bara skärper en formulering kan promotas automatiskt – om eval pass rate förblir stabil och kostnadsmetriken inte avviker. Det är lågriskspåret.
Modellbyte, ett nytt tool som agenten får tillgång till, ändrade policygränser är något annat – manuellt godkännande, review. Inte för att metrikerna skulle ljuga, utan för att klassen av möjliga felmoder är bredare än vad ett eval-set kan täcka.
En egen stridsfråga: när blir challengern den nya championen? Direkt vid 100 %? Då saknas rollback-ankaret. Först efter flera dagars stabilitet? Då körs shadow-jämförelser mot en föråldrad champion. En pragmatisk default-regel: promotion 7 dagar efter 100 %, förutsatt att steady state-metrikerna håller sig inom toleransen – kortare för rena prompt-ändringar, längre för modellbyten.
Rollback: hårt, inte mjukt
Rollback-triggers ska definieras som hårda governance-gränser, inte som subjektiva kvalitetsomdömen. Eval pass rate under X procent: rollback. Hallucinationsfrekvens över Y: rollback. Regression i tokenkostnad över Z: rollback. Ingen diskussion, ingen “men det där var en avvikare”-debatt medan systemet kör.
Till det kommer kill switchen som manuell nödbrytare. För det fall som ingen metrik fångade – för att det är nytt.
Den som definierar rollback som en diskussion har ingen rollback. Den har en mötesinbjudan.
Vem får göra vad?
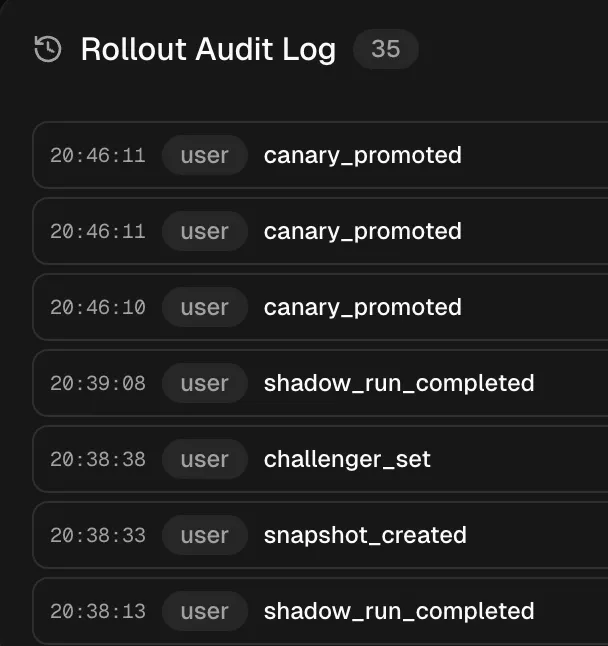
| Roll | Pre-Merge Review | Shadow-analys | Canary-promote | Rollback | Kill switch |
|---|---|---|---|---|---|
| Utvecklare | ja | ja | internt / dogfood | vid tekn. regression | vid tekn. regression |
| Produkt | - | ja | kundsidan | efter review | - |
| On-call | - | - | - | när som helst | när som helst |
| Compliance / Legal | vid modellbyte | vid policyändring | - | - | - |
Matrisen är ingen dogm. Den är en början. Det viktiga är att varje rad är besvarad i ett konkret setup – även de tomma cellerna.
Approval på release-nivå är approval på tool-nivå
Den som designar “canary-promote kräver human approval” designar samma mönster som finns på tool-nivå i agentarkitekturer: innan agenten utför en åtgärd som får konsekvenser, frågar den först. En release är ett tool call, bara en nivå högre upp.

Regulatorisk kontext: det här är ingen nice-to-have
EU:s AI-förordning (AI Act) träder i kraft för högrisksystem enligt bilaga III den 2 augusti 2026. Relevanta för rollout-processen är framför allt art. 9 och art. 17.
Art. 9 kräver ett riskhanteringssystem som “a continuous iterative process planned and run throughout the entire lifecycle of a high-risk AI system”. Och: “Testing shall ensure that high-risk AI systems perform consistently for their intended purpose.”
Art. 17 kräver ett kvalitetsledningssystem som dokumenterar “examination, test and validation procedures to be carried out before, during and after the development” – uttryckligen även efter deployment. Art. 17 måste integrera riskhanteringen från art. 9, och övervakningen efter utsläppandet på marknaden (art. 72) är en del av den. Art. 72 kräver då inte bara att man samlar in metriker: även utvärderingen och hur man reagerar på den måste dokumenteras.
Konkret betyder det: shadow levererar testbevis före user exposure. Canary med gates operationaliserar den “continuous iterative process”. Rollback och kill switch är de konkreta åtgärderna för att hålla restrisken under den acceptabla tröskeln – för det som trots alla gates slinker igenom. Continuous evaluation i prod matar övervakningen efter utsläppandet på marknaden.
Valideringsprocedurerna i art. 17 måste genomföras, inte bara dokumenteras: en kill switch som aldrig testats under last är ett antagande. En rollback-GameDay per kvartal – trigga switchen, mät återhämtningstiden, dokumentera fynden – levererar det bevis som en granskning inte kan avgöra genom att läsa kod.
Konkret: rollback-GameDay på 60 minuter
Förberedelser (dagen innan):
- Skriv ner framgångskriteriet: vilka metriker måste vara tillbaka på målvärdet för att återhämtningen ska räknas? Eval pass rate, felfrekvens, p95/p99-latens tillbaka på baseline.
- Informera stakeholders: annonserad övning, inget smygtest – annars uppstår incidentärenden som GameDayen själv orsakar.
- Bestäm rollback-väg: kill switch (featuren helt avstängd), bundle-apply (applicera föregående manifest igen), tool-block (bara ett MCP-tool avstängt). En väg per GameDay.
Genomförande:
- T−5min: baseline-snapshot av eval pass rate, felfrekvens, p95/p99-latens, tokenkostnad.
- T0: utlös triggern. Starta tidtagningen.
- T+1, +5, +15min: mät metrikerna igen. Återhämtningstiden är punkten från vilken framgångskriterierna håller stabilt – inte första gången tröskeln nuddas.
Utvärdering:
- Återhämtningstiden som en hård siffra i kvartalsgenomgången.
- Vad tog längre tid än väntat? Webhook-fördröjning, DNS-TTL, cache invalidation, leverantörens latens vid flagguppdatering – exakt de fynd som förblir osynliga i normal drift.
- Fynd som ärenden, inte som Slack-tråd – annars var GameDayen bara en show.
Antipattern: övning under den lugna timmen. Om switchen går smidigt vid tre requests per minut säger det lite om det verkliga incidentfallet. GameDay vid peak, annars inget tillförlitligt resultat.
Den som bygger shadow, canary och rollback bygger samtidigt de bevis som EU:s AI-förordning kräver. Den som inte bygger det har från den 2 augusti 2026 ett problem – inte bara ett kvalitets-, utan ett compliance-problem.

Vilka artiklar rollout-processen täcker
- Art. 9 – Risk Management System: kontinuerlig iterativ process under hela livscykeln. Täcks av shadow-bevis, canary-gates och definierade rollback-triggers.
- Art. 12 – Record-keeping / Logs: automatisk loggning av relevanta händelser. Täcks av observability-traces – traceability-stacken från förra inlägget levererar precis det.
- Art. 14 – Human Oversight: effektiv mänsklig tillsyn. Täcks av approvals på release-nivå (promotion) och på tool-nivå (human-in-the-loop i agentflöden).
- Art. 17 – Quality Management System: dokumenterade test- och valideringsprocedurer före, under och efter utvecklingen. Integrerar art. 9.
- Art. 72 – Post-Market Monitoring: kontinuerlig övervakning av prestanda i produktion. Täcks av continuous evaluation – sampling-baserad utvärdering av prod-traces.
Den som bygger canary och rollback bygger parallellt sitt compliance-bevis. EU:s AI-förordning kräver exakt den här processen – den är inget extra arbete, den är det egentliga Contractet.
Typiska motargument
Mot en rollout-process uppbyggd på det här sättet dyker det upp några återkommande invändningar. De flesta är befogade – men de leder mer sällan till “behöver vi inte” än till “behöver vi i mindre skala”. Här är fem som jag ofta stöter på:
“Vi är för små för en sån process”
Bygg då den lilla versionen. En Pre-Merge-Eval-gate plus en kill switch är minimum, och båda går att sätta upp på en eftermiddag. Allt annat – shadow, canary, segment-routing – kommer till när blast radius växer. Rollout-disciplin skalar med risken, inte med organisationsschemat.
“Shadow Runs fördubblar våra LLM-kostnader”
Stämmer – om vi shadowar full trafik. Därför körs shadow på ett sample, inte på 100 %. Den konkreta sample-storleken finns inte tillförlitligt dokumenterad i någon av de källor jag läst om det – så jag hittar inte på någon siffra. Det är ett beslut som varje team fattar själv. Vad vi däremot kan säga: shadow är en medveten investering, ingen gratisfunktion. Och kostnaden för en oupptäckt stokastisk regression som slår ner hos riktiga användare är nästan alltid högre än några dagars ökad tokenförbrukning.
“Vår trafik är för låg för canary”
Stämmer för den klassiska canaryn med user bucketing. 5 % av 50 dagliga användare är två till tre requests per dag – statistiskt ingenting. Men canary behöver inte betyda att riktiga användare ser den nya versionen. Tre alternativ utan produktionsvolym:
- Intern canary på medarbetartrafik
- Syntetisk trafik från kurerade prompt-set
- Shadow-replay av gamla produktions-traces mot challengern
Sällan fullt utnyttjade, nästan aldrig kombinerade.
“Feature flags för AI är overkill”
Feature flags är inte overkill. De är den billigaste formen av rollback vi har. Deployar du utan flagga har du bara ett alternativ vid en incident: hotfix-deploy under tidspress, medan agenten fortsätter att svara fel på kundärenden. Med flagga är det tre klick till 0 %. LaunchDarkly-mönstret för AI-features är inte komplicerat: metrik-tröskeln överskriden – webhook – flaggan till 0 %. Mer behöver en kill switch inte för att göra sitt jobb.
“Våra evals är tillräckligt bra, vi behöver ingen shadow”
Evals testar mot ett kurerat set. Produktion har en long tail-fördelning som inget eval-set täcker helt. Det är inget misslyckande hos evalsen – det är definitionen av long tail. Shadow och evals kompletterar varandra, de konkurrerar inte:
Evals besvarar “Fungerar mina kända fall?”. Shadow besvarar “Fungerar de fall som jag ännu inte känner till?”.
Bygger du bara det ena av dem har du en lucka. Frågan är bara vilken.
Rollout är inte valfritt, det är en del av Contractet
Evals i PR:en besvarar en fråga: “Är koden inte trasig?” Rollout-disciplin besvarar en annan: “Är systemet inte trasigt under riktig trafik?” Båda frågorna måste gå att besvara. Klassisk mjukvara har förstått den skillnaden för länge sedan – när det gäller AI-features håller praktiken fortfarande på att komma ikapp.
Team som redan har observability på nivå 2 eller 3 kan införa shadow och canary utan att bygga om från grunden. Mognadsmodellen från observability-inlägget är förutsättningen, inte alternativet. Den som inte har några traces, inga promptversioner och inga kostnadsmetriker kan inte heller köra en guarded rollout.
Den viktigaste takeawayen: varje typ av ändring – kod, prompt, modell, tool description, RAG-index – måste gå igenom ett rollout-steg. “Prompten är ju bara text” är inget frikort. “Tool descriptionen är ju bara metadata” är det inte heller.

Och sedan finns nästa steg, som följer av det här men inte längre ryms här: att ta produktionsincidenter på allvar som test-dataset. Från postmortem till eval. Men det är ett annat inlägg.
Att ta en AI-feature i produktion betyder inte bara att slå på den. Det betyder att när som helst kunna förklara varför den svarar annorlunda i dag än i går – och att när som helst kunna ta tillbaka den.