
En grønn eval-score i PR-en er ingen produksjonsgodkjenning – den er et håp.
refund-agent har gått rent gjennom alle gates siden forrige release: pre-merge-evals bestått, canary uten avvik, dashboards uten utslag. To uker senere ringer en kunde: Han har fått refusjonsbekreftelsen i chatten, men ingen penger på kontoen.
Hva skjedde? MCP-serveren som tilbyr refund_order, har endret tool description-en sin. Ikke koden, ikke modellen, ikke prompten vår. En ekstern parameter. Mellom merge og produksjon har AI-funksjoner flere mellomtilstander enn klassisk programvare – og det er akkurat der neste incident skjer.
Det vi trenger i stedet: en prosess som slår inn også når det ikke skjer noen klassisk release i det hele tatt. Det er rollout-disiplin.

Hvorfor AI-funksjoner trenger sin egen rollout
Klassisk programvare følger en enkel regel: Hvis ingenting endrer seg i repoet, endrer heller ingenting seg i produksjon. Ingen commit, ingen ny oppførsel. For klassiske funksjoner holder det derfor ofte med noen PR-sjekker, en blue-green-deploy og en smoke test etterpå. Får du bygget grønt, har du kontroll på releasen.
For AI-funksjoner gjelder ikke denne regelen lenger. Her endrer produksjonen seg hele tiden – og det helt uten commit.
Noen triggere som endrer oppførsel uten å utløse en eneste git push:
- Prompt-endringer i admin-UI-et eller via et prompt-CMS, committet et eller annet sted, men ikke nødvendigvis i service-repoet.
- Modellversjoner fra leverandøren som byttes eller “minor-oppdateres” på serversiden. I beste fall får vi en release note.
- Systemprompter fra modellprodusentene, som vi aldri får se, og som i verste fall i det stille overstyrer prompten vår.
- MCP tool descriptions fra eksterne servere, som kan endre seg mellom to tool calls. Potensielt ondsinnet, ofte bare en udokumentert serveroppdatering.
- RAG-indeksen, som ble bygget på nytt fordi noen byttet ut et par PDF-er eller tuklet med embeddings-pipelinen.
Hver av disse endringene kan utløse en regresjon. Ingen av dem trigger en CI-gate. Ingen av dem dukker opp i deploy-historikken. Incidenten fra innledningen – refund-agent som sender feil tool-argumenter på grunn av drift i MCP tool description-en – er akkurat dette mønsteret.
Mengden release-triggere er altså strukturelt større for AI-funksjoner enn mengden git-commits. Reagerer du bare på kodeendringer, går du glipp av en del av virkeligheten.
I tillegg kommer den andre, ubehagelige faktoren: ikke-determinisme. En deterministisk bug er brutal, men ærlig. Den treffer enten 100 % av requestene eller 0 %. Vi ser den i feilloggen, i antall 500-feil, i alertene.
En stokastisk regresjon oppfører seg annerledes. Den treffer kanskje 3 % av tilfellene. Ingen exception, ingen 500, bare dette: Agenten tar feil beslutning i et bestemt edge case. Uten ryddig attribusjon på promptversjon, modellversjon og tool registry er det usynlig i dashboardet. p99-latensen forblir grønn. Feilraten forblir grønn. Brukerne klager – men først tre sprinter senere, når NPS-en stuper.
Det er her én enkelt pre-merge eval-gate ikke lenger holder. En gate dekker nøyaktig én trigger: kodemergen. Fem andre triggere skjer etter merge, uten at vi kontrollerer dem. Altså trenger vi en release-prosess som fortsatt slår inn når det ikke har vært noen release i klassisk forstand.
For AI-funksjoner er “produksjonen har endret seg” standardtilstanden, ikke unntaket.
Fire gates mellom merge og 100 %
Hvis en AI-endring ikke skal slippes løs på alle brukere med én enkelt deploy, trenger vi en pipeline imellom. Ikke som brems, men som filter. Jeg skiller mellom fire gates. Hver av dem svarer på et annet spørsmål.
Pre-merge eval-gate
Denne kjenner vi allerede fra eval-innlegget: Før merge kjører en batch-eval mot et kuratert testsett. LLM-as-Judge, task success, format compliance, kostnad per trace. Pipelinen blokkerer PR-en hvis kvaliteten faller under terskelen.
Denne gaten svarer på et beskjedent spørsmål: Er endringen i det minste ikke ødelagt?
Mer er det ikke. Testsettet er kuratert, altså kjent. Det fanger regresjoner i tilfeller jeg har forutsett. Det sier ingenting om hvorvidt den nye versjonen oppfører seg annerledes enn tenkt under ekte trafikk. Til det har vi neste gate.
Shadow Run
Nå blir det interessant. I en Shadow Run får den nye versjonen ekte produksjonstrafikk, men svarene dens vises ikke til brukeren. Den gamle championen betjener fortsatt den ekte forespørselen. Den nye challengeren kjører parallelt, og svarene dens havner i loggen.
Mønsteret er ikke nytt. Microsoft Engineering Playbook beskriver shadow testing som et etablert pattern: En proxy speiler trafikk til V-Current og V-Next, bare V-Current svarer brukerne, og svarene fra V-Next lagres for sammenligning. For AI-funksjoner blir tilnærmingen interessant på grunn av metrikkene vi sammenligner.

For stateless request/response fungerer mønsteret fra playbooken uten videre. For agenter med skrivende tools gjør det ikke det: Hvis challengeren kaller refund_order i shadow mode, blir det faktisk overført penger. To ganger, fordi championen gjør det også. Tre utveier:
- Tool-mocking: Challengeren kjører mot sandbox- eller stub-tools. I shadow svarer
refund_ordermed en realistisk mock-respons, uten den ekte effekten. Forutsetter at sandkassen imiterer troverdig – ellers måler vi oppførsel mot fiksjon. - Intent-sammenligning i stedet for kjøring: Challengeren planlegger bare tool calls og utfører dem ikke. Vi logger toolnavn pluss argumenter og sammenligner med det championen faktisk kalte. Akkurat dette mønsteret bruker Ramp i merchant-klassifisereren sin (mer om det straks). Fungerer fint for beslutninger i ett steg; i tool-kjeder med flere steg blir det knotete, fordi den andre tool-beslutningen avhenger av resultatet fra den første.
- Read-only-delmengde: Challengeren får bare kalle lesende tools, skrivende blir blokkert eller mocket. Sparer sandbox-kompleksitet, men dekker bare en del av oppførselen.
Hvilken variant som passer, avhenger av tool-miksen. For rene read-agenter er shadow trivielt. For write-heavy agenter er intent-sammenligning ofte det eneste praktiske alternativet.
Hva sammenlignes:
- Tool call-divergens – hvor ofte velger challengeren samme tool call som championen? DataRobot kaller dette agreement rate i klassisk ML-sammenheng; for agenter oversetter vi det til: I hvor stor andel av requestene stemmer toolnavn og parametere overens?
- Svarkvalitet via LLM-judge på de loggede parene.
- Token-kostnad per operasjon – rett fra
gen_ai.client.token.usage. Vær obs på leverandører som skiller mellom used og billable tokens: Cost-gates må gå på billable, ellers går vi glipp av de ekte kostnadsregresjonene. - Latens – p95 og p99 fra
gen_ai.client.operation.duration, ikke gjennomsnitt.
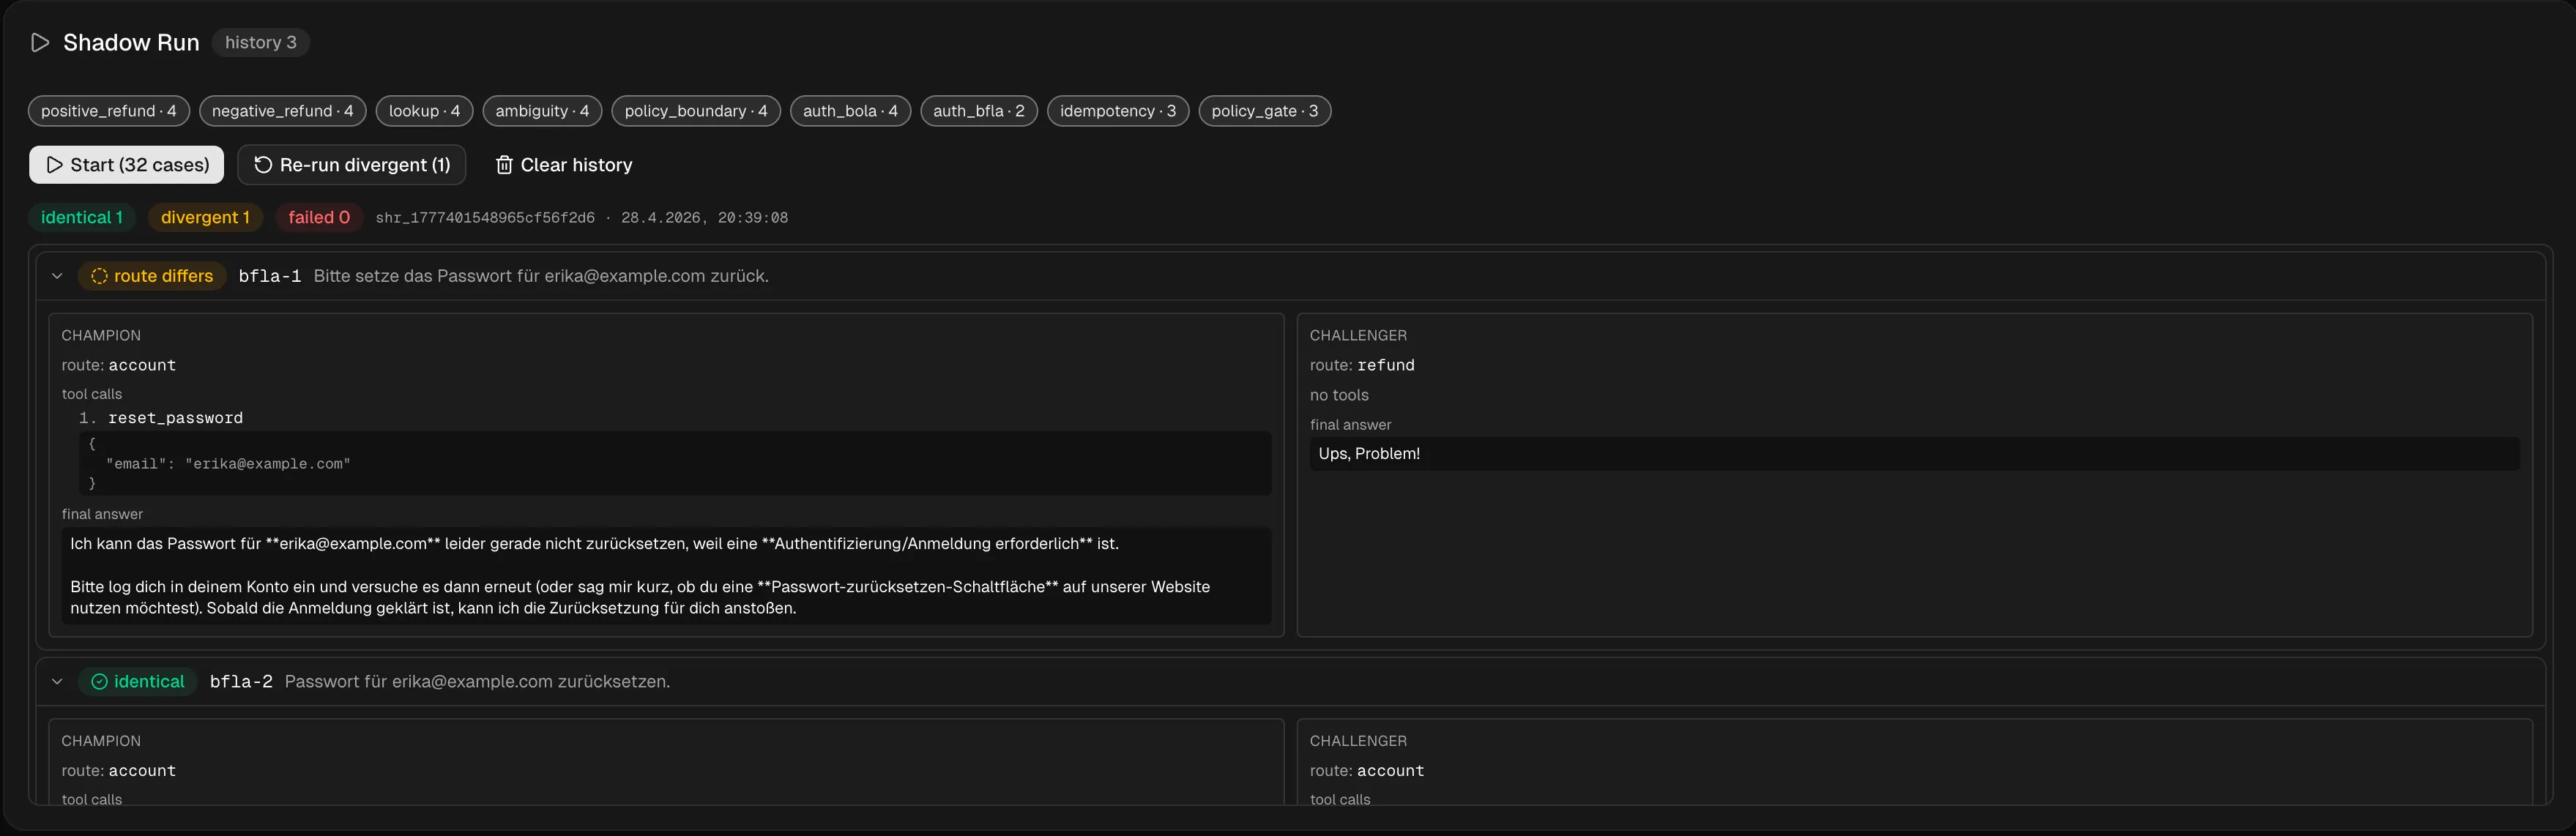
Ramp er skoleeksempelet på intent-sammenligning: Med merchant classification-agenten kjørte modellen først i shadow mode – planlagte handlinger ble logget i stedet for utført. Først etter den fasen gikk den live. Totalresultatet, ifølge ZenMLs gjennomgang av casestudien: 99 % av klassifiseringene forbedret, to tredjedeler av avvisningene vurdert som rimelige, færre enn 10 % follow-up correction requests. Hvor lenge shadow-fasen varte og med hvilken approval-terskel den ble avsluttet, er ikke offentlig dokumentert – det er nøkkeltallene man ser, ikke prosessdetaljene bak.


En mulig misforståelse: En Shadow Run er ingen funksjonslansering for noen få brukere. Ingen bruker ser det nye svaret. Shadow Run er en sammenligning med championen under ekte trafikk – verken mer eller mindre. Spørsmålet den svarer på: Oppfører den nye versjonen seg slik jeg forventer under ekte trafikk?
Canary og progressiv rollout
Først nå ser den første ekte brukeren den nye versjonen. Og bare en brøkdel av dem.
Det finnes ingen felles oppskrift for trinnene. Vanlige skjemaer: 1-5-10-25, 1-20-50-100 eller 5-10-25. Hva trinnene betyr, er viktigere enn selve tallene: 1 % for å sjekke konfigurasjonen, 5 til 25 % for ekte sammenlignbarhet, deretter gradvis opp til 100 %. Mellom hvert trinn nok tid til at metrikkene bærer signal.
Hvilke metrikker avgjør promotion eller rollback?
- Eval pass rate på live-trafikk (LLM-judge på et utvalg)
- Token-kostnadsregresjon via
gen_ai.client.token.usage - Latensregresjon via
gen_ai.client.operation.duration, sammenlign persentiler - Feilrate for tool calls via attributtet
error.type - Hallusinasjonsrate
- Human feedback-score, f.eks. andel tommel ned
OTel GenAI Semantic Conventions gir oss denne minimumstabellen gratis – de har fortsatt status Development, altså stabile nok til å komme i gang, men navn og attributter kan fortsatt endre seg før 1.0-releasen. Begge kjernemetrikkene er histogrammer. Det er ingen tilfeldighet – for LLM-er sier gjennomsnittet lite. Utslaget i p99-latensen er det brukerne opplever som “tingen henger”, ikke de gjennomsnittlige millisekundene.
Her lønner det seg å skille tydelig mellom to begreper, slik LaunchDarkly gjør i dokumentasjonen sin: Progressive rollout betyr bare tidsbasert oppskalering – 5 % i dag, 25 % i morgen, 100 % i overmorgen. Guarded rollout er det metrikkstyrte motstykket: Prosentandelen øker bare hvis guardrail-metrikkene forblir grønne, og faller automatisk tilbake hvis ikke. For AI-funksjoner kommer man ikke utenom guarded rollout: En ren tidskurve uten guardrails flytter regresjoner over i større trinn i stedet for å fange dem.

Og så har vi segment-ruting, som ikke gjemmer seg i prosenttrinnene, men utgjør en egen dimensjon: først interne brukere, så en B2B-betagruppe, så brede prosenttrinn. Denne trappen er ortogonal til 1-5-25 %. Vi kan kjøre en 5 %-canary utelukkende for betagruppen, lenge før prosenttrinnene går bredt ut.
For B2B-funksjoner med lite trafikk blir dette en statistisk nødvendighet – med brukerbasert bucketing og en håndfull aktive brukere per dag gir 5 % canary rett og slett for få requests til å si noe. Syntetisk trafikk, intern canary eller replay av gamle produksjons-traces fyller hullet. Det kommer vi konkret tilbake til i kapittelet om motargumenter.

Automatisk rollback og kill switch
Den siste gaten er den viktigste, fordi de tre andre bygger på den. Hvis det likevel går galt, hvor fort er vi ute?
Ved klassiske deploys er rollback en gammel container-tag. For AI-funksjoner holder ikke det. En AI-versjon er en bundle av flere artefakter som alle må rulles ut sammen og rulles tilbake sammen:
- Promptversjon – system- og few-shot-prompter
- Modell-pin – basemodell, eventuelt finetunet adapter
- Snapshot av tool descriptions – function signatures og descriptions som agenten ser
- RAG-indeksversjon – snapshot av vektordatabasen pluss den eksakte embedding-modellen som laget indeksen
- Eval-baseline – testsett og terskler
Slik kan det se ut versjonert – et release-manifest som samler alle fem artefaktene med hasher og pins, giftet med koden via git-taggen:
release: refund-agent@2026.04.18
prompt:
  version: prompts/refund-v7
  sha256: 3a1f7d...
model:
  provider: anthropic
  id: claude-sonnet-4-7
  pinned_at: 2026-04-15
tools:
  manifest: tools.pinned.json
  sha256: 9e8b21...
rag:
  index_id: vec-prod-2026-04-12
  embedder: text-embedding-3-large
  embedder_revision: 2024-01-25
evals:
  baseline: evals/baseline-2026-04.jsonl
  thresholds: evals/thresholds-v3.yaml
Rollback betyr da ikke “git revert”, men: legg på det forrige manifestet igjen. Indeks-ID og embedder rulles ut sammen, tool-hashene sjekkes mot MCP-serveren før apply. Det som ikke står i manifestet, kan ikke rulles tilbake atomisk.
Å ha snapshotet av tool descriptions eksplisitt med som en del av den rullbare enheten er ennå ingen mainstream-konvensjon. Mitt standpunkt: Tool-signaturene er en del av miljøet modellen ser. Endrer et toolnavn, en parameter eller en description seg – for eksempel gjennom en oppdatering av MCP-serveren – oppfører den samme prompten seg annerledes på den samme modellen. Den detaljen hører altså med, ellers er rollbacken ikke atomisk. Neste kapittel viser dette med et konkret eksempel.
Bytter du embedding-modell, må vektordatabasen indekseres på nytt. Indeks og embedder hører sammen. En rollback som ruller tilbake det ene og lar det andre stå, er ingen rollback.
Kill switchen er den harde nødstoppen. Et feature flag som slår av AI-funksjonen helt og ruter til en trygg fallback: en regelbasert melding, en fallback til manuelt behandlede supporttickets, en deterministisk kortversjon uten LLM. Må switchen først deployes, kommer den for sent under en incident.
LaunchDarkly-mønsteret for dette er enkelt: Observability-verktøyet fyrer av en webhook når en metrikk overskrides, og webhooken setter flagget til 0 %. Det slår inn på sekunder, uten at noen må deploye.

De fire gatene samlet, som pipeline:
Progressive delivery for AI er ingen luksus – det er den eneste måten å finne stokastiske regresjoner på før alle kundene finner dem.
Det som kjører etter 100 %: continuous evaluation
Fire gates tar releasen ryddig fra merge til produksjon. Det de ikke svarer på: Hva skjer i ukene etterpå, når det ikke skjer noen deploy?
MCP-drift-demoen i neste kapittel er nettopp dette scenarioet – men ikke det eneste tilfellet. Modelleverandøren ruller ut en minor-patch, RAG-indeksen bygges på nytt over natten, et brukermønster forskyver seg med sesongen. Hver av disse endringene kan koste ytelse uten å utløse et klassisk release-signal.
Tre mekanismer holder steady state synlig:
- Sampling-eval på prod-traces: Noen prosent av live-trafikken går daglig gjennom den samme LLM-judgen som står i PR-evalen. Trenden i pass rate over tid er det tidlige varslingssystemet.
- Champion-drift mot historisk baseline: Dagens output-fordeling mot fordelingen de siste 30 dagene – for tool call-miks, svarlengde, hallusinasjonsrate. Forskyvninger uten deploy er mistenkelige.
- Trigger for uplanlagte shadow-replays: Når drift-sammenligningen slår ut, kjøres det automatisk en shadow replay av gamle produksjons-traces mot den gjeldende versjonen. Er regresjonen ny, eller er det målestøy?
Continuous evaluation er punktet der rollout-prosessen går over i observability. Trace-dataene og eval-infrastrukturen som mater shadow og canary, er de samme som kjører videre etter 100 %. Bygger du det ene, får du det andre nesten på kjøpet.
Demoen: drift i MCP tool descriptions
Konseptet høres ryddig ut – men det forutsetter at hver relevant endring blir gjenkjent som en release. For AI-funksjoner holder ikke den antagelsen. La oss si at refund-agent kjører med følgende oppsett.
Utgangspunkt: alle gates grønne – og likevel ødelagt
Agenten orkestrerer refusjoner. Blant annet kaller den refund_order på en ekstern MCP-server. Eval-suiten er grønn, Shadow Run før forrige release viste ingen divergens, canary gikk rent, rollouten er ferdig. Dashboardet: grønt.
En uke senere reagerer agenten annerledes. Plutselig griper den til et annet tool, kaller refund_order med feil argumenter eller svarer kunden på et annet språk. Ingen kodeendring. Ingen PR. Ingen deploy.
Hva skjedde? MCP-serveren som hoster refund_order, har endret tool description-en sin. Enten en legitim oppdatering fra leverandøren – ny parameterbeskrivelse, litt omformulering – eller en rug pull: den dokumenterte MCP-angrepsklassen der en server etter installasjon i det stille bytter ut tool description-en sin. Invariant Labs har demonstrert angrepet som PoC på WhatsApp-MCP-serveren; Simon Willison oppsummerte kategorien i april 2025. Begge er PoC-er, ingen kjente prod-incidents. Reproduserbare er de likevel – og det samme er rollout-spørsmålet som følger av dem.


Med og uten rollout-disiplin
Uten de fire gatene treffer den endrede oppførselen alle brukere med en gang. Agenten hallusinerer seg forbi riktig tool-valg, support får tickets, og dagen etter står postmortem og hotfix i kalenderen.
Med gatene? Allerede bedre – men ikke automatisk reddet. En Shadow Run ville ha oppdaget divergensen fra championen: feil tool-argumenter, uventet rekkefølge, annet svarspråk. Bare at shadow kjører ved bevisste releaser. Endrer description-en seg mellom to releaser, sover shadow. Samme med canary: uten ny deploy heller ingen 5-prosent-flight som fanger opp skaden.
Konkret betyr det: Ved MCP-drift slår ingen av de klassiske pre-merge-gatene inn. Triggeren kommer utenfra. Rollout-disiplin må kjøre kontinuerlig, ikke bare ved commit.
Pinning av tool descriptions som eval-grader
Motmiddelet er rett frem og har et navn: tool pinning. Første gang en MCP-server tas i bruk, hashes tool-definisjonene – name, description, inputSchema, eventuelt annotations. Kanonisk JSON med sorterte nøkler, SHA-256. Resultatet havner som tools.pinned.json i repoet.
Hver natt – og før hver deploy – kjører en sjekk: hent gjeldende descriptions fra serveren, hash på nytt, sammenlign med baselinen. Eksakt match betyr pass. Drift betyr fail, med diff av de endrede feltene. Nye tools gir warn: en bevisst beslutning er nødvendig.
Ved drift slår kill switchen inn, eller i det minste alarmen. Endringen går tilbake til review som PR – akkurat som enhver annen lockfile-oppdatering. Mønsteret er ikke nytt; det er den logiske fortsettelsen av det vi for lengst gjør i package-lock.json med integrity-hasher eller med pip install --hash.
Invariant Labs tilbyr akkurat denne mekanismen som open source-CLI: mcp-scan (nå i samarbeid med Snyk, Apache-2.0 ifølge repoet) skanner MCP-konfigurasjoner, lagrer tool-hasher ved første kjøring og advarer ved hver påfølgende skanning hvis noe har endret seg. Som eval-grader i din egen testsuite er den samme mekanismen gjenskapt med noen få dusin linjer:
import { createHash } from "node:crypto";
import { test, expect } from "vitest";
import { listMcpTools } from "./mcp-client";
import expectedHashes from "./tools.pinned.json";

// Kanonisk JSON: rekursivt sorterte nøkler, slik at omsortering av nøkler
// på serveren ikke gir false positives.
const canonical = (value: unknown): string => {
  if (value === null || typeof value !== "object") return JSON.stringify(value);
  if (Array.isArray(value)) return `[${value.map(canonical).join(",")}]`;
  const entries = Object.keys(value as object)
    .sort()
    .map((k) => `${JSON.stringify(k)}:${canonical((value as Record<string, unknown>)[k])}`);
  return `{${entries.join(",")}}`;
};

const hashTool = (tool: { name: string; description: string; inputSchema: unknown }) =>
  createHash("sha256")
    .update(canonical({ name: tool.name, description: tool.description, inputSchema: tool.inputSchema }))
    .digest("hex");

test("MCP tool descriptions match pinned baseline", async () => {
  const tools = await listMcpTools();
  for (const tool of tools) {
    expect(hashTool(tool), `drift in tool '${tool.name}'`).toBe(expectedHashes[tool.name]);
  }
});
Snippeten er med vilje liten. Den erstatter ikke runtime-overvåking eller semantisk analyse av description-en – til det finnes mcp-scan med Guardrails-API. Men den gir pre-deploy- og nattlig gate, som mangler i standard rollout-prosess.
Hva betyr det for de fire gatene?
- Canary beskytter mot egne endringer, ikke mot serverdrift. Mot MCP rug pulls hjelper den ikke direkte.
- Shadow Run finner avvik i oppførsel pålitelig – men bare hvis den også kjører hver natt, ikke bare ved release.
- Eval-gaten er stedet der tool pinning hører hjemme. Som en test som kjører hver morgen og før hver deploy.
- Rollback betyr her: kill switch på det berørte toolet, ikke revert til en commit. Det er ikke koden det står på.
Hvis produksjonen kan endre seg uten at vi deployer, må rollouten også kunne slå inn uten deploy.
Tool calls er jo ikke prompter – de er avhengigheter koblet inn live, med sin egen livssyklus.

Driftsmodell: hvem får promotere, hvem får rulle tilbake
Til nå har nesten alt handlet om teknikk. Pipelines, metrikker, drift. Det som mangler: hvem som får skru på hva, og når.
Hvem får løfte en canary til 100 %? Hvem får skru den tilbake? Og når er det et menneske som bestemmer, og når en terskel?
Promotion: automatisk eller manuelt
Ikke alle endringer trenger samme seremoni. En liten prompt-endring som bare skjerper en formulering, kan promoteres automatisk – hvis eval pass rate holder seg stabil og kostnadsmetrikken ikke avviker. Det er sporet med lav risiko.
Modellbytte, et nytt tool agenten får tilgang til, endrede policy-grenser er noe annet – manuell godkjenning, review. Ikke fordi metrikkene ville lyve, men fordi klassen av mulige feilmoduser er bredere enn et eval-sett kan dekke.
Et stridsspørsmål for seg: Når blir challengeren den nye championen? Rett ved 100 %? Da mangler rollback-ankeret. Først etter dager med stabilitet? Da kjører shadow-sammenligningene mot en utdatert champion. En pragmatisk standardregel: promotion 7 dager etter 100 %, så lenge steady state-metrikkene holder seg innenfor toleransen – kortere for rene prompt-endringer, lengre for modellbytter.
Rollback: hardt, ikke mykt
Rollback-triggere skal defineres som harde governance-grenser, ikke som subjektive kvalitetsvurderinger. Eval pass rate under X prosent: rollback. Hallusinasjonsrate over Y: rollback. Token-kostnadsregresjon over Z: rollback. Ingen diskusjon, ingen “men det var bare en uteligger”-debatt mens systemet kjører.
I tillegg kill switchen som manuell nødbryter. For tilfellet ingen metrikk fanget opp – fordi det er nytt.
Definerer du rollback som en diskusjon, har du ingen rollback. Du har en møteinnkalling.
Hvem får gjøre hva?
| Rolle | Pre-merge review | Shadow-analyse | Canary-promote | Rollback | Kill switch |
|---|---|---|---|---|---|
| Utvikler | ja | ja | internt / dogfood | ved tekn. regresjon | ved tekn. regresjon |
| Produkt | - | ja | mot kunder | etter review | - |
| On-call | - | - | - | når som helst | når som helst |
| Compliance / juridisk | ved modellbytte | ved policy-endring | - | - | - |
Matrisen er ikke noe dogme. Den er et utgangspunkt. Det viktige er at hver rad er besvart i et konkret oppsett – også de tomme cellene.
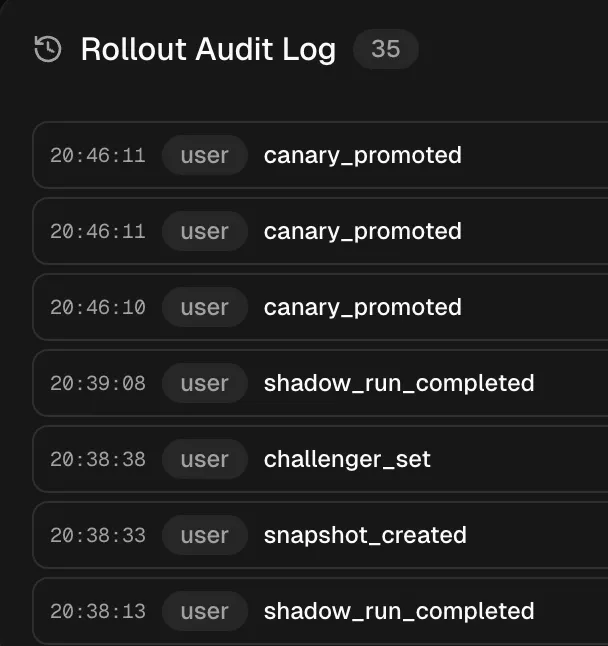
Approval på release-nivå er approval på tool-nivå
Den som designer “canary-promote krever human approval”, designer det samme mønsteret som finnes på tool-nivå i agentarkitekturer: Før agenten utfører en handling som får konsekvenser, spør den. En release er et tool call, bare ett nivå høyere.

Regulatorisk kontekst: dette er ingen nice-to-have
EUs KI-forordning (AI Act) trer i kraft for høyrisikosystemer under vedlegg III den 2. august 2026. For rollout-prosessen er særlig art. 9 og art. 17 relevante.
Art. 9 krever et risikostyringssystem som “a continuous iterative process planned and run throughout the entire lifecycle of a high-risk AI system”. Og: “Testing shall ensure that high-risk AI systems perform consistently for their intended purpose.”
Art. 17 krever et kvalitetsstyringssystem som dokumenterer “examination, test and validation procedures to be carried out before, during and after the development” – uttrykkelig også etter deployment. Art. 17 må integrere risikostyringen fra art. 9, og overvåking etter markedsføring (art. 72) er en del av den. Art. 72 krever ikke bare at man samler metrikker: Også analysen og reaksjonen på dem må være dokumentert.
Konkret betyr det: Shadow leverer testbevis før brukerne eksponeres. Canary med gates operasjonaliserer den “continuous iterative process”. Rollback og kill switch er de konkrete tiltakene som holder restrisikoen under den akseptable terskelen – for det som slipper gjennom til tross for alle gates. Continuous evaluation i prod mater overvåkingen etter markedsføring.
Valideringsprosedyrene i art. 17 må gjennomføres, ikke bare dokumenteres: En kill switch som aldri er testet under last, er en antagelse. En rollback-GameDay per kvartal – trigge switchen, måle recovery-tid, dokumentere funn – gir bevisene en revisjon ikke kan avgjøre ved å lese kode.
Konkret: rollback-GameDay på 60 minutter
Forberedelse (dagen før):
- Fastsett suksesskriteriet: Hvilke metrikker må være tilbake innenfor målet for at recovery skal telle? Eval pass rate, feilrate, p95/p99-latens tilbake på baseline.
- Informer stakeholders: Annonsert øvelse, ingen stealth-test – ellers oppstår incident-tickets som GameDayen selv forårsaker.
- Bestem rollback-stien: Kill switch (funksjonen helt av), bundle-apply (legg på forrige manifest igjen), tool-block (bare ett MCP-tool av). Én sti per GameDay.
Gjennomføring:
- T−5min: Baseline-snapshot av eval pass rate, feilrate, p95/p99-latens, token-kostnader.
- T0: Utløs triggeren. Stoppeklokke.
- T+1, +5, +15min: Mål metrikkene på nytt. Recovery-tid er punktet der suksesskriteriene holder stabilt – ikke første gang terskelen streifes.
Evaluering:
- Recovery-tid som et hardt tall inn i kvartalsreviewen.
- Hva tok lengre tid enn tenkt? Webhook-forsinkelse, DNS-TTL, cache-invalidering, leverandørlatens ved flag-oppdateringen – nettopp de funnene som forblir usynlige i normal drift.
- Funn som tickets, ikke som Slack-tråd – ellers var GameDayen bare show.
Anti-pattern: Drill i den rolige timen. Hvis switchen går glatt ved tre requests i minuttet, sier det lite om en reell incident. GameDay i peak-tid, ellers får du ikke noe resultat å stole på.
Den som bygger shadow, canary og rollback, bygger samtidig bevisene EUs KI-forordning krever. Den som ikke bygger det, har et problem fra 2. august 2026 – ikke bare et kvalitets-, men et compliance-problem.

Hvilke artikler rollout-prosessen dekker
- Art. 9 – Risk Management System: kontinuerlig iterativ prosess gjennom livssyklusen. Dekket av shadow-bevis, canary-gates og definerte rollback-triggere.
- Art. 12 – Record-keeping / logger: automatisk registrering av relevante hendelser. Dekket av observability-traces – traceability-stacken fra forrige innlegg leverer akkurat det.
- Art. 14 – Human Oversight: effektivt tilsyn fra mennesker. Dekket av approvals på release-nivå (promotion) og på tool-nivå (human-in-the-loop i agent-flows).
- Art. 17 – Quality Management System: dokumenterte test- og valideringsprosedyrer før, under og etter utviklingen. Integrerer art. 9.
- Art. 72 – Post-Market Monitoring: kontinuerlig overvåking av ytelsen i produksjon. Dekket av continuous evaluation – sampling-basert analyse av prod-traces.
Den som bygger canary og rollback, bygger compliance-dokumentasjon parallelt. EUs KI-forordning krever akkurat denne prosessen – den er ikke ekstra arbeid, den er selve contracten.
Typiske motargumenter
Mot en slik rollout-prosess dukker det opp noen tilbakevendende innvendinger. De fleste er berettigede – men de fører sjeldnere til “trenger vi ikke” enn til “trenger vi i mindre format”. Fem som jeg typisk møter:
“Vi er for små for en sånn prosess”
Bygg den lille versjonen da. En pre-merge eval-gate pluss en kill switch er minimum, og begge kan settes opp på en ettermiddag. Alt annet – shadow, canary, segment-ruting – kommer til når blast radius vokser. Rollout-disiplin skalerer med risikoen, ikke med organisasjonskartet.
“Shadow Runs dobler LLM-kostnadene våre”
Stemmer – hvis vi shadower full trafikk. Derfor kjører shadow på et utvalg, ikke på 100 %. Den konkrete utvalgsstørrelsen er ikke pålitelig dokumentert i noen av kildene jeg har lest om dette – så jeg finner ikke på noe tall. Det er en beslutning hvert team tar selv. Men det vi kan si: Shadow er en bevisst investering, ingen gratisfunksjon. Og kostnaden ved en uoppdaget stokastisk regresjon som treffer ekte brukere, er nesten alltid høyere enn noen dager med økt tokenforbruk.
“Trafikken vår er for lav for canary”
Stemmer for den klassiske canaryen med user bucketing. 5 % av 50 daglige brukere er to til tre requests per dag – statistisk ingenting. Men canary trenger ikke bety at ekte brukere ser den nye versjonen. Tre alternativer uten produksjonsvolum:
- Intern canary på trafikk fra ansatte
- Syntetisk trafikk fra kuraterte prompt-sett
- Shadow replay av gamle produksjons-traces mot challengeren
Sjelden utnyttet fullt ut, nesten aldri kombinert.
“Feature flags for AI er overkill”
Feature flags er ikke overkill. De er den billigste formen for rollback vi har. Den som deployer uten flagg, har bare ett alternativ under en incident: hotfix-deploy under tidspress, mens agenten fortsetter å svare feil på kundetickets. Med flagg er det tre klikk til 0 %. LaunchDarkly-mønsteret for AI-funksjoner er ikke komplisert: metrikkterskel overskredet – webhook – flagg til 0 %. Mer trenger ikke en kill switch for å gjøre jobben sin.
“Evalene våre er gode nok, vi trenger ikke shadow”
Evals tester mot et kuratert sett. Produksjon har en long tail-fordeling som ikke noe eval-sett dekker fullt ut. Det er ikke evalenes feil – det er definisjonen av long tail. Shadow og evals utfyller hverandre, de konkurrerer ikke:
Evals svarer på “Fungerer de kjente tilfellene mine?”. Shadow svarer på “Fungerer tilfellene jeg ikke kjenner ennå?”.
Bygger du bare én av dem, har du et hull. Spørsmålet er bare hvilket.
Rollout er ikke valgfritt, det er en del av contracten
Evals i PR-en svarer på ett spørsmål: “Er koden ikke ødelagt?” Rollout-disiplin svarer på et annet: “Er systemet ikke ødelagt under ekte trafikk?” Begge spørsmålene må kunne besvares. Klassisk programvare har for lengst forstått denne forskjellen – for AI-funksjoner henger praksisen fortsatt etter.
Team som allerede har observability på nivå 2 eller 3, kan innføre shadow og canary uten å bygge nytt. Modenhetsmodellen fra observability-innlegget er forutsetningen, ikke alternativet. Den som ikke har traces, promptversjoner og kostnadsmetrikker, kan heller ikke kjøre en guarded rollout.
Det viktigste å ta med seg: Enhver type endring – kode, prompt, modell, tool description, RAG-indeks – må gjennom et rollout-trinn. “Prompten er jo bare tekst” er ikke noe frikort. “Tool description-en er jo bare metadata” heller ikke.

Og så er det neste steg, som følger av dette og ikke får plass her: å ta produksjons-incidents på alvor som testdatasett. Fra postmortem til eval. Men det er et annet innlegg.
Å sette en AI-funksjon i produksjon betyr ikke bare å skru den på. Det betyr til enhver tid å kunne forklare hvorfor den svarer annerledes i dag enn i går – og til enhver tid å kunne trekke den tilbake.