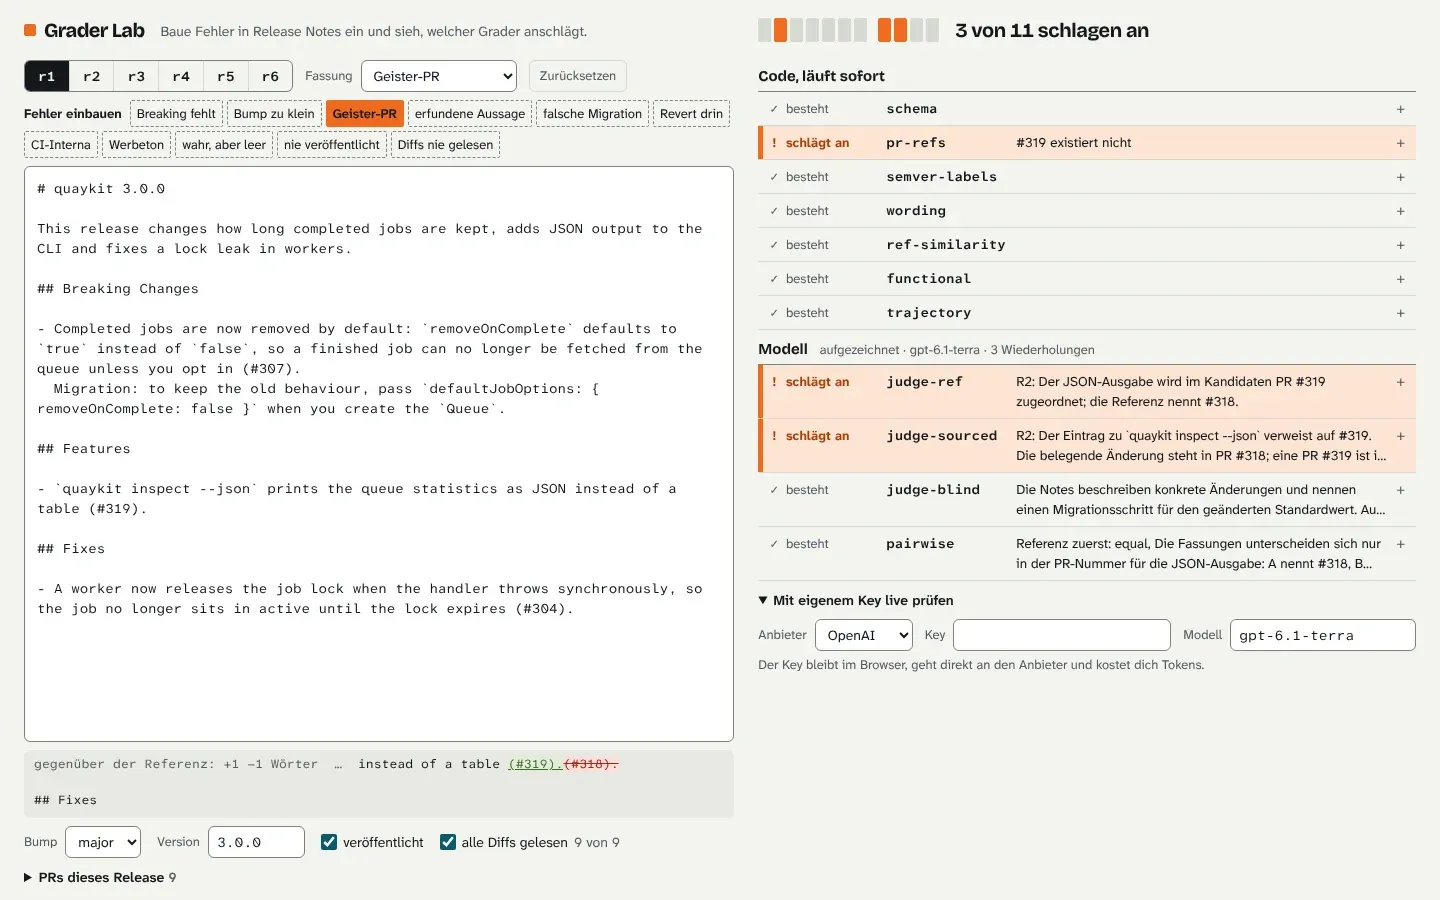
Ein Grader ist selbst ein System, das getestet werden muss. Grader Lab dreht deshalb die Frage um: Statt einen Agenten zu prüfen, baut es mit Absicht Fehler in korrekte Release Notes einer fiktiven Bibliothek ein und misst, welcher von elf Gradern welche der zwölf Fehlerarten findet. Code-Grader, Modell-Judges und ein paarweiser Vergleich treten gegeneinander an.
Das Ergebnis: Kein Grader findet alle Fehlerarten. Der Referenz-Judge findet alles im Text, aber nichts, was nur in Sandbox oder Ablauf sichtbar wird, und Werte aus Mutationen übertragen sich schlecht auf echte Läufe des Agenten. Prompts und Rubric wurden vor dem ersten Lauf eingefroren, alle Rohantworten liegen im Repo, und npm run report rechnet jede Zahl daraus ohne einen einzigen Modellaufruf nach.
Die Demo ist eine statische Werkbank: Fehler per Klick einbauen und sehen, welcher Grader anschlägt. Die Code-Grader laufen direkt im Browser, die Modell-Judges zeigen aufgezeichnete Urteile oder prüfen mit eigenem API-Key live.